歪心公众皓:超分辨率重建
📇 论文卡片
标题:Feature Modulation Transformer: Cross-Refinement of Global Representation via High-Frequency Prior for Image Super-Resolution
作者:Ao Li, Le Zhang, Yun Liu, et al.
发表:ICCV 2023
链接:https://arxiv.org/abs/2308.05022
代码:https://github.com/AVC2-UESTC/CRAFT-SR
💡 一句话先看懂
作者先用一组"挖频谱"实验实锤了 Transformer 超分的软肋------擅长低频、不擅长高频 ;然后让 CNN 分支提取高频信息当"先验",通过跨注意力去精修 Transformer 的全局表征。753K 参数的 CRAFT 在 Manga109 ×4 上比 SwinIR-light 高 0.26 dB,FLOPs、显存、耗时全面更低。
🌄 背景
Transformer 超分(SwinIR、CAT、HAT 等)这两年把长程依赖吃得很透,但一个具体问题始终没人正面回答:这些窗口注意力结构,到底在什么样的频率成分上真正管用?
作者的切入点非常朴素:把输入图的高频成分按比例抹掉,再看 CNN 和 Transformer 谁掉点更多。结果很一致------抹掉高频时 Transformer 掉点小(它本来就主要依赖低频),但在图像域按窗口抹除、考验"从低频重建高频"的能力时,Transformer 掉点明显比 CNN 惨。
这正好解释了超分的核心矛盾:高频=边缘、纹理细节;低频=大块平坦区域。SISR 的得分恰恰主要由高频细节决定,而主流 Transformer 结构天然在"高频重建"上偏科。
痛点 → 方法的因果链 :既然 Transformer 管低频/全局、CNN 管高频/局部,那就别二选一------把 CNN 的高频特征作为先验,喂给 Transformer 去精修它的全局表征。这就是 CRAFT(Cross-Refinement Adaptive Feature Modulation Transformer)名字的由来。
🎯 主要贡献
- 首次从频率视角系统诊断 CNN 与 Transformer 在 SISR 中的能力差异:Transformer 擅长低频,高频重建能力弱于 CNN;
- 提出三模块框架 CRAFT:HFERB(高频增强)+ SRWAB(平移矩形窗口注意力)+ HFB(混合融合),用高频先验跨注意力精修全局表征;
- 轻量赛道全面领先 :753K 参数,最多比 SOTA 高 0.29 dB(摘要口径),且 FLOPs / 显存 / 推理时间均低于 SwinIR;
- 消融闭环验证设计哲学:交换 Q/K/V、级联替代并行等反向实验均显著掉点,证明"高频只能当先验、不能当主角"。
🔧 核心方法
🔍 前置:诊断性实验(全文最抓人的部分)
做法:对 HR 图做 FFT,把频谱按幅值排序后抹掉比例 γ\gammaγ 的高频分量(频域法);或在图像域按窗口抹除像素(图像域法),再比较各模型 PSNR 的变化 PD(γ/θ)P^D(\gamma/\theta)PD(γ/θ)。
结论:Transformer 对"低频被抹"几乎无感,但对"需要自己造高频"的场景明显力不从心------窗口越大(感受野越全局),高频重建掉点越狠。
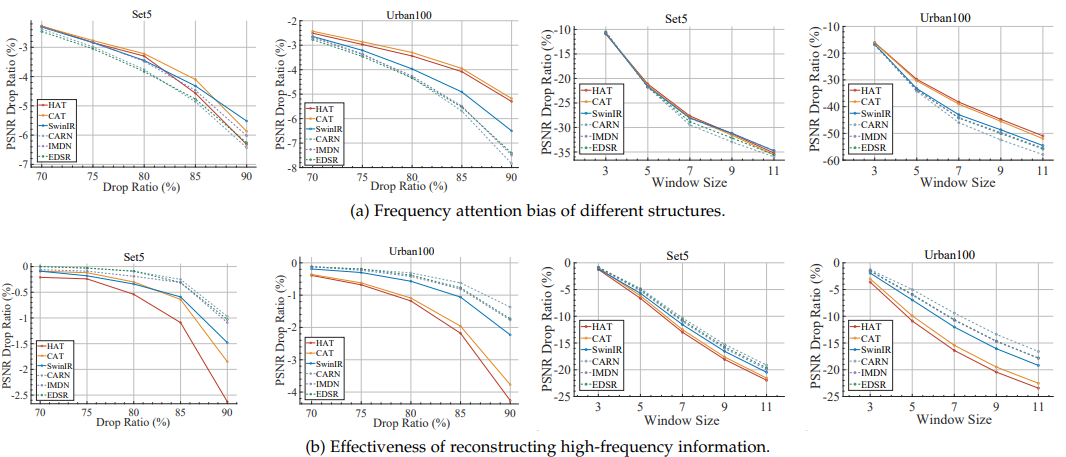
图 1:频谱丢弃诊断实验------(a) 频域高频丢弃下 Transformer 掉点更小(低频依赖);(b) 图像域丢弃下 Transformer 掉点更大(高频重建弱于 CNN)。
1️⃣ HFERB:高频增强残差块
是什么:CNN 血统的分支,专产高频特征。
为什么:既然 Transformer 补不了高频,就安排专职模块来产。
怎么实现:输入特征按通道一分为二(式 5):
FinLFE,FinHFE=Split(Fin) F_{in}^{LFE}, F_{in}^{HFE} = \mathrm{Split}(F_{in}) FinLFE,FinHFE=Split(Fin)
局部特征提取(LFE)分支走 3×33\times33×3 卷积 + GELU;高频增强(HFE)分支先 MaxPooling 再 1×11\times11×1 卷积 + GELU(式 7):
F^inHFE=fa(Conv1×1(MaxPooling(FinHFE))) \hat{F}{in}^{HFE} = f_a(\mathrm{Conv}{1\times1}(\mathrm{MaxPooling}(F_{in}^{HFE}))) F^inHFE=fa(Conv1×1(MaxPooling(FinHFE)))
两路 concat 后经 1×11\times11×1 卷积融合,加残差连接输出 XHX_HXH(式 8)。大白话:一半通道画细节,一半通道用池化"抠边缘",最后拼起来。
2️⃣ SRWAB:平移矩形窗口注意力
是什么:Transformer 血统的分支,负责全局表征。
为什么 :方形窗口对细长结构(建筑物的横竖线条)浪费注意力预算;矩形窗口 4,164,164,16 与 16,416,416,4 交替使用,长轴方向一次看穿更多相关内容。
怎么实现:标准平移窗口流程(式 12):
X=Rwin-SA(LN(Xin))+Xin X = \mathrm{Rwin\text{-}SA}(\mathrm{LN}(X_{in})) + X_{in} X=Rwin-SA(LN(Xin))+Xin
XS=MLP(LN(X))+X X_S = \mathrm{MLP}(\mathrm{LN}(X)) + X XS=MLP(LN(X))+X
论文在 6.4 节证实:去掉 mask 不掉点还能提速约 37--41%(×2--×4)。
3️⃣ HFB:混合融合块(点睛之笔)
是什么 :用 HFERB 的高频输出 XHX_HXH 当 query ,SRWAB 的全局输出 XSX_SXS 当 key/value,做跨模态(跨分支)注意力。
为什么 :直白 concat 会把两种频率分布不同特征强行压在一起,网络学不出"高频-低频"关系(消融见下文);把二次复杂度从空间维 O(N2C)O(N^2C)O(N2C) 挪到通道维 O(NC2)O(NC^2)O(NC2),既融合又省算力。
怎么实现 (式 13,α\alphaα 为可学习温度参数;Q^,K^,V^∈RC×HW\hat{\bm{Q}},\hat{\bm{K}},\hat{\bm{V}}\in\mathbb{R}^{C\times HW}Q^,K^,V^∈RC×HW 为通道维 reshape 后的矩阵):
Attention(Q^,K^,V^)=Softmax (Q^K^Tα)V^ \mathrm{Attention}(\hat{\bm{Q}},\hat{\bm{K}},\hat{\bm{V}}) = \mathrm{Softmax}\!\left(\frac{\hat{\bm{Q}}\hat{\bm{K}}^{T}}{\alpha}\right)\hat{\bm{V}} Attention(Q^,K^,V^)=Softmax(αQ^K^T)V^
融合输出再过 LayerNorm 与改进 MLP(IMLP,扩展比 2.66)收尾(式 14)。
整体框架:浅层卷积 → 4 个 RCRFG(每组 2 个 CRFB,每个 CRFB = 1×HFERB + 2×SRWAB + HFB)→ 重建模块,通道数 48,注意力头 6。
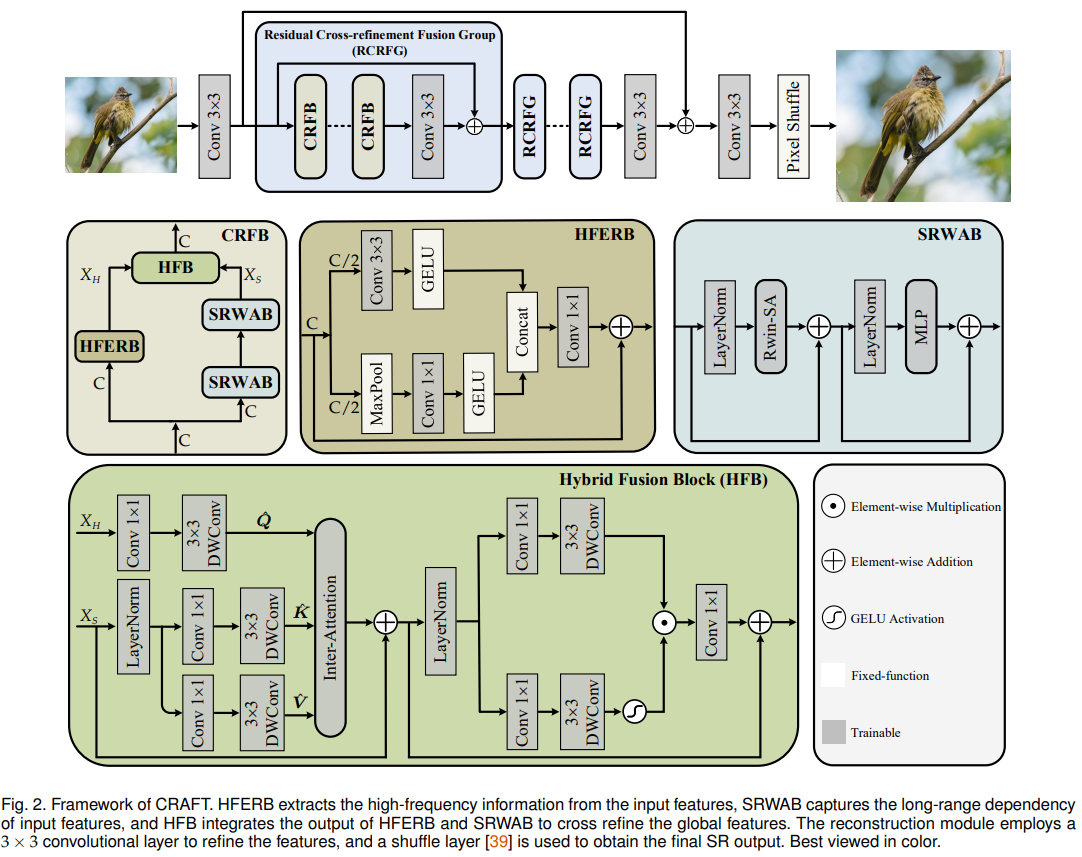
图 2:CRAFT 整体框架------HFERB 提取高频信息,SRWAB 捕捉长程依赖,HFB 以高频先验为 Q、全局特征为 K/V 做跨注意力精修。
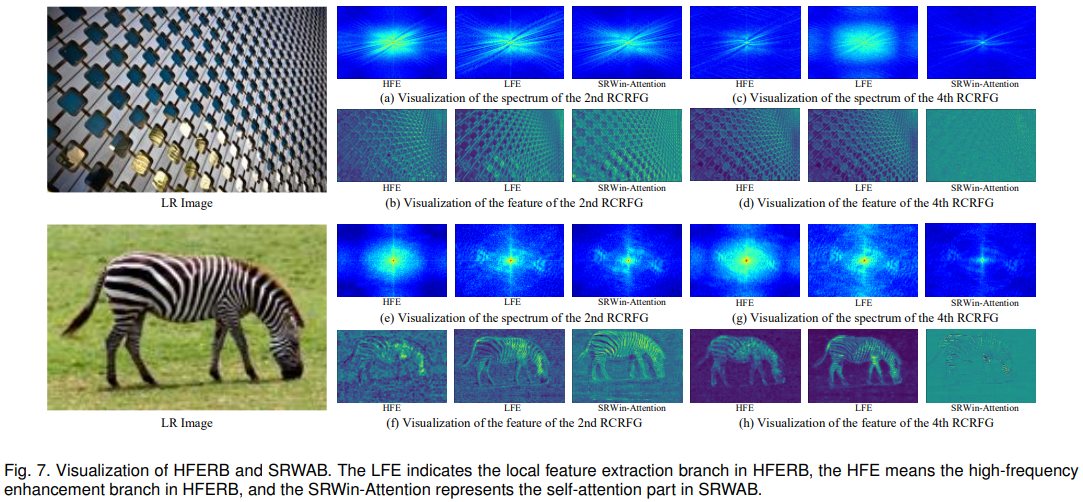
图 3:HFERB 与 SRWAB 的特征可视化------HFERB 的频谱响应集中在边缘、屋檐等高频结构,SRWAB 更关注墙面、窗户等低频平坦区域,印证两分支频率分工。
📊 实验结果
主表:轻量级赛道 ×4 对比(PSNR(dB)/SSIM,Y 通道)
| Model | #Params | Set5 | Set14 | BSD100 | Urban100 | Manga109 |
|---|---|---|---|---|---|---|
| CARN | 1592K | 32.13/0.8937 | 28.60/0.7806 | 27.58/0.7349 | 26.07/0.7837 | 30.47/0.9084 |
| IMDN | 715K | 32.21/0.8948 | 28.58/0.7811 | 27.56/0.7353 | 26.04/0.7838 | 30.45/0.9075 |
| LAPAR-A | 659K | 32.15/0.8944 | 28.61/0.7818 | 27.61/0.7366 | 26.14/0.7871 | 30.42/0.9074 |
| HPUN-L | 734K | 32.31/0.8962 | 28.73/0.7842 | 27.66/0.7386 | 26.27/0.7918 | 30.77/0.9109 |
| LBNet | 742K | 32.29/0.8960 | 28.68/0.7832 | 27.62/0.7382 | 26.27/0.7906 | 30.76/0.9111 |
| ESRT | 751K | 32.19/0.8947 | 28.69/0.7833 | 27.69/0.7379 | 26.39/0.7962 | 30.75/0.9100 |
| SwinIR-light | 897K | 32.44/0.8976 | 28.77/0.7858 | 27.69/0.7406 | 26.47/0.7980 | 30.92/0.9151 |
| ELAN-light | 601K | 32.43/0.8975 | 28.78/0.7858 | 27.69/0.7406 | 26.54/0.7982 | 30.92/0.9150 |
| CRAFT (Ours) | 753K | 32.52/0.8989 | 28.85/0.7872 | 27.72/0.7418 | 26.56/0.7995 | 31.18/0.9168 |
⚠️ 注意:以上全部为轻量级赛道(~1M 参数以内)对比,请勿与 HAT 这类精度型模型直接比参数。
关键读数:
- Manga109 ×4 上对 SwinIR-light / ELAN-light +0.26 dB(30.92 → 31.18),且参数少于 SwinIR-light(753K vs 897K);
- 对 EDSR-baseline:Manga109 上 ×2/×3/×4 分别 +0.85/+0.84/+0.83 dB,同时参数少 46%/52%/50%;
- 复杂度对 SwinIR-light(×4,生成 512×512 输出):FLOPs 26.0 vs 32.2 G,显存 79.5 vs 141.2 M,耗时 56.40 vs 79.11 ms------全面碾压式更低。
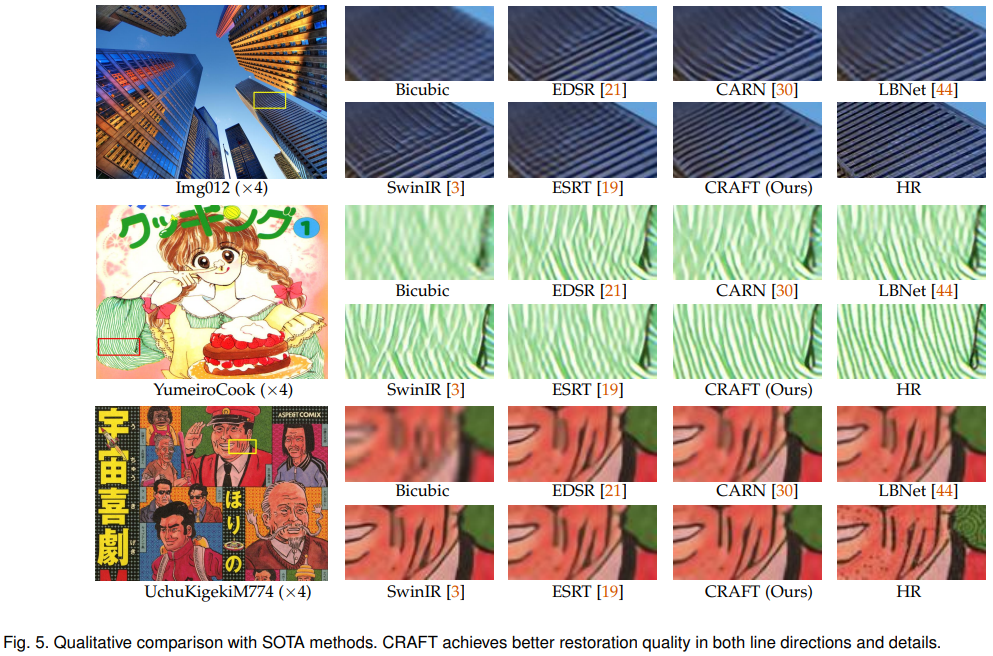
图 4:×4 定性对比------CRAFT 在线条方向恢复与细节保持上优于 EDSR、SwinIR 等方法。
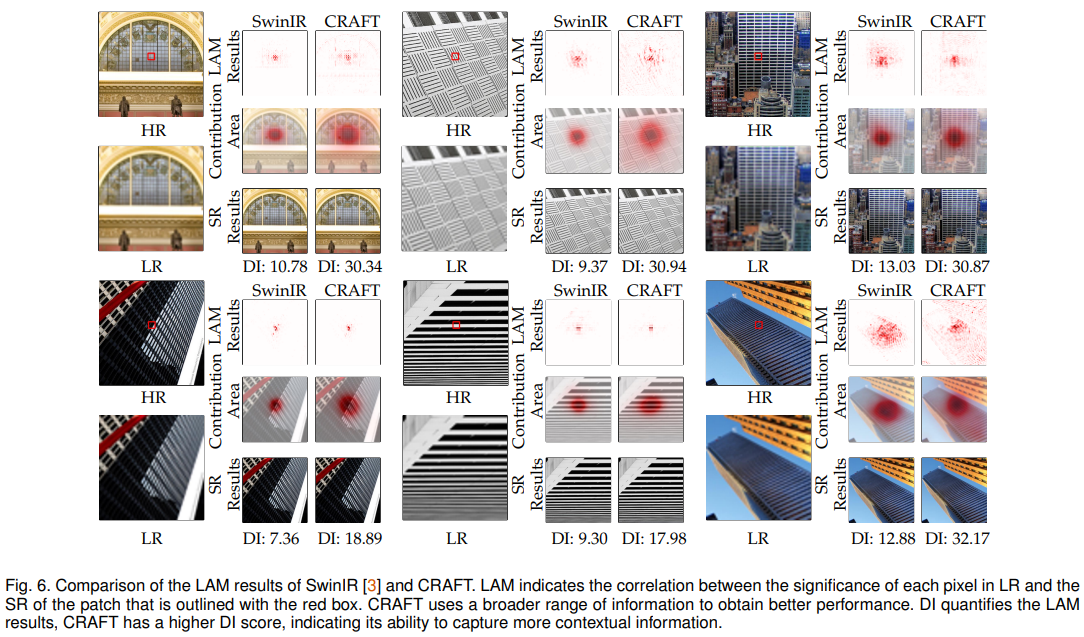
图 5:LAM 归因对比------CRAFT 的扩散指数(DI)约为 SwinIR 的 2--3 倍,说明其利用了更广范围的上下文信息。
最有说服力的消融(Manga109 ×4)
模块消融 (Table IV):只留 HFERB(CRAFT_conv)30.79 dB;只留 SRWAB(CRAFT_transformer)31.12 dB;两分支 concat 融合 30.92 dB;完整 CRAFT 31.18 dB 。三行一起读,故事很清楚:全局分支贡献大头(+0.33 dB),高频分支再补 0.06 dB,而换成 concat 融合直接丢 0.26 dB------融合方式本身很关键。
"先验只能当先验"消融 (Table V):把 HFB 里的 Q 和 K/V 对调(全局特征当 query),PSNR 从 31.18 掉到 30.67(−0.51 dB );改成 HFERB→SRWAB 级联结构,掉到 30.88(−0.30 dB)。高频特征是"调料"不是"主菜",位置摆错立刻掉点。
🧭 结论与思考
一句话总结:CRAFT 用一组诊断实验找到"Transformer 高频失能"的病根,再用 CNN 高频先验 + 跨注意力融合治好了它,在轻量赛道同时拿下精度与效率。
几点批判性思考:
- 赛道限定明显:753K 的体量决定了它是"手机端/边缘端"方案,别拿它和 HAT、SwinIR 完整版在精度榜上硬碰;
- 先验设计是否有通用性未验证(会议版范围内):HFB 的 Q/K/V 分工在 48 通道、4 组 RCRFG 的配置下成立,换到大模型上"高频当 query"是否仍然最优,论文未给出证据;
- 效率对比的口径:Table VI 的 SwinIR 对手是轻量版(897K),推理加速数字不适用于完整版 SwinIR;
- 可延伸方向:作者在扩展版里补了频率引导 PTQ(4-bit 量化下比 MinMax 最高 +8.32 dB),把"频率感知"从结构设计延伸到了部署压缩,值得单独细读。
💬 互动尾巴
开放问题:你觉得"给 Transformer 补高频先验"这条路线,是像 HAT 那样继续堆注意力更划算,还是像 CRAFT 这样做频率分工更划算?评论区聊聊你的判断。
下一篇看哪篇?投票选出:
- A. HAT(CVPR 2023)------混合注意力 + 同类任务预训练的精度王者
- B. DAT(ICCV 2023)------正交可变窗口的另一种"破窗"思路
- C. ELAN(ECCV 2022)------移位卷积 + 组多尺度自注意力的轻量选手
- D. 扩展版 PTQ 精读------CRAFT 的 4-bit 量化是怎么做到几乎不掉点的
声明:本文为论文学习笔记,非商业用途;图表版权归原作者,数据以论文原文为准;侵权请联系删除,转载请联系授权。