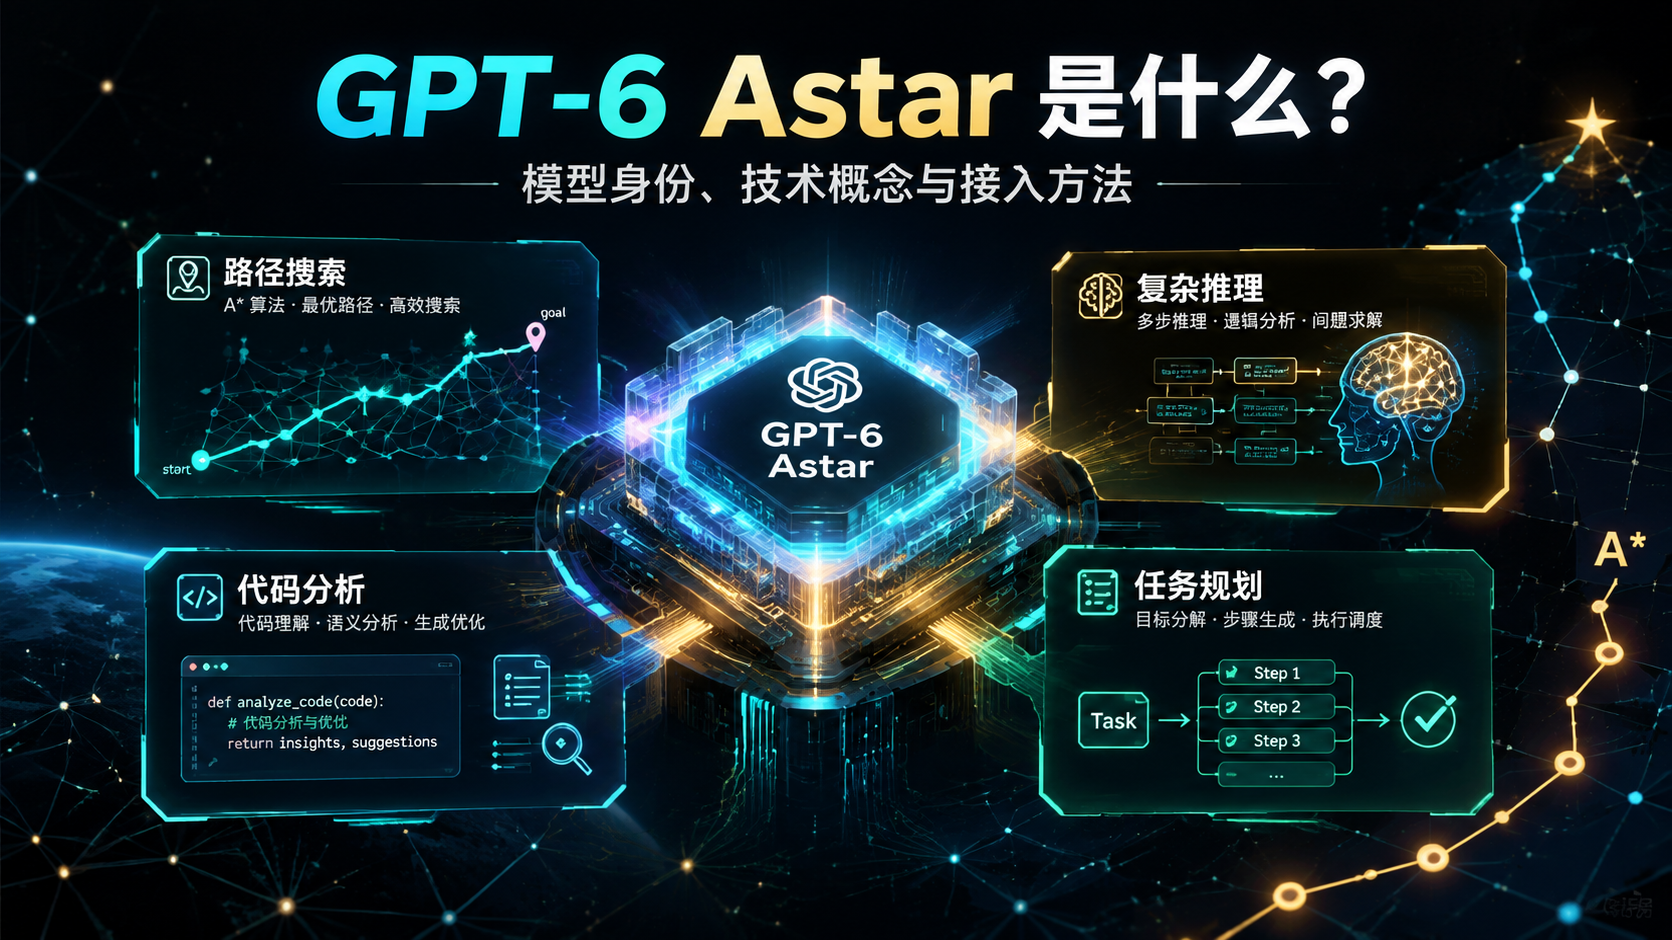
 最近,部分 AI 用户开始关注一个名为
gpt-6-astar 的模型标识。
从名称来看,它似乎同时包含了"GPT-6"和"Astar"两个关键词,很容易让人联想到 OpenAI 的下一代模型,以及计算机科学中的 A* 搜索算法。
但在讨论它的能力之前,需要先明确一个重要问题:
在缺少官方公告、模型卡片和开发者文档的情况下,不能仅凭
gpt-6-astar这一名称,就认定它是 OpenAI 正式发布的 GPT-6 型号。
AI 模型的名称可能来自官方,也可能是第三方平台为了路由、测试或展示而设置的标识。本文不对尚未确认的性能和参数作推测,而是从模型命名、Astar 的技术含义和实际接入三个方面,帮助新手正确理解这一名称。
一、gpt-6-astar 一定是 GPT-6 吗?
不一定。
用户在 AI 客户端、接口列表或模型中转平台中看到的名称,可能来自以下几种情况:
- 官方模型 ID
由模型提供方公开,并能在官方文档、API 文档或模型列表中查询。
- 第三方平台别名
平台为了便于用户识别模型,对底层模型设置了更直观的展示名称。
- 模型路由名称
一个名称背后可能不是固定模型,而是根据任务、负载或成本动态选择底层模型。
- 内部测试标识
部分名称可能用于灰度测试、兼容性测试或临时实验,并不代表正式产品。
- 聚合或工作流名称
某些平台会把"模型 + 搜索 + 推理 + 工具调用"组合成一项能力,再使用一个新的名称对外展示。
因此,判断 gpt-6-astar 的身份,至少需要核对:
模型由谁提供
是否有官方公告
是否存在官方模型卡片
API 返回的模型 ID 是什么
是否为固定模型或动态路由
上下文、价格和能力说明来自哪里
如果这些信息暂时无法确认,文章中更合适的说法是"模型标识""平台提供的型号"或"待核验模型",而不是"OpenAI 正式发布的 GPT-6"。
二、Astar 是什么意思?
Astar 通常是 A* 的文字写法。
A* 是计算机科学中经典的启发式搜索算法,常用于路径规划、图搜索、游戏 AI 和机器人导航。
它会同时考虑两部分成本:
f(n) = g(n) + h(n)其中:
g(n)表示从起点到当前节点的实际成本h(n)表示从当前节点到目标的预估成本f(n)用于评估哪条路径更值得继续搜索
与盲目尝试所有路径相比,A* 会利用启发式信息,优先探索更有可能到达目标的方向。
如果把这一思路类比到 AI Agent,可以理解为:
明确任务目标
 lenecek
评估多个执行方案
选择更可能成功的路径
执行并观察结果
根据新信息调整计划
不过,这只能用于帮助理解"Astar"这个名称。
*除非模型提供方明确说明,否则不能据此判断 gpt-6-astar 内部真的采用了 A 算法。** 产品名称、项目代号和实际技术实现并不是一回事。
三、它可能与推理模型有什么关系?
从命名方式看,Astar 容易让人联想到规划、搜索和推理能力。
现代推理模型在处理复杂任务时,可能会涉及:
- 拆分问题
- 比较候选方案
- 调用外部工具
- 检查中间结果
- 修正错误路径
- 生成最终答案
这些过程与搜索算法在概念上存在相似之处,但不能简单画等号。
一个模型表现出较好的规划能力,并不代表它一定在运行传统 A* 算法。大语言模型、外部 Agent 框架和搜索程序也可能共同组成完整系统:
用户任务
  ↓
大模型理解目标
  ↓
Agent 生成候选步骤
  ↓
搜索或规划模块选择路径
  ↓
工具执行
  ↓
模型检查结果所以,gpt-6-astar 也可能代表一种组合式服务,而非单一基础模型。最终应以服务提供方的技术文档为准。
四、普通用户应该关注什么?
对于普通用户来说,模型名称是否新颖并不是最重要的。真正值得关注的是它能否完成实际任务。
可以从以下几个方面进行测试:
1. 复杂指令理解
给模型一个包含多项要求的任务,检查它是否遗漏条件。
请将这篇文章整理成摘要和提纲,
保留所有关键数据,并将不确定的信息单独列出。
2. 推理与规划
提供一个需要多个步骤的问题,检查它能否给出合理的处理顺序。
3. 代码能力
让模型分析真实报错,而不是只生成简单示例代码。
4. 结构化输出
要求输出 JSON 或固定字段,检查格式是否稳定。
5. 事实准确性
对涉及版本、价格、人物和日期的信息,使用官方来源进行核验。
6. 响应速度与成本
记录完成同一项任务所需的时间、Token 和调用次数。
一个模型即使单次价格较低,如果需要多次重试,实际使用成本也未必更低。
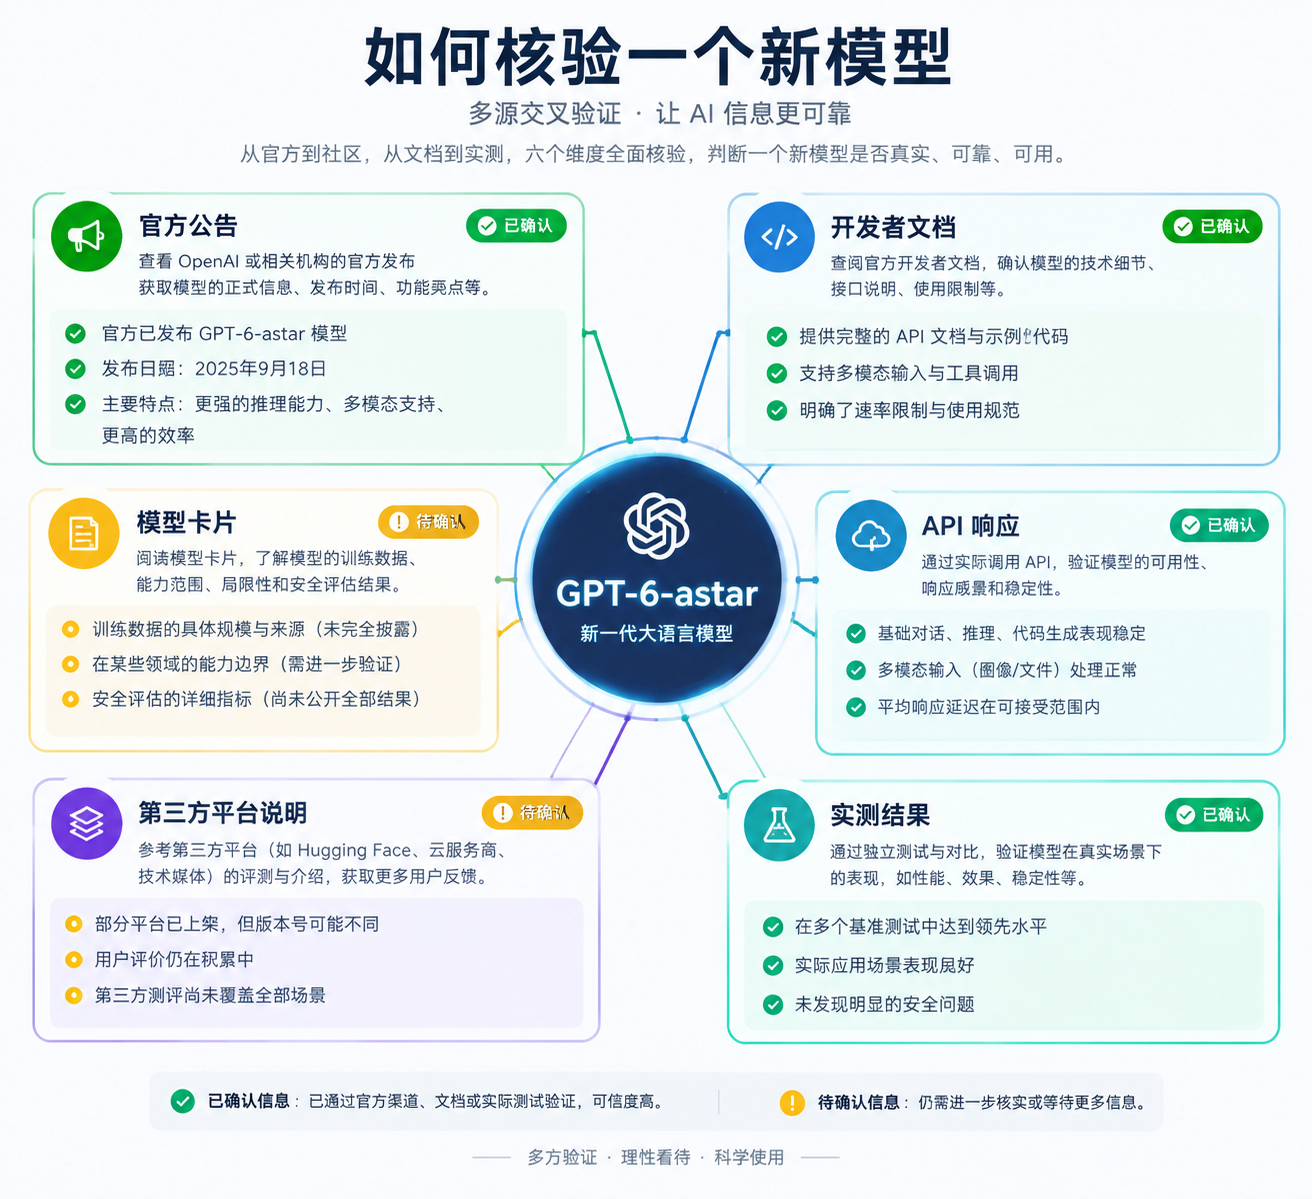
五、如何确认它是不是官方模型?
可以按下面的顺序进行核验:
第一步:查找 OpenAI 官方公告
第二步:检查官方开发者文档和模型列表
第三步:查看接口实际返回的 model 字段
第四步:查询第三方平台的模型说明
第五步:确认模型是否为固定映射
第六步:使用标准测试集验证实际表现
还要特别区分以下三种表述:
"平台显示名称为 gpt-6-astar"
"平台称其接入 GPT-6 Astar"
"OpenAI 官方发布 GPT-6 Astar"
这三句话的证据要求完全不同。
如果只有第三方平台模型列表,最多只能确认该平台提供了这个名称,不能自动推导出它是 OpenAI 官方型号。
六、如何通过 API 测试 gpt-6-astar?
如果模型服务支持 OpenAI 兼容接口,通常需要配置:
API Key
Base URL
模型名称
请求形式可能类似:
{
  "model": "gpt-6-astar",
  "messages": [
    {
      "role": "user",
      "content": "请简要解释 A* 搜索算法的基本原理。"
    }
  ]
}
上面只是通用格式示例,不能证明该模型名称在任意平台都有效。
如果希望在 Codex、代码编辑器或自动化脚本中测试,可以通过统一模型入口减少重复配置。例如,在 https://transitai.chat/ 提供的模型列表中确认存在对应型号后,再按照其接口文档填写 API Key、Base URL 和模型名称。
测试时建议记录:
| 项目 | 需要记录的内容 |
|---|---|
| 模型标识 | 请求和响应中的模型名称 |
| 任务结果 | 是否正确完成要求 |
| 响应时间 | 首次响应与完整输出耗时 |
| Token | 输入、输出及其他计费项 |
| 格式稳定性 | JSON、工具参数是否有效 |
| 错误信息 | 超时、限流或不兼容情况 |
| 实际费用 | 单次任务的最终成本 |
需要强调的是,模型中转站解决的是接口接入和模型调用问题。模型的官方身份、底层来源及实际能力,仍应通过平台文档、官方资料和标准化测试确认。
七、适合用什么题目进行测试?
新手可以准备三类任务。
基础知识任务
请用普通用户能理解的语言解释 A* 搜索算法,
并给出一个地图导航中的例子。
复杂规划任务
一个项目需要在 7 天内完成登录、权限和日志模块。
请分析依赖关系,安排开发顺序,并列出主要风险。
代码排错任务
请根据下面的代码、依赖版本和错误日志定位问题。
将结论分成"已经确认""合理推测"和"仍需检查"三类。
同一组任务可以同时交给多个模型,然后对比准确性、完整性、速度和成本。不要仅根据模型自己声称的身份或能力得出结论。
八、使用新模型标识时要注意什么?
不要把名称当成能力证明
名称中出现 GPT-6、Reasoning 或 Astar,不等于它一定具备对应能力。
不要根据模型回答确认自身身份
询问模型"你是不是 GPT-6",它给出的回答不能作为有效证据。模型可能根据提示词或上下文生成错误描述。
不要直接提交敏感数据
测试来源不明或信息不完整的模型时,不要上传:
- API 密钥
- 客户资料
- 未公开合同
- 企业核心代码
- 生产数据库
- 个人身份信息
不要编造性能参数
如果没有公开资料,不应自行填写上下文长度、训练规模、基准成绩和价格。
区分实测和官方结论
个人测试结果应明确标记测试环境、时间、提示词和样本数量,不能直接写成普遍结论。
九、写在最后
gpt-6-astar 是一个值得关注的模型标识,但名称本身不足以证明它是 OpenAI 正式发布的 GPT-6 型号,也不足以判断其底层使用了 A* 搜索算法。
现阶段更严谨的理解方式是:
GPT-6:可能指向模型代际或平台命名
Astar:可能是版本名、能力标签或路由名称
实际身份:需要官方资料和平台文档确认
实际能力:需要标准化任务测试
对于普通用户来说,不必只追逐版本号,更应该关注模型在写作、编程、推理和资料分析中的实际表现。
对于开发者来说,可以通过统一接口对多个模型进行相同条件下的测试。https://transitai.chat/ 可以作为模型接入入口之一,但使用 gpt-6-astar 前,应先在站内模型列表和接口文档中核对准确名称、计费方式与能力支持。
AI 行业更新很快,新名称也会不断出现。面对任何新模型,专业、可靠的判断方式始终是:
先确认来源,再核对文档,最后用真实任务验证。