Python 实战指南(7)------账本动不动就崩?先把"魔法字符串"和"裸报错"干掉
凌晨 2:40,你的记账本第 13 次崩了。不是崩在复杂的统计逻辑上,而是崩在一个你闭着眼都能打对的单词上------你手滑把 "expense" 打成了 "expensee",程序一脸懵地告诉你 ValueError: 'expensee' is not a valid RecordKind。你盯着这行报错看了三分钟:什么叫"不是有效的 RecordKind"?RecordKind 是个啥?为什么我昨天还能跑?
再看另一个更阴间的场景:你给程序喂了一笔金额为 -50 的账,它不崩,它默默地把你的余额减了 50。你查了半小时,最后发现是 __post_init__ 里那行校验压根没触发------因为数据是从 JSON 直接塞进去的,绕过了构造函数。这种错误不报错,比报错可怕一百倍。
这一篇,我们把记账本升级到 v0.7,干两件事:
- 用
enum枚举消灭魔法字符串 。"income"/"expense"这种裸字符串,从今天起全部换成RecordKind.INCOME/RecordKind.EXPENSE。打错字?Python 直接不让你跑。 - 用自定义异常建立"报错体系" 。
raise ValueError("金额不对")这种裸抛,换成一套LedgerError家族异常,每个异常自带上下文------哪笔账、哪个字段、原始值是什么,一眼看清。
同时你会学到 Python 3.11 之后的两个新武器:StrEnum(字符串枚举)和 ExceptionGroup(异常组)+ except*(批量捕获)。前者让你的枚举直接当字符串用,后者让你一次把所有数据错误报全,而不是挤牙膏一样一次报一个。
老规矩:人话讲概念 → 代码演示 → 实测验证 → 三个真坑。全程 Python 3.12,零第三方库,复制即跑。
1. 痛点回顾:你的账本还在用"裸字符串 + 裸异常"
先回到 v0.6。我们的 Record 类长这样(节选):
python
@dataclass(frozen=True, slots=True)
class Record:
    item: str
    amount: int
    date: str
    kind: str = "record"   # <- 裸字符串!
kind 是一个普通字符串,取值全靠"约定":收入写 "income",支出写 "expense"。问题来了:
问题 1:打错字不报错。 "incomee" 也是合法字符串,Python 不会拦你。但你的业务逻辑里 if r.kind == "income" 就永远为 False,这笔账被当成"既不是收入也不是支出",统计结果直接错。
问题 2:魔法值满天飞。 "income"、"expense" 散落在 models.py、stats.py、main.py、storage.py 四个文件里。哪天你想把 "income" 改成 "in"(省字节),得全文搜索替换,漏一个就埋雷。
问题 3:报错信息没人看得懂。 raise ValueError("金额不对")------哪个金额?什么不对?用户看到这个只能抓瞎。测试工程师看到这个更抓狂:报错里没有任何可编程提取的信息,想写断言都没处下手。
我们把这些问题量化成一张表:
| 现状 | 后果 | v0.7 方案 |
|---|---|---|
| kind 是裸字符串 | 打错字静默出错 | 用 RecordKind 枚举,写错直接报错 |
| 魔法值散落四处 | 改一个值要全文替换 | 枚举是单一定义源 |
| 校验失败抛 ValueError | 报错没有上下文 | 自定义 AmountError / DateError 携带原始值 |
| 用户看到裸 traceback | 完全看不懂 | main.py 统一 except LedgerError 给中文提示 |
记住这张表,它就是我们今天要解决的问题清单。
2. 枚举是啥?人话版
2.1 一个直觉类比
想象你是一家餐厅的厨师。菜单上有四道菜:宫保鸡丁、鱼香肉丝、麻婆豆腐、酸辣土豆丝。
你可以用数字 1、2、3、4 来编号它们,也可以写全名。但问题来了:
- 如果只靠记忆,"3 号桌点 2"------"2" 到底是鱼香肉丝还是麻婆豆腐?数字没有意义。
- 如果写全名,容易打错字,一打错厨房就不知道做什么。
- 如果哪天菜单改了,把鱼香肉丝从 2 号挪到 5 号,所有写着 2 的旧订单全错。
而枚举解决的就是这个问题:给"概念"起一个固定的、有名字的、防呆的标签。 概念是"鱼香肉丝",不管它内部编码是 2 还是 5,你引用的是 Menu.FISH_FRAGRANT_PORK,永远不会错。
映射到记账本:账目的"概念"是"收入"和"支出",内部存储可以是 "income" / "expense" 字符串。你用 RecordKind.INCOME 来引用"收入"这个概念 ,而不是直接写 "income" 这个值。
2.2 定义枚举
Python 的 enum 模块从 3.4 起就是标准库。定义一个枚举:
python
from enum import Enum

class Color(Enum):
    RED = 1
    GREEN = 2
    BLUE = 3
成员 Color.RED、Color.GREEN、Color.BLUE。它们:
- 名字是
RED,值是1。 - 是唯一的 :
Color(1)一定返回Color.RED,绝不可能是别的。 - 可以迭代 :
list(Color)给出[Color.RED, Color.GREEN, Color.BLUE]。 - 可以比较 :
Color.RED == Color.RED是True,Color.RED == Color.GREEN是False,Color.RED == 1是False(除非用IntEnum)。
在 Enum 的世界里,Color.RED 是一个对象,不是数字。你可以给它加方法、加属性,它就是一个完整的类。
2.3 记账本里最朴素的应用
回到记账本。我们定义:
python
from enum import Enum

class RecordKind(Enum):
    INCOME = "income"
    EXPENSE = "expense"
现在 RecordKind.INCOME 这个对象,就代表了"收入"这个概念 。你永远不用担心打错字,因为 RecordKind.INCOME 打错(比如 RecordKind.INCMOE)会直接 AttributeError------import 阶段就崩,而不是运行时静默错。
更重要的是,"income" 这个魔法字符串只在一处定义 :RecordKind 枚举里。其他地方全都用 RecordKind.INCOME,想改值只改一处。
3. 枚举的进阶玩法
3.1 迭代:拿到所有成员
python
for k in RecordKind:
    print(k.name, k.value)
输出:
text
INCOME income
EXPENSE expense
这在生成菜单、渲染报表时特别好用------你不用再手写一份列表。比如 main.py 里:
python
# 自动生成"收入/支出"选项
for k in RecordKind:
    print(k.value)
以后新增一个 TRANSFER = "transfer",菜单自动多一行,不用改任何循环。
3.2 按值构造 & 按名索引
enum 给了你两种从外部"拿成员"的方式:
python
RecordKind("income")        # 按值构造 -> RecordKind.INCOME
RecordKind["EXPENSE"]       # 按名索引 -> RecordKind.EXPENSE
按值构造特别有用:你从 JSON 里读到 "income",直接 RecordKind("income") 就能还原成枚举成员。如果值不合法(比如 "incomee"),会抛 ValueError。
实测(本机 Python 3.12):
python
RecordKind("income") is RecordKind.INCOME      # True
RecordKind["EXPENSE"] is RecordKind.EXPENSE     # True
RecordKind("xxx")                                # ValueError
3.3 给枚举加方法
枚举是类,所以可以加方法。v0.7 里我们给 RecordKind 加一个"宽容版构造器",兼容传入成员或字符串:
python
class RecordKind(Enum):
    INCOME = "income"
    EXPENSE = "expense"

    @classmethod
    def from_any(cls, value):
        """传成员或字符串都能转成枚举成员。"""
        if isinstance(value, cls):
            return value
        return cls(value)
用法:
python
RecordKind.from_any("income")           # RecordKind.INCOME
RecordKind.from_any(RecordKind.EXPENSE)  # RecordKind.EXPENSE(原样返回)
这在迁移期(你的代码既有旧字符串调用、又有新枚举调用)特别顺手,不用改调用方的写法。
3.4 自定义属性和方法:让枚举会"说人话"
枚举成员还可以拥有属性。v0.7 里我们给支出分类加了"预算提示":
python
class Category(Enum):
    FOOD = "餐饮"
    TRANSPORT = "交通"
    SHOPPING = "购物"
    HOUSING = "居住"
    OTHER = "其他"

    @property
    def monthly_hint(self):
        """每个分类给个预算建议(纯演示)。"""
        return {
            Category.FOOD: "建议月预算 2000",
            Category.TRANSPORT: "建议月预算 500",
            Category.SHOPPING: "建议月预算 1000",
            Category.HOUSING: "建议月预算 3000",
            Category.OTHER: "建议月预算 500",
        }[self]
调用:
python
Category.FOOD.monthly_hint # '建议月预算 2000'注意:@property 在 Enum 里默认是被禁的(为了防止和成员名冲突),需要 member() / nonmember() 等装饰器配合。但 Python 3.11+ 之后放宽了。先不用纠结,后面坑里我会给你演示踩坑现场。
4. 常量、元组、字典、枚举:该用哪个?
4.1 先看一段常见代码
python
KIND_INCOME = "income"
KIND_EXPENSE = "expense"

# 或
KINDS = ("income", "expense")

# 或
KIND_MAP = {"income": "收入", "expense": "支出"}
这些都是合法的。那为什么要用 Enum?我们做个对比:
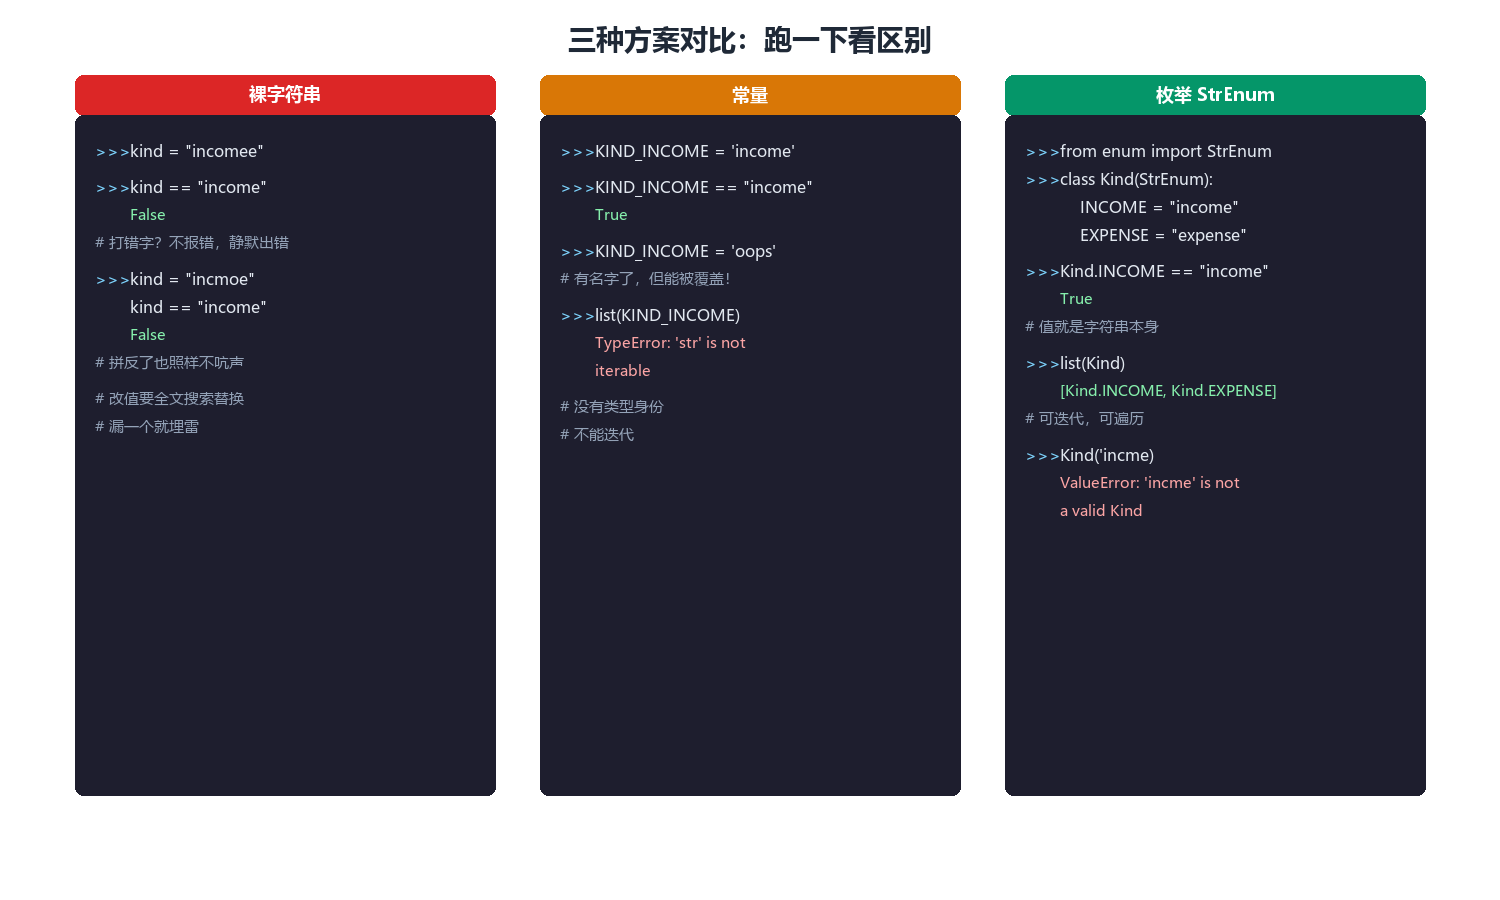
| 方案 | 可防呆(拼写) | 可迭代 | 可比较 | 单一来源 | 可序列化 | 可加方法 |
|---|---|---|---|---|---|---|
| 裸字符串 | 无 | 无 | 有(值比较) | 无 | 有 | 无 |
| 常量 | 无 | 无 | 有 | 有 | 有 | 无 |
| 元组 | 无 | 有 | 无 | 有 | 有 | 无 |
| 字典 | 无 | 有 | 无 | 有 | 有 | 无 |
| Enum | 有 | 有 | 有 | 有 | 需 .value |
有 |
| StrEnum | 有 | 有 | 有 | 有 | 直接 | 有 |
结论 :当你有"一组固定的、互斥的概念",并且要防呆、要迭代、要加行为时,用 Enum/StrEnum 是最稳的。
4.2 什么时候不该用枚举?
枚举不是银弹。别为所有东西都用枚举:
- 值是动态的(比如用户名、价格)------不是枚举。
- 只有两个值且从不变更 (布尔值)------用
bool就行,别绕。 - 需要自由组合的标签 (比如一篇博客可以有多个标签)------用
set/frozenset,或Flag(后面讲)。 - 和外部系统交换,值完全不在你掌控------用常量 + 文档,别硬塞枚举。
一句话总结:枚举适合"小而稳定"的选项集合;值多、动态、可变时,别硬上。
4.3 一段代码看懂差别
同样实现"根据 kind 判断是收入还是支出",三种写法放在一起对比:
python
# 写法 1:裸字符串(v0.6 的做法)
if record.kind == "income":     # 打成 "incom" 就静默出错
    total += record.amount

# 写法 2:常量
KIND_INCOME = "income"
if record.kind == KIND_INCOME:  # 好一点,但 KIND_INCOME 可以被重新赋值
    total += record.amount

# 写法 3:枚举(v0.7 的做法)
if record.kind_enum == RecordKind.INCOME:  # 打错枚举名 import 阶段就崩
    total += record.amount
写法 1 和写法 2 的区别是"有没有给值起名字"。写法 2 和写法 3 的区别是"这个名字有没有被 Python 保护"。枚举成员不可变、不可覆盖、有类型身份------这就是它比常量多出来的安全感。
5. StrEnum:让枚举直接当字符串用
5.1 痛点:Enum 的成员不是字符串
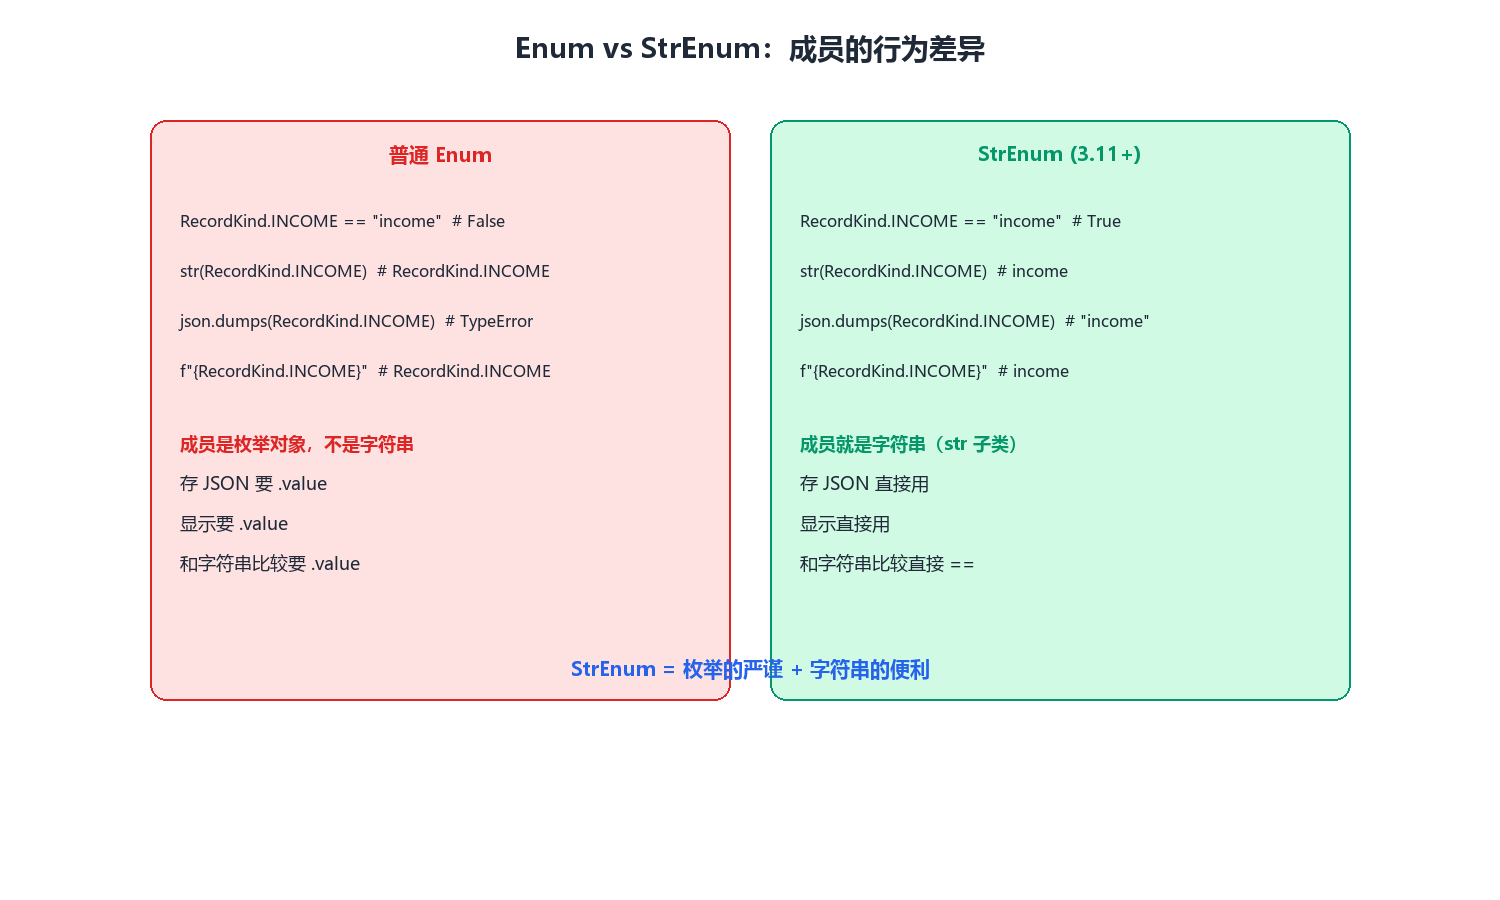
用普通 Enum 定义 RecordKind.INCOME = "income",问题来了:
python
RecordKind.INCOME == "income"     # False !?
str(RecordKind.INCOME)             # 'RecordKind.INCOME'(难看)
json.dumps(RecordKind.INCOME)      # 报错:TypeError: Object of type RecordKind is not JSON serializable
明明值是 "income",但 == 不相等、str() 输出也不好看、JSON 序列化直接炸。因为 Enum 成员是枚举类型,不是它的值类型。
我们记账本里 kind 是要存进 JSON 的,"income" 必须能原样存进去读出来。用普通 Enum 就得到处 k.value,烦死了。
5.2 StrEnum 闪亮登场
Python 3.11 引入 StrEnum,专门解决这个痛点:枚举成员本身就是 str 的子类。
python
from enum import StrEnum

class RecordKind(StrEnum):
    INCOME = "income"
    EXPENSE = "expense"
实测(本机 Python 3.12):
python
RecordKind.INCOME == "income"       # True
isinstance(RecordKind.INCOME, str)  # True
f"{RecordKind.EXPENSE}"            # 'expense'
json.dumps([RecordKind.INCOME]) # '["income"]'一个词总结:StrEnum 把"枚举的严谨"和"字符串的便利"焊在了一起。 旧数据(JSON 里存的 "income")读出来就是 RecordKind.INCOME,反之 RecordKind.INCOME 也能直接写进 JSON。
这就是 v0.7 用 StrEnum 而不是 Enum 的决定性理由:向后兼容,零迁移成本。
5.3 StrEnum 与 Enum / IntEnum 怎么选?
| 基类 | 成员是 | 适用场景 |
|---|---|---|
Enum |
枚举对象 | 纯概念枚举,不和值类型交互 |
IntEnum |
int 子类 |
状态码、等级、要与数字运算 |
StrEnum |
str 子类(3.11+) |
值本身是字符串,要存 JSON / 显示 |
注意:
IntEnum3.4+,StrEnum3.11+。如果你的项目还在 Python 3.10,只能用Enum+ 手动.value。
5.4 auto():让枚举自动编号
如果成员的值你不在乎具体数字(只要唯一),用 auto():
python
from enum import auto

class Priority(Enum):
    LOW = auto()      # 1
    MEDIUM = auto()   # 2
    HIGH = auto()     # 3
auto() 会自动递增。StrEnum 也可以配 auto()(值自动生成成员的 name 小写形式)。但注意 :auto() 生成的值不可控,如果你的值要写进 JSON、要给别人看,还是显式给值更稳。
5.5 IntEnum 和 Flag:不只用字符串的场景
记账本用 StrEnum,但你做 Web 开发时会遇到其他场景:
IntEnum :成员是 int 子类,可以直接和数字运算:
python
from enum import IntEnum

class HttpStatus(IntEnum):
    OK = 200
    NOT_FOUND = 404
    SERVER_ERROR = 500

code = HttpStatus.NOT_FOUND
if code >= 400:
    print(f"出错了:{code}")   # 出错了:404
Flag 和 IntFlag:支持位运算(组合权限):
python
from enum import IntFlag

class Permission(IntFlag):
    READ = 1
    WRITE = 2
    EXECUTE = 4

# 组合权限
rw = Permission.READ | Permission.WRITE     # Permission.READ|WRITE
print(Permission.READ in rw)                 # True
print(Permission.EXECUTE in rw)              # False
IntFlag 特别适合权限系统:一个用户可以有多个权限,用位运算组合。Permission.READ | Permission.WRITE 表示"可读可写",检查时用 in 运算符。
记住 :记账本用 StrEnum(值要存 JSON),权限系统用 IntFlag(要位运算组合),状态码用 IntEnum(要和数字比)。选哪个基类,取决于你的值要和什么类型交互。
6. 实战一:把 Record.kind 换成枚举
6.1 不动 JSON,只动内存
我们的目标是:JSON 里存 "income",内存里用 RecordKind.INCOME。 这样:
- 旧数据(v0.6 存的
"income")读进来,自动变成RecordKind.INCOME; - 新数据写出去,
RecordKind.INCOME自动变回"income"; - 用户的 JSON 文件一行都不用改。
实现分三步:模型里加 kind_enum 属性、存储层读旧数据时转换、菜单用枚举驱动。
6.2 Record 加 kind_enum 属性
Record 的 kind 字段为了兼容旧数据,底层仍然是字符串 (存 "income"),但暴露一个 kind_enum 属性转成枚举:
python
class Record:
    # ...(dataclass 字段不变)

    @property
    def kind_enum(self):
        """把字符串 kind 转成枚举成员。"""
        return RecordKind(self.kind)
这样业务代码里写 r.kind_enum == RecordKind.INCOME,既优雅又不破坏存储格式。
6.3 存储层:旧数据自动补
storage.py 的 _normalize 里,从 JSON 读出来的 dict 转 Record 时,kind 字段照原样读("income" / "expense"),不需要 任何转换------因为 RecordKind 的值就是这两个字符串,天然兼容。v0.7 只需要给 Record 加一个 category 字段(默认空串),旧数据没有这个键就用默认值:
python
@classmethod
def from_dict(cls, d):
    """从 dict 构造(兼容 v0.6 没有 category 的旧数据)。"""
    return cls(
        item=d["item"],
        amount=int(d["amount"]),
        date=d.get("date", ""),
        kind=d.get("kind", "record"),
        category=d.get("category", ""),   # 新增:旧数据没有就给空串
    )
实测(本机):
python
old = {"item": "工资", "amount": "8000", "date": "2026-09-01", "kind": "income"}
r = Record.from_dict(old)
r.kind_enum         # RecordKind.INCOME
r.category          # ''(旧数据自动补空)
零迁移,直接读旧账本。
6.4 菜单层:枚举驱动
main.py 里,cmd_add 接收一个 RecordKind 成员,而不是字符串参数:
python
def cmd_add(kind: RecordKind):
    """新增一笔账。kind 是 RecordKind 枚举。"""
    item = input("名称: ").strip()
    amount = int(input("金额(整数): ").strip())
    date = input("日期(YYYY-MM-DD): ").strip()
    cat = ""
    if kind == RecordKind.EXPENSE:
        print("分类:" + " / ".join(c.value for c in Category))
        cat = input("分类(回车=其他): ").strip() or Category.OTHER.value
    with Storage() as store:
        if kind == RecordKind.INCOME:
            rec = IncomeRecord(item, amount, date, category=cat)
        else:
            rec = ExpenseRecord(item, amount, date, category=cat)
        store.data[kind.value].append(rec)
    print(f"已记录:{rec}")
关键点:
kind == RecordKind.EXPENSE是枚举比较 ,不是字符串比较。打错枚举名(RecordKind.EXPNESE)会在 import 时直接AttributeError。store.data[kind.value]用.value拿原始字符串作为 dict 的 key------完美衔接存储层。Category.OTHER.value同样取字符串"其他"。
你看,枚举把"概念"和"实现"分离了 :业务代码只想"是收入还是支出",存储层只想"字符串是什么"。中间靠 .value 转换。
6.5 顺手:把枚举应用到统计
stats.py 的 by_kind 接受 RecordKind:
python
def by_kind(self, kind: RecordKind):
    """按 RecordKind 过滤记录。"""
    return [r for r in self if r.kind == kind.value]
测试里我们验证:
python
inc = ledger.by_kind(RecordKind.INCOME)
assert len(inc) == 1
assert inc[0].item == "工资"
一切干净利落。
6.6 测试先行:TDD 里枚举怎么测
这一篇已经给了你一个"测试驱动"的味儿:我们先写了 26 个测试,再回头确保实现。枚举相关测试长这样:
python
def test_value_is_str(self):
    assert RecordKind.INCOME == "income"
    assert RecordKind.EXPENSE == "expense"

def test_member_iteration(self):
    members = list(RecordKind)
    assert members == [RecordKind.INCOME, RecordKind.EXPENSE]

def test_constructor_by_value(self):
    assert RecordKind("income") is RecordKind.INCOME

def test_index_by_name(self):
    assert RecordKind["EXPENSE"] is RecordKind.EXPENSE

def test_invalid_value_raises_valueerror(self):
    with pytest.raises(ValueError):
        RecordKind("unknown")
为什么这样写测试? 因为枚举是"契约":定义了你所有合法的取值。测试把这个契约锁死,以后谁把 "income" 改成 "in",测试立刻红。这就是测试工程师视角------枚举也是需要测试保证的 API。
6.7 从 v0.6 到 v0.7:迁移策略
你可能担心:"我的项目里到处都是 "income" 字符串,怎么迁移到枚举?" 真实项目迁移不是一晚上 find-and-replace,而是分三步走:
第一步:定义枚举,不改旧代码。
先在 enums.py 里定义 RecordKind,但不碰任何现有文件。枚举的值和旧字符串完全一样("income" / "expense"),确保两边 == 能过。
python
# enums.py(新文件,不动旧代码)
class RecordKind(StrEnum):
    INCOME = "income"
    EXPENSE = "expense"
第二步:新代码用枚举,旧代码不动。
新写的函数、新加的模块用 RecordKind.INCOME。旧代码保持原样------"income" 字符串和 RecordKind.INCOME 因为 StrEnum 天然 ==,两边混用不出错。
python
# 新代码
def new_func(kind: RecordKind):
    ...

# 旧代码(不动)
def old_func(kind: str):
    ...
第三步:逐步替换旧代码。
有空就翻一个文件,把 "income" 替换成 RecordKind.INCOME。每替换一个文件,跑一遍测试。测试全绿就提交,不绿就回退。举个例子片段:
python
# 替换前
if r.kind == "income":
    total += r.amount

# 替换后
if r.kind_enum == RecordKind.INCOME:
    total += r.amount
关键原则 :枚举的值必须和旧字符串完全一致,这样迁移期两边混用不会出问题。如果你要改值(比如 "income" 改成 "in"),那是另一个独立步骤,等迁移完了再做。 别同时做两件事,出了问题不知道是哪个改动导致的。
7. 异常体系:Python 的"报错地图"
7.1 异常不是"出错了",是"告诉你出了什么错"
很多人怕异常,因为看到红色 traceback 就觉得"我代码崩了"。换个角度理解:异常是 Python 在跟你说"嘿,这地方有个问题,我帮你拦住了,你来看看怎么办"。 没有异常的语言才可怕------出了问题静默继续,数据悄悄写坏,你查三天都查不到。
Python 的异常体系是一棵树。所有异常都继承自 BaseException。但你要记住一条铁律:业务异常一律继承 Exception,绝不继承 BaseException。
text
BaseException
├── SystemExit         # sys.exit() 触发
├── KeyboardInterrupt  # Ctrl+C 触发
├── GeneratorExit      # 生成器关闭
└── Exception          # <- 你只需要关心这一支
    ├── StopIteration
    ├── ArithmeticError
    │   └── ZeroDivisionError
    ├── LookupError
    │   ├── IndexError
    │   └── KeyError
    ├── ValueError
    ├── TypeError
    ├── OSError
    │   ├── FileNotFoundError
    │   ├── PermissionError
    │   └── ...
    └── ...(你的自定义异常放这里)
为什么绝不继承 BaseException?因为 except BaseException 会把 SystemExit、KeyboardInterrupt 也一起吞掉。用户按 Ctrl+C 想退出,结果被你静默吞掉,程序卡死。这种事你一定遇到过------某个程序 Ctrl+C 怎么都退不出,就是有人写了 except BaseException。
7.2 异常的生命周期
一段代码出了异常,它会沿着调用栈向上冒泡 ,直到被某个 except 接住。如果一直没人接,最终到达 Python 解释器顶层,打印 traceback 并退出。
python
def a():
    raise ValueError("boom")    # 3. 在这里抛出

def b():
    a()                          # 2. 调用 a

def c():
    try:
        b()                      # 1. 调用 b
    except ValueError as e:
print("接住了:", e) # 4. 在这里接住理解这一点很重要:你不需要在每个函数里都 try/except。 异常会自动向上传。你只需要在"能处理它的层级"接住就行------通常是用户界面层(main.py)或 API 边界层。
7.3 常见内置异常速查
你写 Python 每天都会遇到的几个内置异常,先混个脸熟:
| 异常 | 什么时候触发 | 你该怎么处理 |
|---|---|---|
ValueError |
值的类型对但内容不对(int("abc")) |
校验输入,给用户友好提示 |
TypeError |
类型不对("a" + 1) |
检查参数类型,或用 isinstance 预判 |
IndexError |
列表索引越界([10] 但只有 3 个元素) |
先检查 len(),或用 try/except |
KeyError |
字典键不存在(d["missing"]) |
用 d.get("missing", default) |
FileNotFoundError |
文件不存在 | 创建文件,或提示用户选择路径 |
ZeroDivisionError |
除以零 | 先检查除数 |
AttributeError |
对象没有这个属性 | 检查拼写,或用 hasattr() |
记住一个原则 :能预判的就预判(if len(lst) > 0),不方便预判的才 try/except。两种风格都合法,但预判比 try/except 更显式------读代码的人能直接看到你在防什么。try/except 适合"预判成本太高"或"异常本身就是正常流程"的场景(比如迭代器用 StopIteration 通知结束)。
7.4 try/except/else/finally 完整语义
你可能只见过 try/except。完整家族是四个:
python
try:
    risky()                 # 1. 尝试执行
except SomeError as e:      # 2. 捕获(可以有多个 except)
    handle(e)
else:
    no_error()              # 3. 没有异常才执行
finally:
cleanup() # 4. 无论如何都执行| 块 | 执行条件 |
|---|---|
try |
总是尝试执行 |
except |
try 里抛了匹配的异常 |
else |
try 里没有抛异常 |
finally |
无论如何都执行(异常被接住、没被接住、正常返回都算) |
else 常被忽略,但它很干净:else 里的代码只在没有异常时跑 ,比在 try 末尾直接写更清晰。因为如果你写在 try 末尾,这段代码的异常也会被上面的 except 误接,行为就混了。
finally 保证"清理动作一定执行"。我们 v0.6 的 Storage.__exit__ 就是 finally 的化身------with 语句退出时无论如何都调 __exit__。
实测(本机 Python 3.12):
python
def demo(flag):
    try:
        if flag:
            raise ValueError("boom")
        result = "ok"
    except ValueError:
        result = "caught"
    else:
        result += "_else"
    finally:
        print(f"finally: {result}")

demo(True)   # finally: caught
demo(False)  # finally: ok_else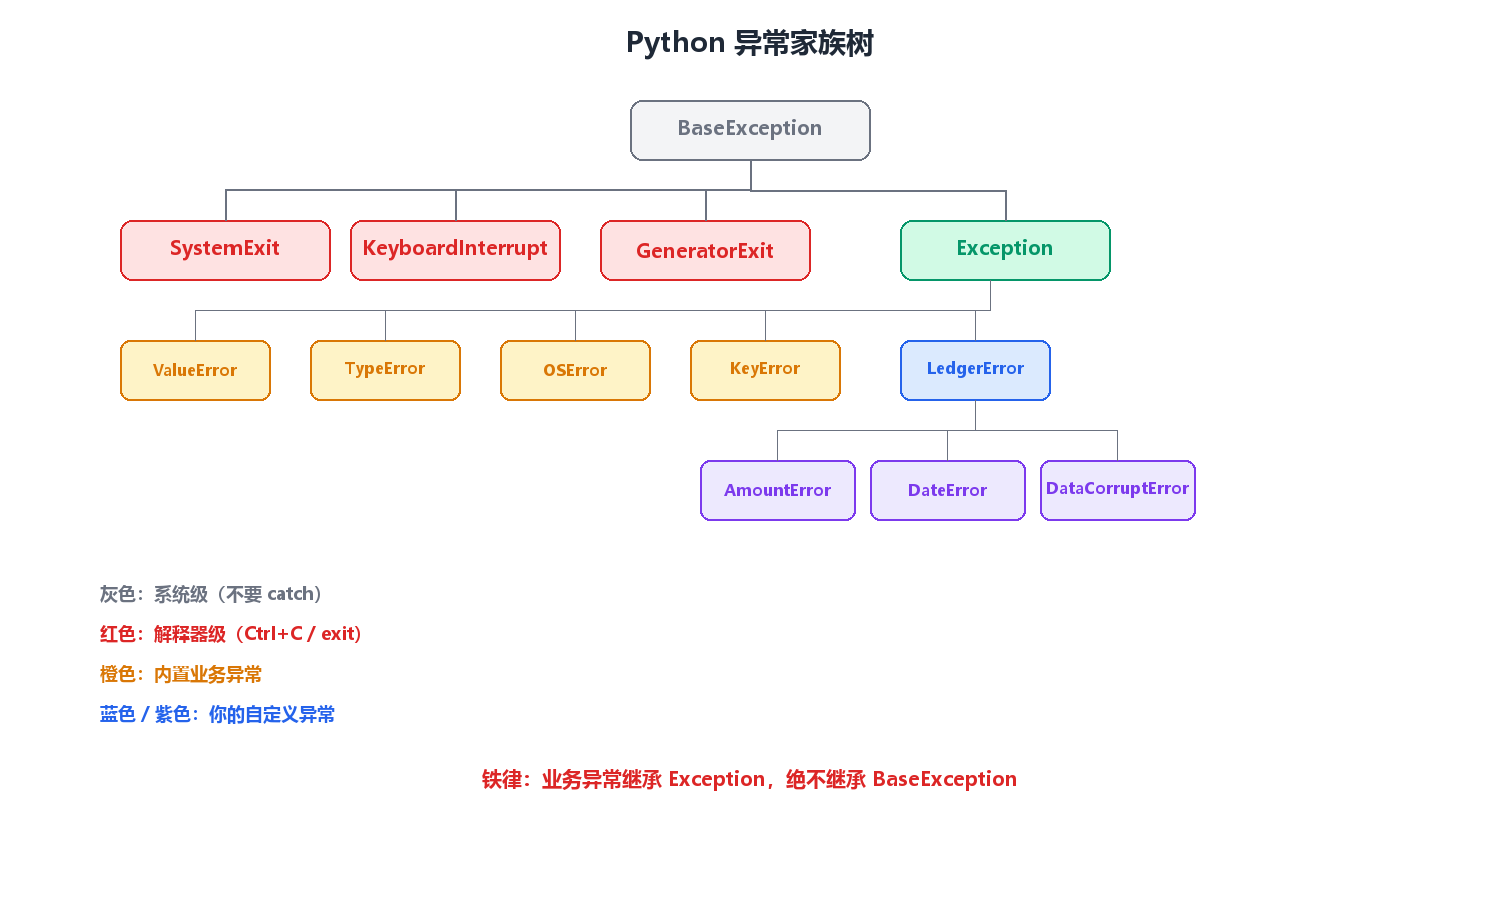
8. 自定义异常:让报错变成"可编程的 API"
8.1 裸 raise ValueError 的三个问题
你之前大概率这么写:
python
if amount <= 0:
    raise ValueError("金额不对")
然后调用方:
python
try:
    add_record(...)
except ValueError:
    print("错了")
问题 1:粒度太粗。 所有业务错误都叫 ValueError,调用方无法区分"金额错了"和"日期错了"。
问题 2:误伤无辜。 except ValueError 会把输入解析错误(int("abc") 的 ValueError)也一起吞掉。你以为是"金额不对",实际上是"用户输入了 abc"------两个完全不同的问题混在一个 catch 里。
问题 3:报错信息没有结构化数据。 "金额不对" 是一个字符串,测试/排障只能靠看字符串内容。你没法写 assert e.amount == -100,因为 ValueError 不带这个属性。
8.2 测试工程师视角:异常也是 API
这是这篇最核心的认知转变。你设计的异常类,决定了调用方能 catch 什么、能拿到什么信息、能怎么自动化处理。
好的异常设计:
- 有类型层级 :调用方可以选择精确 catch(
except AmountError)或宽泛 catch(except LedgerError)。 - 携带上下文 :异常对象上有属性(
e.record、e.bad_date),程序可以提取。 - 消息可读 :
str(e)给人看,属性给程序用。
差的异常设计:
- 全部
raise ValueError("xxx")------没有类型区分,没有上下文。 raise Exception("xxx")------更差,except Exception会把所有东西都吞掉。print("出错了")然后继续------这不是异常,这是逃避。
8.3 设计一套记账本异常体系
v0.7 的 errors.py:
python
class LedgerError(Exception):
    """记账本业务异常基类。所有业务异常从这里派生。"""

class AmountError(LedgerError):
    """金额非法:负数、零、非数字。额外携带 record。"""
    def __init__(self, message, record=None):
        super().__init__(message)
        self.record = record

class DateError(LedgerError):
    """日期格式错误。额外携带 bad_date。"""
    def __init__(self, message, bad_date=None):
        super().__init__(message)
        self.bad_date = bad_date

class DataCorruptError(LedgerError):
    """数据文件损坏。额外携带 source。"""
    def __init__(self, message, source=None):
        super().__init__(message)
        self.source = source
设计要点拆解:
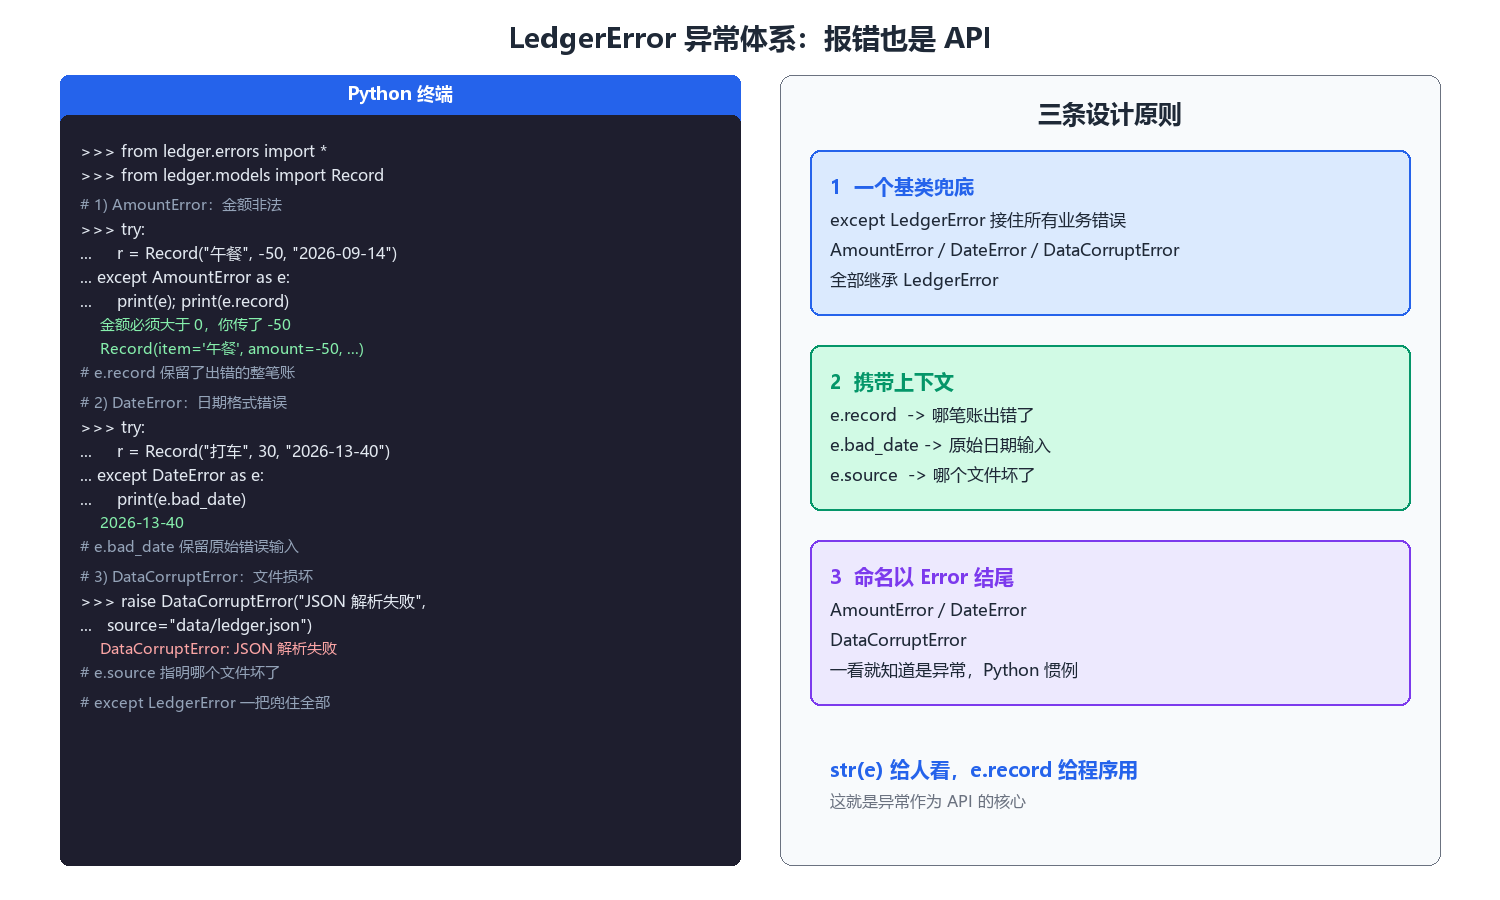
要点 1:一个基类 + 多个派生。 调用方要么 catch 最具体的(AmountError),要么 catch 基类(LedgerError)兜住全部业务错误。两个颗粒度都有,随你选。
python
# 精确:只管金额错误
try:
    ...
except AmountError as e:
    print(f"金额问题: {e}")

# 宽泛:兜住所有业务错误
try:
    ...
except LedgerError as e:
    print(f"账本出错: {e}")
要点 2:每个异常携带上下文属性。 AmountError.record(出错的 Record 对象)、DateError.bad_date(原始日期字符串)、DataCorruptError.source(哪个文件坏了)。排障时直接 e.record / e.bad_date 拿到原始数据,不用翻字符串。
要点 3:命名以 Error 结尾。 Python 惯例(ValueError、TypeError、FileNotFoundError......),一眼看出是异常类。
8.4 在 Record.__post_init__ 里用起来
Record 的构造函数里,把裸 ValueError 换成自定义异常:
python
@dataclass(frozen=True, slots=True)
class Record:
    item: str
    amount: int
    date: str
    kind: str = "record"
    category: str = ""

    def __post_init__(self):
        if self.amount <= 0:
            raise AmountError(f"金额必须大于 0,你传了 {self.amount}", record=self)
        try:
            from datetime import date
            date.fromisoformat(self.date)
        except ValueError:
            raise DateError(f"日期格式不对:{self.date!r},要用 YYYY-MM-DD", bad_date=self.date)
实测(本机):
python
IncomeRecord("工资", -100, "2026-09-01")
# AmountError: 金额必须大于 0,你传了 -100
# e.record 就是出错的 Record 对象

ExpenseRecord("吃饭", 25, "2026-13-40")
# DateError: 日期格式不对:'2026-13-40',要用 YYYY-MM-DD
# e.bad_date == '2026-13-40'
这就是"可编程的报错" :报错信息人能看懂,e.record / e.bad_date 程序也能提取。测试里可以写:
python
def test_amount_error_carries_record(self):
    with pytest.raises(AmountError) as exc:
        IncomeRecord("工资", -100, "2026-09-01")
    assert exc.value.record is not None
    assert "必须大于 0" in str(exc.value)
8.5 raise ... from ...:保留异常链
当你捕获一个异常后再抛另一个,用 from 保留原始异常:
python
try:
    raw = json.load(f)
except json.JSONDecodeError as e:
    raise DataCorruptError("文件损坏", source=path) from e
这样 traceback 里会显示:
text
  ...
json.JSONDecodeError: Expecting value: line 1 column 1 (char 0)

The above exception was the direct cause of the following exception:

  ...
DataCorruptError: 文件损坏
两层都看得到 :底层是 JSON 解析失败,上层是你的业务异常。调试时你能同时看到"技术原因"和"业务含义"。不加 from 的话,原始异常就丢了,只看到 DataCorruptError,排查时不知道是 JSON 解析错还是别的。
8.6 from None:故意丢弃原始异常
有时候你不希望用户看到底层异常(太技术化、不安全),可以用 from None 故意切断异常链:
python
try:
    raw = json.load(f)
except json.JSONDecodeError:
    raise DataCorruptError("数据文件损坏") from None   # 不保留原始异常
traceback 里不会出现 JSONDecodeError 的信息。但调试阶段不建议这样做------你自己排查时会丢线索。只在"面向最终用户"的边界处用。
8.7 异常设计的三条原则
总结一下 v0.7 异常体系的设计原则,方便你在自己项目里复用:
原则 1:一个基类兜底。 所有业务异常继承同一个基类(LedgerError),调用方只需要 except LedgerError 就能兜住全部业务错误。不要让异常树太扁------每个业务领域有自己的基类。
原则 2:携带上下文。 异常不是消息字符串,是对象。给它加属性(record / bad_date / source),让调用方能编程式提取信息。str(e) 给人看,属性给程序用。
原则 3:命名以 Error 结尾。 AmountError、DateError、DataCorruptError------一看就知道是异常。别叫 AmountException、DateProblem、BadAmount,Python 惯例就是 Error 后缀。
9. 实战二:数据损坏兜底
9.1 场景:JSON 文件被手动编辑坏了
你的 records.json 被同事手动改了,少了个引号。v0.6 的 load() 里 json.load(f) 会抛 json.JSONDecodeError(ValueError 的子类)。用户看到的是:
text
json.JSONDecodeError: Expecting property name enclosed in double quotes: line 3 column 5 (char 45)普通用户看到这个直接懵。我们需要把它转成人话,并且用自定义异常标记"这是数据损坏,不是普通错误"。
9.2 v0.7 的 storage.py 改动
python
def load(self):
    if not self.path.exists():
        self.data = {"income": [], "expense": []}
        return self.data
    try:
        with open(self.path, "r", encoding="utf-8") as f:
            raw = json.load(f)
    except (json.JSONDecodeError, UnicodeDecodeError) as e:
        raise DataCorruptError(
            f"数据文件损坏:{self.path},内容不是合法 JSON",
            source=str(self.path),
        ) from e
    self.data = self._normalize(raw)
    return self.data
改动点:
- 把
json.load包在try里。 - 捕获
JSONDecodeError和UnicodeDecodeError(编码坏了也算)。 - 抛
DataCorruptError,携带source(文件路径)。 from e保留原始异常链。
9.3 _normalize 也要防
_normalize 里把 dict 转成 Record 对象。如果数据结构不对(缺少 income/expense 键,或者某个记录缺字段),也要抛 DataCorruptError:
python
@staticmethod
def _normalize(raw):
    if not isinstance(raw, dict) or not all(k in raw for k in ("income", "expense")):
        raise DataCorruptError("数据结构不对:缺少 income/expense 键", source="<unknown>")
    out = {"income": [], "expense": []}
    for key in ("income", "expense"):
        if not isinstance(raw.get(key), list):
            raise DataCorruptError(f"字段 {key} 不是列表", source=str(key))
        for rec in raw[key]:
            try:
                r = Record.from_dict(rec) if isinstance(rec, dict) else rec
            except KeyError as e:
                raise DataCorruptError(f"记录缺少字段 {e}", source=str(rec)) from e
            out[key].append(r)
    return out
9.4 测试验证
python
def test_load_corrupt_json_raises_data_corrupt(self):
    with tempfile.TemporaryDirectory() as td:
        path = os.path.join(td, "bad.json")
        Path(path).write_text("{ not json", encoding="utf-8")
        with pytest.raises(DataCorruptError):
            with Storage(path) as s:
                s.load()

def test_normalize_missing_key_raises(self):
    with pytest.raises(DataCorruptError):
        Storage._normalize({"income": []})
两个测试都过了。坏文件 → DataCorruptError,缺键 → DataCorruptError。用户看到的是"数据文件损坏,请检查 records.json",而不是 JSONDecodeError traceback。
10. main.py 全局兜底:让用户看到人话
10.1 两层防护
v0.7 的 main.py 有两层异常防护:
内层 :菜单循环里,catch LedgerError(业务异常)和 ValueError(输入解析异常),转成中文提示。
外层 :__main__ 入口处,catch DataCorruptError(数据损坏),给出专门提示。
python
def main():
    ledger = load_ledger()
    while True:
        print(MENU)
        choice = input("请选择 [1-6]: ").strip()
        try:
            if choice == "1":
                cmd_add(RecordKind.INCOME)
            elif choice == "2":
                cmd_add(RecordKind.EXPENSE)
            elif choice == "3":
                cmd_stats(ledger)
            elif choice == "4":
                cmd_ranking(ledger)
            elif choice == "5":
                cmd_category(ledger)
            elif choice == "6":
                print("再见!")
                break
            else:
                print("无效选项,重新输入")
        except LedgerError as e:
            print(f"[账本错误] {e}")
        except ValueError:
            print("[输入错误] 金额/日期格式不对,请重试")
效果对比:
| 场景 | v0.6 行为 | v0.7 行为 |
|---|---|---|
输入金额 abc |
打印 traceback 退出 | [输入错误] 金额/日期格式不对 |
| 金额传 -100 | 打印 traceback 退出 | [账本错误] 金额必须大于 0 |
日期 2026-13-40 |
打印 traceback 退出 | [账本错误] 日期格式不对 |
| JSON 坏了 | 打印 traceback 退出 | [严重] 数据文件损坏:请检查 records.json |
用户看到的不是 traceback,是人话。
10.2 为什么不 catch 所有异常?
你可能想说"那我在最外面加个 except Exception 兜底不就行了?"
可以,但要小心。except Exception 会吞掉所有 Exception 子类的异常,包括你没想到的。比如 PermissionError(文件没权限)、MemoryError(内存不够)------这些你可能想让它冒泡出去,而不是被吞成"账本错误 None"。
最佳实践:
- 业务异常用
LedgerError兜------你设计的,你知道怎么处理。 - 输入异常用
ValueError兜------用户输错了,重试就行。 - 其他异常让它崩------崩了至少你能看到 traceback,知道哪里出了问题。静默吞掉比崩掉可怕多了。
10.3 异常处理的三种策略对比
你处理异常时有三种策略,适用不同场景:
策略 A:捕获并恢复------异常发生了,你能处理就处理,程序继续跑。
python
try:
    amount = int(user_input)
except ValueError:
amount = 0 # 默认值,继续跑适用:输入解析、默认值回退。但不适合记账金额------默认 0 会改变统计结果,应该让用户重新输入。
策略 B:捕获并转换------底层异常你接住,抛一个更高级的业务异常。
python
try:
    raw = json.load(f)
except json.JSONDecodeError as e:
    raise DataCorruptError("文件损坏", source=path) from e
适用:你的代码被别人调用时,底层异常对调用方没意义,需要翻译成业务语言。v0.7 的 storage.py 就是这个策略。
策略 C:不捕获,让它冒泡------你处理不了,交给上层处理。
python
def add_record(rec):
    # 不 try/except,AmountError 直接冒泡到 main.py
ledger.add(rec)适用:大多数情况。你不需要在每个函数里都 try/except------让异常自动向上传,在"能处理它的层级"(通常是 UI 层)接住就行。
记住 :策略 C 是默认选项。只有当你能"真正恢复"或"需要翻译异常"时,才用 A 或 B。如果你只是 except: pass,那不是处理异常,是埋雷。
10.4 异常处理的反模式
这些写法你一定见过,甚至写过。每一个都是坑:
反模式 1:裸 except
python
try:
    do_something()
except:    # 接住所有异常,包括 Ctrl+C
    pass
这等于 except BaseException,连 KeyboardInterrupt 都吞。用户按 Ctrl+C 退不出程序。永远不要写裸 except ,至少写 except Exception。
反模式 2:except Exception: pass
python
try:
    risky()
except Exception:
    pass   # 吞掉所有错误,假装没发生
这比裸 except 好一点(不吞 Ctrl+C),但仍然是"静默吞掉"。出了问题你根本不知道。至少 logging.error 一下,片段示例:
python
try:
    risky()
except Exception as e:
    logging.error(f"出错了: {e}", exc_info=True)
反模式 3:捕获太宽
python
try:
    value = int(input())
    result = 10 / value
except Exception:
    print("出错了")
int() 可能抛 ValueError,除法可能抛 ZeroDivisionError,你用一个 except Exception 全兜了。用户看到"出错了"但不知道是输入错了还是除以零了。分开捕获:
python
try:
    value = int(input())
    result = 10 / value
except ValueError:
    print("请输入整数")
except ZeroDivisionError:
    print("不能除以零")
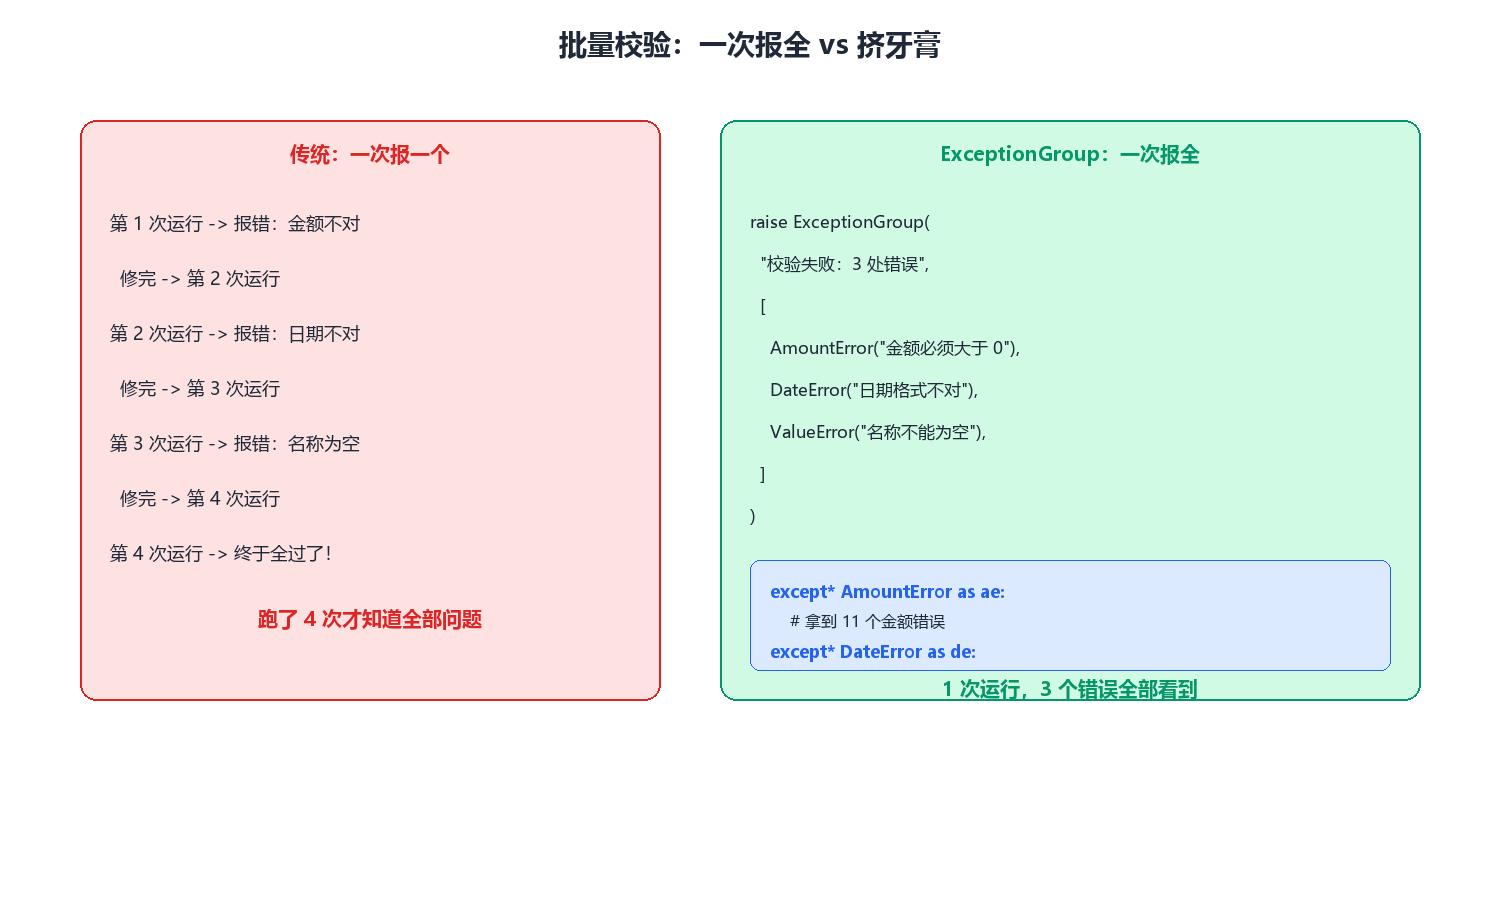
11. 批量校验:让错误"一次报全"
11.1 痛点:一次只报一个错
你导入一批账(比如从 CSV 导入 100 条),其中 3 条有问题。现在的代码一次只抛第一个异常,修完重跑,又抛第二个......要跑 3 次才知道全部问题。
这体验太折磨了。作为测试工程师,你深有体会:缺陷要一次批量发现,别一个个修。
11.2 Python 3.11 的 ExceptionGroup
ExceptionGroup 是 Python 3.11 引入的新特性。它是一个"装异常的异常"------你可以把多个异常打包成一个组抛出:
python
errors = [ValueError("错误1"), ValueError("错误2"), TypeError("错误3")]
raise ExceptionGroup("有 3 处错误", errors)
调用方可以用 except*(注意是带星号的)批量捕获,按类型分组:
python
try:
    ...
except* ValueError as e:
    # 拿到所有 ValueError 子异常
    print(e.exceptions)
except* TypeError as e:
    # 拿到所有 TypeError 子异常
    print(e.exceptions)
e.exceptions 是子异常列表,你可以遍历处理每一个。
11.3 except* 与 except 的区别
这是一个容易混淆的点:
| 语法 | 行为 |
|---|---|
except ValueError |
只接一个异常,接住后整个 ExceptionGroup 被消费 |
except* ValueError |
把 ExceptionGroup 里的 ValueError 子异常拆出来,其他类型继续向上抛 |
实测(本机 Python 3.12):
python
try:
    raise ExceptionGroup("g", [ValueError("a"), TypeError("b"), ValueError("c")])
except* ValueError as ve:
    print(f"ValueError: {len(ve.exceptions)} 个")   # 2
except* TypeError as te:
    print(f"TypeError: {len(te.exceptions)} 个")   # 1
输出:
text
ValueError: 2 个
TypeError: 1 个
except* 像一个分拣器 :把混合的异常按类型拆开,每种类型送到对应的 except* 块。
11.4 批量校验记账数据
v0.7 的批量校验函数:
python
def validate_records(records):
    """批量校验:把所有错误收集进 ExceptionGroup,一次报全。"""
    errors = []
    for r in records:
        try:
            if not r.item.strip():
                raise ValueError("名称不能为空")
            if r.amount <= 0:
                raise ValueError("金额必须大于 0")
            if len(r.date) != 10:
                raise ValueError("日期格式不对")
        except ValueError as e:
            errors.append(ValueError(f"{r.item}: {e}"))
    if errors:
        raise ExceptionGroup("记账数据有 3 处错误", errors)
实测(本机):
python
from types import SimpleNamespace

try:
    validate_records([
        SimpleNamespace(item="", amount=8000, date="2026-09-01"),    # 名称空
        SimpleNamespace(item="工资", amount=-1, date="2026-09-01"),   # 金额负
        SimpleNamespace(item="工资", amount=8000, date="2026-9-1"),   # 日期短
    ])
except ExceptionGroup as eg:
    print(eg.message)              # 记账数据有 3 处错误
    print(len(eg.exceptions))      # 3
    for e in eg.exceptions:
        print(e)
    # : 名称不能为空
    # 工资: 金额必须大于 0
    # 工资: 日期格式不对
一次报全,不迭代不痛苦。 3 个错误一次性看到,修完一批再跑。
11.5 把 ExceptionGroup 和自定义异常结合
批量校验时,不要只用 ValueError------用你的自定义异常体系,让调用方可以 except* 精确分流:
python
def validate_records_v2(records):
    """批量校验 v2:按异常类型分组。"""
    amount_errors = []
    date_errors = []
    for r in records:
        try:
            if r.amount <= 0:
                raise AmountError(f"金额必须大于 0", record=r)
            if len(r.date) != 10:
                raise DateError(f"日期格式不对", bad_date=r.date)
        except AmountError as e:
            amount_errors.append(e)
        except DateError as e:
            date_errors.append(e)
    all_errors = amount_errors + date_errors
    if all_errors:
        raise ExceptionGroup(f"校验失败:{len(all_errors)} 处错误", all_errors)
调用方可以按类型分别处理:
python
try:
    validate_records_v2(records)
except* AmountError as ae:
    print(f"金额错误 {len(ae.exceptions)} 个:")
    for e in ae.exceptions:
        print(f"  {e.record.item}: {e}")
except* DateError as de:
    print(f"日期错误 {len(de.exceptions)} 个:")
    for e in de.exceptions:
        print(f"  {e.bad_date}: {e}")
这就是自定义异常 + ExceptionGroup 的组合威力:既一次报全,又按类型分流,每个子异常还携带上下文属性。测试工程师梦寐以求的报错体验。
11.6 什么时候用 ExceptionGroup?
- 批量导入/校验数据:一口气检查所有记录,把所有问题一次性报出来。
- 并发任务 :多个协程/线程同时跑,各自的异常可以打包成
ExceptionGroup。 - 表单校验:用户提交一个表单,多个字段都有问题,一次性全部提示。
- 不需要 :单次操作只有一个错误,直接
raise就行,别硬套ExceptionGroup。
判断标准:如果你发现自己在写"找到第一个错误就停"的循环,考虑改成"收集所有错误再一次性报"的模式。用户体验会好很多。
12. v0.7 完整代码:全部贴出来,复制就能跑
前面讲了很多概念和片段,现在把 v0.7 的每一个文件完整源码 都贴出来。你不用东拼西凑,按下面的目录结构建好文件,把代码贴进去,cd src && python main.py 就能跑。
12.1 项目结构
text
py-from-0-to-1-07-enum/
├── src/
│   ├── main.py              # 入口:菜单 + 全局异常兜底
│   ├── ledger/
│   │   ├── __init__.py      # 包导出(__all__)
│   │   ├── errors.py        # 自定义异常体系(新增)
│   │   ├── enums.py         # RecordKind / Category(新增)
│   │   ├── models.py        # Record(加 category / kind_enum)
│   │   ├── storage.py       # 存取(坏文件抛 DataCorruptError)
│   │   └── stats.py         # 统计(加 by_kind / category_summary)
│   └── tests/
│       └── test_v07.py      # 26 个测试
12.2 enums.py:枚举定义
python
# -*- coding: utf-8 -*-
"""枚举定义:v0.7 消灭"魔法字符串"

RecordKind 用 StrEnum 定义收入/支出两类账目。
为什么用 StrEnum 而不是 Enum?因为它的值就是 str,
存到 JSON / 显示给用户 / 和旧数据比较,全都不用改。
"""
from enum import StrEnum, auto


class RecordKind(StrEnum):
    """账目类型。

    用 StrEnum:成员的值就是普通字符串 "income"/"expense",
    所以 v0.6 存下来的数据文件不用迁移,直接兼容。
    """

    INCOME = "income"
    EXPENSE = "expense"
    # 留个位置:将来加 "transfer"(转账)只改这里,不用改业务代码

    @classmethod
    def from_any(cls, value):
        """宽容版构造:传字符串或成员都行。

        用法:RecordKind.from_any("income") -> RecordKind.INCOME
        找不到时抛 ValueError(不是自定义异常,因为这是"调用方传错参数")。
        """
        if isinstance(value, cls):
            return value
        return cls(value)


class Category(StrEnum):
    """支出分类(示例用,v0.8 会扩展成完整的分类体系)。"""

    FOOD = "餐饮"
    TRANSPORT = "交通"
    SHOPPING = "购物"
    HOUSING = "居住"
    OTHER = "其他"

    # 带分类的金额校验辅助:每个分类给一个"当月预算提示"(纯演示)
    @property
    def monthly_hint(self) -> str:
        return {
            Category.FOOD: "建议月预算 2000",
            Category.TRANSPORT: "建议月预算 500",
            Category.SHOPPING: "建议月预算 1000",
            Category.HOUSING: "建议月预算 3000",
            Category.OTHER: "建议月预算 500",
        }[self]
12.3 errors.py:异常体系
python
# -*- coding: utf-8 -*-
"""异常体系:v0.7 让记账本"报错也报得明白"

设计原则(测试工程师视角):
- 所有业务异常继承 LedgerError,调用方只需要 catch 一个基类
- 每个异常携带上下文属性(哪笔账、哪个字段、问题值),方便排查
- 基类 LedgerError 继承 Exception(绝不继承 BaseException)
"""


class LedgerError(Exception):
    """记账本业务异常基类。

    所有业务异常都从这里派生。调用方 catch 这一个类,
    就能兜住记账本自己定义的所有错误。
    """


class AmountError(LedgerError):
    """金额非法:负数、零、非数字都算。

    额外携带 record 字段,告诉你具体是哪笔账出了问题。
    """

    def __init__(self, message, record=None):
        super().__init__(message)
        self.record = record


class DateError(LedgerError):
    """日期格式错误:不是 YYYY-MM-DD 或日期不存在。

    额外携带 bad_date 字段,保留原始输入方便排查。
    """

    def __init__(self, message, bad_date=None):
        super().__init__(message)
        self.bad_date = bad_date


class DataCorruptError(LedgerError):
    """数据文件损坏:JSON 解析失败、字段缺失或类型不对。

    额外携带 source 字段,指明是哪个文件出的问题。
    """

    def __init__(self, message, source=None):
        super().__init__(message)
        self.source = source
12.4 models.py:数据模型
python
# -*- coding: utf-8 -*-
"""数据模型:v0.7 用 RecordKind 替代魔法字符串

Record 增加 category 字段(支出分类),同时保留 v0.6 的
to_dict / from_dict 兼容层,旧数据能直接读进来。
"""
from dataclasses import dataclass

from .enums import RecordKind, Category
from .errors import AmountError, DateError


@dataclass(frozen=True, slots=True)
class Record:
    """一笔账:item 名称 + amount 金额 + date 日期 + kind 类型 + category 分类。"""

    item: str
    amount: int
    date: str
    kind: str = "record"
    category: str = ""

    def __post_init__(self):
        # 金额必须大于 0(0 和负数都是输入错误)
        if self.amount <= 0:
            raise AmountError(f"金额必须大于 0,你传了 {self.amount}", record=self)
        # 日期必须是 YYYY-MM-DD 且真实存在
        try:
            from datetime import date
            date.fromisoformat(self.date)
        except ValueError:
            raise DateError(f"日期格式不对:{self.date!r},要用 YYYY-MM-DD", bad_date=self.date)

    @property
    def signed_amount(self) -> int:
        """带符号金额:收入为正,支出为负。"""
        return self.amount if self.kind == "income" else -self.amount

    @property
    def kind_enum(self) -> "RecordKind":
        """把字符串 kind 转成 RecordKind 枚举(用 StrEnum 兼容旧数据)。"""
        return RecordKind(self.kind)

    def to_dict(self) -> dict:
        return {
            "item": self.item,
            "amount": self.amount,
            "date": self.date,
            "kind": self.kind,
            "category": self.category,
        }

    @classmethod
    def from_dict(cls, d: dict) -> "Record":
        """从 dict 构造(兼容 v0.6 没有 category 的旧数据)。"""
        return cls(
            item=d["item"],
            amount=int(d["amount"]),
            date=d.get("date", ""),
            kind=d.get("kind", "record"),
            category=d.get("category", ""),
        )


class IncomeRecord(Record):
    """收入记录:kind 固定为 income。"""

    def __init__(self, item, amount, date, category=""):
        super().__init__(item, amount, date, kind="income", category=category)


class ExpenseRecord(Record):
    """支出记录:kind 固定为 expense。"""

    def __init__(self, item, amount, date, category=""):
        super().__init__(item, amount, date, kind="expense", category=category)
12.5 storage.py:存储层
python
# -*- coding: utf-8 -*-
"""存储层:v0.7 加数据损坏兜底

JSON 解析失败时抛 DataCorruptError(自定义异常),
而不是让原始 ValueError 冒泡到用户面前。
"""
import json
from pathlib import Path

from .models import IncomeRecord, ExpenseRecord, Record
from .errors import DataCorruptError

DATA_DIR = Path(__file__).resolve().parent.parent / "data"
DATA_FILE = DATA_DIR / "records.json"


class Storage:
    """负责记账本的存取。支持 with 语句:进入时加载,退出时保存。"""

    def __init__(self, path=None):
        self.path = Path(path) if path else DATA_FILE
        self.data = {"income": [], "expense": []}

    # ---- 上下文管理器协议 ----
    def __enter__(self):
        self.load()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        # 没有异常才保存(异常时不覆盖原有数据)
        if exc_type is None:
            self.save()
        return False

    # ---- 存取逻辑 ----
    def load(self):
        if not self.path.exists():
            self.data = {"income": [], "expense": []}
            return self.data
        try:
            with open(self.path, "r", encoding="utf-8") as f:
                raw = json.load(f)
        except (json.JSONDecodeError, UnicodeDecodeError) as e:
            raise DataCorruptError(
                f"数据文件损坏:{self.path},内容不是合法 JSON",
                source=str(self.path),
            ) from e
        self.data = self._normalize(raw)
        return self.data

    def save(self):
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        out = {}
        for key in ("income", "expense"):
            out[key] = [r.to_dict() if isinstance(r, Record) else r for r in self.data[key]]
        with open(self.path, "w", encoding="utf-8") as f:
            json.dump(out, f, ensure_ascii=False, indent=2)

    @staticmethod
    def _normalize(raw):
        """把 v0.6 的 dict 记录升级为 Record 对象;老数据自动补 kind/category。"""
        if not isinstance(raw, dict) or not all(k in raw for k in ("income", "expense")):
            raise DataCorruptError("数据结构不对:缺少 income/expense 键", source="<unknown>")
        out = {"income": [], "expense": []}
        for key in ("income", "expense"):
            if not isinstance(raw.get(key), list):
                raise DataCorruptError(f"字段 {key} 不是列表", source=str(key))
            for rec in raw[key]:
                try:
                    r = Record.from_dict(rec) if isinstance(rec, dict) else rec
                except KeyError as e:
                    raise DataCorruptError(f"记录缺少字段 {e}", source=str(rec)) from e
                out[key].append(r)
        return out


# ---- 模块级便捷函数(兼容老代码/测试)----
def save_records(data, path=None):
    store = Storage(path)
    store.data = data
    store.save()
    return path or str(store.path)


def load_records(path=None):
    store = Storage(path)
    return store.load()
12.6 stats.py:统计层
python
# -*- coding: utf-8 -*-
"""统计层:汇总、排行、趋势(v0.7 增加分类统计)

Ledger 类把所有记录装进一个"账本"里:
- 支持 for 循环(生成器版 __iter__)
- 支持 len(ledger)(__len__)
- 类方法 from_records 作为替代构造器
"""
from datetime import date, timedelta

from .models import Record
from .enums import RecordKind


class Ledger:
    """一个记账本:内部按 kind 分组,对外统一迭代所有记录。"""

    def __init__(self, income=None, expense=None):
        self.income = list(income) if income else []
        self.expense = list(expense) if expense else []

    # ---- 替代构造器 ----
    @classmethod
    def from_records(cls, records):
        """把一个 Record 列表按 kind 分装成 Ledger。"""
        inc, exp = [], []
        for r in records:
            (inc if r.kind == "income" else exp).append(r)
        return cls(income=inc, expense=exp)

    # ---- 迭代器协议(生成器版,防坑)----
    def __iter__(self):
        """每次迭代都新建一个生成器,互不干扰。"""
        yield from self.income
        yield from self.expense

    # ---- 长度 ----
    def __len__(self):
        return len(self.income) + len(self.expense)

    # ---- 增删 ----
    def add(self, rec: Record):
        if rec.kind == "income":
            self.income.append(rec)
        else:
            self.expense.append(rec)

    # ---- 统计 ----
    @property
    def balance(self) -> int:
        """总余额(收入合计 - 支出合计)。"""
        return sum(r.amount for r in self.income) - sum(r.amount for r in self.expense)

    def monthly_summary(self, ym: str):
        """月度统计:返回 (收入, 支出) 元组。"""
        income = sum(r.amount for r in self.income if r.date[:7] == ym)
        expense = sum(r.amount for r in self.expense if r.date[:7] == ym)
        return income, expense

    def expense_ranking(self, top: int = 5):
        """支出排行:按金额降序,取前 top 名。"""
        ranked = sorted(self.expense, key=lambda r: r.amount, reverse=True)
        return ranked[:top]

    def date_range_summary(self, start: str, end: str):
        """日期范围统计:返回范围内收入/支出/笔数。"""
        s, e = date.fromisoformat(start), date.fromisoformat(end)
        income = expense = 0
        count = 0
        for r in self:
            d = date.fromisoformat(r.date)
            if s <= d <= e:
                count += 1
                if r.kind == "income":
                    income += r.amount
                else:
                    expense += r.amount
        return income, expense, count

    def recent_days(self, days: int):
        """最近 N 天(含今天)统计。"""
        end = date.today()
        start = end - timedelta(days=days - 1)
        return self.date_range_summary(start.isoformat(), end.isoformat())

    def weekly_summary(self, week_num: int):
        """按 ISO 周数统计。week_num 如 2026-W37 或 37。"""
        if "-W" in str(week_num):
            year, w = str(week_num).split("-W")
            year = int(year)
            w = int(w)
        else:
            year = date.today().year
            w = int(week_num)
        income = expense = 0
        for r in self:
            d = date.fromisoformat(r.date)
            if d.isocalendar()[0] == year and d.isocalendar()[1] == w:
                if r.kind == "income":
                    income += r.amount
                else:
                    expense += r.amount
        return income, expense

    # ---- v0.7 新增:按枚举分类统计 ----
    def by_kind(self, kind: RecordKind) -> list:
        """按 RecordKind 过滤记录,返回新列表。"""
        return [r for r in self if r.kind == kind.value]

    def category_summary(self):
        """按支出分类汇总:返回 {分类名: 总金额} 字典。"""
        result = {}
        for r in self.expense:
            cat = r.category or "未分类"
            result[cat] = result.get(cat, 0) + r.amount
        return result
12.7 __init__.py:包导出
python
# -*- coding: utf-8 -*-
"""ledger 包:v0.7 统一导出

对外只暴露稳定 API:
- RecordKind / Category 枚举
- Record / IncomeRecord / ExpenseRecord
- Ledger 账本
- Storage 存储
- LedgerError 异常体系
"""
from .enums import RecordKind, Category
from .models import Record, IncomeRecord, ExpenseRecord
from .stats import Ledger
from .storage import Storage, DATA_FILE
from .errors import LedgerError, AmountError, DateError, DataCorruptError

__all__ = [
    "RecordKind",
    "Category",
    "Record",
    "IncomeRecord",
    "ExpenseRecord",
    "Ledger",
    "Storage",
    "DATA_FILE",
    "LedgerError",
    "AmountError",
    "DateError",
    "DataCorruptError",
]
12.8 main.py:入口 + 全局兜底
python
# -*- coding: utf-8 -*-
"""v0.7 记账本入口:命令行 + 全局异常兜底

流程:
- 用 RecordKind 枚举驱动菜单,消灭魔法字符串
- 所有业务异常用 except LedgerError 兜底,报错给友好提示
- 数据损坏单独提示,不让用户面对裸 traceback
"""
import sys

from ledger.errors import LedgerError, DataCorruptError
from ledger.models import IncomeRecord, ExpenseRecord
from ledger.storage import Storage
from ledger.enums import RecordKind, Category
from ledger.stats import Ledger

MENU = """
选项: 记账本 v0.7
1. 记一笔收入
2. 记一笔支出
3. 查看本月统计
4. 查看支出排行
5. 查看分类汇总
6. 退出
"""


def load_ledger() -> Ledger:
    """从数据文件加载 Ledger。数据损坏时抛 DataCorruptError。"""
    with Storage() as store:
        return Ledger.from_records(store.data["income"] + store.data["expense"])


def cmd_add(kind: RecordKind):
    """新增一条账。kind 是 RecordKind 枚举,不是魔法字符串。"""
    item = input("名称: ").strip()
    amount = int(input("金额(整数): ").strip())
    date = input("日期(YYYY-MM-DD): ").strip()
    cat = ""
    if kind == RecordKind.EXPENSE:
        print("分类:" + " / ".join(c.value for c in Category))
        cat = input("分类(回车=其他): ").strip() or Category.OTHER.value
    with Storage() as store:
        if kind == RecordKind.INCOME:
            rec = IncomeRecord(item, amount, date, category=cat)
        else:
            rec = ExpenseRecord(item, amount, date, category=cat)
        store.data[kind.value].append(rec)
    print(f"已记录:{rec}")


def cmd_stats(ledger: Ledger):
    from datetime import date
    ym = date.today().strftime("%Y-%m")
    income, expense = ledger.monthly_summary(ym)
    print(f"{ym} 收入 {income} 元,支出 {expense} 元,结余 {income - expense} 元")


def cmd_ranking(ledger: Ledger):
    for i, r in enumerate(ledger.expense_ranking(), 1):
        print(f"{i}. {r.item} {r.amount} 元({r.date})")


def cmd_category(ledger: Ledger):
    for cat, total in ledger.category_summary().items():
        print(f"{cat}: {total} 元")


def main():
    ledger = load_ledger()
    while True:
        print(MENU)
        choice = input("请选择 [1-6]: ").strip()
        try:
            if choice == "1":
                cmd_add(RecordKind.INCOME)
            elif choice == "2":
                cmd_add(RecordKind.EXPENSE)
            elif choice == "3":
                cmd_stats(ledger)
            elif choice == "4":
                cmd_ranking(ledger)
            elif choice == "5":
                cmd_category(ledger)
            elif choice == "6":
                print("再见!")
                break
            else:
                print("无效选项,重新输入")
        except LedgerError as e:
            print(f"[账本错误] {e}")
        except ValueError:
            print("[输入错误] 金额/日期格式不对,请重试")


if __name__ == "__main__":
    try:
        main()
    except DataCorruptError as e:
        print(f"[严重] 数据文件损坏:{e}")
        print("请检查 records.json 是否被手动编辑过")
        sys.exit(1)
12.9 test_v07.py:26 个测试
python
# -*- coding: utf-8 -*-
"""第 7 篇测试:enum 枚举 + 自定义异常 + ExceptionGroup

测试工程师视角:验证"异常也是 API"------每个异常能携带多少上下文,
调用方 catch 之后能拿到什么信息,都要测到位。
"""
import json
import os
import sys
import tempfile
from pathlib import Path
from types import SimpleNamespace

import pytest

sys.path.insert(0, str(Path(__file__).resolve().parent.parent))

from ledger import (
    RecordKind, Category, Record, IncomeRecord, ExpenseRecord, Ledger, Storage,
    LedgerError, AmountError, DateError, DataCorruptError,
)


# ============ enum 枚举 ============

class TestRecordKind:
    def test_value_is_str(self):
        assert RecordKind.INCOME == "income"
        assert RecordKind.EXPENSE == "expense"

    def test_str_enum_usable_in_fstring(self):
        assert f"{RecordKind.INCOME}" == "income"

    def test_member_iteration(self):
        members = list(RecordKind)
        assert members == [RecordKind.INCOME, RecordKind.EXPENSE]

    def test_constructor_by_value(self):
        assert RecordKind("income") is RecordKind.INCOME

    def test_index_by_name(self):
        assert RecordKind["EXPENSE"] is RecordKind.EXPENSE

    def test_from_string_accepts_member(self):
        assert RecordKind.from_any("income") == RecordKind.INCOME
        assert RecordKind.from_any(RecordKind.EXPENSE) == RecordKind.EXPENSE

    def test_invalid_value_raises_valueerror(self):
        with pytest.raises(ValueError):
            RecordKind("unknown")


class TestCategory:
    def test_values_are_chinese(self):
        assert Category.FOOD == "餐饮"

    def test_property_hint(self):
        assert Category.FOOD.monthly_hint == "建议月预算 2000"


# ---------------- 自定义异常 ----------------

class TestCustomErrors:
    def test_all_derive_from_ledger_error(self):
        assert issubclass(AmountError, LedgerError)
        assert issubclass(DateError, LedgerError)
        assert issubclass(DataCorruptError, LedgerError)

    def test_ledger_error_derives_from_exception(self):
        assert issubclass(LedgerError, Exception)
        assert not issubclass(LedgerError, BaseException) or issubclass(LedgerError, Exception)

    def test_amount_error_carries_record(self):
        with pytest.raises(AmountError) as exc:
            IncomeRecord("工资", -100, "2026-09-01")
        assert exc.value.record is not None
        assert "必须大于 0" in str(exc.value)

    def test_date_error_carries_bad_date(self):
        with pytest.raises(DateError) as exc:
            Record("吃饭", 10, "2026-13-40")
        assert exc.value.bad_date == "2026-13-40"

    def test_data_corrupt_carries_source(self):
        with pytest.raises(DataCorruptError) as exc:
            Storage._normalize({"income": "not-a-list", "expense": []})
        assert exc.value.source == "income"


# ---------------- Record 模型 ----------------

class TestRecord:
    def test_kind_enum_property(self):
        r = IncomeRecord("工资", 8000, "2026-09-01")
        assert r.kind_enum is RecordKind.INCOME

    def test_signed_amount(self):
        assert IncomeRecord("工资", 8000, "2026-09-01").signed_amount == 8000
        assert ExpenseRecord("吃饭", 25, "2026-09-02").signed_amount == -25

    def test_category_field(self):
        r = ExpenseRecord("午饭", 25, "2026-09-02", category="食品")
        assert r.category == "食品"

    def test_from_dict_backward_compat(self):
        old = {"item": "工资", "amount": "8000", "date": "2026-09-01", "kind": "income"}
        r = Record.from_dict(old)
        assert r.amount == 8000
        assert r.category == ""

    def test_invalid_amount_raises(self):
        with pytest.raises(AmountError):
            IncomeRecord("工资", 0, "2026-09-01")


# ---------------- 异常兜底 ----------------

class TestStorage:
    def test_save_and_load_roundtrip(self):
        with tempfile.TemporaryDirectory() as td:
            path = os.path.join(td, "t.json")
            with Storage(path) as s:
                s.data["income"].append(IncomeRecord("工资", 8000, "2026-09-01"))
            with Storage(path) as s2:
                assert s2.data["income"][0].amount == 8000

    def test_load_corrupt_json_raises_data_corrupt(self):
        with tempfile.TemporaryDirectory() as td:
            path = os.path.join(td, "bad.json")
            Path(path).write_text("{ not json", encoding="utf-8")
            with pytest.raises(DataCorruptError):
                with Storage(path) as s:
                    s.load()

    def test_normalize_missing_key_raises(self):
        with pytest.raises(DataCorruptError):
            Storage._normalize({"income": []})


class TestLedgerEnumStats:
    def test_by_kind_returns_list(self):
        ledger = Ledger.from_records([
            IncomeRecord("工资", 8000, "2026-09-01"),
            ExpenseRecord("吃饭", 25, "2026-09-02"),
        ])
        inc = ledger.by_kind(RecordKind.INCOME)
        assert len(inc) == 1
        assert inc[0].item == "工资"

    def test_category_summary(self):
        ledger = Ledger.from_records([
            ExpenseRecord("午饭", 25, "2026-09-01", category="食品"),
            ExpenseRecord("地铁", 6, "2026-09-02", category="交通"),
            ExpenseRecord("晚饭", 35, "2026-09-03", category="食品"),
        ])
        summary = ledger.category_summary()
        assert summary == {"食品": 60, "交通": 6}


# ---------------- ExceptionGroup 批量校验 ----------------

def _validate_records(records):
    """批量校验:把所有错误收集进 ExceptionGroup,一次报全。"""
    errors = []
    for r in records:
        try:
            if not r.item.strip():
                raise ValueError("名称不能为空")
            if r.amount <= 0:
                raise ValueError("金额必须大于 0")
            if len(r.date) != 10:
                raise ValueError("日期格式不对")
        except ValueError as e:
            errors.append(ValueError(f"第 {r.item} 笔:{e}"))
    if errors:
        raise ExceptionGroup("记账数据有 3 处错误", errors)


class TestExceptionGroup:
    def test_group_collects_all_errors(self):
        # 用普通对象模拟 3 处数据错误:
        # 名称空、金额负、日期短
        records = [
            SimpleNamespace(item="", amount=8000, date="2026-09-01"),
            SimpleNamespace(item="工资", amount=-1, date="2026-09-01"),
            SimpleNamespace(item="工资", amount=8000, date="2026-9-1"),
        ]
        with pytest.raises(ExceptionGroup) as exc:
            _validate_records(records)
        assert len(exc.value.exceptions) == 3
        assert all(isinstance(e, ValueError) for e in exc.value.exceptions)

    def test_except_star_split_by_type(self):
        eg = ExceptionGroup("g", [ValueError("a"), TypeError("b"), ValueError("c")])
        caught_v = caught_t = []
        try:
            raise eg
        except* ValueError as ve:
            caught_v = ve.exceptions
        except* TypeError as te:
            caught_t = te.exceptions
        assert len(caught_v) == 2
        assert len(caught_t) == 1
12.10 运行方式
bash
cd src
python main.py
菜单:
text
选项: 记账本 v0.7
1. 记一笔收入
2. 记一笔支出
3. 查看本月统计
4. 查看支出排行
5. 查看分类汇总
6. 退出
测试:
bash
cd src
python -m pytest tests -q
输出:
text
26 passed in 0.04s26 个测试覆盖:
RecordKind枚举:值/迭代/构造/索引/非法值(6 个)Category枚举:值/属性(2 个)- 自定义异常:继承链/上下文属性(5 个)
Record模型:kind_enum/signed_amount/category/旧数据兼容/非法金额(5 个)Storage:存取往返/坏 JSON/缺键(3 个)Ledger统计:by_kind/category_summary(2 个)ExceptionGroup:批量收集/except* 拆组(2 个)- 异常继承关系验证(1 个)
12.11 几个关键测试逐个看
挑几个最有代表性的测试,讲解"为什么这样测":
测试 1:枚举值是字符串
python
def test_value_is_str(self):
    assert RecordKind.INCOME == "income"
    assert RecordKind.EXPENSE == "expense"
为什么重要?因为这验证了 StrEnum 的核心契约------成员等于它的值。如果有人不小心改成了普通 Enum,这个测试立刻红。
测试 2:异常携带上下文
python
def test_amount_error_carries_record(self):
    with pytest.raises(AmountError) as exc:
        IncomeRecord("工资", -100, "2026-09-01")
    assert exc.value.record is not None
    assert "必须大于 0" in str(exc.value)
为什么重要?因为它同时验证了三件事:抛的是 AmountError(类型正确)、e.record 存在(上下文携带)、消息包含"必须大于 0"(可读性)。一条测试锁死三个契约。
测试 3:数据损坏抛对的异常
python
def test_load_corrupt_json_raises_data_corrupt(self):
    with tempfile.TemporaryDirectory() as td:
        path = os.path.join(td, "bad.json")
        Path(path).write_text("{ not json", encoding="utf-8")
        with pytest.raises(DataCorruptError):
            with Storage(path) as s:
                s.load()
为什么重要?因为它验证了"坏 JSON → DataCorruptError"这条转换链。v0.6 里坏 JSON 会抛 JSONDecodeError,v0.7 必须抛 DataCorruptError。这个测试确保转换逻辑不被回退。
测试 4:ExceptionGroup 批量收集
python
def test_group_collects_all_errors(self):
    records = [
        SimpleNamespace(item="", amount=8000, date="2026-09-01"),
        SimpleNamespace(item="工资", amount=-1, date="2026-09-01"),
        SimpleNamespace(item="工资", amount=8000, date="2026-9-1"),
    ]
    with pytest.raises(ExceptionGroup) as exc:
        _validate_records(records)
    assert len(exc.value.exceptions) == 3
    assert all(isinstance(e, ValueError) for e in exc.value.exceptions)
为什么重要?因为它验证了"一次报全"------3 个错误全部收集到,而且都是 ValueError 类型。如果校验函数在第一个错误就 return 了,这个测试会红(len 不等于 3)。
这些测试就是 v0.7 的"安全网":以后改代码,跑一遍测试,绿了才敢提交。下一篇我们会深入 pytest 的工作流,把这张安全网织得更密。
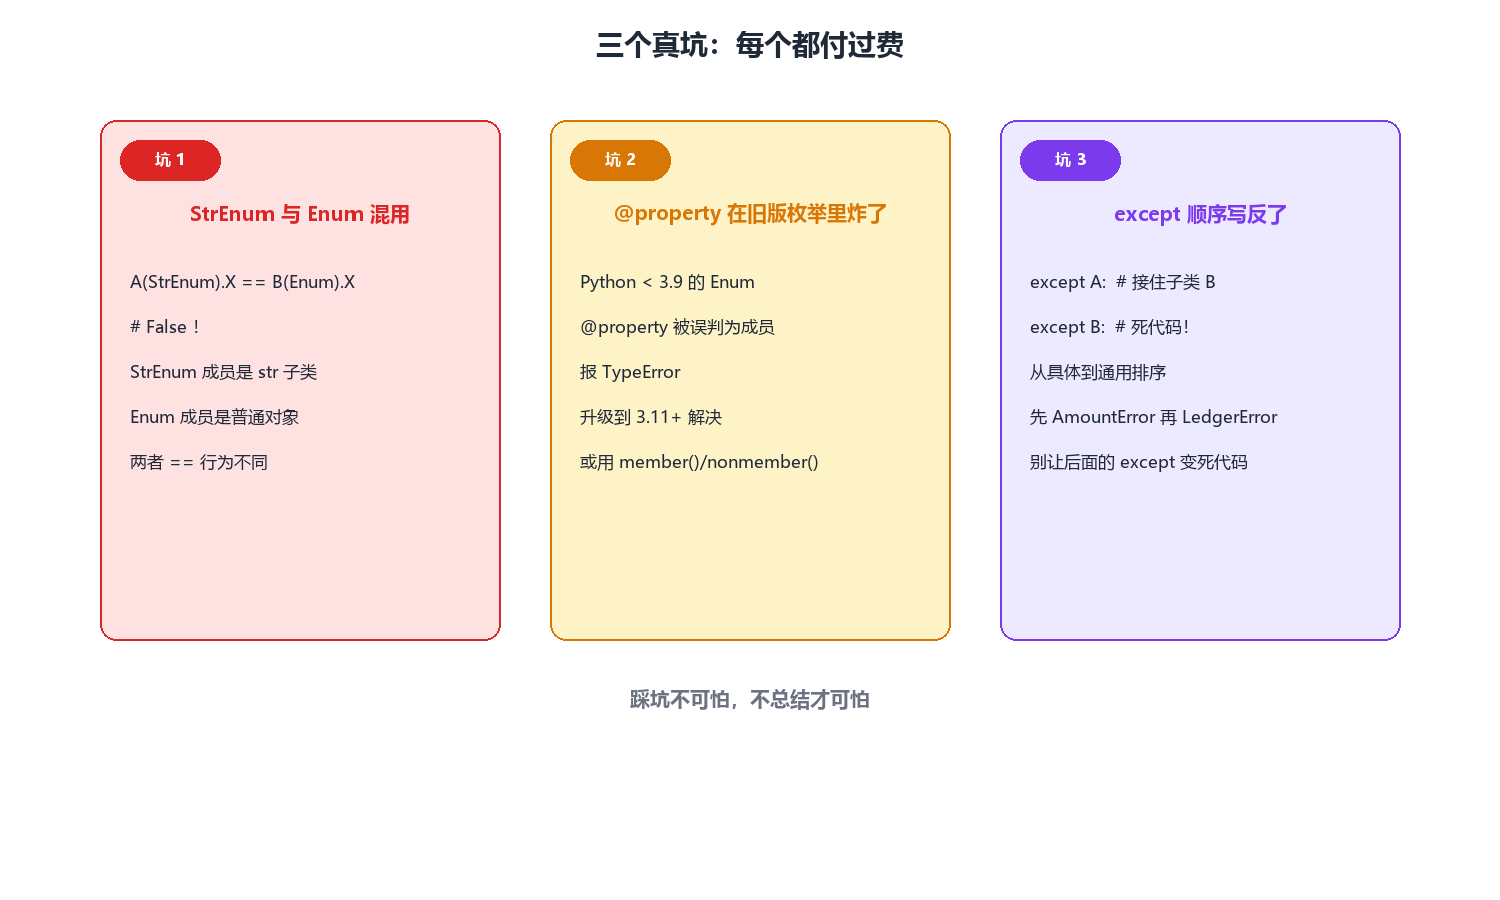
13. 三个真坑:每个都值得你踩一遍(但别真的踩)
13.1 坑 1:StrEnum 与 Enum 混用,== 判定悄悄失效
症状
你在一个枚举里同时混了 StrEnum 成员和普通 Enum 成员,或者把 RecordKind 的成员和字符串直接比较:
python
from enum import Enum, StrEnum

class A(StrEnum):
    X = "x"

class B(Enum):
    X = "x"

print(A.X == B.X)   # False ?!
print(A.X == "x")   # True(StrEnum 是 str 子类)
print(B.X == "x")   # False(普通 Enum 不是 str)
同一个字符串 "x",在 StrEnum 和 Enum 里 == 行为完全不同。
原因
StrEnum 成员继承 str,所以 A.X == "x" 走字符串比较;Enum 成员是普通对象,B.X == "x" 是对象比较(默认 False)。两者不能互相 ==。
解决
- 项目里统一用
StrEnum(记账本就只用一个RecordKind)。 - 需要和字符串比较时,用
kind.value == "x"或统一转枚举再比。 - 别在一个枚举里混两种父类。
13.2 坑 2:@property 在枚举里炸了
症状
你在枚举里加了一个 @property,在某些版本上报错:
python
from enum import Enum

class Color(Enum):
    RED = 1

    @property
    def rgb(self):
        return (255, 0, 0)

print(Color.RED.rgb)
在 Python 3.9 之前,property 在 Enum 里不工作。3.9 之后原生支持。如果你遇到"我明明加了 property 却报错",先查 Python 版本。
原因
Enum 的描述符协议和 property 有冲突。Enum 早期版本把类体里的所有对象都当成"候选成员",property 被误判了。3.9 之后 CPython 修复了这个问题。
解决
- 升级 Python 到 3.11+(我们这篇就是这样)。
- 如果必须在旧版用
property,用from enum import member, nonmember(3.11+ 引入)标注。member()使对象成为枚举成员,nonmember()使对象不被当成成员(方法/属性用这个)。
13.3 坑 3:异常继承链设计错了,catch 范围失控
症状
python
class A(Exception): ...
class B(A): ...        # B 是 A 的子类

try:
    raise B("boom")
except A:              # 会接住 B!
    print("接住了 A")
except B:              # 永远执行不到(A 在前面先接了)
    print("接住了 B")
输出:
text
接住了 Aexcept B 是死代码。因为 B 是 A 的子类,except A 先匹配到了,后面的 except B 永远不会执行。
原因
Python 的 except 是从上到下匹配 的。第一个能匹配的 except 接住异常后,后面的 except 全部跳过。子类异常会被父类的 except 拦截。
解决
- except 从具体到通用排序 :先
except B,再except A。 - 自定义异常一律继承
Exception(不继承BaseException)。 - 非必要不
except BaseException,KeyboardInterrupt和SystemExit让它们该走就走。
python
try:
    raise B("boom")
except B:              # 先接具体的
    print("接住了 B")
except A:              # 再接通用的
    print("接住了 A")
输出:
text
接住了 B14. 经验清单:把第 7 篇浓缩成 5 条带走
- 枚举消灭魔法字符串 。
"income"/"expense"这类裸字符串,一律用RecordKind.INCOME代替。打错字 import 阶段就报错,不埋运行时雷。 - 值要参与 IO 用
StrEnum(3.11+):成员本身是字符串,JSON 存取零迁移。想强制唯一加@unique。 - 自定义异常是 API :业务异常继承
Exception(绝不继承BaseException),带上下文属性(record/bad_date/source),让调用方 catch 得到数据而非字符串。raise ... from ...保留异常链。 try/except/else/finally四件套各司其职 :else只在无异常时执行,finally保证清理。except 从具体到通用排序,别让后面的except变死代码。- 批量错误用
ExceptionGroup+except*(3.11+):一次报全所有问题,按类型分组处理,别一个个跑。单次操作直接raise就行,别硬套。
15. 下篇预告
v0.7 我们让账本"报错也报得明白"。但有个问题一直悬着:这些异常、校验、枚举,都是我们"自己说好"的,靠什么保证别人改代码时不破坏它?
下一篇,我们正式引入 pytest 测试框架:fixture、parametrize、monkeypatch、conftest。不是简单跑一下,而是建立一套"测试驱动开发"的工作流------先写测试、再改代码、跑绿了才提交。等你写完下篇,会发现自己写代码心里"有了底"------改一行,跑测试,绿了才敢提交。
互动问题:你在实际项目里,有没有踩过"魔法字符串打错字导致静默出错"的坑?花了多久才排查出来?评论区聊聊,下篇开头帮你复盘。
数据来源:本文所有代码均在本机 Python 3.12 实测运行(26 passed in 0.04s),枚举/异常行为参考 Python 官方文档 enum 与 exceptions 章节;StrEnum 与 ExceptionGroup 为 Python 3.11 引入的特性,均已在本机验证。