一个经典场面:同事在 mac 上写的数据处理脚本跑得好好的,交给 Windows 同事一运行------UnicodeDecodeError 当场炸掉,或者更糟,读出来一版不报错的乱码 。脚本一行没改,变的只有操作系统。90% 的人会把锅甩给「Windows 编码怪」,然后加一句 encoding="utf-8" 了事。这篇把这个事故完整解剖:四个容易混淆的编码函数、双向实测的崩溃矩阵、以及一个正在倒计时的大变化------Python 3.15 起,UTF-8 已成为默认编码(PEP 686,RC 于 2026-08 发布),这场持续二十年的事故正在被官方终结。
文章目录
-
- 一、先分清:四个「编码」是四件不同的事
- [二、双向实测:9 次崩溃,1 次静默乱码](#二、双向实测:9 次崩溃,1 次静默乱码)
- 三、EncodingWarning:官方给的探雷器
- [四、3.15 终局:这场事故被官方判了死刑](#四、3.15 终局:这场事故被官方判了死刑)
- 五、口径与边界
- [六、30 秒带走版](#六、30 秒带走版)
一、先分清:四个「编码」是四件不同的事
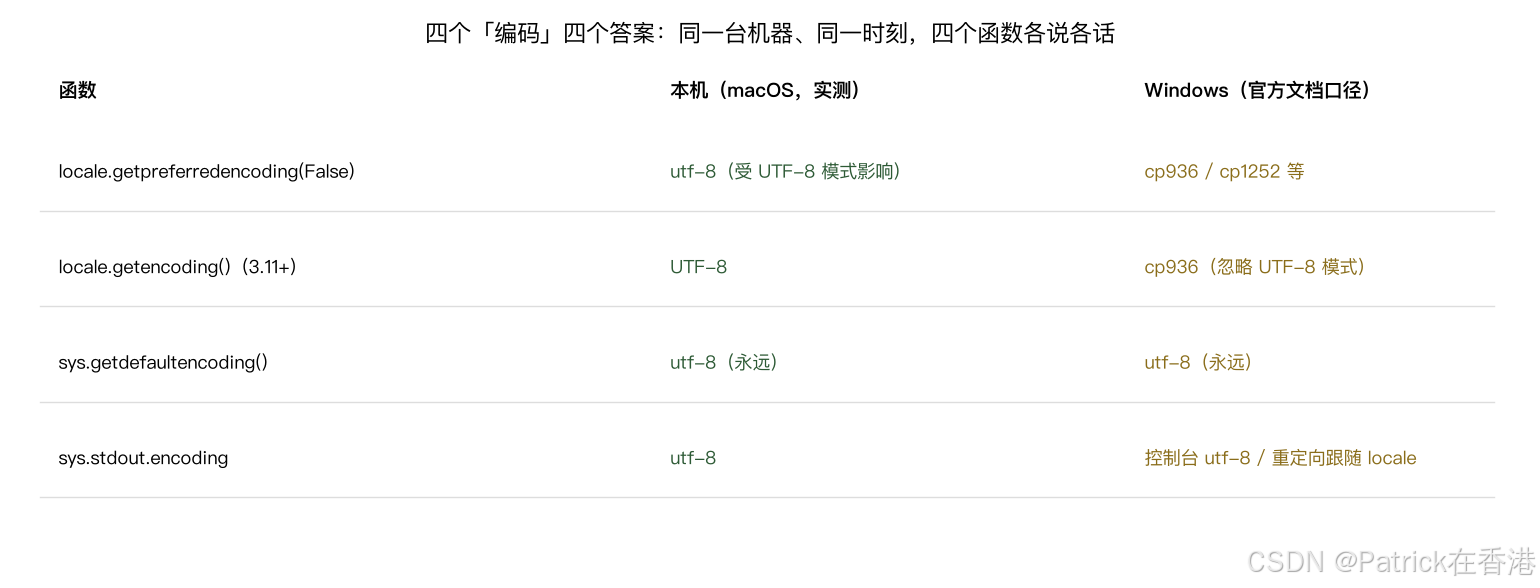
排查编码问题的第一步,是发现自己根本不知道该看哪个值。实测本机(macOS)四个函数的返回:
locale.getpreferredencoding(False)→ utf-8locale.getencoding()(3.11+ 新增)→ UTF-8sys.getdefaultencoding()→ utf-8sys.stdout.encoding→ utf-8
本机上它们恰好一致,但这只是 mac 的巧合。open() 不带 encoding 参数时用的是第一个 (locale 编码,受 UTF-8 模式影响);sys.getdefaultencoding() 是 Python 内部字符串的编码(永远 utf-8,与你读写的文件无关);getencoding() 则刻意忽略 UTF-8 模式、永远报告 locale 真身------3.11 专门加它就是为了在排查时能拿到「不被美化」的答案。在简中 Windows 上,第一个函数返回的是 cp936(GBK),其余照旧------四个值第一次不再一致,事故就从这里开始。
二、双向实测:9 次崩溃,1 次静默乱码
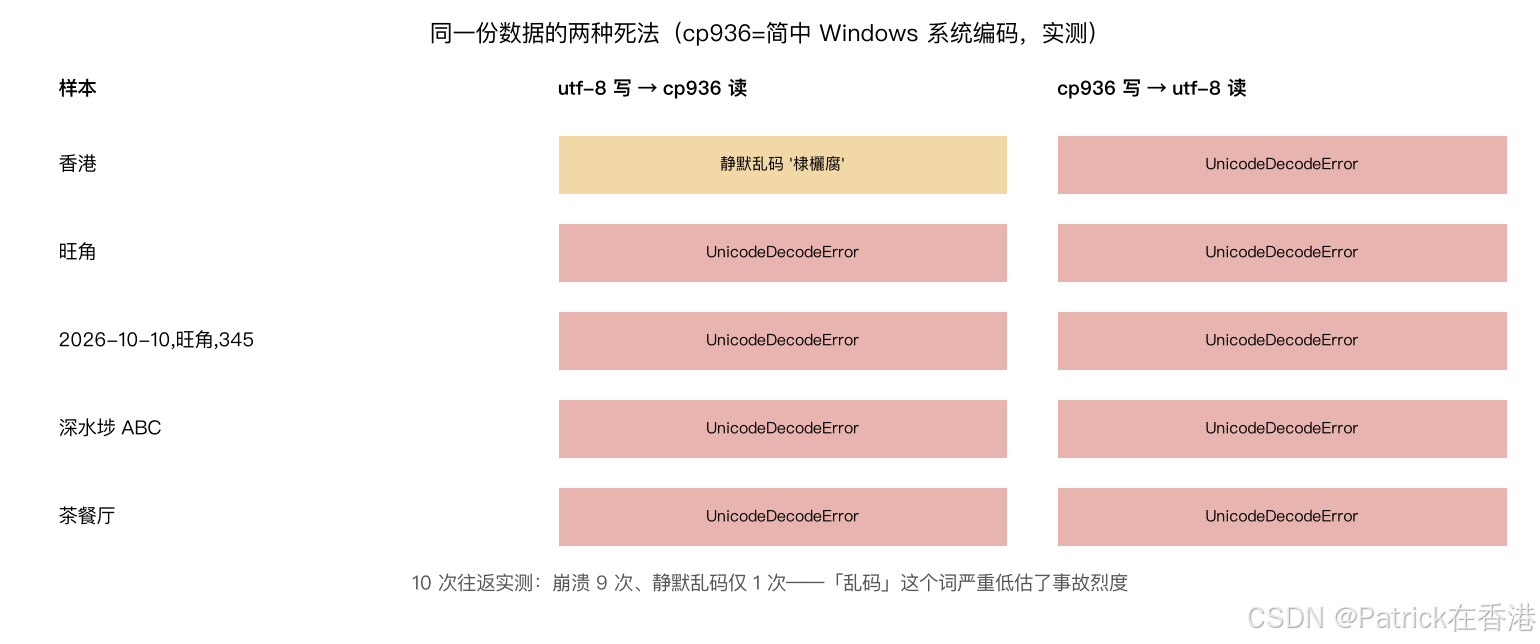
把「香港」「旺角」「茶餐厅」等五个含中文的样本,在 utf-8 与 cp936 之间做双向编解码往返(模拟 mac 写文件、Windows 读,以及反过来),10 次尝试的结果:9 次 UnicodeDecodeError 当场崩溃,仅 1 次静默乱码------「香港」的 utf-8 字节流被 cp936 读出「棣欐腐」。
两个反直觉:其一,崩溃才是常态 。五个样本的 9 崩 1 乱还不够狠,我把 CJK 统一表意区 20,992 个汉字全部跑了一遍双向往返:单字层面 utf-8 写、cp936 读的崩溃率是 100.0%------20,992 个字无一乱码 ;反方向(cp936 写、utf-8 读)崩溃 90.9%,剩 9.9% 是静默乱码。机制也清楚了:单个汉字的 utf-8 字节序列必然撞进 GBK 非法区间;而静默乱码只发生在多字组合 里------前一个字的尾巴和后一个字的开头在 GBK 里重新配对成「合法但错误」的双字节组,字节数对上、内容全错。「乱码」这个词严重低估了事故烈度,绝大多数事故是当场崩溃;真正危险的反而是那 10% 的静默乱码,它不报错、污染数据、等你三周后发现报表统计对不上。其二,报错位置不看内容长短:旺角崩在第 4 字节、CSV 整行崩在第 15 字节------错误位置由字节序列碰巧落进 GBK 的哪个区间决定,与文本含义无关。
三、EncodingWarning:官方给的探雷器
排查这类问题不需要人肉 grep。PEP 597(3.10 起)内置了 EncodingWarning:用 -X warn_default_encoding 启动,所有未写明 encoding 参数 的 open() 都会逐个报警------实测本机(locale 已是 utf-8)也照报不误:'encoding' argument not specified。这意味着mac 上也能提前找出「换到 Windows 会炸」的调用点,不用真的找一台 Windows 来炸一遍 。测试期再把警告升级为错误(-W error::EncodingWarning),CI 直接拦下。库作者的进阶姿势:用 io.text_encoding() 包装 encoding=None,让警告指向调用方而不是库自身。
四、3.15 终局:这场事故被官方判了死刑
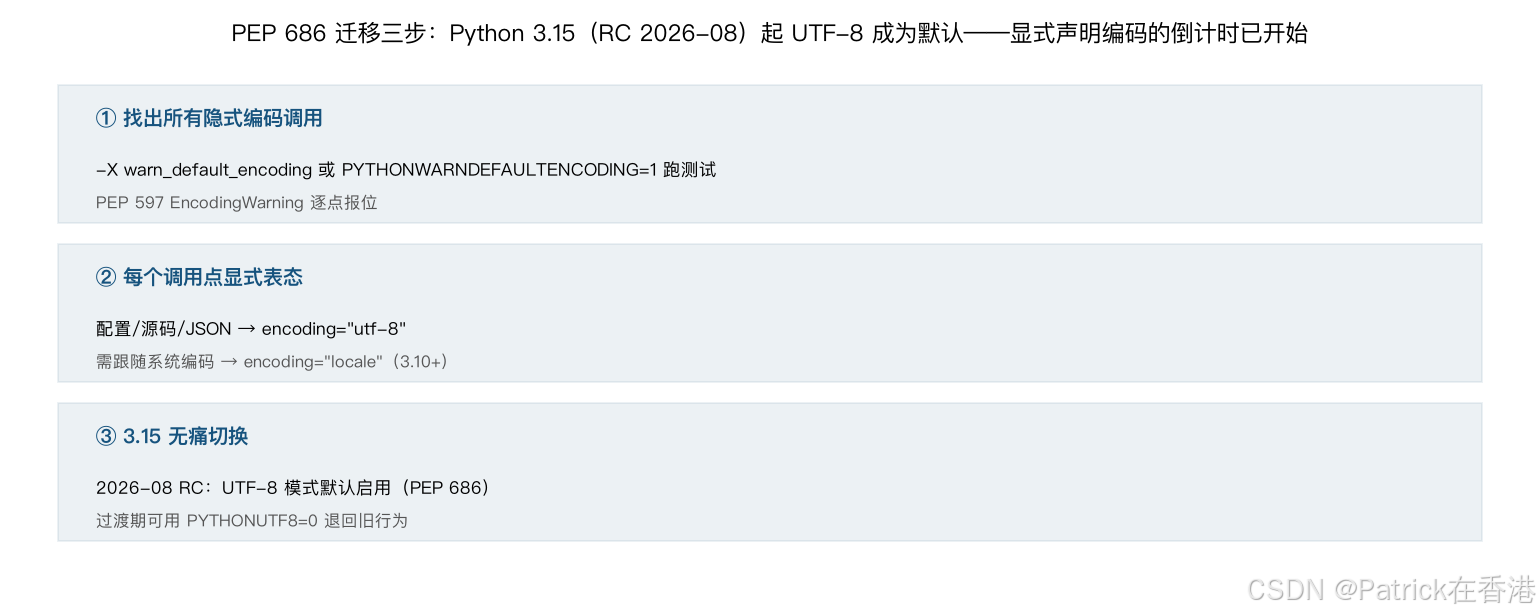
PEP 686 已随 Python 3.15 (RC 2026-08)落地:UTF-8 模式默认启用,open()、pathlib、subprocess(text=True)、configparser、logging.FileHandler、tempfile 的默认文本编码全部统一为 UTF-8------不再随 locale 漂移。影响面几乎全部集中在 Windows;macOS/Linux 的 UTF-8 locale 用户基本无感。先例已经排过两次雷:Ruby 3.0(2020)与 Java 18(2022,JEP 400)都做了同样的切换。
官方给的迁移路径也是三步:先用 EncodingWarning 找出所有隐式调用;再逐点显式表态------配置、源码、JSON 用 encoding="utf-8",确需跟随系统编码的(比如给老软件读的报表)用 encoding="locale"(3.10+,3.11 修好了在 UTF-8 模式下的行为);迁移期可用 PYTHONUTF8=0 整体退回旧行为当止痛药。换语言的先例一致:显式声明编码是终局,退路只是过渡。
五、口径与边界
实测在本机 macOS 完成,Windows 侧的 cp936 行为以受控模拟复现(显式用 cp936 编解码),未在真实 Windows 机器跑,但编码表行为有官方文档背书;「9 崩 1 乱」的分布取决于样本,换一批字符串比例会变,方向性结论(崩溃远多于静默乱码)在多轮试验中稳定 ;UTF-8 模式默认化只改文本 I/O 默认值,二进制模式(rb/wb)与显式声明编码的调用完全不受影响。
六、30 秒带走版
open()默认编码随平台漂移:mac utf-8、简中 Windows cp936------同一份脚本两种命;- 双向实测 10 次往返:9 次崩溃 + 1 次静默乱码------崩溃是常态,静默乱码才是大祸;
- 四个编码函数四个答案,排查用
locale.getencoding()拿「不被美化」的真身; - 探雷器:
-X warn_default_encoding(EncodingWarning)+ 测试期-W error::EncodingWarning; - Python 3.15(PEP 686)起默认 UTF-8------从今天起新代码全部显式写
encoding="utf-8",这是倒计时内的零成本保险。
参考链接
本文实验环境:Python 3.13.12(macOS,locale utf-8);Windows 侧 cp936 行为以受控编解码模拟,未跑真实 Windows;样本有限,「9 崩 1 乱」分布会随样本变化,方向性结论稳定。