(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:RoboTok: An Internet-Scale Data Engine for Human Demonstration Retrieval and Dexterous Manipulation Learning
论文作者:莱斯大学RobotPI Lab与NVIDIA
发表时间:2026年9月2日
目录
本文要点
(1)RoboTok是莱斯大学RobotPI实验室和NVIDIA在2026年9月发布的数据引擎,输入一段人的操作视频,从网络片段里找回手部运动相近的人类演示,用来训练灵巧手策略。
(2)10万条Action100M片段上mAP@20为0.353 ,Recall@20为0.996 ,最强基线STRAP只有0.007和0.12。
(3)做法上两点最值得看,只凭手腕轨迹估计躯干坐标系,以及用DTW监督去学一个可余弦检索的运动空间。
(4)短板在相机几乎不许动,公开材料停在10万条轨迹,项目页的真机结果还没放出来,双臂交接的未见物体上还输给随机检索。
(5)文末附GitHub README的训练命令和模型卡的权重加载写法。
莱斯大学RobotPI实验室和NVIDIA在2026年9月2日把RoboTok的技术报告挂上arXiv。我把HTML版、GitHub README和Hugging Face模型卡对着读了一遍,想看运动空间怎么学、查询时怎么搜。
机器人演示一直贵。Open X-Embodiment、DROID把平行夹爪的数据堆了起来,灵巧手和人手形态接近,缺的是覆盖长尾操作的人手运动。
RoboTok拿一段人的操作视频当查询,从网络视频里把手部运动相近的片段找回来,再拿去训灵巧手策略。
截至2026年9月16日,Hugging Face论文页有122个赞。
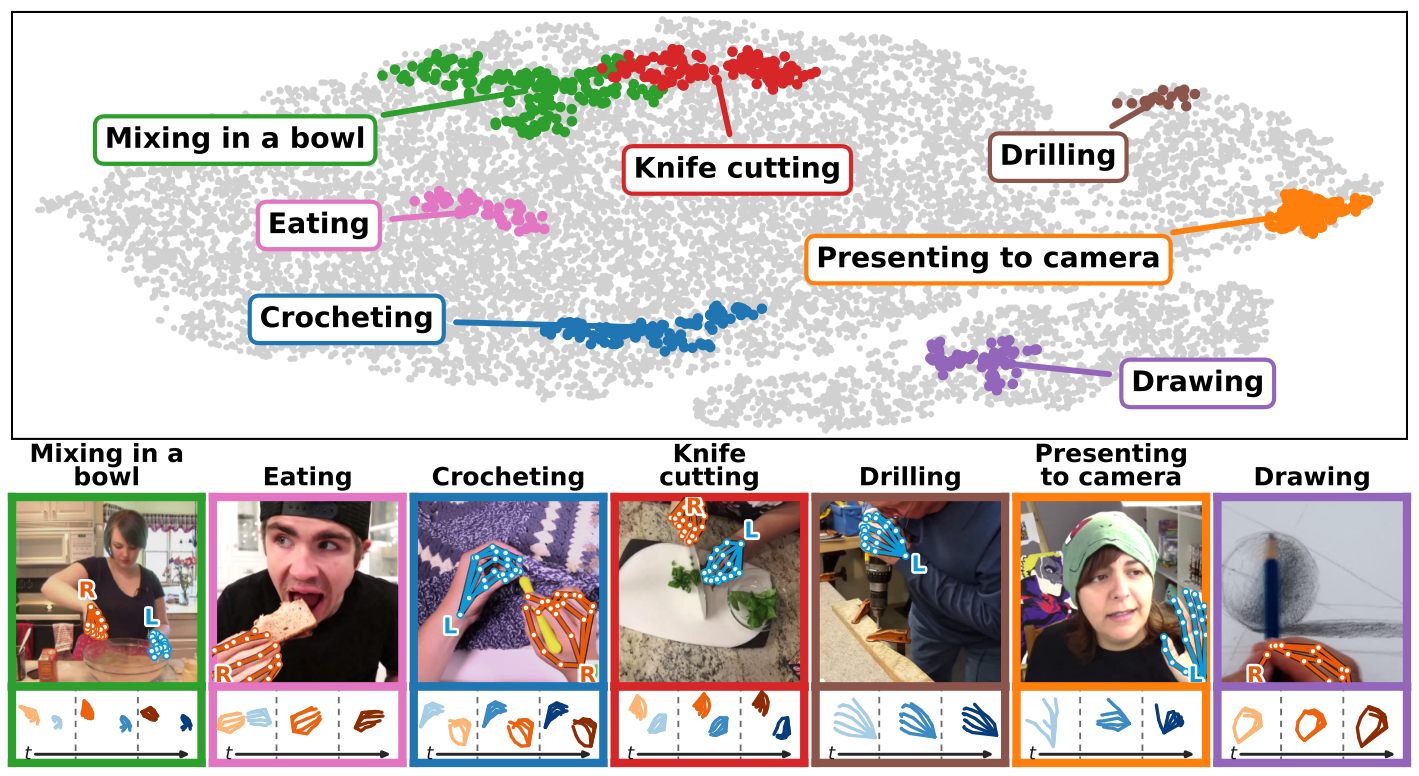
一、互联网人手视频检索框架
机器人学习吃演示。采一份新任务的真机数据贵,场景一换又得重采。从已有数据里检索相似片段,是近几年常见的省钱办法。
FlowRetrieval用光流找运动相近的演示,STRAP拿视觉基础模型特征做子轨迹匹配,HAND先按画面过滤再比二维手路径。这几家主要在固定的机器人语料里搜,操作对象也多是平行夹爪。
互联网上的人手视频每天都在长。HowTo100M、Action100M覆盖的物体、视角和动作,专门搭采集场很难铺到同样宽。麻烦在于,画面像不代表手在做同一件事。
报告自己写,据他们所知RoboTok是第一个专门从互联网人手视频里挖灵巧操作演示的检索框架。查询是人手视频,比的是躯干坐标系里的三维手轨迹。
二、跨视频手部姿态归一化
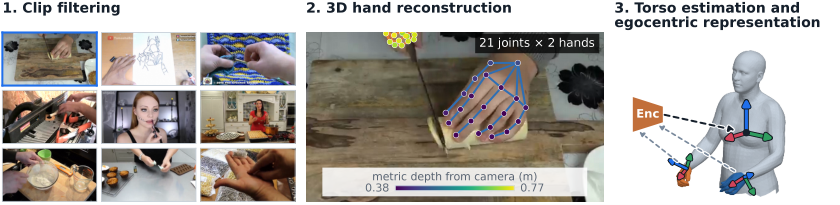
训练数据来自Action100M里已经筛过含人体动作的片段。再自动留下时长4到8秒、相机几乎不动、左右手各至多一只的片段,重叠时优先留长的。
最后拿到10万 条。其中1万条训练全程不碰,只当评测查询。
每段用WiLoR按每秒5帧估三维手关键点,MoGe-2补度量深度,缺的帧用HaWoR填上。得到的还是相机坐标系里的手,换个机位就对不上。
他们另训了一个很轻的躯干估计器,只吃两只手腕的轨迹,预测演示者一个静止的躯干坐标系。人被挡住也没关系,只要手还在。轨迹进了这个坐标系,才谈得上跨视频比运动。
三、DTW监督的余弦检索运动空间
DTW是动态时间规整。两条手部轨迹快慢不同,它先把时间轴拉开再累加姿态距离,得到运动有多像的分数。
理想检索就是按这个分数取最近的K条。对10万条每条都算一遍,查询时扛不住。
他们把DTW当成离线老师,训一个轻量编码器,把轨迹映到单位球面上,让内积大小尽量保住DTW给出的远近次序。查询时变成余弦近邻。新片段过一次编码器就能进索引,不必重训。
语料10万条,随机抽一个196的批次几乎碰不到DTW意义上的近邻。他们按锚点组批,每个锚点取DTW最近的20条当相关集。
从里面抽2个正例,再在相关集外侧紧挨着抽1个难分的反例,49组凑满196。损失是集合项加排序项,前者管谁该进邻域,后者管邻域里谁该排前面。
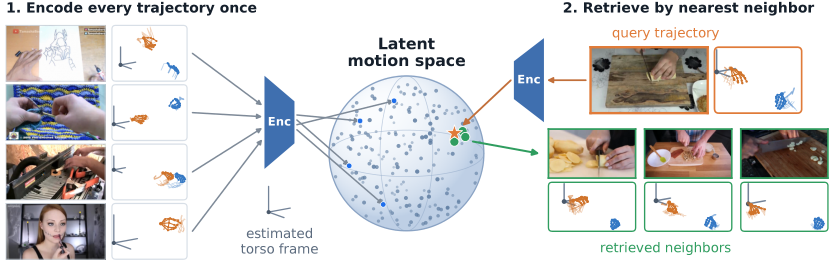
模型卡把编码器写清楚了。输入形状是[T, 126],21个关节乘三维坐标乘两只手,最长42帧,一层4头交叉注意力,压成256维向量。检索权重11MB,躯干估计器9.9MB。
四、Action100M上mAP@20达0.353
评测有两份语料。一份是上述10万条里留出的1万条查询,相关集定为DTW最近的20条,这份没有传感器级真值,报告称为伪真值。
另一份是AssemblyHands的831条双手装配片段,带传感器级三维手标注,相关集定为最近的5条。
| 方法 | 语料mAP@20 | 语料DTW代价@20 | AssemblyHands mAP@5 | AssemblyHands DTW代价@5 |
|---|---|---|---|---|
| Random | 0.0000 | 4.776 | 0.0025 | 1.911 |
| Flow | 0.0004 | 6.612 | 0.0131 | 1.850 |
| HAND | 0.0009 | 4.528 | 0.0214 | 1.830 |
| STRAP | 0.0071 | 4.044 | 0.1330 | 1.304 |
| RoboTok | 0.3531 | 1.333 | 0.2614 | 1.095 |
| GT上界 | 1.000 | 1.145 | 1.000 | 0.966 |
RoboTok的mAP@20是0.353 ,STRAP只有0.007。Recall@20是0.996,几乎每条查询都能在前20里捞到对应的DTW近邻。Kendall τ是0.487,说明捞回来的邻居次序也对得上。
DTW代价按米计。RoboTok前20的均值1.333米,真近邻1.145米,随机4.776米,比真近邻贵16%。Flow那一栏比随机还差,光流在这份三维轨迹任务上基本没帮上忙。
AssemblyHands上排序不变。mAP@5是0.261,STRAP是0.133。DTW代价1.095米,真近邻0.966米,比最优贵13%。这份标注更硬,差距收窄了,但仍压过所有对照方法。
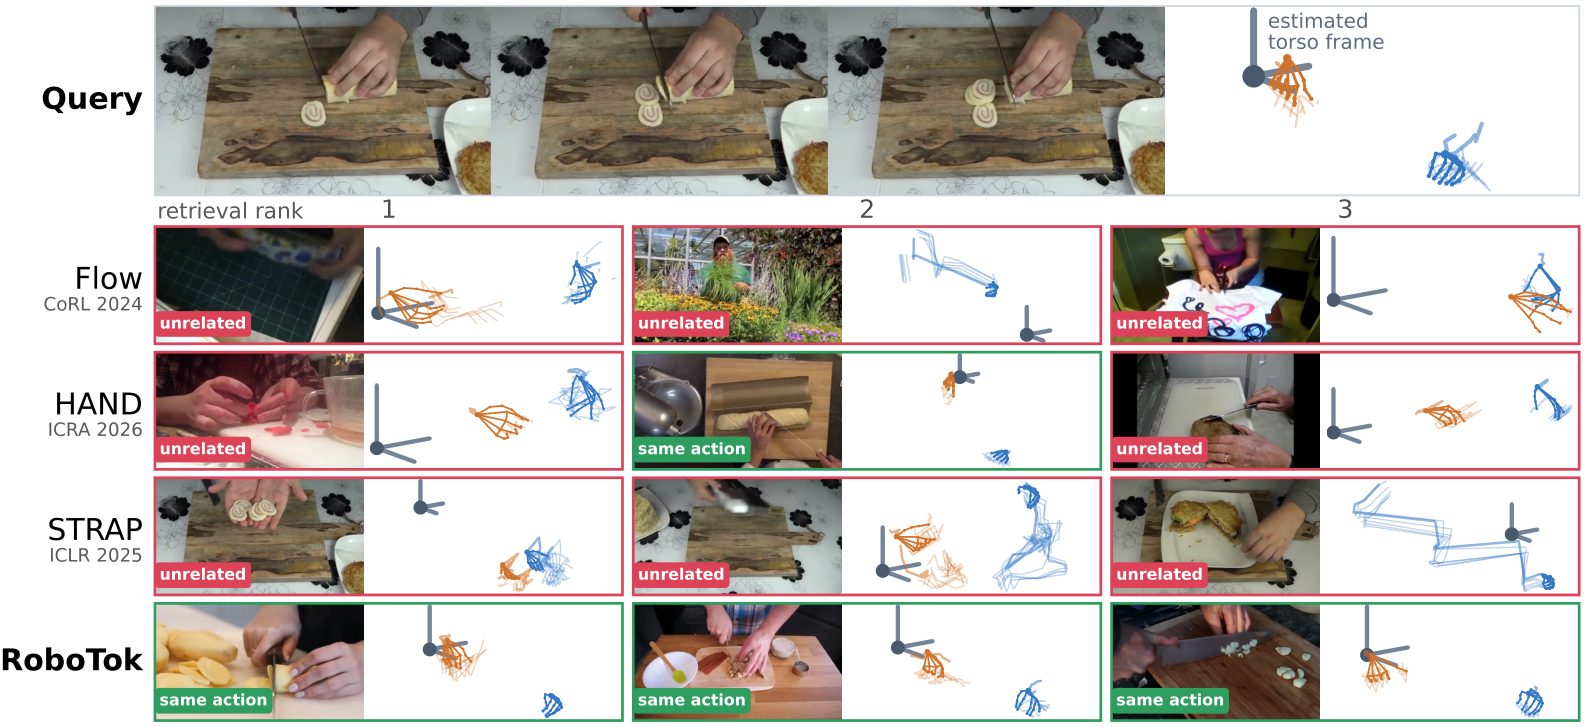
报告表2里还列了Recall@k、nDCG@20、CKNNA@20,正文只留上面这些。定性例子是切菜刀,RoboTok按手轨迹找回相似切法,基线更容易被场景和物体带跑。
五、VTDexManip检索驱动策略
检索回来的片段得能帮上策略,数字才站得住。
他们在VTDexManip仿真里用PPO从头训。策略输入是本体感觉和指尖力,观察窗3步,不用相机画面。
检索片段只进奖励,没有机器人演示,也没有动作标签。方法之间的差别,只来自找回了哪些片段。
原始设定把手钉在固定位置,还配了稠密任务奖励。报告说这个设定已经饱和。六项任务里RoboTok在五项上超过该基准最好的预训练基线,见物体平均高出7.45%,未见物体高出5.83%。
输的两项值得单独记。桌面重定向的见物体上,VT-JointPretrain是85.0,RoboTok是82.6。双臂交接的未见物体上,随机检索是42.1,RoboTok是34.8。
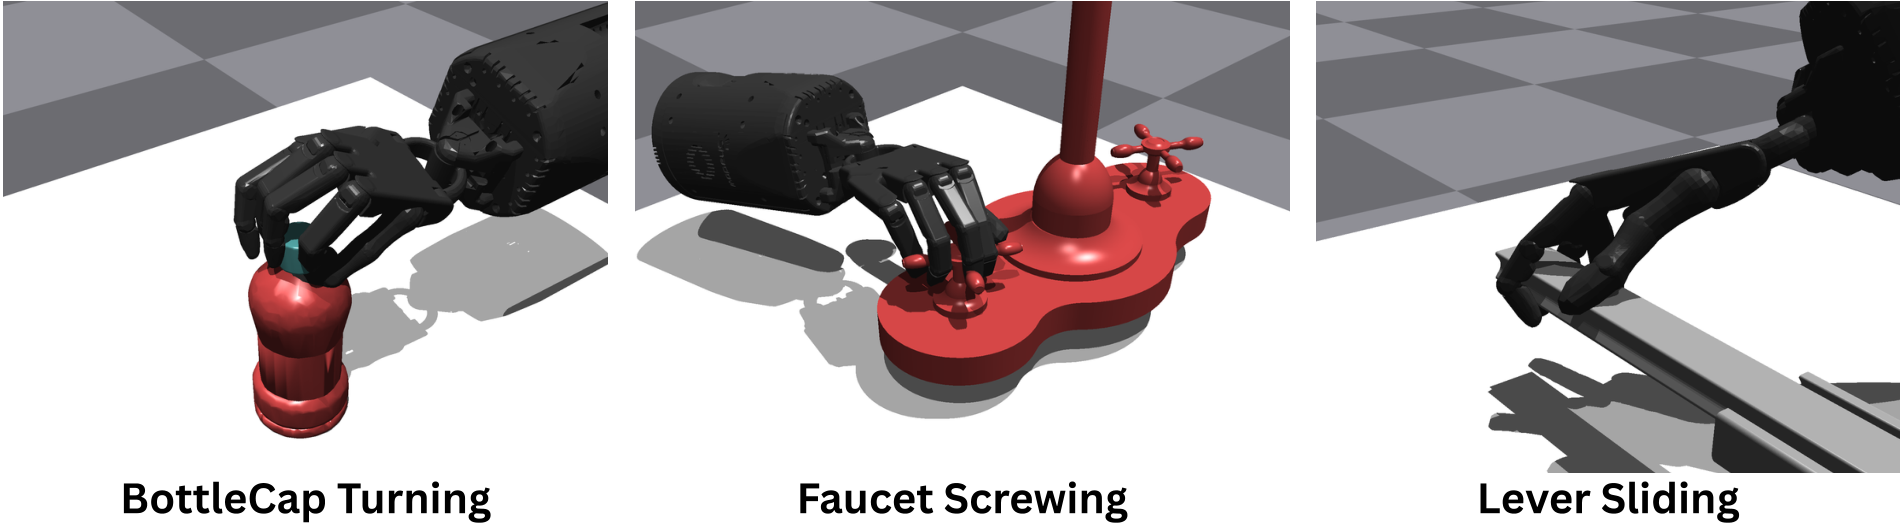
他们又改了三项更依赖手腕运动的任务,放开三维手部位移,去掉大量稠密奖励。八个随机种子,每个物体试100次。
下面只写均值,标准差见报告表5。
| 任务 | 划分 | Base | HAND | STRAP | RoboTok |
|---|---|---|---|---|---|
| 拧瓶盖 | 见物体 | 0.1 | 59.5 | 59.0 | 77.3 |
| 拧瓶盖 | 未见物体 | 0.0 | 27.0 | 25.0 | 38.1 |
| 拧水龙头 | 见物体 | 1.0 | 6.8 | 0.0 | 44.8 |
| 拧水龙头 | 未见物体 | 1.7 | 2.6 | 0.0 | 10.9 |
| 拨杆滑动 | 见物体 | 0.8 | 19.5 | 8.4 | 79.3 |
| 拨杆滑动 | 未见物体 | 2.1 | 25.2 | 6.5 | 58.3 |
困难设定上差距才拉开。拧瓶盖见物体77.3% ,比HAND高17.8个百分点。拧水龙头见物体44.8%,HAND只有6.8。拨杆滑动见物体79.3,HAND是19.5。
未见水龙头仍只有10.9,检索能把探索从接近零拉起来,泛化还远没做完。
项目页写着真机视频和真机数字即将放出。报告正文没有真机成功率,这一项按未报告处理。
六、本地部署与推理实践
以下两段分别来自GitHub README和Hugging Face模型卡。
仓库说明依赖装好后进入retrieval_training训练,配置路径相对仓库根目录,也可用ABMR_PROJECT_ROOT改根。
CUDA机器把faiss-cpu换成faiss-gpu。DTW核是numba的CUDA实现,需要GPU。
留出划分是按片段做的随机切分,同一视频的不同片段可能分到两边,README让去config.py看这条提醒。仓库默认配置里batch_size是210,论文正文写的是196,复现时以仓库为准。
bash
pip install -r requirements.txt
cd retrieval_training
python train.py --config configs/default.yaml
python -m pytest tests/ -q轨迹文件要放到outputs/training_data/depth_grounded_clip_keypoints.pt。模型卡上这份eval_data/torso_relative_clip_keypoints.pt是6.5GB。train.py第一次跑会按设计把轨迹和DTW邻居缓存算出来。
加载已有权重复用模型卡示例。
python
import torch

ckpt = torch.load("models/best_abs_retrieval_model.pt", map_location="cpu", weights_only=True)
ckpt["head_state_dict"]   # encoder weights
ckpt["config"]            # full training configuration

vn = torch.load("models/body_pose_est.pt", map_location="cpu", weights_only=True)
vn["model"]               # torso estimator weights
代码仓库是MIT。检索权重和轨迹点是Action100M的衍生材料,走FAIR非商业研究许可,模型和由它们得到的结果都限非商业研究。管身体的MANO和SMPL-H没随包提供,要自己去MPI-IS登记。
七、总结与思考
把网络人手视频当成可检索的运动库,比再搭一个采集场更对路。灵巧手缺的往往是某种拧、拔、交接在各种物体上的变体,这些变体人已经拍过了,缺的是按手怎么动把它们找回来。
躯干坐标系这个设计我买账。网络视频里人经常只露出一双手,按整段人体去归一化会直接废掉。只拿手腕去估一个静止躯干,等于承认查询条件很脏,这比很多实验室数据集诚实。
检索表要打折看。10万条语料上的真值就是DTW本身,编码器的训练目标也是复现DTW邻域,mAP从0.007跳到0.353,有一部分是在考自己出的题。
AssemblyHands有传感器级标注,那张表更硬一些。下游策略才是更像人话的证据,困难设定上HAND和STRAP几乎探不出拧水龙头,RoboTok能探到44.8%。
短板也明白。所谓互联网规模,公开出来的是过滤后的10万条近静态相机片段,查询时并没有去爬全网。结论里自己把移动相机列成下一步,第三视角和第一视角的晃动视频现在进不来。
公开产物是11MB检索器和6.5GB关键点,没有原始视频。你能复现的是在这份轨迹库上训练和检索,不能把RoboTok直接当成YouTube搜索框。
双臂交接未见物体上随机检索更高,说明运动近邻不等于任务近邻。仿真奖励还在追踪重定向后的手姿态,离用检索视频去训能看图的策略,中间还有一段没写完。
参考链接
- 技术报告原文 arXiv 2609.03199 v1,2026年9月
- 项目页 RoboTok
- 训练代码 Rice-RobotPI-Lab/RoboTok-Code
- 权重与轨迹 Rice-RobotPI-Lab/robotok-public
- 数据来源 Action100M
- 对照方案 FlowRetrieval、HAND、STRAP、VTDexManip、AssemblyHands