问题分析
如题,B端运营人员用富文本编辑出一篇文章,然后C端用户去访问,这中间涉及到多少技术点呢?
有人说这还不简单,直接前端用一个富文本的插件,保存的时候,直接把富文本存到数据库。访问的时候,直接请求富文本的内容,然后用v-html渲染出来。存的时候注意一下XSS攻击,去除多余的节点和属性。
确实这种方案,可以满足大部分的业务场景,且开发容易,代码清楚,但如果是访问量百万级、千万级的文章,问题就浮现出来了:
- 文章里如果携带图片怎么办?
- 文章怎么缓存?多次查看的时候多次请求,用户体验也很差。
- 文章看到一半退出了,下次回来能否定位到原来的位置?
以上种种问题,很难在用了v-html之后处理。因此我们想到的方案,就是把富文本转化成HTML,然后在HTML中处理这些问题。
重点问题1:把富文本转换成HTML
以前我们可能需要服务端协助处理,如今AI时代,前端也可以用AI生成一个nuxt项目,可以写接口,传入富文本,然后生成HTML。
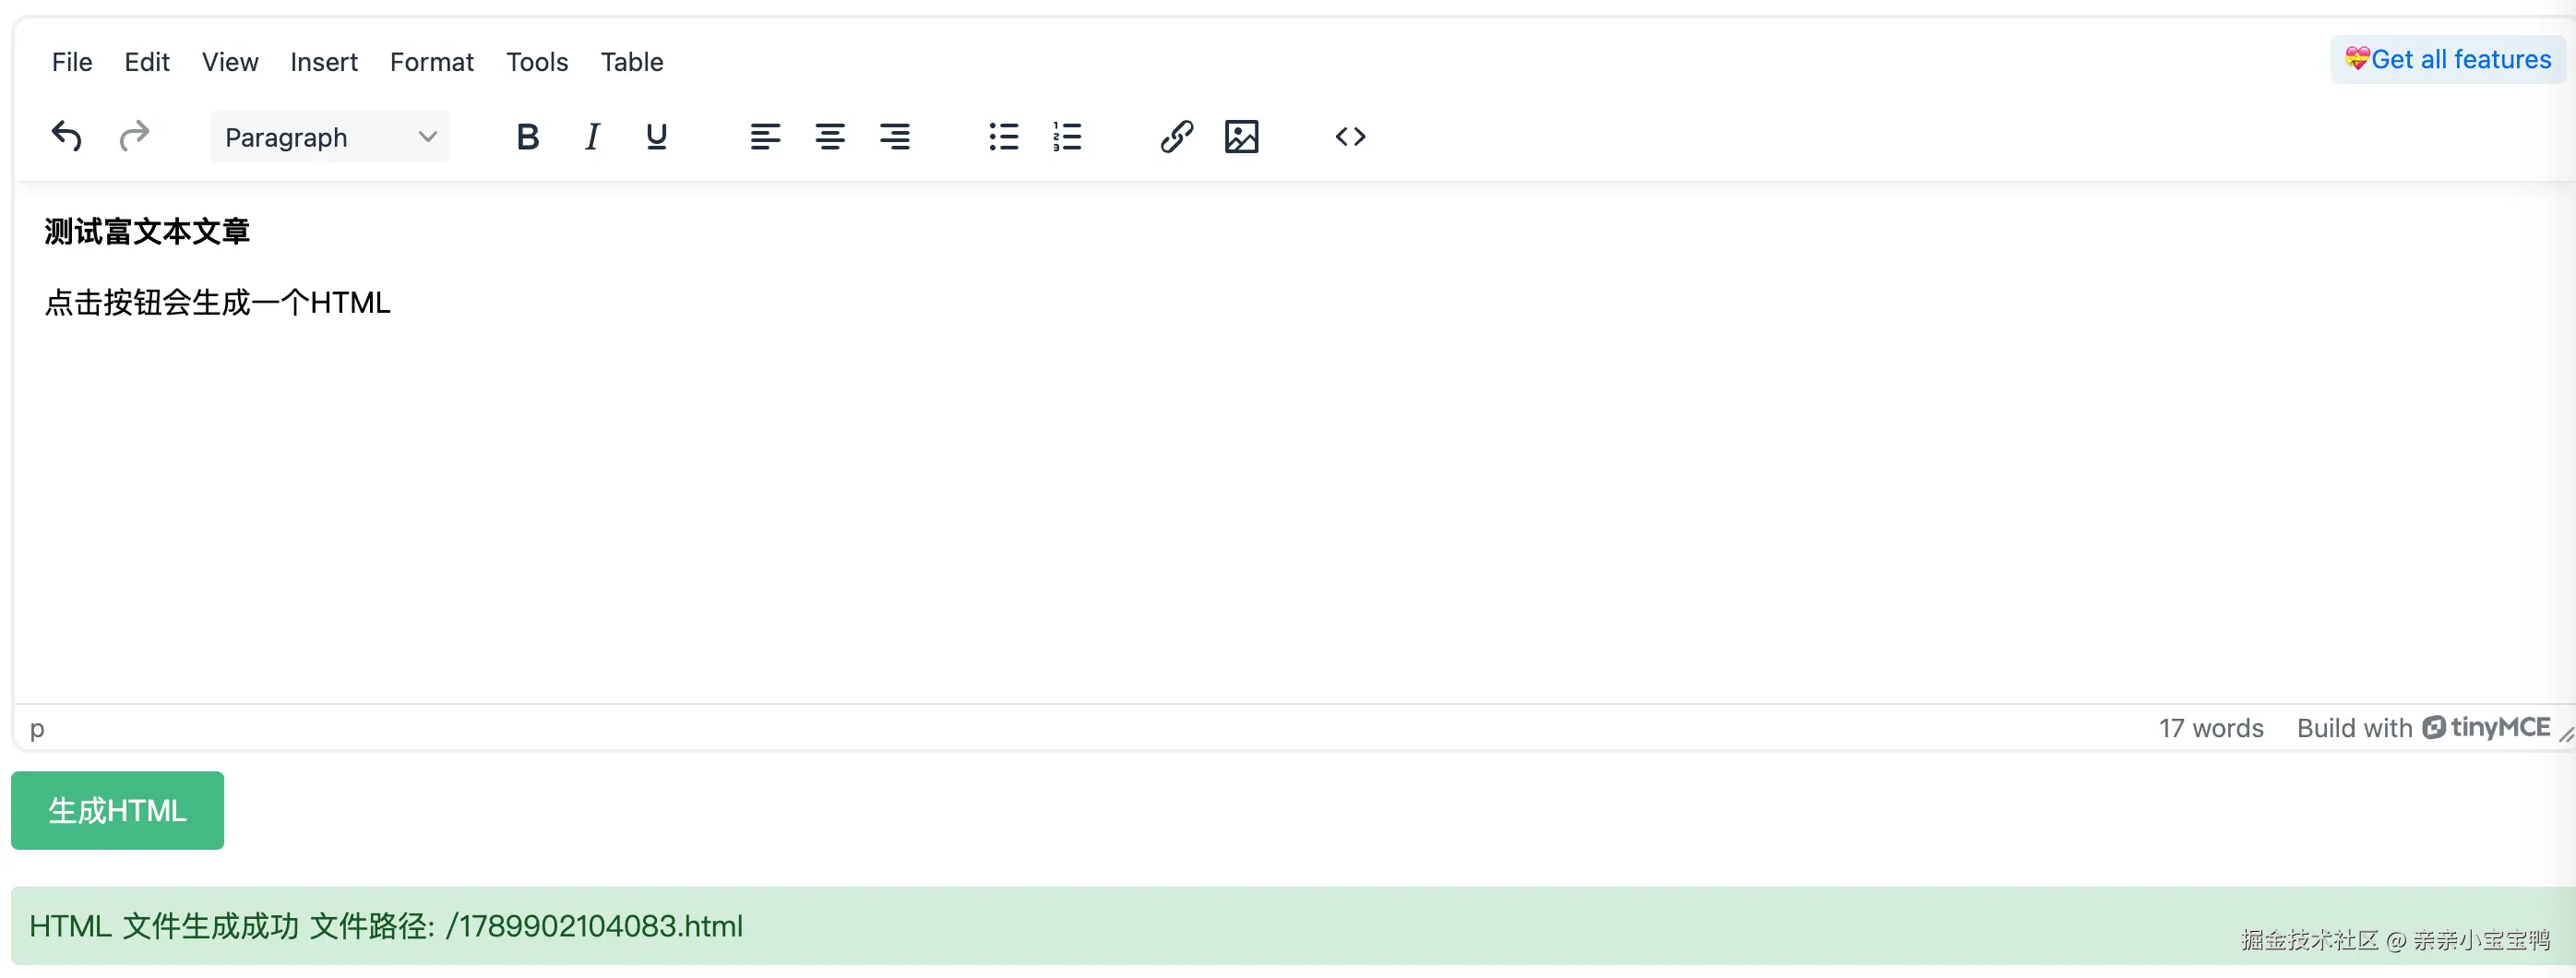
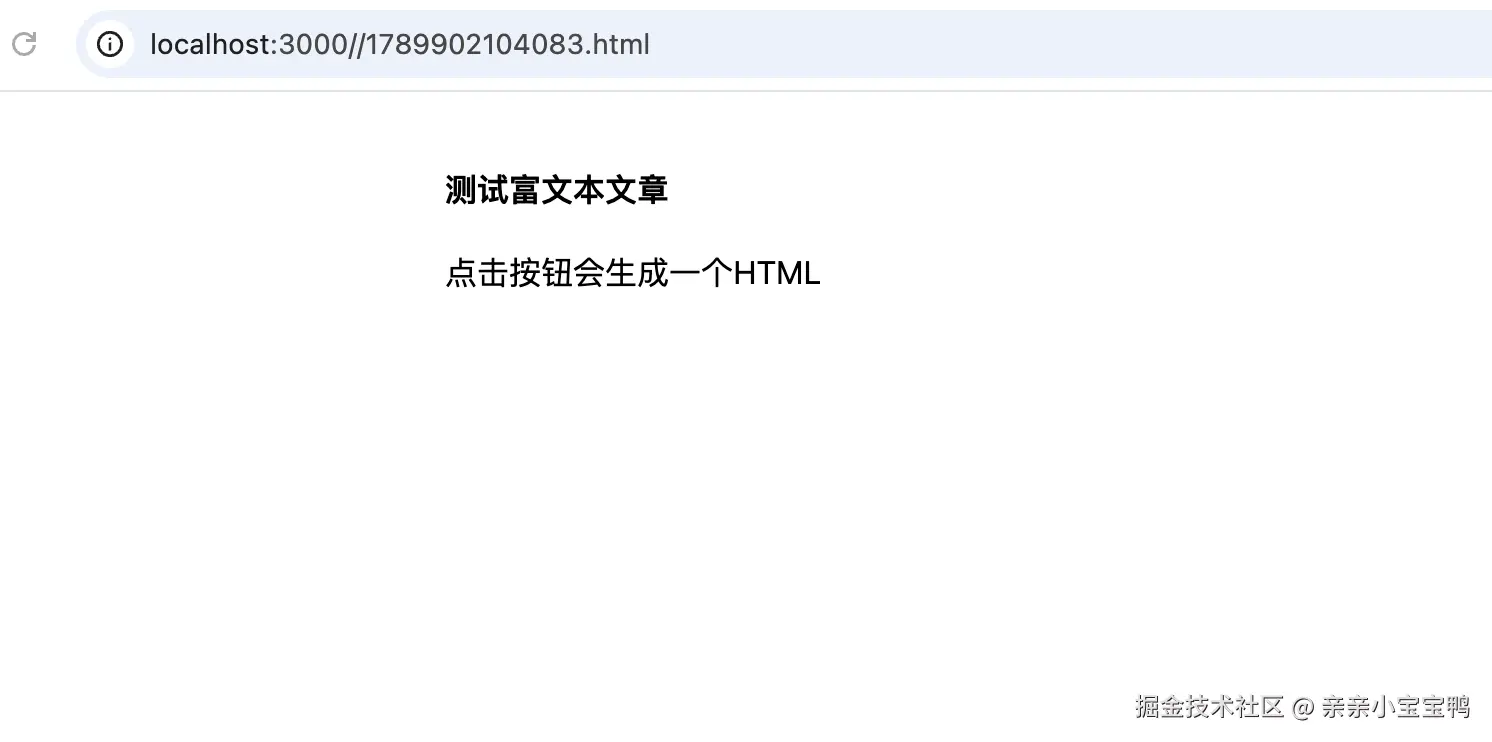
js
export default defineEventHandler(async (event) => {
  console.log('执行了')
  const body = await readBody(event)
  const { content } = body

  if (!content) {
    return {
      success: false,
      message: '请提供富文本内容'
    }
  }

  const timestamp = Date.now()
  const fileName = `${timestamp}.html`
  const filePath = join(process.cwd(), 'public', fileName)

  const htmlContent = `<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>Generated HTML</title>
  <style>
    body {
      font-family: -apple-system, BlinkMacSystemFont, 'Segoe UI', Roboto, 'Helvetica Neue', Arial, sans-serif;
      max-width: 800px;
      margin: 0 auto;
      padding: 20px;
      line-height: 1.6;
    }
  </style>
</head>
<body>
  ${content}
</body>
</html>`

  try {
    await writeFile(filePath, htmlContent, 'utf-8')
    return {
      success: true,
      message: 'HTML 文件生成成功',
      fileName,
      url: `/${fileName}`
    }
  } catch (error) {
    return {
      success: false,
      message: '文件写入失败',
      error: error instanceof Error ? error.message : '未知错误'
    }
  }
})
重点问题2:前后端都需要处理一些业务逻辑
富文本编辑时的前端部分
- 上传图片的时候,记录图片宽高比,放到富文本中;
- 处理img标签的时候,把src属性换成一个体积比较小的静态图片,然后把原来的src属性值放到
data-src;
上面两步操作,都是为后续的懒加载做准备;
- 记录页面滚动的位置,下次进入页面时恢复到指定位置
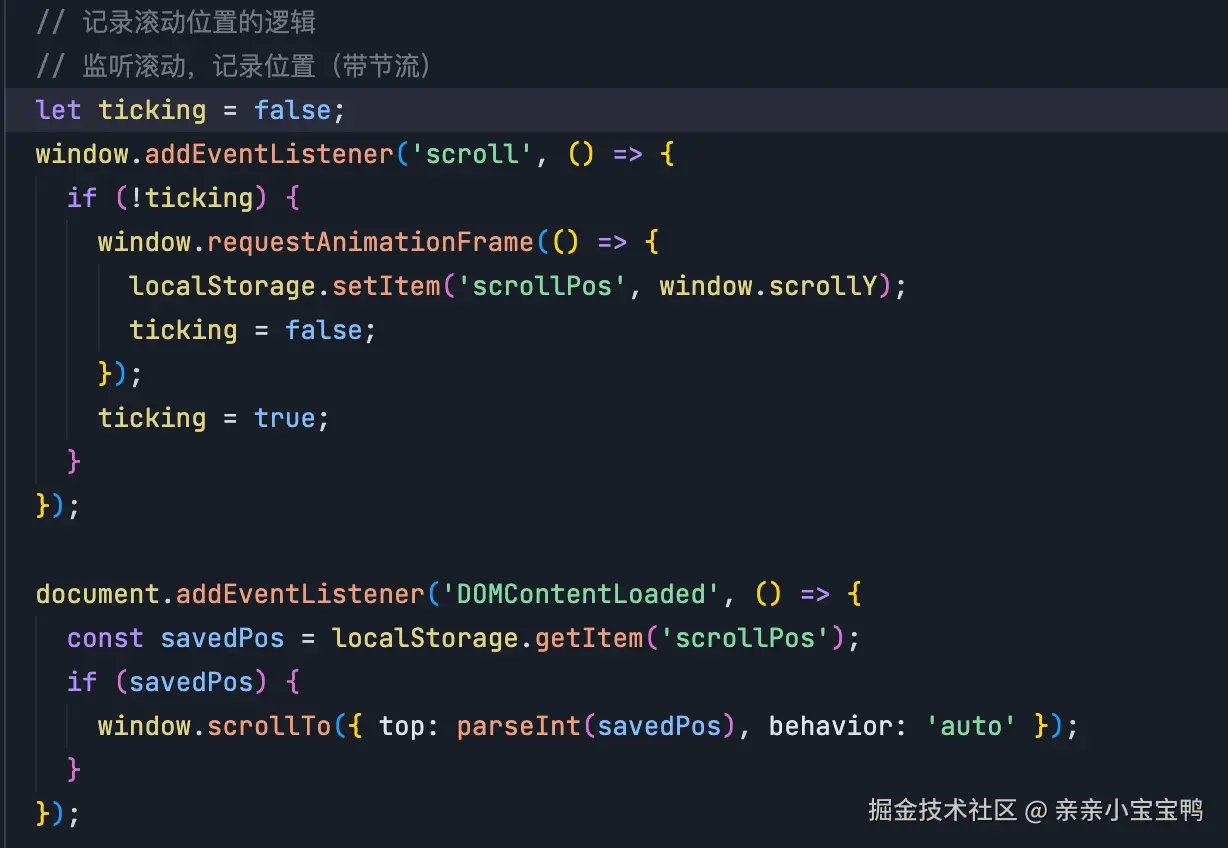
富文本保存时的后端部分
- 引用一个CSS,修改通用样式;
- 引用一个js,处理图片懒加载等逻辑(监听img是否在视口,如果出现,就替换img的src属性);
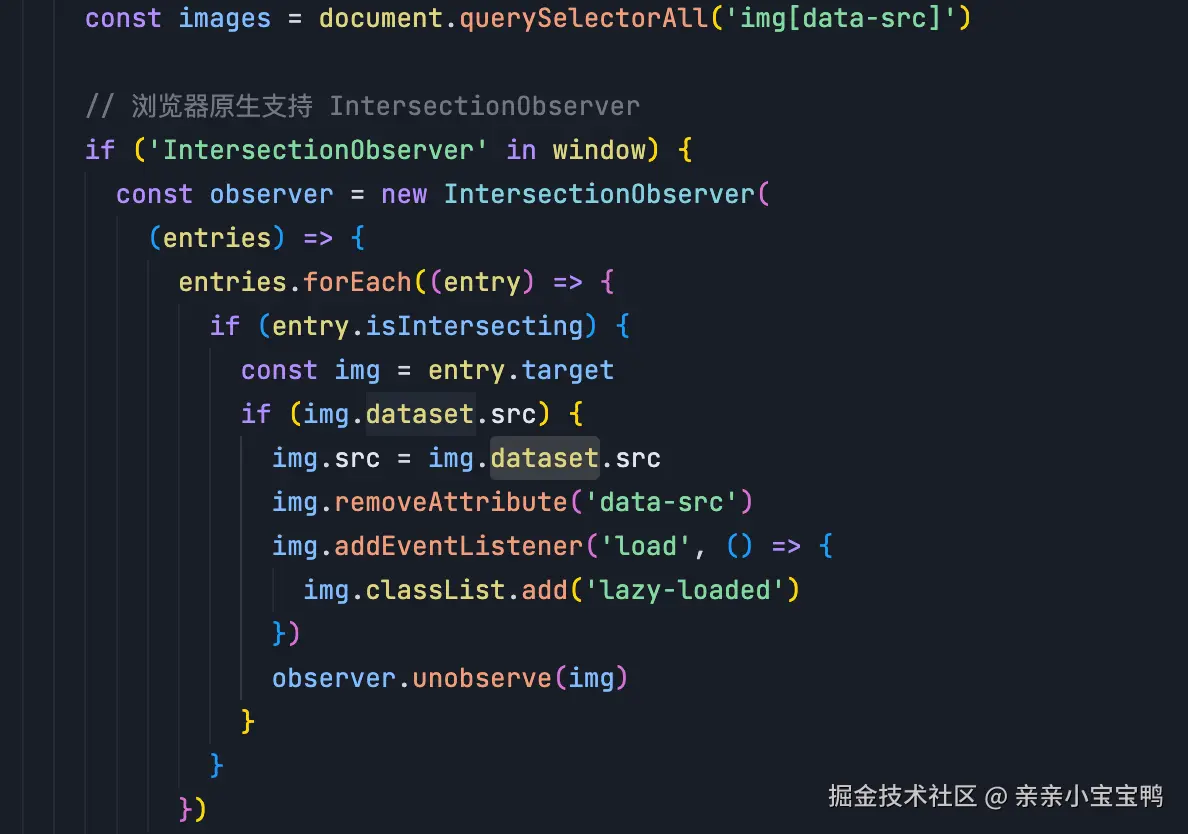
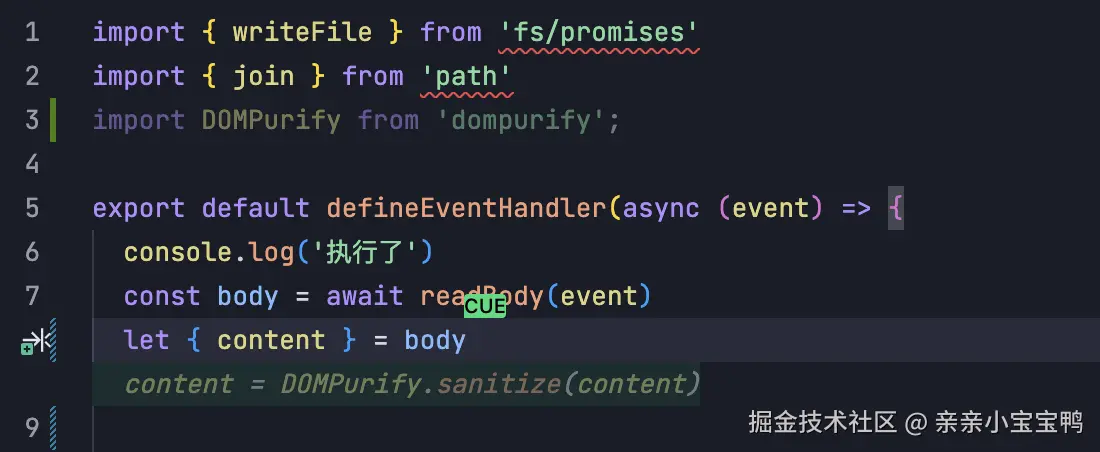
- 对富文本参数进行处理,防止oss攻击。(如下图,AI分析了我的意图,我引用了DOMPurify,光标放到第八行就生成了代码);
重点问题3:设置浏览器缓存
当文章都转换成HTML文件时,我们就可以设置浏览器缓存了:
协商缓存原理:
-
首次请求 :浏览器第一次访问资源时,服务器返回资源内容,并在响应头中带上资源标识(如
Last-Modified或ETag)。 -
再次请求 :当强缓存过期后,浏览器再次请求该资源时,会在请求头中带上之前的标识(如
If-Modified-Since或If-None-Match)。 -
服务器判断:
- 如果资源未修改,服务器返回
304 Not Modified,不返回资源内容,浏览器使用本地缓存 。 - 如果资源已修改,服务器返回
200 OK及新的资源内容,并更新响应头中的标识 。
- 如果资源未修改,服务器返回
这样,如果文章的内容没有发生变化,用户重复访问时,可以大大提升访问速度。除了HTML之外,引用的article.js等文件,都可以做到缓存。