版本:LangGraph4j 1.8.25 (Java 17+);业务侧对齐 Spring AI 2.0.1 。 目标:弄清图编排解决什么问题;先认能力全貌;再把
AgentState、StateGraph、CompiledGraph对上号。
单轮 ChatModel.call / ChatClient 适合「问一句、答一句」。流程一旦出现多步、分支、循环、人审、按会话恢复,堆在一个大方法或一串 if-else 里会很难改、很难测。
LangGraph4j 用状态图描述这类流程:
bash
节点:做一步计算(改状态)
边:决定下一步去哪
共享状态:各节点读写的同一份数据
节点算;边决定往哪走;Channels 决定结果怎么合进状态。
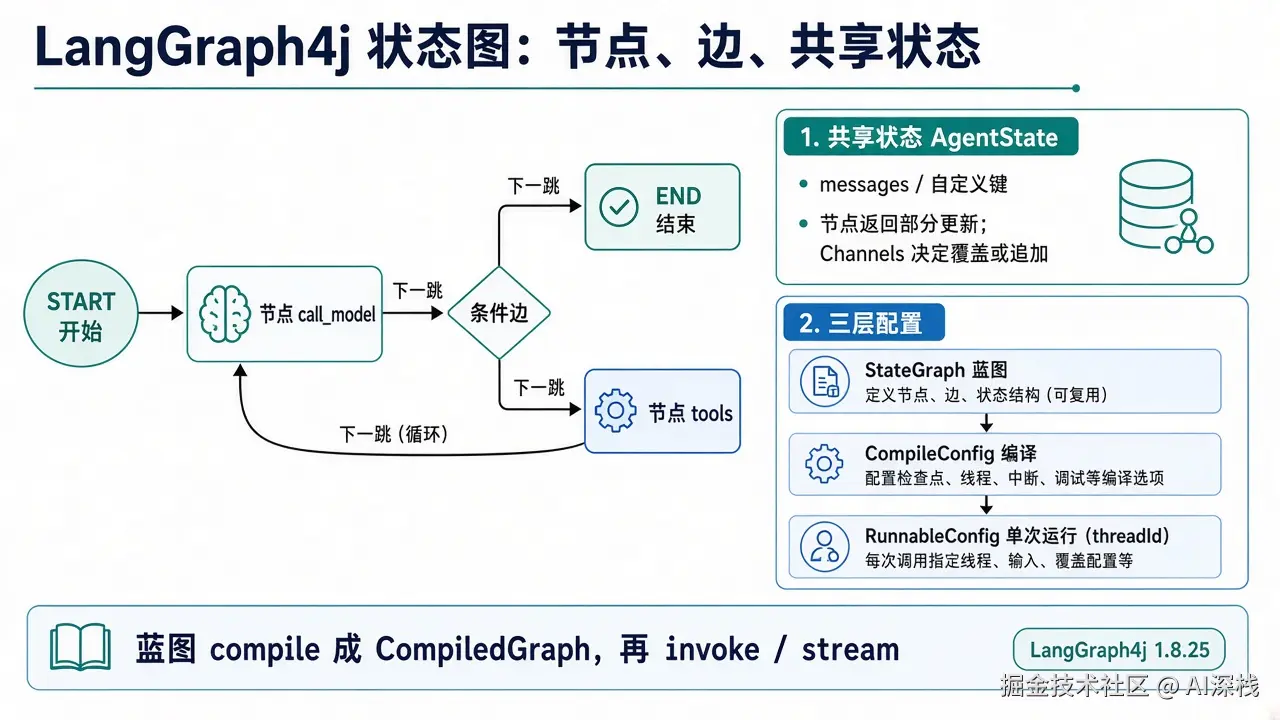
上图是常见拓扑:START → call_model → 条件边,一边到 tools(可环回模型),一边到 END。右侧是共享状态与三层配置。
14.1 能力覆盖范围
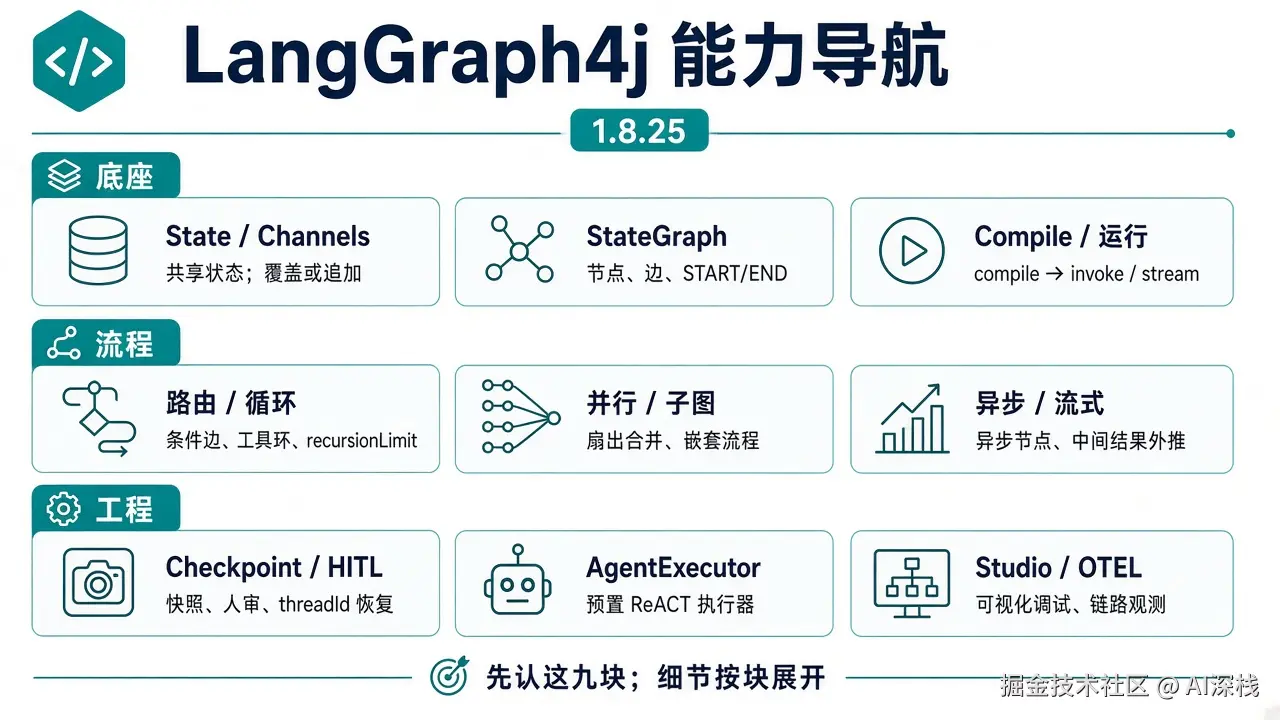
先认脸,不必背 API。九块按用途分成三层:
| 层 | 能力块 | 做什么 |
|---|---|---|
| 底座 | State / Channels | 共享状态怎么存、怎么合并(覆盖或追加) |
| 底座 | StateGraph | 节点、边、START / END,画出蓝图 |
| 底座 | Compile / 运行 | compile 成可执行图;invoke / stream |
| 流程 | 路由 / 循环 | 条件下一跳、工具环、recursionLimit |
| 流程 | 并行 / 子图 | 扇出合并、把子流程嵌进大图 |
| 流程 | 异步 / 流式 | 节点异步执行、中间结果往外推 |
| 工程 | Checkpoint / HITL | 快照落盘、人审中断、按 threadId 恢复 |
| 工程 | AgentExecutor | 预置 ReACT(模型 ↔ 工具)执行器 |
| 工程 | Studio / OTEL | 可视化调试、链路观测 |
怎么用这张图:
-
没有底座三块,其它都挂不上。
-
拓扑简单时,路由 / 并行可以后加。
-
要人审或要按会话恢复,才认真上 Checkpoint。
-
标准「模型叫工具再叫模型」可直接用 AgentExecutor;业务边很定制再自建
StateGraph。
14.2 核心抽象
bash
StateGraph(蓝图)
    → compile(CompileConfig)
    → CompiledGraph(可执行图)
→ invoke / stream(带 RunnableConfig)| 概念 | 类型 / 入口 | 管什么 |
|---|---|---|
| 状态 | AgentState + Channels |
键、默认值、合并规则(覆盖 / 追加) |
| 节点 | NodeAction(或异步变体) |
读状态,返回部分更新 Map |
| 边 | 固定边 / 条件边(EdgeAction) |
下一个节点 id,或 END |
| 命令 | Command |
边动作里可同时带「下一跳 + 状态更新」 |
| 端点 | START / END |
图的入口与出口(特殊节点 id) |
| 编译 | CompileConfig |
Saver、中断点、recursionLimit(默认 25) |
| 运行 | RunnableConfig |
尤其是 threadId(有 Saver 时的会话键) |
消息列表这类「越跑越长」的字段,用 Channels.appender(...)(或允许重复的 appenderWithDuplicate)。旧资料里的 MessageChannel 已删除,不要再按那个名字找 API。
节点返回的是增量 ,不是整份新状态;也不要改 state.data() 里的可变集合------合并交给 Channel。
三层配置不要混:
| 层 | 类型 | 何时定 | 典型内容 |
|---|---|---|---|
| 蓝图 | StateGraph |
写代码时 | 有哪些节点、边怎么连 |
| 编译 | CompileConfig |
compile(...) 时 |
CheckpointSaver、interrupt、递归上限 |
| 单次运行 | RunnableConfig |
每次 invoke / stream |
threadId、与本次恢复相关的参数 |
有 Saver 时,threadId 就是会话键 :同一用户连续对话应复用同一 threadId;多用户绝不能共用一个默认值,否则检查点会串台。
14.3 最小形态
下面这段不接模型,只说明「状态 → 节点 → 边 → 编译 → 运行」怎么串(START / END 来自 StateGraph 的静态常量):
java
import static org.bsc.langgraph4j.StateGraph.END;
import static org.bsc.langgraph4j.StateGraph.START;
public class HelloState extends AgentState {
public HelloState(Map<String, Object> initData) {
super(initData);
}
public Optional<String> greeting() {
return value("greeting");
}
}
Map<String, Channel<?>> schema = Map.of(
"greeting", Channels.base(() -> "")
);
NodeAction<HelloState> greet = state -> {
String name = state.<String>value("name").orElse("world");
return Map.of("greeting", "Hello, " + name + "!");
};
CompiledGraph<HelloState> graph = new StateGraph<>(schema, HelloState::new)
.addNode("greet", greet)
.addEdge(START, "greet")
.addEdge("greet", END)
.compile();
graph.invoke(Map.of("name", "LangGraph4j"))
.ifPresent(s -> System.out.println(s.greeting().orElse("")));
// → Hello, LangGraph4j!读这段时抓住四点:
-
schema声明每个键如何合并;节点只返回要改的键。 -
addNode/addEdge画蓝图;START/END是端点。 -
compile()得到CompiledGraph;无参编译 ≈ 默认CompileConfig(无 Saver,recursionLimit = 25)。 -
invoke(初始数据)跑一轮,拿到最终状态。
接模型、工具循环、Checkpoint,都是在这个骨架上加节点与配置,而不是换一套运行时。
14.4 和 Spring AI 怎么分工
| 问题 | 放哪 |
|---|---|
| 调哪家模型、Tool、RAG、MCP、流式 SSE | Spring AI |
| 多步流程、环、条件分支、人审中断、按 thread 恢复、子图 | LangGraph4j |
| 节点里要不要调模型 | 图节点内调用 ChatModel / ChatClient,或使用预置 Agent 执行器 |
java
Spring AI   = 模型与周边能力(会不会说、会不会用工具、会不会检索)
LangGraph4j = 流程资产(先干什么、再干什么、失败 / 人审怎么走)
标准 ReACT(模型 ↔ 工具循环)可用预置 Agent 执行器直接得到一张图;拓扑与业务边强绑定(审批、多专家分工、子流程复用)时,再自建 StateGraph。
14.5 何时上图
| 场景 | 是否上图 | 原因 |
|---|---|---|
| FAQ、单轮问答 | 否 | 一次 call / stream 即可 |
| 记忆 + 少量 Tool | 通常否 | ChatClient + Advisor 已够 |
| 多分支(审单 / 拒答 / 转人工) | 是 | 分支要显式边,不能靠模型自觉 |
| 工具循环要可控退出 | 是 | 要管轮次、终止条件与中间态 |
| 人审通过后再继续 | 是 | 需要中断点与按 threadId 恢复 |
| 并行扇出再合并 | 是 | 需要并行节点与状态合并规则 |
上图的成本是:状态 schema、失败策略、测试与观测。需求还没到这一步时,先把 Spring AI 主链做稳更划算。
14.6 小结
| 记住 | 含义 |
|---|---|
| 能力块 | 九块先认脸;底座是 State → Graph → Compile |
| 状态图 | 节点算、边路由、Channels 合并 |
| 蓝图 → 编译 → 运行 | StateGraph → CompiledGraph → invoke / stream |
| 三层配置 | 图结构 / 编译选项 / 单次 threadId 分开 |
| 与 Spring AI | 能力底座 vs 流程编排,不是互相替代 |