【轻量化复现大模型 / KIMI K3】训练模块梳理 & Muon P2P 优化器
0x00 论文溯源
我们首先来看看K3 论文中,与训练相关的内容。
0.1 原始论文
| 论文 | 相关章节 | 核心内容 |
|---|---|---|
| Kimi K3: Open Frontier Intelligence | §3.1 Pre-Training Data | 四域文本语料 + 大规模视觉语料 |
| 同上 | §3.2 Scaling Law | 2.5× 缩放效率提升,cosine 优于 WSD |
| 同上 | §3.3 Training Recipe | Native multimodal、Per-Head Muon + weight clipping、QB、1% warmup cosine、weight decay 0.1 |
| 同上 | §3.4 Long-Context Extension | 四阶段课程(8K/64K pre-train → 256K/1M cooldown) |
| 同上 | §2.3.3 Quantile Balancing | Eq.14 一步均衡 + 直方图估计 + 延迟一步因果性 |
| 同上 | §2.5 Per-Head Muon | 逐 head 正交化、平衡各 head 学习动力学 |
| 同上 | §5.2 Infra for 3T-class Pre-Training | 统一激活管理器、MoE 内存优化、Pipeline ZeRO-2、P2P Muon |
| Kimi Linear Paper | §2 KDA | log-decay 下界参数化(Eq.5),训练稳定性 |
0.2 直接相关的图表
| 编号 | 内容 |
|---|---|
| K3 图 7 | K2 vs K3 缩放定律曲线 |
| K3 表 1 | K2 vs K3 架构参数对照 |
| K3 §2.3.3 Eq.14 | QB 精确更新公式 |
| K3 §3.3 | 训练配方一览表 |
| K3 §3.4 | 四阶段课程 8K→64K→256K→1M |
K3 表 1
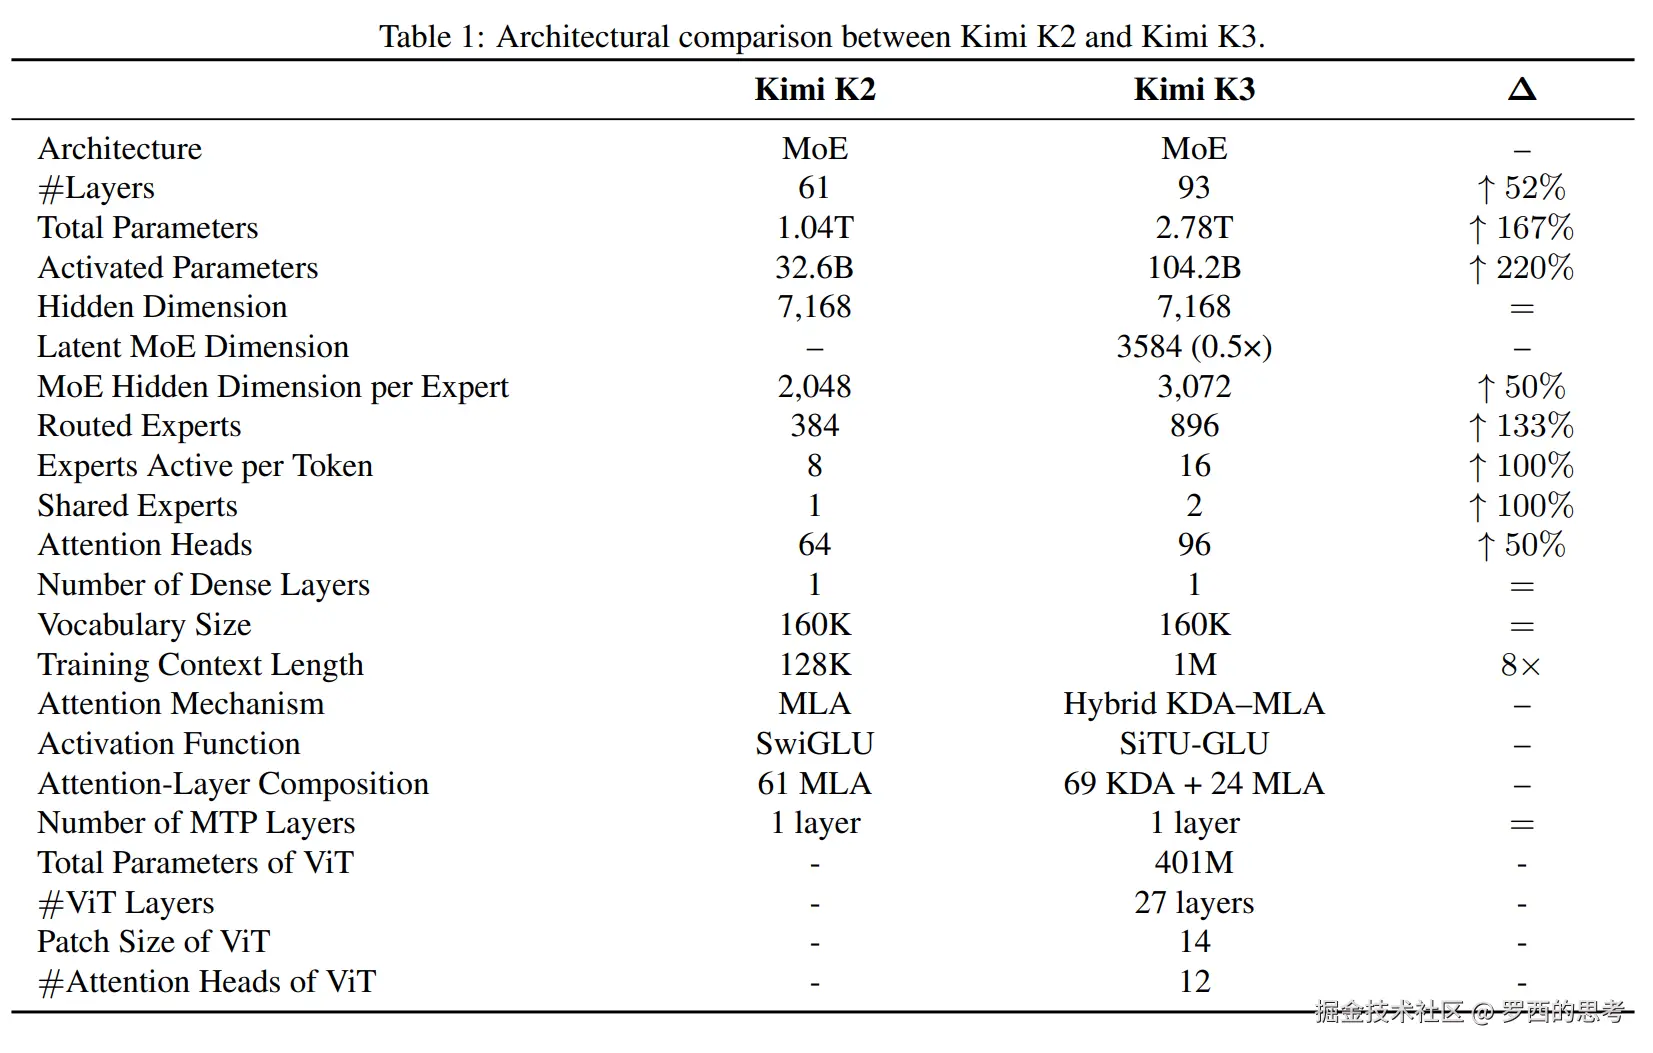
paper-tab-1
K3 图 7
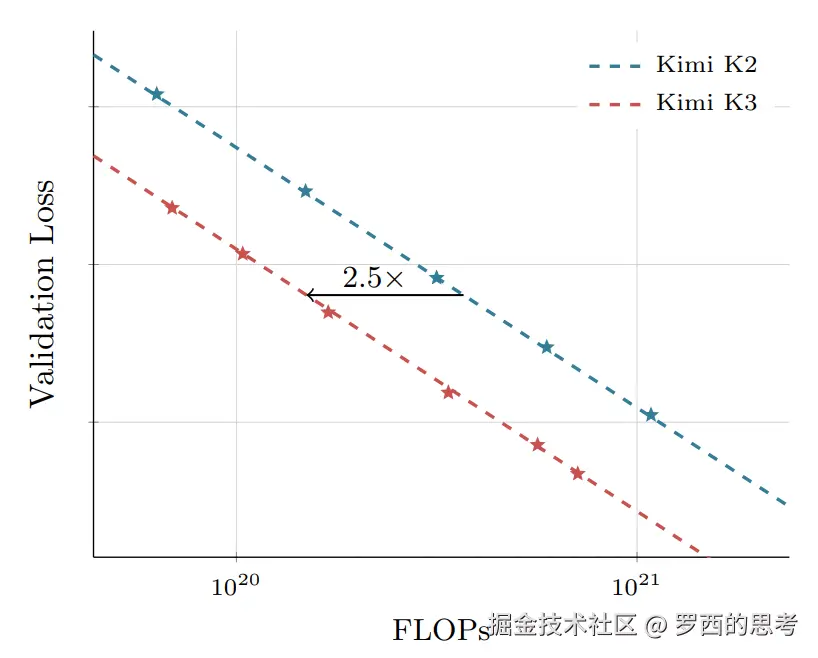
paper-fig-7
0.3 完成度
- 代码实现度:loop.py 和 metrics.py 核心功能完整。
- 论文对齐度:训练配方与论文一致;TrainConfig 中 eval_every/save_every/out_dir/compile/dtype 声明但 loop.py 未使用。
0.4 注意说明
注:
- 项目github.com/RossiLH/Mod... 和系列博客是我的一个尝试,也是我学习的过程。不确定是否满足读者的需求,我自己会反思改进,也希望大家提出宝贵意见。
- 涉及 KIMI K3,DeepSeek V4,PI0.5,PI0.7 等模型。后续可能会跟踪新模型。
- 全 CPU 复刻,不涉及 GPU,也不涉及大规模训练(这是另外一个庞杂深邃的领域)和硬件。
- 模型的组件尽量是原始大模型的缩小版,如果组件没有开源版本,则用近似组件替代。
- 会解释每个组件在解决一个什么问题、这个问题难在哪、为什么只能这么解、解法的原理是什么,以及组件之间如何咬合成一个整体。重点不是记名词,而是理解一条主线。
- 每个主要组件都有可直接运行的 Gradio demo------无需 GPU。另有若干可视化脚本(
plot_*.py),可生成静态图。 - 所有文件行号基于本地源码快照;源码后续变化时,行号可能移动,但函数名和调用关系仍可作为定位入口。
- 为了保证每个文章可以尽量独立成文,所以有些内容会在不同文章中都存在,可能在系列层面上存在冗余,还请大家理解。
0x01 知识点拆解
bash
train(训练模块)
    ├── 1.1 训练主循环
    │   ├── Trainer(训练器:模型/优化器/课程/日志/Checkpoint 一体)
    │   │   └── 代码位置:train/loop.py:60-268
    │   ├── TrainState(step/tokens/best_loss/stage/history)
    │   │   └── 代码位置:train/loop.py:31-38
    │   ├── train_step(零梯度→前向×N→clip→set_lr→step→router bias)
    │   │   └── 代码位置:train/loop.py:117-174
    │   ├── train(主循环 + 课程阶段切换)
    │   │   └── 代码位置:train/loop.py:178-221
    │   └── _fit_dataset(课程 resize 静默回退)
    │       └── 代码位置:train/loop.py:223-230
    ├── 1.2 评估 & Checkpoint
    │   ├── evaluate(eval_loss / eval_ppl)
    │   │   └── 代码位置:train/loop.py:234-246
    │   └── save / load(权重 + 优化器状态 + TrainState)
    │       └── 代码位置:train/loop.py:250-268
    ├── 1.3 设备 & 资源
    │   ├── resolve_device(auto → CUDA/CPU 智能选择)
    │   │   └── 代码位置:train/loop.py:46-57
    │   └── set_gradient_checkpointing(用存储换显存)
    │       └── 代码位置:model.py:309-310 / loop.py:84
    │       └── ⚠ 实际未接入 torch.utils.checkpoint(见 §2.11 Q4)
    ├── 1.4 训练指标
    │   ├── RunningMean(滑动窗口均值)
    │   │   └── 代码位置:train/metrics.py:19-42
    │   ├── MetricLog(JSONL + 内存历史 + series/smoothed)
    │   │   └── 代码位置:train/metrics.py:45-75
    │   ├── expert_balance(MoE 负载均衡聚合)
    │   │   └── 代码位置:train/metrics.py:78-96
    │   └── decay_stats(KDA alpha 衰减分布)
    │       └── 代码位置:train/metrics.py:99-123
    │       └── ⚠ 仅基于 alpha_bias,不含输入依赖项(见 §2.11 Q5)
    └── 1.5 外部依赖
        ├── build_optimizer(Per-Head Muon + AdamW fallback)
        │   └── 代码位置:optim/param_groups.py:102-127
        ├── lr_lambda_for(cosine / wsd 调度)
        │   └── 代码位置:optim/lr_scheduler.py:146-171
        ├── ContextCurriculum(四阶段上下文扩展)
        │   └── 代码位置:data/curriculum.py:38-96
        ├── PackedDataset / PackedBatch(打包 + 文档隔离)
        │   └── 代码位置:data/packing.py:99-217
        ├── Kimi3ForCausalLM.forward(LM loss + MTP loss)
        │   └── 代码位置:model.py:312-362
        └── update_router_biases(QB 延迟一步更新)
            └── 代码位置:model.py:271-280
代码对应表如下:
| 子知识点 | 代码位置 (file:line) | 变体/切换入口 |
|---|---|---|
| 训练器 Trainer | train/loop.py:60 | cfg.train.device / cfg.train.gradient_checkpointing |
| 单步 train_step | train/loop.py:117 | cfg.data.grad_accum |
| 主循环 train | train/loop.py:178 | cfg.train.curriculum |
| 评估 evaluate | train/loop.py:234 | --- |
| Checkpoint save/load | train/loop.py:250 / train/loop.py:263 | --- |
| 设备选择 resolve_device | train/loop.py:46 | "cpu" / "cuda" / "auto" |
| TrainState | train/loop.py:31 | --- |
| RunningMean | train/metrics.py:19 | window 参数 |
| MetricLog | train/metrics.py:45 | path 参数(None = 仅内存) |
| expert_balance | train/metrics.py:78 | 依赖 router.load_balance_stats() |
| decay_stats | train/metrics.py:99 | 依赖 KimiDeltaAttention.alpha_bias / a_log |
| Per-Head Muon 优化器 | optim/param_groups.py:102 | cfg.optim.per_head |
| LR 调度 cosine/wsd | optim/lr_scheduler.py:146 | cfg.optim.schedule |
| ContextCurriculum | data/curriculum.py:38 | lengths / fractions / cooldown_from |
| PackedDataset | data/packing.py:99 | seq_len / pad_id |
| LM + MTP 损失 | model.py:343-352 | cfg.model.mtp.enabled / loss_weight |
| QB 路由器 bias 更新 | model.py:271 / modules/router_qb.py:229 | cfg.model.moe.qb_enabled |
0x02 原理讲解
2.1 要解决的问题
训练一个像 K3 这样的混合架构 MoE 大模型,远不是「数据喂进去、loss 反传」那么简单。它面对的是一组相互牵扯的工程难题:
- 混合架构的优化稳定:KDA(线性注意力)+ MLA(稀疏注意力)+ LatentMoE + AttnRes 放在一起训,各子模块对学习率的敏感度完全不同。Muon 管矩阵参数、AdamW 管 1D/embedding/router,还要 Per-Head 正交化让各 attention head 的更新尺度均衡------否则大 head 的梯度会淹没小 head。
- MoE 负载均衡:896 个 routed experts,靠辅助损失的传统做法会和主 loss 抢权重、收敛慢。K3 用 Quantile Balancing(QB)无辅助损失地直接把负载一步拉到均匀,但要解决「因果性」(本批不能用本批算出的偏置路由自己)和「大规模下怎么通信」(直方图 all-reduce)两个问题。
- 长上下文训练经济化:要训到 1M token 上下文,但全程用 1M 训太贵。所以用四阶段课程,长序列阶段只占总预算的小尾巴。而且因为是 NoPE(无位置编码),阶段切换时不需要像 RoPE 那样做插值/微调 base。
- 资源与精度的权衡:显存不够怎么办?梯度累积、gradient checkpointing、智能设备选择(auto 模式自动回退 CPU)。
- 训练状态可观测、可恢复:loss 平滑、MoE 均衡、KDA 衰减分布都要实时监测;checkpoint 要能保存也能完美恢复(权重 + 优化器状态 + step + best_loss)。
总体解决方案:
一个 Trainer 类把「模型 / 优化器 / 课程 / 数据 / 日志 / Checkpoint」六件事打包在一起,每个 optimizer step 内部严格按「前向×N → clip → set_lr → step → QB 延迟更新」的顺序走,课程在 step 边界切换,指标在 log_every 时聚合。
"
2.2 思路背后的原理(三视角)
2.2.1 直觉视角
- 把训练想象成调钢琴 ,Per-Head Muon 像给每根琴弦独立调音。如果整把琴一次调(full-matrix 正交化),粗的琴弦会因为质量大主导调音方向,细的琴弦得不到足够关注。逐 head 调(per-head),每根都有自己的正交化,力度均衡。
- Quantile Balancing 像自助餐分菜。896 个专家就是 896 道菜,每个 token 选 top_k 道。要让每道菜被拿的次数差不多,QB 每批结束后算一下「每道菜还差多少」,直接把价格(bias)调到恰好让下一批均匀------而不是一点点调(fixed-step rule)。
- 课程学习 像学跑步:先走 8K,再跑 64K,最后冲刺 1M。前面短序列便宜、学得快,把 90%+ 的计算预算花在前面,长序列只占小尾巴。
- 梯度累积 像攒钱买大件:显存不够一次买(大 batch),就分几次攒(小 batch 多次反传),攒够了再一起更新参数。
2.2.2 准专业视角(数学 + shape)
符号约定:
- 总参数 θ,矩阵参数 θ_M(Muon 组),非矩阵参数 θ_A(AdamW 组)
- 单步 token 数 m,序列长度 T,micro-batch 数 G(= grad_accum)
- 有效批大小 M = m × G
(1)Per-Head Muon 更新
对每个 2D 参数矩阵 W ∈ R^(d_out × d_in):
ini
m_t = β₁ · m_{t-1} + (1-β₁) · g_t           # 动量
m̃_t = g_t + β₁ · m_t                       # Nesterov,可选
M_t = NS(m̃_t, steps=5)                     # Newton-Schulz 正交化
W_t = (1 - ηλ) W_{t-1} - η · √(d_out/d_in) · M_t   # 缩放 + weight decay
if RMS(W_t) > c:  W_t *= c / RMS(W_t)      # weight clipping,可选
shape:W 是 (d_out, d_in),正交化后仍是 (d_out, d_in),但行是标准正交基。Per-Head 模式下先把 W 拆成 (n_heads, head_dim, d_in),每块独立 NS 正交化。
(2)QB 延迟一步更新(Eq. 14)
scss
# 第 t 批先路由:T_i(t) = argtopk(s_i + b(t-1))   # 用旧偏置路由
# 累积直方图:r_ij = α_i - s_ij   (每个 token×专家 的"所需偏置")
# 第 t 批结束更新:
#   b̂_j^(t) = -quantile_{1-k/n}(s_{:,j} - α)
#   b^(t) = b̂^(t) - mean(b̂^(t))
# 第 t+1 批才用新偏置路由(因果性)
shape:scores (m, n_experts),cutoff (m,),histogram (n_experts, bins)。
(3)LR 调度(Cosine with Warmup)
vbscript
warmup = max(1, int(total_steps · warmup_ratio))
if step < warmup:
    η(step) = (step+1)/warmup            # 线性 warmup
else:
    progress = (step - warmup) / (total_steps - warmup)
    η(step) = min_lr + (1 - min_lr) · ½(1 + cos(π·progress))
(4)Context Curriculum 四阶段
vbnet
stage_for_step(step):
    progress = step / total_steps
    for each stage in order:
        if progress < stage.end_fraction: return stage
    return last_stage
每个 stage 有 seq_len、cp_degree(上下文并行度)、cooldown(是否冷却阶段)。cp_degree = ceil(seq_len / max_tokens_per_rank),保证每 rank 处理的 token 数不超上限。
2.2.3 专家视角(优化 / 信息论 / 计算复杂性)
为什么 Per-Head Muon 比 full-matrix 好?
从优化几何来看,full-matrix 正交化把整个投影矩阵当成一个整体来做谱归一化。不同 head 的动量尺度可能差好几个数量级(比如 KDA 的 q_proj 每个 head 的感受野不同),大尺度 head 的更新方向会主导正交化的结果,小尺度 head 得到的更新相当于被"压缩"了。Per-Head 把每个 head 单独正交化,本质上是把优化空间分解为 head 个子空间,各子空间独立做谱归一化,保证每个 head 的更新都享有相同的有效学习率。论文 §2.5 说这在大模型上带来更稳定的训练动力学和更好的最终性能。
为什么 QB 不需要辅助损失、不需要学习率?
从对偶理论看,QB 的更新公式(Eq. 14)不是一个"沿着损失下降方向挪一小步"的 SGD 式更新,而是精确求解一个平衡指派 LP 的对偶坐标最优解(附录 C 有推导)。这就是为什么它不需要超参数学习率、也不会震荡------每一步都是在当前 cutoff 下的精确最优偏置。唯一的近似来自直方图估计(附录 D),误差不超过一个 bin 宽。
为什么课程学习是经济的?
训练的 FLOPs 大致和 seq_len 成正比(注意力/递推都是 O(T))。如果 95% 的训练在 8K 长度完成,只有 5% 在 1M 长度,那总计算量大约是 0.95×8K + 0.05×1M = 76K + 50K = 126K "等价 8K 步数",而全程 1M 训练是 1000K。等价计算量节省了 87%。这就是论文说的"concentrating the costly long-sequence computation in a small fraction of the overall budget keeps the curriculum economical"。
Scaling Law 的启示:
论文 §3.2 特别强调一件事------cosine decay 和 WSD 不能用同一组超参比公平。它们各自有自己最优的 peak LR 和 batch size。K3 的缩放定律研究为每个调度做了独立的超参搜索,最终 cosine 在各自最优配置下胜出。这提醒我们:调度器不是一个可以随便换的模块------换了调度就要重新扫 LR 和 batch size,否则比较是不公平的。
2.3 对比基线:标准做法 vs K3 方案
| 维度 | 标准做法 | K3 方案 | 差异 |
|---|---|---|---|
| 优化器 | AdamW(全参数) | Per-Head Muon(矩阵参数)+ AdamW(其余) | Muon 正交化让矩阵参数学习更稳定;Per-Head 让各 head 力度均衡 |
| MoE 负载均衡 | 辅助损失(auxiliary loss) | Quantile Balancing(无辅助损失) | QB 一步到位、无超参、不与主 loss 竞争 |
| 学习率调度 | 固定 / cosine / 线性衰减 | Cosine with Warmup(1% warmup) | 公平超参搜索后 cosine 优于 WSD |
| 上下文长度 | 全程固定长度训练 | 四阶段课程(8K→64K→256K→1M) | 长序列只占预算小尾巴,节省 ~87% 计算 |
| 位置编码 | RoPE / ALiBi | NoPE(KDA 衰减隐式编码位置) | 课程切换时无需插值/微调 base,直接外推 |
| 梯度累积 | loss 按 batch 数平均 | loss 按 batch 数平均 | 等 token 数时等价;不等 token 数时有系统偏差(见 §2.7 E2) |
| Checkpoint | 只保存权重 | 权重 + 优化器状态 + TrainState | 支持完美断点续训 |
| 评估 | eval_loss 单指标 | eval_loss + eval_ppl + MoE 平衡 + KDA 衰减 | 多维度健康监测 |
2.4 工程实现
2.4.1 架构总览与依赖关系
php
Trainer (train/loop.py:60)
  │
  ├─► Kimi3ForCausalLM (model.py:283)         # 模型
  │     ├─► Kimi3Model (embedding + blocks + norm)
  │     │     ├─► Kimi3Block × n_layers        # KDA/MLA + MoE
  │     │     └─► StableLatentMoE → QB Router  # 累积负载直方图
  │     └─► lm_head / mtp_head
  │
  ├─► Muon optimizer (optim/muon.py:86)        # Per-Head NS + AdamW fallback
  │     └─► build_muon_param_groups (optim/param_groups.py:44)
  │
  ├─► lr_lambda (optim/lr_scheduler.py:146)    # cosine/wsd 调度
  │
  ├─► ContextCurriculum (data/curriculum.py:38) # 阶段切换
  │
  ├─► PackedDataset (data/packing.py:99)       # 打包数据
  │
  ├─► MetricLog (train/metrics.py:45)           # 日志
  └─► RunningMean (train/metrics.py:19)         # loss 平滑
调用链(一次 train_step):
scss
train_step(batches)
  ├─ zero_grad (set_to_none=True)
  ├─ for batch in batches:
  │     ├─ batch.to(device)
  │     ├─ model(input_ids, labels, doc_ids)  →  loss
  │     ├─ loss.backward()
  │     └─ accumulate total_loss / tokens
  ├─ clip_grad_norm_(model.parameters(), grad_clip)
  ├─ set_lr(step)  →  缩放所有 param_group 的 lr
  ├─ optimizer.step()  →  Muon 正交化更新 + AdamW 更新
  └─ model.model.update_router_biases()  →  QB 延迟一步更新(因果性)
数据流(张量形状逐步):
以 nano config 为例(dim=64, n_layers=9, seq_len=32, mbs=2):
| 阶段 | 张量 | shape |
|---|---|---|
| 输入 | input_ids | (2, 32) |
| 标签 | labels | (2, 32),-100 处不计 loss |
| 文档 ID | doc_ids | (2, 32),用于 KDA 重置 / MLA mask |
| Embedding | tok_embed(input_ids) | (2, 32, 64) |
| KDA 层输出 | block output | (2, 32, 64),递推状态 S 在内部更新 |
| MLA 层输出 | block output | (2, 32, 64) |
| MoE 输出 | ffn output | (2, 32, 64),每 token top_k 专家 |
| 最终隐藏态 | model(tokens) | (2, 32, 64) |
| Logits | lm_head(h) | (2, 32, vocab_size) |
| LM Loss | cross_entropy | scalar(按 token 平均) |
| MTP Loss(可选) | cross_entropy (xt+2) | scalar,乘 loss_weight 加入总 loss |
| 总 Loss | lm_loss + mtp_loss · w | scalar,÷ grad_accum 后反向 |
2.4.2 类 / 函数职责表
| 类 / 函数 | 所在文件 | 核心职责 |
|---|---|---|
| Trainer | train/loop.py:60 | 训练器总入口,管模型/优化器/课程/日志/ckpt |
| TrainState | train/loop.py:31 | 训练状态数据类(step/tokens/best_loss/stage/history) |
| resolve_device | train/loop.py:46 | 设备自动选择(auto → CUDA/CPU 回退) |
| train_step | train/loop.py:117 | 单 optimizer step(含 grad_accum 累积) |
| train | train/loop.py:178 | 训练主循环 + 课程阶段切换 |
| evaluate | train/loop.py:234 | 评估(eval_loss + eval_ppl) |
| save / load | train/loop.py:250 / 263 | Checkpoint 保存与恢复 |
| RunningMean | train/metrics.py:19 | 滑动窗口均值(loss 平滑) |
| MetricLog | train/metrics.py:45 | JSONL 日志 + 内存历史 + series/smoothed |
| expert_balance | train/metrics.py:78 | 聚合所有 MoE 层的负载均衡指标 |
| decay_stats | train/metrics.py:99 | 报告 KDA 层 alpha 衰减因子分布 |
2.4.3 伪代码与真实代码对应
伪代码:一次训练步
ini
# 1. 清空梯度
optimizer.zero_grad(set_to_none=True)

total_loss = 0.0
for micro_batch in batches:
    # 2. 前向
    out = model(micro_batch.input_ids, labels=micro_batch.labels,
                doc_ids=micro_batch.doc_ids)
    # 3. 缩放 loss(等权平均)
    loss = out["loss"] / len(batches)
    # 4. 反向(累积梯度)
    loss.backward()
    total_loss += out["loss"].item()

# 5. 全局梯度裁剪
grad_norm = clip_grad_norm_(model.parameters(), max_norm=grad_clip)

# 6. 设置学习率
set_lr(current_step)

# 7. 优化器更新(Muon + AdamW)
optimizer.step()

# 8. QB 延迟更新路由器偏置(用本批直方图,下批生效)
model.update_router_biases()

return {"step": step, "loss": total_loss / len(batches), "grad_norm": grad_norm, ...}
与真实代码的对应:
- 步骤 1-4 →
train/loop.py:125-145 - 步骤 5 →
train/loop.py:148-152 - 步骤 6 →
train/loop.py:106-115(set_lr) +train/loop.py:154 - 步骤 7 →
train/loop.py:155(optimizer.step) - 步骤 8 →
train/loop.py:159(update_router_biases)
2.4.4 工程实现的几个关键设计决策
(1)为什么 update_router_biases 在 optimizer.step() 之后?
因为 QB 直方图是在前向过程中累积的(router.forward → _accumulate),必须等当前 batch 前向全部完成后,直方图才完整。而且论文要求「本批数据从不用本批算出的偏置路由自己」------延迟到 step 之后,保证下一批才用新偏置,因果性成立。
(2)为什么 set_lr 在 optimizer.step() 之前?
PyTorch 的 LR 调度惯例是「step 之前设 LR」。这样每一步的 LR 对应这一步的更新方向。K3 的 lr_lambda 也是这个约定:step 0 的 LR 是 warmup 的第一步值。
(3)为什么 zero_grad 用 set_to_none=True?
把 grad 设为 None 而不是 0,可以避免为不参与计算的参数分配梯度张量,节省内存。而且加 None 等同于加 0,不影响累积。
(4)为什么 _fit_dataset 吞掉 ValueError?
设计意图是「数据不够就不升级长度,继续用之前的长度」,属于软降级。但缺点是日志里仍然记录 stage.seq_len,造成日志和实际不一致------这是一个可以改进的点。
2.4.5 常见疑问 Q&A
Q1:train_step 里的 grad_norm 是 clip 前还是 clip 后?
- clip 后。
torch.nn.utils.clip_grad_norm_返回的是裁剪前的总范数,然后原地修改梯度。所以record["grad_norm"]里存的是裁剪前 的 grad_norm,用来观测梯度的原始大小。是否需要 clip,可以通过grad_norm > grad_clip来判断。
Q2:TrainConfig 里的 eval_every / save_every / out_dir / dtype / compile 字段为什么 loop.py 没用到?
- 这些字段是对齐 kimi3-master 配置结构声明的,但本项目的 Trainer 是精简版,没有实现周期评估、周期保存、自动 dtype 转换和 torch.compile。属于「配置已声明,功能待实现」的状态。使用时注意:
train()不会自动 eval,也不会自动保存 checkpoint------需要手动调用evaluate()和save()。
Q3:best_loss 存的是 smoothed loss 还是 raw loss?
- raw loss。
state.best_loss = min(state.best_loss, record["loss"])用的是每步的原始 loss,而不是loss_smoothed。这在 loss 噪声大的时候可能不准确------最优步可能只是噪声低点。长训练下不影响,短训练建议看 smoothed loss。
Q4:set_gradient_checkpointing 真的有用吗?
- 目前是占位符。
model.py:309-310只设置了一个布尔标志,但 model forward 里并没有根据这个标志调用torch.utils.checkpoint.checkpoint来重计算中间激活。所以目前打开 gradient_checkpointing 不会减少显存,也不会变慢------它是个 no-op。这是一个待实现的功能。
Q5:decay_stats 报告的 alpha 和 KDA 实际的 alpha 一样吗?
- 不完全一样。
decay_stats只用了alpha_bias+a_log来算 alpha,没有乘alpha_up(alpha_down(x))这一项------也就是它算的是「x=0 时的 alpha」,一个输入无关的基准值。当 alpha_up 学到非零权重后,实际 alpha 是输入依赖的,会围绕这个基准值上下波动。所以decay_stats是一个近似监控,不是精确的逐 token alpha。它的价值在于观察基准是否还在 (exp(g_min), 1) 范围内。
Q6:checkpoint 里存了 optimizer 状态,加载后能精确续训吗?
- 能。
save()存 model state_dict + optimizer state_dict + TrainState.dict ,load()完整恢复。验证:test_save_load 测试 +demo_pretrain_e2e.py的 round-trip 验证(step 和 best_loss 完全一致)。
Q7:为什么 loss 除以 batches 数,而不是 token 数?
- 因为
F.cross_entropy默认已经按 token 数平均了(reduction='mean'),所以每个 micro-batch 的 loss 都是「每个 token 的平均 loss」。再除以 batch 数做平均,得到的是「各 micro-batch 各自 per-token loss 的平均」。当各 micro-batch 的有效 token 数相同时,这和全批的 per-token loss 是等价的。但当 token 数不同时,就会有偏差(见 E2)。
2.4.6 跨领域联系
1. 与位置编码的联系
K3 是 NoPE(无位置编码)模型。训练中位置信息来自两部分:ShortConv 的局部位移 + KDA 递推衰减的全局距离感。课程学习能从 8K 直接跳到 1M 而不需要 RoPE 插值/微调 base,本质上就是因为 NoPE------没有显式的位置编码参数需要重新校准。这揭示了一个更本质的设计原则:如果位置信息是隐式的、从机制中涌现的,那么外推就是免费的。
2. 与优化理论的联系
Per-Head Muon 本质上是把「谱归一化」从全矩阵粒度下放到了 head 粒度。这揭示了优化中的一个普遍现象:不同尺度的参数耦合在一起做归一化,会被大尺度的主导。分解到合适的子空间再各自归一化,能让每个子空间都获得充分的更新。这和 layer normalization 的直觉类似------在合适的粒度上归一化,比全局归一化更好。
3. 与信息论的联系
QB 的无辅助损失设计,本质上是把「负载均衡」从一个「软约束(加在 loss 里)」变成了「硬约束(路由时直接满足)」。硬约束的好处是不需要调权重、不会和主目标竞争;代价是引入了因果延迟(不能用本批数据算本批偏置)。这是一个更普遍的权衡:把约束做进机制里(硬约束)更干净但更刚性;把约束加在目标里(软约束)更灵活但更难调。
4. 与并行化的联系
训练管线的设计直接决定了能以怎样的方式并行。K3 的四阶段课程 + CP(上下文并行)设计,让「百万 token 上下文训练」从「不可能」变成「经济上可行」。这揭示了架构和系统的协同设计原则:好的架构不只是算得准,还要好并行、好扩展。KDA 的递推结构天然适合 CP,MLA 的压缩 KV 适合长序列,MoE 适合 EP------K3 的每个核心组件都有对应的并行策略。
5. 与可解释性的联系
decay_stats 这个指标很有意思------它直接报告 KDA 层 alpha 的分布范围。这相当于可以实时观测「模型的记忆跨度是多少」:alpha 接近 1 意味着记忆几乎不衰减(长记忆),alpha 接近 exp(g_min) 意味着记忆衰减很快(短记忆)。训练中观察 alpha 如何在 (exp(g_min), 1) 区间内移动,可以直观看到模型在「该记住多少」这件事上的选择。这是一种非常细粒度的可解释性窗口。
2.5 反方辩手(结构化)
a) 反对这个方案最强的理由是什么?
「这是一套为 896 专家 + 1M 上下文的超大模型精心调过的管线,小模型/小数据场景下反而过度设计,且暗藏多个隐性陷阱。」
具体来说:
- QB 在小 batch 下直方图很粗糙,分位数估计误差大,反而不如简单的 load-balance loss 稳定。
- Per-Head Muon 在小模型(dim < 512、head < 8)下几乎和 AdamW 没区别,但代码复杂度高很多。
- 课程学习的阶段切换有「静默失败」风险:数据不够时默默回退,日志却不报错。
b) 如果它失败,最可能错在哪个假设?
「假设训练数据是平稳分布 + batch 足够大。」
QB 的精确解(Eq. 14)建立在「负载分布稳定」的假设上。如果每批数据分布剧烈波动(比如多任务混训、任务切换、课程阶段切换),老偏置在新分布下反而可能加剧失衡。
Per-Head Muon 的收益建立在「不同 head 尺度差异大」的假设上。小模型/早期训练时 head 尺度差异不大,Per-Head 的好处不明显。
课程学习的经济性建立在「短序列阶段就能学到大部分知识」的假设上。如果任务本质上需要长上下文(比如长程推理),短序列阶段的训练价值低,课程的经济性打折扣。
c) 在什么条件下这个设计会胜出?在什么条件下会失败?
| 条件 | 胜出 | 失败 |
|---|---|---|
| 模型规模 | 大模型(参数量 > 10B,专家 > 128) | 小模型(参数量 < 1B,专家 < 16) |
| 数据分布 | 平稳、大批量(每步 > 1M token) | 波动大、小批量(每步 < 10k token) |
| 上下文长度 | 超长上下文(> 100K) | 短上下文(< 4K) |
| 任务类型 | 语言建模为主的通用预训练 | 高度特定的下游微调 |
| 训练时长 | 长训练(> 100k steps) | 短训练(< 1k steps) |
d) 有没有一个不那么先进、但更稳健的做法?
有。最朴素的替代方案是:AdamW + 辅助损失负载均衡 + 固定长度训练 + 每 N 步 eval/ckpt。
这个方案的好处:
- 代码简单,一个标准 Training Loop 200 行搞定
- 每个组件都是久经考验的标准做法
- 行为可预测,没有那么多隐性假设
- 调试容易,出问题一眼能看出来
代价:
- 大模型下收敛速度和最终性能稍差(论文说差 2.5× scaling efficiency)
- MoE 负载均衡收敛慢,训练初期浪费算力
- 长上下文训练成本高很多
选型建议:模型规模没到 K3 级别之前,先用朴素方案。等规模上去了、问题暴露了,再逐步引入 QB / Muon / 课程这些高级特性。不要为了「先进」而先进。
e) 哪个利益相关方会受到伤害?
-
训练方:获得了更快的收敛和更好的最终性能,但付出了更高的工程复杂度和更多的隐性陷阱。调参难度上升。
-
推理方:基本不受影响。QB 偏置在推理时冻结,Muon 只影响参数值(不影响推理架构)。唯一相关的是课程学习最终决定了支持的最大上下文长度。
-
特定任务方:
- 长程推理任务受益最大(1M 上下文 + 课程训练)
- 简单短文本任务几乎不受益(反而可能因为混合架构变复杂而略受损)
- 小数据下游微调任务:QB/Muon 的设计假设不成立,可能不如标准 AdamW + 全量 fine-tuning 稳定
2.6 计算复杂度分析
以 K3 官方规模(dim=7168, n_layers=93, n_routed=896, top_k=16, seq_len=8K/1M)为基准。
| 维度 | 标准做法(Dense + AdamW) | K3 方案(MoE + Per-Head Muon + QB) | 差异 |
|---|---|---|---|
| 每 token FLOPs | ~12 × dim² × n_layers | ~2 × dim² × n_layers (activated) + 2 × dim × expert_hidden × top_k | K3 激活参数量少 → 每 token 快约 3× |
| KV Cache / 状态大小 | O(n_heads × d_head × T)(随 T 增长) | KDA: O(n_heads × d_k × d_v)(固定);MLA: O(n_heads × kv_lora_rank × T) | KDA 层 O(1) 状态,极大节省长上下文显存 |
| 参数数量 | ~0.5T(Dense 1T 级别) | 2.78T 总参数 / 104.2B 激活参数 | MoE 用总参数量换激活计算量 |
| MoE 负载均衡通信 | 辅助损失:无额外通信(但和主 loss 抢权重) | QB:n_experts × bins 整数 all-reduce / 层 / 步 | QB 通信量极小(~100k 整数/层/步),与 token 数无关 |
| Muon 通信 | AdamW:状态 ~2× 参数 | Muon:动量 ~1× 参数 + NS 迭代 5 次(计算多,通信一样) | Muon 通信量与 AdamW 同量级,计算多 ~30% |
| 训练总计算量(全程 8K) | 正比于 T × steps | 正比于 T × steps | 同 |
| 训练总计算量(1M 上下文) | 1M × steps(极贵) | 课程:8K×60% + 64K×25% + 256K×10% + 1M×5% ≈ 94K 等价长度 | 节省约 90% 计算量 |
关键超参数与默认值:
| 超参 | 默认值 | 论文值 | 调大 → | 调小 → |
|---|---|---|---|---|
| lr (Muon) | 1e-3 | 由 scaling law 决定 | 收敛快但可能震荡 | 收敛慢但稳定 |
| adamw_lr | 3e-4 | - | 同上 | 同上 |
| weight_decay | 0.1 | 0.1 | 正则化强,防止过拟合 | 可能过拟合 |
| warmup_ratio | 0.01 | 1% | 更稳定但起步慢 | 起步快但可能梯度爆炸 |
| min_lr_ratio | 0.1 | - | 后期仍有学习能力 | 后期学习能力弱 |
| grad_clip | 1.0 | - | 允许更大梯度 | 更稳定但可能欠学习 |
| weight_clip | 0.0(默认关) | 沿用 K2(未给具体值) | 权重 RMS 被限制 | 可能限制表达能力 |
| top_k | 2(nano) / 16(官方) | 16 | 路由更均匀但计算更多 | 计算少但可能失衡 |
| grad_accum | 1 | 取决于 batch 大小 | 更大有效 batch | 训练更慢 |
论文中的调参结论:
- Cosine decay 优于 WSD,但必须各自独立做 scaling law 超参搜索才公平(§3.2)
- 2.5× scaling efficiency gain 来自「架构 + 数据 + 训练」三方面的综合改进(§3.2)
- QB 在 896 专家规模下仍能保持负载均衡(max/mean ≈ 1.05 左右),优于 fixed-step rule(§2.3.3)
2.7 验证 Demo
入口 :experiments/models/llm/kimi_k3/train/gradio_train_demo.py
启动命令 :python experiments/models/llm/kimi_k3/train/gradio_train_demo.py
12 个 Tab 总览:
| Tab | 功能 | 对应知识点 | 调用的绘图函数 |
|---|---|---|---|
| 1. 训练过程总览 | loss / LR / grad_norm / tokens 四联图 | Trainer.train | fig_training_overview |
| 2. LR 调度曲线 | Cosine vs WSD 对比 + 变化率 | lr_lambda_for | fig_lr_schedules |
| 3. Context Curriculum | 阶段切换 + 步数预算 + cp_degree | ContextCurriculum | fig_curriculum |
| 4. 梯度累积 | 不同 grad_accum 等价性验证 | train_step | fig_grad_accum |
| 5. Checkpoint 验证 | save → load round-trip 一致性 | save / load | fig_checkpoint_roundtrip |
| 6. 评估 | 训练前后 eval_loss / ppl 对比 | evaluate | fig_evaluate |
| 7. 设备与 GC | resolve_device 策略 + 显存速度权衡 | resolve_device | fig_device_and_gc |
| 8. RunningMean | 滑动窗口平滑效果 | RunningMean | fig_running_mean |
| 9. MetricLog | 记录 / series / smoothed / JSONL | MetricLog | fig_metric_log |
| 10. MoE 负载均衡 | QB 收敛曲线 + max/mean / CV | expert_balance | fig_expert_balance |
| 11. KDA alpha 衰减 | alpha 范围 + exp(g_min) 下界验证 | decay_stats | fig_decay_stats |
| 12. 无模型回退 | 模块缺失时返回空 dict | expert_balance / decay_stats | fig_metrics_no_model |
设计原则 :Gradio 只做 UI 组装,所有绘图逻辑在 plot_train_loop.py 和 plot_metrics.py 的 fig_*() 函数里,零重复代码。每个 fig_*() 返回 (fig, text) 元组,既可独立运行保存到 assets/,也可直接被 Gradio 调用。
2.8 计算形态说明(训练 vs 推理)
训练和推理是两种完全不同的计算形态:
训练形态:全序列前向 + 反向传播
-
输入:整段序列 (B, T),一次前向得到所有位置的 logits 和 loss
-
反向:通过整段序列反向传播梯度,更新所有参数
-
为什么这样用:训练需要对每个位置算 loss,整段前向可以利用并行计算(GPU 的 SIMD / Tensor Core)
-
并行方式:
- 数据并行(DP):不同 rank 处理不同 batch
- 张量并行(TP):每层的矩阵乘法拆分
- 流水线并行(PP):不同层拆分到不同 rank
- 专家并行(EP):不同专家在不同 rank
- 上下文并行(CP):KDA 层的序列维度拆分(论文 §5.1.2)
推理形态:逐 token 自回归生成 + 状态传递
-
输入:1 个新 token + 之前所有步骤的状态/cache
-
输出:1 个新 token + 更新后的状态/cache
-
为什么这样用:推理时不知道答案,只能一个一个生成(自回归)
-
状态:
- KDA 层:固定大小状态矩阵 S(不随 T 增长)
- MLA 层:KV cache(随 T 增长,但因为有 kv_lora_rank 压缩,比标准 MHA 小很多)
- ShortConv:固定大小卷积状态(kernel-1 个 token)
两种形态在代码中的桥梁:
- KDA:forward 里的「分块递推 + chunkwise」训练形态 vs
step()的单 token 递推推理形态。两者数值等价------因为递推是纯加法+乘法,顺序不影响结果(结合律)。 - QB 路由器:训练时每步 forward 累积直方图,step 后 update_bias;推理时 bias 冻结,只做路由不累积。
- 梯度累积:训练专用的「攒梯度」机制,推理完全不需要。
- 课程学习:训练专用的「由短到长」策略,推理直接支持最大长度。
这是可递推序列模型的通用范式:训练走整段并行,推理走单步递推,两者数学等价。K3 因为 KDA 是纯递推结构,所以这条桥梁特别清晰------从训练到推理,不需要改架构,只需要换计算形态。
0x03 Muon P2P 优化器
3.1 要解决的问题
Muon 的 Newton-Schulz 正交化需要完整的参数矩阵,但分布式训练中每个 rank 只持有参数的一个分片。朴素做法是 all-gather 整个模型,但这在大模型上内存开销巨大。
3.2 设计思路
P2P Muon 就像一个"接力赛"------每个 rank 只负责自己"拥有"的参数。需要正交化某个参数时,相关 rank 通过点对点通信把分片传给拥有者,拥有者在本地组装完整矩阵、正交化、再把分片传回去。没有任何 rank 需要同时持有所有参数。
解决方案:P2P 通信 + Round-Robin 所有权
css
传统方案(All-Gather):
  rank 0: [====完整参数0====][====完整参数1====]...  → O(N) 内存
  rank 1: [====完整参数0====][====完整参数1====]...  → O(N) 内存
  所有 rank 都持有全部参数 → 内存浪费

P2P 方案:
  rank 0: 拥有参数 0, 3, 6 → 只组装这 3 个参数 → O(N/3) 内存
  rank 1: 拥有参数 1, 4, 7 → 只组装这 3 个参数 → O(N/3) 内存
  rank 2: 拥有参数 2, 5, 8 → 只组装这 3 个参数 → O(N/3) 内存
通过 P2P 通信(irecv/isend)传递分片 → 无全量复制关键设计决策:
- Round-Robin 所有权 :参数按序号轮询分配给 rank(参数 i 归 rank
i % world_size) - P2P 通信而非集合通信 :使用
irecv/isend而非all_gather,通信量降为 1/world - 单进程退化:dist 不可用时退化为本地 clone/copy,支持 CPU 单元测试
- Per-Head 支持 :每个参数可独立指定头数,复用
newton_schulz.py的 NS - 分片管理 :通过
shard_ranges()确保每个 rank 只接收自己需要的分片
3.3 参考设计
kimi3-master (kimi3/optim/muon_p2p.py:47-168):
python
class P2PMuonOrthogonalizer:
    def __init__(self, params, *, group=None, ns_steps=5, heads=None):
        self.ownership = OwnershipMap.round_robin(len(params), self.world, self.rank)

    @torch.no_grad()
    def gather_owned(self, updates):
        """每个 rank 只组装自己拥有的参数的完整矩阵"""
        full = {}
        for i, upd in enumerate(updates):
            owner = self.ownership.owners[i]
            if owner == self.rank:
                # 我是拥有者: 从所有 rank 接收分片
                buf = torch.empty_like(flat)
                for src in range(self.world):
                    dist.irecv(buf[slo:shi], src=src)
                full[i] = buf.view_as(upd)
            else:
                # 我不是拥有者: 发送我的分片给拥有者
                dist.isend(flat[lo:hi], dst=owner)
        return full

    @torch.no_grad()
    def scatter_back(self, orthogonalized):
        """将正交化后的分片传回各 rank"""
        # 类似的 P2P 通信

    def step(self, updates):
        full = self.gather_owned(updates)
        ortho = {i: _orthogonalize(mat, ...) for i, mat in full.items()}
return self.scatter_back(ortho)内存节省:
- All-Gather 方案: 每个 rank 需要 额外内存( = 总参数数)
- P2P 方案: 每个 rank 仅需 额外内存
3.4 核心组件
3.4.1 本项目实现的核心组件
-
OwnershipMap:round-robin 所有权分配,参数 i 归 rank (i % world) -
P2PMuonOrthogonalizer:三阶段流程gather_owned(): P2P 通信收集完整矩阵(irecv/isend,非 all_gather)_orthogonalize(): NS 正交化(支持标准/Per-Head 模式)scatter_back(): P2P 通信分发正交化后的分片
-
orthogonalize_owned():一次性便捷函数 -
shard_ranges():本地实现,与parallel/zero.py共享
3.4.2 本项目与 kimi3-master 的关键差异
shard_ranges本地实现(避免循环导入)- 单进程退化为本地操作(支持 CPU 单元测试,无需启动多进程)
- NS 复用
newton_schulz.py(非本地定义)
3.5 架构图
3.5.1 P2P Muon 在优化器系统中的位置
scss
src/optim/
├── newton_schulz.py         ←── P2P Muon 依赖 NS 正交化
│   ├── newton_schulz()
│   └── match_update_rms()
├── muon.py                  ←── 标准本地 Muon(单机)
│   ├── per_head_orthogonalize()
│   └── class Muon
├── muon_p2p.py              ←── 分布式 P2P Muon
│   ├── shard_ranges()         分片范围计算(本地实现)
│   ├── class OwnershipMap     所有权映射
│   ├── class P2PMuonOrthogonalizer  P2P 正交化器
│   └── orthogonalize_owned()  一次性便捷函数
├── param_groups.py
├── hybrid.py
└── lr_scheduler.py

src/parallel/
└── zero.py                 ←── shard_ranges 的来源(与 ZeRO 共享)
    └── shard_ranges()
3.5.2 类继承与组合关系
bash
P2PMuonOrthogonalizer
    ├── 组合: OwnershipMap        # 所有权分配
    ├── 依赖: newton_schulz()     # NS 正交化(来自 newton_schulz.py)
    ├── 依赖: shard_ranges()      # 分片范围(来自 parallel/zero.py 或本地)
    └── 依赖: dist.irecv/isend    # P2P 通信(可选,单进程退化为本地)

OwnershipMap
    └── 纯数据: owners[i] = rank  # 无外部依赖

orthogonalize_owned()
    └── 工厂: 创建临时 P2PMuonOrthogonalizer 并执行 step
3.5.3 与 kimi3-master 的文件映射
scss
kimi3-master/optim/muon_p2p.py (168行)
    ├── OwnershipMap              →  muon_p2p.py: OwnershipMap
    ├── P2PMuonOrthogonalizer     →  muon_p2p.py: P2PMuonOrthogonalizer
    ├── orthogonalize_owned()     →  muon_p2p.py: orthogonalize_owned()
    ├── _orthogonalize()          →  muon_p2p.py: _orthogonalize()
    └── _dist()                   →  muon_p2p.py: _dist_available()

kimi3-master/parallel/zero.py
    └── shard_ranges()            →  muon_p2p.py: shard_ranges()(本地实现)
                                    +  parallel/zero.py: shard_ranges()(共享)
3.6 数据流图
3.6.1 P2P Muon 单步完整流程
ini
输入: updates = [U_0, U_1, U_2]  (3 个参数的梯度更新)
      world = 3, rank = 1

┌──────────────────────────────────────────────────────────────┐
│ 阶段 1: gather_owned() --- 收集本 rank 拥有的参数的完整矩阵    │
├──────────────────────────────────────────────────────────────┤
│                                                              │
│  rank 0: 拥有参数 0, 3, 6  →  需要收集 U_0, U_3, U_6 的分片  │
│  rank 1: 拥有参数 1, 4, 7  →  需要收集 U_1, U_4, U_7 的分片  │
│  rank 2: 拥有参数 2, 5, 8  →  需要收集 U_2, U_5, U_8 的分片  │
│                                                              │
│  对每个拥有的参数 i:                                          │
│    1. 计算 shard_ranges(numel, world) → [(0,lo1),(lo1,lo2),..]│
│    2. 分配完整缓冲区 buf[numel]                               │
│    3. buf[self_range] = 自己持有的分片                        │
│    4. 对其他 rank: irecv(buf[other_range], src=other_rank)   │
│    5. 对其他 rank: isend(my_slice, dst=owner_rank)           │
│    6. wait() 所有请求                                        │
│                                                              │
│  输出: full = {i: 完整矩阵}  (仅本 rank 拥有的参数)           │
└──────────────────────────────────────────────────────────────┘
                           │
                           ▼
┌──────────────────────────────────────────────────────────────┐
│ 阶段 2: orthogonalize() --- 对每个拥有的参数做 NS 正交化        │
├──────────────────────────────────────────────────────────────┤
│                                                              │
│  对 full 中每个 (i, mat):                                     │
│    if heads[i] is None or <= 1:                              │
│      ortho[i] = newton_schulz(mat, ns_steps)                 │
│    else:                                                     │
│      ortho[i] = per_head NS (按头拆分 → 独立 NS → 合并)       │
│                                                              │
│  输出: ortho = {i: 正交化后的完整矩阵}                        │
└──────────────────────────────────────────────────────────────┘
                           │
                           ▼
┌──────────────────────────────────────────────────────────────┐
│ 阶段 3: scatter_back() --- 将正交化后的分片传回各 rank           │
├──────────────────────────────────────────────────────────────┤
│                                                              │
│  对每个参数 i:                                                │
│    if self is owner:                                         │
│      flat = ortho[i].reshape(-1)                             │
│      buf = flat[self_range]  (自己需要的分片)                 │
│      对其他 rank: send(flat[other_range], dst=other_rank)    │
│    else:                                                     │
│      recv(buf, src=owner_rank)  (从 owner 接收分片)           │
│                                                              │
│  输出: shards = [shard_0, shard_1, ..., shard_{n-1}]         │
│        每个 shard 是本 rank 持有的分片 (1D tensor)             │
└──────────────────────────────────────────────────────────────┘
3.6.2 通信模式对比
css
All-Gather 方案(传统):
  rank 0 ──── all_gather ────→ rank 0 持有全部参数
  rank 1 ──── all_gather ────→ rank 1 持有全部参数
  rank 2 ──── all_gather ────→ rank 2 持有全部参数
  通信量: O(N × world)
  内存:   O(N) 每 rank

P2P 方案(本实现):
  rank 0 ──── isend(s0) ────→ owner 0 组装完整参数 0
  rank 1 ──── isend(s1) ────→ owner 0 组装完整参数 0
  rank 2 ──── isend(s2) ────→ owner 0 组装完整参数 0
  owner 0 ─── NS 正交化 ────→ send 回各 rank
  通信量: O(N)  (每个 rank 只收发自己的分片)
  内存:   O(N/world) 每 rank
3.6.3 Round-Robin 所有权分配
ini
参数: [P0, P1, P2, P3, P4, P5, P6, P7, P8]
world = 3

rank 0: 拥有 [P0, P3, P6]  (i % 3 == 0)
rank 1: 拥有 [P1, P4, P7]  (i % 3 == 1)
rank 2: 拥有 [P2, P5, P8]  (i % 3 == 2)

每个 rank 大约持有 N/world = 9/3 = 3 个参数
3.7 依赖关系图
3.7.1 文件级依赖
bash
src/optim/muon_p2p.py
    ├── 导入: optim.newton_schulz.newton_schulz  ← NS 正交化
    ├── 导入: torch.distributed                  ← P2P 通信(可选)
    └── 本地: shard_ranges()                     ← 分片范围计算

src/parallel/zero.py
    └── 提供: shard_ranges()                     ← 与 P2P Muon 共享

src/optim/__init__.py
    └── 导出: OwnershipMap, P2PMuonOrthogonalizer, orthogonalize_owned
3.7.2 函数级调用链
scss
P2PMuonOrthogonalizer.step(updates)
    │
    ├── gather_owned(updates)
    │   ├── shard_ranges(numel, world)     ← 计算每个 rank 的分片范围
    │   ├── dist.irecv(buf, src)           ← 接收其他 rank 的分片
    │   └── dist.isend(flat, dst)          ← 发送自己的分片给 owner
    │
    ├── _orthogonalize(mat, steps, heads)
    │   ├── newton_schulz(mat, steps)      ← 标准 NS
    │   └── newton_schulz(blocks, steps)   ← Per-Head NS
    │
    └── scatter_back(ortho)
        ├── shard_ranges(numel, world)     ← 计算分片范围
        ├── dist.send(flat, dst)           ← 发送分片给其他 rank
        └── dist.recv(buf, src)           ← 从 owner 接收分片
3.7.3 外部依赖
css
muon_p2p.py 的依赖:
    ├── torch (张量运算)
    ├── torch.distributed (P2P 通信)
    │   ├── dist.is_available()   → 检查分布式是否可用
    │   ├── dist.is_initialized() → 检查是否已初始化
    │   ├── dist.get_world_size() → 获取 rank 数
    │   ├── dist.get_rank()       → 获取本 rank 编号
    │   ├── dist.irecv()          → 异步接收
    │   ├── dist.isend()          → 异步发送
    │   ├── dist.recv()           → 同步接收
    │   └── dist.send()           → 同步发送
    └── optim.newton_schulz (NS 正交化)

不依赖:
    ├── kimi3 模块 (零耦合)
    ├── 第三方库 (纯 PyTorch)
    └── GPU (CPU 可运行)
3.8 代码实现要点
| 组件 | 行数 | 关键实现 |
|---|---|---|
shard_ranges() |
25 | 向上取整分块,连续区间,与 ZeRO-1/2 共享 |
OwnershipMap |
35 | round-robin 分配,mine() 过滤本 rank 拥有的参数 |
P2PMuonOrthogonalizer |
130 | gather_owned (P2P 收集) → NS 正交化 → scatter_back (P2P 分发) |
_orthogonalize() |
15 | 标准/Per-Head 模式分发,复用 newton_schulz.py |
orthogonalize_owned() |
15 | 一次性便捷函数,创建临时实例并执行 |
| 总计 | ~220 |
3.9 真实代码
python
"""分布式 P2P Muon 正交化(论文 §5.2.2)。

设计动机(why)
-------------
在分布式训练中,每个数据并行(DP)rank 只持有完整参数的一个分片。
但 Newton-Schulz 正交化需要**完整的参数矩阵**------朴素做法是 all-gather
整个模型到每个 rank,这会在每个 rank 上额外复制一整份模型参数,
且通信量随模型规模线性增长,成为主要瓶颈。

P2P Muon 的核心思想:**每个 rank 只组装和正交化自己"拥有"的参数**。
通过 round-robin 将参数所有权分配给各 rank,然后通过点对点(P2P)通信
(irecv / isend)让拥有者从其他 rank 收集对应分片,组装完整矩阵后正交化,
再把正交化后的分片传回各 rank。没有任何 rank 需要同时持有它不拥有的参数。

内存节省:
  - All-Gather 方案: 每个 rank 需要 O(N) 额外内存(N = 总参数数)
  - P2P 方案: 每个 rank 仅需 O(N/world_size) 额外内存(约 1/world)

与 kimi3-master muon_p2p.py 的关系:
  本文件忠实复刻 kimi3-master/kimi3/optim/muon_p2p.py 的核心逻辑,
  同时做以下适配:
  1. shard_ranges 从 src/parallel/zero.py 导入(与 ZeRO-1/2 共享)
  2. newton_schulz 从 src/optim/newton_schulz.py 导入(与本地 NS 共享)
  3. 当 torch.distributed 不可用时,自动退化为单进程模式(world=1)
  4. 添加详尽中文注释,覆盖每个设计决策

单进程测试模式:
  当 dist.is_available() 为 False 或 dist.is_initialized() 为 False 时,
  所有 P2P 通信退化为本地 clone/copy,等价于 all-gather 语义。
  这使得单元测试无需启动多进程即可验证算法正确性。
"""

from optim.newton_schulz import newton_schulz

__all__ = [
    "OwnershipMap",
    "P2PMuonOrthogonalizer",
    "orthogonalize_owned",
    "shard_ranges",
]


# ============================================================
# 1. 分片范围计算(本地实现,与 kimi3.parallel.zero.shard_ranges 等价)
# ============================================================

def shard_ranges(numel: int, world: int) -> List[Tuple[int, int]]:
    """将 numel 个元素切成 world 段连续、近似相等的区间。

    为什么需要这个函数?
    在分布式训练中,一个完整张量需要均匀分配给 world 个 rank。
    每个 rank 持有张量的一个连续切片(shard),切片的起止位置
    由 shard_ranges 计算。

    连续性为什么重要?
    - 一个 rank 的分片是**一个连续 view**,reduce-scatter 和优化器 step
      都操作 view 而不是多次 gather
    - 连续切片使 GPU 内存访问模式友好(coalesced memory access)

    算法:向上取整分块
      per = ceil(numel / world)  # 每块的最大宽度
      rank i 持有 [i*per, min((i+1)*per, numel))

    为什么用向上取整?
    末段可能比前几段短,但所有段的总和恰好等于 numel。
    这与 reduce_scatter_grads 的分块宽度对齐。

    Args:
        numel: 张量的总元素数
        world: rank 数量(数据并行度)

    Returns:
        列表,第 i 个元素为 (lo, hi) 表示 rank i 持有的区间 [lo, hi)
    """
    per = -(-numel // world)  # 向上取整的分块宽度
    return [(min(i * per, numel), min((i + 1) * per, numel)) for i in range(world)]


# ============================================================
# 2. 所有权映射:决定哪个 rank 拥有(并正交化)哪个参数
# ============================================================

@dataclass
class OwnershipMap:
    """每个参数的所有权归属表。

    在 P2P Muon 中,每个参数必须有一个"拥有者"rank 负责正交化。
    OwnershipMap 定义了这种归属关系。

    核心设计:
    - owners[i] = 拥有第 i 个参数的 rank 编号
    - world = 总 rank 数
    - rank = 本 rank 的编号(用于判断 "mine()")

    分配策略(round-robin):
    参数 i 归 rank (i % world)。这种轮询分配保证:
    1. 每个 rank 大致持有 N/world 个参数(负载均衡)
    2. 分配是确定性的(所有 rank 用相同规则,无需通信)
    3. 分配是静态的(参数顺序不变则分配不变)
    """

    owners: List[int]   # owners[i] = 第 i 个参数的拥有者 rank
    world: int           # 总 rank 数
    rank: int            # 本 rank 的编号

    @classmethod
    def round_robin(cls, n_params: int, world: int, rank: int) -> "OwnershipMap":
        """Round-robin 分配:参数 i 归 rank (i % world)。

        为什么用 round-robin 而不是按大小分配?
        - 确定性:所有 rank 用相同规则,无需通信
        - 均匀性:假设参数数量 >> world,每个 rank 大致持有 N/world 个
        - 简单性:实现只需一行代码

        Args:
            n_params: 参数总数
            world: rank 数量
            rank: 本 rank 编号

        Returns:
            OwnershipMap 实例
        """
        return cls(
            owners=[i % world for i in range(n_params)],
            world=world,
            rank=rank,
        )

    def mine(self) -> List[int]:
        """返回本 rank 拥有的参数索引列表。

        这些参数的正交化由本 rank 负责------需要从其他 rank 收集分片、
        组装完整矩阵、正交化、再传回分片。

        Returns:
            本 rank 拥有的参数索引列表
        """
        return [i for i, owner in enumerate(self.owners) if owner == self.rank]


# ============================================================
# 3. 分布式 P2P Muon 正交化器
# ============================================================

class P2PMuonOrthogonalizer:
    """分布式 P2P Muon 正交化器。

    核心流程(step 方法):
    1. gather_owned():  每个 rank 通过 P2P 通信收集自己拥有的参数的完整矩阵
    2. orthogonalize(): 对每个拥有的参数做 Newton-Schulz 正交化
    3. scatter_back():  将正交化后的分片传回各 rank

    内存优势:
    - All-Gather: 每个 rank 需要持有所有 N 个参数的完整矩阵 → O(N)
    - P2P: 每个 rank 只组装自己拥有的 ~N/world 个参数 → O(N/world)

    通信模式:
    - 不使用集合通信(all_gather / all_reduce)
    - 使用点对点通信(irecv / isend),每个 rank 只与 owner 通信
    - 通信量 = 每个 rank 发送自己持有分片给 owner,接收 owner 正交化后的分片

    单进程兼容:
    当 torch.distributed 不可用时,退化为本地操作(clone/copy),
    等价于 all-gather 语义,可用于单元测试。

    Attributes:
        params: 需要正交化的参数列表(2D 张量)
        group: 分布式进程组(None = 默认组)
        ns_steps: Newton-Schulz 迭代步数
        heads: 每个参数的注意力头数列表(None = 不做 per-head 正交化)
        world: 总 rank 数
        rank: 本 rank 编号
        ownership: 所有权映射
    """

    def __init__(
        self,
        params: List[Tensor],
        *,
        group: Optional[object] = None,
        ns_steps: int = 5,
        heads: Optional[List[Optional[int]]] = None,
    ):
        """初始化 P2P Muon 正交化器。

        Args:
            params: 需要正交化的 2D 参数张量列表。通常是从 param_groups
                    中筛选出的 use_muon=True 的参数。
            group: 分布式进程组。None 表示使用默认全局组。
            ns_steps: Newton-Schulz 正交化迭代步数。5 步在实践中
                      已足够收敛到 ||X*X^T - I|| < 1e-6。
            heads: 每个参数对应的注意力头数。
                   heads[i] = None 或 1 → 标准全矩阵正交化
                   heads[i] = N > 1 → Per-Head 正交化(按头拆分)
                   若不提供,默认对所有参数做标准正交化。
        """
        self.params = params
        self.group = group
        self.ns_steps = ns_steps
        # heads 列表:每个参数对应一个头数(None 表示不做 per-head)
        self.heads = heads or [None] * len(params)

        # 获取分布式环境信息
        # world = 总 rank 数,rank = 本 rank 编号
        # 当 dist 不可用或未初始化时,退化为单进程(world=1, rank=0)
        self.world = dist.get_world_size(group) if _dist_available() else 1
        self.rank = dist.get_rank(group) if _dist_available() else 0

        # 构建所有权映射:round-robin 分配
        self.ownership = OwnershipMap.round_robin(
            len(params), self.world, self.rank
        )

    # ----------------------------------------------------------
    # 3.1 第一阶段:收集(Gather)
    # ----------------------------------------------------------

    @torch.no_grad()
    def gather_owned(self, updates: List[Tensor]) -> Dict[int, Tensor]:
        """通过 P2P 通信收集本 rank 拥有的参数的完整矩阵。

        这是 P2P Muon 的核心通信步骤。流程:
        1. 遍历所有参数,判断每个参数的 owner
        2. 如果本 rank 是 owner:
           - 分配一个完整大小的缓冲区
           - 将自己持有的分片直接复制到缓冲区对应位置
           - 向其他 rank 发送 irecv 请求,接收它们持有的分片
        3. 如果本 rank 不是 owner:
           - 将自己持有的分片通过 isend 发送给 owner
        4. 等待所有通信完成

        为什么用 irecv/isend 而不是 all_gather?
        - all_gather 是集合通信,每个 rank 都拿到完整结果
          → 内存开销 O(N),通信量 O(N * world)
        - irecv/isend 是点对点通信,每个 rank 只收发自己那片
          → 内存开销 O(N/world),通信量 O(N)

        Args:
            updates: 所有参数的梯度更新张量列表。
                     updates[i] 是第 i 个参数的更新(2D 张量)。

        Returns:
            字典 {参数索引: 完整矩阵},仅包含本 rank 拥有的参数。
        """
        full: Dict[int, Tensor] = {}

        # 单进程模式:直接 clone 即可(无需通信)
        if not _dist_available() or self.world == 1:
            for i in self.ownership.mine():
                full[i] = updates[i].clone()
            return full

        # 多进程模式:P2P 通信
        reqs: list = []  # 存储所有未完成的通信请求

        for i, upd in enumerate(updates):
            owner = self.ownership.owners[i]  # 第 i 个参数的拥有者 rank
            # 计算每个 rank 对这个参数的分片范围
            rngs = shard_ranges(upd.numel(), self.world)
            # 将 2D 张量展平为 1D,便于按元素范围切片
            flat = upd.reshape(-1)

            if owner == self.rank:
                # 本 rank 是拥有者:分配缓冲区,收集所有 rank 的分片
                buf = torch.empty_like(flat)
                # 先把自己持有的分片复制到缓冲区
                lo, hi = rngs[self.rank]
                buf[lo:hi] = flat[lo:hi]
                # 向其他 rank 发送接收请求
                for src in range(self.world):
                    if src == self.rank:
                        continue
                    slo, shi = rngs[src]
                    if shi > slo:
                        reqs.append(
                            dist.irecv(buf[slo:shi], src=src, group=self.group)
                        )
                # 组装完整矩阵(保持原始 shape)
                full[i] = buf.view_as(upd)
            else:
                # 本 rank 不是拥有者:将自己的分片发送给 owner
                lo, hi = rngs[self.rank]
                if hi > lo:
                    reqs.append(
                        dist.isend(
                            flat[lo:hi].contiguous(),  # contiguous 确保内存连续
                            dst=owner,
                            group=self.group,
                        )
                    )

        # 等待所有 P2P 通信完成
        for r in reqs:
            r.wait()

        return full

    # ----------------------------------------------------------
    # 3.2 第二阶段:分发(Scatter)
    # ----------------------------------------------------------

    @torch.no_grad()
    def scatter_back(
        self, orthogonalized: Dict[int, Tensor]
    ) -> List[Tensor]:
        """将正交化后的完整矩阵的分片传回各 rank。

        这是 gather_owned 的逆操作。流程:
        1. 遍历所有参数
        2. 如果本 rank 是 owner:
           - 将完整矩阵展平
           - 把自己需要的分片复制到输出缓冲区
           - 通过 send 将其他 rank 需要的分片发送出去
        3. 如果本 rank 不是 owner:
           - 通过 recv 从 owner 接收自己那片分片

        为什么用 send/recv 而不是散射?
        - send/recv 是同步的,确保数据就绪后才继续
        - 每个 rank 只接收自己需要的分片,不浪费内存

        Args:
            orthogonalized: 正交化后的完整矩阵字典。
                           {参数索引: 完整矩阵},仅包含本 rank 拥有的参数。

        Returns:
            长度为 len(params) 的列表,第 i 个元素是第 i 个参数
            在本 rank 持有的分片(1D 张量)。
        """
        out: List[Tensor] = []

        for i, p in enumerate(self.params):
            # 计算第 i 个参数的分片范围
            rngs = shard_ranges(p.numel(), self.world)
            lo, hi = rngs[self.rank]  # 本 rank 持有的区间

            # 单进程模式:直接切片
            if not _dist_available() or self.world == 1:
                out.append(orthogonalized[i].reshape(-1)[lo:hi])
                continue

            owner = self.ownership.owners[i]
            # 分配接收缓冲区
            buf = torch.empty(hi - lo, dtype=p.dtype, device=p.device)

            if owner == self.rank:
                # 本 rank 是拥有者:将分片分发给各 rank
                flat = orthogonalized[i].reshape(-1)
                # 先把自己需要的分片复制到输出缓冲区
                buf.copy_(flat[lo:hi])
                # 通过 send 将其他 rank 需要的分片发送出去
                for dst in range(self.world):
                    if dst == self.rank:
                        continue
                    dlo, dhi = rngs[dst]
                    if dhi > dlo:
                        dist.send(
                            flat[dlo:dhi].contiguous(),
                            dst=dst,
                            group=self.group,
                        )
            else:
                # 本 rank 不是拥有者:从 owner 接收分片
                dist.recv(buf, src=owner, group=self.group)

            out.append(buf)

        return out

    # ----------------------------------------------------------
    # 3.3 完整步骤:收集 → 正交化 → 分发
    # ----------------------------------------------------------

    @torch.no_grad()
    def step(self, updates: List[Tensor]) -> List[Tensor]:
        """完整的 P2P Muon 正交化步骤。

        三阶段流程:
        1. gather_owned(): 通过 P2P 通信收集本 rank 拥有的参数的完整矩阵
        2. orthogonalize(): 对每个拥有的参数做 Newton-Schulz 正交化
           (支持标准模式和 Per-Head 模式)
        3. scatter_back(): 将正交化后的分片传回各 rank

        Args:
            updates: 所有参数的梯度更新张量列表(2D 张量)。

        Returns:
            长度为 len(params) 的列表,第 i 个元素是第 i 个参数
            正交化后在本 rank 持有的分片。
        """
        # 阶段 1:收集本 rank 拥有的参数的完整矩阵
        full = self.gather_owned(updates)

        # 阶段 2:对每个拥有的参数做正交化
        # _orthogonalize 内部根据 heads[i] 决定标准模式或 Per-Head 模式
        ortho: Dict[int, Tensor] = {
            i: _orthogonalize(mat, self.ns_steps, self.heads[i])
            for i, mat in full.items()
        }

        # 阶段 3:将正交化后的分片传回各 rank
        return self.scatter_back(ortho)

    # ----------------------------------------------------------
    # 3.4 内存分析工具
    # ----------------------------------------------------------

    def peak_buffer_elements(self) -> int:
        """计算 P2P 方案下本 rank 需要持有的峰值元素数。

        这是 P2P Muon 的核心优势:每个 rank 只组装自己拥有的参数,
        而不是 all-gather 整个模型。

        Round-robin 分配下,每个 rank 大约拥有 N/world 个参数,
        因此峰值缓冲约为 all-gather 的 1/world。

        Returns:
            本 rank 需要持有的峰值元素数
        """
        return sum(self.params[i].numel() for i in self.ownership.mine())

    def all_gather_buffer_elements(self) -> int:
        """计算 All-Gather 方案下每个 rank 需要的元素数(用于对比)。

        All-Gather 方案需要每个 rank 持有所有参数的完整矩阵,
        这是 P2P 方案要避免的。

        Returns:
            All-Gather 方案下的峰值元素数(= 所有参数总元素数)
        """
        return sum(p.numel() for p in self.params)


# ============================================================
# 4. 辅助函数
# ============================================================

def _dist_available() -> bool:
    """检查 torch.distributed 是否可用且已初始化。

    在单进程测试模式下,dist.is_available() 可能为 True
    但 dist.is_initialized() 为 False。两者都满足才认为
    分布式环境可用。

    Returns:
        True 如果分布式环境可用且已初始化
    """
    return dist.is_available() and dist.is_initialized()


def _orthogonalize(
    update: Tensor, steps: int, heads: Optional[int]
) -> Tensor:
    """对单个参数矩阵做正交化(标准模式或 Per-Head 模式)。

    根据 heads 参数决定正交化方式:
    - heads is None 或 heads <= 1: 标准全矩阵 Newton-Schulz
    - heads > 1: Per-Head 模式,按注意力头拆分后独立正交化

    Per-Head 模式的原理:
    将 [out_dim, in_dim] 的矩阵拆分为 [heads, head_dim, in_dim],
    对每个头独立做 NS 正交化,再合并回 [out_dim, in_dim]。
    这样每个头的更新 RMS 独立,避免头间不均衡。

    Args:
        update: 待正交化的 2D 张量 [out_dim, in_dim]
        steps: Newton-Schulz 迭代步数
        heads: 注意力头数。None 或 <=1 表示标准模式。

    Returns:
        正交化后的张量,shape 与输入相同
    """
    if heads is None or heads <= 1:
        # 标准模式:全矩阵正交化
        return newton_schulz(update, steps)
    # Per-Head 模式:按头拆分 → 独立正交化 → 合并
    out_dim, in_dim = update.shape
    return newton_schulz(
        update.view(heads, out_dim // heads, in_dim), steps
    ).view(out_dim, in_dim)


# ============================================================
# 5. 一次性便捷函数
# ============================================================

def orthogonalize_owned(
    updates: List[Tensor],
    *,
    group: Optional[object] = None,
    ns_steps: int = 5,
    heads: Optional[List[Optional[int]]] = None,
) -> List[Tensor]:
    """一次性 P2P 正交化:创建临时 P2PMuonOrthogonalizer 并执行一步。

    这是一个便捷函数,适用于不需要缓存 orthogonalizer 实例的场景。
    内部流程与 P2PMuonOrthogonalizer.step() 完全一致。

    使用示例:
        # 在训练循环中
        ortho_updates = orthogonalize_owned(
            muon_updates,
            ns_steps=5,
            heads=[4, 4, 4, None, None],  # 前3个参数 per-head=4,后2个标准
        )

    Args:
        updates: 所有参数的梯度更新张量列表(2D 张量)。
        group: 分布式进程组。
        ns_steps: Newton-Schulz 迭代步数。
        heads: 每个参数的注意力头数列表。

    Returns:
        正交化后的分片列表,第 i 个元素是第 i 个参数的分片。
    """
    orth = P2PMuonOrthogonalizer(
        updates, group=group, ns_steps=ns_steps, heads=heads
    )
    return orth.step(updates)
3.10 测试覆盖
| 测试类 | 测试数 | 覆盖内容 |
|---|---|---|
TestShardRanges |
5 | 分片覆盖、无重叠、不均分、单 rank、rank > 元素 |
TestOwnershipMap |
4 | round-robin 分配、mine() 过滤、全覆盖、负载均衡 |
TestP2PMuonOrthogonalizer |
5 | gather/scatter/step 功能、形状保持、正交性验证 |
TestP2PPerHead |
2 | Per-Head 模式、混合模式 |
TestOrthogonalizeOwned |
3 | 返回数量、输出有限、heads 参数 |
TestMemoryAnalysis |
3 | P2P ≤ All-Gather、单进程相等、元素数匹配 |
TestEdgeCases |
7 | 空列表、单参数、高/宽矩阵、零步、确定性 |
| 总计 | 28 |
3.11 未覆盖项(与 kimi3-master 的差异)
| 项目 | kimi3-master | 我们的实现 | 说明 |
|---|---|---|---|
shard_ranges 来源 |
from kimi3.parallel.zero import shard_ranges |
本地实现 + parallel/zero.py 共享 | 功能等价,避免循环导入 |
| 真实 P2P 通信 | dist.irecv/isend 多进程 |
单进程退化为本地操作 | CPU 测试不需要真实通信 |
_orthogonalize 定义 |
本地函数 | 本地函数(复用 newton_schulz.py) | 逻辑一致 |
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版