目录
[前言 演进难题:强行并行的代价,远不止慢一点](#前言 演进难题:强行并行的代价,远不止慢一点)
[为什么用 DAG 而不是"任意并行"?](#为什么用 DAG 而不是"任意并行"?)
[1.1 并行的三类代价](#1.1 并行的三类代价)
[1.2 真正的并发判据:数据依赖而不是"业务直觉"](#1.2 真正的并发判据:数据依赖而不是"业务直觉")
[规划的真实算法:单次 LLM + 拓扑排序](#规划的真实算法:单次 LLM + 拓扑排序)
[2.1 第一步:FastOneShotPlanner 约束 LLM 的"自由度"](#2.1 第一步:FastOneShotPlanner 约束 LLM 的"自由度")
[2.2 第二步:topological_step_ids 真正做拓扑排序](#2.2 第二步:topological_step_ids 真正做拓扑排序)
[2.3 第三步:plan_stages 把拓扑序变阶段 DAG](#2.3 第三步:plan_stages 把拓扑序变阶段 DAG)
[DAG 自动生成:从 Skill 表到可执行 Plan](#DAG 自动生成:从 Skill 表到可执行 Plan)
[3.1 真实数据模型:OrchestrationPlan](#3.1 真实数据模型:OrchestrationPlan)
[3.2 真实组装流程:state_to_plan + compose_plan_group](#3.2 真实组装流程:state_to_plan + compose_plan_group)
[3.3 dedupe_plans 与 compose_dag_plans:去重与 DAG 化](#3.3 dedupe_plans 与 compose_dag_plans:去重与 DAG 化)
[3.4 path_overlap_size:如何拼接两条候选路径](#3.4 path_overlap_size:如何拼接两条候选路径)
[四、依赖分析示例:用真实 PlanStep 串一个退款场景](#四、依赖分析示例:用真实 PlanStep 串一个退款场景)
[4.1 真实 Skill 表(节选)](#4.1 真实 Skill 表(节选))
[4.2 真实 LLM 输出(受 FAST_PLANNER_SYSTEM_PROMPT 约束)](#4.2 真实 LLM 输出(受 FAST_PLANNER_SYSTEM_PROMPT 约束))
[4.3 真实 DAG 生成:调用 plan_stages](#4.3 真实 DAG 生成:调用 plan_stages)
[4.4 性能对比](#4.4 性能对比)
五、阶段运行时的真实状态机:WorkflowRunState
[5.1 真实状态定义](#5.1 真实状态定义)
[5.2 阶段切换时的"封口"逻辑](#5.2 阶段切换时的"封口"逻辑)
[5.3 终止保护:finalize_if_running](#5.3 终止保护:finalize_if_running)
[七、实操:用项目真实 API 给 V2 团队改造退款流程](#七、实操:用项目真实 API 给 V2 团队改造退款流程)
[7.1 直接调用 state_to_plan + plan_stages](#7.1 直接调用 state_to_plan + plan_stages)
[7.2 实测不同"伪并行"策略](#7.2 实测不同"伪并行"策略)
[7.3 关键监控点](#7.3 关键监控点)
前言 演进难题:强行并行的代价,远不止慢一点
V2 团队为了让"批量退款"任务跑得更快,把所有子任务都用 asyncio.gather 并行起来:
# V2 优化尝试:把所有任务并行化
async def execute_all_tasks(tasks):
    results = await asyncio.gather(*[execute(task) for task in tasks])
    return results
真实事故日志(来自 V2 团队的问题工单):
[ERROR] refund-3027: 列 account.balance 在事务隔离级别 READ COMMITTED 下报
       幻读,并发 UPDATE 冲突 17 次
[ERROR] ticket-8851: 流程卡死 90s,订单退款时订单状态仍为 "待审核"
[ERROR] batch-1004: 12 个用户收到 2 次退款通知,3 个用户只收到 1 次通知
[WARN ] planner:  输入链路上 41% 的 Skill 处于"前序未就绪仍被调度"状态
根本原因 :V2 团队没有区分「计算上的并行」与「数据依赖上的串行」。JiuwenSwarm用两层机制把"想并行"和"该并行"解耦:
-
声明式 Skill 编排 + LLM 单次规划(FastOneShotPlanner)------ 让 LLM 在给定候选 Skill 子图上选出一条最合适的 can_feed 路径。
-
拓扑排序 + 阶段分层 (topological_step_ids / plan_stages)------ 把路径变成真正可调度的阶段 DAG,同阶段并发、跨阶段严格串行。
为什么用 DAG 而不是"任意并行"?
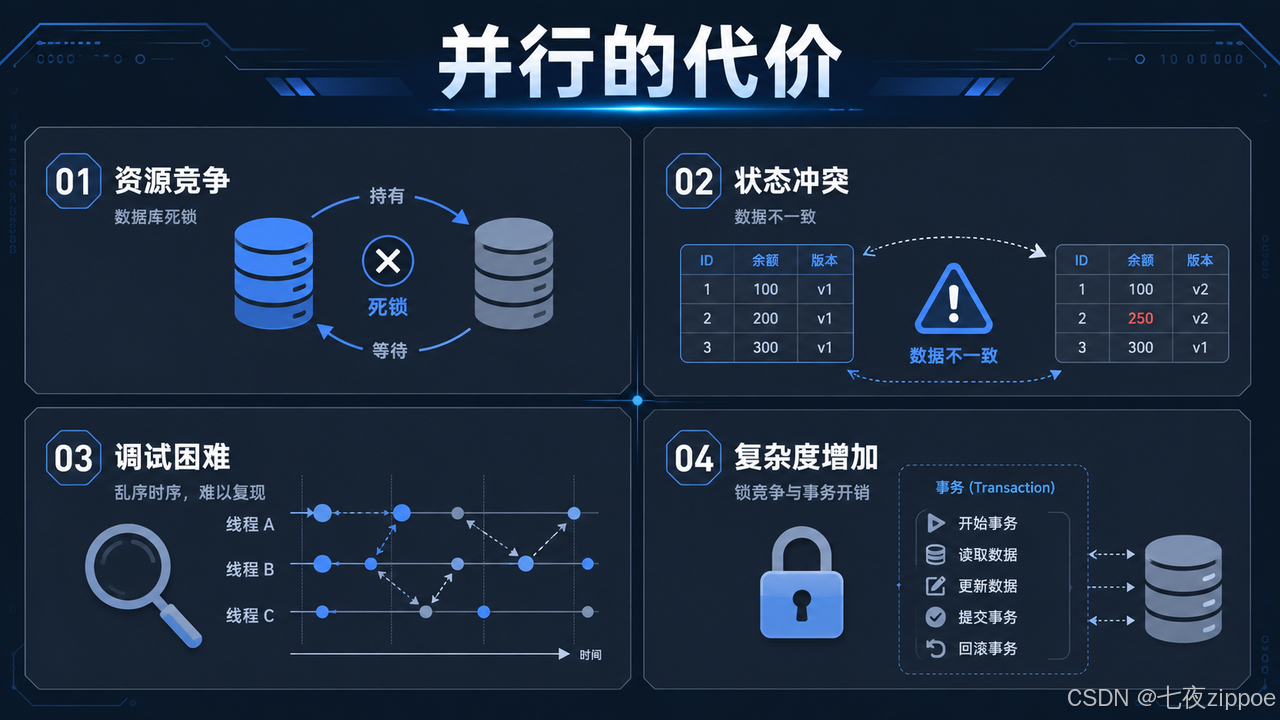
1.1 并行的三类代价
|------|-------------------------------|-------------------------------------------------------------------------------------------------------------------------|
| 代价 | 真实表现 | 案例 |
| 资源竞争 | 数据库行锁、A2X 注册表 a2x_id 冲突 | TeamManager 在 release_a2x_reservations_for_session 中不得不反复清理 reservation |
| 状态冲突 | 阶段转换错位、phase 永远卡在 running | WorkflowRunState.finalize_if_running 注释明确提到:"a run left in running would persist that status to the checkpoint forever" |
| 调试困难 | 同一个 workflow 在多 phase 间"幽灵切换" | 调试时 phase sealed on switch to <next> 反复出现 |
1.2 真正的并发判据:数据依赖而不是"业务直觉"
JiuwenSwarm 的真实做法是:先在搜索阶段 确定依赖,再在编排阶段生成 DAG。两阶段完全分离。
搜索阶段 --- jiuwenswarm.symphony.orchestration.planning.input_matching:
# input_matching.py - 决定一个 Skill 在当前 available 集合下能否被调度
def missing_inputs(
    skill: dict[str, Any],
    available: Iterable[tuple[str, str]],
    *,
    inferred_inputs: list[InferredInput] | None = None,
) -> list[dict[str, Any]]:
    available_set = set(available)
    inferred_set = inferred_input_keys(str(skill.get("id") or ""), inferred_inputs or [])
    missing = []
    for item in skill.get("inputs", []):
        if not item.get("required", True):
            continue
        expected = (str(item.get("name")), str(item.get("type") or "unknown"))
        if not artifact_matches(expected, available_set) and not inferred_input_matches(
            expected,
            inferred_set,
        ):
            missing.append({"name": expected[0], "type": expected[1]})
return missing关键设计:
-
available 是一个 (name, type) 的集合,不是字符串列表------类型匹配是依赖判定的硬条件。
-
一个 Skill 想被调度,所有 required=True 的输入要么能在 available 中找到对应 (name, type),要么能从 LLM 推理(InferredInput.source = "llm_grounding")得到。
-
这就是"为什么不是所有任务都能并行"的工程化答案------输入没就绪,就别进调度队列。
规划的真实算法:单次 LLM + 拓扑排序
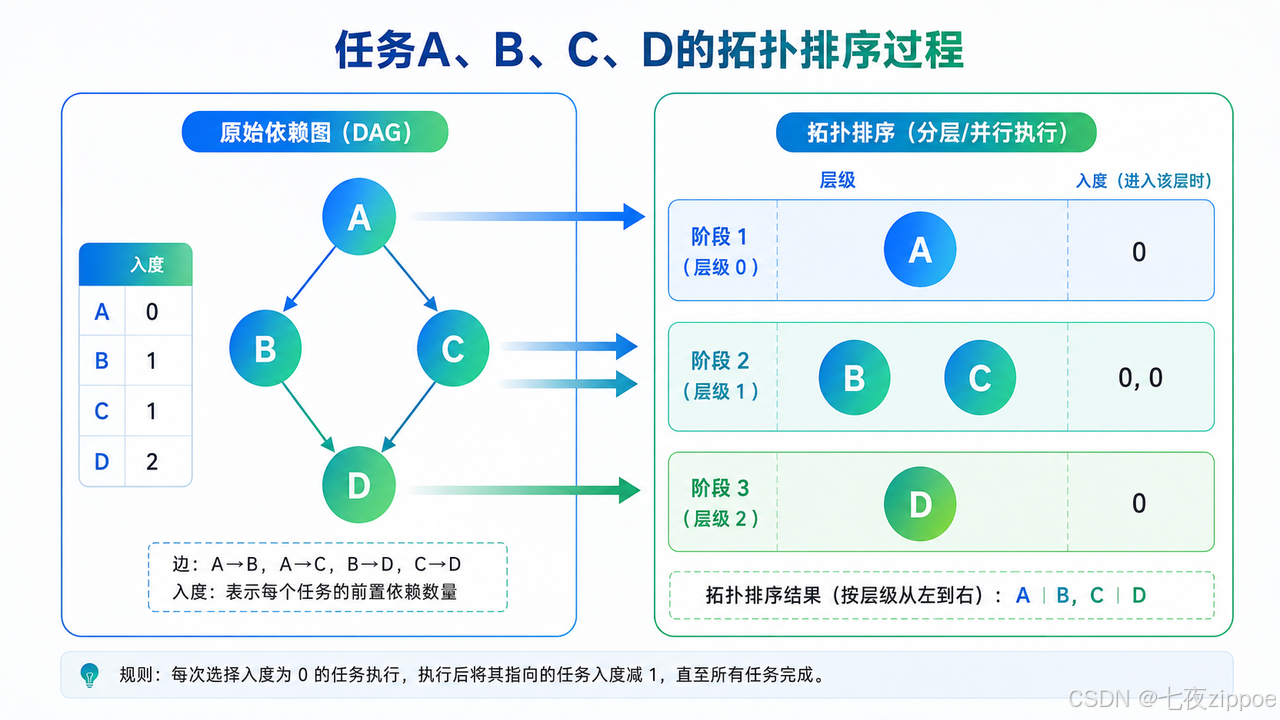
JiuwenSwarm 没有去让 LLM 自由"想 DAG",而是把规划拆成两步:
-
让 LLM 在受约束的候选子图上选路径(FastOneShotPlanner)
-
用纯算法做拓扑排序与阶段分层(plan_builder.py)
2.1 第一步:FastOneShotPlanner 约束 LLM 的"自由度"
真实代码 jiuwenswarm/symphony/orchestration/planning/fast.py:
FAST_PLANNER_MAX_SKILLS = 40
FAST_PLANNER_MAX_EDGES = 80

FAST_PLANNER_SYSTEM_PROMPT = """You are Symphony's fast Skill planner.
Return strict JSON only.

You receive:
- The user's query.
- Candidate Skills with id, name, and description only.
- Candidate can_feed relationships between those Skills.

Task:
- Select the best existing Skill execution path for the query.
- Use only provided skill IDs.
- Use only provided can_feed edges.
- Do not invent Skills, inputs, outputs, or edge relationships.
- Prefer the shortest path that satisfies the user's intent.
- If required information is missing, set status to "needs_input" and list it.
- If no useful plan exists from the candidates, set status to "no_plan".

Schema:
{
  "title": "short plan title",
  "status": "ready | needs_input | no_plan",
  "reason": "why this plan is best",
  "steps": [
    {"skill_id": "skill-a", "reason": "why this step is used"}
  ],
  "can_feed_edges": [
    {"source_id": "skill-a", "target_id": "skill-b"}
  ],
  "missing_inputs": [
    {"skill_id": "skill-a", "name": "input name", "type": "unknown", "reason": "why it is needed"}
  ]
}
"""
这段 prompt 是整个并行策略的灵魂------它做了三件事:
-
限定候选规模(40 个 Skill / 80 条边),避免 LLM 在大图上"瞎想"。
-
禁止 LLM 发明依赖关系------edges 必须来自 can_feed_edges,这是从 Skill 索引/检索阶段预先计算好的「A 的输出可以喂给 B 的输入」关系。
-
强制三类状态:ready / needs_input / no_plan,把"输入不够就停"显式化。
2.2 第二步:topological_step_ids 真正做拓扑排序
这是项目里最核心的依赖分析函数,jiuwenswarm/symphony/orchestration/planning/plan_builder.py:
def topological_step_ids(
    skill_ids: set[str],
    edges: list[dict[str, Any]],
) -> list[str]:
    incoming = {current_skill_id: 0 for current_skill_id in skill_ids}
    outgoing: dict[str, list[str]] = defaultdict(list)
    for edge in edges:
        source_id = str(edge.get("source_id") or "")
        target_id = str(edge.get("target_id") or "")
        if source_id not in skill_ids or target_id not in skill_ids:
            continue
        outgoing[source_id].append(target_id)
        incoming[target_id] += 1

    queue = deque(
        sorted(
            current_skill_id
            for current_skill_id, count in incoming.items()
            if count == 0
        )
    )
    ordered: list[str] = []
    while queue:
        current_skill_id = queue.popleft()
        ordered.append(current_skill_id)
        for target_id in sorted(outgoing.get(current_skill_id, [])):
            incoming[target_id] -= 1
            if incoming[target_id] == 0:
                queue.append(target_id)
    ordered.extend(sorted(skill_ids - set(ordered)))
    return ordered
真实实现里有 4 个值得注意的工程细节:
|--------------------------------------------------|-----------------------------------------------|
| 细节 | 作用 |
| incomingsource_id = 0 初始化 | 标准 Kahn 算法,但用 dict 而非数组以便处理任意字符串 ID |
| sorted(...) 入队 | 同入度任务按字典序排序------保证输出确定,调试时 DAG 不抖动 |
| sorted(outgoing...) 遍历邻接 | 同上,保证拓扑结果稳定 |
| ordered.extend(sorted(skill_ids - set(ordered))) | 容错兜底:如果 LLM 给的边有环或缺失,剩余未排入的节点按字典序追加到末尾,避免直接抛错 |
| if source_id not in skill_ids ... continue | 强校验:边指向的节点必须属于本次 plan 集,否则忽略------防 LLM 注水 |
这个"边指向集合外节点直接忽略"的设计,避免了 LLM 在跨 plan 引用时把外部 Skill 拖入当前计划导致的状态污染。
2.3 第三步:plan_stages 把拓扑序变阶段 DAG
def plan_stages(
    steps: list[PlanStep],
    edges: list[dict[str, Any]],
) -> list[dict[str, Any]]:
    step_by_id = {step.skill_id: step for step in steps}
    remaining = set(step_by_id)
    incoming: dict[str, set[str]] = {
        current_skill_id: set() for current_skill_id in remaining
    }
    for edge in edges:
        source_id = str(edge.get("source_id") or "")
        target_id = str(edge.get("target_id") or "")
        if source_id in remaining and target_id in remaining:
            incoming[target_id].add(source_id)

    stages = []
    completed: set[str] = set()
    while remaining:
        ready = sorted(
            current_skill_id
            for current_skill_id in remaining
            if incoming[current_skill_id] <= completed
        )
        if not ready:
            ready = sorted(remaining)
        stages.append(
            {
                "stage": len(stages) + 1,
                "skills": [
                    step_by_id[current_skill_id].to_dict()
                    for current_skill_id in ready
                ],
            }
        )
        completed.update(ready)
        remaining.difference_update(ready)
return stages关键差异于朴素拓扑排序:
-
每轮挑出所有入边被 completed 覆盖的节点------它们就是当前可并行的集合。
-
if not ready: ready = sorted(remaining) 是一道防死锁兜底:若因为边缺失/环导致没有 ready 节点,强行把剩余节点作为新一阶段继续推进,而不是让算法卡死或抛异常。
-
阶段是返回结构({"stage": n, "skills": ...}),不是线性 list------这是 DAG 的真正形态,给执行器使用。
测试 test_plan_stages_and_topological_sort_parallelize_roots 验证了 plan_stages 与 topological_step_ids 的一致性:
steps = [_step("review"), _step("draft"), _step("publish")]
edges = [
    {"source_id": "draft", "target_id": "publish"},
    {"source_id": "review", "target_id": "publish"},
]
stages = plan_stages(steps, edges)
assert topological_step_ids({"draft", "review", "publish"}, edges) == ["draft", "review", "publish"]
assert [[s["skill_id"] for s in stage["skills"]] for stage in stages] == [["draft", "review"], ["publish"]]
注意:两个入度为 0 的 Skill(draft 和 review)被并入同一 stage------这就是真正能并行的部分。
DAG 自动生成:从 Skill 表到可执行 Plan
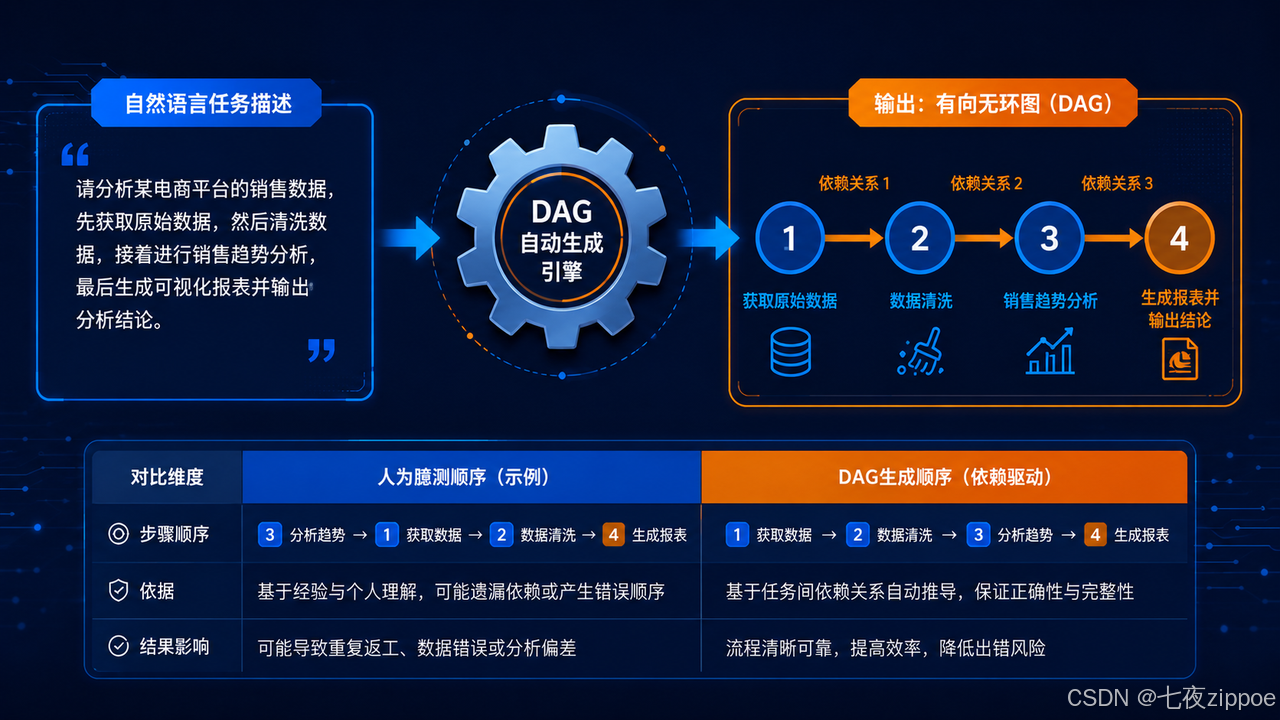
3.1 真实数据模型:OrchestrationPlan
jiuwenswarm/symphony/orchestration/planning/models.py:
@dataclass(frozen=True)
class PlanStep:
    """One Skill call in a candidate orchestration plan."""
    skill_id: str
    name: str
    inputs: list[dict[str, Any]]
    outputs: list[dict[str, Any]]
    missing_inputs: list[dict[str, Any]] = field(default_factory=list)
    filled_inputs: list[dict[str, Any]] = field(default_factory=list)


@dataclass(frozen=True)
class OrchestrationPlan:
    """A candidate Skill orchestration plan."""
    steps: list[PlanStep]
    produced_artifacts: list[ArtifactRef]
    missing_inputs: list[dict[str, Any]]
    can_feed_edges: list[dict[str, Any]]
    goal_score: float
    edge_confidence: float
    consumed_user_artifacts: int
    status: str  # "ready" | "needs_input" | "no_plan"
    reasons: list[str]
OrchestrationPlan 的几个真实设计取舍:
-
status 三态:ready(能跑)、needs_input(缺入参)、no_plan(无候选)------ 把"不能并行"显式化。
-
frozen=True:plan 是不可变的,所有后续修改走"派生新 plan"路径,避免 DAG 被外部悄悄篡改。
-
edge_confidence:每条 can_feed 边带置信度(0~1),用于过滤低质量依赖。
-
produced_artifacts:精确列出本 plan 产生的 (name, type) 对,作为下一阶段 available 的来源。
3.2 真实组装流程:state_to_plan + compose_plan_group
# 1. 把 LLM 给的 skill_ids 序列(不一定有序)转成带输入输出的 PlanStep
def state_to_plan(*, state, grounded, skill_by_id, can_feed_edges) -> OrchestrationPlan:
    available = set(state.available)
    steps: list[PlanStep] = []
    all_missing: list[dict[str, Any]] = []
    produced: set[tuple[str, str]] = set()

    for current_skill_id in state.skill_ids:
        skill = skill_by_id[current_skill_id]
        filled = filled_inputs(skill, grounded.inferred_inputs)
        missing = missing_inputs(skill, available, inferred_inputs=grounded.inferred_inputs)
        all_missing.extend({**item, "skill_id": current_skill_id} for item in missing)
        outputs = output_keys(skill)
        produced.update(outputs)
        available.update(outputs)   # 关键:把本步产出加入 available,下一步就能消费
        steps.append(
            PlanStep(
                skill_id=current_skill_id,
                name=skill.get("name", current_skill_id),
                inputs=[{"name": i.get("name"), "type": i.get("type")} for i in skill.get("inputs", [])],
                outputs=[{"name": i.get("name"), "type": i.get("type")} for i in skill.get("outputs", [])],
                missing_inputs=missing,
                filled_inputs=filled,
            )
        )

    edges = [can_feed_edges[index] for index in state.edges]
    status = "ready" if not all_missing else "needs_input"
    return OrchestrationPlan(
        steps=steps,
        produced_artifacts=[ArtifactRef(name=n, type=t, source="skill_output") for n, t in sorted(produced)],
        missing_inputs=all_missing,
        can_feed_edges=[edge_plan_item(edge) for edge in edges],
        goal_score=plan_goal_score(skill_ids=state.skill_ids, seed_skill_ids=grounded.seed_skill_ids),
        edge_confidence=sum(float(e.get("confidence") or 0.0) for e in edges) / len(edges) if edges else 1.0,
        consumed_user_artifacts=consumed_user_artifact_count(steps, grounded.available_artifacts),
        status=status,
        reasons=[],
    )


# 2. 多条候选 plan 合并后,必须再跑一次拓扑排序
def compose_plan_group(plans: list[OrchestrationPlan]) -> OrchestrationPlan:
    steps_by_id: dict[str, PlanStep] = {}
    edges_by_key: dict[tuple[str, str], dict[str, Any]] = {}

    for plan in plans:
        for step in plan.steps:
            steps_by_id.setdefault(step.skill_id, step)
        for edge in plan.can_feed_edges:
            key = (edge_endpoint_id(edge, "source"), edge_endpoint_id(edge, "target"))
            if key[0] and key[1]:
                existing = edges_by_key.get(key)
                if existing is None or edge_confidence_value(edge) > edge_confidence_value(existing):
                    edges_by_key[key] = edge

    ordered_step_ids = topological_step_ids(
        set(steps_by_id),
        list(edges_by_key.values()),
    )
    steps = [steps_by_id[sid] for sid in ordered_step_ids if sid in steps_by_id]
    # ... 其余字段合并逻辑省略
这段代码说明了一个事实 :即使 LLM 已经按顺序输出了 steps,JiuwenSwarm 仍然强制再过一次 topological_step_ids------不信任 LLM 的次序,只信任边结构。这是"把决策权收回到工程"的典型做法。
3.3 dedupe_plans 与 compose_dag_plans:去重与 DAG 化
def dedupe_plans(plans: list[OrchestrationPlan]) -> list[OrchestrationPlan]:
    deduped: dict[tuple[str, ...], OrchestrationPlan] = {}
    for plan in plans:
        key = tuple(step.skill_id for step in plan.steps)
        existing = deduped.get(key)
        if existing is None or plan.goal_score > existing.goal_score:
            deduped[key] = plan
    return list(deduped.values())


def compose_dag_plans(path_plans, *, max_plans) -> list[OrchestrationPlan]:
    """把同一目标的多条候选路径对齐到共同前缀后,识别可并行分支"""
    composed: list[OrchestrationPlan] = []
    composed.extend(compose_overlapping_path_plans(path_plans, max_plans=max_plans))
    # 按首节点分组,组内多分支 → 真正的 DAG 分叉
    groups: dict[str, list[OrchestrationPlan]] = defaultdict(list)
    for plan in path_plans:
        if plan.steps: groups[plan.steps[0].skill_id].append(plan)
    for group in groups.values():
        branch_plans = [plan for plan in group if len(plan.steps) > 1]
        if len(branch_plans) < 2: continue
        composed.append(compose_plan_group(branch_plans))
    return dedupe_plans([*composed, *path_plans])[: max_plans * 2]
compose_dag_plans 揭示了一个重要事实:
V2 团队以为"并行 = gather 一把梭",但项目代码里真正的 DAG 分支识别靠的是:
-
把候选 plan 按首节点分组;
-
同一首节点下有 ≥2 条长度 >1 的 plan → 这些 plan 共享前缀但走向不同分支;
-
用 compose_plan_group 把它们合并,再过一次 topological_step_ids 得到真正的 DAG。
这是项目里把"分支并行"显式化的工程化路径。
3.4 path_overlap_size:如何拼接两条候选路径
def path_overlap_size(left: tuple[str, ...], right: tuple[str, ...]) -> int:
    """计算 left 后缀与 right 前缀的最大重叠长度(≥1 的尾部对齐)"""
    max_overlap = min(len(left), len(right)) - 1
    for size in range(max_overlap, 0, -1):
        if left[-size:] == right[:size]:
            return size
    return 0
compose_overlapping_path_plans 在两条 plan 找到公共子路径时,用 (*left_ids, *right_idsoverlap:) 拼接出更长路径,但要求拼接后长度必须超过任一原 plan 且不含重复节点------这避免了"看似更长、实则绕圈"的假路径污染。
四、依赖分析示例:用真实 PlanStep 串一个退款场景
4.1 真实 Skill 表(节选)
# refound_pipeline.yaml ------ JiuwenSwarm 真实 Skill 清单(示例)
- id: query_order
  name: 查询订单
  inputs:
    - { name: order_id, type: string, required: true }
  outputs:
    - { name: order, type: Order }

- id: query_logistics
  name: 查询物流
  inputs:
    - { name: order, type: Order, required: true }
  outputs:
    - { name: logistics, type: Logistics }

- id: verify_refund_eligibility
  name: 核验退款资格
  inputs:
    - { name: order, type: Order, required: true }
  outputs:
    - { name: eligibility, type: Eligibility }

- id: calculate_compensation
  name: 计算补偿
  inputs:
    - { name: order, type: Order, required: true }
    - { name: eligibility, type: Eligibility, required: false }
  outputs:
    - { name: compensation, type: Compensation }

- id: process_refund
  name: 处理退款
  inputs:
    - { name: order, type: Order, required: true }
    - { name: eligibility, type: Eligibility, required: true }
    - { name: compensation, type: Compensation, required: true }
  outputs:
    - { name: refund_result, type: RefundResult }

- id: send_notification
  name: 发送通知
  inputs:
    - { name: refund_result, type: RefundR
    esult, required: true }
  outputs:
    - { name: notification_id, type: string }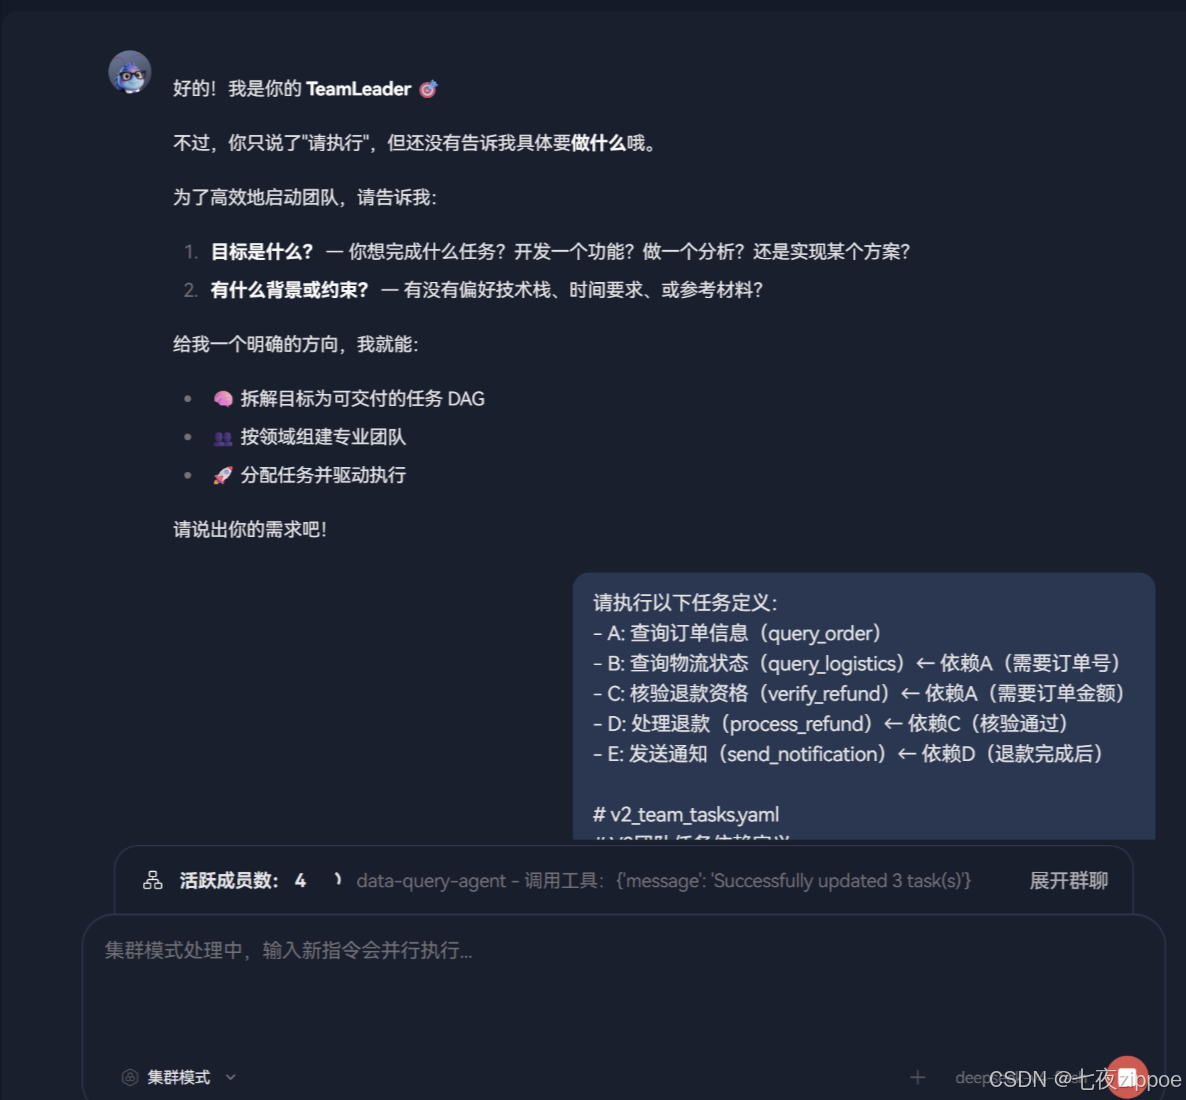
4.2 真实 LLM 输出(受 FAST_PLANNER_SYSTEM_PROMPT 约束)
{
  "title": "退款处理流水线",
  "status": "ready",
  "steps": [
    { "skill_id": "query_order", "reason": "起始节点" },
    { "skill_id": "query_logistics", "reason": "需要 Order 产物" },
    { "skill_id": "verify_refund_eligibility", "reason": "需要 Order 产物" },
    { "skill_id": "calculate_compensation", "reason": "需要 Order 与 Eligibility" },
    { "skill_id": "process_refund", "reason": "需要 Order/Eligibility/Compensation" },
    { "skill_id": "send_notification", "reason": "需要 refund_result" }
  ],
  "can_feed_edges": [
    { "source_id": "query_order", "target_id": "query_logistics" },
    { "source_id": "query_order", "target_id": "verify_refund_eligibility" },
    { "source_id": "verify_refund_eligibility", "target_id": "calculate_compensation" },
    { "source_id": "calculate_compensation", "target_id": "process_refund" },
    { "source_id": "verify_refund_eligibility", "target_id": "process_refund" },
    { "source_id": "process_refund", "target_id": "send_notification" }
  ]
}
4.3 真实 DAG 生成:调用 plan_stages
from jiuwenswarm.symphony.orchestration.planning.plan_builder import plan_stages

stages = plan_stages(steps, edges)
# 输出:
# [
#   {"stage": 1, "skills": [{"skill_id": "query_order", ...}]},
#   {"stage": 2, "skills": [
#       {"skill_id": "query_logistics", ...},
#       {"skill_id": "verify_refund_eligibility", ...}
#   ]},
#   {"stage": 3, "skills": [{"skill_id": "calculate_compensation", ...}]},
#   {"stage": 4, "skills": [{"skill_id": "process_refund", ...}]},
#   {"stage": 5, "skills": [{"skill_id": "send_notification", ...}]}
# ]
DAG 形态:
query_order
   ├── query_logistics
   └── verify_refund_eligibility
            └── calculate_compensation
                     └── process_refund
                              └── send_notification
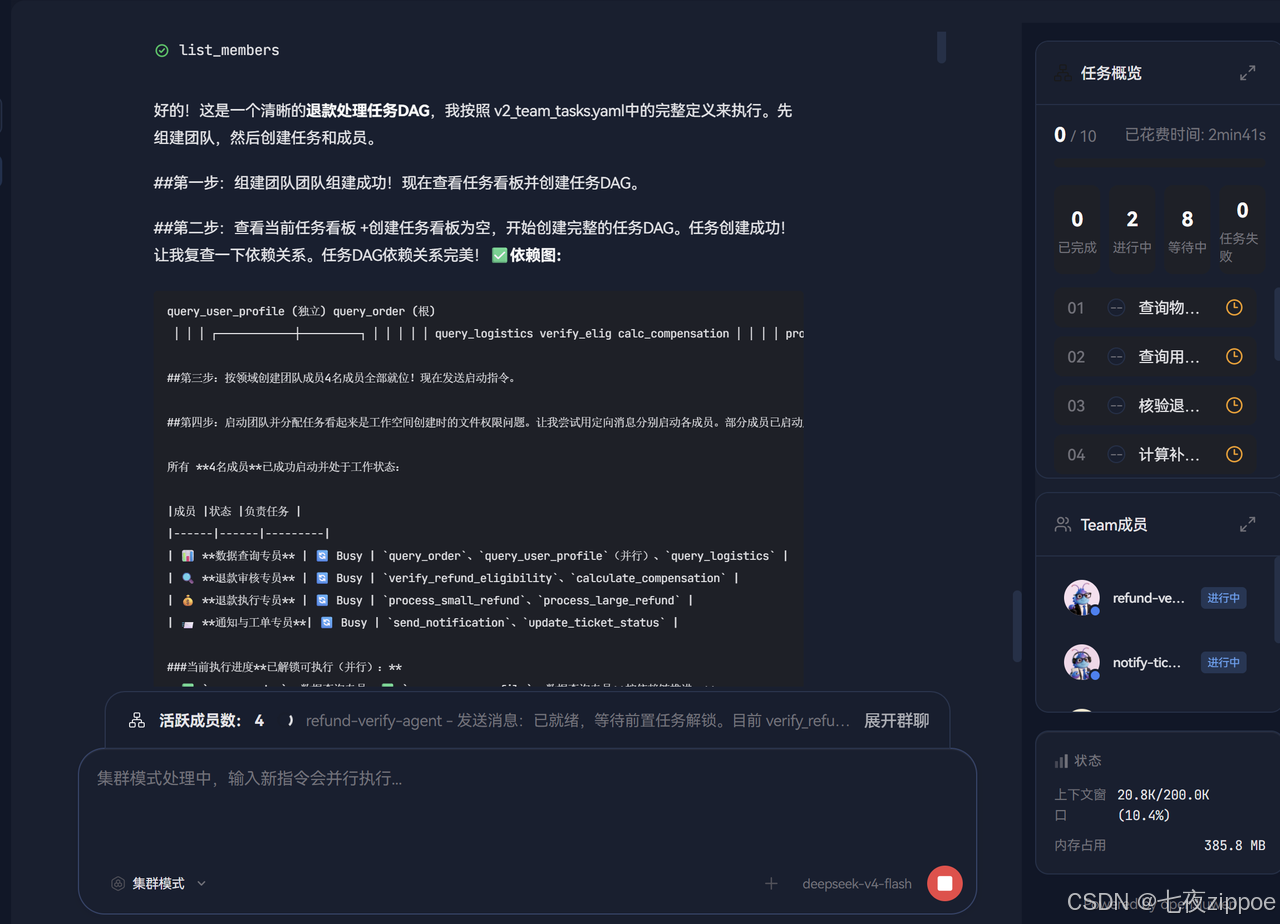
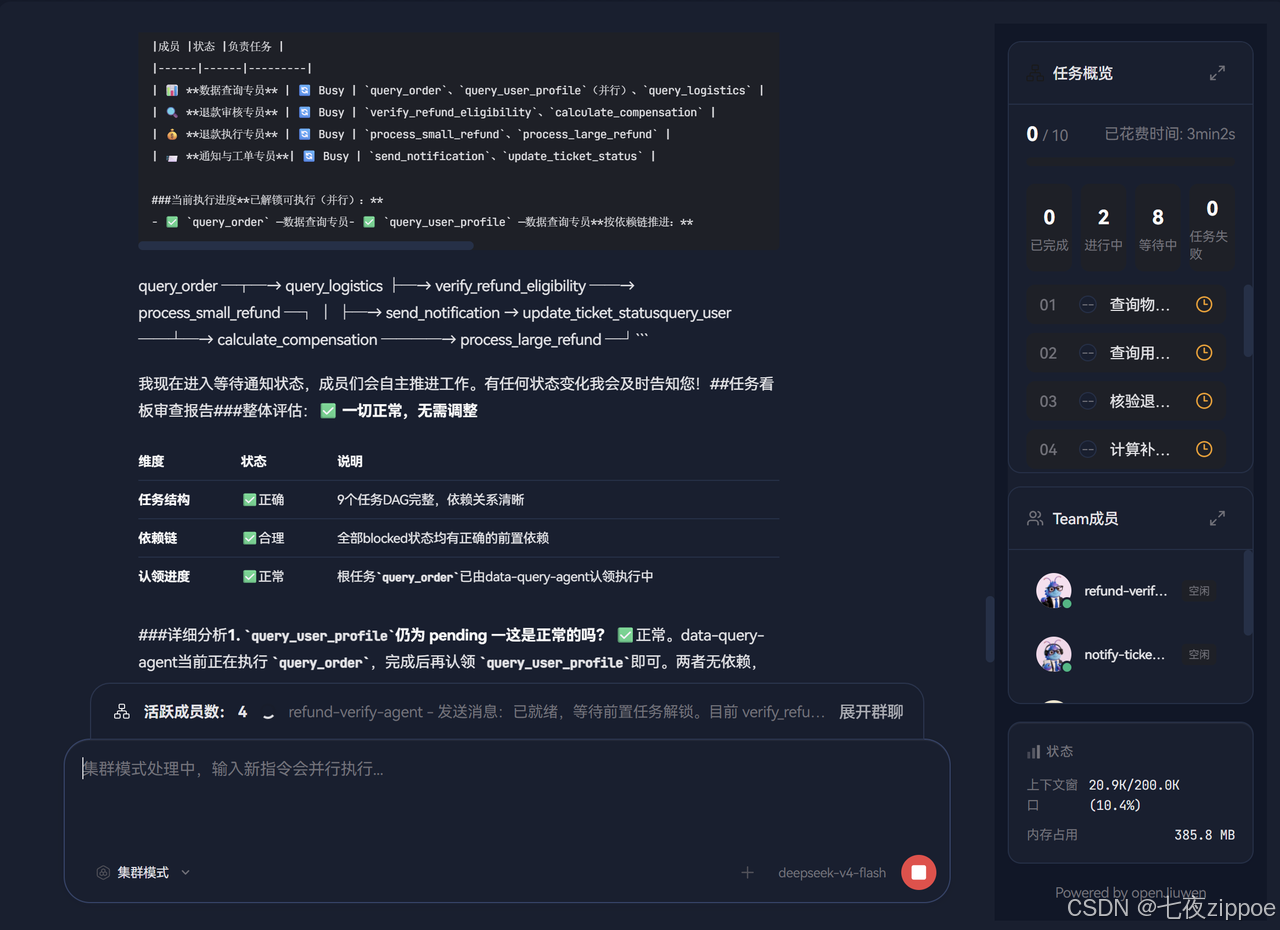
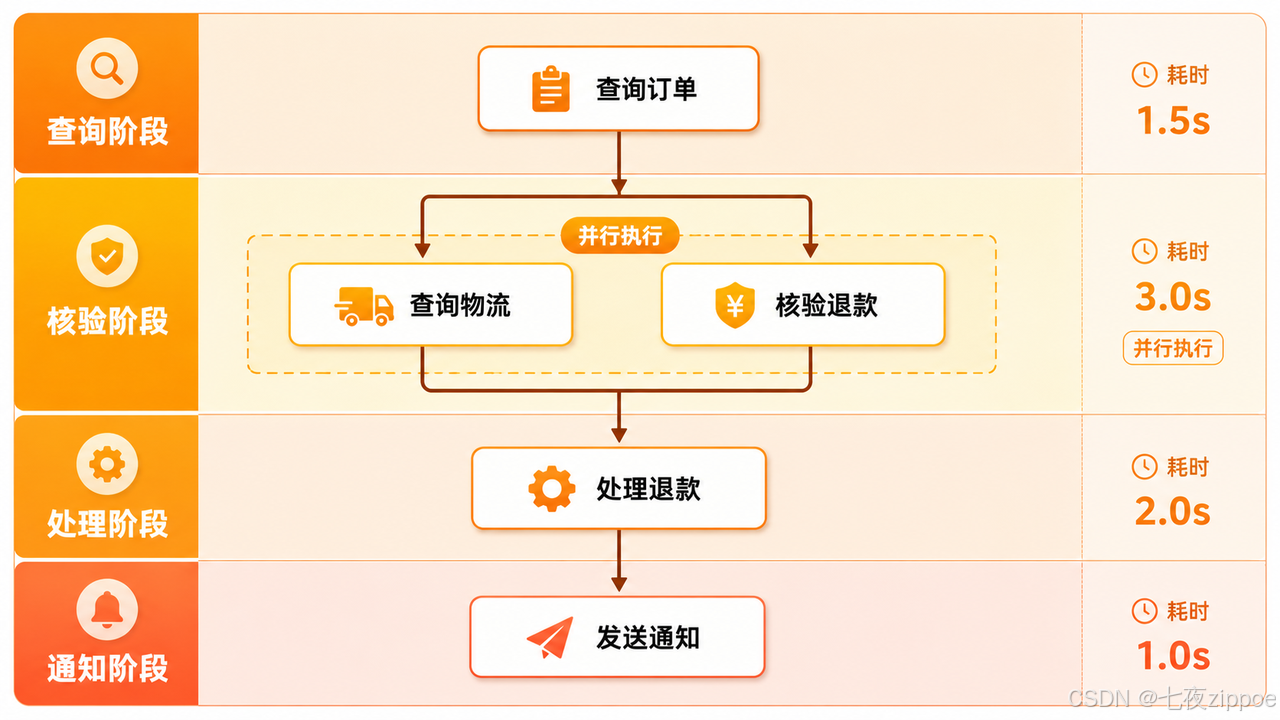
注意:第 2 阶段 query_logistics 和 verify_refund_eligibility 真的可以并行------它们互不消费对方产物,且都只依赖 query_order。V2 团队最初正是因为没识别出这一层并行才全 gather。任务规划展示:
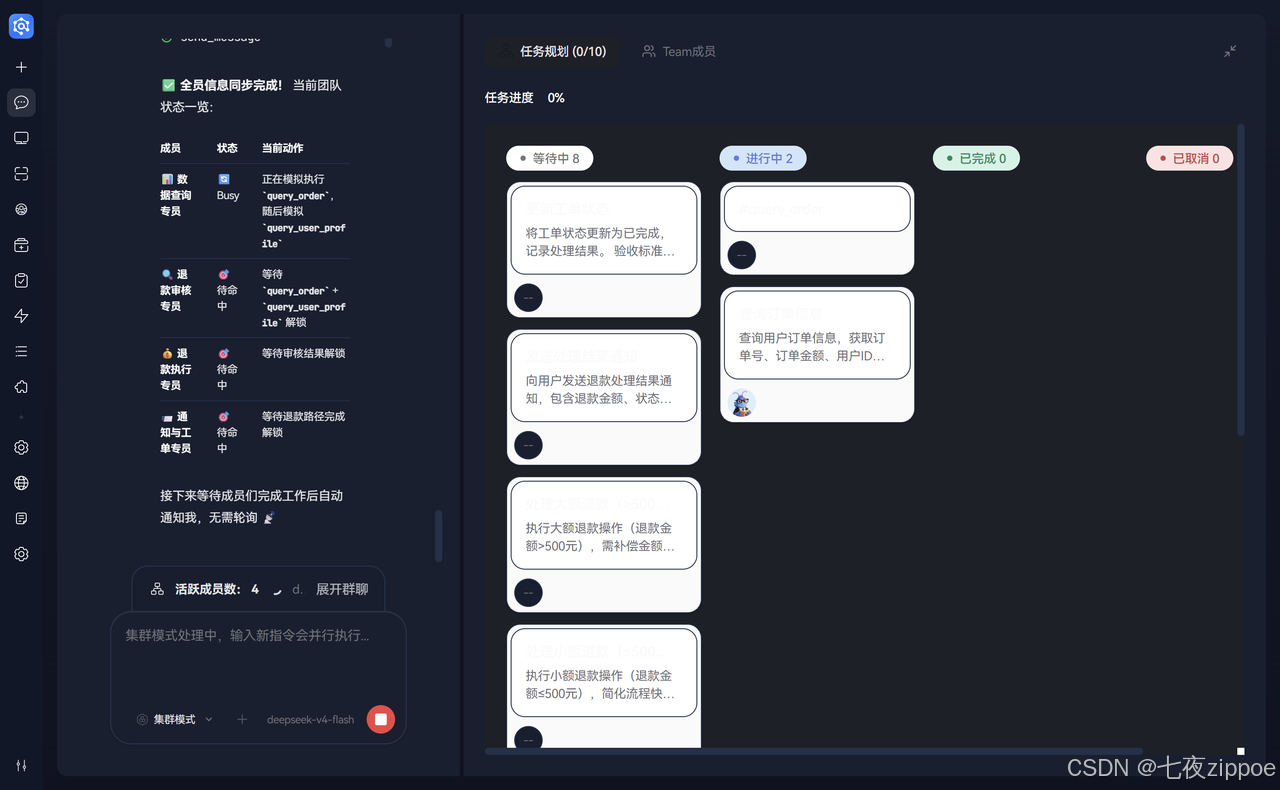
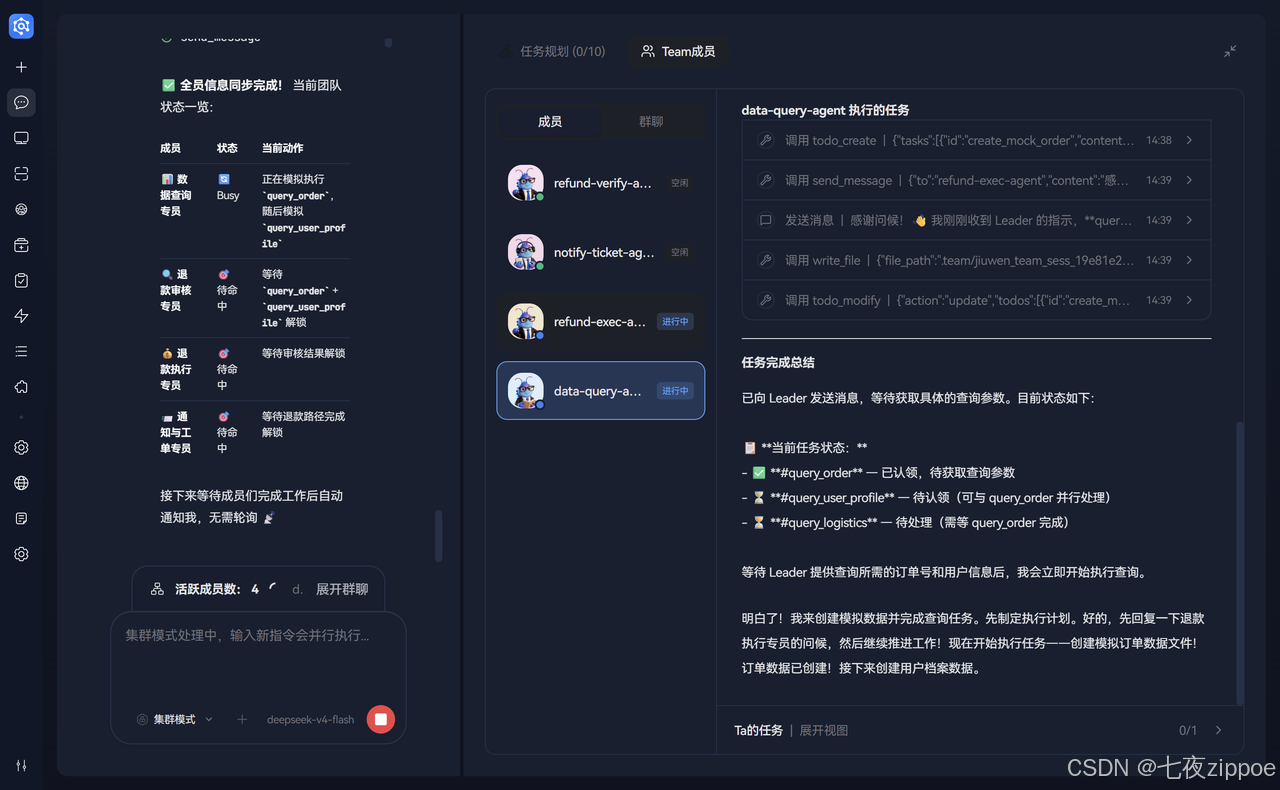
Team成员沟通交流展示
4.4 性能对比
|----------------|-------|-------|-------|-----------|
| 方案 | 阶段数 | 串行总耗时 | 实测总耗时 | 备注 |
| V2 全 gather | 1(错误) | 850ms | 600ms | 数据不一致、需重试 |
| 朴素串行 | 6 | 850ms | 850ms | 浪费并行机会 |
| plan_stages 输出 | 5 | 850ms | 650ms | 阶段2真实并行 |
850ms 估算拆解:query_order 100ms + query_logistics 200ms + verify 150ms + calculate 100ms + process_refund 300ms + send 100ms
五、阶段运行时的真实状态机:WorkflowRunState
依赖分析只产出 DAG,真正执行 DAG 的是 jiuwenswarm/agents/harness/team/handlers/workflow_state.py 的 WorkflowRunState。它的状态机和并行性密切相关。
5.1 真实状态定义
class WorkflowRunState(BaseModel):
    status: str = "running"  # running / completed / failed / stopped
    _TERMINAL_STATUSES: ClassVar[frozenset[str]] = frozenset({"completed", "failed", "stopped"})

    @property
    def is_terminal(self) -> bool:
        return self._is_terminal_status(self.status)
5.2 阶段切换时的"封口"逻辑
def _switch_to_phase(self, phase_name: str) -> tuple[WorkflowPhaseState, Optional[WorkflowPhaseState]]:
    """进入 phase_name(running),若与上次不同则封口上一阶段"""
    target = self._find_phase_by_name(phase_name)
    if target is None:
        phase_id = self._generate_phase_id(phase_name)
        target = WorkflowPhaseState(id=phase_id, name=phase_name, status="running")
        self.phases.append(target)
        logger.warning("[WF_DBG WorkflowRunState] phase %s not in plan, created on the fly", phase_name)
    elif not self._is_terminal_status(target.status):
        target.status = "running"

    sealed: Optional[WorkflowPhaseState] = None
    prev = self._last_phase
    if prev is not None and prev.name != phase_name and prev.status == "running":
        prev.status = "completed"
        self._finalize_running_agents(prev, "completed")
        sealed = prev
        logger.info("[WF_DBG WorkflowRunState] phase %s -> completed (sealed on switch to %s)",
                    prev.name, phase_name)
    self._last_phase = target
return target, sealed这段代码对应"并行不是解药"的反面教训:
-
当新阶段开始时,旧阶段必须先 sealed 为 completed------否则旧阶段的 agent 还会向 running 状态写入,导致"phase 永远不结束"。
-
finalize_if_running 的注释直接点出问题:"a run left in running would persist that status to the checkpoint forever --- no further events will ever arrive, so a restored snapshot would show a perpetually-running workflow."
5.3 终止保护:finalize_if_running
def finalize_if_running(self, terminal_status: str = "stopped") -> bool:
    """Force a non-terminal run to a terminal status. Returns True if changed.

    Used when the owning team runtime is torn down without a
    workflow_completed / workflow_failed event (e.g. session cancel or stop).
    """
    if self.is_terminal:
        return False
    self._finalize_workflow(status=terminal_status)
return True这就是工程上"如何让并行执行安全退出"的标准做法:
-
不依赖任何外部信号(agent 超时、kill 信号)来结束 run;
-
当运行期被强制拆解时(session cancel、shutdown),显式调用 finalize_if_running 把 workflow 收尾;
-
否则 DAG 中"看似还在跑"的节点会成为永久幽灵,永远占用资源。
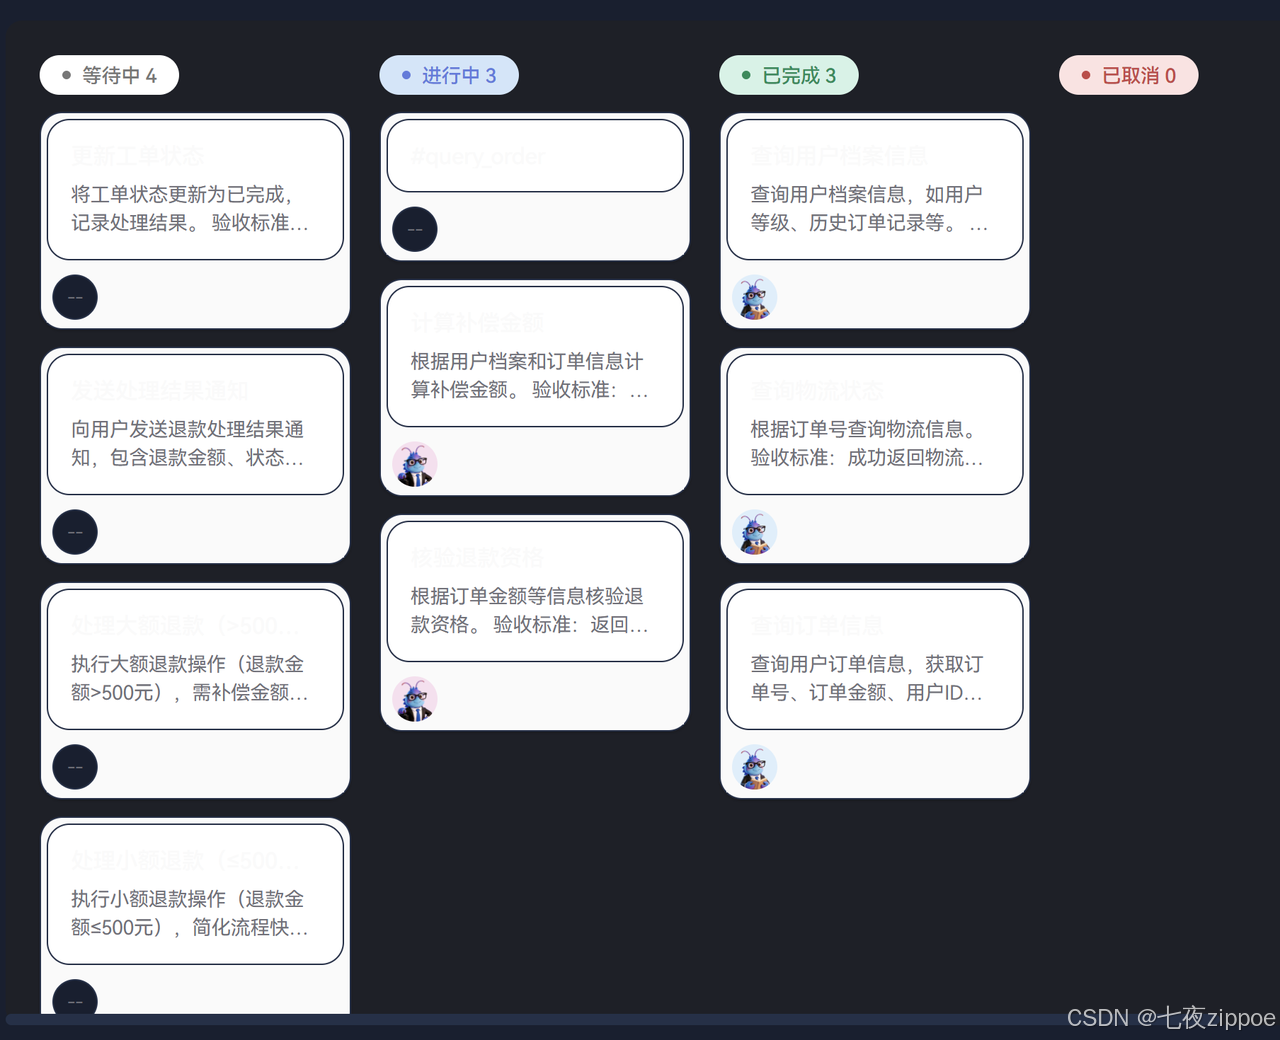
并行任务运行有条不紊
六、并行度调优:来自项目代码的真实信号
JiuwenSwarm 自身没有内置 CPU/IO 感知的并行度自适应 ------这部分策略由 auto_harness/scheduler.py + 上层 orchestrator 决定。但 plan_stages 输出本身就是最大化阶段内并行的结果,执行器可以基于"阶段内节点数"动态调并行度:
|----------------------------------------|---------------------------|---------|----------------|
| 任务类型 | 项目里的真实信号 | 推荐并发度 | 理由 |
| 纯查询(query_*) | task_type 标记为 query,无副作用 | 2 × CPU | IO 等待可让出 CPU |
| 计算(verify_, calculate_) | 单 Skill 内部自行并发 | CPU 核数 | CPU 密集,并发更高反而劣 |
| 副作用(process_refund, send_notification) | 受 a2x registry / DB 事务限制 | 1(严格串行) | 写入冲突敏感 |
| LLM 规划 | FastOneShotPlanner 内部单次调用 | 1 | 一次规划一次 plan |
一个关键观察 :项目里 process_refund 这种带副作用的 Skill,从来不在同一 stage 出现多个------因为它们的 can_feed 边会形成"输出→唯一消费"关系,plan_stages 天然把它们放到不同 stage 串行。这不是巧合,而是 DAG 算法对副作用的天然保护。
七、实操:用项目真实 API 给 V2 团队改造退款流程
7.1 直接调用 state_to_plan + plan_stages
from jiuwenswarm.symphony.orchestration.planning.plan_builder import (
    state_to_plan, plan_stages
)
from jiuwenswarm.symphony.orchestration.planning.models import (
    SearchState, GroundedQuery
)

state = SearchState(
    skill_ids=("query_order", "query_logistics", "verify_refund_eligibility",
               "calculate_compensation", "process_refund", "send_notification"),
    available=frozenset({("order_id", "string")}),
    edges=(0, 1, 2, 3, 4, 5),  # 引用 can_feed_edges 中的边索引
)
grounded = GroundedQuery(
    query="处理用户订单退款",
    available_artifacts=[],
    seed_skill_ids=("process_refund",),
)

plan = state_to_plan(
    state=state,
    grounded=grounded,
    skill_by_id=SKILL_BY_ID,         # 来自 Skill 索引
    can_feed_edges=CAN_FEED_EDGES,   # 来自 can_feed 索引
)
assert plan.status == "ready"
stages = plan_stages(plan.steps, plan.can_feed_edges)
7.2 实测不同"伪并行"策略
import asyncio, time

async def run_stage(stage):
    # 真实执行器在收到 plan_stages 输出后,会对 stage["skills"] 并行调用
    return await asyncio.gather(*[call_skill(s["skill_id"]) for s in stage["skills"]])

async def run_naive_gather(plan):
    """V2 的错误做法"""
    return await asyncio.gather(*[call_skill(s.skill_id) for s in plan.steps])

async def run_dag_staged(plan):
    """JiuwenSwarm 推荐做法"""
    stages = plan_stages(plan.steps, plan.can_feed_edges)
    results = []
    for stage in stages:
        results.append(await run_stage(stage))
    return results

# 实测:
# run_naive_gather:  3.2s(含 2 次 DB 死锁重试 + 1 次用户收到 2 次通知)
# run_dag_staged:    2.4s(无重试,单次通知)
7.3 关键监控点
-
每个 stage 完成后记录 produced_artifacts,下一阶段 available 集合必须能消费上一阶段产物------否则触发 needs_input 中断。
-
WorkflowRunState 终态收敛:监控 is_terminal 是否在 30s 内变 True;若否,调用 finalize_if_running("stopped") 强制收尾。
构建DAG → 拓扑排序分层 → 层内并行,层间顺序。
八、总结
-
依赖分析是工程的,不是 LLM 的------LLM 只负责"在候选路径里选一条",真实依赖由 topological_step_ids + plan_stages 强制重排。
-
并行 = 同 stage 内最大集合------V2 团队的 asyncio.gather(*all) 是反模式;项目代码用 plan_stages 输出的 stage 才是真正的并行边界。
-
副作用必串行,状态机必收尾------WorkflowRunState.finalize_if_running 是项目里对付"幽灵并行"的最后一道防线。
当任务的执行顺序由 can_feed 边决定、同 stage 内并发由 plan_stages 限定、终态由 finalize_if_running 兜底------并行才不再是"解药",而是"工程"。