目录
[二、Swarm Skill 的核心设计------为什么是文件夹而不是 YAML](#二、Swarm Skill 的核心设计——为什么是文件夹而不是 YAML)
[2.1 Swarm Skill 的本质:不是"函数",是"团队"](#2.1 Swarm Skill 的本质:不是"函数",是"团队")
[2.2 为什么是文件夹而不是单个 YAML](#2.2 为什么是文件夹而不是单个 YAML)
[2.3 源码解析:Skill Manager 的初始化与加载机制](#2.3 源码解析:Skill Manager 的初始化与加载机制)
[2.4 源码解析:技能继承的三级机制](#2.4 源码解析:技能继承的三级机制)
[2.5 和传统"模板"的本质区别](#2.5 和传统"模板"的本质区别)
[3.1 传统动态编排的局限](#3.1 传统动态编排的局限)
[3.2 SwarmFlow 的源码实现](#3.2 SwarmFlow 的源码实现)
[3.3 SwarmFlow 的三种生成方式](#3.3 SwarmFlow 的三种生成方式)
[3.4 workflow.md 中异常处理的关键设计](#3.4 workflow.md 中异常处理的关键设计)
[4.1 两层自演进的定位](#4.1 两层自演进的定位)
[4.2 演进补丁架构------源码级解析](#4.2 演进补丁架构——源码级解析)
[4.3 经验评分机制------源码级解析](#4.3 经验评分机制——源码级解析)
[4.4 自演进的实战案例------旅行规划](#4.4 自演进的实战案例——旅行规划)
[4.5 演进补丁和原始 Skill 的隔离机制](#4.5 演进补丁和原始 Skill 的隔离机制)
[五、实操:从零构建订单客服 Skill](#五、实操:从零构建订单客服 Skill)
[5.1 要不要封装成 Swarm Skill?](#5.1 要不要封装成 Swarm Skill?)
[5.2 Step 1:安装 swarmskill-creator 技能](#5.2 Step 1:安装 swarmskill-creator 技能)
[5.3 Step 2:用自然语言生成 Skill](#5.3 Step 2:用自然语言生成 Skill)
[5.4 Step 3:微调------补充能力边界和异常处理](#5.4 Step 3:微调——补充能力边界和异常处理)
[5.5效果对比:Before vs After](#5.5效果对比:Before vs After)
[六、Swarm Skills Hub------技能的共享市场](#六、Swarm Skills Hub——技能的共享市场)
[6.1 Skills Hub 是什么](#6.1 Skills Hub 是什么)
[6.2 核心价值](#6.2 核心价值)
[6.3 使用 Skills Hub 的典型流程](#6.3 使用 Skills Hub 的典型流程)
[七、决策框架------什么情况该用、不该用 Swarm Skill](#七、决策框架——什么情况该用、不该用 Swarm Skill)
[7.1 要不要封装成 Swarm Skill?](#7.1 要不要封装成 Swarm Skill?)
[7.2 手写还是用 swarmskill-creator?](#7.2 手写还是用 swarmskill-creator?)
[7.3 Expert 包挂载几个合适?](#7.3 Expert 包挂载几个合适?)
[7.4 什么情况不要用 Swarm Skill?](#7.4 什么情况不要用 Swarm Skill?)
[坑 1:SKILL.md 只写 name 不写成员](#坑 1:SKILL.md 只写 name 不写成员)
[坑 2:能力边界只写"负责什么"不写"不能做什么"](#坑 2:能力边界只写"负责什么"不写"不能做什么")
[坑 3:workflow.md 不写异常处理](#坑 3:workflow.md 不写异常处理)
[坑 4:一次挂载过多 Expert 包](#坑 4:一次挂载过多 Expert 包)
[坑 5:经验库不过期检查](#坑 5:经验库不过期检查)
[坑 6:社区 Skill 直接用不验证](#坑 6:社区 Skill 直接用不验证)
一、"查询订单"能力的复制噩梦------一个真实复用事故
V2 团队的"查询订单"能力运行得很好------客户报一个订单号,Agent 秒级返回物流状态,用户满意度从 4.2 涨到 4.5。于是市场部的同事跑来说:"我们团队也需要这个能力,能移植一下吗?"
然后你打开代码库,发现"查询订单"的实现散落在三个地方:一个 Python 函数处理 API 调用,一段 Prompt 模板定义回复格式,还有一条写在工作空间 README 里的注意事项------"物流 API 偶尔超时,记得加 3 秒兜底"。没有标准接口,没有输入输出定义,甚至连调用方式都得问原作者。
你花了一整天把代码复制过去,改了接口名、调了参数格式、重写了 Prompt。第二天市场部的同事说"改了之后查不了了"------你改了 A 忘了改 B,两个团队的代码已经分叉了。更糟的是,一周后你修了原版的一个 Bug,但市场部那边的副本还是旧的,直到用户投诉才发现。
这不是个例。随着团队规模扩大、业务场景增多,能力复用的三个结构性缺陷会越来越严重:
能力碎片化:同样的逻辑,不同团队各写一套,Bug 修了这边漏了那边。V2 到 V3 的过程中,"查询订单"的逻辑在三个团队里各有一份副本,修一个 Bug 要改三个地方,漏掉一个就是线上事故。
经验难沉淀:最佳实践只在人脑里,人员流动就等于知识流失。那个写了"物流 API 加 3 秒兜底"的同事离职后,没人知道这个注意事项的存在------直到 API 真的超时了,新来的同事对着报错排查了半天。
版本不可控:改了一处接口,依赖它的三个团队两个报错、一个静默失败。你把"查询订单"的返回格式从 JSON 改成 Markdown,结果一个团队的消息解析直接崩了,另一个团队的 Agent 把 Markdown 标记当成用户消息发出去了,第三个团队压根没用到新字段所以没报错------但你不知道它还在用旧格式。
Swarm Skills Hub 就是为解决这个痛点而生。它不是又一套模板系统,而是一个让团队协作经验可以被封装、流通、复用并持续进化的技能生态。一个 Swarm Skill 不是一个"函数"或"API",而是一个团队技能包------包含团队叫什么、成员有谁、怎么配合、出了问题怎么办的完整文件夹。
二、Swarm Skill 的核心设计------为什么是文件夹而不是 YAML
2.1 Swarm Skill 的本质:不是"函数",是"团队"
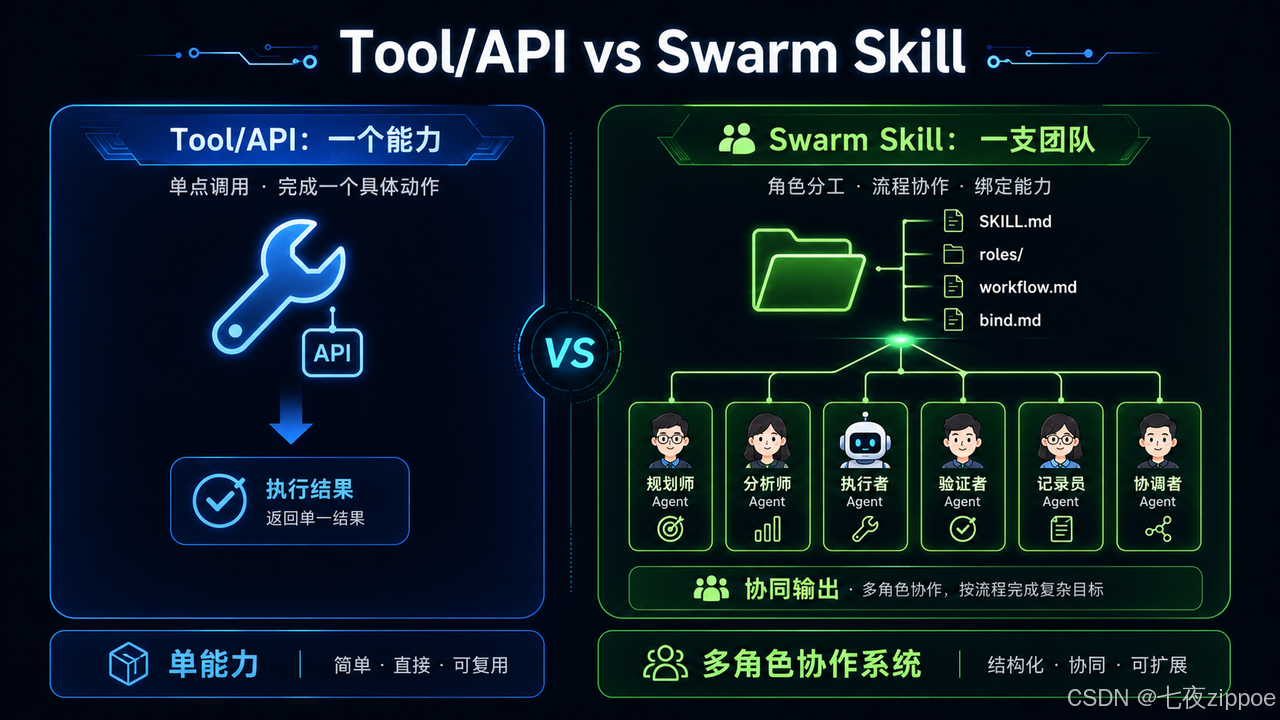
核心区别在于:工具函数解决的是"一个能力怎么调用",Swarm Skill 解决的是"一支团队怎么协作"。
一个 Swarm Skill 封装的不是单个能力,而是一套完整的团队协作方案------这个团队叫什么、干什么、成员有谁、每个成员负责什么、大家怎么配合、出了问题怎么处理、需要哪些外部工具。
打个比方:如果工具函数是"一把螺丝刀",Swarm Skill 就是"一本装修手册"------不仅告诉你用什么工具,还告诉你谁负责水电、谁负责木工、先做什么后做什么、出了问题找谁。
2.2 为什么是文件夹而不是单个 YAML
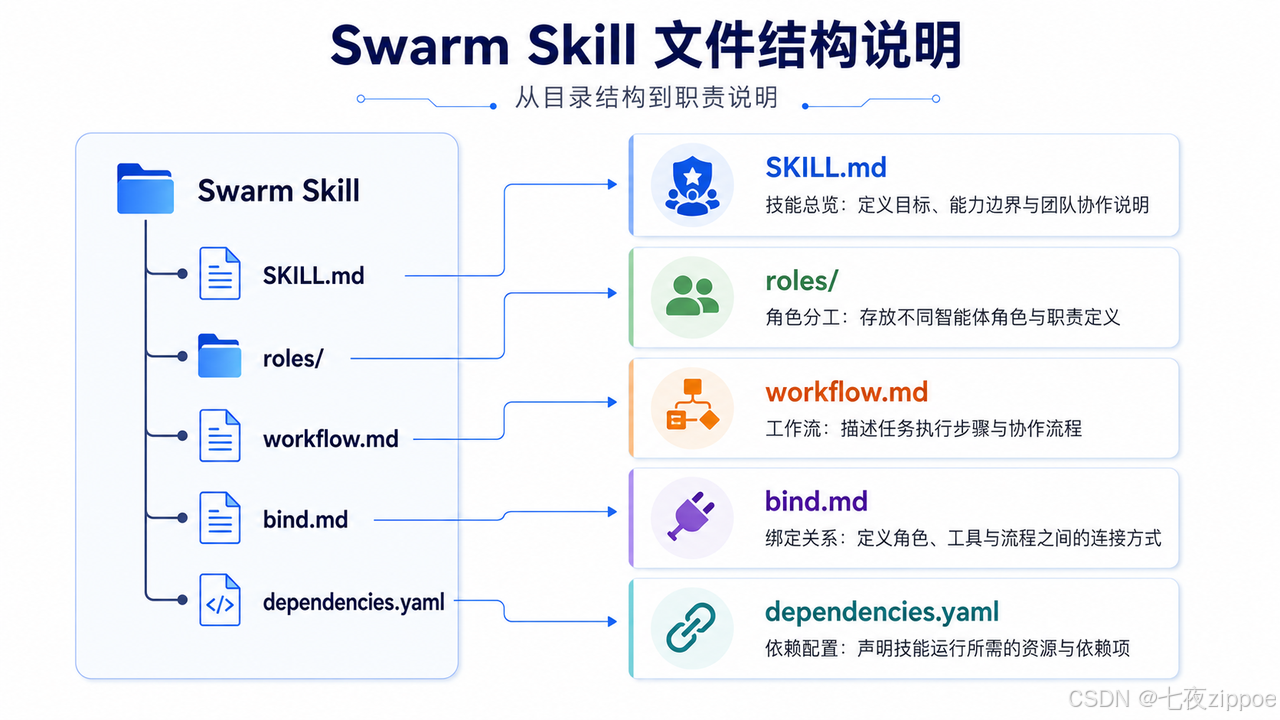
Swarm Skill 的核心载体是一个文件夹目录结构:
your-skill-team/
├── SKILL.md           # 团队名称、目标、适用场景、成员有谁
├── roles/             # 每个成员角色各自负责什么
│   ├── query-agent.md     # 查询专员角色定义
│   └── notify-agent.md    # 通知专员角色定义
├── workflow.md        # 大家怎么配合、执行顺序是什么
├── bind.md            # 绑定配置(频道/工具等)
├── dependencies.yaml  # 依赖说明
└── ...                # 可自由扩展
为什么不用一个 YAML 文件搞定? 这不是随意的选择,而是基于实际踩坑后的设计决策。
原因一:可读性。 SKILL.md 是给人读的 Markdown,不是给机器解析的 YAML。新同事打开文件夹,看一眼 SKILL.md 就知道这支团队干什么、谁负责什么------不需要读 YAML 字段、不需要理解 schema。我们早期试过用单个 YAML 描述整个团队,结果是非技术人员根本不想看,技能审查变成了开发者的专属工作。
原因二:可扩展性。 每个角色一个独立文件(roles/query-agent.md),可以单独修改、单独替换、单独复用。如果所有角色挤在一个 YAML 里,改一个角色可能误改另一个。这个设计是从血泪教训里来的------早期所有角色定义写在一个配置块里,有一次改查询专员的超时时间,不小心把售后专员的 API 地址也改了,因为两个配置项挨着。
原因三:可复用性。 文件夹结构天然支持"拿半个走"。你需要复用查询专员的角色定义但不需要售后专员?直接复制 roles/query-agent.md 就行。如果是一个 YAML,你得手动把不需要的部分删掉,还容易删多。
2.3 源码解析:Skill Manager 的初始化与加载机制
说了半天设计理念,现在深入源码,看 JiuwenSwarm 框架到底是怎么加载和管理 Swarm Skill 的。
Skill Manager 的初始化过程
当 JiuwenSwarm 启动时,Skill Manager 会扫描配置的技能目录,解析每个文件夹中的 SKILL.md,注册到技能注册表:
# Skill Manager 初始化的核心逻辑(简化)
class SkillManager:
    def __init__(self, skill_dirs: list[str]):
        self.skill_registry: dict[str, SkillMeta] = {}
        for skill_dir in skill_dirs:
            self._scan_skill_directory(skill_dir)

    def _scan_skill_directory(self, skill_dir: str):
        """扫描目录,发现所有合法的 Swarm Skill"""
        for entry in os.scandir(skill_dir):
            if not entry.is_dir():
                continue
            skill_md_path = os.path.join(entry.path, "SKILL.md")
            if not os.path.exists(skill_md_path):
                continue  # 没有 SKILL.md 的目录被跳过

            meta = self._parse_skill_md(skill_md_path)
            # 解析 SKILL.md 提取:团队名称、目标、适用场景、成员列表
            # 解析 roles/ 目录提取每个角色的定义
            # 解析 workflow.md 提取协作流程
            # 解析 dependencies.yaml 提取依赖信息

            skill_id = f"{meta.team_name}@{meta.version}"
            self.skill_registry[skill_id] = meta
设计决策1:为什么用目录扫描而不是配置文件注册? 如果用配置文件注册(比如在 team.yaml 里列出所有 Skill 路径),新增 Skill 需要改配置文件,容易遗忘。目录扫描的好处是"放进去就生效"------你把 Skill 文件夹丢到技能目录下,下次启动自动发现并注册,不需要改任何配置。
设计决策2:为什么没有 SKILL.md 的目录被静默跳过? 技能目录可能包含临时文件、半成品、测试目录。如果没有 SKILL.md 就跳过,相当于用 SKILL.md 作为"这个文件夹是一个合法 Skill"的标记。这比强制命名约定(比如必须叫 skill.yaml)更灵活------你可以放任何辅助文件在目录里,只要 SKILL.md 存在就是合法 Skill。
2.4 源码解析:技能继承的三级机制
Swarm Skill 的能力继承不是简单的"复制一份",而是三级继承机制。理解这个机制,才能理解为什么 Swarm Skill 比"模板复制"更安全。
# 技能继承的核心逻辑(简化)
class TeamManager:
    def build_agent_customizer(self, team_config) -> AgentCustomizer:
        """构建 Agent 定制器,处理三级技能继承"""

        # 第一级:全局技能 → 团队共享
        global_skills = self.skill_manager.get_global_skills()
        # 全局技能目录中的所有 Skill,所有团队默认可见

        # 第二级:团队共享 → 团队成员共享
        team_shared_skills = self._load_team_skills(team_config.skill_refs)
        # team_config.skill_refs 指定了团队引用哪些 Skill
        # 只有在 skill_refs 列表中的 Skill 才会被加载到团队

        # 第三级:团队成员 → 按需复制到个人
        for member in team_config.members:
            member_skills = self.copy_member_configured_skills(
                member.skill_whitelist,
                team_shared_skills
            )
            # 只复制白名单中的技能到成员个人目录
            # 不在白名单中的技能,成员连 SKILL.md 都看不到

        return AgentCustomizer(
            global=global_skills,
            team=team_shared_skills,
            member=member_skills
        )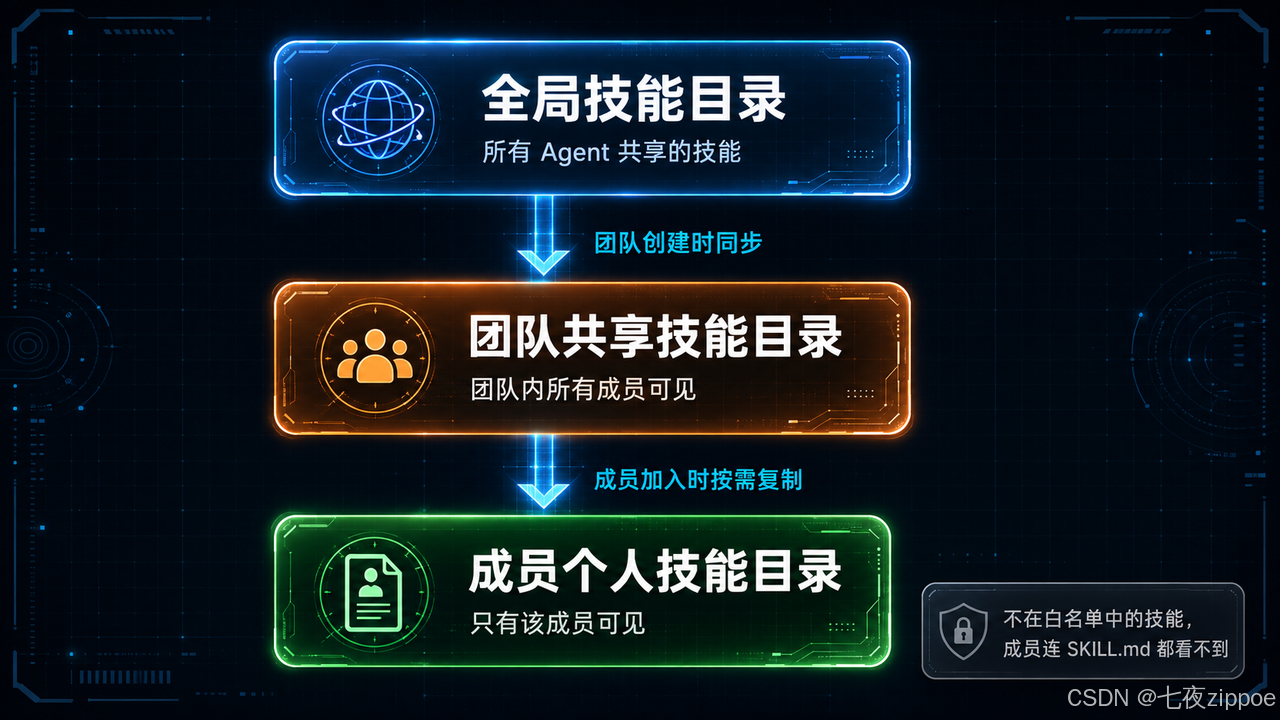
设计决策1:为什么用三级继承而不是直接复制? 如果直接把 Skill 复制到每个成员,修改一个 Skill 需要同步到所有成员的副本------回到了"版本不可控"的老问题。三级继承保证:全局技能更新后,所有团队自动同步;团队技能更新后,所有成员自动同步。只有个人定制部分是独立的。
设计决策2:为什么用白名单而不是"全部继承"? 一个团队可能有 10 个 Skill,但查询专员只需要 2 个(订单查询 + 物流追踪)。如果全部继承,查询专员的 Prompt 里会包含 10 个 Skill 的描述------Prompt 膨胀导致推理质量下降。白名单机制确保每个成员只看到自己需要的技能,Prompt 精简,推理更准确。
踩坑经验 :早期没有白名单机制,所有成员继承所有技能。结果售后专员的 Prompt 里有"订单查询"技能的描述,它在处理退款请求时偶尔会顺手查一下订单------不是用户要求的,而是 LLM 看到这个技能后"主动帮忙"。加了白名单后,售后专员的 Prompt 里没有"订单查询"的描述,这种越界行为消失了。和白名单去掉一个技能,比在 Prompt 里写"不要做 XX"有效十倍。
2.5 和传统"模板"的本质区别
|------|--------------|----------------------------------|
| 维度 | 模板 | Swarm Skill |
| 复用方式 | 复制一份,改完跟原件无关 | 安装即用,保持与上游的版本关系 |
| 协作定义 | 固定配置,无法表达流程 | workflow.md 定义协作流程,SwarmFlow 可执行 |
| 角色定义 | 硬编码在配置里 | roles/ 独立定义,可替换可扩展 |
| 进化能力 | 无 | 自演进机制,根据执行轨迹自动优化 |
| 社区流通 | 无 | Skills Hub 市场,一键安装/发布 |
三、SwarmFlow------从动态编排到可执行脚本
3.1 传统动态编排的局限
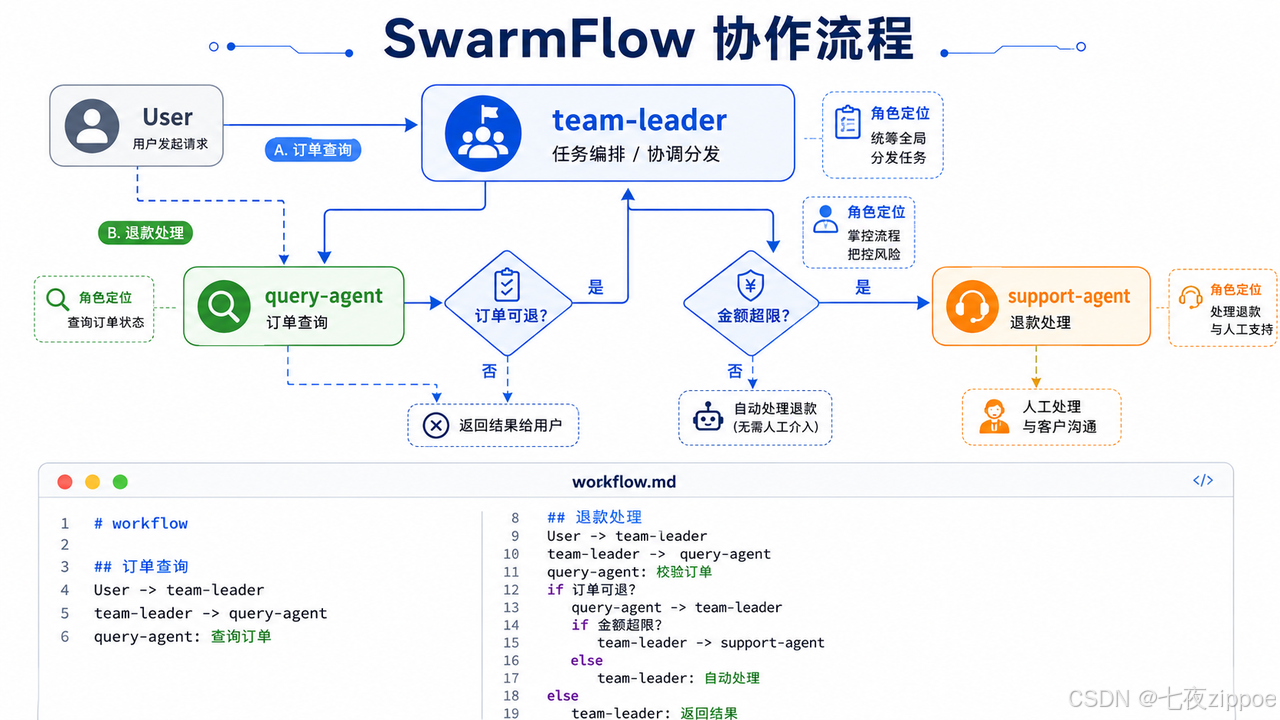
在 SwarmFlow 出现之前,JiuwenSwarm 的任务编排是动态的------Leader Agent 根据当前上下文和任务描述,实时决定怎么分配任务、按什么顺序执行。
这种模式灵活,但有两个结构性问题:
问题一:不可复现。 同一个任务,不同时间执行可能走完全不同的路径。有一次 Leader 把退款任务先交给查询员确认订单状态,再交给售后专员处理退款;另一次 Leader 直接交给售后专员,跳过了订单状态确认。两次执行路径不同,结果也可能不同------这给调试和审计带来了巨大困难。
问题二:不可控。 Leader 的编排逻辑受 LLM 推理影响,有时候会做出不合理的分配。比如查询员正在处理一个复杂查询,Leader 又把一个新查询任务塞给它------因为它"看起来适合做查询",但实际上查询员已经过载了。
3.2 SwarmFlow 的源码实现
SwarmFlow 是 JiuwenSwarm v0.2.2 引入的关键特性------将协作流程固化为可执行的工作流脚本,Leader 按脚本执行而非动态编排。
# SwarmFlow 执行引擎的核心逻辑(简化)
class SwarmFlowExecutor:
    def __init__(self, workflow_md_path: str):
        # 解析 workflow.md,构建任务图
        self.task_graph = self._parse_workflow(workflow_md_path)
        # 每个"场景"被解析为一个有向无环图(DAG)
        # 节点 = 任务步骤,边 = 依赖关系

    async def execute(self, scenario: str, context: dict) -> FlowResult:
        """按任务图执行指定场景"""
        dag = self.task_graph.get(scenario)
        if not dag:
            raise ScenarioNotFound(f"Scenario '{scenario}' not in workflow.md")

        # 拓扑排序:按依赖关系确定执行顺序
        execution_order = dag.topological_sort()

        results = {}
        for node in execution_order:
            # 检查前置依赖是否全部完成
            if not self._check_dependencies(node, results):
                raise DependencyNotMet(
                    f"Node '{node.id}' depends on incomplete nodes"
                )

            # 分配任务给对应角色
            agent = self._get_agent_for_role(node.role)
            result = await agent.execute(node.task, context)

            # 异常处理
            if result.is_error():
                handler = node.error_handler
                if handler:
                    result = await self._handle_error(handler, result, context)
                else:
                    raise FlowExecutionError(
                        f"Node '{node.id}' failed with no error handler"
                    )

            results[node.id] = result

        return FlowResult(scenario=scenario, results=results)
设计决策1:为什么用 DAG(有向无环图)而不是简单的线性列表? 线性列表只能表达"A 做完 B 做"的顺序关系,但实际协作中经常有并行------"查询员查订单状态"和"通知员查物流进度"可以同时进行,互不依赖。DAG 能表达并行关系,拓扑排序后同一层级的节点可以并行执行。
设计决策2:为什么异常处理绑定在节点上而不是全局处理? 不同的步骤可能需要不同的异常处理策略。查询超时应该"返回降级提示",退款金额超限应该"通知 Leader 审批",API 不可用应该"告知用户稍后再试"。如果用全局异常处理,要么过度泛化(一个策略套所有场景),要么变成巨大的 if-else 分支。绑定在节点上,每个步骤自己定义自己的异常处理,职责清晰。
3.3 SwarmFlow 的三种生成方式
JiuwenSwarm v0.2.2 提供三种生成 SwarmFlow 的方式:
|-------------------------|----------------|----------------|------------------|
| 方式 | 适用场景 | 优势 | 局限 |
| 手动编写 workflow.md | 非标准场景、复杂异常处理 | 完全可控,能表达精细逻辑 | 编写门槛高,耗时长 |
| swarmskill-creator 自动生成 | 标准场景(客服、调研、报告) | 自然语言描述即可生成,速度快 | 生成的异常处理较粗,需要手动微调 |
| 流程图生成 | 已有 SOP 流程图的场景 | 可视化输入,直观 | 流程图质量直接影响生成质量 |
实际项目中,推荐"swarmskill-creator 生成 → 手动微调"的流程------先用自然语言快速生成骨架,再根据业务细节调整角色边界和异常处理。
3.4 workflow.md 中异常处理的关键设计
很多人写 workflow.md 只写正常流程,不写异常处理。这是最大的坑------生产环境中,异常才是常态。
为什么异常处理必须写? 因为 LLM 不会自己发明降级策略。如果 workflow.md 没写"查询超时返回降级提示",query-agent 超时后会怎么做?大概率是重试、报错、或者卡死------都不是你想要的行为。
异常处理是 workflow.md 中"指导性最强"的部分------它直接告诉 Agent "遇到这个情况,做这个动作",不需要 Agent 自己推理。这不只是"写好一点"的问题,而是"有和没有"的质变。
四、自演进机制------双层源码级深入
自演进是 Swarm Skill 区别于传统模板的最大特性。原文只讲了概念,这里深入到源码级实现。
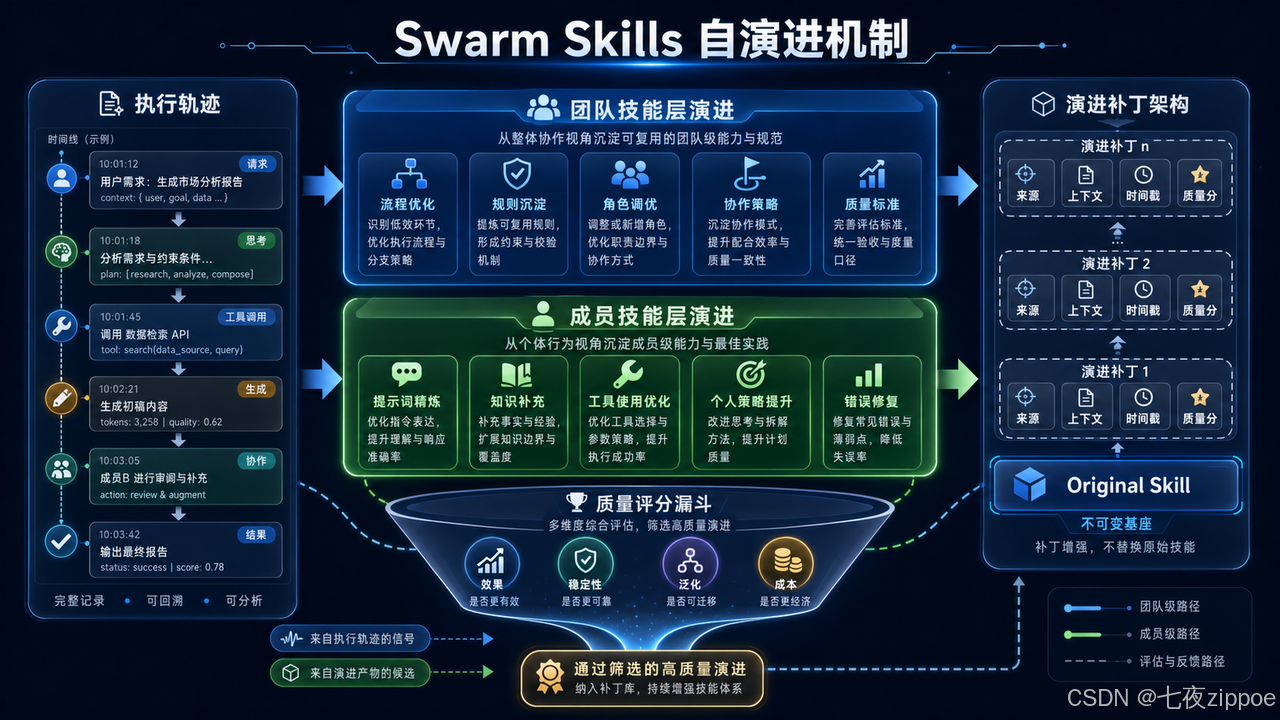
4.1 两层自演进的定位
|-------|--------------------------------------|----------------------|-----------|
| 层级 | 演进内容 | 触发条件 | 影响范围 |
| 团队技能层 | 增加成员角色、补充协作约束、优化任务流转、调整 Leader 的规划分工 | 任务执行轨迹中发现角色冲突或流程瓶颈 | 整个团队的协作方式 |
| 成员技能层 | 工具报错经验沉淀、接口超时降级策略、参数缺失默认值、依赖配置失败备选方案 | 工具调用失败、超时、参数缺失等运行时异常 | 单个成员的技能表现 |
为什么要分两层? 因为团队层和成员层的问题性质不同。团队层是"协作流程不合理"------比如查询员和售后员抢同一个任务,需要调整协作约束。成员层是"单个技能执行出错"------比如物流 API 超时,需要沉淀降级策略。把两层混在一起,会导致团队层被大量成员层的琐碎经验淹没,看不到结构性的协作问题。
4.2 演进补丁架构------源码级解析
这是自演进最关键的设计:演进内容以独立经验条目附加到 Skills 上,不修改原始文件。
# 演进补丁的数据结构(简化)
class EvolutionPatch:
    patch_id: str                    # 补丁唯一标识
    skill_name: str                  # 所属 Skill
    layer: str                       # "team" 或 "member"
    trigger_source: str              # 触发来源(哪次执行、什么异常)
    context: dict                    # 触发时的上下文
    # 例: {"scenario": "order_query", "error": "api_timeout", "duration": 8.5}
    timestamp: datetime              # 时间戳
    quality_score: float             # 质量评分(0-1)
    content: dict                    # 演进内容
    # 团队层:新增角色、修改协作约束等
    # 成员层:降级策略、默认值、备选方案等
    applicable_arch_version: str     # 适用的架构版本
    success_count: int               # 成功应用次数
    apply_count: int                 # 总应用次数
设计决策1:为什么演进内容不和原始 Skill 合并? 两个原因:
可回滚:如果演进补丁导致问题,直接删除补丁即可,不需要回滚整个 Skill。我们踩过坑------一次团队层演进把"查询员"和"售后员"的协作约束调整了,结果导致查询员在退款场景中完全沉默。如果演进直接改了原始 Skill,回滚需要找到原始版本、重新安装、重新配置。用补丁架构,删掉那个补丁就恢复了。
版本兼容:Skill 来自社区时,本体升级后依然能沿用沉淀的经验。如果经验直接改了原始文件,上游更新时会产生合并冲突------就像 Git merge conflict 一样,手动解决非常痛苦。补丁架构让原始 Skill 保持纯净,补丁独立存在,上游更新后补丁自动附加到新版本上。
设计决策2:为什么保留 applicable_arch_version? 这是踩坑踩出来的设计。早期没有版本检查,Auto Harness 检索到 3 个月前的一次上下文压缩优化经验,直接复用了当时的方案。但架构已经从 v0.1.8 迭代到 v0.2.1,那个方案在新版本上反而引入了 bug------旧的截断策略和新的分层压缩逻辑冲突。所以现在经验库会标注适用的架构版本,过时经验自动跳过。
4.3 经验评分机制------源码级解析
经验不是越多越好,低质量经验会误导后续优化。JiuwenSwarm 从三个维度给经验评分:
# 经验评分的核心逻辑(简化)
def score_experience(patch: EvolutionPatch, usage_stats: dict) -> float:
    """三维度加权评分,决定补丁的注入优先级"""

    # 维度一:有效性------这条经验实际解决了问题吗?
    effectiveness = patch.success_count / max(patch.apply_count, 1)
    # 例:一条降级策略被应用了 10 次,成功 8 次 → effectiveness = 0.8

    # 维度二:使用率------这条经验被使用了多少次?
    usage_rate = min(usage_stats.get(patch.patch_id, 0) / 10, 1.0)
    # 归一化到 0-1,10 次以上为满分
    # 低使用率的经验可能只适用于边缘场景

    # 维度三:新鲜度------这条经验还适用于当前版本吗?
    freshness = 1.0 if not patch.is_outdated(current_arch_version) else 0.0
    # 过时经验直接 0 分,不注入

    # 加权综合评分
    score = 0.5 * effectiveness + 0.3 * usage_rate + 0.2 * freshness

    if score < 0.3:
        logger.info(
            "Patch %s score %.2f below threshold, auto-deprioritized",
            patch.patch_id, score
        )

    return score
设计决策1:为什么有效性权重最高(0.5)? 因为一条"经常用但效果差"的经验比"偶尔用但效果好"的经验更危险。高使用率 + 低有效性 = 每次都在用错误的策略。所以有效性必须是最重要的维度。
设计决策2:为什么新鲜度权重最低(0.2)? 因为版本检查已经在检索阶段做了------过时的经验根本不会被检索到,到不了评分阶段。新鲜度评分是"二道保险",处理的是"版本匹配但逻辑上已不适用"的边缘情况。大部分情况下这个维度都是 1.0,只有在极少数边缘情况下才会扣分。
设计决策3:为什么低于 0.3 分不删除而是降权? 因为"低分"不等于"错误"------可能只是适用场景少。删除会丢失信息,降权让它"安静存在但不主动干扰"。如果未来遇到匹配的场景,它的使用率上升,评分会自动恢复。
4.4 自演进的实战案例------旅行规划
以 Skills Hub 上"旅行规划"团队技能为例,展示实际的演进过程:
初始状态:旅行规划 Skill 包含三个角色------行程规划师、费用审核员、内容创作者。workflow.md 定义了"调研目的地→规划行程→计算费用→生成文案"的协作流程。
第一次运行:出现角色定位不清------"费用审核"与"朋友圈文案生成"被分配给同一角色(内容创作者)。用户反馈"文案里夹着费用数据,很奇怪"。
演进引擎分析执行轨迹,识别到角色冲突:内容创作者同时处理了"文案生成"和"费用审核"两个不相关的任务。系统建议拆分------将费用审核独立为新角色"费用审核员"。
用户同意后,团队层演进补丁被创建:
# 演进补丁示例(第一次运行)
patch_001 = EvolutionPatch(
    patch_id="team-evolve-001",
    skill_name="travel-planning",
    layer="team",
    trigger_source="run-001-role-conflict",
    context={"conflict": "content_creator handling cost_review", "severity": "medium"},
    content={
        "action": "add_role",
        "new_role": "cost-reviewer",
        "reassign_tasks": ["cost_review", "budget_validation"],
        "from_role": "content-creator"
    },
    applicable_arch_version=">=0.2.0",
    success_count=1,
    apply_count=1,
    quality_score=0.85  # 有效性 0.85 + 使用率 0.1 + 新鲜度 1.0 → 0.5*0.85+0.3*0.1+0.2*1.0 = 0.755
)第二次运行:演进引擎识别到用户有"适配多平台"的诉求------原始文案只生成了一个版本,但用户在对话中提到了"小红书""朋友圈""公众号"三个平台。
团队层演进补丁被创建,新增"多平台文案适配"角色:
# 演进补丁示例(第二次运行)
patch_002 = EvolutionPatch(
    patch_id="team-evolve-002",
    skill_name="travel-planning",
    layer="team",
    trigger_source="run-002-multi-platform",
    context={"platforms": ["xiaohongshu", "moments", "wechat_official"]},
    content={
        "action": "add_role",
        "new_role": "platform-adapter",
        "capabilities": ["multi_platform_formatting", "title_optimization"],
        "workflow_update": "content-creator generates draft → platform-adapter adapts"
    },
    applicable_arch_version=">=0.2.0",
    success_count=1,
    apply_count=1,
    quality_score=0.72
)第三次运行:效果进一步提升。内容创作者先生成统一草稿,平台适配器根据三个平台的特点分别调整标题、排版和标签。用户满意度从第一次的 3.2 提升到 4.6。
这就是"越用越强"------Swarm Skill 不是一个静态技能包,而是一个会在实战中自我优化的"活的"团队。
4.5 演进补丁和原始 Skill 的隔离机制
最后讲一个容易被忽略但很关键的设计------演进补丁和原始 Skill 的物理隔离。
演进补丁存储在哪里? 不在 Skill 文件夹里。Skill 文件夹(SKILL.md、roles/、workflow.md 等)保持原始状态,演进补丁存储在独立的经验库中:
# 经验库的存储结构(简化)
class ExperienceStore:
    def __init__(self, store_path: str):
        self.store_path = store_path  # 独立于 Skill 目录
        self.patches: dict[str, list[EvolutionPatch]] = {}

    def add_patch(self, patch: EvolutionPatch):
        skill_patches = self.patches.setdefault(patch.skill_name, [])
        skill_patches.append(patch)

    def retrieve(self, skill_name: str, gap_report: dict = None) -> list[EvolutionPatch]:
        patches = self.patches.get(skill_name, [])
        # 版本检查:跳过过时经验
        relevant = [
            p for p in patches
            if not p.is_outdated(current_arch_version)
        ]
        # 评分排序:高分优先
        relevant.sort(key=lambda p: p.quality_score, reverse=True)
        return relevant
为什么物理隔离? 三个原因:
-
社区 Skill 的纯净性:从 Skills Hub 下载的 Skill 保持原始状态,你的演进经验不会被上传回去(除非你主动贡献)。下载的 Skill 本体升级后,你的演进补丁自动附加到新版本上
-
多团队复用:A 团队和 B 团队都用了"旅行规划"Skill,但各自的演进经验不同。物理隔离让同一个 Skill 在不同团队中保持不同的演进路径,互不干扰
-
调试便利:当 Skill 出问题时,可以先禁用所有演进补丁,回到原始状态排查。如果问题消失,说明是演进补丁引入的;如果问题还在,说明是原始 Skill 的问题
五、实操:从零构建订单客服 Skill
5.1 要不要封装成 Swarm Skill?
在动手之前,先做一个决策------不是所有能力都需要封装成 Swarm Skill。
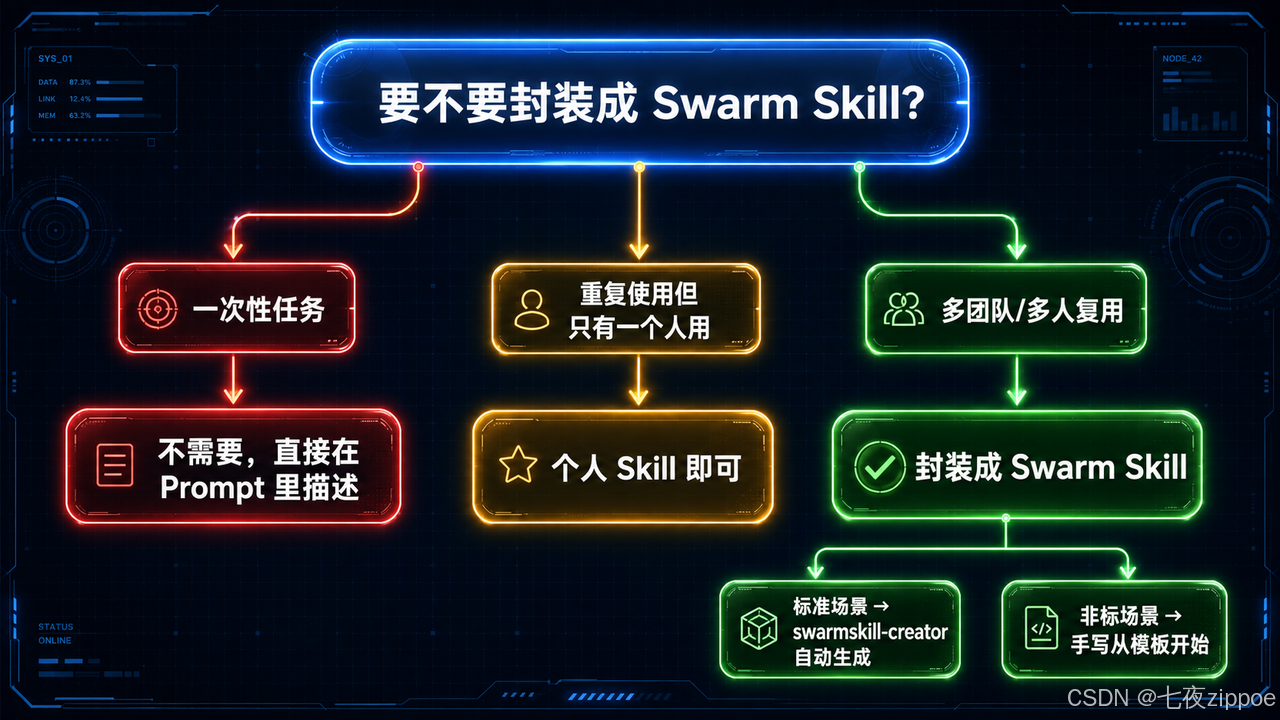
|----------------------|------|-------------------------|
| 场景 | 是否封装 | 原因 |
| 用户问"帮我查订单" | ❌ | 单次请求,Prompt 就够了 |
| 每天自动生成日报 | ❌ | 重复使用但只有一个人用,个人 Skill 即可 |
| 查询订单能力给 5 个团队复用 | ✅ | 多团队复用,需要标准化封装和版本管理 |
| 客服团队技能发布到 Skills Hub | ✅ | 社区流通,需要标准格式 |
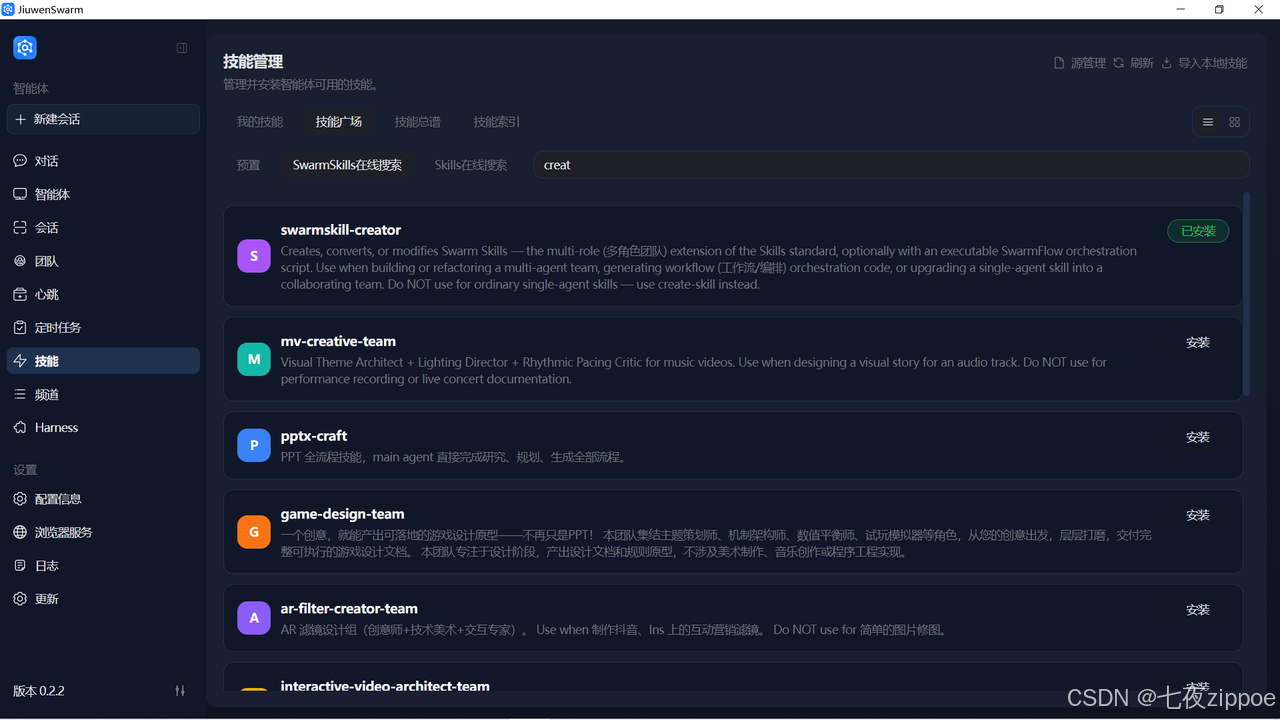
5.2 Step 1:安装 swarmskill-creator 技能
在技能模块中的技能广场搜索 swarmskill-creator,点击安装。
5.3 Step 2:用自然语言生成 Skill
/sswarmskill-creator 创建一个智能客服团队技能,包含查询专员和售后专员,支持订单查询、物流追踪和退款处理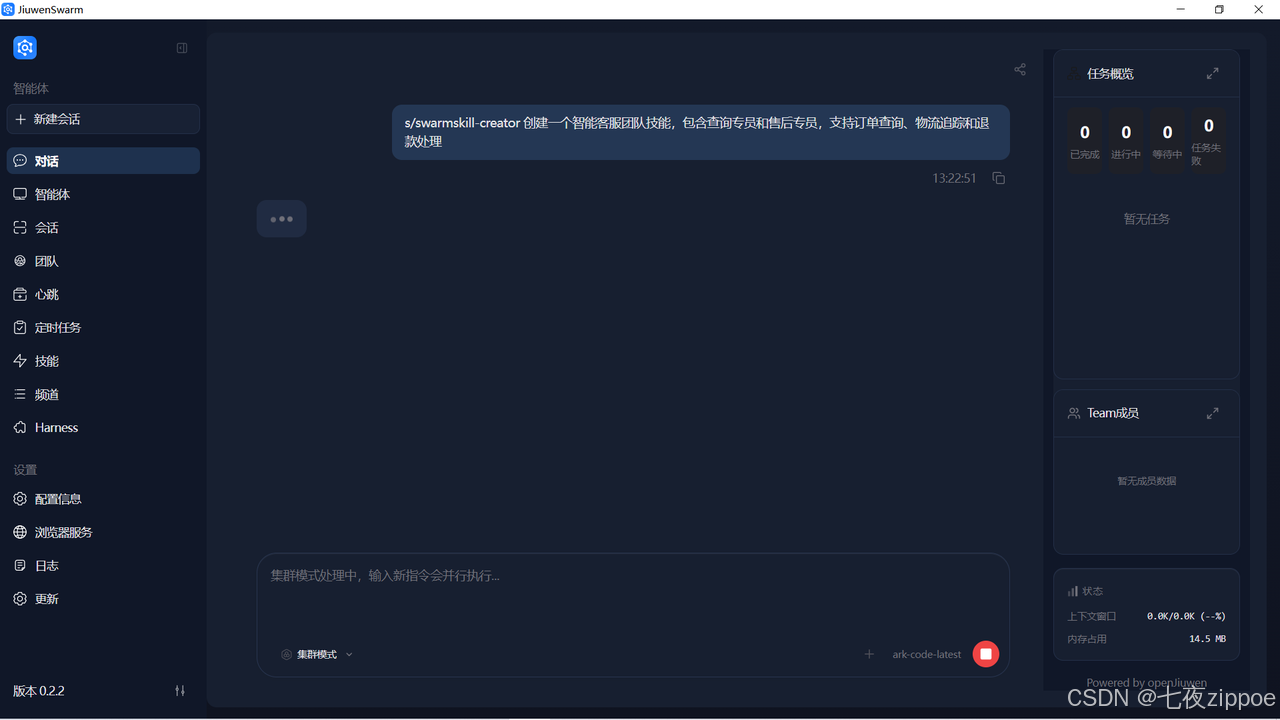
开始创建
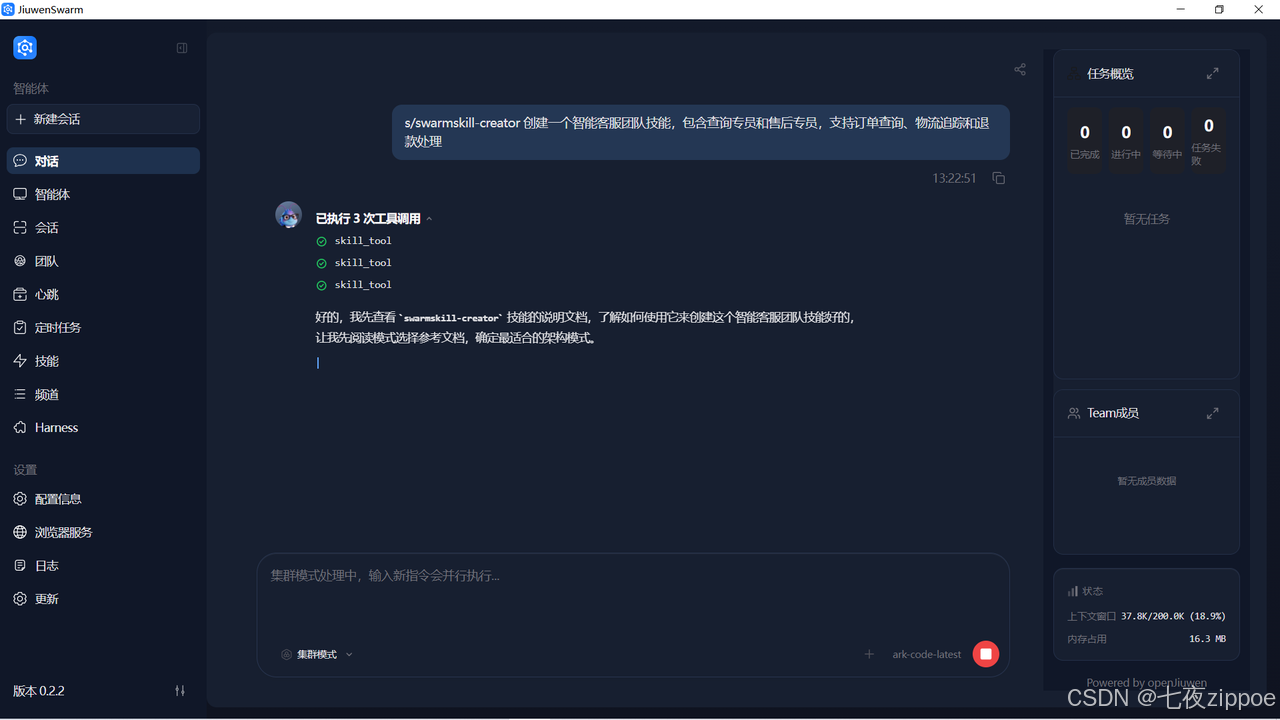
选择模式
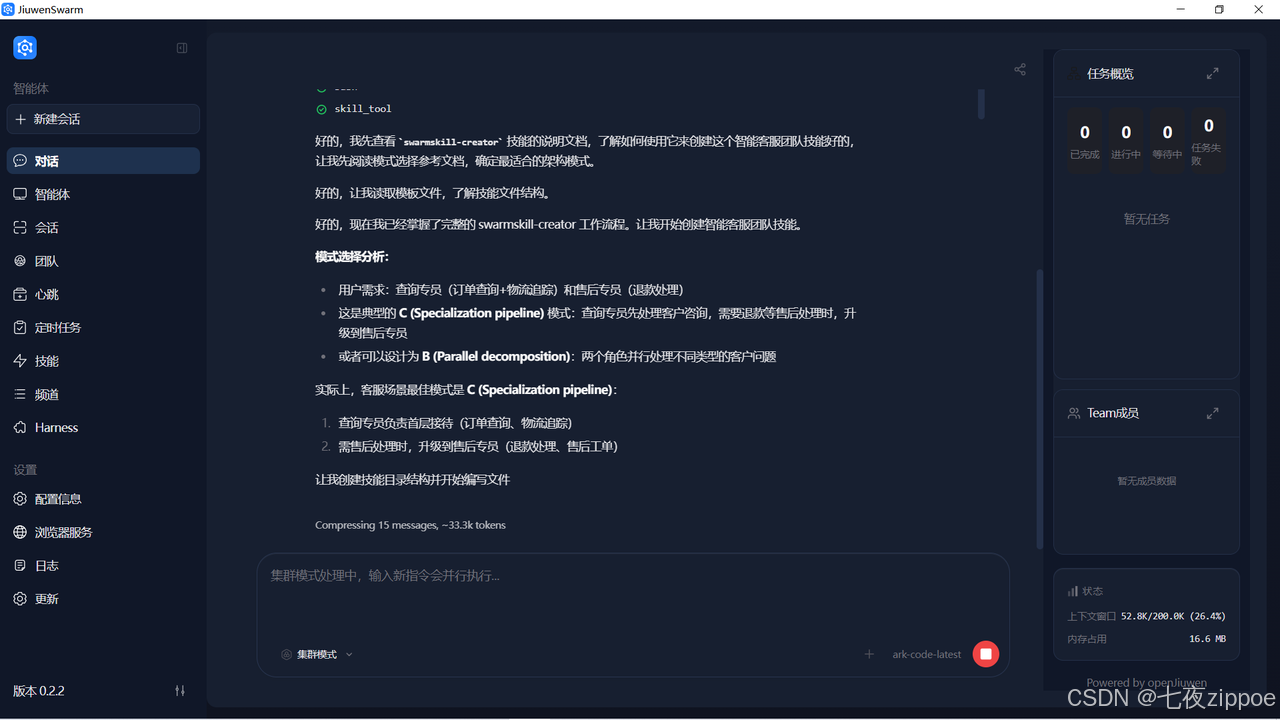
开始创建Skills相关文件
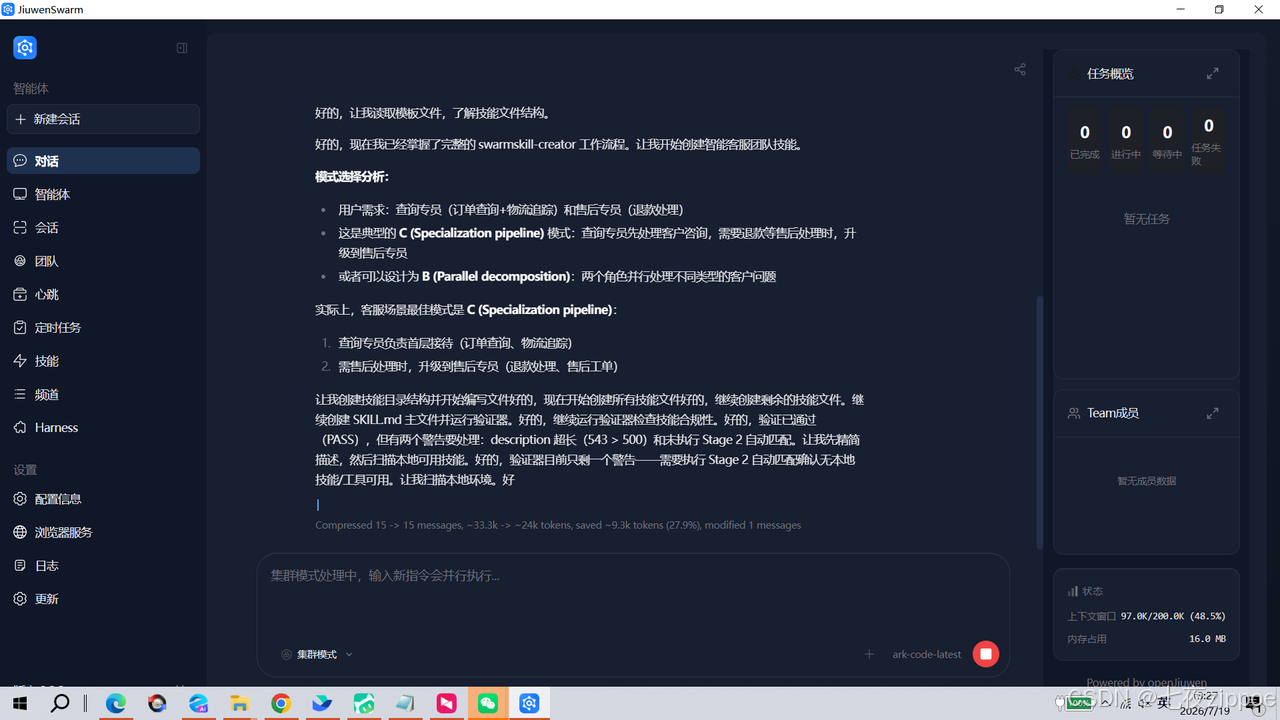
创建完成
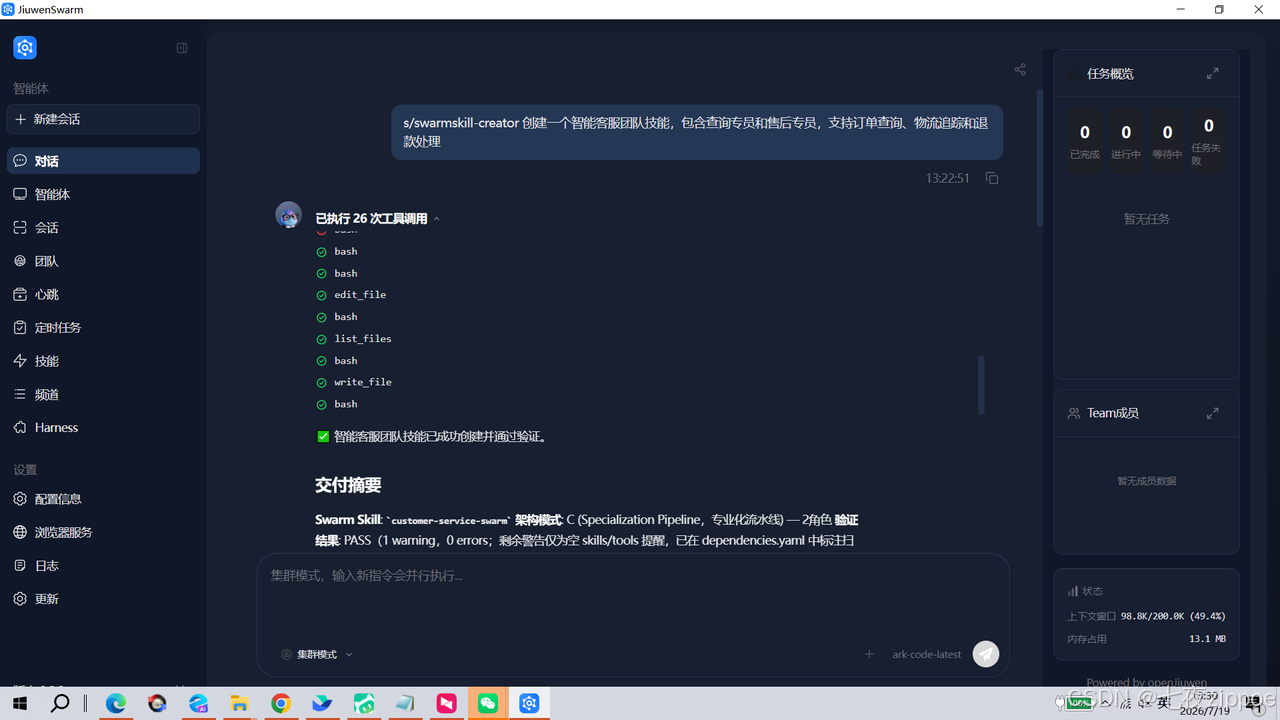
最终交付的Skills相关内容,如下图: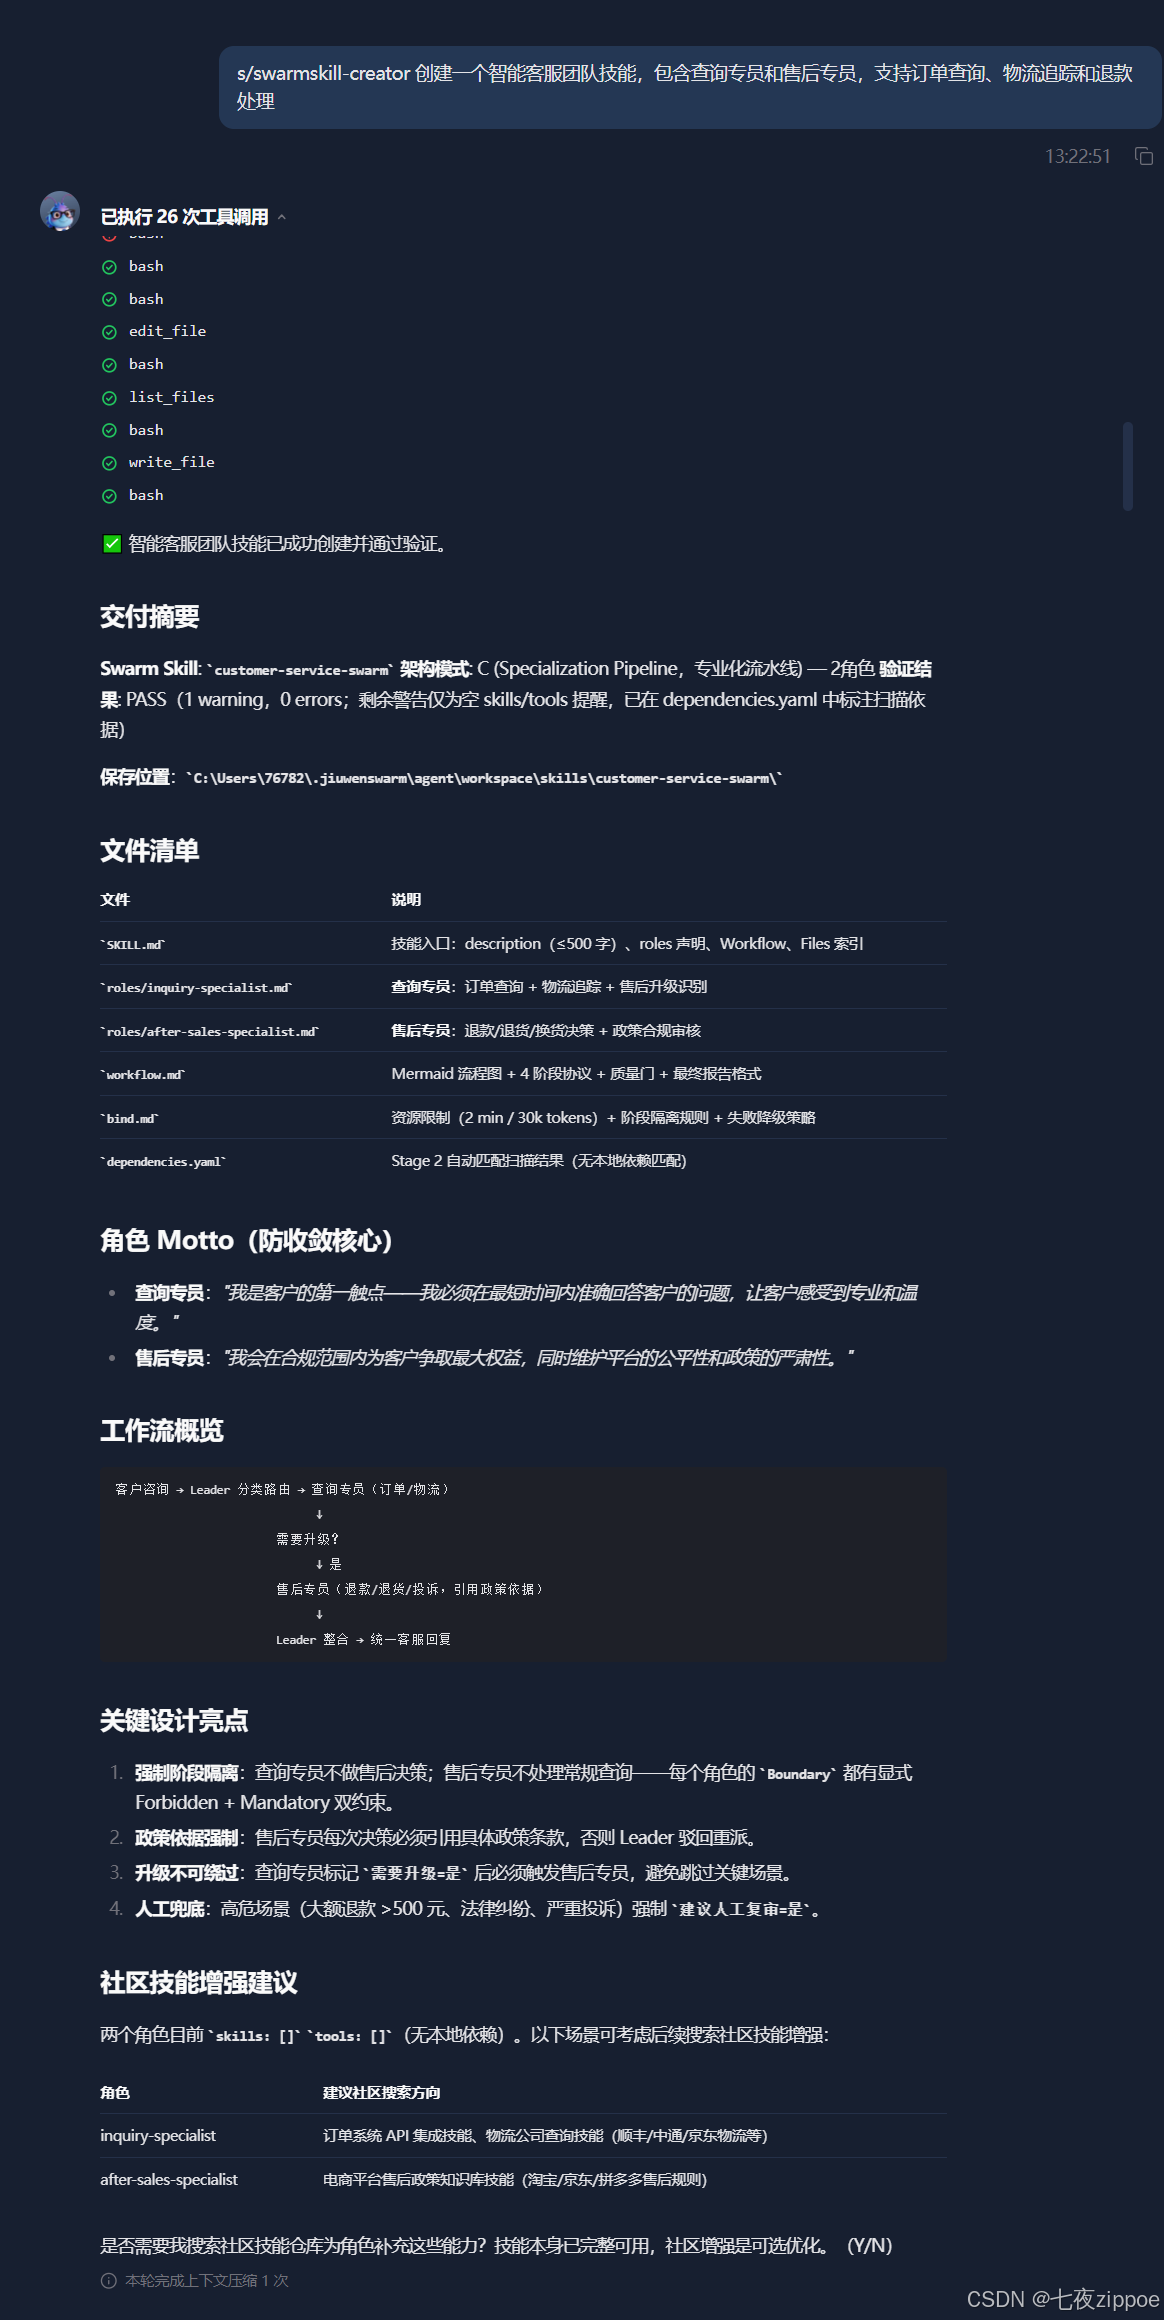
5.4 Step 3:微调------补充能力边界和异常处理
swarmskill-creator 生成的是骨架,需要根据业务细节微调。最重要的两处:
微调1:roles/ 中补充能力边界
生成器的默认角色定义可能只有"职责",没有"不能做什么"。参考第02篇的经验,能力边界是角色定义中最重要的一环------它告诉 Agent "你不能做什么",相当于 Rails(安全护栏)的角色级定义。
为什么不自动生成能力边界? 因为能力边界和业务强相关------什么操作允许、什么操作禁止,只有你自己的业务才知道。生成器只能基于常见模式推断,无法覆盖所有业务规则。
微调2:workflow.md 中补充异常处理
生成器的默认 workflow 只写正常流程。补充异常处理------查询超时返回降级提示、退款金额超限通知 Leader 审批、API 不可用告知用户稍后再试。
5.5效果对比:Before vs After
|-------|-------------------|-----------------------|
| 维度 | 无 Swarm Skill(V2) | 有 Swarm Skill(V3) |
| 能力复用 | 复制代码,改了没人知道 | 安装 Skill,版本关系保持同步 |
| 角色定义 | 硬编码在 Agent 配置中 | roles/ 独立定义,可替换可扩展 |
| 协作流程 | Leader 动态编排,不可复现 | SwarmFlow 固化为脚本,可控可复现 |
| 异常处理 | 靠 LLM 实时推理,不可预期 | workflow.md 固化,行为确定 |
| 经验沉淀 | 在人脑里,人员流动就丢失 | 演进补丁自动入库,版本可控 |
| 社区流通 | 无 | Skills Hub 市场一键安装/发布 |
| 跨团队复用 | 手动复制+改接口,极易出错 | 安装+微调角色名称和工具依赖 |
六、Swarm Skills Hub------技能的共享市场
6.1 Skills Hub 是什么
Swarm Skills Hub 是 openJiuwen 生态中的社区技能市场,地址:swarmskills.openjiuwen.com。
6.2 核心价值
|----------|---------------------|
| 价值 | 说明 |
| 加速落地 | 新用户直接安装社区已有 Skill |
| 经验流通 | 最佳实践成为整个生态的共享资产 |
| 二次创作 | 下载的 Skill 可根据需求修改扩展 |
| 持续进化 | 社区贡献的演进经验回流 |
6.3 使用 Skills Hub 的典型流程
1. 发现:在 swarmskills.openjiuwen.com 浏览或搜索
2. 安装:将 Skill 安装到 JiuwenSwarm 环境
3. 配置:根据 dependencies.yaml 配置外部依赖
4. 运行:启动团队,Skill 中的角色和协作流程自动生效
5. 演进:自演进机制持续优化 Skill
6. 贡献:将优化后的 Skill 发布回 Skills Hub
一个容易被忽略的步骤 :安装社区 Skill 后,先跑一遍测试用例再用于生产环境。社区 Skill 的配置可能和你的本地环境不兼容------比如它依赖的 API 版本和你安装的版本不同,或者它的角色定义和你的业务规则有冲突。跑一遍测试用例,确认没有问题再上线。
七、决策框架------什么情况该用、不该用 Swarm Skill
7.1 要不要封装成 Swarm Skill?
|----------------------------|------|----------------------|
| 场景 | 是否封装 | 原因 |
| 一次性任务("帮我查一下这个订单") | ❌ | 单次请求,Prompt 就够了 |
| 重复使用但只有一个人用(每天生成日报) | ❌ | 个人 Skill 即可,不需要团队技能包 |
| 多团队/多人复用(查询订单给 5 个团队) | ✅ | 需要标准化封装和版本管理 |
| 社区流通(客服团队技能发布到 Skills Hub) | ✅ | 需要标准格式和社区复用 |
| 频繁变更的不稳定流程 | ❌ | 流程还没稳定就封装,演进补丁会堆积混乱 |
7.2 手写还是用 swarmskill-creator?
|----------------|-------------------------|-------------|
| 场景 | 推荐方式 | 原因 |
| 标准场景(客服、调研、报告) | swarmskill-creator 自动生成 | 速度快,骨架可用 |
| 非标场景(特殊业务流程) | 手写,从模板开始 | 生成器无法覆盖特殊逻辑 |
| 复杂异常处理 | 生成后手动微调 | 生成器的异常处理较粗 |
7.3 Expert 包挂载几个合适?
一次挂载不超过 5 个。每个扩展包都会增加 Prompt 长度和工具数量,过多导致 Agent 在选择工具时犹豫不决------有 6 个搜索相关工具时,它经常选错。
7.4 什么情况不要用 Swarm Skill?
-
单步骤任务:不需要团队协作,一个 Agent 就能搞定
-
个人临时使用:不需要复用,用完就丢
-
频繁变更的不稳定流程:流程还没稳定,封装了也是白封,演进补丁会堆积混乱
-
对响应时间极其敏感的场景:Skill 加载和角色初始化有开销,毫秒级响应场景不适合
八、避坑指南------六个高风险配置误区
以下六类问题在配置 Swarm Skill 时最容易出问题,建议逐一自查。
坑 1:SKILL.md 只写 name 不写成员
风险场景:如果 SKILL.md 只写团队名称和目标、漏掉成员列表,成员 Agent 就失去了角色边界的第一道约束。比如查询员收到退款请求时,由于 LLM 的帮助性倾向,很可能"顺手"就调用退款 API------没有任何配置告诉它"这不是你的活"。
规避建议:SKILL.md 的成员列表是角色边界的第一道防线。没有成员列表,Agent 不知道自己的角色定位,LLM 的帮助性倾向会让它"什么都做"。
坑 2:能力边界只写"负责什么"不写"不能做什么"
风险场景:如果 query-agent.md 的能力边界只写"负责查询订单状态和物流信息",而不写"不能处理退款请求",查询员在用户要求退款时很容易越界处理------尤其当它从主 Agent 继承了退款工具时,没有任何反向约束能拦住它。
规避建议:反向约束比正向描述更有效。"不能处理退款请求(转交 support-agent)"比"负责订单查询"更能防止越界。LLM 的帮助性倾向让它倾向于"多做",只有明确的"不能做"才能拦住它。
坑 3:workflow.md 不写异常处理
风险场景:如果 workflow.md 只写正常流程(查询员查订单→返回结果→Leader 回复用户),不写查询超时怎么办,那么一旦物流 API 超时,查询员的行为就完全不可预期------可能反复重试后报错,整个流程卡死;用户在长时间等待后收到一条 "API request timeout" 的技术报错,完全无法理解。
规避建议:异常处理是 workflow.md 中"指导性最强"的部分。没有异常处理,Agent 在遇到异常时的行为完全不可预期------它会按照 LLM 的推理"自由发挥"。异常处理 = 把"遇到这个情况做这个动作"提前固化,不依赖 LLM 的实时推理。
坑 4:一次挂载过多 Expert 包
风险场景:如果给一个 Agent 同时挂载较多数量的 Expert Package(例如覆盖搜索、文档处理、代码生成、数据分析、邮件处理、日程管理的 6 个包),工具数量和 Prompt 长度会显著膨胀(达到数千 token 量级)。工具选择空间过大时,Agent 选错工具的概率上升,推理质量也随之下降。
规避建议:挂载数量建议控制在少数几个(如 5 个以内)。每个扩展包都会增加 Prompt 长度和工具数量,过多容易导致选择困难和推理质量下降。
坑 5:经验库不过期检查
风险场景:如果关闭 is_outdated 检查,让 Auto Harness 直接复用较早期(如 3 个月前)的优化经验,旧方案可能与新架构冲突------例如旧的截断策略与新的分层压缩逻辑不兼容,可能导致部分对话的上下文丢失。过时的经验比没有经验更危险:它看起来"有道理",实际却可能误导后续优化。
规避建议:经验库的版本检查不能关。建议每月回顾一次经验库,清理过时记录。
坑 6:社区 Skill 直接用不验证
风险场景:如果从 Skills Hub 下载一个"客服团队"Skill 后直接上线,可能运行后才发现 Skill 依赖的 API 版本和本地环境不兼容------比如社区 Skill 基于 v2 API 编写,本地安装的是 v3 API,接口格式对不上。用户查询订单返回空结果,往往要排查很久才能定位到是版本问题。
规避建议:安装社区 Skill 后,先跑一遍测试用例再用于生产环境。检查 dependencies.yaml 中的依赖版本,确认和本地环境兼容。
九、写在最后
回到开头那个"查询订单"的复制噩梦------如果当时有 Swarm Skills Hub,故事完全不同:
-
不需要复制代码 --- 把"查询订单"封装成 Skill,市场部安装即可
-
不需要改接口 --- Skill 的版本关系保持同步,上游更新自动通知
-
不需要怕人员流动 --- 最佳实践封装在 Skill 里,不是在人脑里
-
不需要担心质量退化 --- 自演进机制让 Skill 越用越强
-
不需要担心改出新问题 --- 演进补丁独立存储,可随时回滚
Swarm Skills Hub 的核心不是"模板市场",而是"团队协作经验的标准化封装与流通"。一个 Swarm Skill 不是一个函数签名,而是一个文件夹目录------包含团队叫什么(SKILL.md)、每个角色负责什么(roles/)、怎么配合(workflow.md)、绑定什么工具(bind.md)。
更关键的是自演进机制------团队层演进补充角色和协作约束,成员层演进沉淀工具报错和降级策略,演进补丁架构保证优化不破坏原始结构。三层技能继承保证全局技能更新自动同步,白名单机制确保每个成员只看到自己需要的技能。经验评分机制从有效性、使用率、新鲜度三维度给经验打分,高分优先注入、低分自动降权。
技能不是模板,它是你的团队可沉淀、可复用、可进化的数字资产。
参考资料