上一篇文章我们聊了如何用极小的内存判断手机号是否存在。
但数据最终要落库,落库就绕不开一个最基础的问题:主键用什么?
单机时代,
AUTO_INCREMENT就够了。但一旦进入分库分表、微服务集群,自增主键立刻失效------每个库都从 1 开始,主键必然冲突。本文沿着「单机 → 分布式」的主线,把主键选择这件事讲透。能 ASCII 画清楚的就不上 Mermaid,只有流程图和时序关系才用 Mermaid。
全文主线
text
主键决定物理存储顺序
    │
    ▼
自增 ID ──▶ 单机最优,分布式冲突
    │
    ▼
UUID ──▶ 全局唯一,但随机插入性能差
    │
    ▼
雪花算法 ──▶ 趋势递增 + 结构唯一
    │
    ▼
工业级方案 ──▶ Leaf、UidGenerator 解决雪花算法硬伤
    │
    ▼
选型对比与实战建议
一、先搞懂原理:InnoDB 的聚集索引
1.1 聚集索引:主键即数据
InnoDB 是索引组织表 。B+ 树叶子节点直接存储完整行数据:
text
                     ┌──────────────────────┐
                     │   非叶子节点(只存 key)  │
                     │      [30, 60]         │
                     └──────────┬───────────┘
                ┌───────────────┼───────────────┐
                ▼               ▼               ▼
        ┌─────────────┐  ┌─────────────┐  ┌─────────────┐
        │  [10, 20]   │  │  [40, 50]   │  │  [70, 80]   │
        │ ─────────── │  │ ─────────── │  │ ─────────── │
        │ 完整行数据   │  │ 完整行数据   │  │ 完整行数据   │
        └─────────────┘  └─────────────┘  └─────────────┘
             叶子节点:key + 完整行数据
核心结论:主键的顺序 = 数据在磁盘上的物理顺序。
1.2 二级索引:叶子节点存主键
二级索引的叶子节点不存完整行数据,只存主键值。查数据时需要回表:
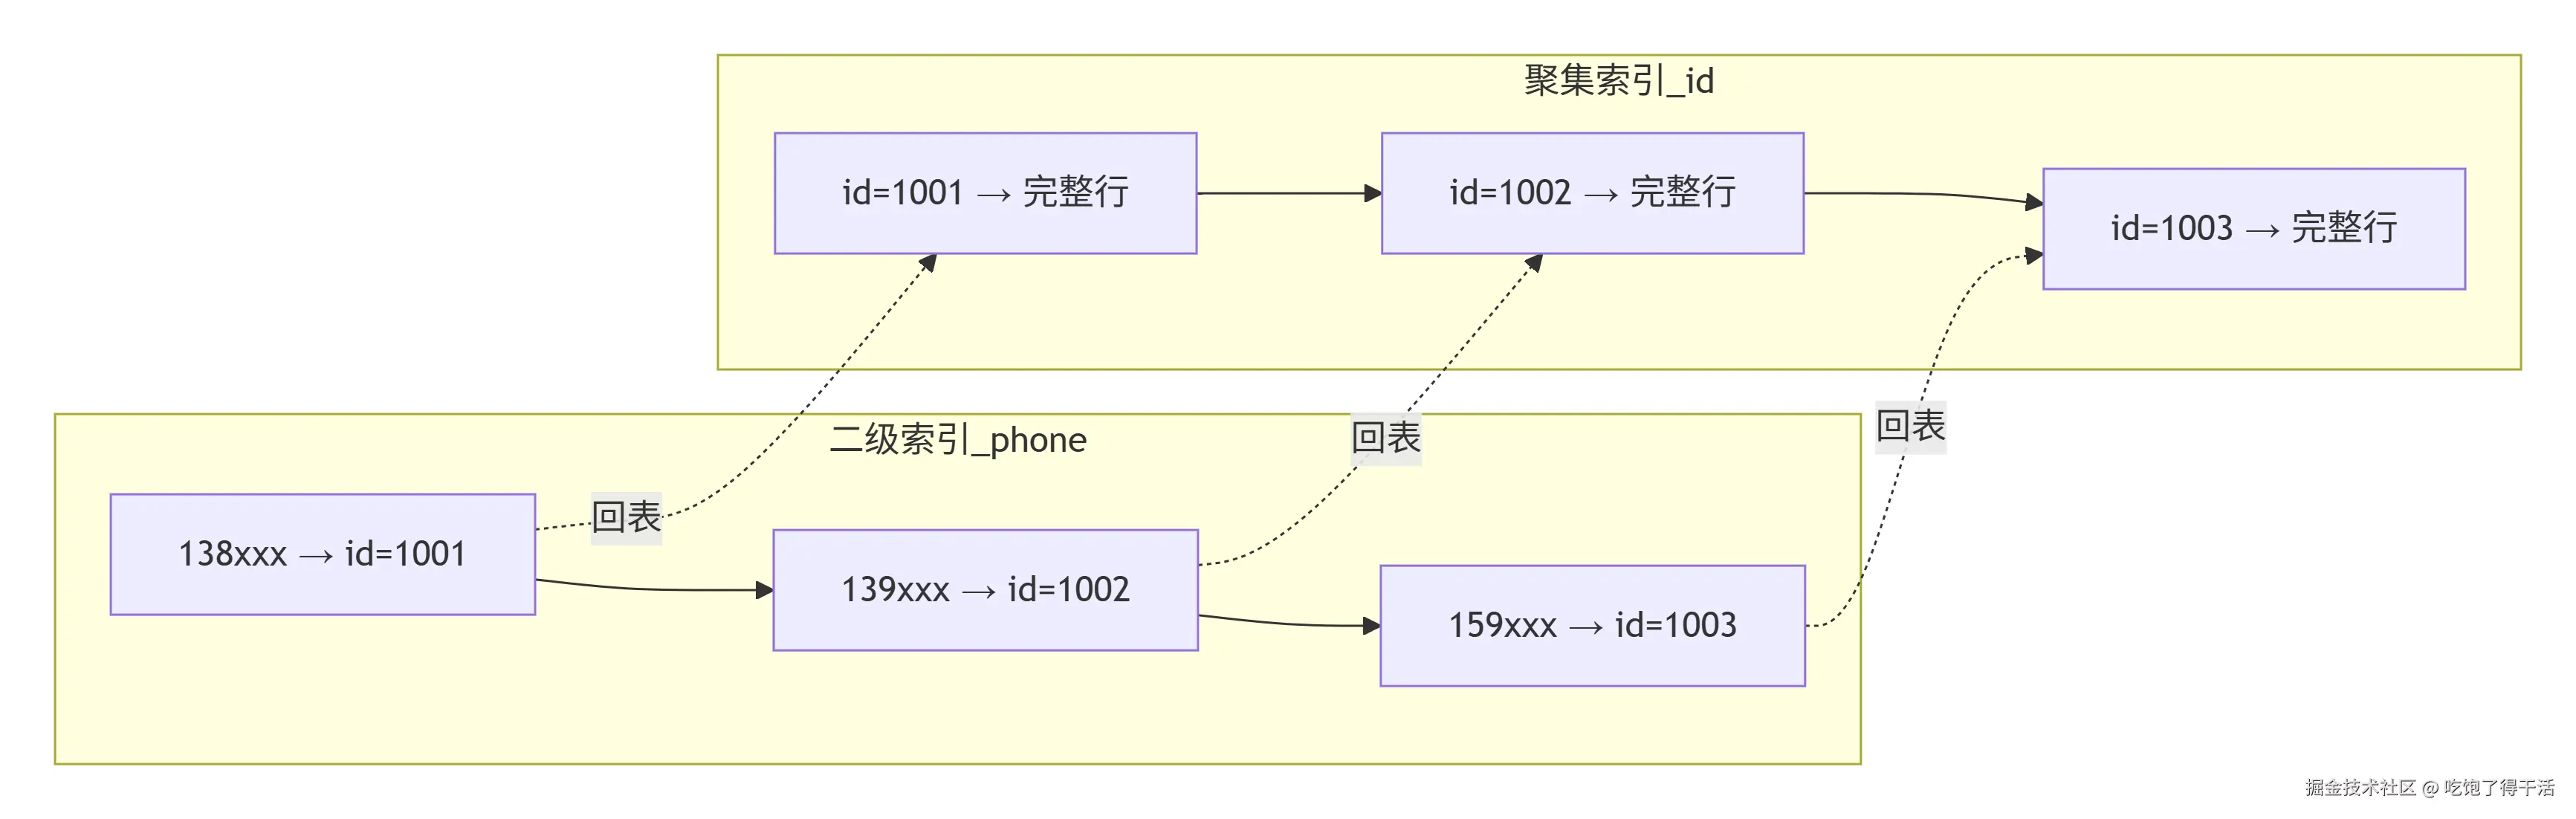
关键推论:主键越长,所有二级索引越大。
text
主键 8 字节(BIGINT):
┌──────────────────────────────────────────┐
│ 二级索引1 │ 二级索引2 │ 二级索引3 │ ...   │
│   8字节   │   8字节   │   8字节   │       │
└──────────────────────────────────────────┘

主键 36 字节(UUID 字符串):
┌──────────────────────────────────────────┐
│ 二级索引1 │ 二级索引2 │ 二级索引3 │ ...   │
│  36字节   │  36字节   │  36字节   │       │
└──────────────────────────────────────────┘
              ↑ 每个索引膨胀 4.5 倍
1.3 页分裂:随机插入的代价
B+ 树的每个节点是一个页(Page),InnoDB 默认 16KB。
顺序插入(自增 ID):
text
   [1,2,3]   →   [4,5,6]   →   [7,8,9]   →   [10,11,12]
                                                ↑
                                          新数据总是追加到最右页
   ┌─────┐   ┌─────┐   ┌─────┐   ┌─────┐
   │1,2,3│   │4,5,6│   │7,8,9│   │10,11│  ← 顺序追加,不移动已有数据
   └─────┘   └─────┘   └─────┘   └─────┘
随机插入(UUID):
text
   [1,2,3]   →   [4,5,6]   →   [7,8,9]
                      ↑
                 新数据 5.5 要插入这里

   第一步:页 [4,5,6] 满了,新开一页
   ┌─────┐   ┌─────┐         ┌─────┐
   │1,2,3│   │4,5,6│         │7,8,9│
   └─────┘   └─────┘         └─────┘

   第二步:把一半数据移到新页
   ┌─────┐   ┌─────┐   ┌─────┐   ┌─────┐
   │1,2,3│   │4,   │   │  6  │   │7,8,9│
   └─────┘   └─────┘   └─────┘   └─────┘

   第三步:插入 5.5,更新父节点指针
   ┌─────┐   ┌─────┐   ┌─────┐   ┌─────┐
   │1,2,3│   │4,5.5│   │  6  │   │7,8,9│
   └─────┘   └─────┘   └─────┘   └─────┘
结论:主键越随机,页分裂越频繁,插入性能越差。
二、自增 ID:单机最优解
sql
CREATE TABLE user (
    id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    phone VARCHAR(20) NOT NULL
);
为什么快? 新数据永远追加到 B+ 树最右侧页:
text
插入顺序:  1 → 2 → 3 → 4 → 5 → 6 → 7 → 8

B+ 树形态:
┌───────┐   ┌───────┐   ┌───────┐
│ 1,2,3 │ → │ 4,5,6 │ → │ 7,8,9 │
└───────┘   └───────┘   └───────┘
                            ↑
                       永远从这里追加
硬伤一:分库分表冲突
text
              应用层
                │
    ┌───────────┼───────────┐
    ▼           ▼           ▼
┌────────┐  ┌────────┐  ┌────────┐
│  库1   │  │  库2   │  │  库3   │
│ 自增ID │  │ 自增ID │  │ 自增ID │
│ 1,2,3  │  │ 1,2,3  │  │ 1,2,3  │  ← 主键冲突!
└────────┘  └────────┘  └────────┘
硬伤二:信息泄露与越权
订单号 1000001 暴露业务量。IDOR 漏洞:用户 A 把订单 ID 从 1001 改成 1002,就能看到用户 B 的订单。
java
@TableId(type = IdType.AUTO)
private Long id;
三、UUID:全局唯一,但代价不小
java
String id = UUID.randomUUID().toString();
// 550e8400-e29b-41d4-a716-446655440000
⚠️ UUID 并非数学意义上的「全局唯一」,而是「碰撞概率极低」。详见文末补充。
硬伤一:随机性导致页分裂
text
插入顺序:550e → 1b9c → 8a4f → 3a7f → ...

B+ 树形态:
┌───────┐   ┌───────┐   ┌───────┐   ┌───────┐
│ 1b,3a │   │ 5d,7f │   │ 8a,9c │   │ c1,e4 │
└───────┘   └───────┘   └───────┘   └───────┘
      ↑           ↑           ↑           ↑
新数据可能落在任何一个位置,触发页分裂有测试表明:UUID 主键的插入性能通常只有自增 ID 的 1/5 到 1/10。
硬伤二:占用空间大
text
自增 BIGINT:          8 字节
┌────────┐
│ 8 字节 │
└────────┘

UUID 字符串:          36 字节
┌────────────────────────────────────┐
│            36 字节                  │
└────────────────────────────────────┘
        ↑ 主键体积是自增 ID 的 4.5 倍
硬伤三:可读性差 ------ 550e8400... 和 10086 哪个好记?
java
@TableId(type = IdType.ASSIGN_UUID)
private String id;
四、雪花算法:趋势递增 + 结构唯一
4.1 64 位分段结构
text
 0 │ 41位时间戳 │ 10位机器ID │ 12位序列号
───┼────────────┼────────────┼────────────┐
 1 │   41 bit   │   10 bit   │   12 bit   │
   │            │            │            │
   │            │            │            └─ 同一毫秒内支持 4096 个 ID
   │            │            └─ 支持 1024 个节点
   │            └─ 毫秒级,可用约 69 年
   └─ 符号位,固定为 0,保证正数

 总长度:1 + 41 + 10 + 12 = 64 bit
4.2 为什么趋势递增?
text
ID1: 0 │ 1700000000000 │ 00001 │ 000000000001
ID2: 0 │ 1700000000000 │ 00001 │ 000000000002
ID3: 0 │ 1700000000001 │ 00001 │ 000000000001
                                        ▲
                                   时间戳增大,ID 整体增大

B+ 树插入位置:
┌───────┐   ┌───────┐   ┌───────┐
│ ID1   │ → │ ID2   │ → │ ID3   │
└───────┘   └───────┘   └───────┘
                            ↑
                       趋势递增,追加在右侧
4.3 为什么结构唯一?
text
        同一毫秒内的并发请求
                │
    ┌───────────┼───────────┐
    ▼           ▼           ▼
┌────────┐  ┌────────┐  ┌────────┐
│ 节点1  │  │ 节点2  │  │ 节点3  │
│机器ID=1│  │机器ID=2│  │机器ID=3│
└────────┘  └────────┘  └────────┘
    │           │           │
    ▼           ▼           ▼
序列号+1 序列号+1 序列号+1- 不同节点 → 机器 ID 不同;
- 同一节点同一毫秒 → 序列号不同;
- 同一节点不同毫秒 → 时间戳不同。
4.4 Java 实现
java
public class SnowflakeIdGenerator {
    private final long workerId;
    private final long datacenterId;
    private long sequence = 0L;
    private long lastTimestamp = -1L;

    private static final long EPOCH = 1700000000000L;
    private static final long WORKER_ID_BITS = 5L;
    private static final long DATACENTER_ID_BITS = 5L;
    private static final long SEQUENCE_BITS = 12L;

    private static final long MAX_WORKER_ID = ~(-1L << WORKER_ID_BITS);
    private static final long MAX_DATACENTER_ID = ~(-1L << DATACENTER_ID_BITS);
    private static final long SEQUENCE_MASK = ~(-1L << SEQUENCE_BITS);

    private static final long WORKER_ID_SHIFT = SEQUENCE_BITS;
    private static final long DATACENTER_ID_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS;
    private static final long TIMESTAMP_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS + DATACENTER_ID_BITS;

    public SnowflakeIdGenerator(long workerId, long datacenterId) {
        if (workerId > MAX_WORKER_ID || workerId < 0) {
            throw new IllegalArgumentException("workerId 超出范围");
        }
        if (datacenterId > MAX_DATACENTER_ID || datacenterId < 0) {
            throw new IllegalArgumentException("datacenterId 超出范围");
        }
        this.workerId = workerId;
        this.datacenterId = datacenterId;
    }

    public synchronized long nextId() {
        long timestamp = System.currentTimeMillis();

        if (timestamp < lastTimestamp) {
            throw new RuntimeException("时钟回拨,拒绝生成 ID");
        }

        if (timestamp == lastTimestamp) {
            sequence = (sequence + 1) & SEQUENCE_MASK;
            if (sequence == 0) {
                timestamp = waitNextMillis(lastTimestamp);
            }
        } else {
            sequence = 0L;
        }

        lastTimestamp = timestamp;

        return ((timestamp - EPOCH) << TIMESTAMP_SHIFT)
                | (datacenterId << DATACENTER_ID_SHIFT)
                | (workerId << WORKER_ID_SHIFT)
                | sequence;
    }

    private long waitNextMillis(long lastTimestamp) {
        long timestamp = System.currentTimeMillis();
        while (timestamp <= lastTimestamp) {
            timestamp = System.currentTimeMillis();
        }
        return timestamp;
    }

    public static void main(String[] args) {
        SnowflakeIdGenerator generator = new SnowflakeIdGenerator(1, 1);
        for (int i = 0; i < 5; i++) {
            System.out.println(generator.nextId());
        }
    }
}
4.5 硬伤:依赖时钟
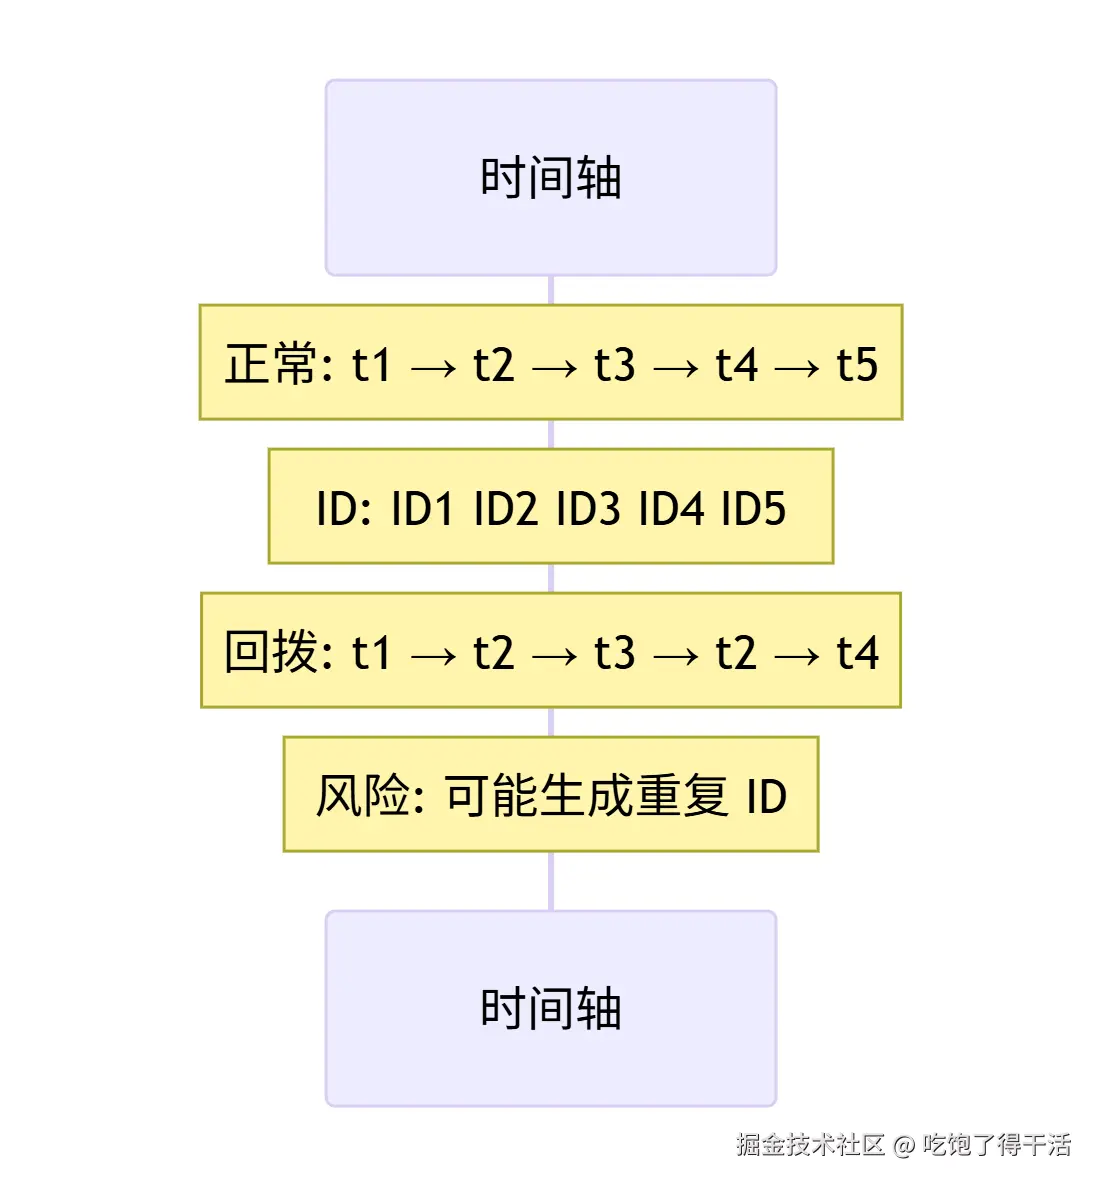
另一个隐蔽问题:机器 ID 需要手动分配。大规模容器化场景下,Pod 频繁重建,机器 ID 管理极其复杂。
五、工业级方案:雪花算法的工程化落地
5.1 美团 Leaf
Leaf-segment(号段模式): 完全脱离时钟依赖。
text
┌──────────────┐         ┌──────────────┐
│ Leaf Server 1│         │ Leaf Server 2│
│ 号段 [1,1000]│         │号段[1001,2000]│
└───────┬──────┘         └───────┬──────┘
        │                        │
        │   用完再取新号段          │
        ▼                        ▼
┌─────────────────────────────────────────┐
│              MySQL 号段表               │
│  biz_tag  │  max_id  │  step  │  ...    │
│  order    │  2000    │  1000  │         │
└─────────────────────────────────────────┘
sql
CREATE TABLE id_segment (
    biz_tag VARCHAR(64) NOT NULL PRIMARY KEY,
    max_id BIGINT NOT NULL,
    step INT NOT NULL,
    update_time DATETIME
);
双 Buffer 优化: 当前号段使用量达到 10% 时,异步预加载下一个号段:
text
┌──────────────┐   ┌──────────────┐
│  当前号段     │   │  下一个号段  │
│  [1, 1000]   │   │ [1001, 2000] │
│  已用 100    │   │  预加载中     │
└───────┬──────┘   └──────────────┘
        │                  ▲
        │   使用到 10% 时   │
        └──────────────────┘
             异步预加载
美团生产数据显示,step 从 1000 调整到 5000,数据库压力降低 80%,TP99 从 15ms 降至 3ms。
Leaf-snowflake: 用 ZooKeeper 解决机器 ID 分配问题。
text
┌─────────────────────────────────────────┐
│              ZooKeeper                  │
│  /leaf/worker/0001  (临时节点)           │
│  /leaf/worker/0002  (临时节点)           │
│  /leaf/worker/0003  (临时节点)           │
└──────────────────┬──────────────────────┘
                   │ 启动时注册,自动获取 workerId
        ┌──────────┼──────────┐
        ▼          ▼          ▼
   ┌────────┐ ┌────────┐ ┌────────┐
   │ 节点1  │ │ 节点2  │ │ 节点3  │
   │ID=0001 │ │ID=0002 │ │ID=0003 │
   └────────┘ └────────┘ └────────┘
Leaf 核心优势:一个服务,两种模式。对时钟敏感的业务用 segment,对性能要求极高的用 snowflake。
5.2 百度 UidGenerator
最大创新是 RingBuffer 缓存:
text
┌─────────────────────────────────────────────────┐
│                   UidGenerator                  │
│                                                 │
│  ┌──────────┐      ┌──────────────────────────┐ │
│  │ 生产者线程│     │      RingBuffer           │ │
│  │ 异步预生成│───▶ │  ┌────┬────┬────┬────┐   │ │
│  └──────────┘      │  │ID  │ID  │ID  │ID  │   │ │
│                    │  ├────┼────┼────┼────┤   │ │
│                    │  │ID  │ID  │ID  │ID  │   │ │
│                    │  ├────┼────┼────┼────┤   │ │
│                    │  │ID  │ID  │ID  │ID  │   │ │
│                    │  └────┴────┴────┴────┘   │ │
│                    └────────────┬─────────────┘ │
│                                 │               │
│                                 ▼               │
│                          业务直接读取            │
└─────────────────────────────────────────────────┘
用生产者-消费者模型,异步批量预生成 ID 放入 RingBuffer,业务直接从内存读取。单次调用耗时从微秒级降至纳秒级,QPS 可达 600 万以上。
借用未来时间解决时钟回拨:
text
正常情况:
时间轴 ──────────────────────────────▶
        t1    t2    t3    t4    t5
        ID1   ID2   ID3   ID4   ID5

时钟回拨:
时间轴 ──────────────────────────────▶
        t1    t2    t3    t2    t4
        ID1   ID2   ID3   RingBuffer 中
                          │
                          ▼
                 已有未来时间戳的 ID 可用
                 (预生成时借用未来时间)
同时支持机器 ID 持久化,重启后从数据库或 ZooKeeper 恢复,确保 ID 连续性。
六、选型对比
| 方案 | 长度 | 有序性 | 分布式 | 时钟依赖 | 适用场景 |
|---|---|---|---|---|---|
| 自增 ID | 8 字节 | 严格递增 | 冲突 | 无 | 单库单表 |
| UUID v4 | 16/36 字节 | 随机 | 碰撞概率极低 | 无 | 非 MySQL 或低频写入 |
| 雪花算法 | 8 字节 | 趋势递增 | 全局唯一 | 强 | 分布式、高并发 |
| Leaf-segment | 8 字节 | 趋势递增 | 全局唯一 | 无 | 需多业务隔离 |
| Leaf-snowflake | 8 字节 | 趋势递增 | 全局唯一 | 弱(ZK 兜底) | 超大规模分布式 |
| UidGenerator | 8 字节 | 趋势递增 | 全局唯一 | 弱(RingBuffer 兜底) | 极致性能场景 |
决策路径
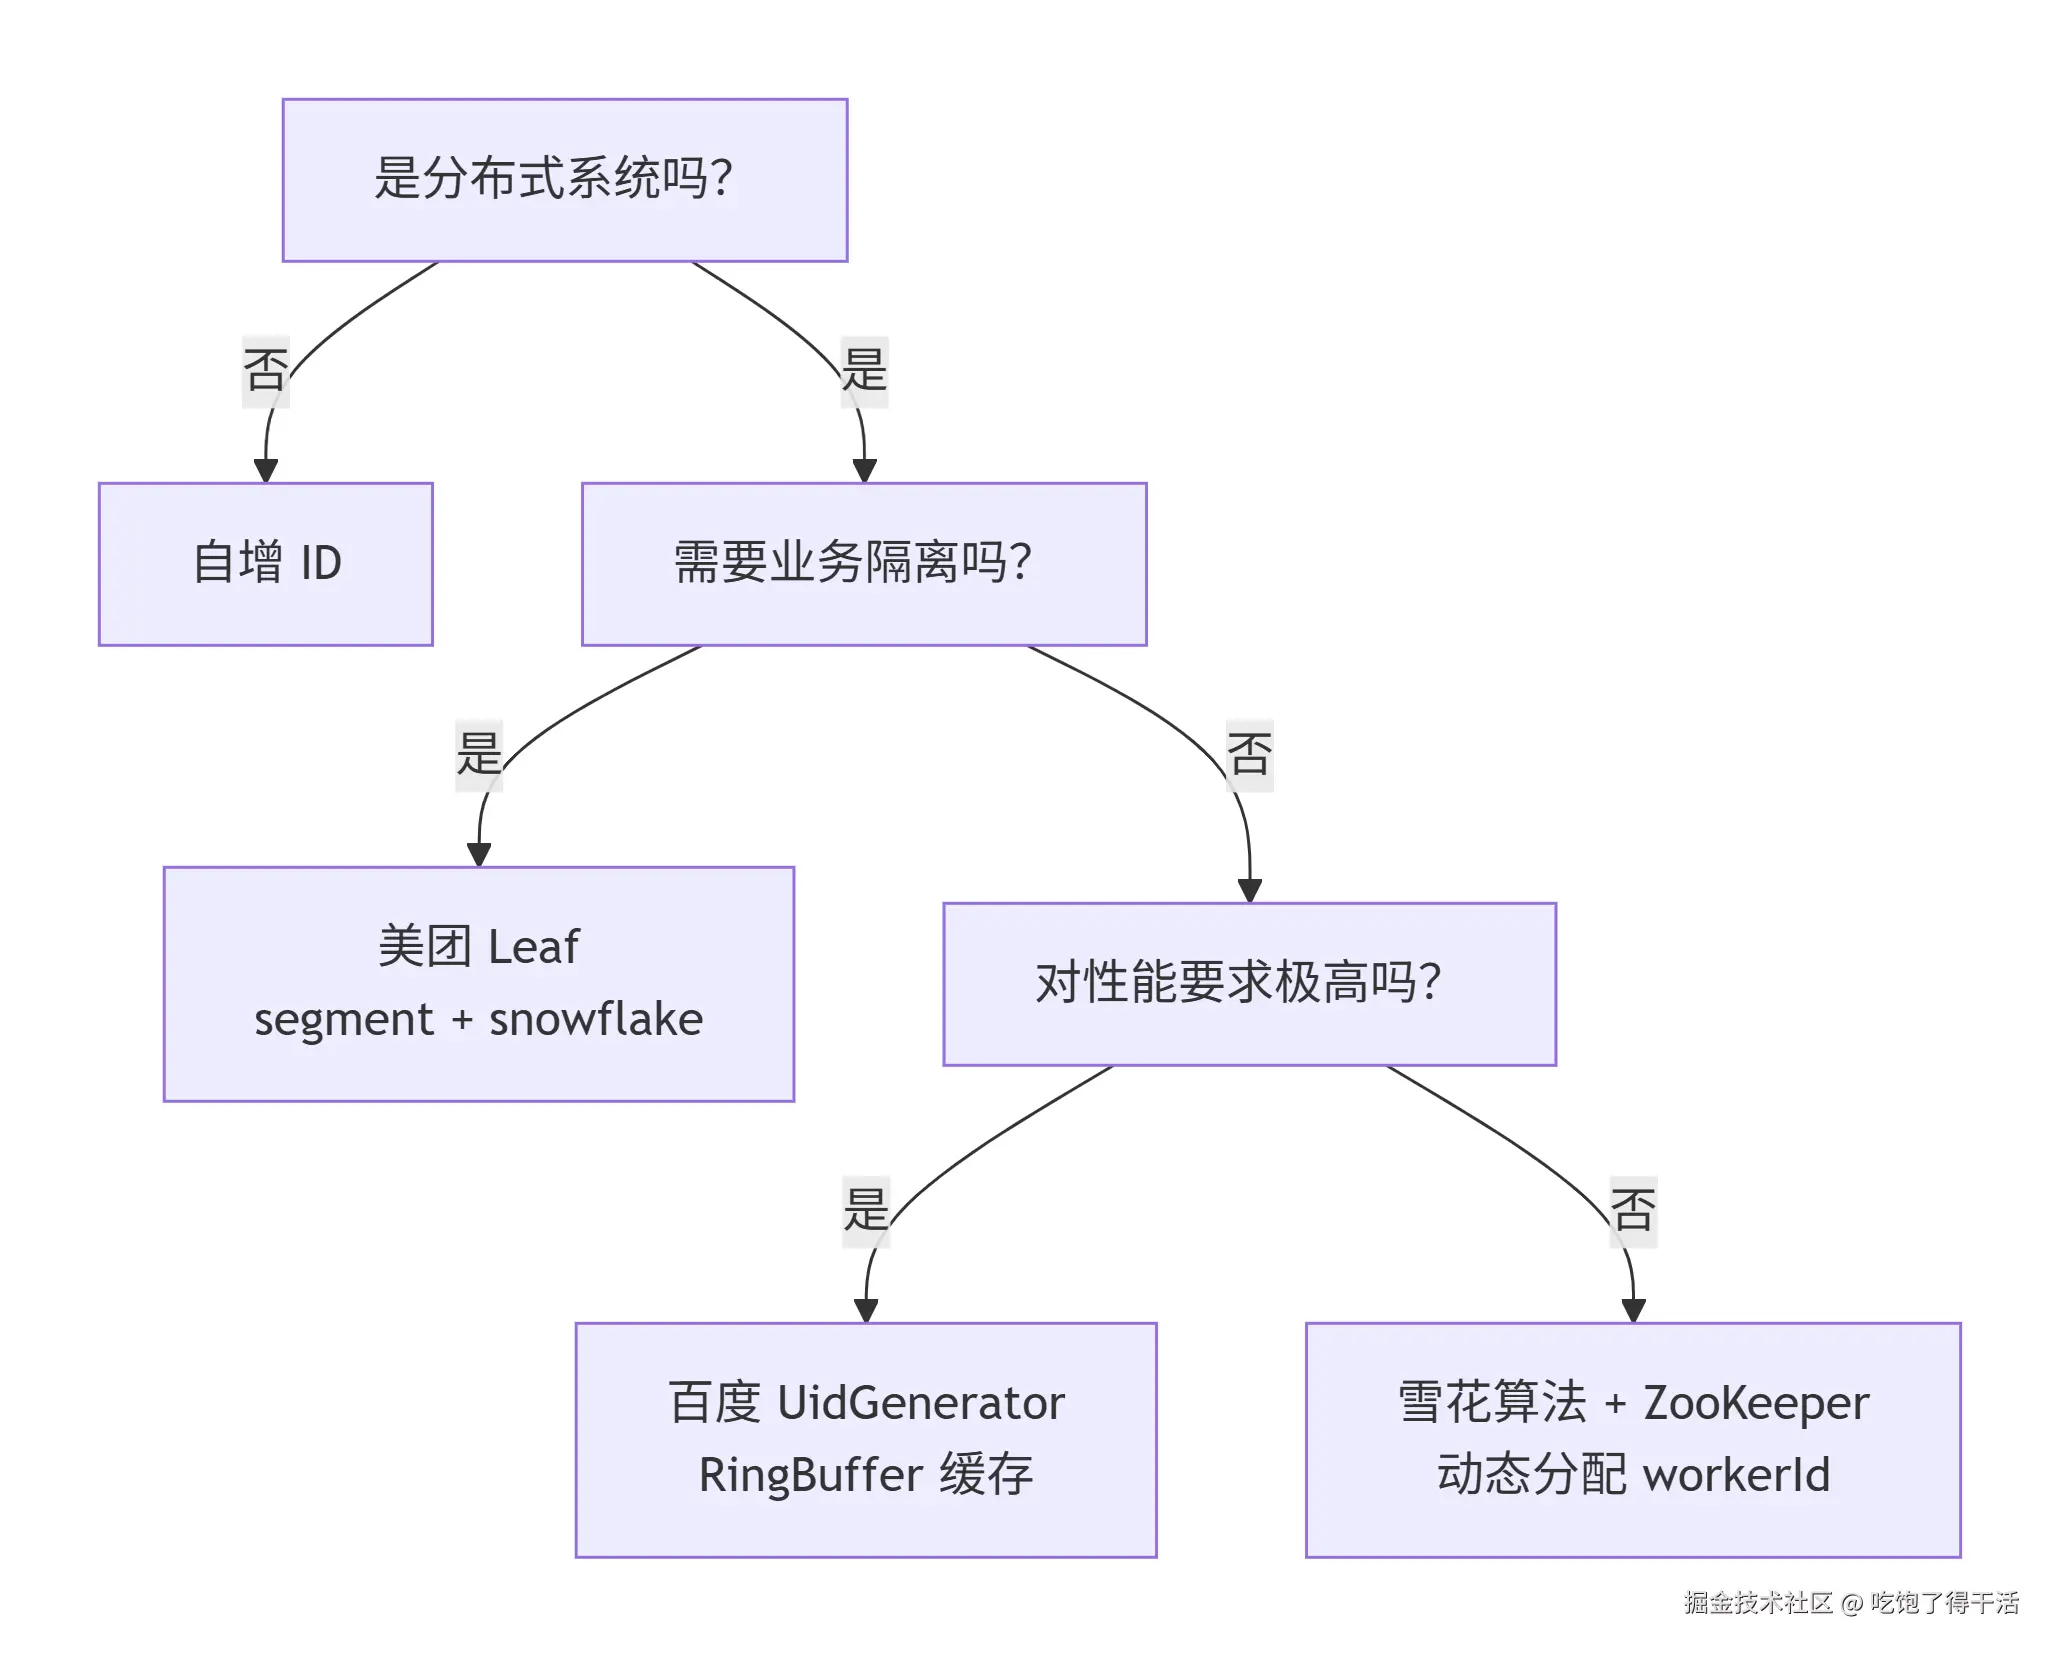
分库分表场景推荐
text
                应用层
                  │
        ┌─────────┼─────────┐
        ▼         ▼         ▼
   ┌────────┐┌────────┐┌────────┐
   │ 分片1  ││ 分片2  ││ 分片3  │
   │ID=...01││ID=...02││ID=...03│
   └────────┘└────────┘└────────┘
        │         │         │
        └─────────┼─────────┘
                  ▼
        雪花算法保证全局唯一
        (不同分片 workerId 不同)
两个关键点:
- 主键 ≠ 分片键。主键只为唯一标识,分片键决定数据落哪张表;
- workerId 需要规划。可将库号、表号映射到 workerId 位段。
七、实战建议
1. 主键用 BIGINT,不要用 INT ------ INT 最大 21 亿,跑几年就溢出。BIGINT 才 8 字节,一步到位。
2. 业务主键和数据库主键分离
text
┌─────────────────────────────────────────┐
│              订单表                      │
│  id (雪花ID)  │  order_no (业务编号)     │
│  7382910384   │  ORD202401010001        │
│  内部使用     │  对外展示                │
└─────────────────────────────────────────┘
3. 分库分表用雪花 ID ------ 但务必提前规划 workerId 分配策略,ZooKeeper 动态注册最稳妥。
4. 如果一定要用 UUID,用 UUIDv7 ------ UUIDv4 随机性太强,插入性能差。UUIDv7 于 2024 年 5 月在 RFC 9562 中正式标准化,前 48 位是时间戳,B+ 树插入友好。PostgreSQL 18 已原生支持 uuidv7()。
八、补充:UUID 一定全局唯一吗?
严格来说,不是。UUID v4 从 21222122 个可能值中随机选,碰撞概率:
| 生成数量 | 碰撞概率 |
|---|---|
| 10^9(10 亿) | 约 10^-19 |
| 10^15(千万亿) | 约 10^-7 |
| 10^18(百亿亿) | 约 0.1% |
| 2.7×10^18 | 约 50% |
每秒生成 10 亿个 UUID,连续生成 85 年 ,才有约 50% 的概率发生一次碰撞。工程意义上可以忽略,但数学上不是零。
更隐蔽的坑在实现层面:
- 随机源质量差:某些环境使用弱 PRNG,熵不足;
- 虚拟机克隆:MAC 地址相同,UUID v1 可能重复;
- 时钟回拨:UUID v1 依赖时间戳,回拨可能重复;
- 状态复用:生成库的本地状态未持久化,重启后可能重复。
准确的说法是:UUID 是「概率唯一」,雪花算法是「结构唯一」。前者依赖随机性,后者依赖协调机制。
九、总结
主键选择的主线只有一条:主键决定了数据的物理存储顺序,顺序决定性能。
- 自增 ID:单机最优,但分布式冲突、信息泄露;
- UUID:碰撞概率极低,但随机性导致 B+ 树频繁分裂,空间占用大;
- 雪花算法:趋势递增 + 结构唯一,但依赖时钟、机器 ID 管理复杂;
- 工业级方案:美团 Leaf 同时提供号段和雪花两种模式,百度 UidGenerator 用 RingBuffer 把 QPS 拉到 600 万+。
三句话收尾:
- MySQL InnoDB 下,主键顺序就是数据顺序,页分裂是随机插入的代价;
- 单机用自增,分布式用雪花,需要工程化落地就用 Leaf 或 UidGenerator;
- 对外暴露的 ID 和数据库主键,最好分开。
如果本文对你有帮助,欢迎点赞、收藏、关注。你们项目的主键用的是什么方案?踩过哪些坑?欢迎评论区交流