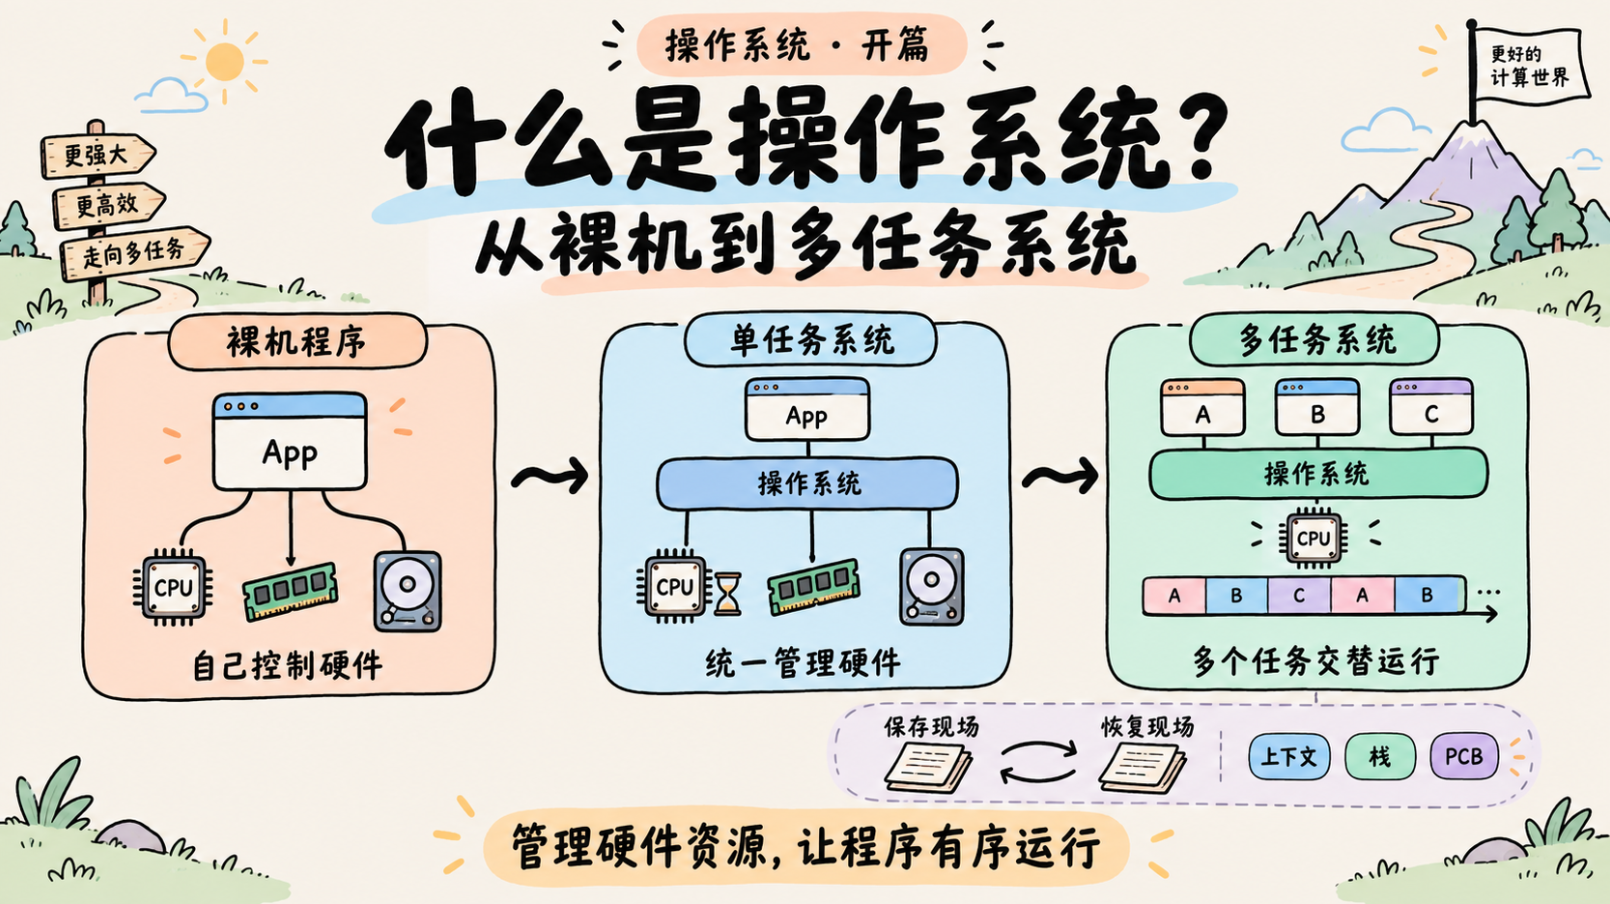
平时使用计算机时,我们很少关心程序究竟怎样控制硬件。打开播放器就能听音乐,启动浏览器就能访问网络,点击保存就能把文档写入磁盘。这些操作背后,都有操作系统参与其中。
那么,为什么需要操作系统?它怎样让多个程序共享同一台机器?进程、上下文、栈和 PCB 这些概念,又是为了解决什么问题而出现的?
这一篇就从最基本的硬件访问开始,沿着"裸机程序 → 单任务系统 → 多任务系统"的思路,逐步认识操作系统。
1. 理解操作系统这个概念
先用一句话理解:操作系统是负责管理计算机资源,并向上提供统一使用接口的系统软件。
它一方面管理 CPU、内存、磁盘和外设,另一方面让应用程序能够方便地使用这些资源,而不必每次都自己处理硬件细节。
比如,程序需要读取一个文件时,通常只需要调用相应接口,提供文件名、读取位置和长度。至于数据位于哪种存储设备上、控制器如何工作、数据怎样传输,则由文件系统、设备驱动等组件协同处理。
常见的设备访问过程可以简化为:
text
用户使用应用程序
        ↓
应用调用库函数或系统服务
        ↓
通过系统调用请求内核服务
        ↓
内核中的相关管理模块与设备驱动
        ↓
具体硬件
驱动负责处理设备的具体控制方式,上层接口则尽量屏蔽这些差异。这样,应用程序就能更多地关注"要完成什么功能"。
从资源管理的角度,可以先抓住三条主线:
| 核心资源 | 操作系统需要解决的问题 | 对应内容 |
|---|---|---|
| CPU | 哪个任务运行?运行多久?什么时候切换? | 进程、线程与任务调度 |
| 内存 | 空间怎样分配、共享、保护和回收? | 内存管理 |
| 磁盘 | 数据怎样组织、存储和访问? | 文件系统 |
除此之外,键盘、显示器、网卡等设备的使用,还需要 I/O 管理机制。
更完整地说,操作系统是一组控制和管理计算机硬件、软件资源,合理组织与调度任务,并方便用户使用计算机的程序集合。
提高资源利用率和系统吞吐量是它的重要目标;同时,它还要兼顾响应速度、公平性、稳定性和安全性。
2. 从裸机程序到操作系统的出现
理解操作系统,可以先暂时把它拿掉,看看程序会面临哪些问题,再一步步把需要的能力补回来。
下面用"操作系统 1.0"和"操作系统 2.0"分别表示简化的单任务、多任务模型。这是为了说明问题的演进,并不是正式的系统版本或严格的历史分期。
2.1 裸机程序
没有操作系统,程序也可以运行。 直接运行在硬件上、不依赖操作系统提供运行环境的程序,通常称为裸机程序。
计算机底层有很多硬件,各自承担不同的职责:
- CPU:执行程序指令。
- 内存:保存运行时的指令和数据。
- 磁盘等存储设备:持久保存程序与数据。
- 外设控制器:控制 USB、网卡、磁盘等设备的具体操作。
- 总线与互连:连接 CPU、内存和控制器,传递地址、数据及控制信息。
程序要操作硬件,最终必须按照硬件规定的方式发出命令。
例如,在采用内存映射 I/O 的系统中,控制器的寄存器会映射到特定地址。程序执行对这些地址的读写,就可以设置控制信息或查询设备状态。
以 USB 控制器为例,可以先把基本关系理解为:
text
裸机程序
   │ 包含访问设备寄存器的指令
   ↓
CPU
   │ 执行读写操作
   ↓
总线与互连
   │ 将访问送到对应控制器
   ↓
USB 控制器的寄存器
   │ 设置控制信息、查询状态等
   ↓
USB 控制器内部电路
   ↓
通过 USB 接口与设备通信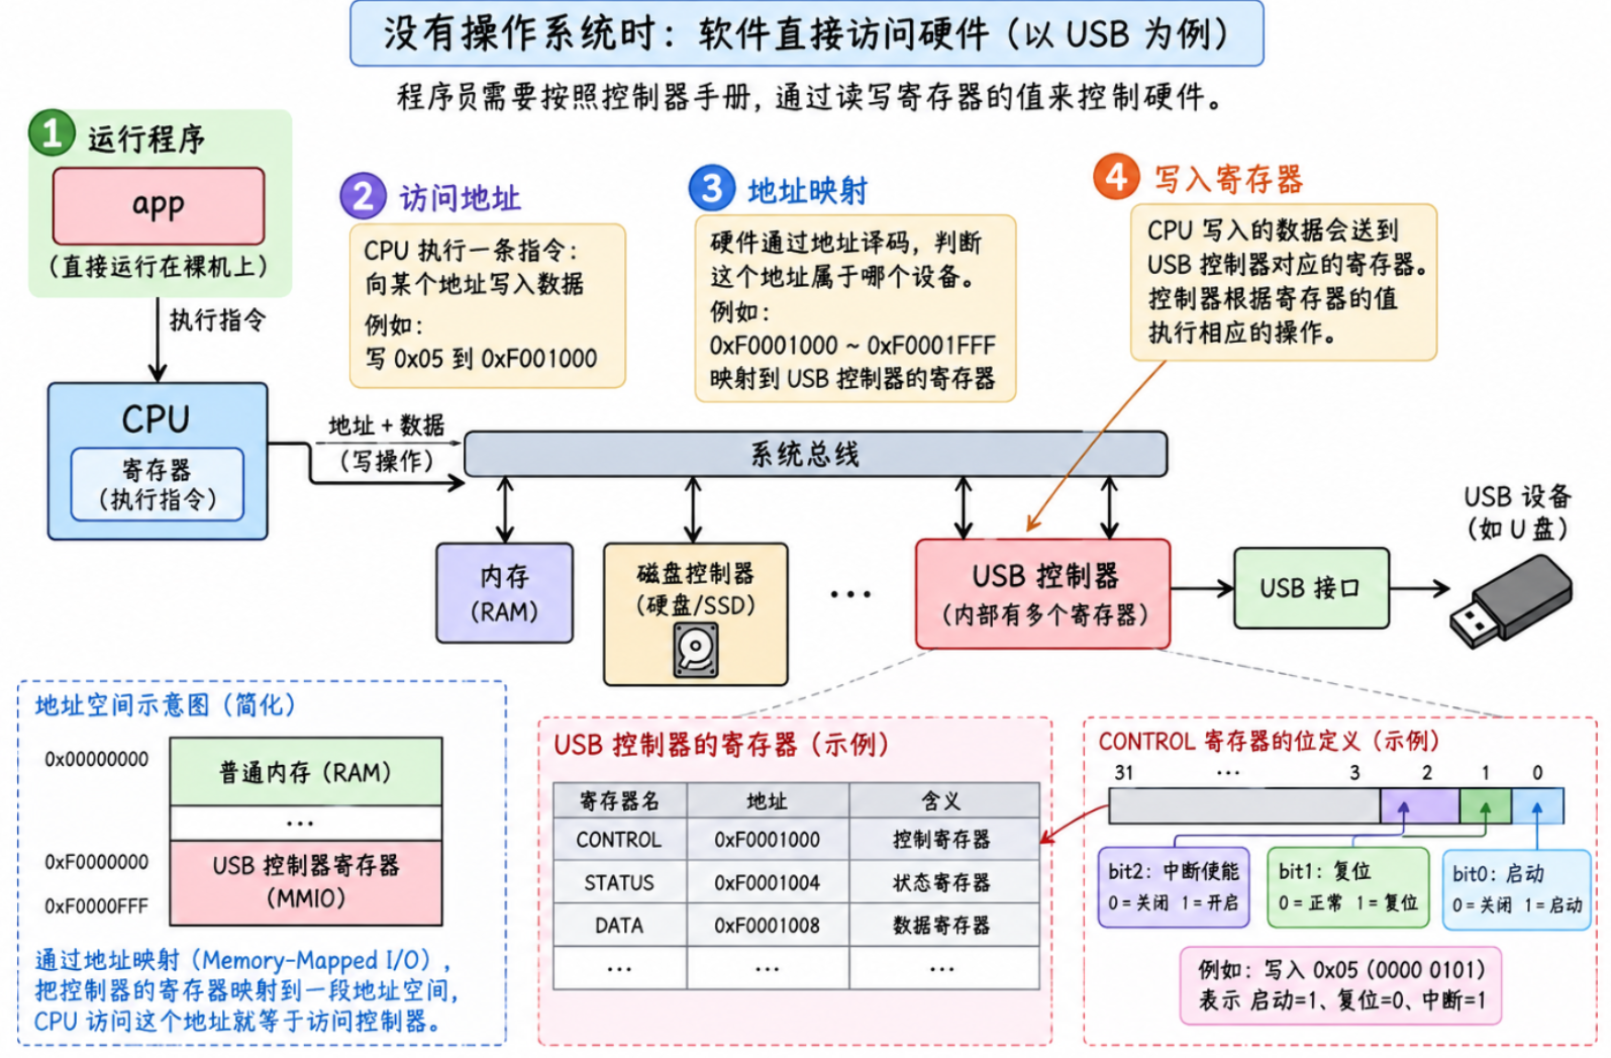
实际的 USB 通信还涉及协议、缓冲区、传输描述符等机制。这里先抓住一点:软件通过 CPU 执行指令,按照硬件约定控制设备。
这意味着,裸机开发者除了实现业务逻辑,还需要了解不少硬件知识:控制器地址是什么?哪个寄存器用于启动操作?哪个状态位表示完成?中断到来以后怎样处理?
如果一个程序同时要操作磁盘、键盘、显示器和网卡,就可能包含大量设备控制代码:
text
App A                         App B
├── 业务逻辑                  ├── 业务逻辑
├── 磁盘控制代码              ├── 磁盘控制代码
├── 键盘控制代码              ├── 键盘控制代码
├── 显示控制代码              ├── 显示控制代码
└── 网络控制代码              └── 网络控制代码
这些功能如果分别实现,就会产生重复劳动;更换硬件时,应用也可能需要跟着修改。
于是可以把共同的底层能力集中起来,在应用和硬件之间增加一层:
text
App A          App B          App C
   \             |             /
    └────── 统一的软件接口 ─────┘
                  ↓
               操作系统
                  ↓
          设备驱动与硬件访问
                  ↓
                硬件
操作系统统一管理和抽象硬件,让应用不必各自重复处理所有底层细节。 这就是从裸机程序走向操作系统的重要原因。
2.2 操作系统 1.0------单任务系统
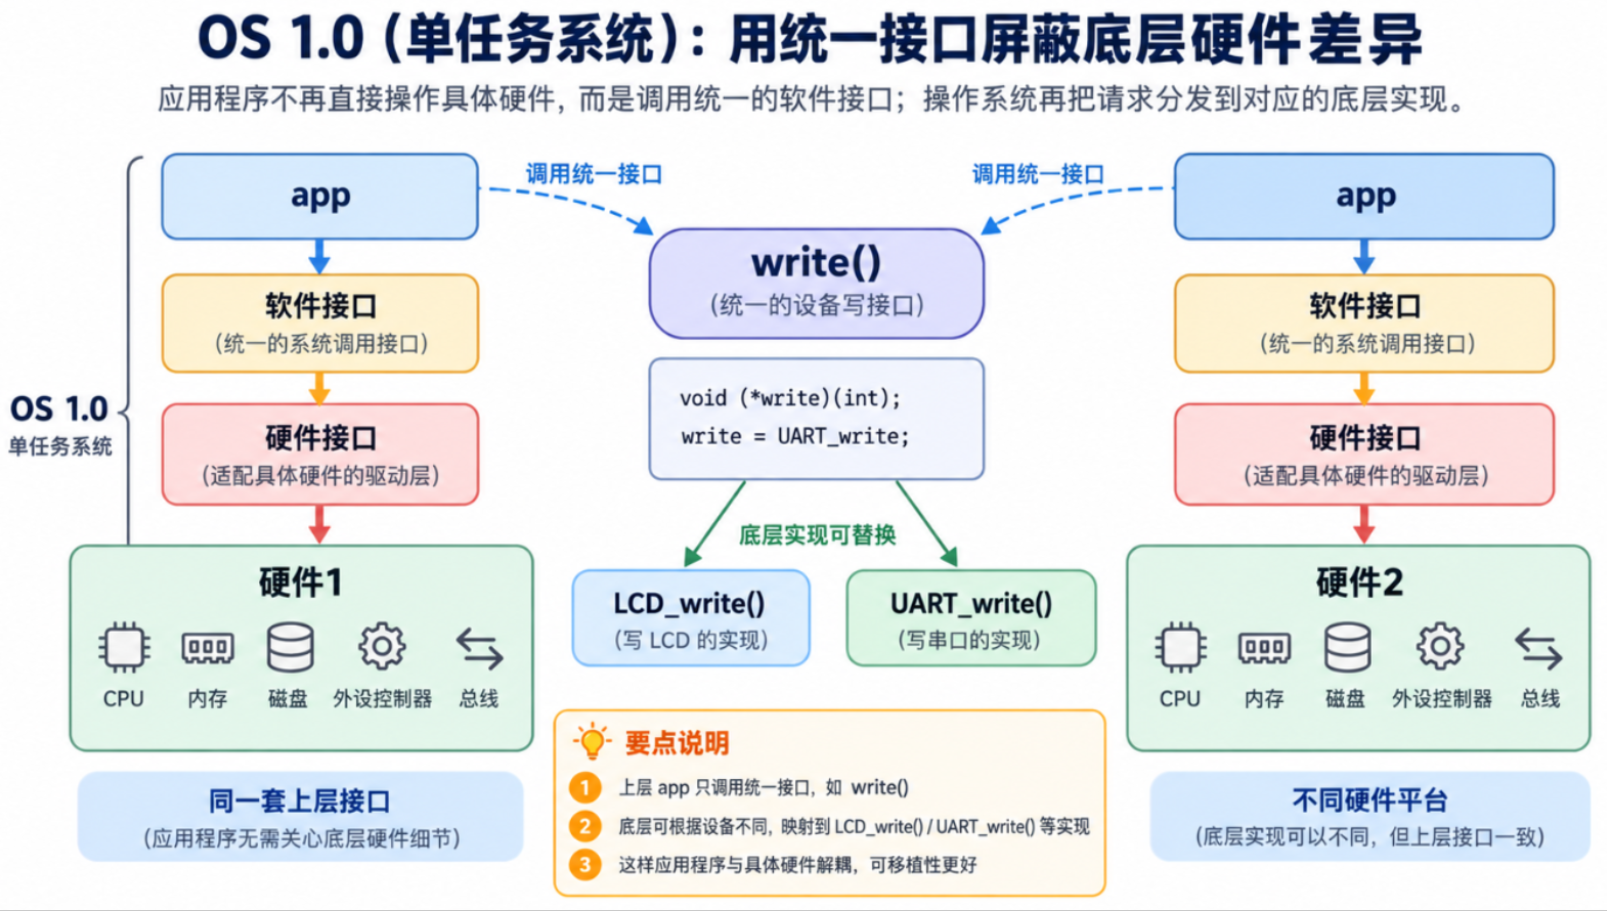
现在,应用已经能够通过操作系统提供的接口使用硬件。比如,编辑器只需要请求保存文件,不必自己实现每一种磁盘控制器的操作流程。
但假设系统一次主要运行一个应用,仍然会遇到新的问题:这个应用等待设备时,CPU 应该做什么?
例如,一个任务先计算,再读取磁盘,最后继续计算:
text
任务 A:计算 ──→ 等待磁盘 I/O ──→ 继续计算
CPU:   忙碌 ──→ 可能空闲      ──→ 再次忙碌
磁盘操作并不会瞬间完成。如果没有其他任务可以调度,等待期间 CPU 就可能闲着,即使它本来有能力完成更多计算。
这个简化的单任务模型主要存在以下局限:
- 任务不能充分交替推进:当前应用未结束时,其他应用通常难以获得执行机会。
- CPU 利用率受 I/O 等待影响:当前任务等待设备,CPU 可能缺少可运行的工作。
- 资源共享能力有限:CPU、内存和外设难以在多个应用之间进行灵活分配。
- 管理机制较简单:一些早期系统的隔离、保护和资源管理能力也不完善,但这些并不是"单任务"必然决定的属性。
因此,统一硬件接口还不够。为了让资源得到更充分的利用,系统还需要让多个任务共同推进。
2.3 操作系统 2.0------多任务系统
从单任务走向多任务,可以沿着一条线理解:
多个任务共享 CPU → CPU 需要切换任务 → 切换前必须保存执行现场 → 系统需要管理每个任务的上下文、状态和资源。
下面依次把这些问题展开。
多任务
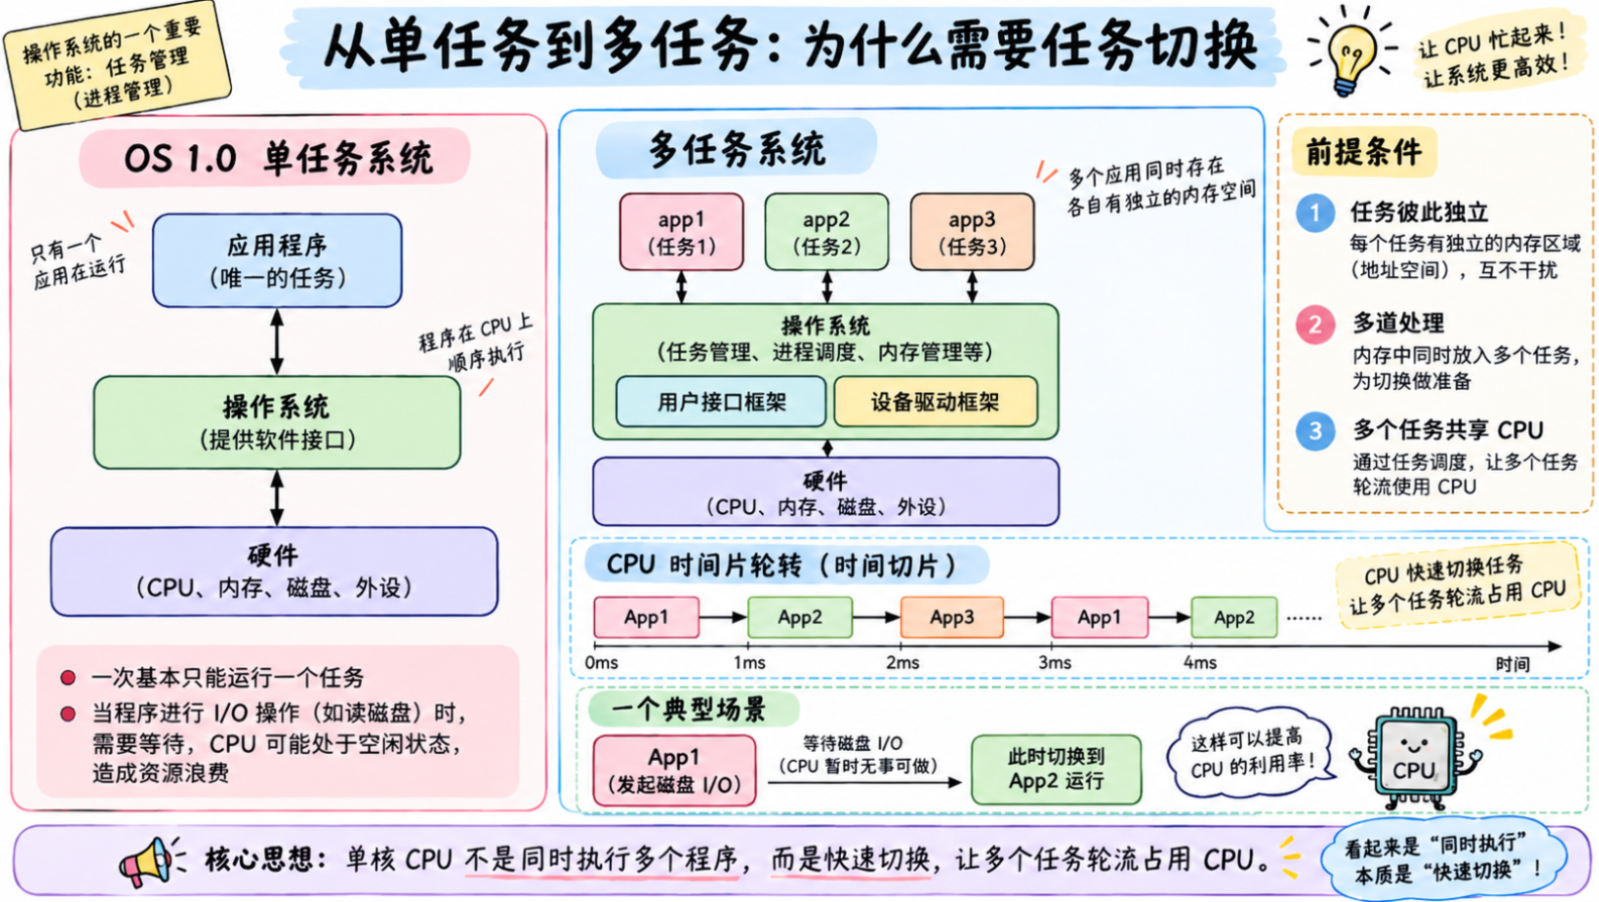
现在,系统里不再只有一个 App,而是同时存在多个需要运行的任务:
text
App1          App2          App3
    \          |          /
             操作系统
                ↓
        CPU / 内存 / 磁盘
为了简化讨论,先假设机器只有一个 CPU 核心,而且不考虑硬件多线程。同一时刻,CPU 只能执行一个任务,但可以在不同任务之间交替运行:
text
时间 ─────────────────────────────────→

CPU:| App1 | App2 | App3 | App1 | App2 | ......从一段时间来看,各个任务都在向前推进;切换足够及时,用户就会觉得这些程序在"同时运行"。这种交替推进属于并发 。如果多个核心在同一时刻分别执行不同任务,则属于并行。
多道程序设计的重要思路,是让一个任务的等待时间成为其他任务的执行机会:
text
App1 运行
    ↓
App1 等待磁盘 I/O
    ↓
切换到已经就绪的 App2
    ↓
App2 等待网络数据
    ↓
切换到已经就绪的 App3
为了让需要交互的任务及时获得响应,分时系统还会利用时间片等机制,让持续计算的任务也适时让出 CPU。
这样可以减少有可运行任务时的 CPU 空闲时间,但任务切换本身也有开销,并不是切得越频繁越好。
此时最关键的问题就出现了:App1 离开 CPU 时,它执行到一半的状态怎么办?
CPU 上下文和上下文切换
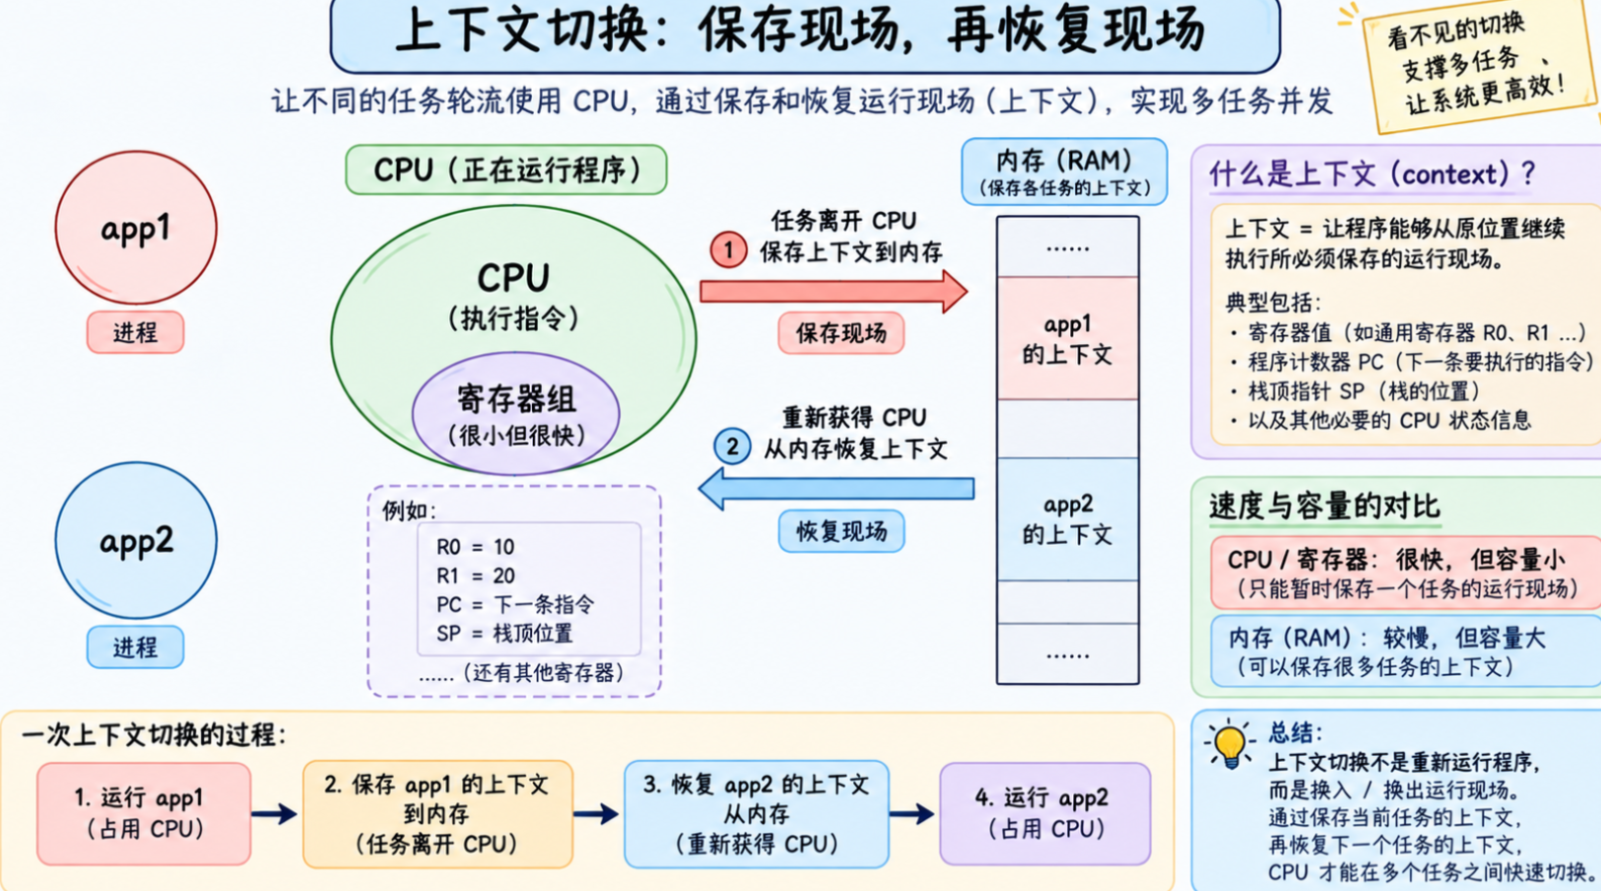
假设某个程序正在计算:
c
c = a + b;用一个简化过程表示,CPU 可以先把参与运算的数据放入寄存器,再执行加法:
text
内存中的数据
   a = 10,b = 20
          ↓ 读取
CPU 寄存器
   R0 = 10,R1 = 20
          ↓
执行加法实际指令会受编译优化和体系结构影响,变量也不一定始终存放在内存里。这里要理解的是:程序运行到某个位置时,CPU 寄存器中会保存当前执行所需的数据和状态。
例如:
text
R0、R1 等通用寄存器:中间计算结果、地址等
PC:程序执行的位置
SP:当前栈顶位置
状态寄存器:条件标志等处理器状态
这些为了恢复执行而需要保留的 CPU 状态,就是任务的 CPU 上下文(CPU Context)。
它回答了两个问题:程序运行到哪里了?接下来应该在什么状态下继续?
如果 CPU 要从 App1 切换到 App2,就不能直接让 App2 覆盖 App1 的寄存器状态。正确的做法是先保存旧现场,再恢复新现场:
text
CPU 正在执行 App1
        ↓
把 App1 的寄存器状态保存到内存
        ↓
从内存恢复 App2 的寄存器状态
        ↓
CPU 从 App2 保存的位置继续执行
等 App1 再次获得 CPU 时,再把它原来的状态恢复回来。这里不需要等 App2 整个执行完,只需要等下一次调度选择 App1。
可以把这个过程理解成游戏存档:离开之前保存进度,再次进入时读取进度。不过,上下文切换通常不会复制整个进程的内存,而是保存、恢复必要的执行状态;跨进程切换时还可能涉及地址空间等状态的变化。
因此,上下文切换使任务能够从暂停的位置继续运行。
任务上下文管理
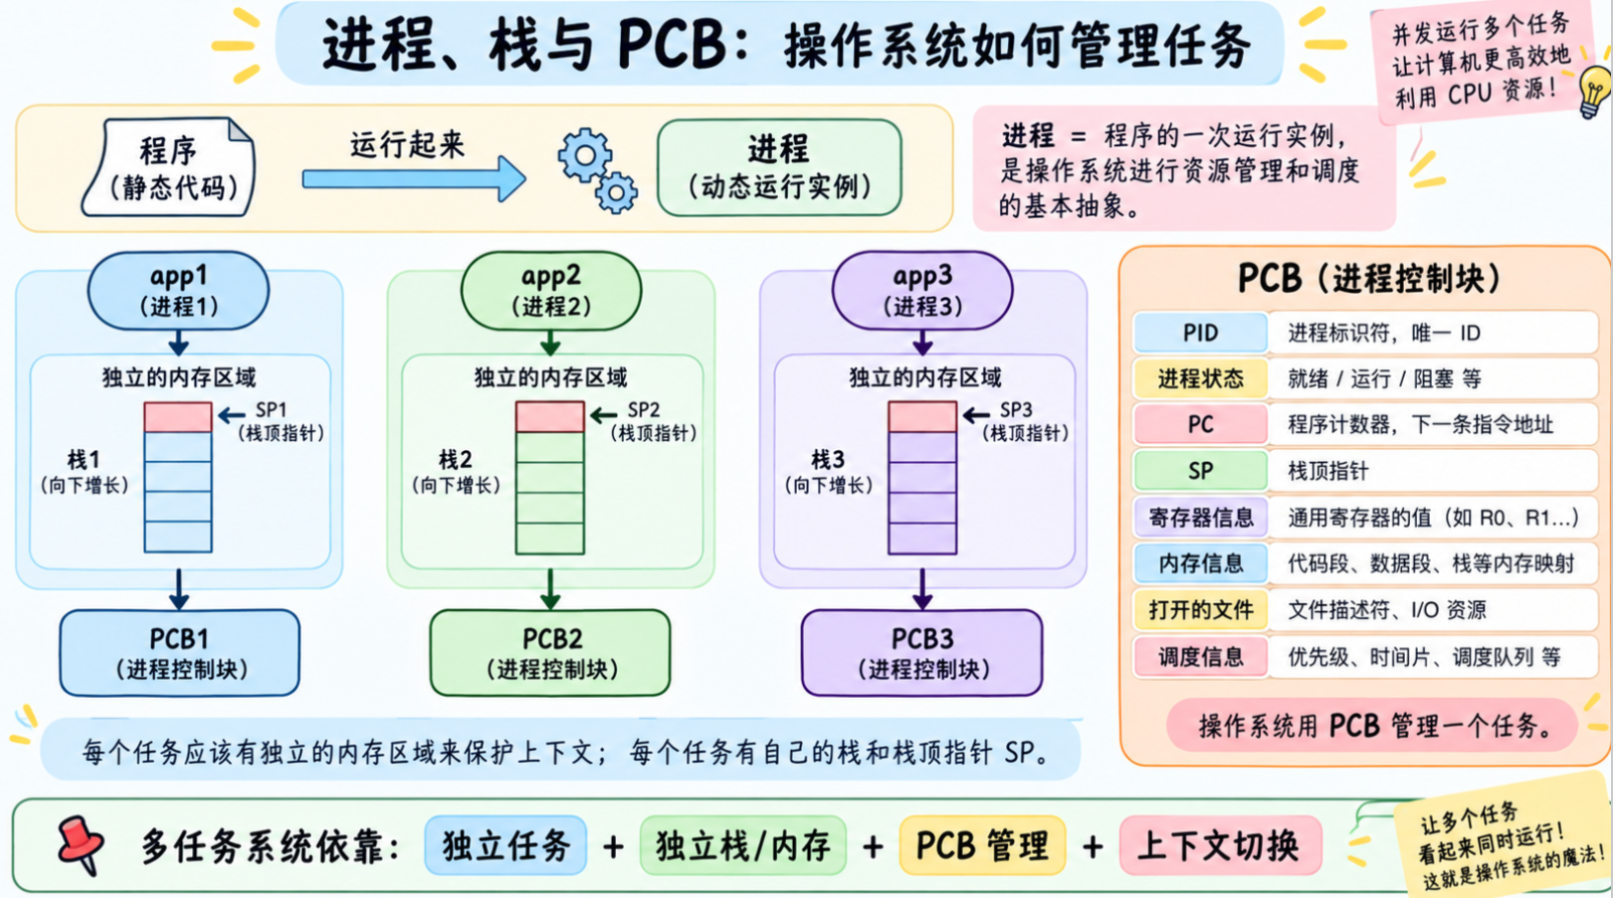
保存和恢复寄存器只是其中一部分。要真正管理多个任务,操作系统还需要知道:
- App1 现在正在运行,还是等待某个事件?
- 它之前的上下文保存在哪里?
- 它的栈和其他内存在哪里?
- 它打开了哪些文件,占用了什么资源?
- 它什么时候可以再次参与调度?
因此,任务管理包含了一整套工作:保存上下文、恢复上下文、维护任务状态,以及管理任务使用的资源。
这时,只用一个"程序文件"已经不足以描述正在运行的任务。
例如,磁盘上的 demo 可执行文件是静态的,里面保存着代码和相关数据。启动之后,它还会拥有自己的运行环境:
text
磁盘上的程序文件 demo
          ↓ 启动
一次运行实例
├── 代码和数据的内存映射
├── 栈等运行空间
├── 当前寄存器状态
├── 打开的文件
└── 当前运行状态这就引出了进程(Process)。
程序是静态的代码和数据,进程是程序的一次运行实例。操作系统通过进程组织和管理这次运行所需的资源与状态。
同一个普通命令行程序可以独立启动多次,形成多个进程。它们可以执行相同的代码,却拥有不同的进程 ID,以及各自的地址空间和执行状态。
为了便于入门,本文先按"一个进程只有一条执行流"来理解。在现代多线程系统中,进程主要承载资源,每个线程有自己的执行现场,CPU 通常调度内核可见的线程。这部分后续再展开。
栈与 SP(栈顶指针)
任务暂停以后,除了要保留 CPU 寄存器状态,还需要保留它原来的函数调用现场。其中很重要的一块内存,就是栈(Stack)。
假设 App1 正在执行一串函数调用:
text
A()
 └── B()
      └── C()
当 C() 执行完毕,程序需要知道该回到 B() 的什么位置;之后 B() 返回,也要能接着执行 A()。调用过程中的局部数据和必要的返回信息,都需要有地方保存。
栈通常就用于组织这些调用现场。概念上,可以这样理解:
text
App1 的栈                     App2 的栈
┌──────────────────┐         ┌──────────────────┐
│ App1 的函数调用现场 │         │ App2 的函数调用现场 │
│ 局部数据、返回信息等 │         │ 局部数据、返回信息等 │
└──────────────────┘         └──────────────────┘
          ↑                            ↑
         SP1                          SP2
具体哪些局部变量、参数或返回信息放在栈上,要看调用约定和编译结果;其中一些信息也可能保存在寄存器中。
但基本原则很明确:独立执行的任务通常需要各自的栈空间,不能随意破坏其他任务尚未结束的调用现场。
如果 App1 正在 C() 中执行,此时切到 App2,App2 就应该使用自己的栈。等切回 App1,再恢复它对应的栈指针,继续使用原来的调用现场。
SP(Stack Pointer,栈指针)用来指示当前栈位置,也是需要保存和恢复的上下文之一。 栈的内容通常仍留在内存中,不必在每次切换时整块复制。
系统及相应运行库在建立执行环境时,会准备好初始栈、入口位置等信息:
text
准备栈空间
    ↓
设置初始 SP
    ↓
设置程序入口和初始寄存器状态
    ↓
使任务具备运行条件
    ↓
获得 CPU 后开始执行
所以,在正常的应用开发中,程序员通常不需要手工初始化 SP,也不需要自己实现系统级的上下文切换。
这里的"自己的栈"强调的是分别维护调用现场。多线程进程中的线程虽然通常各有自己的用户栈,但它们共享进程地址空间,并不因此具有进程之间那样的内存隔离。
PCB
有了多个进程,操作系统还需要一份管理信息,记录每个进程是谁、当前状态如何,以及资源和上下文在哪里。
这就是 PCB(Process Control Block,进程控制块)。
可以把 PCB 理解成操作系统为进程维护的一份档案:
text
PCB(App1)
├── 身份信息:进程 ID(PID)等
├── 状态信息:就绪、运行、阻塞等
├── 调度信息:优先级、队列关系等
├── 内存信息:地址空间相关管理信息
├── 资源信息:打开的文件等
└── 执行上下文或其保存位置
于是,操作系统管理多个进程的关系可以概括为:
text
                 操作系统
                    │
         ┌──────────┼──────────┐
         ↓          ↓          ↓
        PCB1       PCB2       PCB3
         │          │          │
         ↓          ↓          ↓
      进程 App1  进程 App2   进程 App3
      资源与状态  资源与状态   资源与状态
假设 App1 等待磁盘数据,系统准备切换到已经就绪的 App2,可以按下面的逻辑理解:
text
App1 正在运行
      ↓
App1 因等待 I/O 而阻塞
      ↓
保存 App1 的执行现场,更新相关管理信息
      ↓
调度器选择已经就绪的 App2
      ↓
切换必要的运行环境,恢复 App2 的上下文
      ↓
CPU 继续执行 App2
等 I/O 完成,App1 会重新进入就绪状态,等待后续调度。
这里要区分三种基本状态:
| 状态 | 含义 |
|---|---|
| 运行(Running) | 正在 CPU 上执行 |
| 就绪(Ready) | 具备运行条件,正在等待 CPU |
| 阻塞/等待(Blocked / Waiting) | 等待 I/O、同步事件等,暂时不能继续执行 |
如果 App1 只是时间片用完,通常回到就绪状态;如果等待的数据还没到,则进入阻塞状态。被切走不一定意味着阻塞,被唤醒也不意味着立刻运行。
实际系统的数据结构名称和组织方式可能不同,但都需要某种机制记录并关联这些管理信息。
PCB 与上下文的关系
这两个概念很容易混在一起,可以从它们回答的问题来区分:
- 上下文:任务暂停在哪里,恢复时需要什么执行状态?
- PCB:操作系统怎样管理这个进程的身份、状态、资源和执行信息?
上下文关心恢复执行所需的现场,PCB 管理的信息范围更广。概念上可以表示为:
text
PCB 所管理的信息
├── 进程身份
├── 进程状态
├── 调度信息
├── 内存与其他资源信息
└── 关联的 CPU 上下文
    ├── PC
    ├── SP
    ├── 通用寄存器
└── 处理器状态等因此,上下文属于进程管理信息的一部分,PCB 则保存或关联这些信息。
"关联"意味着寄存器值未必全部直接放在某一个 PCB 结构体中。根据系统实现,它们可能保存在内核栈、线程控制结构或其他内存区域,再通过相应结构找到。
总结
把前面的推导串起来,就能看出这些概念之间的联系:
text
单任务系统
    ↓
任务等待 I/O 时,CPU 可能闲置
    ↓
引入多任务,让多个任务共享 CPU
    ↓
CPU 在任务之间切换
    ↓
为了继续执行,需要保存、恢复上下文
    ↓
为了管理一次运行,需要进程这一抽象
    ↓
独立执行流需要维护各自的栈和 SP
    ↓
操作系统通过 PCB 等结构管理资源、状态与上下文
    ↓
实现多个任务的调度和切换
这并不表示"只有多任务系统才有进程或栈",而是从多任务需求出发,更容易理解这些机制为什么重要。
到这里,可以先记住四句话:
- 进程是程序的一次运行实例,用来组织这次运行的资源与状态。
- 上下文是暂停后恢复执行所需的运行现场。
- 栈与 SP帮助保留并继续使用各自的函数调用现场。
- PCB是操作系统记录和关联进程管理信息的数据结构。
题外话:为什么操作系统还需要生态?(了解)
一个教学内核可以先只支持固定硬件,完成启动、简单调度、内存管理和基本 I/O。但要成为大量用户日常使用的系统,还需要适配不同的 CPU、显卡、网卡、存储设备和其他外设。
操作系统通常通过设备驱动、硬件抽象接口和统一的上层接口,把这些差异尽量集中到底层处理。
以 Android 这类平台为例,应用可以通过框架提供的接口使用摄像头、蓝牙等能力;底层再由系统服务、硬件抽象层和驱动等组件协同完成具体操作。应用不必为每一款手机重新实现一套硬件控制逻辑。
硬件支持之外,还需要开发工具、软件库、应用和兼容性保障。浏览器、办公软件、游戏以及开发者愿不愿意持续适配,也会直接影响系统是否好用。
所以,操作系统的成熟度既取决于内核能力,也取决于硬件支持和软件生态。
3. 从程序角度来看 OS
前面已经建立了操作系统与多任务的基本认识。接下来换一个程序开发的视角,简要看看这些机制如何出现在日常编程中。
3.1 操作系统面临的问题
即使只是一个输出 Hello World 的程序,也离不开几个问题:
| 问题 | 相关机制 |
|---|---|
| 源文件和可执行文件怎样保存、读取? | 文件系统 |
| 程序启动后由谁执行,多个任务怎样共享 CPU? | 进程、线程与调度 |
| 代码、数据和栈放在哪里,如何保护? | 内存管理 |
| 输出内容怎样送到终端、文件或其他目的地? | I/O 管理 |
这些问题可以归结为操作系统学习的几条主线:管理 CPU、管理内存、组织文件,以及管理 I/O。 多个任务需要协作时,还会进一步涉及同步与互斥。
至于"C 源码怎样变成 CPU 能执行的指令",主要由编译工具链完成;操作系统则负责建立和管理程序的运行环境。
3.2 编译器的作用
编译器与操作系统的关系
编译工具链通常面向特定的目标环境,生成符合目标 CPU 指令集、操作系统及 ABI 要求的程序。ABI 可以先理解为程序之间进行二进制交互时需要遵守的约定。
因此,编译得到的可执行文件不能随意复制到任意机器上运行,还要考虑架构、文件格式和运行库等条件。裸机开发也有对应工具链,但需要开发者提供相应的启动代码和运行支持。
GCC 的编译过程
常见的处理流程是:
text
源代码 → 预处理 → 编译 → 汇编 → 链接 → 可执行文件以 hello.c 为例,下面几条命令可以分别观察中间产物:
bash
# 预处理:处理头文件包含、宏等
gcc -E hello.c -o hello.i

# 编译:生成目标体系结构的汇编代码
gcc -S hello.i -o hello.s

# 汇编:生成目标文件
gcc -c hello.s -o hello.o

# 链接:组合目标文件与所需库
gcc hello.o -o hello
上面的 -E、-S、-c 控制工具链停在哪个阶段,具体定义见 GCC:Overall Options。还可以使用 file hello 查看产物类型,使用 nm hello.o 查看目标文件的符号表。
链接负责组合目标文件、处理符号和地址关系;程序启动后的地址空间管理与内存保护,则由操作系统等运行机制负责。普通 C 程序通常通过 gcc 驱动链接,以便自动补充适当的启动文件和库。
总结
这部分先记住分工即可:工具链把代码转换并组织成目标平台的程序文件,操作系统建立运行环境、分配资源,并管理它的执行。
如果这篇文章对你有帮助,欢迎点赞、评论、关注、收藏。你们的支持是我前进的动力!