专栏导语:本专栏系统讲解数学建模的经典方法与 AI 智能方法,并打通两者之间的联系。本篇作为开篇,先把数学建模的完整流程讲清楚,让你知道面对一道题该从哪里下手、每一步做什么、做完怎么检验。
文章目录
- 一、为什么要先讲流程
- 二、七步流程详解
-
- [2.1 审题:把模糊问题变成明确问题](#2.1 审题:把模糊问题变成明确问题)
- [2.2 假设:把现实简化成可处理的世界](#2.2 假设:把现实简化成可处理的世界)
- [2.3 符号:给每个量起名字](#2.3 符号:给每个量起名字)
- [2.4 建模:用数学结构描述问题](#2.4 建模:用数学结构描述问题)
- [2.5 求解:让模型给出答案](#2.5 求解:让模型给出答案)
- [2.6 验证:你的结果靠谱吗](#2.6 验证:你的结果靠谱吗)
- [2.7 论文:把思考过程写出来](#2.7 论文:把思考过程写出来)
- [2.8 AI 申明:近几年起的硬性要求](#2.8 AI 申明:近几年起的硬性要求)
- 三、流程的本质
- 个人主页 :蒲公英eric
- 专栏传送门 :《数学建模 × AI:从经典模型到智能方法》
- 学习方向:大数据 / 数学建模 / AI交叉领域
- 人生格言:建模没有终点,只有不断迭代的更优解
📌本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 1 篇文章。
一、为什么要先讲流程
很多人学数学建模的第一反应是"我要学哪些模型"------线性规划、神经网络、遗传算法......但模型只是工具箱里的锤子,真正决定建模质量的,是你怎么把一个现实问题拆成可以用锤子敲的结构。
数学建模的核心不是"会用某个模型",而是"面对一个开放问题,知道从哪里下手、每一步做什么、做完怎么检验"。这就是流程的价值。
一套标准的建模流程分为七步:
审题 ⟶ 假设 ⟶ 符号 ⟶ 模型 ⟶ 求解 ⟶ 验证 ⟶ 论文 \text{审题} \longrightarrow \text{假设} \longrightarrow \text{符号} \longrightarrow \text{模型} \longrightarrow \text{求解} \longrightarrow \text{验证} \longrightarrow \text{论文} 审题⟶假设⟶符号⟶模型⟶求解⟶验证⟶论文
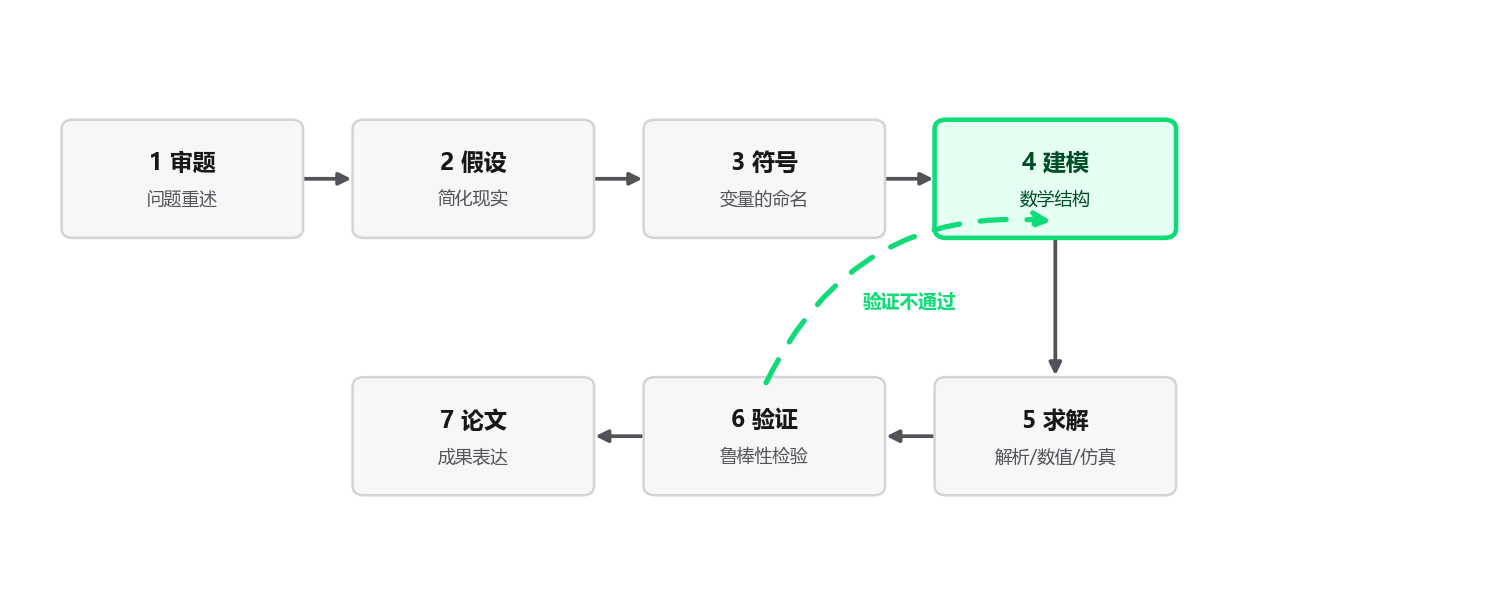
注意验证到建模之间那条虚线------建模是个迭代过程,验证不过就回到前面改假设、换模型。
下面逐步拆解,每一步都讲清楚"做什么、怎么做、常见坑"。
二、七步流程详解
2.1 审题:把模糊问题变成明确问题
赛题往往很长,里面混杂着背景、数据、要求和干扰信息。审题的目标是提炼出三个东西:
- 要解决什么问题(通常不止一个,要拆成子问题)
- 有哪些已知条件和数据
- 有哪些隐含约束(比如"不能超过多少"、"必须满足什么")
常见错误是一上来就套模型。正确做法是先把问题用自己的话重述一遍,确保你真的懂了题目在问什么。
审题还有一个容易被忽略的点:拆分子问题。一道赛题通常会问 3-4 个小问题,它们之间往往有依赖关系------比如第 2 问要用到第 1 问的结果。审题时就要理清子问题之间的逻辑链条,而不是做一个算一个。
2.2 假设:把现实简化成可处理的世界
现实太复杂,必须简化。假设就是"为了让问题可解,我先忽略哪些因素"。好的假设有两个标准:
- 合理:忽略的因素对结果影响不大,或者有文献/常识支撑
- 可追溯:每个假设都要写清楚"我做了什么假设、为什么这么假设"
假设不是越少越好,也不是越多越好,而是刚好让问题变得可解、又不失真。后面如果模型结果不好,第一个要回头检查的就是假设。
假设通常分三类:
- 简化性假设:把非线性的近似成线性的、把连续的近似成离散的
- 规范性假设:数据服从某种分布(如正态分布、泊松分布)
- 排除性假设:忽略某些次要因素(如忽略空气阻力、忽略迁移)
每一条假设都要在论文里写出来,因为假设决定了模型的适用边界------评委看到你的假设,就知道你的结果在什么范围内成立。
2.3 符号:给每个量起名字
把问题里涉及的量用数学符号表示,并列成符号说明表。这一步看似简单,但直接决定了后面推导是否清晰。符号约定的原则:
- 统一:全文同一个符号只能表示一个含义
- 简洁:优先用单字母加下标,避免冗长
- 标注单位:每个符号都要有单位(无量纲的要说明)
一个规范的符号说明表长这样(论文中用三线表格式):
| 符号 | 含义 | 单位 |
|---|---|---|
| P(t) | t 时刻的人口数量 | 人 |
| r | 自然增长率 | 1/年 |
| K | 环境容量 | 人 |
对应的 LaTeX 三线表源码(论文排版时直接用):
latex
\begin{table}[H]
\centering
\caption{符号说明}
\begin{tabular}{ccc}
\toprule[1.5pt]
符号 & 含义 & 单位 \\
\midrule
$P(t)$ & $t$ 时刻的人口数量 & 人 \\
$r$    & 自然增长率         & 1/年 \\
$K$    & 环境容量           & 人 \\
\bottomrule[1.5pt]
\end{tabular}
\end{table}
三线表只有顶线、表头线、底线三条线,没有竖线,是学术论文的标准表格格式。
不要小看这一步------如果符号混乱,后面的推导会一团糟,评委也看不懂。建议养成"先列表、再推导"的习惯。
2.4 建模:用数学结构描述问题
这是核心一步。根据问题类型选择合适的数学结构:
- 要"评价好坏" → 评价类模型(AHP、TOPSIS、熵权法)
- 要"预测未来" → 预测类模型(回归、时间序列、灰色预测)
- 要"求最优解" → 优化类模型(线性规划、整数规划、启发式算法)
- 要"分类分组" → 分类聚类模型(判别分析、聚类分析)
- 要"模拟过程" → 仿真类模型(蒙特卡洛、元胞自动机)
建模的本质是用方程、不等式、图、概率分布等数学语言,把问题中的关系写出来。
建模时要注意一个判断标准:这个模型是否抓住了问题的主要矛盾? 比如预测人口增长,核心矛盾是"资源有限导致增长减速",那就要用带环境容量的 Logistic 模型,而不是纯指数的 Malthus 模型。模型不是越复杂越好,而是越贴合问题本质越好。
2.5 求解:让模型给出答案
模型建好后是一组数学表达式,需要求解才能得到具体结果。求解方式有三类:
- 解析解:直接推导公式,得到闭式解(如 Logistic 模型的解析解)。优点是精确、可解释,缺点是不是所有模型都能求出解析解
- 数值解 :用计算机迭代求解(如
odeint、scipy.optimize)。优点是适用面广,缺点是需要初值、可能不收敛 - 仿真解:通过大量随机模拟逼近真实结果(如蒙特卡洛)。优点是能处理复杂随机性,缺点是计算量大、有误差
实际建模中,能用解析解的优先用,否则用数值解或仿真。求解后要做灵敏度分析------参数变一点,结果变多少?这决定了模型是否稳健。
求解还有一个常见坑:初值选择。数值优化方法对初值很敏感,差的初值会导致结果陷入局部最优。解决办法是多试几个初值,或者先用解析估算给一个合理初值。
2.6 验证:你的结果靠谱吗
建模不是"算出来就完事"。必须验证结果是否合理:
- 与常识/文献对比:人口预测结果不能比地球总人口还多
- 与历史数据回测:用模型预测已知的过去,看准不准
- 与其他模型对比:换个方法做,看结论是否一致
- 鲁棒性检验:扰动输入或参数,看结果是否稳定
验证不过,就要回到前面的步骤------改假设、换模型、调参数。建模是个迭代过程,不是一次性的。
验证失败时怎么排查?按这个顺序:
- 先检查数据有没有问题(读错了?清洗错了?)
- 再检查代码有没有 bug(公式写错了?循环越界了?)
- 然后检查假设合不合理
- 最后才考虑换模型
很多人一遇到结果不对就换模型,其实问题往往出在前面几步。
2.7 论文:把思考过程写出来
建模竞赛最终交的是论文,不是代码。论文要让评委看懂你怎么想的、为什么这么做、结果怎么样。本专栏统一使用以下标准结构:
摘要 → 问题重述 → 模型假设 → 符号说明 → 问题分析 → 模型建立 → 模型算法 → 模型求解 → 模型评价 → AI声明 → 参考文献 → 附录其中几个关键节的定位:
- 问题分析:在建模前独立成节,讲清问题拆解、要素抽取、为什么选这个模型
- 模型算法:单独说明求解该模型所用的算法,与"模型建立"的数学结构分开
- 模型评价:灵敏度分析、鲁棒性检验、优缺点、改进方向
- AI声明:声明是否使用 AI 辅助、用在哪些环节,符合当前竞赛规范
- 附录:完整代码、补充数据、额外图表
下面单独讲一下 AI 申明------这是 近几年起数模竞赛新增的硬性要求,必须重视。
2.8 AI 申明:近几年起的硬性要求
为什么要申明? 从近几年开始,国赛、美赛、MathorCup 等主流竞赛都明确要求参赛者声明 AI 工具的使用情况。原因很直接:大模型(GPT、Claude、Codex、DeepSeek 等)已经能帮人做审题、写代码、润色论文,如果不声明,就无法区分哪些是选手原创、哪些是 AI 生成,竞赛的公平性和学术诚信就无从谈起。
申明写什么? 一般要交代三件事:
- 用了哪些 AI 工具(如 GPT-4o、Claude 3.5等,注明版本)
- 用在哪些环节(审题思路、代码生成、数据清洗、论文润色、图表制作等)
- 哪些环节是独立完成的(核心建模思路、最终决策、论文主体写作等)
各竞赛要求差异。 目前不同比赛的松紧程度不一样:
- 有些比赛要求在论文里专门设一节"AI 申明",详细列出使用情况
- 有些比赛只要求在摘要或结尾附一句话声明
- 有些比赛禁止使用 AI 工具(或限制在特定环节)
所以赛前一定要仔细阅读当年的竞赛规则,按要求申明,不要想当然。
合理使用 AI 的边界。 AI 申明不是说"不能用 AI",而是说"用了要老实说"。合理的使用方式:
- ✅ 让 AI 帮你查资料、解释概念、生成代码框架
- ✅ 让 AI 帮你润色语言、检查公式排版
- ✅ 让 AI 帮你做数据清洗的重复性工作
- ❌ 让 AI 直接帮你决定用什么模型、得出什么结论
- ❌ 把 AI 生成的大段文字不做修改地放进论文
- ❌ 用 AI 生成整篇论文后不声明
以国赛要求的申明模板示例。 可以直接套用:
## AI工具使用声明

本参赛队在竞赛过程中使用了 AI 工具,主要用于:
背景查询与资料整理:文字描述
语言润色与表述优化:对摘要、问题分析、模型建立等部分的非数学性文字进行语法检查和学术表达润色,不涉及核心逻辑与数学推导的改写;
其他方面自己加:文字描述
详细使用情况见支撑材料。记住:AI 是工具,不是替代品。用 AI 提高效率没问题,但思路和判断必须是你自己的,而且要如实声明。
写论文的黄金法则:让一个没做过这道题的人,能照着你的论文复现出结果。图表要自明(有标题、有坐标轴、有图例),公式要编号,推导不跳步。
三、流程的本质
回头看这七步,你会发现它不只是数模竞赛的流程,而是所有"用数学方法解决现实问题"的通用流程------数据分析、机器学习、运筹优化,甚至科研,都是这套骨架的变体:
| 数模流程 | 机器学习对应 |
|---|---|
| 审题 | 问题定义 |
| 假设 | 数据分布假设 |
| 符号 | 特征工程 |
| 建模 | 选择模型 |
| 求解 | 训练 + 优化 |
| 验证 | 测试集评估 + 消融实验 |
| 论文 | 实验报告 |
这就是本专栏的底层信念:传统建模和 AI 方法不是两套东西,而是同一条河的上下游。后面讲具体模型时,我们会反复看到这种对应关系。
📌 本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 1 篇文章。
- 下一篇预告 :将进入 近年数学建模出题趋势:数模在往哪走
👉 点击订阅专栏,第一时间收到更新通知!
如果你在阅读过程中有任何疑问,欢迎在评论区留言交流。😊