目录
[一、传统 CNN 的两大痛点](#一、传统 CNN 的两大痛点)
[二、ResNet 核心思想:残差连接](#二、ResNet 核心思想:残差连接)
[三、ResNet 整体架构](#三、ResNet 整体架构)
[BasicBlock 简易代码实现](#BasicBlock 简易代码实现)
[1. 什么是迁移学习](#1. 什么是迁移学习)
[2. 迁移学习步骤](#2. 迁移学习步骤)
[案例 1:加载预训练 ResNet18,单图推理](#案例 1:加载预训练 ResNet18,单图推理)
[案例 2:迁移学习,修改最后一层,训练自己的数据集(重点)](#案例 2:迁移学习,修改最后一层,训练自己的数据集(重点))
前言
随着卷积神经网络不断加深,单纯堆叠卷积层之后,模型效果不升反降。深层网络不仅会遇到梯度消失 / 梯度爆炸,还会出现网络退化。ResNet(残差网络)在 2015 年由何恺明等人提出,凭借残差 shortcut 结构,一举拿下 ImageNet 多项竞赛冠军;同时 ResNet 强大的预训练权重,也成为迁移学习最常用的骨干网络。
一、传统 CNN 的两大痛点
普通 CNN(例如 VGG)串行堆叠卷积、BN、激活、池化层,层数加深后出现两个核心问题:
- 梯度消失 / 梯度爆炸
反向传播梯度是多层导数连乘。每层导数小于 1,网络越深梯度趋近于 0,深层参数无法更新,就是梯度消失;每层导数大于 1,梯度会不断放大,造成梯度爆炸。BN、权重初始化可以缓解梯度爆炸,但很难解决深层网络退化。 - 网络退化( Degradation ) 退化不等于过拟合。现象:更深网络的训练集误差,反而高于浅层网络。普通 CNN 每一层都必须做卷积变换,很难学习恒等映射;当网络很深时,后面部分层不需要修改特征,但串行结构无法跳过变换,误差不断累积,效果变差。
二、ResNet 核心思想:残差连接
普通 CNN 直接学习完整映射 y=H(x)  ;残差网络学习残差 F(x)=H(x)-x
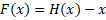 ,最终输出:
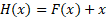
- F(x):主分支卷积学习到的残差;
- x:shortcut 直接传递过来的原始输入特征;
- 代码层面核心就是 Y += X。
为什么残差能解决退化
想要模块实现恒等映射 ,残差结构只需要让
 ,这比普通 CNN 学习恒等映射简单很多。网络可以自主选择:部分块学习特征变换,不需要的块近似恒等,直接保留原有特征。
梯度求导: ,梯度有 shortcut 这条通路,保底有常数 1,缓解梯度消失。
|-----------------------------------------|
| 残差连接不能解决梯度爆炸,梯度爆炸依靠 BN、初始化、ReLU 控制。 |
三、ResNet 整体架构
整体流水线:Stem 初始层 → 4 组残差层(layer1~layer4) → 全局平均池化 → 全连接分类头
- Stem:7×7 卷积 + BN + ReLU + 3×3 最大池化,快速下采样,提取底层纹理。
- 残差层
- ResNet18/34:BasicBlock,两层 3×3 卷积。顺序:Conv3×3→BN→ReLU→Conv3×3→BN,相加后再 ReLU。
- ResNet50 及以上:Bottleneck ,1×1 降维 → 3×3 → 1×1 升维,减少计算量。
- 每组第一个残差块做下采样,特征图尺寸减半、通道翻倍;此时 shortcut 用 1×1 卷积对齐维度。
- 分类头:全局平均池化 GAP,压缩特征,再接全连接输出类别,相比 VGG 大幅减少参数量。
|----------------------------------------------------------------------------------|
| ResNet18 命名:Stem 1 个卷积,8 个 BasicBlock(每个 block 2 卷积),共 17 卷积,加上最后的 FC 层,合计 18 层。 |
BasicBlock 简易代码实现
python
import torch
import torch.nn as nn
#ResNet18使用的BasicBlock
class BasicBlock(nn.Module):
def init(self, in_channels, out_channels, stride=1):
super().init()
self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, padding=1)
self.bn1 = nn.BatchNorm2d(out_channels)
self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, stride=1, padding=1)
self.bn2 = nn.BatchNorm2d(out_channels)
    # shortcut维度对齐,下采样时使用
    self.shortcut = nn.Sequential()
    if stride != 1 or in_channels != out_channels:
        self.shortcut = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride),
            nn.BatchNorm2d(out_channels)
        )

def forward(self, x):
    out = torch.relu(self.bn1(self.conv1(x)))
    out = self.bn2(self.conv2(out))
    # 残差相加
    out += self.shortcut(x)
    out = torch.relu(out)
    return out
#测试残差块
block = BasicBlock(64, 128, stride=2)
x = torch.randn(1, 64, 56, 56)
y = block(x)
print(y.shape)  # torch.Size([1, 128, 28, 28])
四、迁移学习
1. 什么是迁移学习
使用 ImageNet 上预训练好的模型,在自己的小数据集上微调训练。优势:训练更快,小样本任务效果好,复用模型学到的边缘、轮廓等通用视觉特征。
|-------------------------------------------------------|
| 残差解决深层网络能不能训练;迁移学习解决数据少怎么训练,二者相互独立。ResNet 是迁移学习最热门骨干。 |
2. 迁移学习步骤
- 选择预训练 ResNet;
- 冻结骨干,只训练新分类头,防止小数据集破坏预训练特征;
- 训练新增全连接层;
- 分类头收敛后,解冻部分骨干层,用更小学习率微调;
- 在测试集评估模型。
案例 1:加载预训练 ResNet18,单图推理
我们先直接加载 ImageNet 预训练好的 ResNet18,对一张图片做分类推理,看看模型原生能力。
|--------------------------------------|
| 注意:必须使用和预训练时完全一致的图像预处理(归一化参数不能改) |
python
import torch
from torchvision import models, transforms
from PIL import Image
#自动选择GPU/CPU设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
#加载在ImageNet1K上预训练好的ResNet18
model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
model = model.to(device)
model.eval()  # 设置为推理模式,关闭dropout、BN的训练行为
#图像预处理流水线(预训练模型固定参数,不可随意修改)
preprocess = transforms.Compose([
transforms.Resize(256),
transforms.CenterCrop(224),
transforms.ToTensor(),
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225])
])
#读取图片并预处理
img = Image.open("test.jpg").convert("RGB")
img_tensor = preprocess(img).unsqueeze(0)  # 增加batch维度 → [1,3,224,224]
img_tensor = img_tensor.to(device)
#推理,关闭梯度计算,节省显存
with torch.no_grad():
output = model(img_tensor)  # 输出shape [1,1000],对应ImageNet的1000个类别
pred = torch.argmax(output, dim=1)
print("预测类别id:", pred.item())
案例 2:迁移学习,修改最后一层,训练自己的数据集(重点)
原生 ResNet18 最后一层 fc 是Linear(512,1000),用来预测 ImageNet 的 1000 个类别。
如果我们要做自己的分类任务(二分类、十分类等),只需要替换最后的全连接分类头,搭配冻结 / 微调策略训练。
python
import torch
import torch.nn as nn
from torchvision import models
#自动选择GPU/CPU设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
#加载ImageNet预训练权重
model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
========= 两种训练方案二选一 =========
#方案A:冻结全部骨干卷积层,只训练最后全连接(小数据集推荐,防止过拟合)
for param in model.parameters():
param.requires_grad = False
#方案B:全部参数参与训练,全局微调(大数据集时使用)
#替换分类头,适配自己任务的类别数
num_classes = 2  # 修改为你的任务类别数量,例如2代表二分类
in_features = model.fc.in_features
model.fc = nn.Linear(in_features, num_classes)
model = model.to(device)
#定义损失函数与优化器
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=1e-3, momentum=0.9)
五、总结
- 传统深层 CNN 存在梯度消失 / 爆炸、网络退化;ResNet 通过 shortcut 残差连接学习残差映射,解决退化,缓解梯度消失。
- BasicBlock 是 ResNet18 基础单元,Bottleneck 用于深层网络;下采样场景 shortcut 需要 1×1 卷积对齐维度。
- 迁移学习复用预训练 ResNet,分为冻结骨干、微调两个阶段。先可以直接加载预训练模型做推理,再替换分类头,在自己数据集上训练。