技术解读:一套通用腹部CT诊断AI的视觉语言架构,如何用「报告即标注」替代人工病灶勾画
核心要点
- 问题:腹部增强CT涉及数十个器官、数百种潜在病变,传统"一病一模"的医学影像AI依赖大量人工标注,成本高、通用性差,难以满足多病种真实临床需求。
- 方法:浙江大学医学院附属第一医院梁廷波团队联合阿里达摩院,构建视觉语言通用模型 RADAR,用约42.5万例增强CT检查与诊断报告对齐训练,全程无需人工病灶标注。
- 结果:覆盖18个解剖结构、146种影像发现;内部近4万例检查AUC达0.913,8个外部中心0.874--0.912;未参与训练的急腹症场景AUC仍达0.904。
- 意义:辅助26名放射科医生诊断敏感度提升10%、阅片耗时减少30.7%,为复杂放射诊断的通用型AI提供了可落地的技术路线。
- 原文:An expert-level generalist AI for abdominal CT diagnosis,Science,2026-09-17
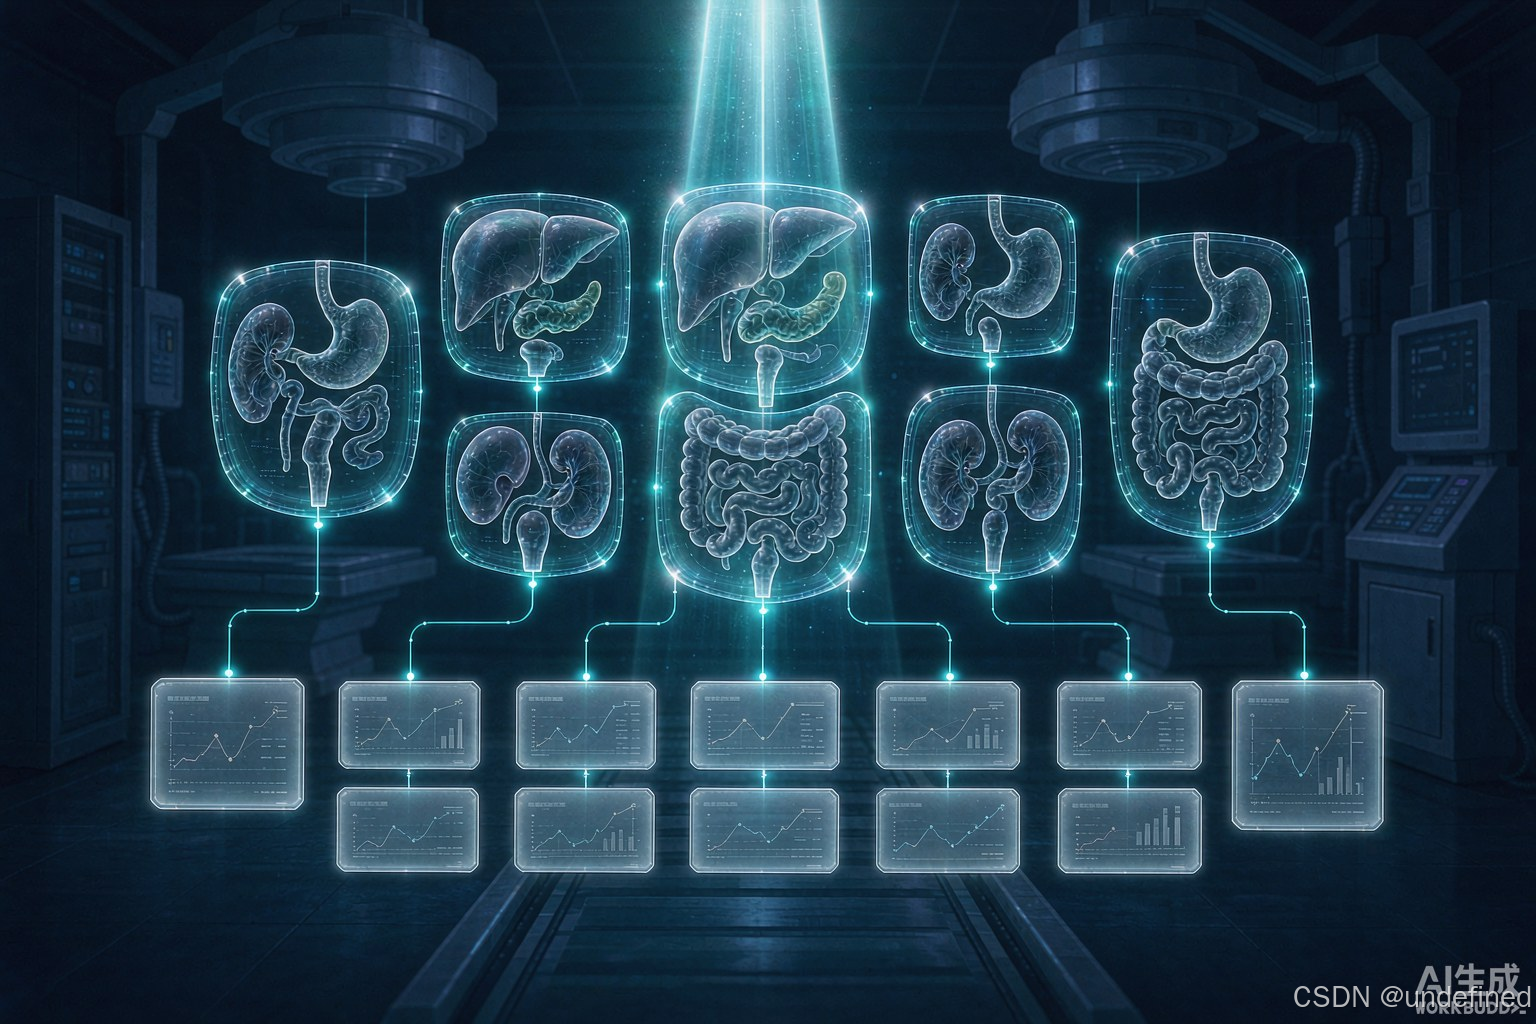
腹部增强CT是临床最复杂的影像诊断场景之一。一张增强CT里塞着肝脏、胰腺、肾脏、胃肠道等数十个器官,潜在异常与病变多达数百种,放射科医生要在一套几百甚至上千张图像里,找出病灶那些稀疏的异常信号。这让"医学影像AI诊断"在这里长期卡壳。
过去的主流路线是"一病一模":肺结节、胰腺癌、糖尿病视网膜病变各训练一个专用模型。这类模型在单一病种上表现不错,但训练依赖医生逐张勾画病灶,标注成本高、研发周期长;更重要的是,标注过的病才认得出,遇到没见过的新场景立刻抓瞎,难以"举一反三"。要覆盖真实临床里海量、多变的病变,专用模型的路线越走越吃力。基层与低年资医生面对复杂腹部影像时尤感吃力,一套能"广覆盖、可导航"的通用辅助诊断工具,正是临床的迫切需求。
2. RADAR的核心创新:不标病灶,直接读报告
研究由浙江大学医学院附属第一医院梁廷波团队与阿里巴巴达摩院合作完成,2026年9月17日在线发表于 Science。模型名为 RADAR,创新集中在三点。
第一,放弃人工标注,改用临床报告作监督信号。团队直接让模型学习海量CT影像与诊断报告之间的配对关联,用医院在诊疗过程中本来就写好的结构化报告当"老师",绕开了逐病灶勾画的高昂成本。这与达摩院此前在肝脏恶性肿瘤上的单病种模型 LiON形成了鲜明对比------一个向深处扎,一个向广处铺。
第二,器官级细粒度对齐。CT信号稀疏,直接做"整卷CT对整份报告"只能学到粗浅关联。团队把三维CT体数据拆解为18个解剖单元,在器官层面让影像块与报告里对应的诊断语句精确对齐,再通过自适应对比建模动态调整。
第三,提示词驱动的通用推理。推理时无需针对任务重新微调,靠正负提示计算相似度即可输出诊断,还附带注意力热力图,指出关键诊断线索,增强可解释性。这种"一个模型、多种任务、按提示调用"的范式,与神经影像大模型评测揭示的"开放式诊断仍是短板"形成对照,也说明通用模型的价值在于广度覆盖而非单项极限精度。
3. 技术原理:把腹部拆成解剖单元,逐个与报告对齐
RADAR是一条视觉语言模型,训练链路可概括为"拆解器官 → 图文对齐 → 对比学习 → 提示推理"。输入是增强腹部CT体积数据,模型先把肝、胰、胃、小肠、肾等解剖结构切分出来;同一受检者的CT图像块和报告里对应诊断语句被拉近,不同患者的图文表示被推开,从而学会"哪些影像表现对应哪些疾病"。
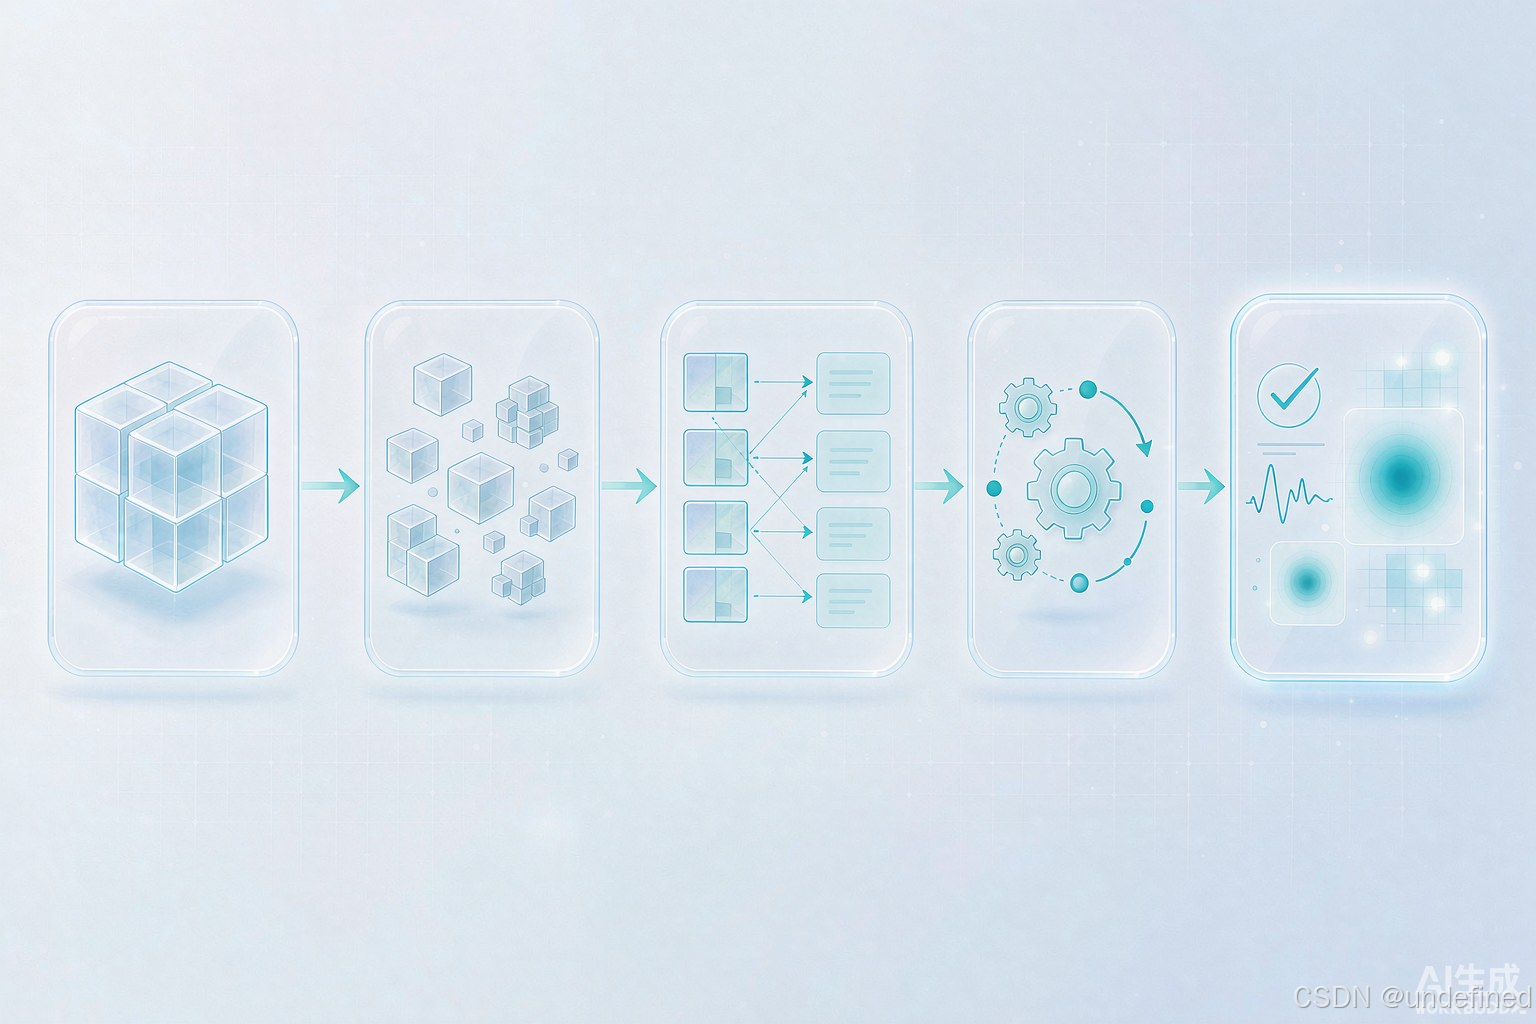
这套机制的关键在于用现成报告替代人工标签:医院每天都在产出"影像---报告"配对,模型从这些配对里自动挖掘诊断知识,既降低了标注成本,也让疾病覆盖范围能随数据自然扩展。需要强调,这是研究原型模型,论文评估的是其诊断能力,而非一个已完成注册、可投入临床的获批产品。
4. 数据说话:146种发现达专家级,急腹症零样本不塌
论文的核心结果可归纳为几组对比。
| 研究维度 | 比较对象 | 核心结果 |
|---|---|---|
| 内部验证(146种发现) | RADAR vs 次优fVLM | AUC 0.913 vs 0.776(高0.137,P<0.001) |
| 外部8中心泛化 | RADAR | AUC 0.874--0.912(平均0.895) |
| 病理确诊4种癌症 | 肝/胰/胃/结直肠 | AUC 0.891--0.984 |
| 急腹症(未训练场景) | RADAR零样本 | AUC 0.904 |
| 人机协作(26名医生) | AI辅助前后 | 敏感度+10.0%(P<0.001),阅片省时30.7% |
内部验证基于39,160次连续检查,95%置信区间0.911--0.915,显著高于监督学习基线(如ViT、nnUNet+),且在低频发现上的优势更明显。读者研究纳入14个中心26名放射科医生、300例61个发现:无辅助时医生特异性98.8%,AI辅助后敏感性提升10个百分点、特异性98.2%。需要强调,这是回顾性研究,读者研究在受控读片条件下进行,未测量患者结局,"专家级"是作者基于基准对比的表述,尚不等于临床获批。
5. 从实验室到临床:应用前景与局限
这项研究为"医学影像AI诊断"指出了一条可落地的新路:与其花巨资标注有限的病种,不如用海量"报告---影像"配对训练通用模型。可能的应用场景包括:作为阅片"导航"辅助医生快速发现易漏诊的异常、让低年资医生达到高年资水平、以及在急诊等资源紧张场景提供初步筛查。但至少有三条局限必须正视。
其一,这是回顾性验证,未经过前瞻性随机对照试验,也无患者结局数据,"提升敏感度"不等于改善患者预后。其二,读者研究在受控条件下进行,真实临床会参考主诉、病史、检验等其他信息,模型目前只吃影像与报告,信息来源单一。其三,模型开源尚处早期,跨机构部署的数据治理、版本管理与持续监控仍需补齐;外部8中心AUC虽达0.874--0.912,但不同扫描仪、不同人群之间仍有波动,需要更长期的随访证据。
6. 结论与产业启示
这项研究给出一个清晰信号:通用医学影像AI不再依赖昂贵的病灶标注,也能在复杂腹部CT上逼近专家水平------用一个模型覆盖146种发现,并在未见过的急腹症场景保持0.904的AUC。
对医疗AI产业有三点可执行建议:一是把"报告即标注"纳入训练路线,降低影像AI的标注门槛与研发成本;二是把通用模型定位为"辅助导航"而非替代医生,用注意力热力图和敏感性提升来验证人机协同价值;三是正视回顾性证据的边界,落地前补齐前瞻验证、外部多中心测试与持续监控。归根结底,要获得可靠的"医疗AI解决方案",仍须以严格的临床验证为前提,而非只看基准分数的高低。
相关问题
Q:RADAR现在能直接替代放射科医生读片吗?
A:不能。它是一项回顾性研究,未经过前瞻性随机对照试验,也非获批产品。论文的价值在于证明通用模型可逼近专家水平,并能在AI辅助下提升医生敏感度;最终诊断与治疗责任仍由医生承担。
Q:它识别的是模型本身,还是一个完整可用的临床产品?
A:是研究原型模型。论文评估的是其影像诊断能力,尚未经历产品化、注册审批与临床部署。从"模型准"到"产品可安全落地",中间还隔着工程集成、数据治理与临床验证。
Q:这种"报告即标注"的训练方式对中国医疗环境有意义吗?
A:有较大参考价值。中国医院同样面临标注成本高、病种覆盖难的问题,用现成的结构化报告训练通用模型,方向契合;但其结论基于回顾性数据,迁移到国内仍需做本地病种覆盖、数据治理与前瞻验证。
参考文献
- Zhang Q, Zhang J, Cao W, Lu Z, et al. An expert-level generalist AI for abdominal CT diagnosis . Science. 2026;393(6817). DOI: 10.1126/science.aec6129
- Moor M, Banerjee O, Abad ZSH, et al. Foundation models for generalist medical artificial intelligence . Nature. 2023;616:259--265. DOI: 10.1038/s41586-023-05881-4
- Rajpurkar P, Chen E, Banerjee O, Topol E J. AI in health and medicine . Nature Medicine. 2022;28:31--38. DOI: 10.1038/s41591-021-01614-0
本文基于 An expert-level generalist AI for abdominal CT diagnosis 的独立解读,仅供学术交流,不构成临床建议。
工程实现要点
- 视觉语言学习:直接对齐 CT 影像与诊断报告,摆脱逐病灶人工标注
- 器官级细粒度对齐:把三维 CT 拆成 18 个解剖单元,影像块与报告语句逐器官对齐
- 自适应对比建模:正负提示计算相似度,推理阶段无需针对任务重新微调
- 通用覆盖:单模型覆盖 18 器官、146 种影像发现,急腹症零样本 AUC 0.904
- 可解释输出:附带注意力热力图,标注关键诊断线索