Segment Anything(SAM)总结
来源:Meta AI Research, FAIR(Alexander Kirillov 项目负责、Eric Mintun / Nikhila Ravi 共同一作、Piotr Dollár 与 Ross Girshick 方向负责)
原文:
论文原文/SAM.md(含正文 §1--§8 与附录 A--G)项目地址:https://segment-anything.com | 代码与数据以 Apache 2.0 开源
生成方式:按
paper-summaryskill 的五大模块框架生成;图片引用路径相对本文件换算为../论文原文/images/模块说明 :本文没有编号公式 (损失与训练目标均在附录 §A 用文字描述),按 skill 规则省略「重要公式分析」一节,不保留空标题。相关内容并入「流程解析」的步骤 4 与步骤 5。
前言:
Segment Anything(SAM)研究的是能否为图像分割造一个基础模型(foundation model)。
研究背景与动机 :语言领域已经证明,在海量数据上预训练 + 提示工程(prompt engineering)可以让一个模型零样本(zero-shot)迁移到新任务;CLIP 进一步说明"提示"这一接口在视觉上同样成立。但这套范式在分割上一直没能复制。
当前现状 :视觉基础模型的进展几乎都集中在图文对齐 (CLIP、ALIGN),分割领域则由各任务各自的专用模型主导------交互式分割(RITM、FocalClick)、边缘检测、目标提议、语义/实例/全景分割各有一套模型与标注协议。以 CLIP 式的思路做分割,会立刻撞上一个硬约束:互联网上不存在"网页规模的掩码数据",掩码不像文本与图文对那样天然可获得。
本文旨在解决的问题:现状中有三个相互纠缠的 gap:
- 任务层面 :现有分割任务都是固定任务的------多任务系统虽然一个模型做多件事,但训练任务与测试任务相同,无法在推理时应对设计时没见过的任务。
- 模型层面 :交互式分割模型为人操作设计,追求"多点击之后的高 IoU";缺少一个能在实时、任意提示下都返回合理掩码的通用模型。
- 数据层面:没有 web-scale 的掩码数据源,也没有可复制的数据生产方式------这正是前两个问题无法解决的根本原因。
SAM 的答案是任务、模型、数据三位一体 :定义可提示分割任务(promptable segmentation),配套"重型图像编码器 + 轻量提示编码器 + 轻量掩码解码器"的模型,再用一个数据引擎(data engine)让模型与标注互相促进,最终产出 SA-1B:11M 图像、1.1B 掩码的数据集。结果是在 23 个数据集的零样本单点评估中在 16 个上超过最强交互式分割器 RITM(最大差距约 47 IoU),并零样本迁移到边缘检测、目标提议、实例分割与文生掩码。
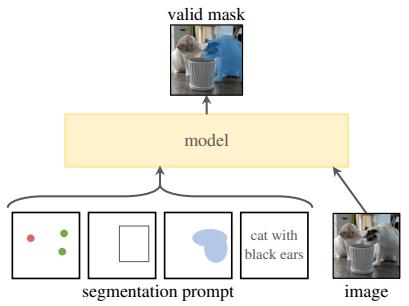
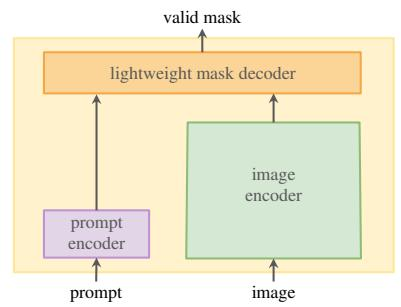
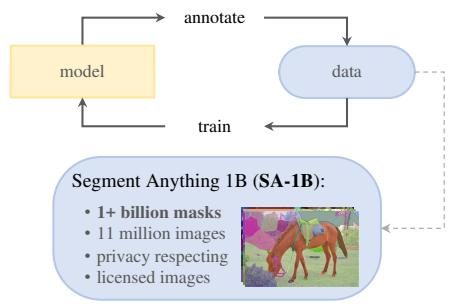
Figure 1. SA 项目的三个互连组件:可提示分割任务、由该任务驱动的分割模型 SAM(既支撑数据标注,也能通过提示工程零样本迁移到多种任务)、以及用于采集 SA-1B(超 10 亿掩码)的数据引擎。
流程图分析:
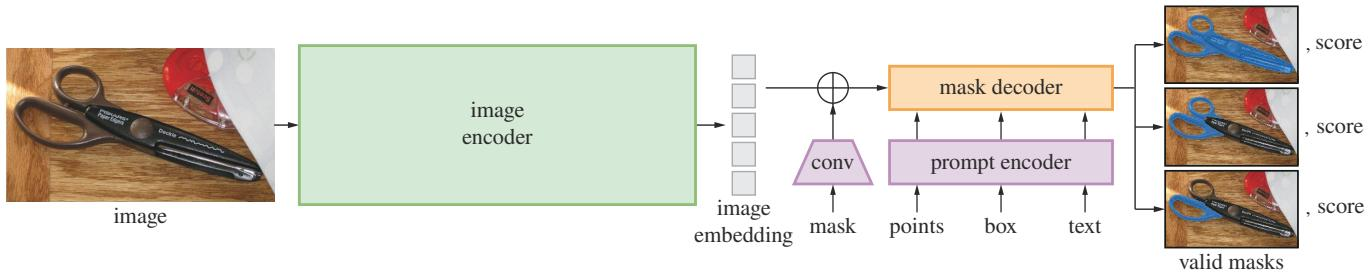
Figure 4. SAM 总览。重型图像编码器输出图像嵌入,之后可以被多种输入提示高效查询,以摊薄后的实时速度产出物体掩码;对对应多个物体的歧义提示,SAM 可输出多个有效掩码及各自的置信度分数。
整条流水线可以拆成 3 块来理解:
- 任务块(§2) :把 NLP 的"提示"概念搬到分割上------提示可以是前景/背景点、粗略框或掩码、自由文本,任何"指明要分割什么"的信息。核心要求是输出必须是"有效掩码":即使提示有歧义(比如点在衬衫上,可能指衬衫也可能指穿衬衫的人),也要给出至少其中一个物体的合理掩码。
- 模型块(§3):图像编码器(MAE 预训练的 ViT-H,1024×1024 输入)、提示编码器(稀疏提示:点/框/文本;稠密提示:掩码)、轻量掩码解码器(2 层 Transformer 解码器 + 动态掩码预测头)。
- 数据块(§4--§5) :数据引擎三阶段------辅助人工(assisted-manual)→ 半自动(semi-automatic)→ 全自动(fully automatic),模型与数据交替迭代,最后对 11M 图像全自动生成 1.1B 掩码。
关键姿态:图像编码器每张图只跑一次 ,其开销可被后续所有提示"摊薄";提示编码器与掩码解码器在单 CPU 上约 50ms 即可出掩码,可在浏览器内实时交互。正因如此,解码器可以承担大量迭代(训练时每样本 11 轮),而总开销仍可接受------这是它区别于所有前作的结构性优势。
各模块功能对应总结:
| 模块 | 作用 | 是否可训练 |
|---|---|---|
| ① 图像编码器 | MAE 预训练 ViT-H/16,1024×1024 输入 → 64×64、256 通道图像嵌入;14×14 窗口注意力 + 4 个等距全局注意力块 | 是(但每图只前向一次) |
| ② 提示编码器(稀疏) | 点 = 位置编码 + 前景/背景学习嵌入;框 = 左上/右下角位置编码 + 对应学习嵌入;文本 = CLIP 文本编码器 | 是 |
| ③ 提示编码器(稠密) | 掩码提示经两级 2×2 步长卷积降到 1/4 分辨率,再与图像嵌入逐元素相加 | 是 |
| ④ 掩码解码器 | 2 层修改版 Transformer 解码器:token 自注意力 → token 到图像的交叉注意力 → MLP → 图像到 token 的交叉注意力;输出经 3 层 MLP 产生动态线性分类器 | 是(主要计算集中于此) |
| ⑤ 歧义感知头 | 单提示输出 3 个掩码(whole / part / subpart)+ IoU 预测头用于排序;多提示时只输出 1 个掩码 | 是 |
| ⑥ 数据引擎与 SA-1B | 三阶段人机协同标注,全自动阶段用 32×32 点网格 + 20 个放大裁剪生成掩码,经 IoU/稳定性过滤与 NMS 去重 | 否(数据生产流程) |
流程解析:
步骤 1:把"提示"定义为分割任务的接口(任务先于模型)
SAM 不从架构出发,而从任务出发。可提示分割任务要求"任意提示 → 有效掩码",并给出了天然可扩展的预训练算法 :对每个训练样本模拟一串提示(点、框、掩码),把预测掩码与真值比较。这一步与经典交互式分割的关键区别在于------交互式分割假设"用户点多几下最终能得到正确掩码",SAM 要求即使提示有歧义,也必须返回某个物体的合理掩码。这个要求直接决定了后面要造"歧义感知"的多输出结构。
步骤 2:用重型编码器 + 轻量解码器做成本解耦
模型设计几乎全部服务于效率:
- 图像编码器用 MAE 预训练的 ViT-H/16,输入 1024×1024(缩放 + 短边填充),经 1×1 与 3×3 卷积把通道压到 256,输出 64×64 的图像嵌入;
- 提示编码器采用位置编码 + 类型学习嵌入的加和,文本提示复用 CLIP 文本编码器;
- 掩码解码器只有 2 层,且交叉注意力中把 q/k/v 通道降为 128 以省算力。
这一分工带来一个反直觉的结论:图像编码器可以很贵,因为它每图只算一次;解码器必须极轻,因为它每次提示都要算。
步骤 3:用多掩码输出解决"歧义"(本文最巧妙的设计)
单个提示对应多个有效物体时,只输出一个掩码的模型会把多个物体平均起来 ,得到一个四不像的结果。SAM 的做法是让模型同时预测 3 个掩码(依据是嵌套掩码通常最多三层:整体 / 部件 / 子部件),并:
- 训练时只回传损失最小的那个掩码的梯度(multiple choice learning 的经典技巧);
- 额外用一个头预测每个掩码的 IoU 置信度用于排序;
- 当输入多于一个提示时只输出 1 个掩码------因为此时歧义基本消失,这样也避免退化损失、保证无歧义样本仍能得到规则的梯度信号。
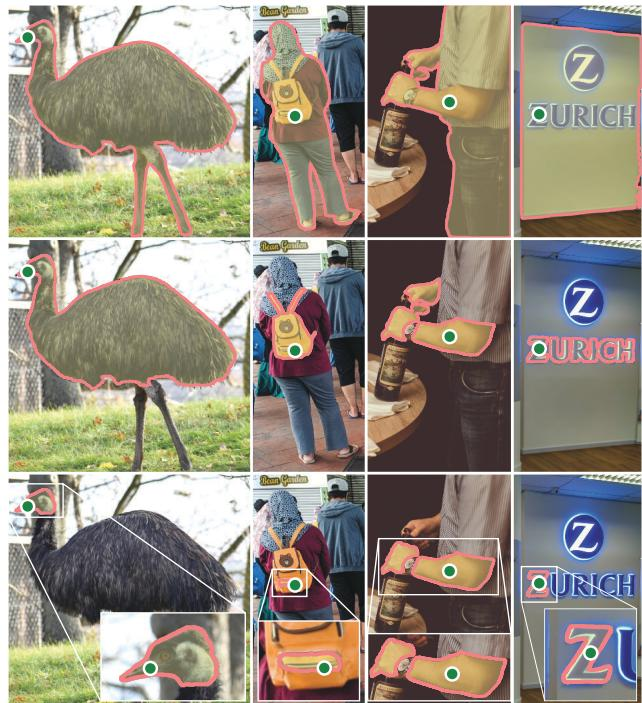
Figure 3. 每一列展示 SAM 由同一个有歧义的点提示(绿圈)生成的 3 个有效掩码。
步骤 4:构造 11 轮迭代的"模拟交互"训练回合
训练时模拟交互式分割流程:
- 首轮以等概率随机取一个前景点或一个框;框由真值掩码外接框加噪(各坐标标准差为框边长的 10%,上限 20 像素),以兼顾"紧框"(实例分割)与"松框"(用户手绘)两种场景;
- 之后每轮从上一轮预测与真值的误差区域 中采点,误差是漏检就取前景点、是误检就取背景点,并把上一轮的未阈值化掩码 logits(而非二值掩码)作为额外提示回灌;
- 共 11 轮 = 1 个初始提示 + 8 个迭代采样点 + 2 个不提供新信息的自我修正轮(一轮随机插入,一轮固定在末尾)。
损失为 focal loss 与 dice loss 的 20:1 线性组合,IoU 头用 MSE 且以权重 1.0 并入掩码损失;作者特别指出逐层辅助深监督对此任务无帮助。
步骤 5:数据引擎三阶段,让模型与数据互相抬升(对应 §4--§5)
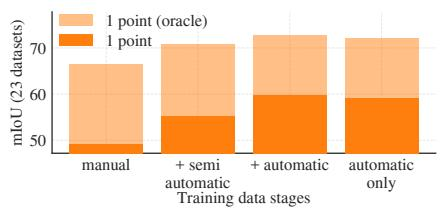
Figure 13(左). 三个数据引擎阶段的累加训练消融。每个阶段都带来提升;训练时对人工与半自动掩码过采样 10× 效果最好,但仅用自动掩码的性能只低约 0.5 mIoU------因此默认只用自动掩码,以简化训练。
- 阶段一(辅助人工) :专业标注员用 SAM 驱动的浏览器工具点击前景/背景点,配画笔与橡皮精修;不施加语义约束 ,不收集物体名称。平均标注时间从 34 秒降到 14 秒 (比 COCO 快 6.5 倍),每图掩码数从 20 升到 44;累计 120k 图像 / 4.3M 掩码 。图像编码器从 ViT-B 扩到 ViT-H,模型共重训 6 次。
- 阶段二(半自动) :先用阶段一掩码训一个通用"object"类别检测器,自动找出置信掩码预先填入图像,标注员只补标遗漏物体,以此提升掩码多样性 。新增 180k 图像 / 5.9M 掩码(累计 10.2M),重训 5 次。
- 阶段三(全自动) :用 32×32 前景点网格 + 20 个放大裁剪(2×2 与 4×4 部分重叠窗口,配 16×16 与 8×8 点网格)批量生成,再用三重过滤保质量------预测 IoU > 88.0 、稳定性(在 ±1 阈值下掩码 IoU ≥ 95.0 )、剔除覆盖 ≥95% 图像的掩码;NMS 阈值 0.7 去重。最后去掉面积 <100 像素的连通分量与 <100 像素的孔洞。1.1B 掩码中 99.1% 由此阶段全自动产生。
创新点分析:
1. 提出"可提示分割"这一新任务(核心贡献)
本文最本质的创新是一个任务定义 :给定任意分割提示,返回有效掩码。它同时充当预训练目标(把分割统一成"提示 → 掩码")、零样本迁移手段(下游任务通过提示工程实现),以及组合接口 (SAM 可作为更大系统中的一个组件)。vs 多任务分割系统:后者训练与测试任务相同、任务集合固定;SAM 的定位是"在推理时作为组件去完成一个训练时没见过的任务"。
2. 成本解耦的三件套架构
重型图像编码器 + 轻量提示编码器与掩码解码器的分工,使同一图像嵌入可被任意多个提示复用,单 CPU 约 50ms 出掩码。这让交互式标注真正可用(浏览器内实时),也让训练时的 11 轮迭代在算力上可承受。vs 此前交互式分割方法:那些方法每次优化器更新只能做 1 次或少数几次交互步骤,迭代成本高。
3. 歧义感知的多掩码输出 + IoU 排序
3 个掩码输出、"只回传最小损失的梯度"、"多提示时退化为单掩码"、"IoU 头用于排序"这一组设计,把"提示本质上可能指多个物体"这一被前作忽略的现实,变成了模型的一等公民。消融上也能看到收益:去掉歧义感知(单输出)的 SAM 在目标提议所有 AR 指标上显著更差,人工评分也一致更低。
4. 数据引擎:模型与数据的共演化范式
在"掩码无法从网上抓取"的约束下,本文给出了可复制的替代方案------用模型加速标注、再用标注反过来训更强的模型 ,三阶段把标注从"人工主导"推向"半自动"再到"全自动",标注时间从 34 秒降至 14 秒。最终 SA-1B 的掩码数是此前最大分割数据集 Open Images 的 400 倍 ,平均每图掩码数是它的 36 倍。作者也验证了纯自动掩码几乎等价于全量数据(低约 0.5 mIoU),这让"全自动产数据"这条路站住了。
5. 零样本迁移的系统验证 + 负责任 AI 分析
在 23 个来源各异的(水下、内窥、X 光、绘画、航拍等)数据集上做单点提示评估,并用人类评分补充 mIoU------因为"单点分割"本身是 ill-posed 的,自动指标会低估模型。此外本文专门做了 RAI 分析(地域与收入分布、跨感知性别/年龄/肤色肤的公平性),这在此前的分割论文中并不常见。
论文总结:
贡献回顾
- 任务:提出可提示分割任务,为分割提供了可预训练、可零样本迁移、可组合的任务接口。
- 模型:给出 SAM------重型图像编码器 + 轻量提示编码器 + 轻量掩码解码器,具备歧义感知与实时提示能力。
- 数据:设计数据引擎三阶段流程,产出 SA-1B(11M 图像 / 1.1B 掩码,400 倍于此前最大数据集)。
- 验证与开源:在 23 数据集与 5 类下游任务上验证零样本迁移,附带 RAI 分析,模型与数据以 Apache 2.0 开放。
实验结果精华
| 实验 | 关键数字 | 含义 |
|---|---|---|
| 单点提示分割(23 数据集,mIoU) | 16/23 优于 RITM ,最大约 +47 IoU;oracle 选择下全面胜出 | 通用模型在零样本单点上已超专用交互式分割器;低绝对 mIoU 主要由歧义导致 |
| 掩码质量(人工评分 1--10) | SAM 均值落在 7--9,全面高于 RITM 与单输出消融版 | 自动指标不利的数据集上,人工评分反而更高 → 指标与人类判断存在系统性偏差 |
| 零样本边缘检测(BSDS500) | SAM ODS .768 / R50 .928;vs Canny .600 / HED .788(在 BSDS 上训练的) | 未经边缘训练即接近深度学习早期方法;recall 高但 precision 低(不学 BSDS 的抑制偏好) |
| 零样本目标提议(LVIS v1,AR@1000) | SAM 59.3 vs ViTDet-H 63.0;但 SAM 在中/大目标、罕见/常见类上更好 | ViTDet 靠"检测器伪装成提议器"在 AR 上取巧;SAM 只在小目标与高频类上落后 |
| 零样本实例分割(COCO / LVIS,mask AP) | SAM 46.5 / 44.7 vs ViTDet-H 51.0 / 46.6,但人工评分 SAM 更高 | 差距来自数据标注偏差(如 COCO 掩码质量偏低、LVIS 掩码无孔洞),而非掩码质量本身 |
| 数据与规模消融 | 仅自动掩码比全量低约 0.5 mIoU ;1M 图像(约 10%)≈ 全量 | 全自动数据路线成立;约 100M 掩码是很多场景下的实用规模 |
与前序/相关工作关联
本文在阅读库中位于 B05,是"提示 → 输出"这条线索上的第二个基础模型,与 B04(LLaVA)构成一组鲜明对照:
- vs CLIP(B03) :CLIP 用对比学习把图文对齐到一个共享空间 ,能力体现在"相似度匹配";SAM 用监督训练把提示映射到掩码,能力体现在"任意提示的生成式输出"。CLIP 是 SAM 内部的组件之一(文本提示与 text-to-mask 训练都借它),这是两篇论文之间真实的依赖关系。
- vs LLaVA(B04) :同为"基础模型 + 提示",但提示类型与输出模态相反 ------LLaVA 吃自然语言 、出文本 ;SAM 吃几何提示 、出掩码。两者共同定义了"语言到像素"链条的两端,而中间那段(语言 → 掩码)正是 LISA / GeoPixel 这类工作要补的缺口。
- vs 交互式分割(RITM、FocalClick、SimpleClick) :目标不同。它们为"人点多几次拿到高 IoU"设计;SAM 为"泛化与广度"设计,作者明确承认多点场景下专用方法会更好。这条界线在评价时必须守住------不能用 SAM 的 1 点结果(或它的多点劣势)做越界结论。
- 演进逻辑 :CLIP 对齐语义 → LLaVA 接入指令 → SAM 提供可复用的像素级接口 → LISA / GeoPixel / SAM 2 把语言与像素、图像与视频连通。SAM 提供的是工具 ,不是理解。
局限与改进方向(也是切入空间):
- 训练数据无遥感域:SA-1B 是自然图像,23 个评估数据集里航拍仅占一个。改进方向:在遥感域重估单点提示的表现,或直接用遥感数据做域内适配(计划 T16 读 SAM 2、T14 读 Grounded SAM 时对照)。
- 细结构与极小目标会失败 :原文明确承认"会漏细结构、偶尔幻觉出小的不连通分量、边界不如 zoom-in 类方法锐利"。这正好是小目标课题的痛点------是缺口,也是可能的贡献点:局部放大/多尺度裁剪是否能稳定改善,需要受控实验而不是直觉。
- 文本提示只是初步探索 :text-to-mask 需要改动训练流程(用 CLIP 图像嵌入训练、文本嵌入推理),且作者自评"不完全稳健"。改进方向:遥感上"语言到掩码"必须靠专门的语言-像素对齐机制(LISA / GeoPixel 路线),不能指望 SAM 原生支持。
- 无法用简单提示表达语义/全景分割:原文自认"不清楚如何设计实现语义与全景分割的简单提示"。改进方向:把"分类"从提示侧移到解码侧,或在组合系统中由语言模型承担语义分配------这正是"大模型 + 分割器"分工的依据。