阅读人工智能技术资料时,经常会同时遇到这些名词:
MLP、FFN、CNN、ResNet、Transformer、MoE、Mamba、U-Net、扩散模型、JEPA、VLA、世界模型、端到端......
它们看起来都是"模型名称",实际上并不处于同一个抽象层级:
- 卷积、注意力是计算机制;
- FFN、残差块是可复用模块;
- ResNet、ViT、U-Net是骨干网络;
- 扩散、JEPA描述的是学习或生成方法;
- VLA、世界模型描述的是模型承担的系统功能;
- 端到端则是一种训练与系统组织方式。
因此,与其寻找"所有模型都由三种积木组成"这样的简单结论,不如建立一套更严谨的五层框架:
- 基础算子;
- 可复用模块;
- 骨干网络;
- 学习与生成范式;
- 完整智能系统。
这不是唯一的分类方法,但足以帮助我们定位大多数常见术语。
第一层:基础算子------模型实际执行的计算
基础算子是构成神经网络的底层计算。严格来说,MLP、CNN已经不是最小单元;它们还可以继续拆成线性变换、激活函数、归一化等操作。
1. 线性变换与嵌入
线性层执行的基本运算是:
它负责改变特征维度、组合输入信息,也是MLP、注意力投影和分类头的基础。
嵌入层则把离散对象映射为连续向量,例如:
- 文本模型中的词元嵌入;
- ViT中的图像块嵌入;
- 推荐系统中的用户和物品嵌入;
- 多模态模型中的图像、音频和动作表示。
2. 激活函数与门控
如果网络只有线性变换,无论叠多少层,整体仍然是线性映射。ReLU、GELU、SiLU等激活函数为网络引入非线性。
门控结构会进一步控制信息通过的比例。LSTM中的门、GLU以及现代大模型常用的SwiGLU,都属于这一类机制。
3. 归一化
BatchNorm、LayerNorm和RMSNorm用于调节中间特征的数值尺度,改善深层网络的训练稳定性。
它们不是"附属装饰"。在现代深层模型中,归一化方式及其放置位置------例如Pre-Norm和Post-Norm------会直接影响优化过程。
4. 残差连接
残差连接通常写作:
它为信息和梯度提供了一条较短的传播路径,使深层网络更容易优化。ResNet系统化地验证了这一设计的有效性,但残差连接并不属于CNN专用技术;Transformer、扩散模型和状态空间模型同样大量使用它。ResNet论文
5. 卷积
卷积通过局部连接和参数共享处理具有空间或时间邻域的数据,天然带有局部性和平移相关的归纳偏置。
需要区分:
- 卷积是基础运算;
- CNN是以卷积为主要特征混合方式的网络家族;
- ResNet、ConvNeXt则是具体的CNN架构。
其中,ConvNeXt是吸收了部分现代网络设计经验的纯卷积网络,并不是简单的"CNN与Transformer融合"。
6. 注意力
注意力根据输入内容动态计算不同位置之间的关联。常见形式包括:
- 自注意力:同一序列内部建立关系;
- 交叉注意力:一个序列读取另一个序列的信息;
- 多头注意力:在多个表示子空间中并行计算关系。
注意力不等于Transformer。Transformer是把注意力、FFN、归一化和残差连接等机制组织起来形成的网络架构。Transformer论文
7. 循环与状态空间更新
RNN、GRU和LSTM通过隐状态按顺序处理数据。状态空间模型(SSM)同样维护和更新状态,但通常采用更适合并行训练与长序列计算的形式。
Mamba引入选择性状态更新,使模型能够根据输入决定保留或遗忘哪些信息,是Attention之外具有代表性的序列建模路线。Mamba论文
8. 池化、采样与重排
最大池化、平均池化、步幅卷积、上采样、Patch合并和Pixel Shuffle等操作负责改变特征的空间分辨率或序列长度。
它们在CNN、U-Net、视觉Transformer和生成模型中都很常见。
9. 路由与稀疏选择
路由器根据输入选择部分计算分支。Mixture of Experts(MoE)是典型例子:模型拥有多个专家,但每个词元通常只激活其中少数几个。
MoE增加的是模型容量,而不是让全部参数在每次前向计算中同时参与。它还会引入负载均衡、跨设备通信和训练稳定性等问题。Switch Transformer论文
10. 图消息传递
图神经网络通过"发送消息---聚合邻居---更新节点"的方式处理不规则结构,适合分子、社交网络、知识图谱和物理系统。
它可以看作另一种信息混合机制,与卷积、注意力和状态更新并列。Graph Networks论文
第二层:可复用模块------把算子组织成标准部件
基础算子通常不会孤立使用,而是被封装成能够反复堆叠的模块。
1. MLP与Transformer FFN
MLP是由线性层和非线性函数组成的通用网络。
Transformer中的FFN通常指对每个位置独立应用的前馈子网络。经典形式是:
现代模型还经常采用GLU、GeGLU或SwiGLU等门控变体。因此,更准确的表述是:
MLP是广义网络类型;Transformer FFN是其中一种位置独立、可重复使用的子模块。
FFN并不必然固定为"两个线性层",也不只存在于Transformer中。
2. 残差卷积块
典型结构是:
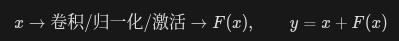
ResNet使用这类模块构建深层CNN。不同网络还会采用Bottleneck、Depthwise Convolution、Inverted Bottleneck等变体。
3. Attention Block
Attention Block通常包括输入投影、多头注意力、输出投影以及残差连接。交叉注意力块还会分别接收查询和外部上下文。
它可以用于文本内部建模,也可以让图像特征读取文本、动作解码器读取视觉状态。
4. Transformer Block
一个典型的Transformer Block可以概括为:
但这只是结构摘要。不同模型还会改变:
- 使用自注意力还是交叉注意力;
- 采用Pre-Norm还是Post-Norm;
- FFN使用普通MLP、门控MLP还是MoE;
- 使用全局、局部、稀疏或线性注意力;
- 是否加入旋转位置编码等位置信息。
因此,"使用Transformer"并不意味着不同模型的内部结构完全相同。
5. MoE Block
MoE Block通常由路由器和若干专家组成:
专家往往是FFN,但也可以是其他类型的网络。MoE属于条件计算模块,可以嵌入Transformer或其他骨干网络。
6. SSM Block
状态空间模块通过状态更新在序列上传递信息。它适合长序列和流式处理,也经常与卷积、门控和残差连接组合。
实际系统不一定在"Attention或SSM"之间二选一;混合架构可以在不同层或不同分支中同时使用二者。
第三层:骨干网络------决定信息如何流动
骨干网络负责把模块组织成完整的特征提取或序列建模网络。
| 骨干家族 | 主要信息混合方式 | 典型代表 | 常见场景 |
|---|---|---|---|
| CNN | 局部卷积 | ResNet、ConvNeXt | 图像、视频、语音、边缘设备 |
| Transformer | 注意力与FFN | GPT、BERT、T5、ViT、Swin | 语言、视觉、多模态 |
| 循环/SSM | 隐状态或状态空间更新 | LSTM、Mamba | 时序、长序列、流式数据 |
| 编码器---解码器 | 压缩后逐级恢复 | U-Net | 分割、扩散生成、密集预测 |
| 图神经网络 | 邻居消息传递 | GCN、GAT、Graph Network | 分子、关系数据、物理系统 |
| 混合网络 | 多种机制协同 | CNN-Attention、Attention-SSM | 多模态和长序列任务 |
Transformer的三种基本形态
- Encoder-only:擅长理解和表征,BERT是典型代表;
- Decoder-only:按因果顺序预测后续词元,GPT类大语言模型多采用这种形式;
- Encoder--Decoder:编码输入,再条件生成输出,原始Transformer和T5属于这一类。
ViT与Swin Transformer
ViT把图像切分为Patch,将其映射为词元序列后交给Transformer Encoder处理。ViT论文
Swin Transformer进一步引入局部窗口、窗口移动和分层特征,在视觉任务中保留了更强的局部性与多尺度结构。
U-Net
U-Net由下采样编码器、上采样解码器和跨尺度跳跃连接组成。它最初用于图像分割,后来也成为扩散模型中常见的去噪骨干。
但扩散模型不等于U-Net:Diffusion Transformer已经证明,Transformer也可以承担去噪网络的角色。DiT论文
第四层:学习与生成范式------模型究竟在学习什么
同一种骨干可以使用完全不同的训练目标。因此,不能仅凭训练方法判断底层网络结构。
1. 自回归建模
模型根据已有内容预测下一个词元、图像块、音频单元或动作:
大语言模型最常使用这种方式,但自回归并不是Transformer专属。
2. 掩码与重建学习
模型遮挡一部分输入,再恢复词元、像素或隐表示。BERT、掩码自编码器等方法属于这一大类。
3. 对比学习与联合嵌入预测
对比学习使相关样本的表示接近、不相关样本的表示分离。
JEPA则在表示空间中预测目标区域或未来状态,而不是强制重建全部像素。以I-JEPA为例,系统包含上下文编码器、目标编码器和预测器;其实验采用ViT作为骨干。I-JEPA论文
因此:
JEPA更适合被归类为表示学习架构或训练范式,而不是与Transformer、ResNet并列的基础网络结构。
4. 扩散与分数建模
扩散模型在训练时学习逆转逐步加噪的过程,生成时从噪声开始迭代去噪。DDPM论文
"扩散"描述的是概率建模和采样方式;负责预测噪声、速度或数据状态的网络,可以是U-Net,也可以是Transformer。
5. 强化学习与策略学习
策略模型根据观测选择动作,以最大化长期回报。模型骨干可以是MLP、CNN、Transformer或其组合。
模仿学习、离线强化学习和在线强化学习的差异主要在于数据来源及优化目标,而不在于是否采用某种固定网络。
第五层:完整智能系统------模型在系统中承担什么角色
1. 端到端
端到端不是一种网络,而是一种优化和系统组织方式。
更准确的定义是:系统依据最终任务目标,对输入到输出的整体映射进行联合学习。端到端系统内部仍然可以包含视觉编码器、记忆、规划器和动作头等多个模块。
因此,"端到端"不等于"内部没有模块",也不等于"一定从原始像素直接输出控制信号"。
2. 多模态模型
多模态模型需要解决三个问题:
- 不同模态如何编码;
- 不同模态在何处融合;
- 输出采用文本、图像、音频还是动作表示。
常见方案包括独立编码器加投影层、交叉注意力融合,以及把多种模态统一成词元序列。
3. VLA:视觉---语言---动作模型
VLA接收视觉观测和语言指令,输出机器人动作或动作序列。
典型系统可能包含:

动作既可以被离散化为词元进行自回归预测,也可以由连续回归、扩散策略等方式生成。RT-2便将机器人动作表示为词元,与视觉---语言任务共同训练。RT-2论文
所以,VLA描述的是模型的输入、输出和应用职责,而不是唯一确定的内部网络。
4. 世界模型
世界模型学习环境如何随时间和动作变化,可能预测:
- 下一时刻的观测;
- 潜在状态;
- 奖励或终止信号;
- 多条可能的未来轨迹。
它可以服务于规划、控制、数据生成或策略训练。实现方式可能是RNN、SSM、Transformer、图网络或扩散模型。
世界模型也不一定生成视频。只要模型学习了对决策有用的环境动力学,隐空间预测同样可以构成世界模型。
5. RAG与智能体
RAG由检索器、知识库和生成模型共同组成,是系统架构而不是新的神经网络层。
智能体系统通常进一步组合:
- 基础模型;
- 工具调用;
- 外部记忆;
- 检索;
- 规划与执行循环;
- 验证器或安全策略。
这些能力主要来自系统编排,不能简单归因于某个Transformer Block。
一张图理清概念层级
基础算子
├─ 线性变换、嵌入
├─ 激活、门控、归一化
├─ 卷积、注意力
├─ 循环与状态空间更新
├─ 残差、采样、路由
└─ 图消息传递
        ↓
可复用模块
├─ MLP / FFN / SwiGLU
├─ 残差卷积块
├─ Attention Block
├─ Transformer Block
├─ MoE Block
└─ SSM Block
        ↓
骨干网络
├─ ResNet / ConvNeXt
├─ GPT / BERT / T5
├─ ViT / Swin
├─ U-Net
├─ Mamba
└─ GNN与混合架构
        ↓
学习与生成范式
├─ 自回归
├─ 掩码与重建
├─ 对比学习 / JEPA
├─ 扩散与分数建模
└─ 模仿学习 / 强化学习
        ↓
系统与应用
├─ 多模态模型
├─ VLA
├─ 世界模型
├─ RAG与智能体
└─ 端到端系统
需要注意,箭头不代表严格的一一依赖。例如,扩散模型既可以采用U-Net,也可以采用Transformer;VLA既可能使用自回归动作头,也可能使用扩散动作头。
当前值得关注的结构趋势
1. 从单一路线转向混合架构
Attention、卷积、SSM和图消息传递各有不同的归纳偏置。越来越多的模型根据数据类型和计算约束组合这些机制,而不是追求一种结构覆盖所有场景。
2. 条件计算与结构化稀疏
MoE、稀疏注意力和动态路由的共同目标,是让模型根据输入选择计算路径。它们可以扩大模型容量,但不会自动降低显存、通信或部署成本。
3. 长序列优化同时发生在多个层面
长上下文并不是单一架构问题:
- FlashAttention属于注意力实现优化;
- KV Cache压缩属于推理系统优化;
- 稀疏或线性注意力属于计算结构调整;
- SSM属于替代或补充Attention的序列建模路线。
讨论"谁取代谁"之前,应先确认比较的是算法、架构还是工程实现。
4. 多模态正在统一接口,而非完全统一结构
图像、文本、音频和动作可以被转换为统一的向量或词元接口,但不同模态仍可能保留专用编码器、时间尺度和损失函数。
"统一词元空间"不等于所有模态必须使用完全相同的前端网络。
5. 模型能力越来越依赖系统协同
检索、工具、记忆、规划器和验证器不会改变基础模型的权重结构,却可能显著改变整个系统的可靠性和任务边界。
分析现代AI产品时,必须同时观察模型层和系统层。
结语
现代AI并不是由"三块万能积木"简单堆叠而成。更准确的理解方式是:
基础算子决定如何计算,可复用模块决定如何组合,骨干网络决定信息如何流动,训练范式决定模型学习什么,系统设计决定它最终能够完成什么任务。
以后遇到一个新名词,可以依次追问:
- 它是算子、模块、骨干,还是完整系统?
- 它改变了网络结构,还是只改变了训练目标?
- 它解决的是表示、生成、规划还是控制问题?
- 它的改进来自模型本身,还是来自数据、推理和系统工程?
回答完这四个问题,大多数看似复杂的新概念,就能被放回清晰、可比较的技术坐标系中。