我手上有两张截的是同一段 12 px 的侧栏小字。一张是普通屏的 1x 截图,另一张是 Retina 屏的 2x 截图。两张直接交给 OCR 时专业档的字符错误率都是 0.0%。我给它们各做了一次阈值 128 的二值化再识别。2x 那张还是 0.0% 而 1x 那张变成了 30.9%。换成 3×3 的中值去噪也是一样。2x 是 0.0% 而 1x 到了 32.4%。这两张截图在我眼里是同一段字。放大了看也只是一张清楚一张略糊。可对 OCR 来说它们是两张很不一样的图。人眼看到的是字,OCR 能用的只有每一笔落在了哪几个像素上。
普通屏和Retina截图差在笔画像素
这里的 1x 和 2x 指的是截图时的设备像素比,不是截完再放大。同一段侧栏文字在 1x 下截出来是 280×97 而在 2x 下是 560×194。字号和排版都一样,2x 截图里每一笔的宽和高都是 1x 的两倍。样本是我自己写的一个网页,里面放的是自编的「社区服务时间调整说明」。
我从正文、侧栏、灰色页脚和收费表格各截了一块。每块都有 1x 和 2x 两份,另外还加了网上找的一张放假通知模板里裁下的 2 块红底文字。识别我用的是图映(https://imging.cn/)的图片文字识别,以默认的专业 OCR 档为主并把极速 OCR 和极致 OCR 也各跑了一遍。对照组我放的是没调过参数的 tesseract.js 5,语言用 chi_sim+eng。我在一台 Apple M4 上用 Chromium 149 开源构建跑的这组测试,识别后端显示的是 WebGPU。图映的识别模型和前后的流水线不是我做的,下面讲到它内部的地方都只是我从输入和输出反推出来的。
原图直接识别时 1x 和 2x 几乎没有差别,这批截图上专业档原图的错几乎都是零。剩下那一点错反倒很能说明 OCR 在看什么。16 px 正文里有一处「9:00---20:30」,那条长横线在 6 次原图识别里有 5 次被认成了汉字「一」。人看到两个时间中间夹着一道横线会自然读成「到」。OCR 看到的只是一条又平又细的线,它和「一」在形状上本来就很接近。极速档在 1x 的 12 px 侧栏上把「末班车」认成了「未班车」,又把「已巳己」认成了「已已己」。这几组字的差别都在一笔的长短或者一个开口上。像素一少就先丢这种细节。
削笔画的处理在1x上才出事
问题出在预处理上。下面是专业档在几块截图上的字符错误率,同一种处理放在 1x 和 2x 上对比着看。
| 样本 | 原图 | 阈值 100 | 阈值 128 | 中值 3×3 |
|---|---|---|---|---|
| 12 px 侧栏 1x | 0.0 | 64.7 | 30.9 | 32.4 |
| 12 px 侧栏 2x | 0.0 | 1.5 | 0.0 | 0.0 |
| 13 px 表格 1x | 0.0 | 14.5 | 1.2 | 21.7 |
| 13 px 表格 2x | 0.0 | 0.0 | 0.0 | 0.0 |
2x 那几行基本贴着零。1x 那几行在同一种处理下错了一大片。我对这个结果的理解是这样的。中值 3×3 会把每个像素换成它周围九个像素的中位数。一笔要是只有很窄的一条,它周围九个像素里多数都是背景,这一笔就会被抹掉或者跟旁边的笔画粘成一团。2x 截图里笔画宽了一倍,周围九个像素里笔画自己就能占上多数,怎么滤它都还在。二值化的道理也差不多。字边上那一圈半灰的像素在 2x 里只是边缘,到了 1x 里可能就是半个笔画。阈值一刀切下去以后 2x 的字瘦了一圈还认得出来,1x 的字就只剩下零零碎碎的几个点。
灰色页脚把这件事放得更大。那行字是 #999 灰字配 #f5f5f5 底。里面最暗的像素是 153。阈值取 160 时刚好比最暗那几个像素高一点,只有笔画中心那条芯能留下来。2x 截图上专业档还是 1.0%。1x 截图上是 75.5%,认出来的是「洛た小↓公告终双社差有如有关公3279025...」这样的乱码。同样一道阈值下笔画粗的那张只是瘦了。笔画细的那张已经散成了噪点。
阈值低过字的灰度时分辨率也救不了
上面说的是削掉一部分笔画,还有一种情况是整个删掉。同一行灰字用阈值 128 或 100 去二值化的时候阈值比字里最暗的 153 还低,所有的字都被判成了背景。这时 1x 和 2x 一样惨。图映三档和 tesseract.js 全部只认出 0 字,错误率 100%。笔画再宽也没用,因为像素已经一个都不剩了。
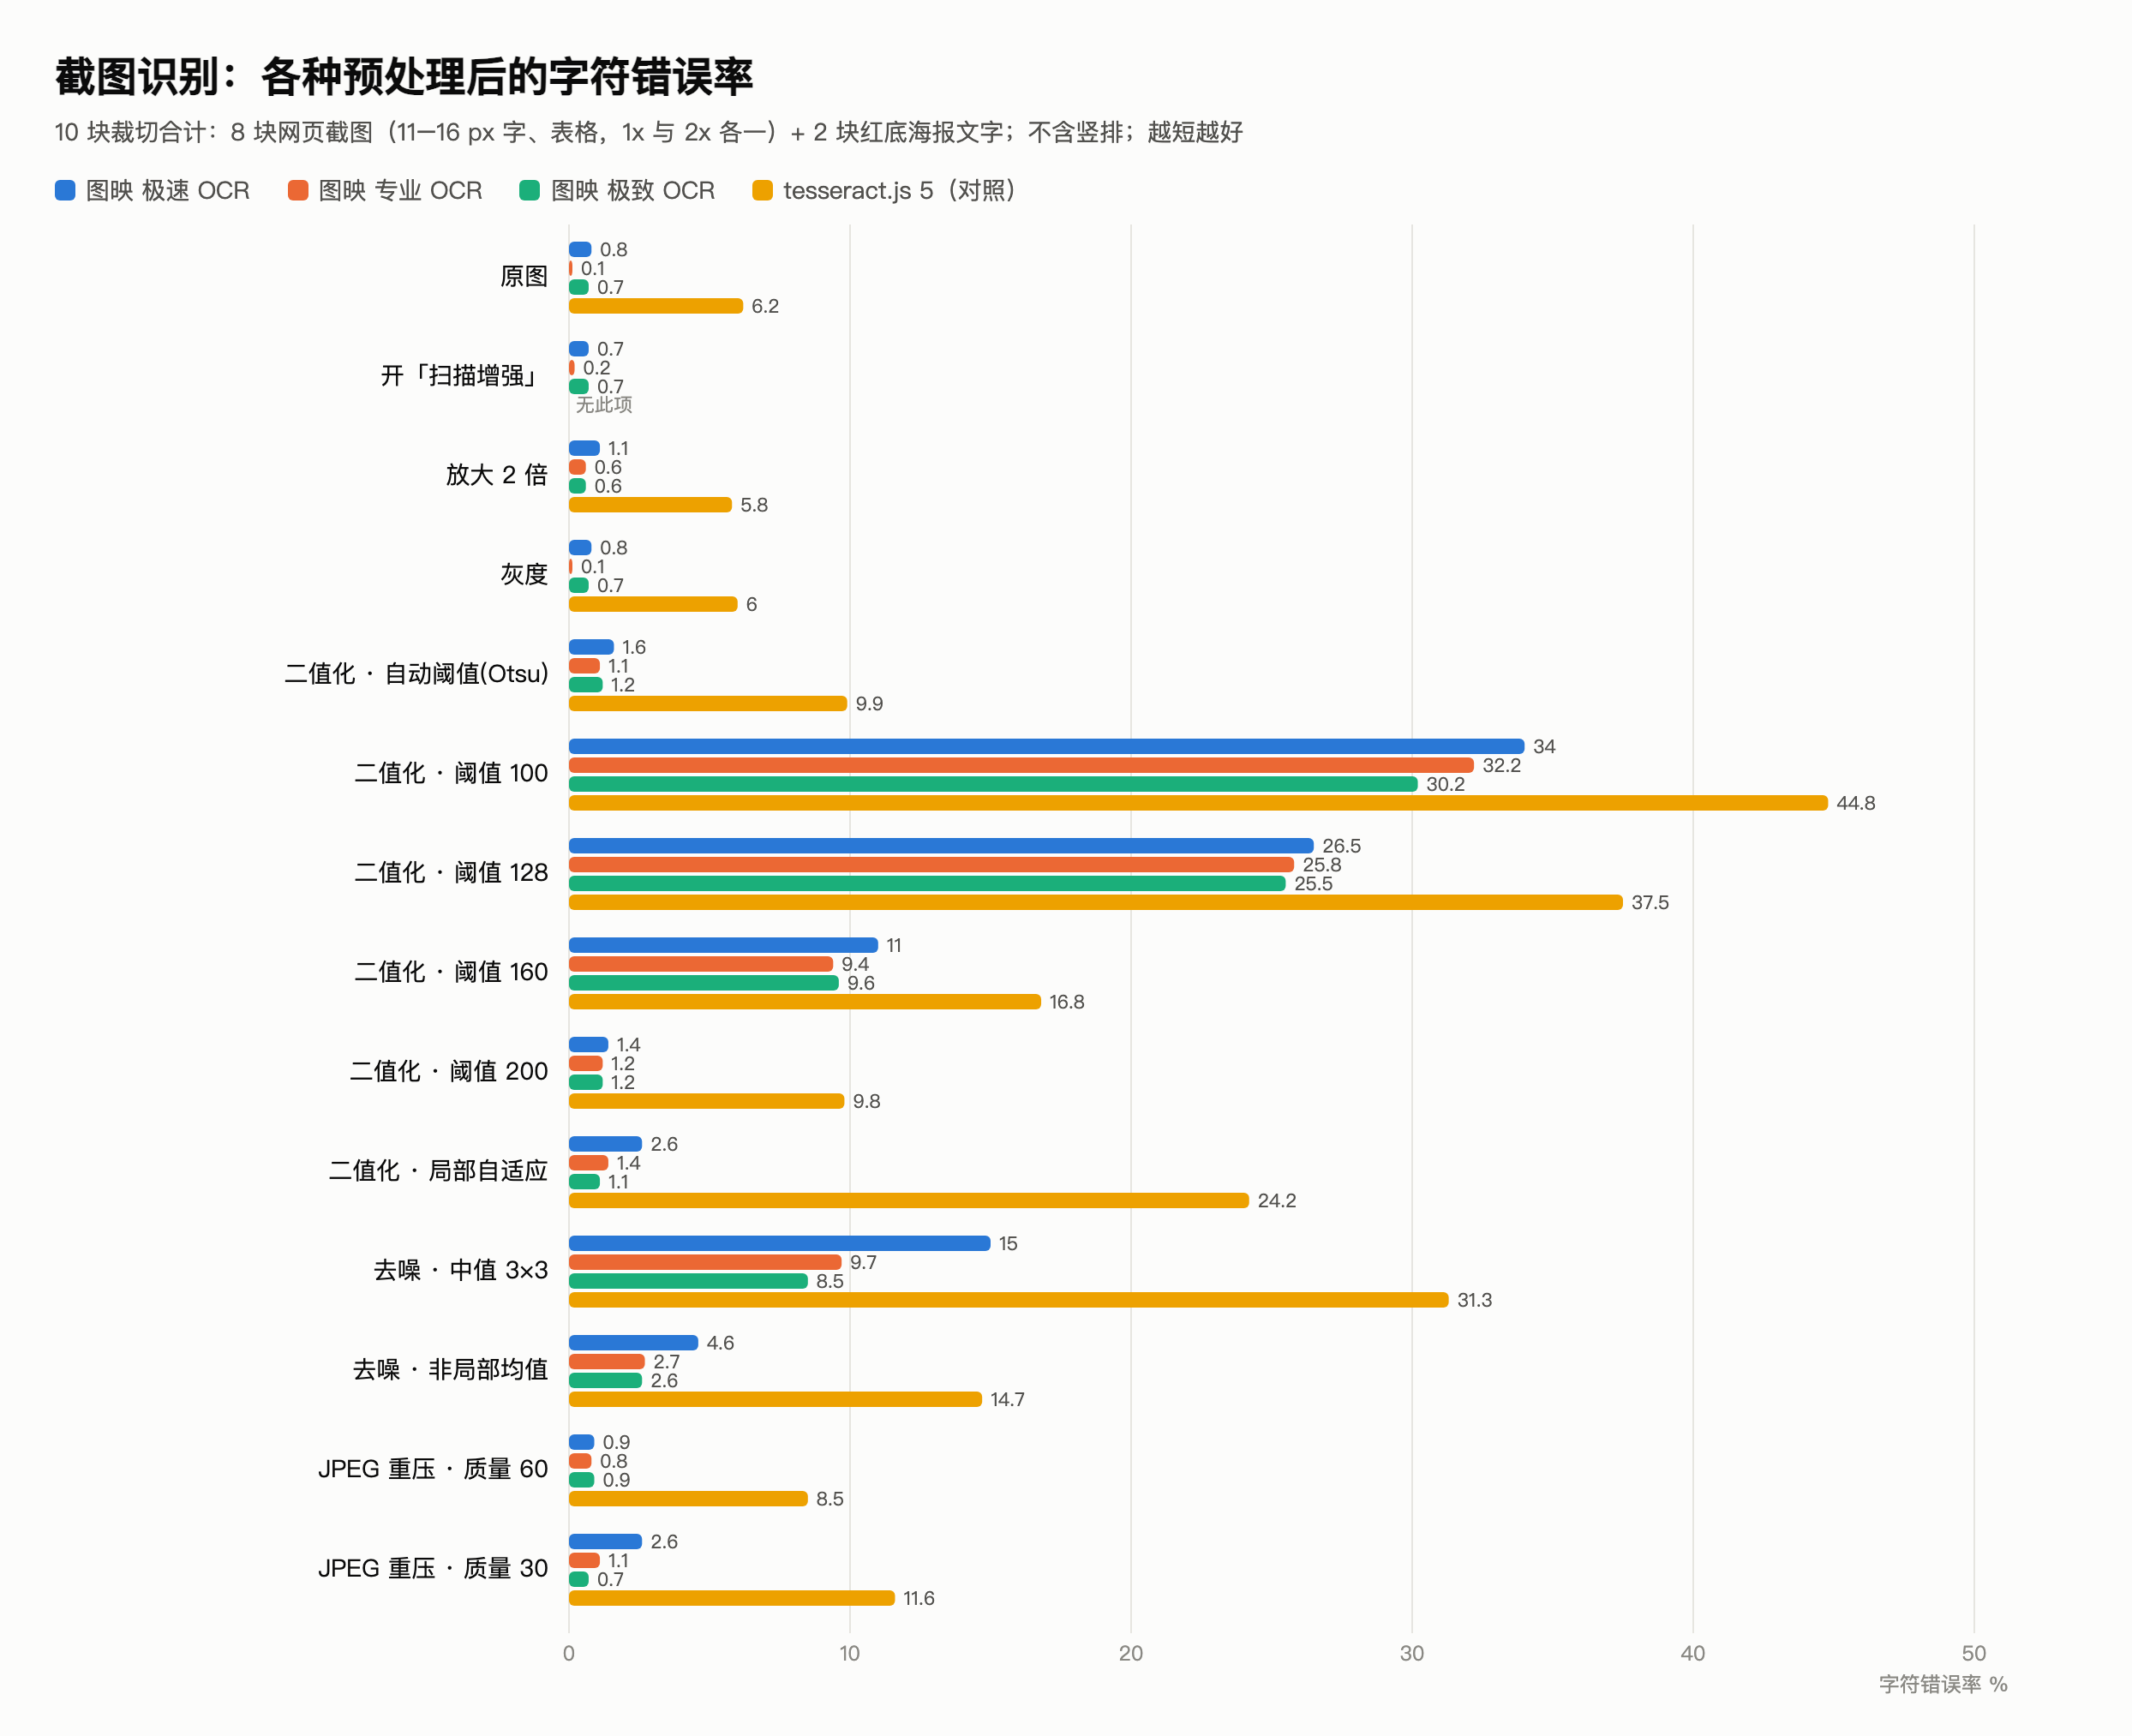
这张图是 8 块网页截图和 2 块红底海报文字共 10 块横排裁切的合计,1x 和 2x 都算在了里面。先看阈值 100、阈值 128 和中值去噪那几根长条再拿它们跟原图那几根贴着 0 的短条比一比。
专业档原图合计是 0.1%。灰度也是 0.1%,开着界面上的「扫描增强」是 0.2%。这个开关的说明写的是「仅轻度灰度、对比度与锐化,不强制二值化」。它不去碰笔画的形状,结果也就和原图基本持平。Otsu 自动阈值是 1.1% 而阈值 128 是 25.8%,中值去噪是 9.7%。阈值 128 的错几乎全来自那行灰字和 1x 侧栏。中值去噪的错几乎全来自 1x 截图,2x 那几块只在 16 px 正文上错了 0.7%。三档原图合计分别是 0.8%、0.1% 和 0.7%。彼此差不到 1 个百分点。
拍照件上的像素问题换了一种形式。我手上没有合适的真实手机照片就用程序合成了两张模拟拍照的停水通知。我给它们加了约 2.5° 的倾斜和左上亮右下暗的光照,其中一张还在正文右侧压了一块阴影。下面的数字只出自这两张程序合成的样本,不能当成真实照片的错误率来看。
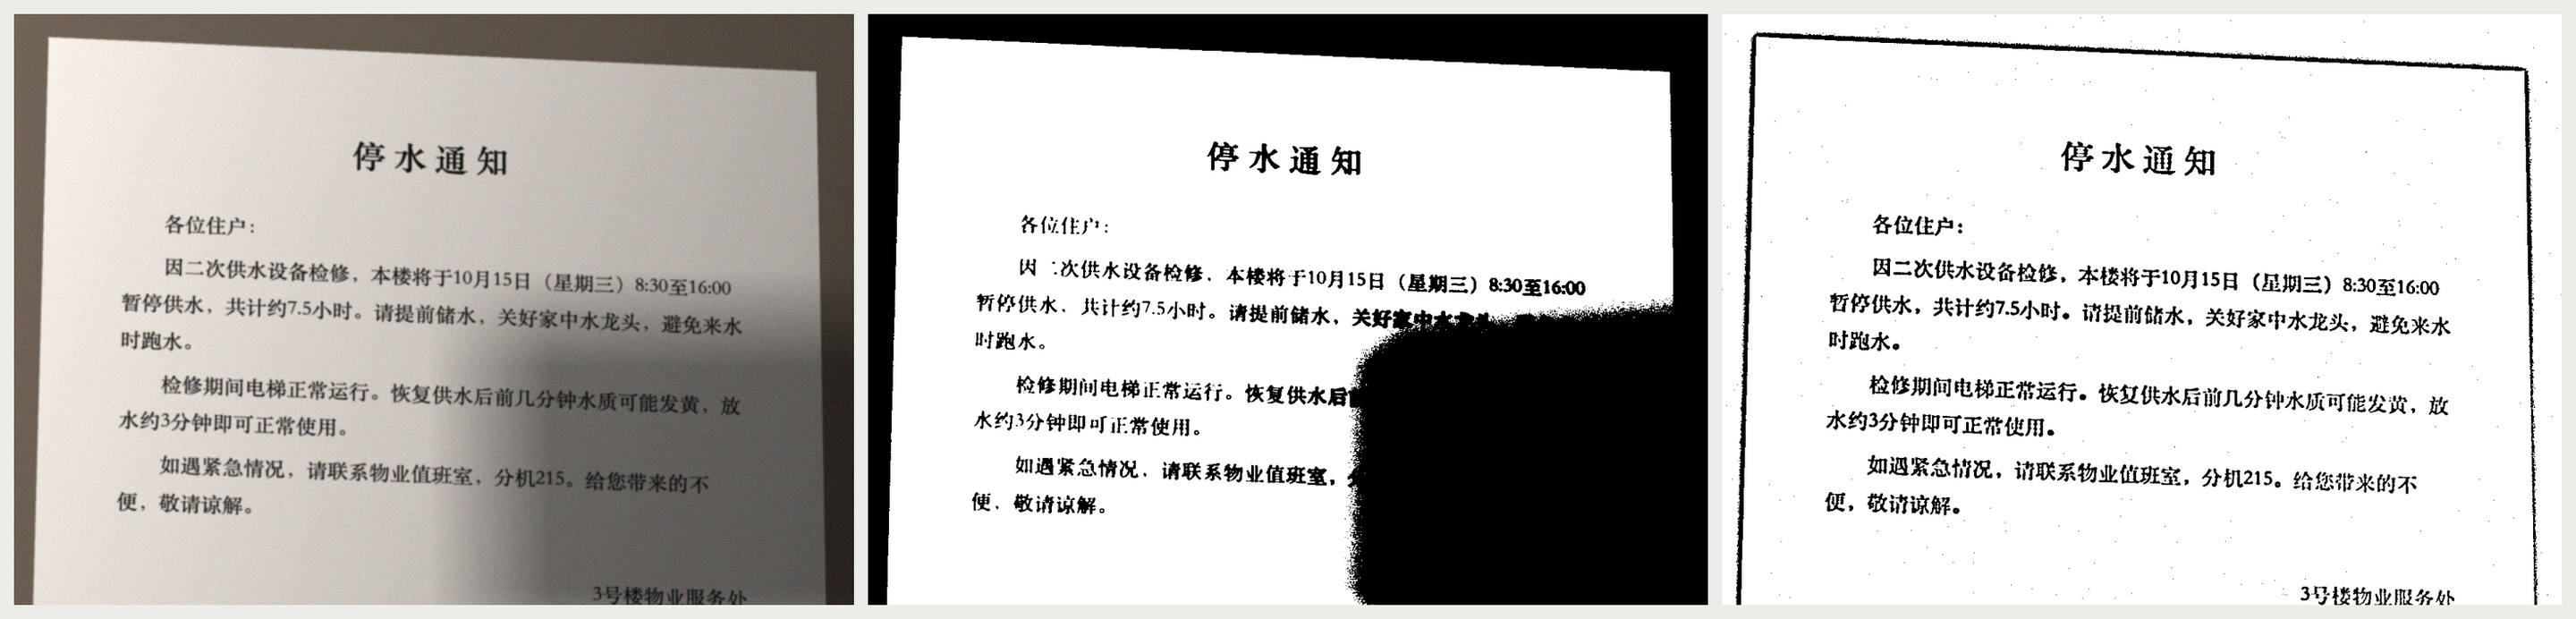
这张图是程序合成的模拟拍照而不是真的拍出来的。左边是右侧压着阴影的原图。中间是 Otsu 自动阈值的结果,阴影区黑成了一片。右边是局部自适应二值化的结果,上面的字都还在原处。
人眼会自动把阴影里的字和亮处的字当成一样的黑字。全局阈值只认绝对亮度,阴影区的背景比阈值还暗就整块被判成了字。带阴影那张做完 Otsu 以后专业档错了 31.0%,阴影区里的字是真的没了。局部自适应按每一小块周围的亮度来定阈值,它在这张图上没有吞字。
缩小过的截图像素已经回不来
还有一种截图比 1x 更糟,就是被聊天软件或者缩略图压过一遍的那种。我把 1x 截图再缩到 50% 以后,12 px 的侧栏小字只剩大约 6 px 高。专业档原样识别是 14.7%。再放大 2 倍去识别反而成了 23.5%。用 Lanczos 放大是 29.4%。放大只能在已有的像素之间插值,它插不出被缩掉的那一笔。同样缩到 50% 的 16 px 正文还是 0.7%,字本身够大时多少还留着一点余量。
我现在怎么处理截图
现在给截图做识别时我会先看它是 1x 还是 2x,再看字号有多小。清楚的截图就直接拿原图去识别,这是我这批测试里最好的结果。要是流水线里非得加一道预处理,我会先拿 1x 的小字截图去试它。2x 截图上没出事说明不了什么。二值化之前我会先量一下文字里最暗的灰度。阈值别低过它。照片上有阴影就别用全局阈值而改用局部自适应。能拿到原始截图就别用转发过的缩略图。
这组数的边界我也交代一下。我只测了 Chromium 149 开源构建加 WebGPU 后端,手机、WASM 后端和别的浏览器都还没测。截图样本只有 11 到 16 px 的苹方字体和一张网上的模板图,手写体和艺术字都没碰。拍照件只有程序合成的两张。真实手机照片还没测。每种组合只跑了 1 次,1 到 2 个百分点的波动别太当真。中值滤波和二值化为什么在 1x 上伤得这么重,上面是我按滤波本身的原理推出来的,图映模型内部怎么用这些像素我没看过。有没有一种预处理能在 1x 小字上真正加分,这组测试里我还没找到。