本文代码已同步Github
一、二叉搜索树的概念
我们前面学过二叉树,但普通二叉树有个问题:查找一个元素只能从头遍历,效率很低。如果在二叉树的基础上加一条规则------左子树都比根小、右子树都比根大------查找的时候就能根据大小每次砍掉一半分支,这就是二叉搜索树。
二叉搜索树又称二叉排序树,它或者是一棵空树,或者是具有以下性质的二叉树:
- 若它的左子树不为空,则左子树上所有结点的值都小于等于根结点的值;
- 若它的右子树不为空,则右子树上所有结点的值都大于等于根结点的值;
- 它的左右子树也分别为二叉搜索树。
这里的"小于等于/大于等于"说明二叉搜索树可以支持插入相等的值,也可以不支持,具体看使用场景。后续我们学的map/set/multimap/multiset底层就是二叉搜索树,其中map/set不支持插入相等值,multimap/multiset支持。我们这篇先实现不支持重复值的版本。
1、效率分析
最优情况下,二叉搜索树接近完全二叉树,高度为log₂N,增删查都是O(logN)。最差情况下,如果插入序列本身就是有序的,树会退化成一条单支链,高度为N,增删查就退化成了O(N)。
所以二叉搜索树的效率不稳定:平均O(logN),最差O(N)。这也是它自身结构的缺陷------没有任何机制保证树是平衡的。后续的AVL树和红黑树就是在二叉搜索树基础上引入平衡约束,把最差情况也拉回到O(logN)。
这里顺带说一下,二分查找也能做到O(logN),但它有两个缺陷:一是要求顺序存储结构支持下标随机访问;二是插入删除需要搬移元素,效率低。而二叉搜索树用链式存储,插入删除只要改指针,这就体现出了平衡二叉搜索树的价值。
二、结构实现
我们先把基础结构封装出来。节点里存key和左右孩子指针,类里维护一个根指针即可。
cpp
#include <iostream>

namespace stl
{
    template<class K>
    struct BSTNode
    {
        BSTNode(const K& key)
            :_left(nullptr)
            , _right(nullptr)
            , _key(key)
        {}

        BSTNode<K>* _left;
        BSTNode<K>* _right;
        K _key;
    };

    template<class K>
    class BST
    {
    public:
        using Node = BSTNode<K>;

        BST() = default;

    private:
        BSTNode<K>* _root = nullptr;
    };
}
接下来依次实现插入、查找、删除。
三、插入 Insert
1、逻辑分析
插入的思路很直接:
- 如果是空树,直接new一个节点作为根;
- 如果不是空树,从根开始走,根据key和当前节点的大小关系决定往左还是往右,直到走到空位,把新节点挂上去。
这里有个细节:走到空位的时候,当前指针cur已经是nullptr了,我们没法把新节点挂到nullptr上。所以需要一个parent指针,在cur往下走之前记住它的父节点,最后用parent来连接新节点。
另外要注意,插入相等的值直接返回false,因为我们这版不支持重复值。
2、代码实现
cpp
bool Insert(const K& key)
{
    if (_root == nullptr)
    {
        _root = new Node(key);
        return true;
    }

    // 找到合适位置
    Node* cur = _root;
    Node* parent = nullptr;
    while (cur)
    {
        if (key > cur->_key)
        {
            parent = cur;
            cur = cur->_right;
        }
        else if (key < cur->_key)
        {
            parent = cur;
            cur = cur->_left;
        }
        else
        {
            // 相等,不支持重复值
            return false;
        }
    }

    // parent即为其父节点
    Node* newnode = new Node(key);
    if (key > parent->_key) parent->_right = newnode;
    else parent->_left = newnode;

    return true;
}
3、用中序遍历来验证
光插入完我们没法直观看出树对不对,写一个中序遍历辅助验证。因为二叉搜索树的性质,中序遍历的结果一定是一个递增序列------左子树(小)、根、右子树(大)。如果中序遍历出来是有序的,基本说明插入逻辑没问题。
cpp
public:
    void InOrder()
    {
        _InOrder(_root);
        std::cout << std::endl;
    }

private:
    void _InOrder(Node* root)
    {
        if (root == nullptr) return;

        _InOrder(root->_left);
        std::cout << root->_key << " ";
        _InOrder(root->_right);
}来测试一下,插入{8, 3, 1, 10, 6, 4, 7, 14, 13}:
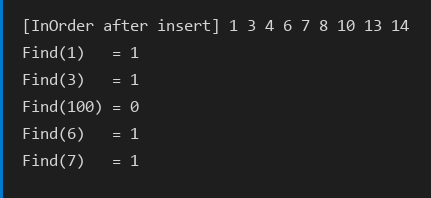
中序遍历输出1 3 4 6 7 8 10 13 14,确实是递增的,插入正确。
四、查找 Find
查找其实就是插入时"走位置"那一步的简化版:从根开始,key比当前节点大就往右走,小就往左走,相等就找到;走到空还没找到就是不存在。
cpp
bool Find(const K& key)
{
    Node* cur = _root;
    while (cur)
    {
        if (key > cur->_key)
        {
            cur = cur->_right;
        }
        else if (key < cur->_key)
        {
            cur = cur->_left;
        }
        else
        {
            return true;
        }
    }

    return false;
}上面的运行结果里,Find(1)、Find(3)、Find(6)、Find(7)都返回1,Find(100)返回0,符合预期。
五、删除 Erase
删除是三个操作里最麻烦的。
1、为什么不先Find再删
直觉上会想:先Find判断存不存在,再Erase删掉
但这样做有个问题------Find要遍历一遍找到节点,Erase又要再遍历一遍不如直接在一遍遍历里同时完成"查找+删除"
而且删除时还需要父节点指针,所以遍历过程中就用parent记录下来。
2、四种情况
假设要删除的节点是cur,它的孩子分布有四种情况:
情况1:左右孩子都为空。
直接让parent对应位置置空,删掉cur即可。
情况2:左孩子为空,右孩子不为空。
让parent对应位置指向cur的右孩子,删掉cur。
情况3:右孩子为空,左孩子不为空。
让parent对应位置指向cur的左孩子,删掉cur。
这三种情况可以合并处理:只要cur有一个孩子为空,就把那个非空的孩子(或者nullptr)接给parent。
情况4:左右孩子都不为空。
这种情况不能直接删cur------删了之后它的左右两棵子树没法同时挂到parent上。正确做法是找一个替代节点来顶替cur的位置,然后把替代节点删掉。
替代节点选谁?要满足"顶替之后二叉搜索树的性质仍然成立",最合适的就是左子树的最大值 或者右子树的最小值。因为:
左子树的最大值 < 被删除节点 < 右子树的最小值
也就是说,左子树最右边那个节点,或者右子树最左边那个节点,放到cur的位置上,依然满足"左边都比它小、右边都比它大"。我们这里选右子树的最小值。
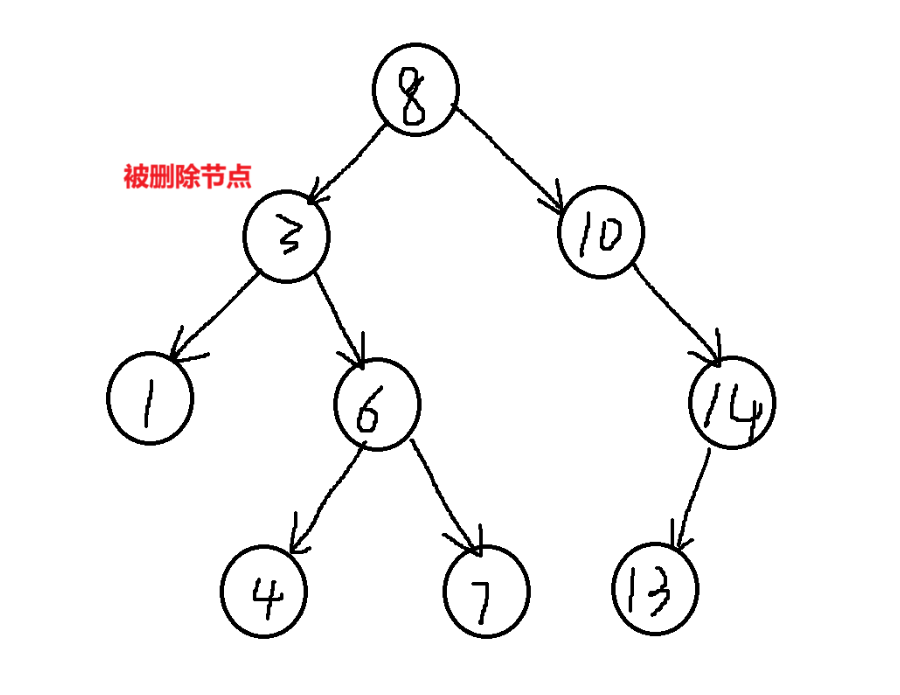
比如上图要删节点3,它有左右两个孩子。右子树的最小值是4(沿着6的左子树一直往左走),把4的值覆盖到3上,再删掉原来那个4节点即可。这样只需要改一次值、删一个叶子级别的节点,指针操作最少。
3、代码实现
cpp
bool Erase(const K& key)
{
    Node* cur = _root;
    Node* parent = nullptr;
    while (cur)
    {
        if (key > cur->_key)
        {
            parent = cur;
            cur = cur->_right;
        }
        else if (key < cur->_key)
        {
            parent = cur;
            cur = cur->_left;
        }
        else
        {
            // 情况1、2、3:cur有一个孩子为空(或都为空)
            if (cur->_left == nullptr)
            {
                // 删根节点的特殊处理:parent为空,直接改_root
                if (parent == nullptr)
                {
                    _root = cur->_right;
                }
                else
                {
                    if (parent->_left == cur) parent->_left = cur->_right;
                    else parent->_right = cur->_right;
                }

                delete cur;
                return true;
            }
            else if (cur->_right == nullptr)
            {
                if (parent == nullptr)
                {
                    _root = cur->_left;
                }
                else
                {
                    if (parent->_left == cur) parent->_left = cur->_left;
                    else parent->_right = cur->_left;
                }

                delete cur;
                return true;
            }
            // 情况4:左右孩子都不为空,找右子树最小值替代
            else
            {
                // 右子树的最小值:从cur->_right一直往左走
                Node* RightMinP = cur;      // 注意初始化为cur
                Node* RightMin = cur->_right;
                while (RightMin->_left)
                {
                    RightMinP = RightMin;
                    RightMin = RightMin->_left;
                }

                // 用替代节点的值覆盖被删节点
                cur->_key = RightMin->_key;

                // 删除替代节点(它最多只有一个右孩子)
                if (RightMinP->_right == RightMin) RightMinP->_right = RightMin->_right;
                else RightMinP->_left = RightMin->_right;

                delete RightMin;
                return true;
            }
        }
    }

    return false;
}
4、踩坑:RightMinP空指针崩溃
写完跑测试,程序直接崩了。调试一看,崩溃在访问RightMinP->_right这一行------RightMinP是nullptr。
为什么会这样?RightMinP初始是nullptr,RightMin从cur->_right开始,只有当RightMin->_left存在时才会进循环、把RightMinP更新成非空。也就是说,当cur的右孩子本身就没有左孩子时,循环一次都不进,RightMinP就一直是nullptr,后面解引用直接崩。
画张图看一下这个场景:
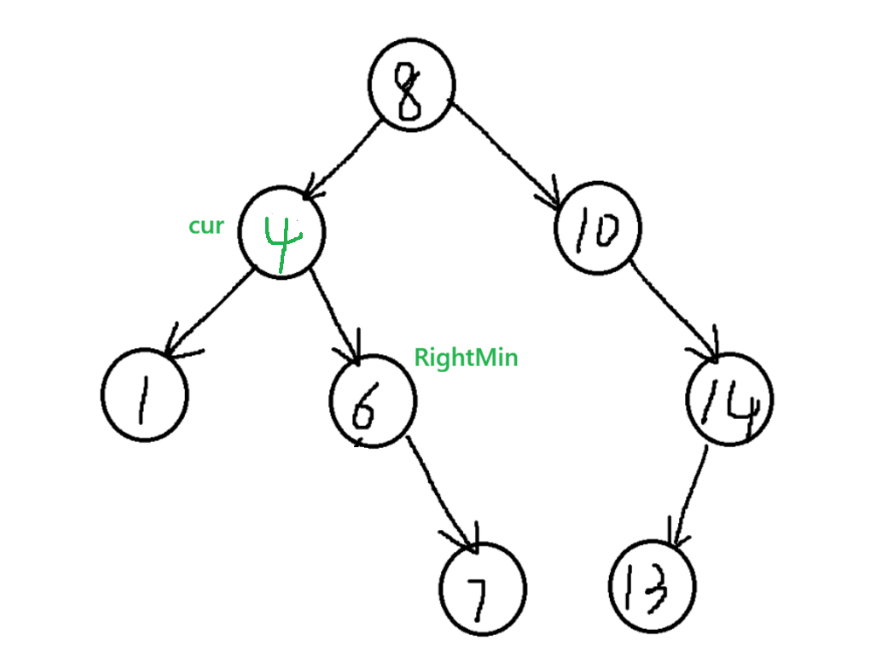
这是删完节点3之后再删节点4时遇到的情况。此时cur指向4,它的右孩子是6,而6已经没有左孩子了(原来的左孩子4在上一步替代删除时被摘掉了)。所以RightMin直接就是6,循环不进,RightMinP还是nullptr。
怎么修?其实我们想做的事情很清楚:RightMin就是cur的右孩子,删掉它之后,要把它的右孩子接上来。此时RightMinP本来就应该是cur自己------也就是说,把RightMinP初始值从nullptr改成cur就行了:
cpp
Node* RightMinP = cur;      // 而不是 nullptr
Node* RightMin = cur->_right;这样即使循环不进,RightMinP也指向cur,后面的RightMinP->_right == RightMin判断成立(因为cur的右孩子确实就是RightMin),正确地把cur->_right接到了RightMin->_right。
顺带说一下,删根节点走情况4时也是同理:cur就是根,parent是nullptr,但情况4里根本不依赖parent(只依赖RightMinP),所以只要RightMinP初始化成cur,删根节点也不会出问题。
来测试一下:
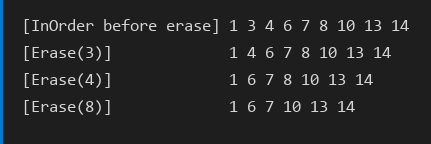
依次删3、4、8(根节点),每次中序遍历都是递增序列,程序正常跑完,没有崩溃。
六、key与key/value搜索场景
前面我们实现的这版二叉搜索树,节点里只存了一个key。但实际用起来,搜索场景分两种,决定了节点里到底要存什么。
1、key搜索场景
这种场景我们只关心"这个key在不在树里",不需要存额外信息。比如:
- 小区无人值守车库:物业把买了车位的业主车牌号录进系统,车辆进时扫车牌,在系统里就抬杆,不在就提示非本小区车辆;
- 检查一篇英文文章单词拼写是否正确:把词库所有单词放进二叉搜索树,读文章时拿单词去查,不在树里就标波浪线。
这两种场景下,节点存一个key就够了,查找只要返回bool------"在"还是"不在"。前面我们写的Find返回bool,就是为这种场景设计的。
2、key/value搜索场景
很多时候光知道"在不在"不够,我们还想根据key把对应的value取出来。比如:
- 中英互译字典:节点存英文key和中文value,输入英文查到对应的中文;
- 商场无人值守车库:key是车牌号,value是入场时间,出场时用当前时间减去入场时间算停车费;
- 统计一篇文章每个单词出现次数:key是单词,value是次数,查到单词就把value++。
这种场景下,节点里要同时存key和value,而且Find不能再返回bool了------必须返回节点指针,这样才能通过指针拿到对应的value。
3、key/value版本的代码差异
改动其实很小:节点多存一个value,Insert多带一个value参数,Find返回Node*而不是bool:
cpp
template<class K, class V>
struct BSTNode
{
    K _key;
    V _value;
    BSTNode<K, V>* _left;
    BSTNode<K, V>* _right;

    BSTNode(const K& key, const V& value)
        :_key(key)
        , _value(value)
        , _left(nullptr)
        , _right(nullptr)
    {}
};

template<class K, class V>
class BST
{
    // ... Insert和Erase逻辑不变,只是比较用 _key ...

    // 关键区别:Find返回节点指针,外面才能拿到对应的_value
    Node* Find(const K& key)
    {
        Node* cur = _root;
        while (cur)
        {
            if (key > cur->_key) cur = cur->_right;
            else if (key < cur->_key) cur = cur->_left;
            else return cur;
        }
        return nullptr;
    }

    // ...
};
增删逻辑跟key版本完全一样,因为增删始终是按key走二叉搜索树规则的;变的只是"查出来之后我们要拿value"。
拿单词计数来跑一下:给定一组水果名,第一次出现就插入<单词, 1>,已经存在就把次数++:
cpp
std::string arr[] = { "苹果", "西瓜", "苹果", "西瓜", "苹果", "西瓜", "苹果", "香蕉", "苹果", "香蕉" };
BST<std::string, int> countTree;
for (const auto& str : arr)
{
    auto ret = countTree.Find(str);
    if (ret == nullptr)
    {
        countTree.Insert(str, 1);
    }
    else
    {
        ret->_value++;
    }
}
countTree.InOrder();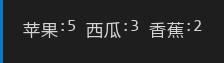
中序遍历输出苹果:5 西瓜:3 香蕉:2,次数统计正确,而且因为二叉搜索树的性质,输出天然按key有序。这其实就是后面STL中map的雏形------map底层就是一棵key/value结构的二叉搜索树。
七、总结
我们这篇从二叉搜索树的定义出发,先理解了"左小右大"这条规则为什么能把查找从O(N)降到O(logN),也看到了它退化成单支链时O(N)的缺陷,这为后面学AVL树和红黑树埋下了伏笔。
然后我们从零实现了三个核心操作:插入用parent指针定位空位;查找就是插入时的那一段比较逻辑;删除最复杂,需要分四种情况处理,左右孩子都不为空时用右子树最小值替代------这个替代法不仅让代码更简洁,还顺带解决了一个空指针崩溃的坑。最后我们区分了key和key/value两种搜索场景,看到节点多存一个value、Find改返回节点指针,就能从"只判断在不在"扩展成"根据key查value"。
二叉搜索树的本质,是用"左小右大"的顺序性把查找变成一条确定的路径;而所有的复杂操作,本质上都是在维护这条顺序性不被破坏。
如果觉得有帮助,可以关注Github项目持续更新