🔢 前言
Hello~大家好,我是秋天的一阵风
上周外网开发者圈在讨论一个"不会说话"的AI模型。
它来自一家叫 TypeSafe AI 的公司,隐身两年,第一次露面就带着 4000 万美元种子轮,DCVC 领投。创始人 Diogo Almeida 在 OpenAI 时参与过 InstructGPT 那一支研究,那批工作的目标,是让大模型听懂人话、把话说明白。
发布第二天,Vercel 宣布把它接进 AI Gateway,隔一天 Netlify 跟上。
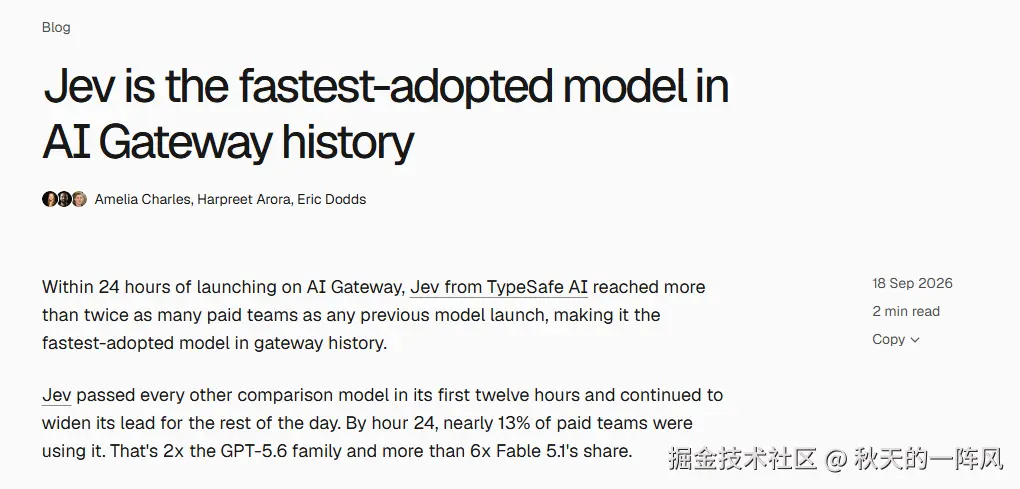
又过了两天,Vercel 发了篇博客,标题直译过来叫 "AI Gateway 史上采用最快的模型"。
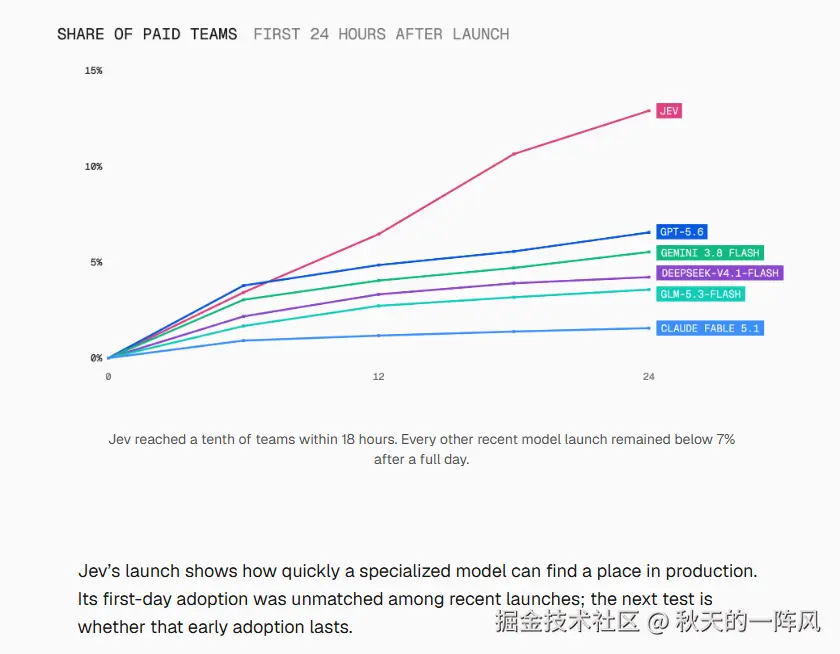
里面有个数据挺扎眼:上线 24 小时,接近 13% 的付费团队已经在用它,是之前任何一次模型发布首日的两倍多。
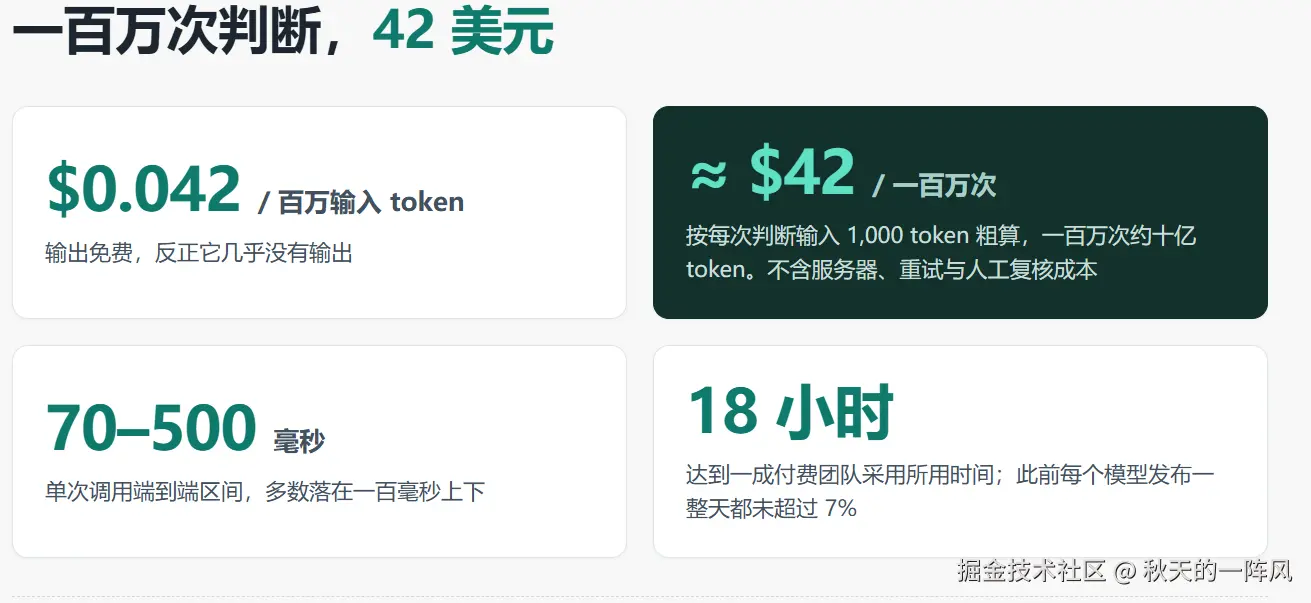
它便宜和快到什么程度?单次判断多数在一百毫秒上下,人眨一次眼要两三百毫秒;
每百万输入 token 收 0.042 美元,输出免费。
而它全部的本事,就是从你给它的选项里挑一个,不写文章,不生成代码,不陪你聊天。
一个什么都不会说的模型,为什么这么多团队愿意在发布当天就把它接进自己的系统??
它补的是 AI 应用最烦人的那块短板
因为现在的 AI 应用,太啰嗦了。
一个跑在线上的 AI 功能,用户只看到最后那段回答,但中间是一长串判断:这步该调哪个工具,检索回来的材料有没有用,这条操作要不要拦下来,出错了是重试、是问用户、还是直接停。
每一步都是一个模型在替你做主。
麻烦在于,这些帮你做主的家伙都特别擅长"思考"和"写文章"。
你只想知道"要不要拦",它非要先写一百多字的分析才肯收尾,你的程序只能在旁边干等。
等几十步走完,用户早把页面关了。而这一长串答案,一大半就值一个字。
Vercel 那篇博客里给 Jev 列的用法,正好就是这几件事:选下一个工具或者子智能体,决定流程是继续、重试、问人还是停,给紧急度和风险打个分,检查别的模型输出得对不对,没把握的转人工。
全是判断,没有一样需要它写文章。
TypeSafe 干的就一件事:只要判断,就别让模型写作文。
你给它材料,它给你数字
Jev 的使用方式很单纯:你把当前的情况交给它,同时告诉它你想知道什么、允许的答案有哪些,它把结果还给你。问法一共三种。
我用一条直播间弹幕来举例。假设其中一条是:"9.9 三袋真从仓库发?"
-
第一种,选择题,官方叫
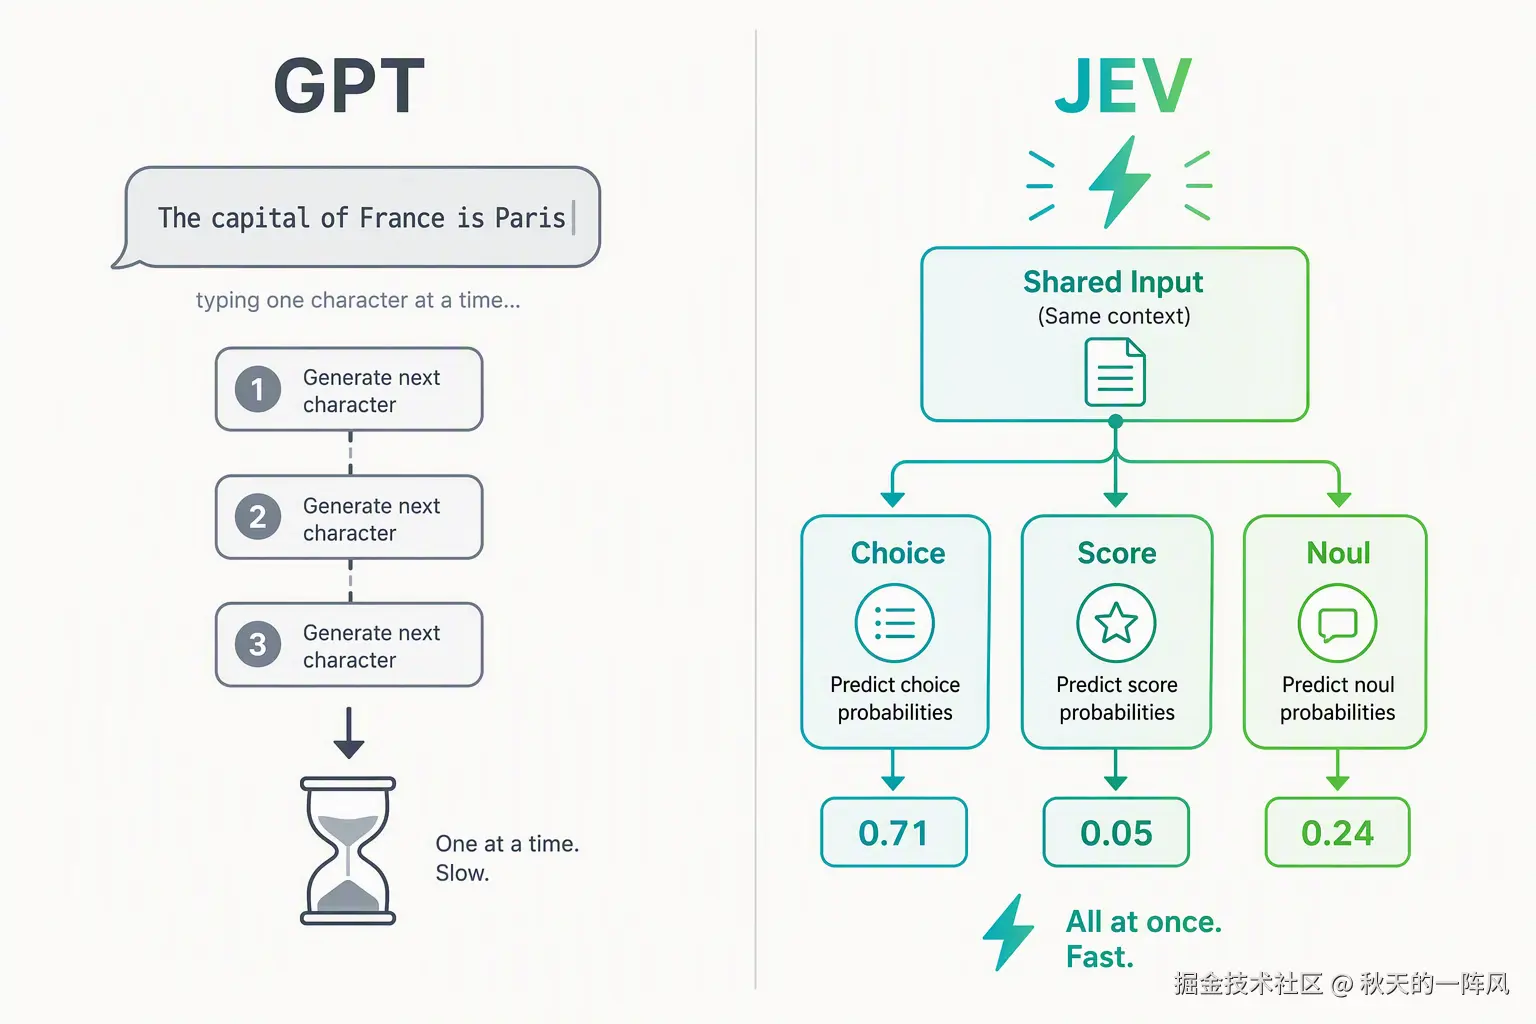
Choice。选项由你定义,比如 "问价 / 砍价 / 下单前确认" :它从中选一个,并把每个选项的概率一并给你:0.71、0.05、0.24。你给三个选项,它的回答就一定落在这三个里面。
-
第二种,打分题,
Score。你先定义一套标准,比如 1 到 5 分的购买意向,它给一个数。这个数可以卡在两档中间,4.3 是正常输出。
-
第三种,是非题,
Noul。一个是否问题,它返回 0 到 1 之间的概率。比如 "这条弹幕带不带售后情绪",答案可能是 0.12。
三种问法单看都不算新鲜,值得留意的是接下来这件事:它们可以放进同一次调用,一起算完。
对话模型回答三个问题,得写完第一题再写第二题,因为它的输出是一个字接一个字生成的。
Jev 不是这样。同一份材料只读一次,几个问题并行评估。
官方文档里的说法是,往同一个请求里继续增加问题,响应时间几乎不变。
你的程序于是会一次拿到一组结构化的数字,后面的处理逻辑完全由你来写:把握度高的直接执行,两个选项咬得紧的转给更贵的模型再看一遍,实在拿不准的交给人。
为什么又便宜又快
因为它不写。
大模型输出是一个字一个字往外蹦的,每个字都实打实计费。
你哪怕只要它说"A 团队",前面那几百字的过场也照样算钱。
Jev 是判别式的,不生成文本,直接给每个选项一个概率。省掉的恰恰是别人省不掉的那部分。
官方给的延迟区间是端到端 70 到 500 毫秒,价格前面说过,每百万输入 0.042 美元。
我们来把账算细一点:每次判断喂它 1000 个 token,一百万次判断大约十亿 token,42 美元。
你在外面请两个人吃顿像样的饭也就这个数,而这 42 美元换来一百万次判断。
同样这批小判断如果换成某家大模型的结构化输出,是几百到几千美元的量级。
哪里用得上,哪里千万别
判断一个任务适不适合交给 Jev,看三件事就够了:
- 这个判断要不要重复很多次;
- 答案的范围能不能提前列清楚;
- 判断的依据是不是自然语言。
三条都占,它就很合适。
Agent 内部是这类判断最密集的地方。一条流程里,选哪个工具、检索回来的十篇文档哪三篇跟问题真有关系、这一步要不要升级去问更贵的模型,这样的判断能出现几十次。
它们决定的是流程往哪走,如果全部交给负责整体流程的那个大模型,成本和延迟都不太划算。
反过来,有三种情况不适合,值得说清楚。
任务的产出是一段文字的,它做不了。写回复、写方案、写代码都不是它的活,它不生成文本。
需要精确计算或者查证事实的,别交给它。金额、日期、库存数量这些有唯一正确答案的东西,属于普通代码和数据库。
官方文档也把精确计算和日期比较直接列进了限制里。
调用频率低的,不值得为它多接一个服务。偶尔分一条工单,通用模型多花几百毫秒、多付几厘钱,谁都感觉不到。
这类模型的价值全建立在"次数多"上,量不够,省下来的那点东西盖不住接入和维护的开销。
最后
Jev 能做的事,我们现在用一句话来总结:你把情况和选项交给它,它回一个带概率的答案,不解释,也不生成文本。
我为什么觉得它值得写一篇。因为它把一笔一直没人算的账算清楚了:AI 应用里大量的模型调用,需要的只是一个词或者一个数,而这部分过去一直按"写作文"的价格付费。
当单价标到每百万输入 token 0.042 美元,很多原来舍不得加的判断、检查、分流就开始划算了。
这件事跟 Jev 这家公司关系不大,就算没有它,也会有别人来做。
至于它自己能不能做起来,我没有判断依据。首发的采用率能不能维持,大厂把类似能力做成自家低价档之后还剩多少空间,都需要时间给答案。