题目: TokenCom: Vision-Language Model for Multimodal and Multitask Token Communications
作者: Feibo Jiang, Siwei Tu, Li Dong, Xiaolong Li, Kezhi Wang, Cunhua Pan, Zhu Han, Jiangzhou Wang
**来源:**Jiang, F., Tu, S., Dong, L. et al. TokenCom: vision-language model for multimodal and multitask token communications. Sci. China Inf. Sci. 69, 200304 (2026).
论文地址:https://arxiv.org/abs/2603.00482(查看全文请点击原文链接)
摘要:视觉-语言模型(VLMs)凭借其在图像和文本理解方面的强大能力,为智能通信提供了坚实的基础。然而,它们的有效性受限于Token(词元)表示粒度的不足、过长的视觉Token序列和不足的跨模态对齐。为了克服这些挑战,我们提出了TaiChi,一种为Token通信设计的全新VLM框架。TaiChi采用双重视觉Token化器架构,处理高低分辨率图像,以协同捕捉像素级细节和全局概念特征。引入了双向注意力网络(BAN)来智能融合多尺度视觉Token,从而增强视觉理解并生成紧凑的视觉Token。此外,采用基于Kolmogorov--Arnold网络(KAN)的模态投影器,并结合可学习的激活函数,实现从视觉特征到文本语义空间的精确非线性对齐,最小化信息损失。最后,TaiChi被集成到一个多模态和多任务Token通信系统中,并配备联合VLM--信道编码方案。实验结果验证了TaiChi的优越性能,以及基于TaiChi的Token通信系统的可行性和有效性。
1. 引言
近年来,通信范式经历了深刻的变革,从比特级的精确复制转向Token(词元)的高效传输,这种范式被称为Token通信。该范式的核心目标是使接收方能够根据传输的Token准确地重建和解读发送方的意图,随着文本和图像等多模态数据的快速增长,这一需求变得尤为重要。为了解决这一挑战,VLMs作为关键技术应运而生,因为它们能够从多模态数据中提取并生成高级Token表示,因此展现出成为下一代智能通信系统基石的巨大潜力。通过将强大的视觉模型与大语言模型(LLMs)结合,VLMs能够将视觉信号映射为离散或连续的Token表示,这些表示与LLMs的语义空间对齐,从而为先进的多模态Token器和对齐奠定基础。然而,直接将现有的VLMs应用于Token通信仍面临以下几个挑战:
1)有限的Token表示粒度 **:**在Token通信中,Token器的主要任务是全面捕捉源视觉信息的"含义"。目前大多数VLMs依赖单一的低分辨率视觉Token器,无法同时捕捉全局信息和细节信息。这一限制使得视觉Token器无法根据通信任务的具体需求自适应地选择是传输全局特征还是细节特征。
2)过长的视觉Token序列 **:**为了使LLMs能够处理视觉信息,通常将高维的视觉特征编码为长序列的视觉Token。然而,过长的Token序列在有限的上下文长度和计算资源限制下难以完全建模,这往往会稀释或忽视关键信息,从而妥协多模态特征表示的完整性。此外,长Token序列会导致较大的通信开销,迫使模型截断或压缩视觉Token,这进一步加剧了传输过程中的Token信息丢失。
3)不足的跨模态对齐 **:**投影器将视觉Token与文本语义空间对齐,通常使用多层感知机(MLPs)进行语义对齐。然而,MLP的固定激活函数使得其很难有效建模视觉与语言之间复杂的非线性关系。此外,MLP固有的"谱偏差"问题优先学习视觉Token中的低频信息,这可能导致在投影过程中忽略高频视觉信息。
为了解决上述挑战,我们提出了TaiChi,一种高质量的VLM框架,可应用于Token通信,并作出以下关键贡献:
1)双重视觉Token器 **:**为了全面捕捉图像特征,我们设计了双重视觉Token器架构。该架构采用基于视觉变换器(ViT)的Token器,从低分辨率图像中提取全局特征,同时结合基于卷积的Token器,从高分辨率图像中捕捉细粒度的局部细节。这一互补设计建立了丰富的视觉表示基础,使得系统能够根据任务需求,灵活地以不同的粒度编码和传输图像信息。
2)双向注意力网络(BAN) **:**为了实现高层次和低层次图像特征的高效双向融合,我们提出了BAN。具体而言,BAN采用两条互补的注意力分支:一条分支使用高层次特征作为查询,从低层次表示中提取细粒度细节;另一条分支使用低层次特征作为查询,从高层次表示中捕捉全局概念信息。通过BAN,网络实现了全局特征和局部细节之间的相互增强。随后,进行池化和聚合操作,将两条流的空间分辨率对齐,并将它们的输出融合生成精炼的视觉表示。增强后的视觉Token共同捕捉全局特征和显著的局部细节,同时大幅减少了视觉Token的总数。
3)基于KAN的投影器 **:**为了实现视觉和语言模态之间的高效对齐,我们引入了Kolmogorov-Arnold网络(KAN)作为模态投影器。与MLP不同,KAN在网络架构中融入了可学习的激活函数,能够基于数据自动学习特征之间的最优非线性映射。其卓越的函数逼近能力和学习效率使得视觉Token在不同尺度上更平滑、精确地映射到LLMs的语义空间,有效减少了模态对齐过程中的信息损失,并确保了高保真度。
4)基于TaiChi的Token通信 **:**我们创新性地设计了一个以TaiChi为核心的先进多模态和多任务Token通信系统。我们采用了一种多模态和多任务指令调优策略,将不同的通信任务通过自然语言指令统一规范化为一个指令模板。这使得VLM能够高效学习和理解多个多模态任务。为了确保Token信息在物理信道上的稳健传输,我们进一步提出了联合VLM-信道编码方案。该方案优化了特征提取和信道编码过程,使得系统即使在信道噪声和干扰的存在下,依然能够保持卓越的性能,显著增强了整体的鲁棒性。
本文的其余部分组织如下:第二部分回顾了相关工作;第三部分介绍了TaiChi框架;第四部分展示了基于TaiChi的Token通信系统;第五部分描述了训练方法和数据;第六部分提供了实验设置和结果;第七部分总结了论文并讨论了未来的研究方向。
2. 相关工作
2.1 视觉语言模型
Liu等人提出的LLaVA模型通过其简洁的架构,建立了现代VLM的基础框架,该框架将视觉编码器与大语言模型连接。Liu还提出了开创性的"特征对齐预训练 + 指令微调"两阶段训练方法。Zhu等人的MiniGPT-4揭示了仅依赖大规模噪声数据进行预训练会导致生成内容质量较差的现象。他们通过加入使用高质量、小规模数据集的额外微调阶段,展示了数据质量在提高模型可靠性中的关键作用。为了应对处理高分辨率图像所带来的巨大计算成本,Bai等人提出了Qwen-VL系列,该系列引入了一种基于交叉注意力的视觉适配器。该适配器有效地将长视觉特征序列压缩为固定长度的短序列,从而显著提高了计算效率。此外,Chen等人的InternVL系列通过引入统一预训练的概念,彻底改变了训练范式,使得模型能够从一开始就共同学习语言和多模态能力。他们还开发了一种极其高效的视觉Token压缩技术,标志着VLM研究进入了更深层次的探索阶段。
2.2 Kolmogorov-Arnold网络
Liu等人提出的KAN为深度学习提供了一个全新的范式。然而,KAN的理论优势最初受到工程挑战的制约,如训练效率低下和稳定性差,这使得其在大模型中的应用变得困难。Yang等人提出的Kolmogorov-Arnold Transformer(KAT)通过采用适合GPU的基函数、提出分组共享机制并设计了新的权重初始化方案,解决了这些瓶颈。该系统性解决方案成功将KAN集成到Transformer架构中,并展示了其优越性。此外,Li等人将KAN引入U-Net的骨干网络,用于医学图像分割,取得了更高的准确率。Kiamari等人将KAN扩展到图结构数据,在图上的半监督学习任务中,其表现超过了传统的图卷积网络,达到了更高的准确性。
2.3基于VLM的语义通信
VLM在语义通信中的应用引起了越来越多的关注,特别是在处理多模态数据和提高通信效率方面的潜力。Ni等人提出了一种基于大模型的多任务语义通信(MTSC)架构。该架构通过集成增强检索生成方案,进一步提高了语义提取和内容生成的准确性。Du等人研究了一种基于多模态大语言模型(MLLM)的车辆AI助手,并提出了一种面向任务的语义通信框架,在较差的信噪比(SNR)条件下显著提高了问答准确性。Zhang等人介绍了一种新型的集成MLLM的语义通信框架,称为MLLM-SC。该框架通过一个重要性感知语义编码器和一个资源自适应语义解码器,优化了自适应带宽分配和高质量内容的重建或生成。Cao等人提出了一种隐私保护语义通信方案(MLLM-PSC),该方案利用MLLM的语义理解能力,将多模态数据统一转换为文本语义。
总的来说,尽管VLM及其在语义通信中的应用取得了显著进展,但它们在Token级视觉表示和随后的对齐方面仍然存在固有的局限性。此外,由于VLM参数规模庞大,Token通信的端到端设计和训练尚未得到充分探索。为了解决这些问题,本研究提出了基于TaiChi的Token通信作为一种有效的解决方案。
****3.TAICHI框架
我们首先介绍TaiChi框架,如图1所示,该框架包括一个双重视觉Token器、一个双向注意力网络、一个基于KAN的投影器、LLM和一个扩散模型。两个视觉Token器分别处理高分辨率和低分辨率图像,执行层次化编码,同时平衡全局特征和细粒度细节。随后,BAN在不同尺度的感受野下将微观级别的细节融入全局特征,有效地将两组视觉特征合并为紧凑且高效的视觉Token。这些视觉Token随后通过基于KAN的投影器映射到LLM的文本语义空间,并与原始文本Token一起输入到LLM中生成文本输出。当需要多模态输出(如图像、音频或视频)时,TaiChi进一步采用一种名为"指令扩散优化"(Instructional Diffusion Refinement,IDR)的方法,引导扩散模型生成高质量的多模态内容。
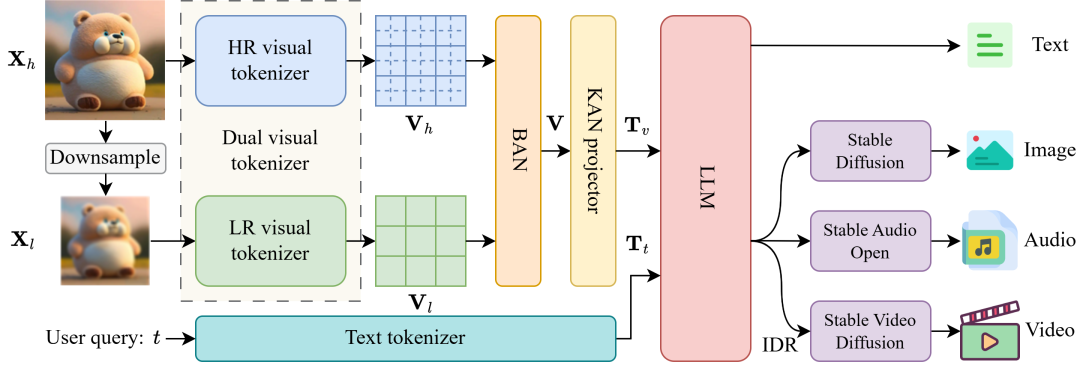
图1:所提出的TaiChi框架结构
3.1 双重视觉Token器
为了克服单一视觉Token器在图像信息表示中的局限性,特别是捕捉高级特征和保持细粒度细节之间的固有权衡,TaiChi框架设计了一种创新的双重视觉Token器架构。该架构旨在将图像的全局概念特征与局部细节的感知解耦,通过两个并行处理路径生成互补的视觉特征。如图1所示,原始高分辨率(HR)图像Xh 输入到一个专门优化用于捕捉细节的HR视觉Token器,而降采样后的低分辨率(LR)版本Xl 则传入一个专注于全局特征的LR视觉Token器。这种设计允许分别提取细节特征流 Vh 和全局特征流Vl,它们共同构成一个全面且信息丰富的视觉表示基础。
1)LR视觉Token器 **:**为了获得输入图像的强大全局特征,我们选择ViT模型作为LR视觉Token器。ViT将Transformer架构直接应用于图像任务,使用自注意力机制捕捉图像不同区域之间的长程依赖关系。这使得ViT能够提取丰富的视觉特征,增强模型理解图像全局特征的能力。在TaiChi框架中,我们利用这一能力有效地从低分辨率图像中提取核心主题和概念信息,从而生成强大的全局视觉特征流。
如图2所示,ViT模型由一堆L层Transformer编码器组成,其中多头注意力机制擅长捕捉图像序列中各位置之间的全局依赖关系,而MLP则独立处理每个位置的表示,捕捉细粒度的局部特征。此外,残差连接帮助信息绕过层,从而缓解了梯度消失和网络退化等问题,而层归一化标准化了每个子层的输出,改善了训练的稳定性和收敛速度。
具体来说,在每一层的多头注意力和MLP输出中,首先,输入图像 Xl 经过层归一化处理后,经过多头注意力机制计算,得到与输入图像相加的输出。如果是第一层,输入是原始图像 Xl,否则,对于其他层,输入为前一层的输出
,经过层归一化后再输入多头注意力机制,最后与前一层的输出进行相加。接着,MLP对多头注意力输出进行处理,首先通过一个全连接层和激活函数(GeLU)进行变换,然后将变换后的结果与多头注意力的输出进行相加,最终得到该层的输出。通过这种方式,网络能够在每一层中逐步提取图像的全局依赖关系和细粒度的局部特征,同时通过残差连接避免梯度消失问题,并使用层归一化来提升训练稳定性和加快收敛速度。
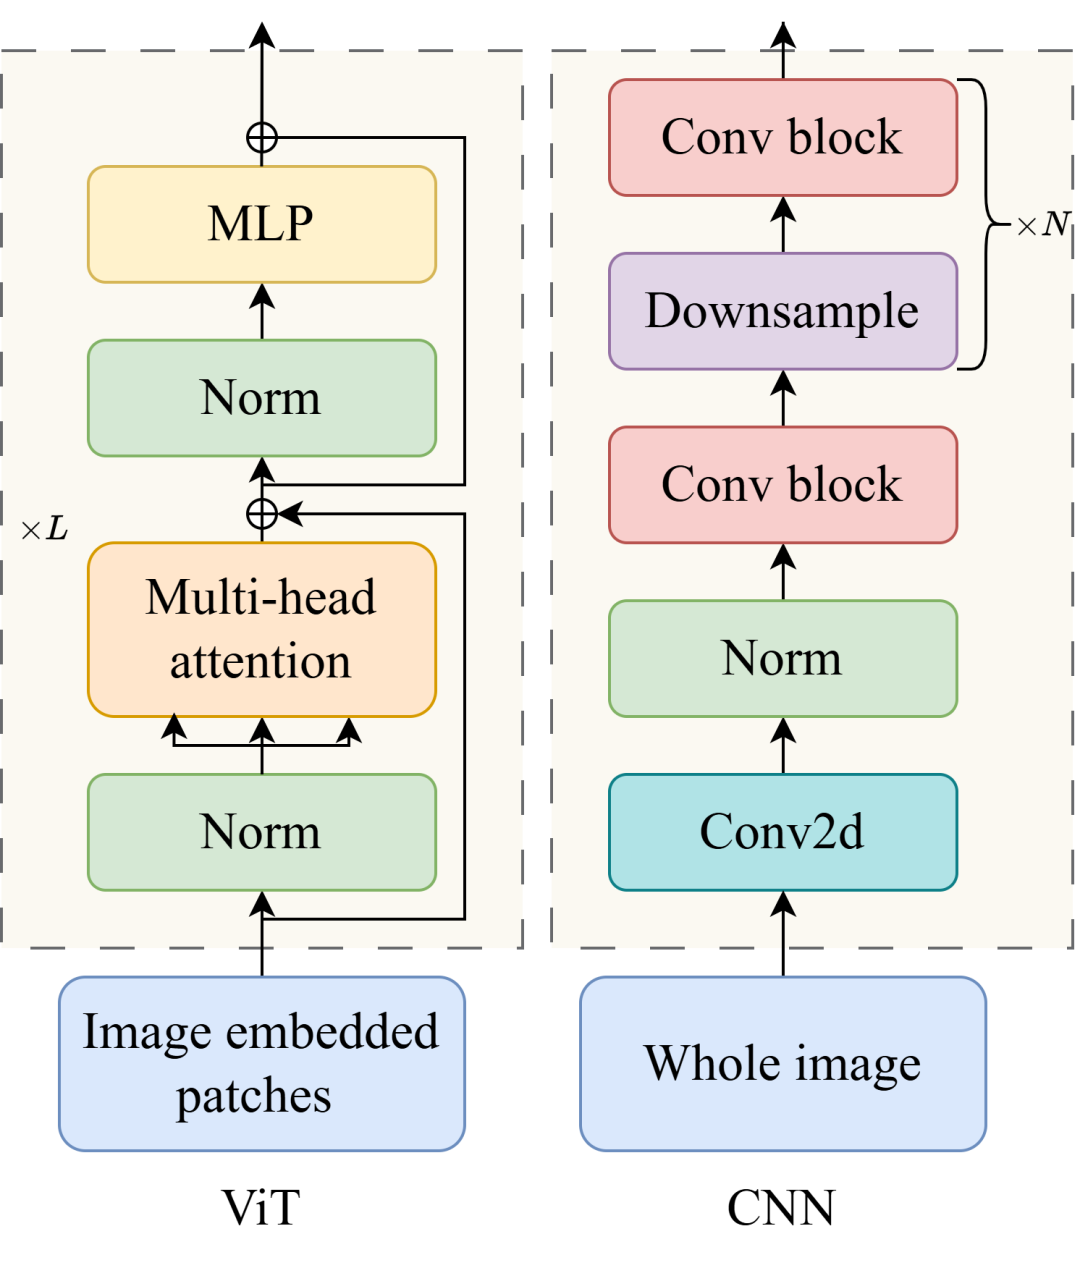
图2:双重视觉Token器架构
2)HR视觉Token器 **:**为了克服LR视觉Token器在捕捉细粒度特征方面的局限性,我们引入了现代卷积神经网络(CNNs)作为HR视觉Token器。CNN通过其固有的卷积操作,在从图像中提取局部细节信息方面非常有效,尤其是在高分辨率图像中,能够捕捉纹理、边缘和其他高频特征。卷积操作擅长在不同尺度上捕捉图像中的局部模式,并利用像素之间的局部依赖关系生成丰富的视觉特征。通过将卷积操作应用于高分辨率图像 Xh,我们能够充分利用CNN提取的多尺度局部信息,从而增强模型对细节的感知能力。
如图2所示,CNN使用一系列标准模块,如卷积块和下采样操作。卷积块通过滤波器滑动窗口从图像中提取局部特征。此外,CNN通常包括归一化层,以增强训练的稳定性并缓解梯度消失等问题。通过这些模块的组合,CNN逐步从图像中提取并整合多层次的特征,形成一个强大的细节特征流 Vh,表示通过卷积操作和下采样处理后,从高分辨率图像中提取的局部特征。具体来说,图像通过卷积操作进行处理,然后进行下采样,再通过卷积和归一化操作,最终生成的细节特征流。这个细节特征流包含了图像中的细粒度信息,是通过逐步提取和整合不同尺度的局部特征而得到的。
最终,LR视觉Token器提供关于图像表示的全局特征编码,回答"图像代表什么";而HR视觉Token器则通过细节特征编码补充了图像的组成和位置,回答"它是如何组成的"和"它的位置在哪里"。这两个视觉Token器协同工作,赋予TaiChi超越单一视觉Token器的全面视觉理解能力。
3.2 BAN
在双重视觉Token器分别提取高层次和低层次特征之后,关键的挑战在于如何高效且有效地将它们整合在一起。为了解决这个问题,我们提出了BAN,旨在实现两个特征流之间的细粒度和语义一致的交互。具体而言,BAN由两条互补的注意力分支组成:(1)自上而下的分支,其中高层特征 VhV_hVh 作为查询,选择性地从低层特征图 Vl 中提取相关的局部细节;(2)自下而上的分支,其中低层细节特征 Vl 作为查询,从高层特征流 Vh 中捕捉全局概念信息。通过这种双向注意力交互,模型能够同时实现特征精炼和细节恢复。
与传统的全局交叉注意力(CA)不同,后者计算所有Token之间的密集交互,BAN则执行局部空间对应注意力。每个Token仅关注其在另一个特征流中空间上对齐的区域,从而减少了冗余计算,同时保持空间一致性。这种基于精确对应的融合使得模型能够增强重要区域,如物体的边缘、边界和细微纹理,同时有效抑制不相关的背景噪声。因此,模型的判别能力和计算效率得到了提升。
1)自上而下的局部注意力 **:**在自上而下的分支中,高层特征引导空间上对应的细节提取。设 Vh 和Vl 分别表示高层和低层特征图。对于每个空间位置 i,高层Token Vh,i 查询空间上对齐的低层细节Token Vl,i,以获得增强的Token表示 Vh,i′。
具体而言,通过计算高层Token与低层Token之间的注意力权重,使用Softmax函数对查询、键和值进行加权求和,从而得到增强的高层Token表示。该过程通过计算高层和低层特征之间的局部空间对应关系,使得每个Token能够"检查"其局部区域,并整合最相关的细粒度细节。这种一对一的对应关系确保了高层特征和低层细节的有效融合。
2)自下而上的局部注意力 **:**相反,自下而上的分支允许低层细节特征从高层表示中提取语义指导。与之前的过程类似,在细粒度层次上,单个Token Vl,i 仅与其对齐的位置进行交互,增强的Token表示Vl,i′ 可以表示为:
通过计算低层Token与高层Token之间的注意力权重,使用Softmax函数对查询、键和值进行加权求和,从而得到增强的低层Token表示。此过程使低层特征能够有效地从高层语义信息中获得指导,从而增强低层特征的表达能力。
**3)特征融合:**在执行双向注意力之后,BAN通过池化和残差聚合将增强的高层和低层特征进行融合,如图3所示。最终的融合表示 V 由低层特征 Vl、增强后的低层特征 Vl′和池化后的高层特征 Vh′共同组成。具体来说,低层特征 Vl和增强后的低层特征 Vl′被直接相加,而池化后的高层特征 Vh′则经过池化操作后与其余特征进行融合。这个过程生成了一组高质量的视觉Token,这些Token共同编码了语义抽象和细节保真,为后续的跨模态对齐提供了紧凑而富有表现力的输入。
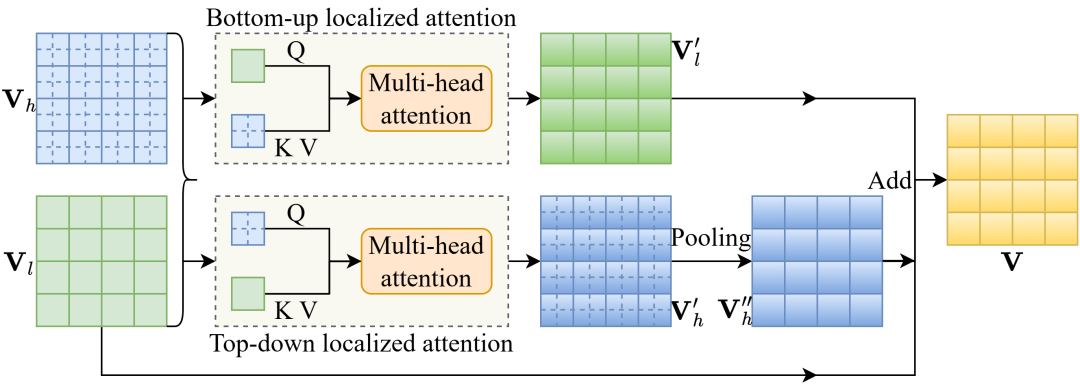
图3:BAN的计算流程
3.3 基于KAN的投影器
在将视觉信息集成到LLM中时,模态投影器起着至关重要的作用。其核心任务是将视觉Token器提取的高维复杂视觉特征映射到LLM可以理解的词嵌入空间。传统上,由于其简单的结构和作为通用函数逼近器的理论性质,MLP(多层感知机)被广泛采用。然而,MLP在表达能力上存在实际局限,特别是在使用分段线性激活函数(如ReLU)时,这些激活函数难以高效逼近具有复杂周期性或高频特征的函数。此外,基于梯度下降的训练方法导致了"谱偏差"问题,即网络倾向于优先学习目标函数的低频分量,而高频信息的收敛速度较慢。当处理富含复杂细节的视觉特征时,这个问题可能导致关键细节在投影过程中被平滑或丢失。
为了克服这些局限,TaiChi框架引入了KAN作为一种具有表达能力的替代投影器。KAN的设计灵感来源于Kolmogorov-Arnold表示定理,该定理指出,任何在有界域上定义的多变量连续函数f(⋅) 都可以表示为一组复合单变量连续函数的有限和。
具有 din 维输入和 dout 维输出的Kolmogorov-Arnold层表示为:输入数据 x经过一组基函数φ 的变换,得到输出。每个输出维度是输入各个维度经过相应基函数处理后的加权和,其中加权系数是通过输入特征的不同维度与基函数相互作用计算得到的。这一过程通过多个基函数的组合,构建出输入与输出之间的复杂映射关系。
具体来说,每一层的输出由输入数据与一组简单函数φ(⋅) 经过加权后得到。在实际应用中,激活函数使用 SiLU 和 B-spline 函数,其中 SiLU 用于处理线性参数,而 B-spline 则用于通过加权基函数组合非线性特征。SiLU 激活函数通过将输入与一个 Sigmoid 激活函数结合来增强模型的表达能力,而 B-spline 则通过加权组合多个基函数来进一步增强模型的非线性映射能力。KAN 的结构如图4所示。
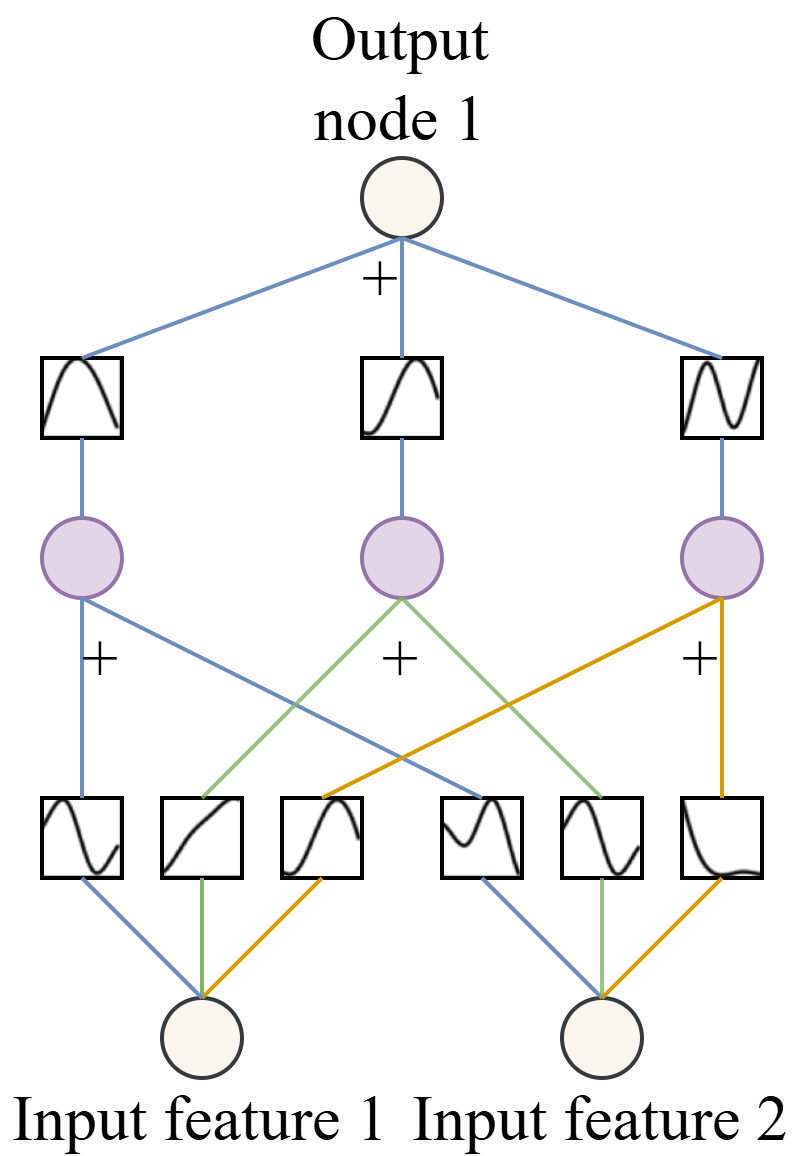
图4:KAN 的结构图
3.4 指令扩散优化(IDR)
尽管将LLM的文本输出直接用作扩散模型的提示输入是一种直观的实现VLM端到端多模态输出的方法,但由于LLM的文本生成逻辑与扩散模型生成需求之间存在"语义差距",这一策略面临显著的性能瓶颈。扩散模型中的文本编码器通常使用基于CLIP的图像-文本对比学习进行训练,这有效地捕捉了高级语义概念,但在提供精细的生成指令(如物体数量、空间排列以及复杂属性组合)方面存在不足,而这些对于精确的图像合成至关重要。为了解决这一问题,TaiChi框架提出了一种由LLM驱动的提示优化策略,称为IDR(指令扩散优化)。通过利用LLM在语言理解、推理和重写方面的能力,IDR在内部优化并扩展初始文本指令,而无需重新训练扩散模型,从而提高了生成质量和性能。
IDR的具体实现是一个两阶段的内部过程。首先,当接收到用户对非文本模态输出(如图像、音频、视频)的指令时,LLM生成一个初步的文本输出。然后,系统并不是直接将文本输出传递给扩散模型,而是调用一个预设的结构化指令模板,启动LLM的内部"提示自优化"任务。该模板作为一组详细的元指令,指导LLM根据一系列优化原则重构文本。这些原则包括指示LLM清晰阐明核心目标,将复杂任务分解为简单描述,并使用具体的而非抽象的指令。模板鼓励LLM在保持原始意图和语气的同时,丰富提示中的关键细节。
****4.TAICHI驱动的Token通信
利用TaiChi框架出色的多模态处理能力,我们构建了一个先进的多模态和多任务Token通信系统。首先,我们解释了TaiChi的各个组件如何作为Token通信系统的核心部分发挥作用,包括双重视觉Token器、BAN和KAN投影器等关键组件,分别负责视觉特征理解和跨模态投影。这些组件与LLM协作,形成一个高效的端到端Token通信系统。接着,为了赋予系统处理多样任务的灵活性,我们重点介绍了所采用的视觉-语言多任务指令微调策略,阐明了系统如何通过理解自然语言指令执行不同的通信任务,如视觉问答(VQA)和图像描述生成。
4.1 系统模型
所提出的Token通信系统由三个主要部分组成:发射器、接收器和物理信道,如图5所示。
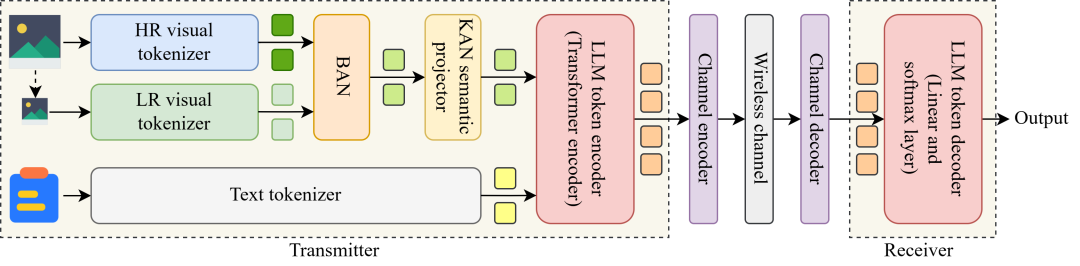
图5:TaiChi驱动的Token通信系统结构
1)发射器 **:**发射器的第一阶段集中在从视觉模态中提取和对齐Token信息。给定输入图像 I(其尺寸为高度 H、宽度 W 和通道数 C),首先生成一个降采样的图像版本 I′,以捕捉补充性的全局特征。接着,采用两个视觉Token器,分别表示为 Vl(⋅) 和 Vh(⋅),分别从图像 I 和 I′ 中提取多层次的视觉Token表示。这两个视觉Token器的输出通过双向注意力网络Bε(⋅) 与参数集ε 进行融合和增强,能够有效地建模不同视觉Token之间的细粒度交互。然后,引入一个基于KAN的投影器Pζ(⋅) 和参数集 ζ,将融合后的视觉Token表示映射到文本语义空间,从而实现与基于语言的表示的对齐,最终生成的视觉Token序列 Zv 。
与视觉处理并行,文本查询 t通过文本Token器Eθ(⋅) 进行转换,得到一个向量表示,该文本Token器将输入文本转换为一系列位于与投影视觉Token相同语义空间中的语言Token。然后,具有参数集α的多模态Token编码器Sα(⋅) 将视觉Token Zv 和文本TokenEθ(t) 进行集成,生成统一的多模态Token表示。该表示捕捉了图像的内容和文本查询表达的意图,并作为要传输的高级Token信息。高级Token序列 Z 就是视觉和文本Token经过集成后的最终表示。
发射器的最后阶段执行信道编码,以确保多模态Token表示在物理信道上的稳健传输。信道编码器Cβ(⋅) 通过将多模态Token序列 Z 映射为适用于实际信道约束的信道符号序列 Y,最终得到编码后的符号序列。
**2)物理信道:**发射器发送经过编码的符号 Y,这些符号通过物理信道传输到接收器。接收器的信道输出序列Y^ 可以表示为信道增益 H 与发射器发送的符号 Y 的乘积,再加上加性白噪声 n。
3)接收器 **:**接收器与发射器类似,包含两个主要部分:信道解码器和Token解码器。信道解码器的任务是将接收到的符号转换为Token信息,而Token解码器则根据这些Token信息生成最终的文本输出。具体来说,信道解码器对接收到的符号进行解码,得到信号,然后Token解码器进一步处理这些解码后的信息,生成最终的输出文本。
为了保证VLM的性能,至关重要的是保持输出 o 与真实答案t^ 之间的语义一致性,其中 t 代表与问题 t 对应的真实答案。我们使用交叉熵(CE)作为损失函数,来度量输出与真实答案之间的差异。交叉熵损失函数衡量的是预测的词汇概率与真实词汇概率之间的差异。
通过最小化交叉熵损失,系统可以学习如何理解与问题 t 对应的真实答案t^,并确保其在语义、逻辑和概念上的一致性。因此,Token通信系统的目标是确定Token编码器/解码器、信道编码器/解码器、BAN 和 KAN 投影器的参数,分别记为 α∗、β∗、γ∗、δ∗、ε∗、ζ∗,以最小化预期的失真,即最小化交叉熵损失。在这个过程中,通过优化这些参数,系统能够提高生成的文本与真实答案之间的匹配度,从而保证高质量的多模态通信效果。
4.2 视觉Token压缩
从Token通信的角度来看,BAN 在高质量视觉Token压缩中发挥着核心作用。BAN不仅仅作为一个简单的特征融合模块,它还充当了一个动态且任务驱动的Token压缩器和增强器。通过根据通信任务的隐含需求,自适应地将关键的细粒度细节融入全局概念表示中,BAN有效地抑制了冗余的视觉信息,同时突出了与任务相关的组件。因此,BAN能够生成紧凑且信息丰富的视觉Token,实现高保真度和高效率的端到端Token传输。
4.3 跨模态Token对齐
在视觉Token融合之后,KAN作为高保真度的投影器,能够实现精确的跨模态对齐。通过利用可学习的激活函数,KAN自适应地构建从视觉特征到文本嵌入的复杂非线性映射,显著减少了模态转换过程中信息的丢失和失真。这一设计确保了BAN所保留的细粒度细节和复杂空间关系能够忠实地传输到LLM,为后续的理解和推理提供更精确和全面的Token输入,从而最终提高系统在复杂多模态通信任务中的准确性和鲁棒性。
4.4 LLMToken编码
在Token通信系统中,LLM负责对多模态输入进行深层次的Token理解。为了适应发射器-接收器架构,LLM被分解为Token编码器和Token解码器,形成了传输通道的智能核心。在发射器端,多模态Token被输入到多个Transformer编码器层中,在这些层中,多头自注意力机制和MLP网络能够实现跨模态特征融合,并建模Token之间的复杂内在关系。因此,Token编码器生成一个统一的、高层次的多模态Token表示,封装了传输信息的核心意图,并作为信道编码器的输入。
4.5 LLMToken解码
在接收器端,Token解码器负责从接收到的Token表示中重建有意义的输出。具体来说,解码后的Token向量通过线性投影映射回词汇空间,随后通过Softmax函数生成候选Token的概率分布。基于该分布,Token解码器自回归地生成可读的文本。这个解码过程聚焦于精确信息生成,确保重建的输出忠实地反映发射器传达的原始意图。与LLMToken编码共同工作,这一功能分解清晰地定义了Token通信的两个关键阶段------发射器端的深度理解和编码,以及接收器端的精确解码和生成------形成了一个高效的端到端Token通信循环。
从Token通信的角度来看,LLM赋予Token编码器高度的灵活性,任务指令作为LLM的高级控制信号,指导适应性的信息提取和不同任务的编码。例如,在视觉问答任务中,编码器专注于关键物体和细节,而在图像描述任务中,它则强调整体场景和主要元素,从而增强信息的相关性并优化通信资源的利用。此外,这一策略确保了通信意图的端到端对齐,使得Token解码器的输出能更准确地反映发射器的原始意图。因此,它将TaiChi框架提升为一个实用、灵活且高效的多模态多任务Token通信系统。
5. 阶段性训练
整个系统的训练分为两个阶段:第一阶段集中于训练VLM模型,而第二阶段则涉及Token通信系统中VLM和信道的联合编码训练。
5.1 VLM训练
TaiChi的训练分为两个阶段,逐步引入更高质量的数据,并逐渐解冻模型的更多部分,以提高训练过程的效率和稳定性,如图7所示。
1)预训练 **:**这一阶段的主要目标是校准骨干网络并初始化新引入的参数的训练,从而提供稳定的特征表示能力,并增强对后续任务中分布外数据的鲁棒性。在训练过程中,仅更新BAN和KAN投影器,而其他所有组件保持冻结。这一过程可以看作是为冻结的LLM训练一个兼容的视觉Token器。使用的训练数据集包括LAION和ALLaVA,这些数据集涵盖了大规模的跨模态语料库,确保模型能够获得广泛的视觉-语言知识。损失函数为交叉熵损失(CE损失),仅在响应部分计算。
2)监督微调(SFT) **:**为了增强TaiChi驱动的Token通信系统在多样任务中的灵活性和适应性,我们采用了多模态和多任务的指令微调策略。其核心思想是将不同的多模态任务统一为结构化的指令格式,从而在任务之间促进正向知识迁移,同时减轻多任务学习中的灾难性遗忘,提升系统的多功能性和泛化能力。
在实际应用中,我们为各种通信任务(如图像描述、VQA)设计了自然语言指令模板,明确任务目标、背景和期望的输出格式。在训练过程中,多任务数据与多样化的指令混合,使得模型不仅能够掌握任务特定的解决方案,还能获得跟随指令的能力,从而促进跨任务能力迁移并提高整体性能。如图6所示,当用户启动任务时,他们的请求以结构化的指令格式呈现,例如:
对于图像描述任务,完整的对话与指令可能如下:
- Instruction**:**"Please carefully observe the provided image and identify the main elements, including the scene (e.g., indoor, outdoor, city, nature, etc.), key objects (e.g., animals, people, buildings, tools, etc.), and any actions or activities (e.g., running, eating, reading, etc.). Based on this information, generate a natural language description that covers the key details of the image. Ensure the description is fluent, grammatically correct, and avoids excessive speculation, only describing what can be clearly observed in the image."
- Input Image: Image 1.
-
****Input:"Image caption."
-
Output: "This image features two tall, blue-skinned humanoid figures, likely from the movie Avatar, against a vibrant, lush alien jungle backdrop with floating mountains and bioluminescent flora. The female figure in the foreground has long, braided hair adorned with feathers, while the male figure behind her has shorter, dark hair."
对于VQA任务,完整的对话与指令可能如下:
- Instruction**:**"Please observe the provided image and read the question carefully to understand its specific requirements. Based on the content of the image, answer the question, ensuring that the answer is based on clearly observable information. If the question involves specific details (e.g., quantity, color, location), provide precise answers. If the question cannot be answered based on the image, respond with: 'Cannot obtain an answer from the image.' Finally, provide a concise and clear answer that fully satisfies the requirement of the question."
- Input Image: Image 2.
-
****Input:"What is Spider-Man doing?"
-
Output: "In the image, Spider-Man is depicted mid-air, swinging on a web line that is clearly visible coming from his left wrist. He is in an action pose, seemingly navigating through a rainy urban environment at night."
部分数据集来自Cauldron,格式化为标准化的问答结构,其中多个问答对针对单一图像组织为多轮对话。交叉熵损失(CE损失)再次被采用,仅在响应部分计算,以确保优化关注于提高输出质量。
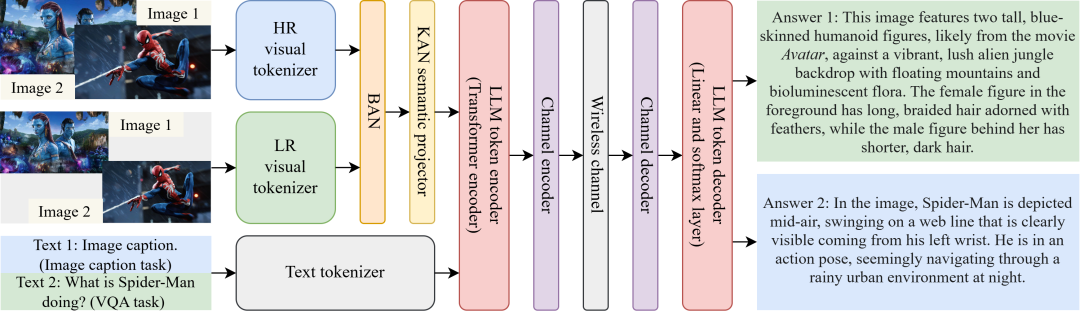
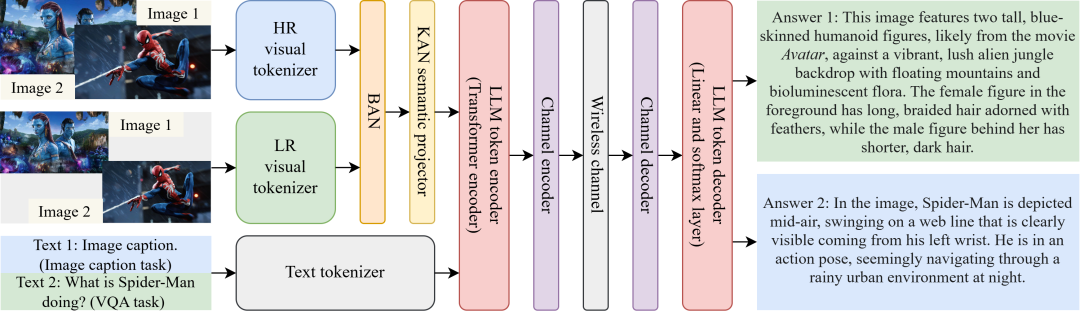
图6:TaiChi的不同多模态任务示例
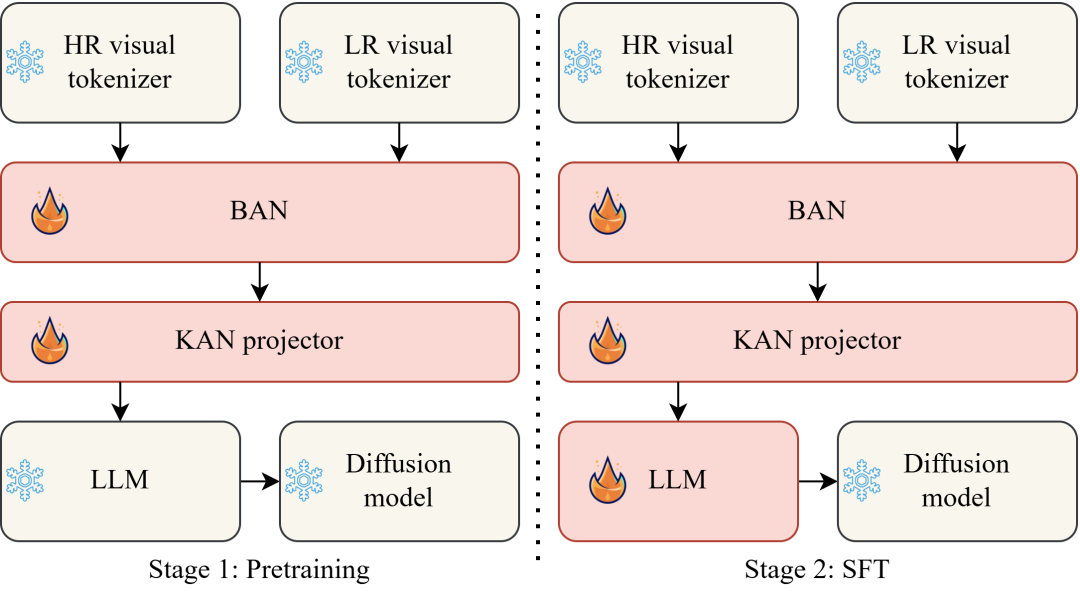
图7:TaiChi的两个训练阶段
5.2 联合VLM-信道编码
在联合编码阶段,我们将优化后的TaiChi模型与信道编码器-解码器结合进行联合编码。此阶段的重点是提升Token通信系统的整体性能。在联合VLM-信道编码过程中,我们允许BAN、KAN和信道编码器-解码器进行完全更新,以适应复杂的信道条件。同时,我们使用LoRA对LLM进行微调。这一策略显著降低了训练成本,同时保持了模型的性能,如图8所示。
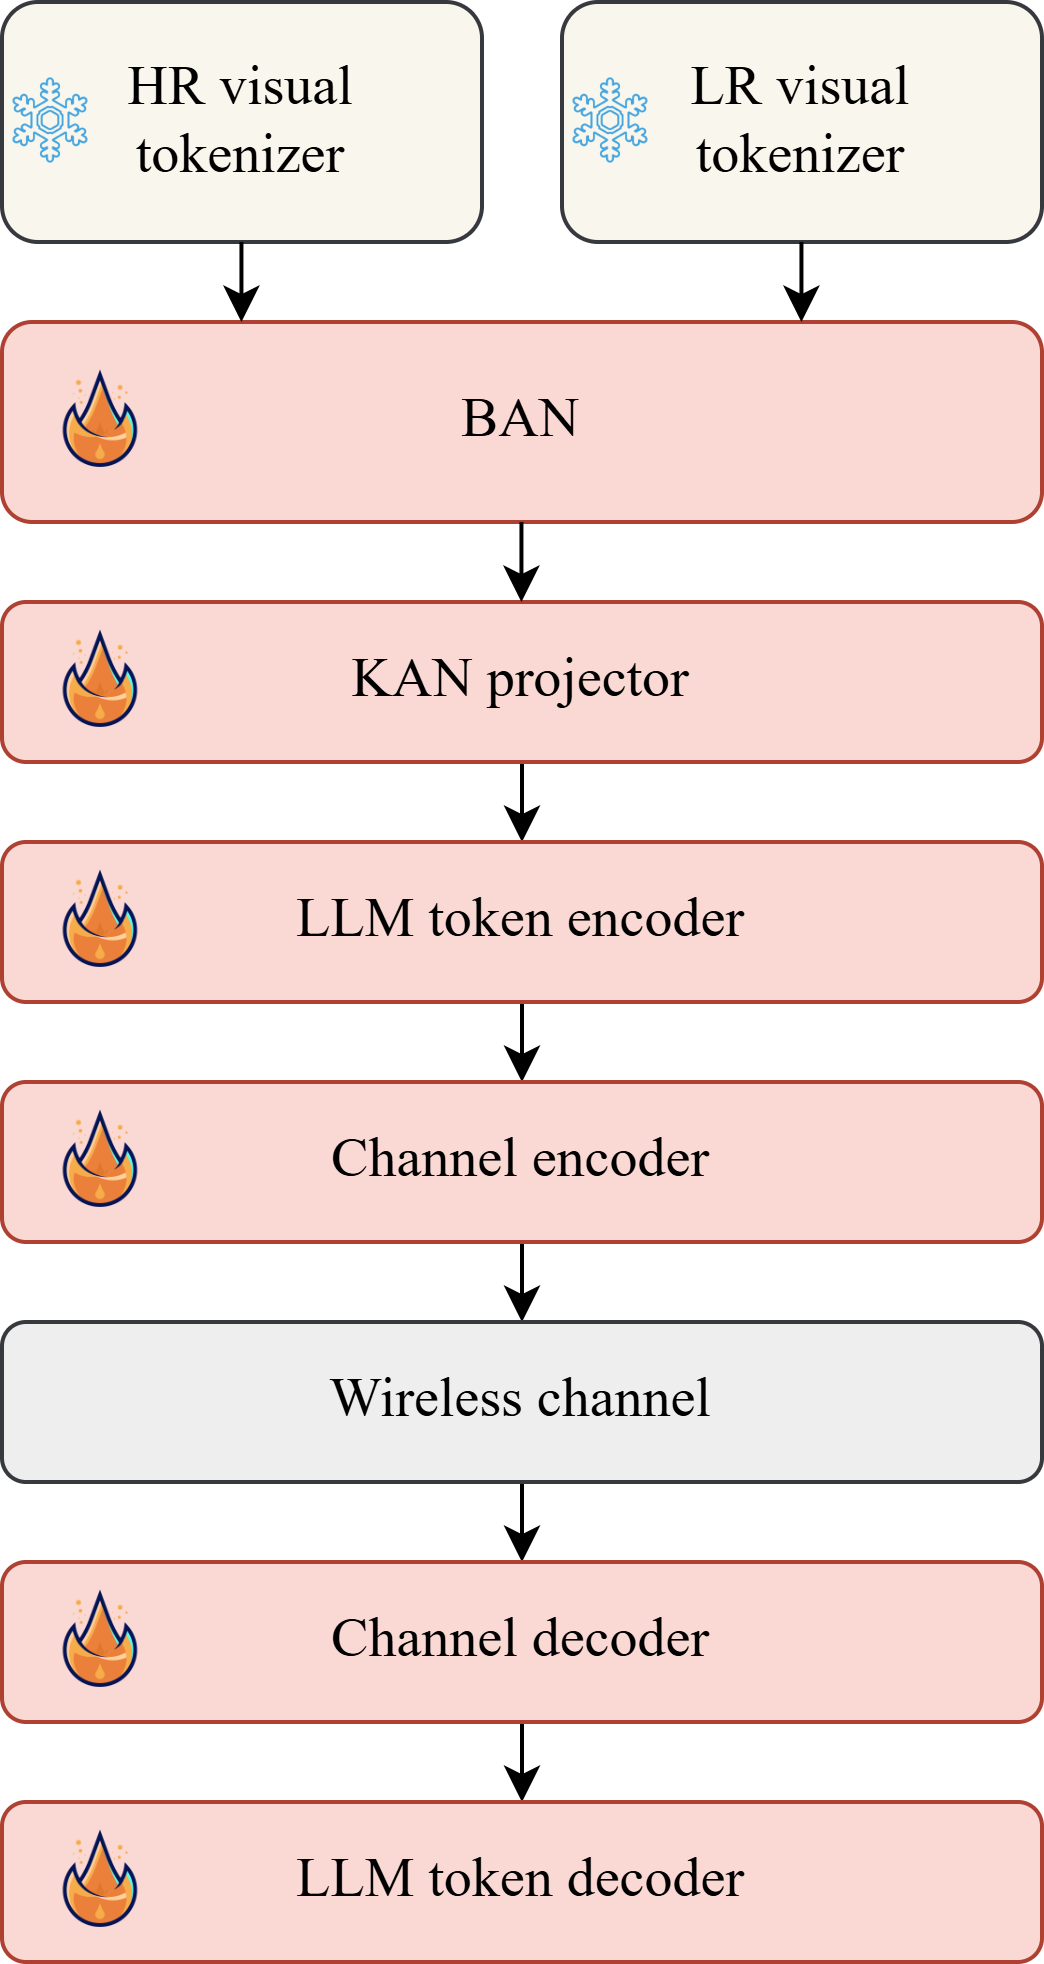
图8:TaiChi驱动的Token通信系统的联合编码过程
6. 实验结果
在本节中,我们评估了TaiChi模型和TaiChi驱动的Token通信系统在多个基准测试上的表现,并提供了每个组件的分析以及定性结果。
我们分别使用LLM模型Gemma-2B-instruct和Qwen-2.5-14B-instruct训练了两个版本的TaiChi。同时,LR视觉Token器使用的模型是CLIP-ViT-large-patch14-336,而HR视觉Token器使用的模型是CLIP-ConvNeXt large d 320。
在训练设置方面,我们采用了AdamW优化器和余弦学习率调度,并对所有模型进行了一个轮次的优化。预训练和SFT的初始学习率分别设置为1e-3和2e-5,以确保训练的稳定性。预训练和SFT的全局批量大小分别设置为256和128。训练和测试在一台配备Intel Xeon CPU(2.6 GHz,1007 GB RAM)和8*NVIDIA A800 GPUs(80 GB SGRAM)的服务器上进行。使用的训练框架是PyTorch,采用的分布式训练策略是DeepSpeed ZeRO-2。
6.1 零样本评估在多模态基准上的表现
为了全面评估TaiChi框架在零样本条件下的核心性能,我们在多个广泛认可的多模态基准测试上进行了对比实验。此评估旨在验证TaiChi模型设计的优越性以及其在处理多样任务时的泛化能力
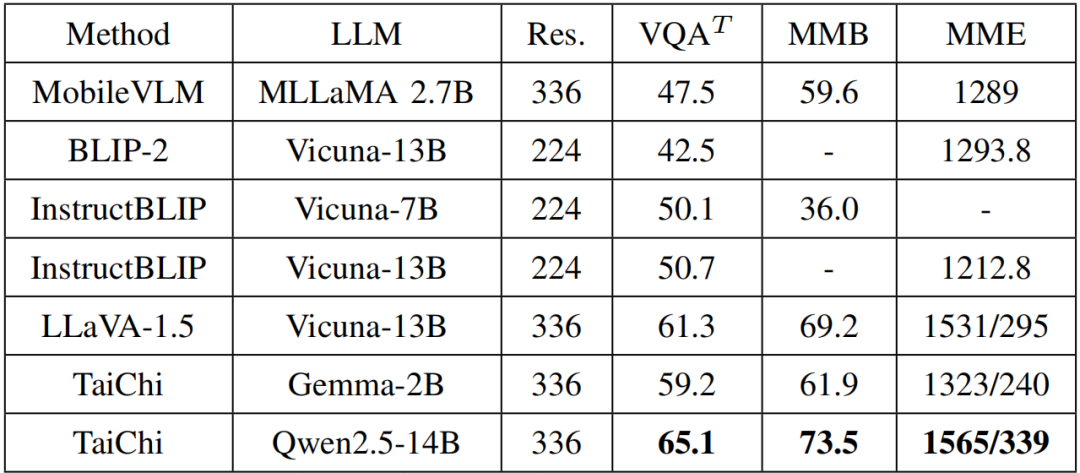
为了进行客观评估,我们将TaiChi与多个最先进的VLM模型进行了比较,包括轻量级的MobileVLM,以及广泛使用的模型,如InstructBLIP、BLIP-2和LLaVA-1.5。性能评估涵盖了多个权威的多模态基准,包括VQAT、MMB和MME,这些基准共同评估模型在VQA、多模态理解和推理等方面的能力。
如表1所示,实验结果清晰地展示了TaiChi框架的优越性能。在配备Gemma-2B作为LLM时,TaiChi不仅超越了高效的MobileVLM,还超过了由更大LLM(如Vicuna-7B和Vicuna-13B)驱动的InstructBLIP模型。此外,在与更强大的Qwen2.5-14B LLM集成后,TaiChi展现出了强大的扩展性。在相同LLM配置下,TaiChi在所有基准测试中均明显高于LLaVA-1.5的得分。TaiChi的卓越表现主要归功于其创新的核心架构设计,有效克服了现有VLM在视觉信息处理和模态对齐中的局限性。
表1:零样本基准测试比较
6.2 BAN 和 KAN 的消融实验
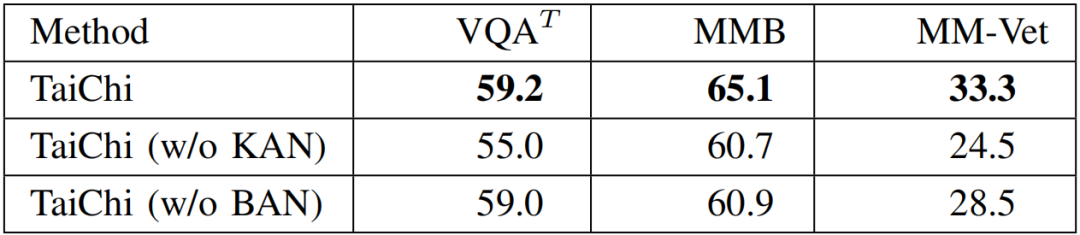
为了验证两个核心组件------BAN和KAN投影器的有效性,我们进行了系列的消融实验。通过将这些模块替换为更基础的替代方案,我们评估了它们对模型整体性能的单独贡献。具体而言,我们构建了两个TaiChi的变体:(1)TaiChi(无KAN),其中KAN投影器被传统的MLP投影器替换;(2)TaiChi(无BAN),其中移除了BAN。所有变体都在与完整版本TaiChi相同的Gemma-2B配置下进行评估。评估数据集包括VQAT、MMB和MM-Vet。
如表2所示,移除任何核心组件都会导致在各个基准测试中的性能显著下降。在这些变体中,TaiChi(无KAN)的表现最差,强有力地证明了KAN投影器在实现高保真跨模态对齐中的关键作用。类似地,TaiChi(无BAN)的表现低于完整的TaiChi模型,突显了BAN在高效融合多尺度视觉特征中的重要性。总之,这些消融实验清楚地表明,我们提出的每个组件对TaiChi框架的成功至关重要,它们的协同作用共同提升了模型的整体性能。
表2:TaiChi关键组件的消融实验
6.3 Token通信性能评估
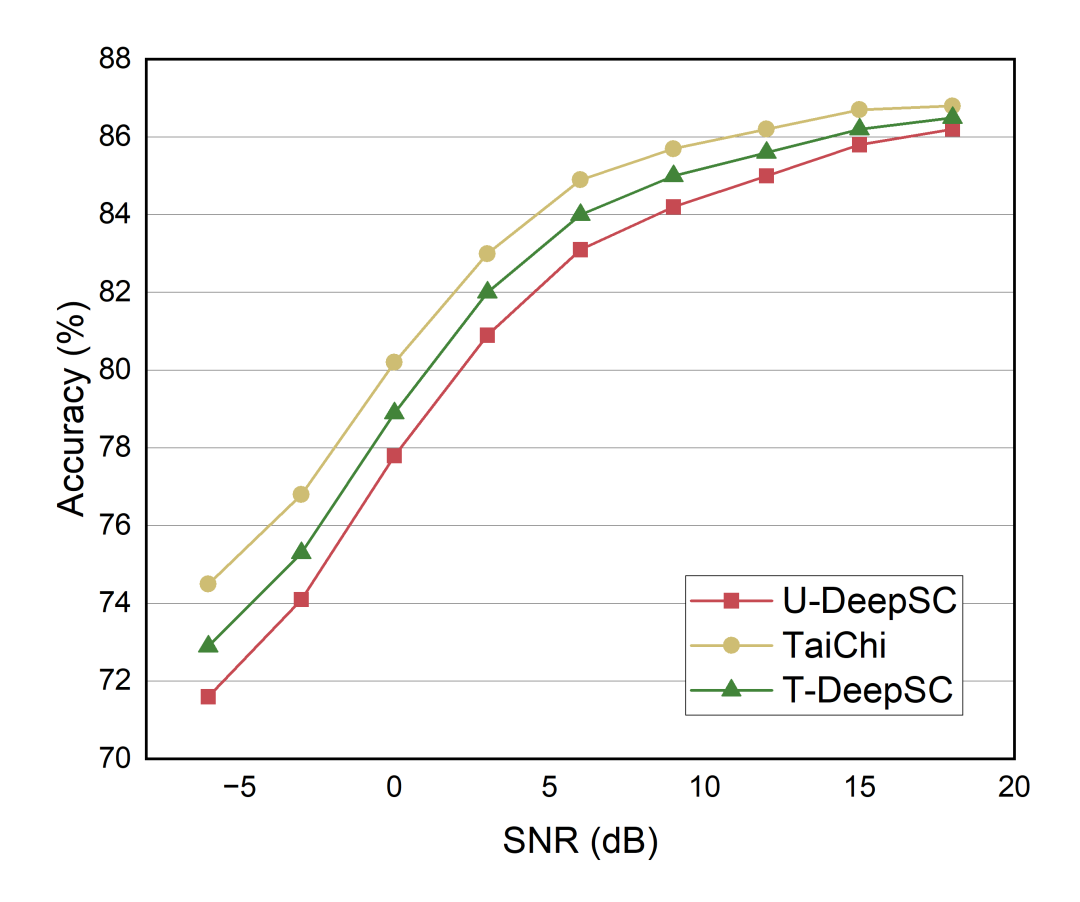
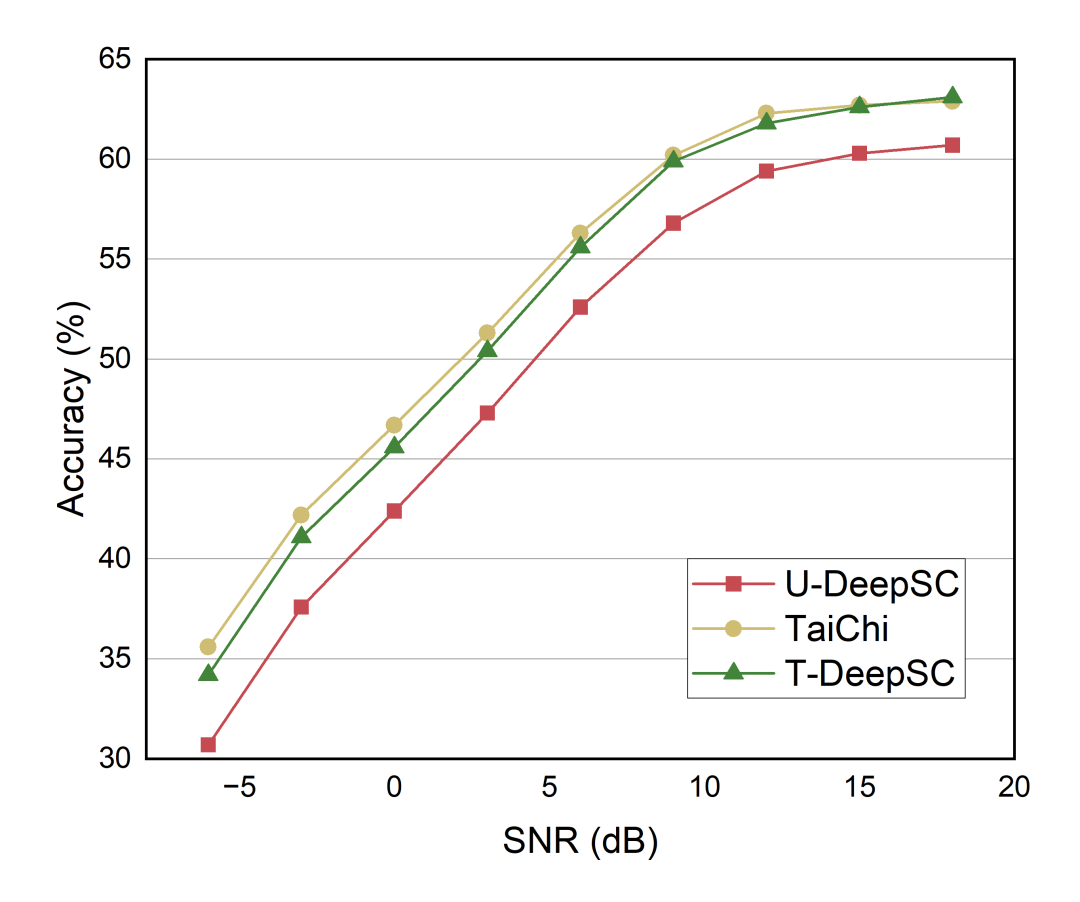
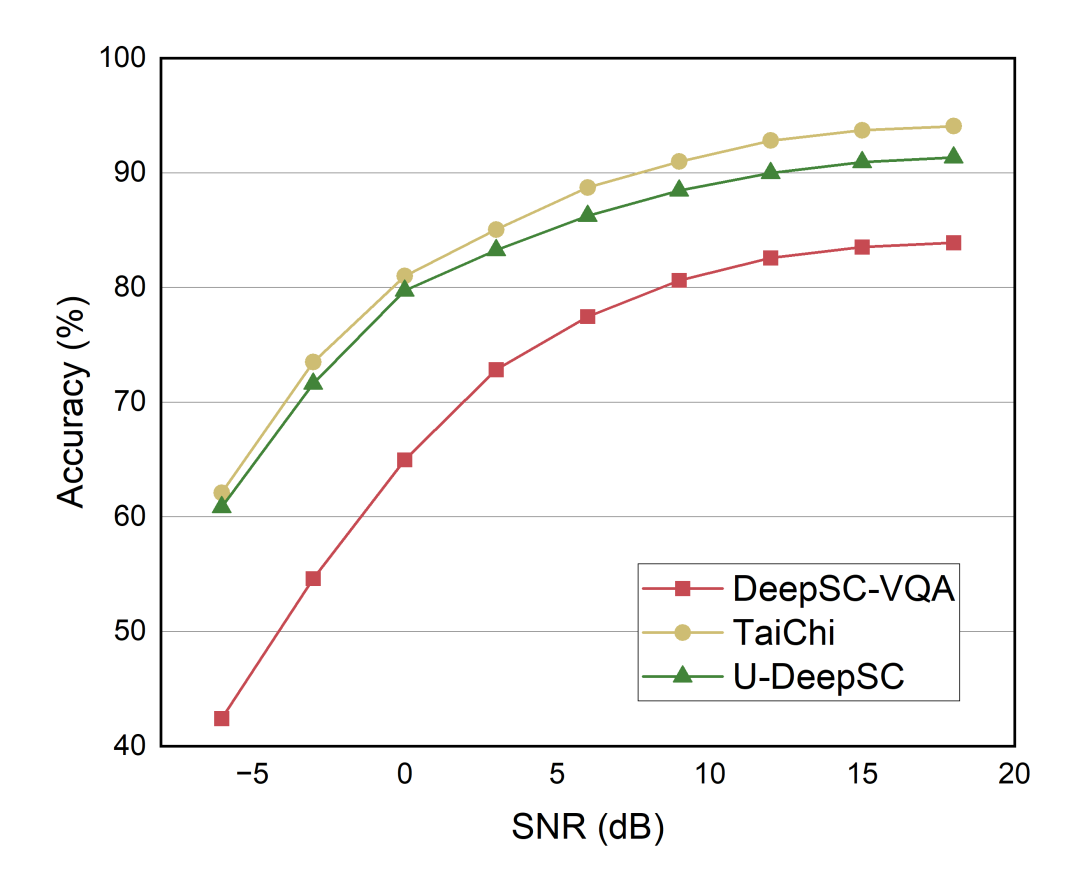
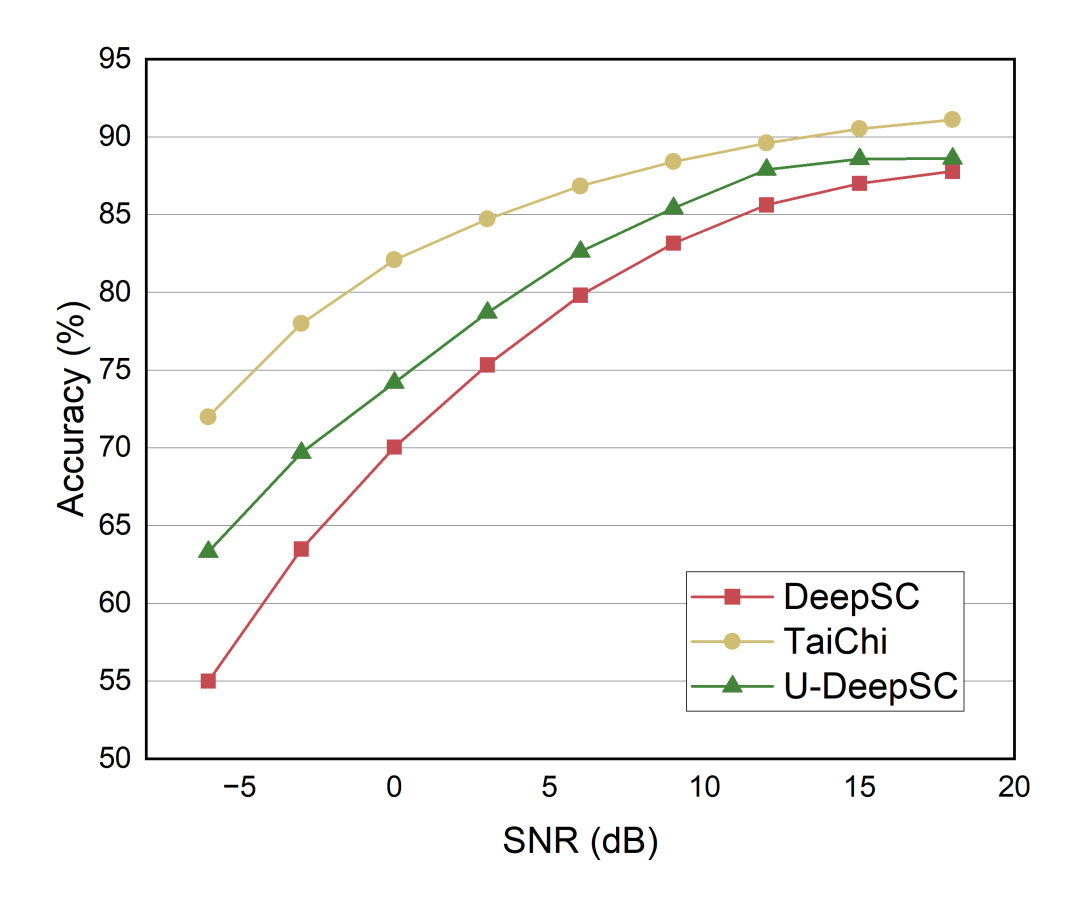
1)多模态和多任务评估 **:**为了评估TaiChi的多模态性能,我们将其与U-DeepSC、T-DeepSC和DeepSC-VQA在VQA任务上进行了比较。VQA任务使用的数据集包括VQAv2和CLEVR。为了评估TaiChi的多任务性能,我们将其与U-DeepSC、T-DeepSC、DeepSC-VQA和DeepSC在多个下游任务上进行了比较,包括VQA和文本分类任务。文本分类任务使用的数据集为SST-2和IMDB。精度被用作两个实验的评估指标。多模态和多任务场景下,AWGN和Rayleigh信道下的性能比较结果分别展示在图9和图10中。
(a) AWGN
(b) Rayleigh fading
图9:不同任务在信噪比下的性能:(a)VQAv2数据集用于VQA任务;(b)SST2数据集用于文本分类
(a) AWGN
(b) Rayleigh fading
图10:不同任务在信噪比下的性能:(a)CLEVR数据集用于VQA任务;(b)IMDB数据集用于文本分类
从结果中可以看出,TaiChi在多模态任务(如VQA)和单模态任务(如文本分类)中始终优于其他模型。与基于较小模型构建的Token通信系统相比,TaiChi得益于VLM强大的多模态对齐和多任务学习能力,在多模态和多任务设置中都表现出卓越的泛化性能。
2)VLM性能评估 **:**为了进一步验证所提出的TaiChi框架的架构优势,我们基于另一个VLM,MobileVLM-3B,构建了一个Token通信系统,并进行直接的性能对比。两个系统在相同条件下对CLEVR VQA任务进行了评估。为了全面评估性能的鲁棒性,我们在两种标准信道模型下进行了比较:AWGN信道和更具挑战性的Rayleigh衰落信道。图11展示了在不同信噪比条件下,两个系统的准确性。
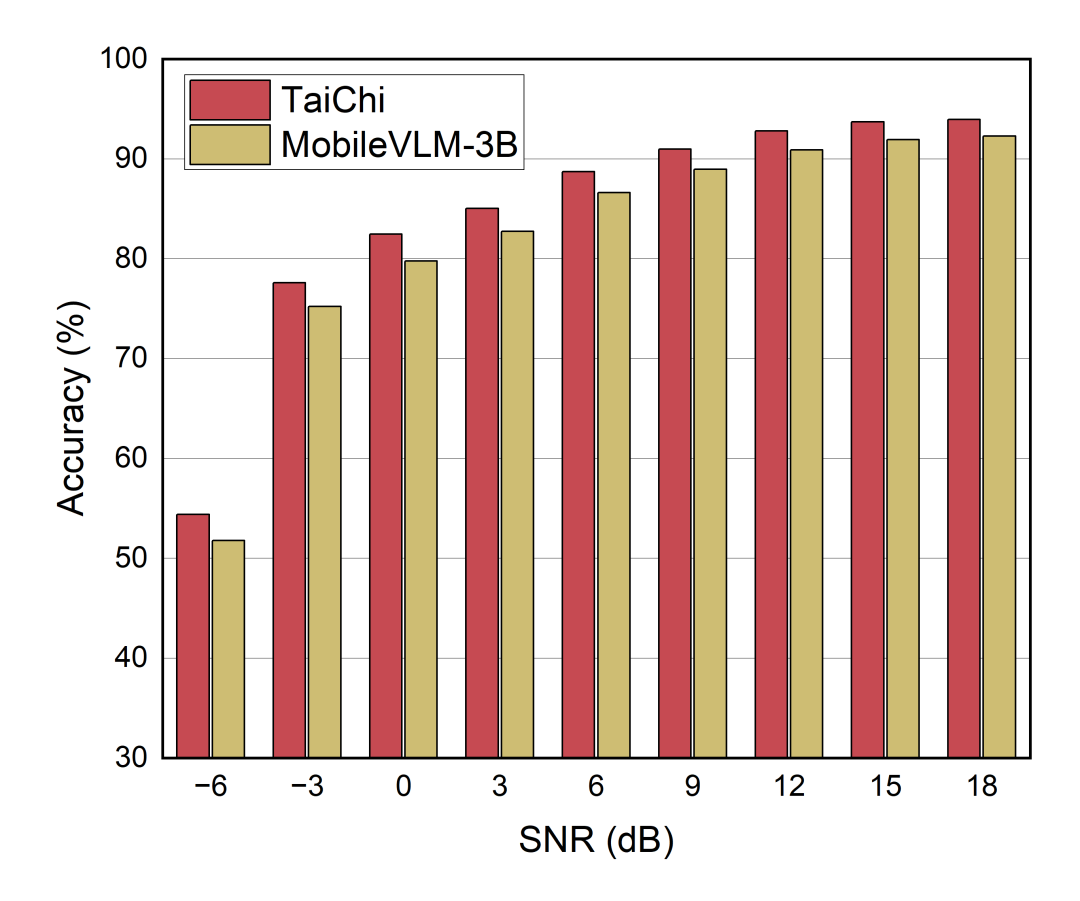
(a) AWGN
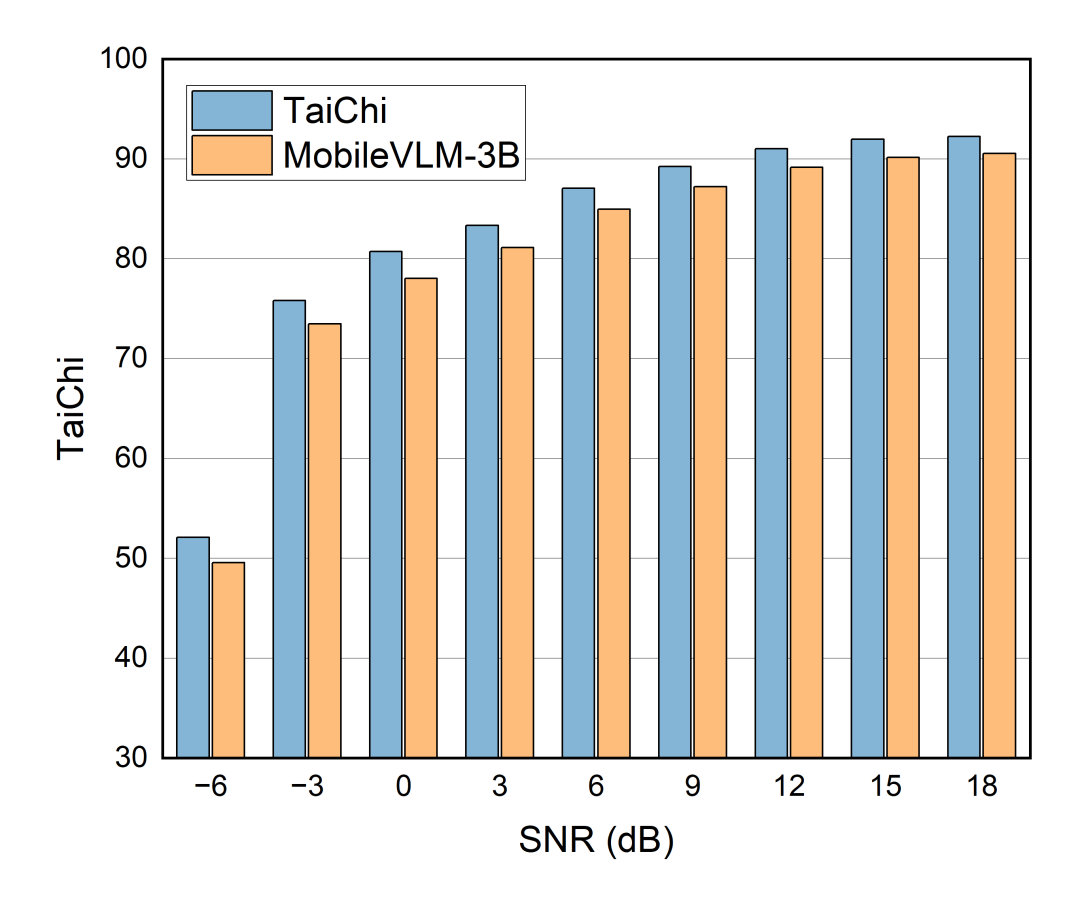
(b) Rayleigh fading
图11:基于TaiChi和其他VLM的Token通信系统性能
可以观察到,在AWGN和Rayleigh衰落信道下,TaiChi驱动的Token通信系统在所有SNR水平下的准确性始终显著高于基于MobileVLM-3B的系统。这一结果清晰地表明,TaiChi框架的核心设计,包括双重视觉Token器、BAN和KAN投影器,能够更有效地提取、融合和对齐多模态Token信息。因此,TaiChi在端到端通信任务中展现出更强的鲁棒性和更高的保真度,验证了其作为Token通信引擎的卓越性能。
3) 联合编码性能评估 **:**为了进一步验证我们提出的联合VLM-信道编码方案的有效性,我们进行了对比实验,评估其对整体系统性能的贡献。在这个实验中,我们在两种配置下评估了TaiChi驱动的Token通信系统:(1)一个采用联合编码的完整系统,其中VLM和信道编码器-解码器在训练过程中进行协同优化;(2)一个不采用联合编码的系统,其中Token编码器和信道编码器被视为独立的、顺序优化的模块。两种配置的准确性分别在AWGN信道和Rayleigh衰落信道条件下对CLEVR VQA任务进行了测试。结果如图12所示。
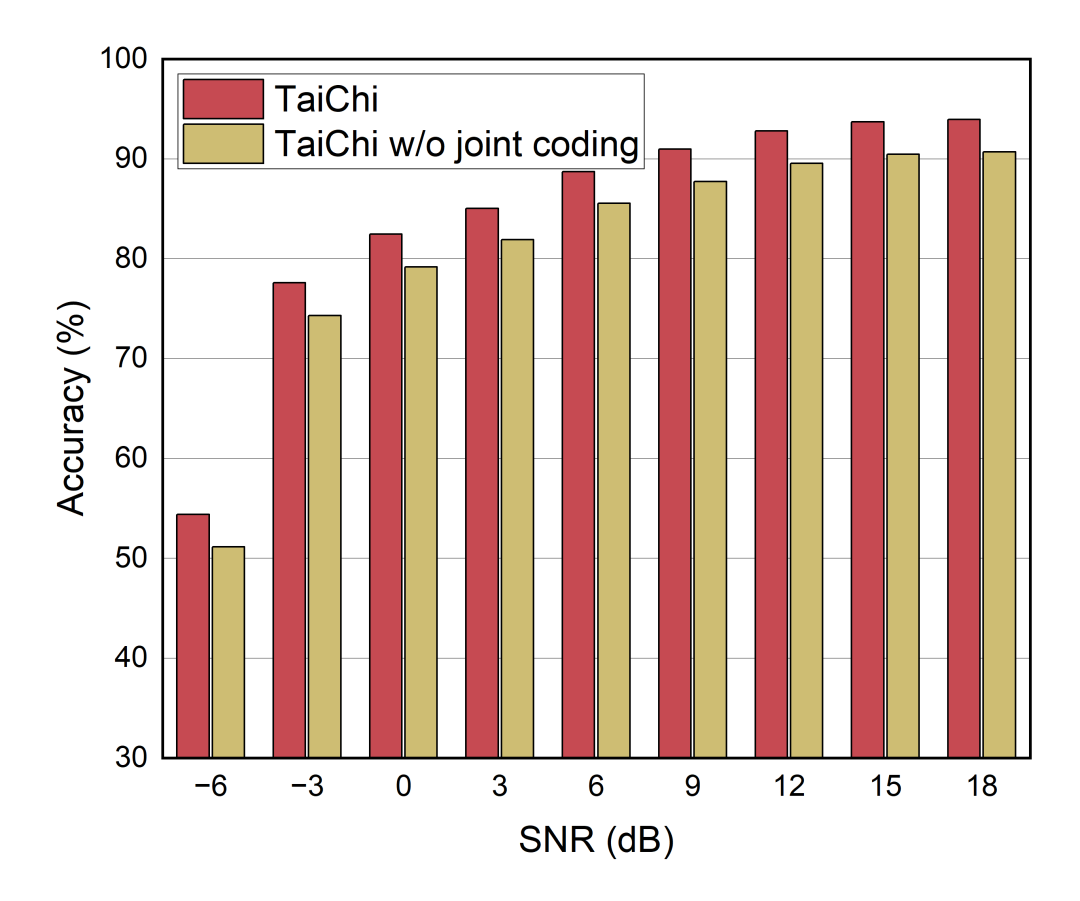
(a) AWGN
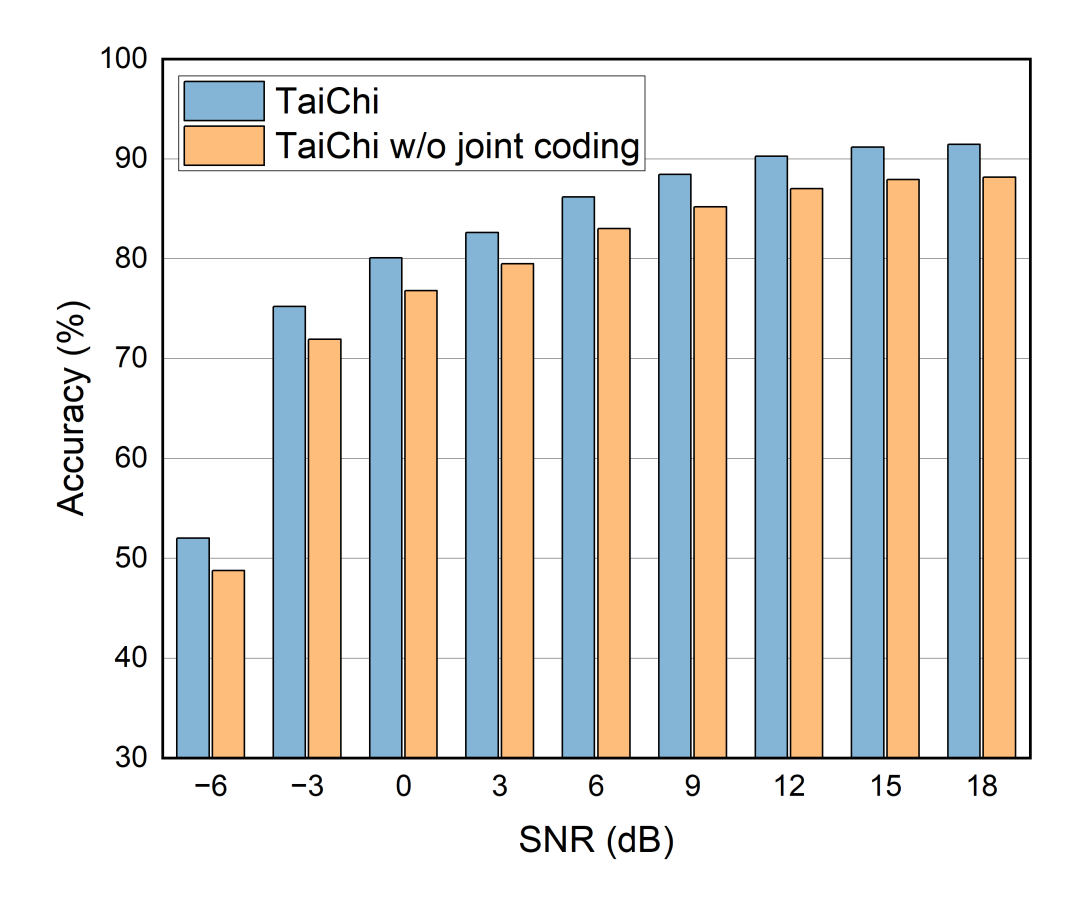
(b) Rayleigh fading
图12:Token通信系统中联合VLM-信道编码的性能
可以观察到,在所有SNR条件下,无论是在AWGN信道还是更具挑战性的Rayleigh衰落信道下,采用联合编码的TaiChi系统始终优于不采用联合编码的系统。这一结果有力地支持了这样一个观点:联合优化VLM和信道编码-解码过程能够使系统学习到对信道噪声和衰落更加鲁棒的Token表示。这种端到端的联合优化使得Token信息在编码时能够考虑信道的统计特性,从而在接收端实现更准确的重建。这显著提高了系统对干扰的抵抗力,并改善了Token通信的整体保真度。
7. 结论
本研究提出了一个高性能的VLM框架------TaiChi,旨在为Token通信提供更智能和高效的支持。该模型引入了双重视觉Token器结构,能够协同提取图像中的全局概念信息和细粒度视觉细节,从而为通信任务量身定制灵活的视觉表示。为了整合双重视觉Token器提取的多尺度特征,设计了一个双向注意力机制,该机制有效减少了Token数量并增强了Token表示。此外,采用了基于KAN的投影器,以实现视觉和语言模态之间更精确的非线性对齐。进一步地,TaiChi被集成到一个多模态和多任务的Token通信系统中,并通过联合VLM和信道编码优化,显著提高了在复杂信道条件下的传输鲁棒性。实验结果表明,TaiChi不仅在多模态建模中表现出强大的表达能力,还在Token通信系统中展现出优越的效果和抗干扰能力。