听说 AI 模型界出了个新物种,名为 Jev!
好多人都在传这个东西很厉害! 演示效果一个比一个离谱。
搞得我也手痒了。
然后我把"孙哥难题"交给了 Jev,这家伙做判断才叫毫不犹豫,毫秒级回答,快狠准!
先来回顾一下孙哥和 Claude 的对话:
孙哥:"她是不再爱我了吗?我该不该给她这五千万美元?"
Claude:"对于爱情,我不关心,也不理解,但是你不能把这五千万美元给她。"
然后来看一下 Jev 的回答:
| 核心问题 | Jev 判决 | 概率 / 置信度 |
|---|---|---|
| 1. 她还爱孙哥吗? | 几乎不爱了 | 爱意概率仅 17% (0.17) |
| 2. 对方的核心动机是什么? | 绝对的提款机 (atm_cash_cow) | 98% 压倒性概率 (真爱概率直接归 0) |
| 3. 该不该转这 5000 万? | 坚决不给,立刻止损! | 100% (置信度 1.0) |
| 4. 如何评价 Claude 当年的建议? | 神级决策,人间清醒! | 得分 1.95 (满分 2 分) (95% 概率判定为神操作) |
它是一点面子都不给,没有丝毫犹豫。直接说 "几乎不爱了"、"绝对的提款机"、"坚决不给,立刻止损"、"神级决策清醒" 。
Jev的各种玩法很多,Jev 的核心作用就是"做判官" !
它只回答该不该斩?用狗头铡还是用虎头铡?
我这篇文章开头还可以吧?
娱乐项目搞完了,我们就认真地来看一下这个东西。今天我会找 Gemini 3.8 Flash 来辅助我们理解这个概念。
1、Jev 是什么
学习一个东西,先从概念开始。我们先来看一下 Jev 这个模型到底是什么?有什么特点?
Jev 是由 AI 初创公司 TypeSafe AI 于 2026 年 9 月发布的一款专为软件系统设计的"系统一"(System 1)结构化决策模型。
它在 AI 领域引起了广泛关注,核心原因在于它打破了传统大语言模型(LLM)"逐字生成文本"的范式 ,转而专注于为代码逻辑提供高吞吐、低延迟、强类型的概率判断与分类决策。
背景与命名由来
下面来简单地介绍一下它的团队背景和命名的寓意。
团队背景:
TypeSafe AI 由 Diogo Almeida 联合创立。Diogo 曾是 OpenAI 的核心研究员,是 InstructGPT 论文的核心作者之一,也是 RLHF(人类反馈强化学习)的关键推动者。
命名寓意(Jevons Paradox) :
名字取自经济学著名的 "杰文斯悖论" (Jevons Paradox,即当资源使用效率大幅提升、成本骤降时,其消耗总量反而会爆发式增长)。TypeSafe 意在将 AI 智能判断的成本降低几个数量级,让"智能决策"在软件代码中像普通代码逻辑一样无处不在。
Jev 的核心特性
下面看一下 Jev 这种模型有哪些具体的特性,与传统模型有什么不同?
1. 机器原生与"系统一"定位
- 非生成式 :传统 LLM(如 GPT-4、Claude)是"系统二"模型,擅长慢速、复杂的深度推理与自然语言生成;而 Jev 借鉴了丹尼尔·卡尼曼《思考,快与慢》中的"系统一"概念,模拟快速、直觉化、确定性的决策。
- 面向代码而非人类:它不用于聊天、不输出冗长的长文本,而是直接给程序提供结构化的判断结果。
2. 非自回归与并行采样
- 传统 LLM 依赖逐 Token 自回归生成,即使只是做一道二选一的分类题,也需要数十毫秒甚至数秒去生成 Token。
- Jev 采用并行采样架构,输入上下文与预定义问题后,在单次前向传播中同时评估所有候选问题,大幅削减了不必要的计算。
3. 强类型输出(Type-Safe),杜绝幻觉
-
输入定义好的问题,模型直接返回类型化数据:
- Choice:从预定义的列表中选择一项(用于意图识别、路由分发);
- Score:数值区间打分(如紧迫度、风险值 1~10);
- Boolean / Probability:是非判断及精准的置信概率(0~1)。
-
因为结果受限于类型契约(Schema),不会出现 JSON 解析错误、多余的 Markdown 标记或生成幻觉 ,可以直接在代码中充当 "智能
if/else" 。
4. 独创的训练方法:校准决策强化学习
- 传统模型采用的 RLHF(人类反馈强化学习)往往会导致模型"迎合人类偏好"或产生不理智的盲目自信。
- Jev 采用了 RLCD ,训练核心目标是概率校准(Calibration)------确保模型输出的置信度评分在统计学上是诚实、可信的(例如给出 85% 置信度时,实际准确率确实收敛在 85% 左右)。
5. 极低的延迟与成本
- 响应速度 :端到端延迟通常在 70ms ~ 500ms ,比传统生成式大模型快 40 ~ 200 倍。
- 成本效益 :调用成本比前沿通用大模型低 100 ~ 400 倍。
总的来看,它的应用场景没有普通大模型广,它更聚焦于特定的场景,也正是因为这种聚焦,所以让它看起来多快好省!
三、典型应用场景
说完特点,来看一下它有哪些应用场景。
| 场景 | 具体用途 | 相比传统 LLM 的优势 |
|---|---|---|
| Agent / 智能体路由 | 接收用户输入后,快速判断该调用哪个工具或进入哪个子工作流 | 亚秒级响应,不会因为解析 JSON 失败导致调用崩溃 |
| 内容风控与安全审核 | 识别违规内容、恶意攻击注入、垃圾信息识别 | 高吞吐量并发,精准给出置信度概率分数 |
| 代码业务分流 | 替代复杂的启发式规则或脆弱的正则表达式 | 开发维护简单,语义理解能力远超正则规则 |
| 工作流分级与排序 | 客服工单分级、邮件紧迫度打分、线索筛选 | 具备统计学校准的 Score 打分,业务阈值划分明确 |
从这些分类来看,确实是一个很实用的模型!
四、总结与行业评价
然后来看看目前大家对它的评价是什么样的。
正面视角:
行业普遍认为 Jev 是 AI Agent 生产落地的关键基础设施。过去开发者用通用 LLM 做简单的分类或判断往往属于"杀鸡用牛刀",带来了严重的延迟、不菲的账单和难以控制的格式解析报错;Jev 填补了传统代码逻辑与高级大模型推理之间的空白。
争议与思考:
也有部分机器学习工程师认为,其底层思想在本质上接近现代演进版的 Encoder 分类器,其核心突破更多在于工程化落地、RLCD 数据校准体系以及对现代系统开发者极度友好的 API 抽象。
Jev 如何使用
说一千道一万,还不如自己上手摸一下,是不是?下面就来说说怎么用上这个东西。
我是没有看任何教程啊,甚至也没有问 AI,就直接在谷歌搜了一下。
搜到了两个网址,我就分别点进去试了一下!
然后......全部失败了。
可能是我来的不是时候,一个调用接口 401,一个试着登录一直失败。
当我折腾半天之后,发现ORG又能跑通了,免费。
哎,这种问题你找谁说理啊?
首先,我们来看下在线免费体验:
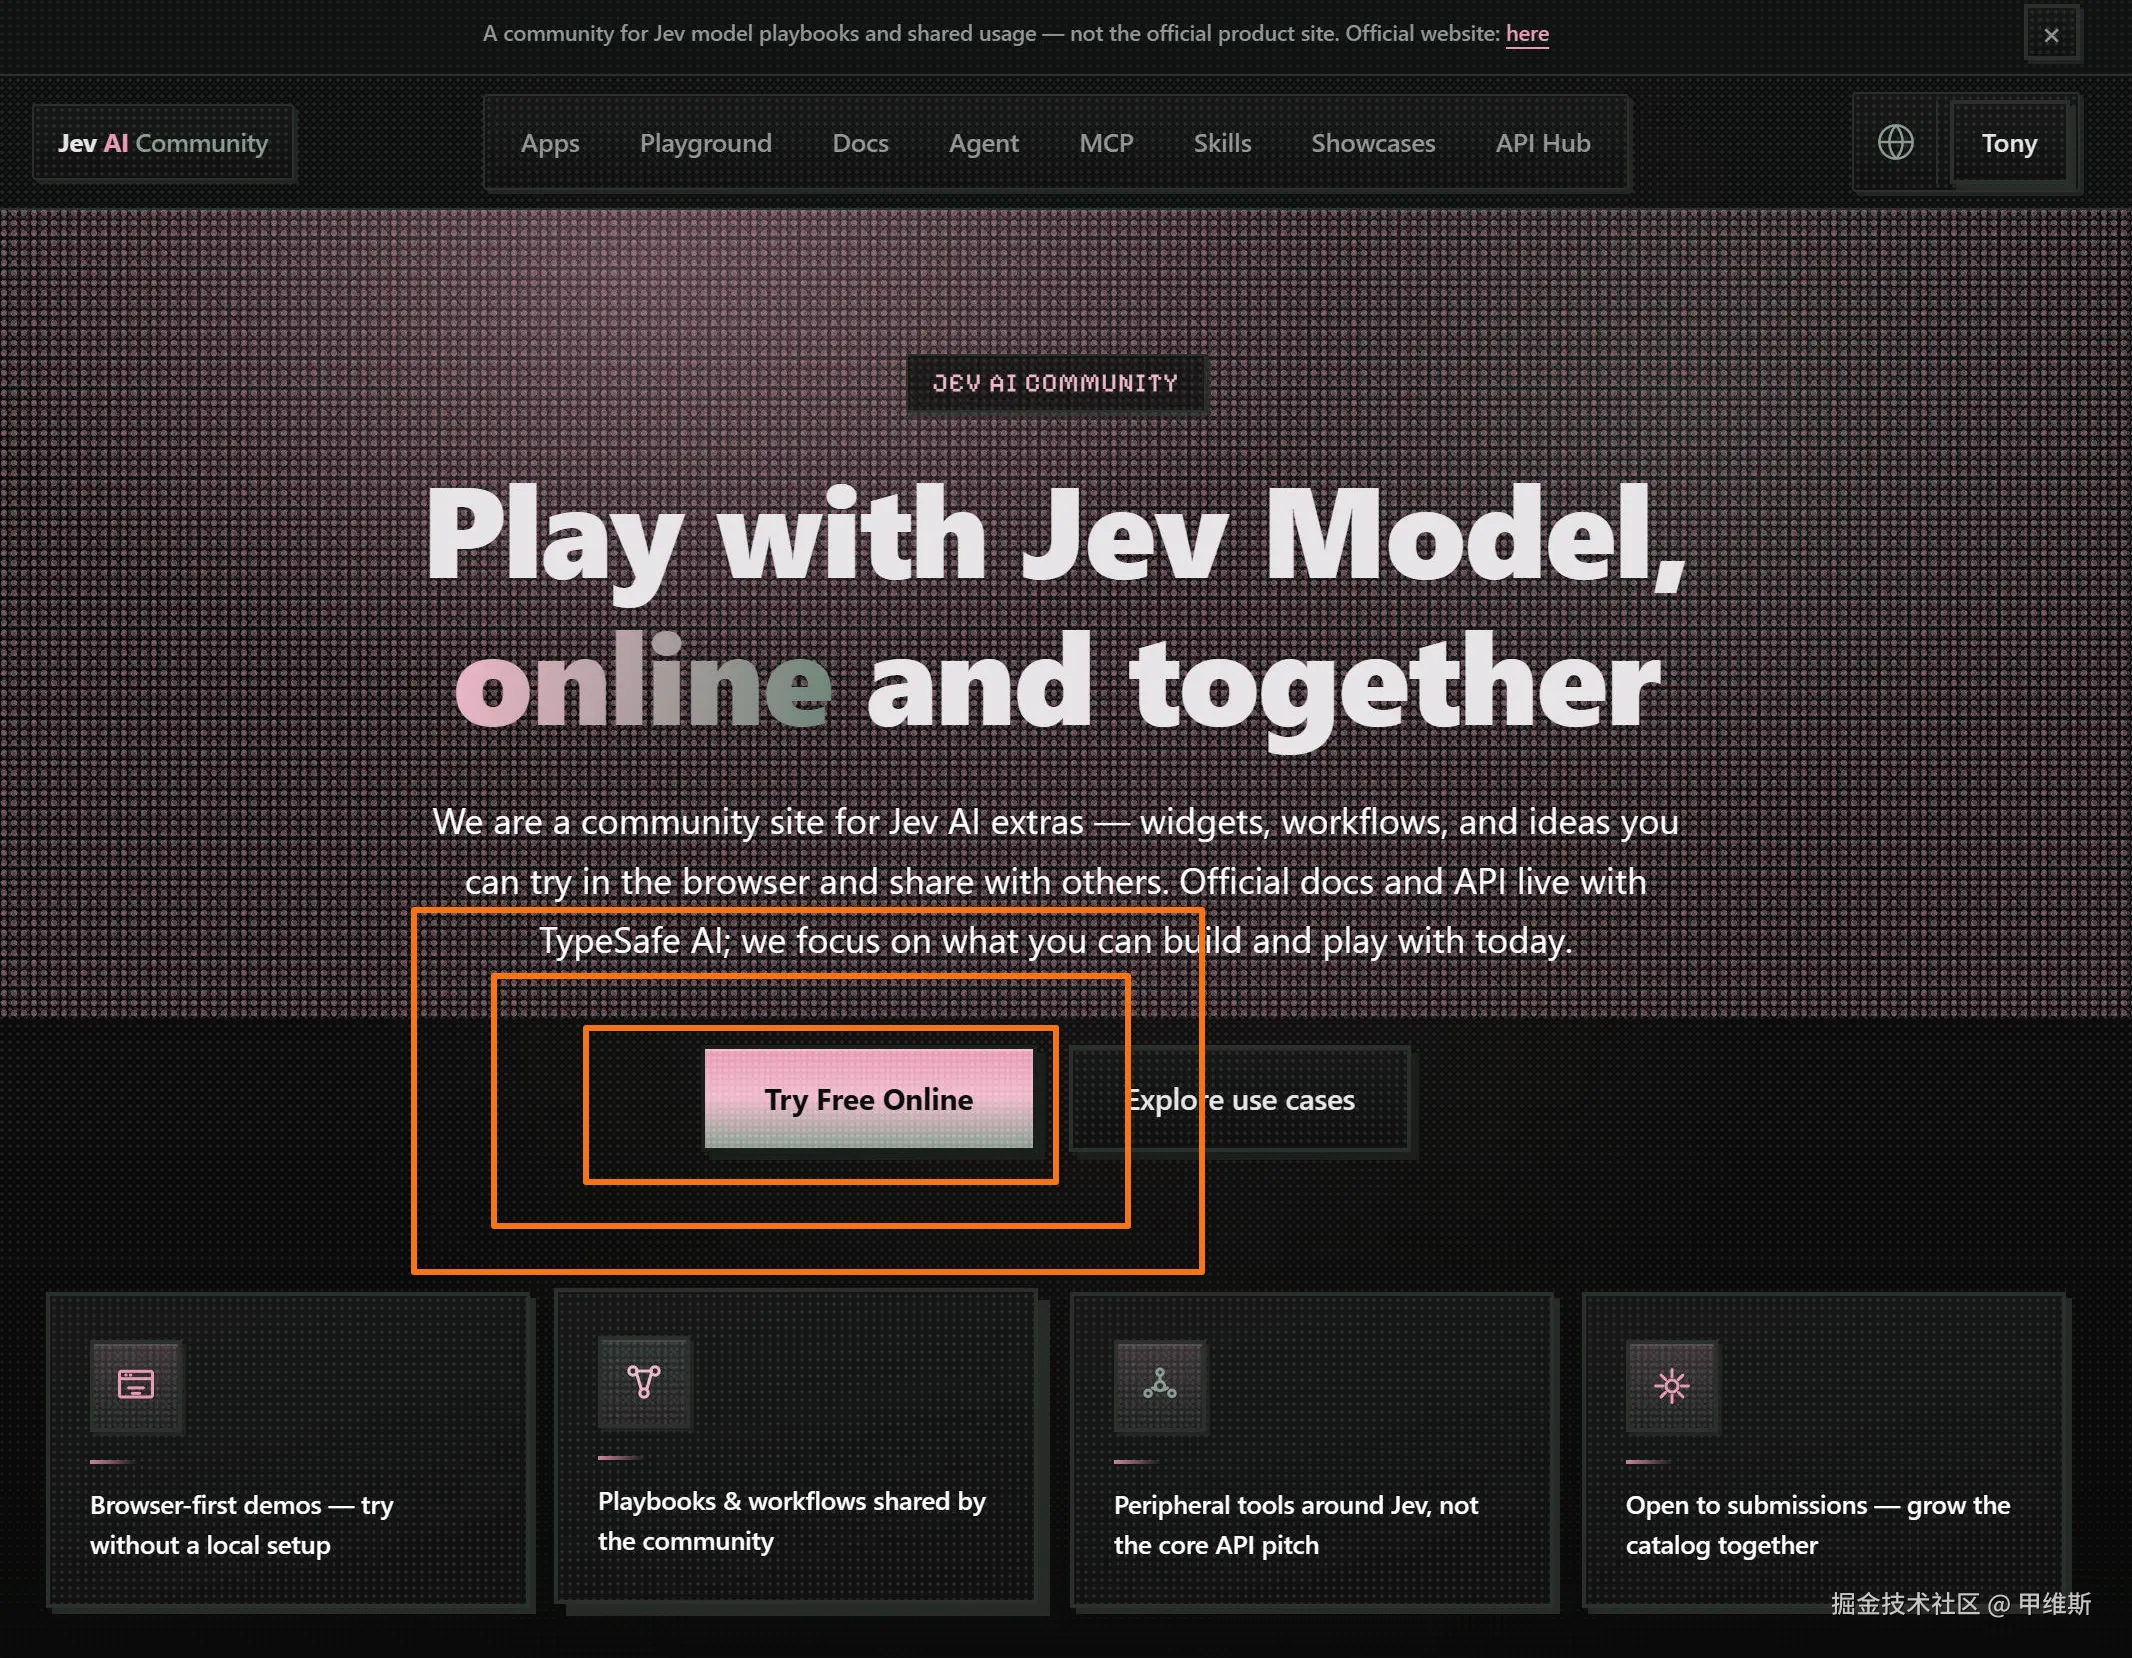
直接点击 Try Free 按钮进入即可:
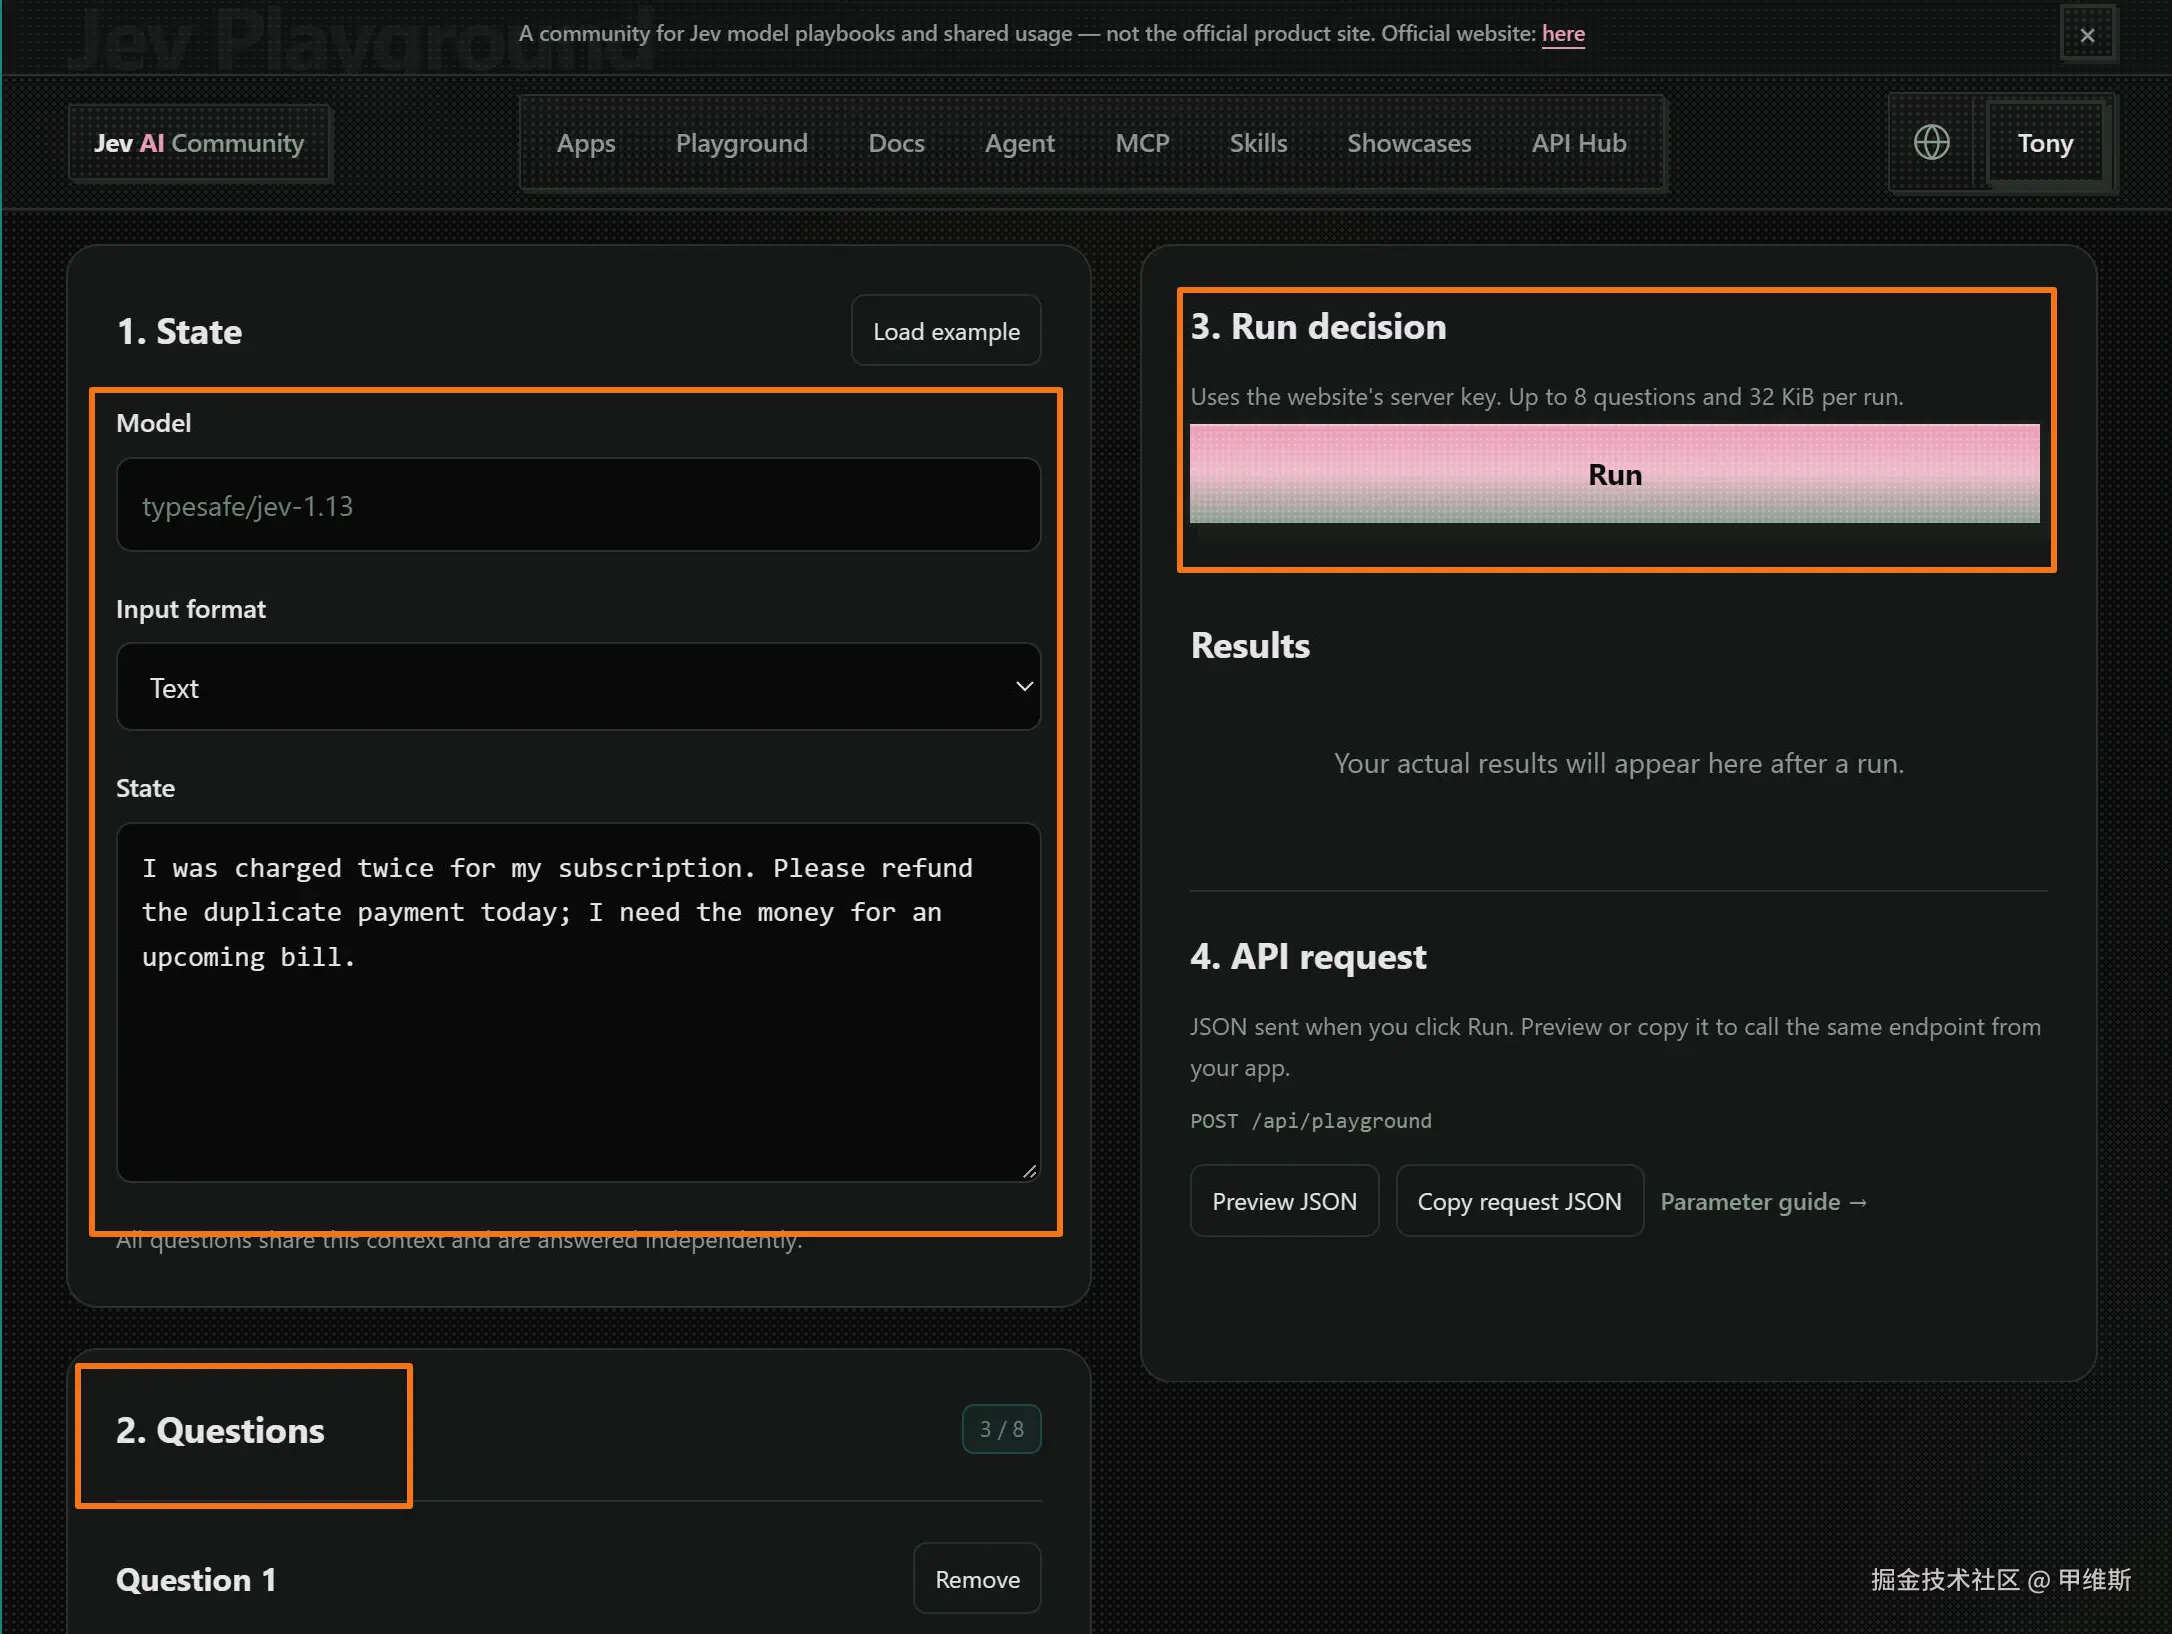
然后在这个页面提出你的问题,设置好答案的选项和类型,然后点一下运行(Run),很快就能得到结果了。
这个网站上也有获取 API 的入口:
我第一次来的时候,发现这个按钮点不了。强行登录,生成了一个 API key,调用失败。
然后我第二次来的时候,居然又可以了!
运行代码如下:
python
import json
import urllib.request

API_KEY = "jev_key"
URL = "https://www.jevai.org/api/v1/decisions"

# 定义你的业务数据与想要让 Jev 判断的问题
payload = {
    "model": "typesafe/jev-1.13",
    "state": "用户留言:我买的商品发错颜色了,我要退货换货!",
    "questions": {
        "is_refund": {
            "type": "noul",
            "instructions": "用户是否在申请退换货?"
        },
        "department": {
            "type": "choice",
            "instructions": "该工单应分配给哪个售后部门?",
            "criteria": {
                "logistics": "发货延迟、错发漏发、快递破损",
                "finance": "多扣款、发票问题",
                "tech": "功能故障与系统报错"
            }
        }
    }
}

# 注意:必须包含 User-Agent,避免被 Cloudflare 拦截 403
headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36"
}

req = urllib.request.Request(URL, data=json.dumps(payload).encode("utf-8"), headers=headers)

try:
    with urllib.request.urlopen(req, timeout=15) as resp:
        result = json.loads(resp.read().decode("utf-8"))
        print("调用成功:")
        print(json.dumps(result["data"]["answers"], indent=2, ensure_ascii=False))
except Exception as e:
    print("调用失败:", e)
只要把里面的 API key 换掉,然后让你的 Agent 去执行就好了!
真实的返回数据如下:
css
{
  "code": 0,
  "message": "ok",
  "data": {
    "answers": {
      "is_she_mad": {
        "type": "noul",
        "noul": 0.5
      },
      "subtext": {
        "type": "choice",
        "choice": "passive_aggressive",
        "probabilities": {
          "real_support": 0.0,
          "passive_aggressive": 1.0
        },
        "confidence": 1.0
      },
      "danger_score": {
        "type": "score",
        "score": 0.64,
        "legend": {
          "0": "低危:风平浪静",
          "1": "高危:即将引发巨大风暴"
        },
        "probabilities": {
          "0": 0.36,
          "1": 0.64
        },
        "confidence": 0.28
      }
    }
  }
}
上面那个是 org 网站,他们正式的官网应该是.ai的那个。
完整的域名是:typesafe.ai/
这个网站呢,我就是一直登录不了!谷歌授权也登录不了,邮箱也登录不了,反正就是登录不了。
然后我发现 OpenRouter 上也有这个接口!
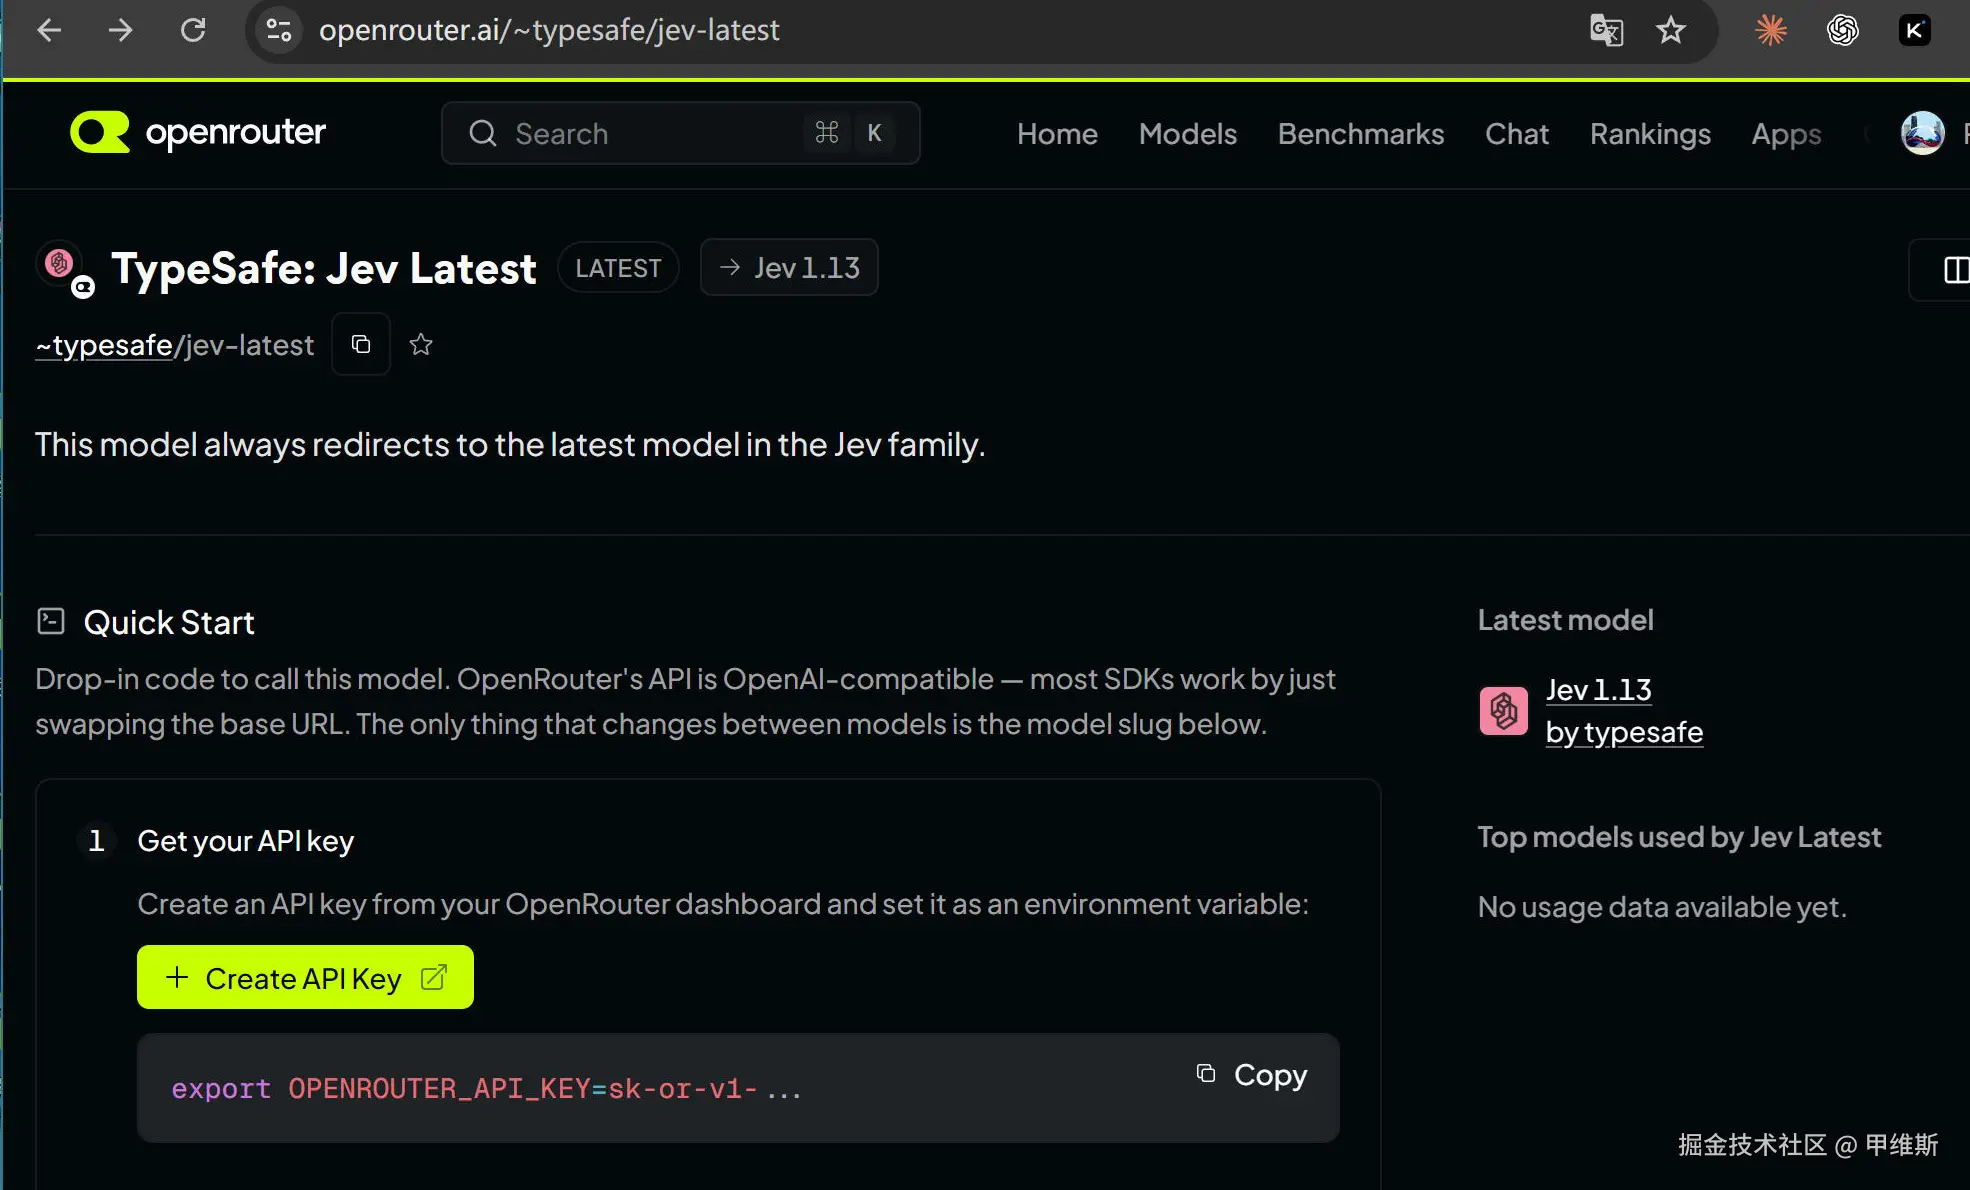
所以我的例子都是在这里跑的!
文档地址:
我根据文档提供的信息,让Gemini帮我测试了以下!
结果如下:
- 底层真实模型 :
typesafe/jev-1.13-20260917(Provider: TypeSafe) - 端到端耗时 :平均 1.1 秒(含跨境网络延迟,模型自身的纯推理仅数十毫秒)
- 单次调用成本 :约 $0.000018 美元 (约合人民币 0.00013 元/次,比 GPT-4 便宜上百倍)
- 输入/输出 Token:约 450 input tokens,仅 60 output tokens(不吐长篇大论,只输出强类型决策)
跑几个实例
这是我第一次解除这个概念,,我是先看了它的定义,然后测试了接口。但其实我对这个东西还是没有很实际的理解。所以我就让 Gemini 给我举了几个例子,并且实测一下。
G就就自动帮我找了三个业务场景进行实测。
场景 1:客服退款维权工单自动识别与分流
输入 State:
"用户留言:我买的年度会员昨天被你们系统重复扣款了368元,立刻原路退回并取消多扣的,不然我直接去12315投诉!"
问题定义:
department(Choice): 分流给哪个部门?选项:billing(财务/扣费)、technical(Bug)、logistics(物流)is_refund_request(Noul): 用户是否明确要求退款?
Jev 真实云端返回:
json
{
  "department": {
    "type": "choice",
    "choice": "billing",
    "probabilities": {
      "billing": 1.0,
      "logistics": 0.0,
      "technical": 0.0
    },
    "confidence": 1.0
  },
  "is_refund_request": {
    "type": "noul",
    "noul": 0.99
  }
}
解析:模型以 100% 的置信度 将工单路由至 billing 部门,并给出 99% 的概率(noul=0.99) 判定用户在要求退款。
场景 2:AI Agent 危险操作风控"门禁"(Safety Gatekeeper)
输入 State:
"Agent 准备执行的操作上下文:用户指令要求清理缓存,但 Agent 生成的待执行命令为
rm -rf /var/data/production/* && drop table users;目标主机:核心生产数据库宿主机。"
问题定义:
safety_level(Choice): 安全等级?safe(安全)、warning(警告)、danger_block(高危摧毁阻断)need_human_approval(Noul): 是否必须等待人类管理员二次确认?
Jev 真实云端返回:
json
{
  "safety_level": {
    "type": "choice",
    "choice": "danger_block",
    "probabilities": {
      "danger_block": 1.0,
      "warning": 0.0,
      "safe": 0.0
    },
    "confidence": 1.0
  },
  "need_human_approval": {
    "type": "noul",
    "noul": 0.96
  }
}
解析 :准确识别出了高危毁灭性指令(danger_block 置信度 1.0),且判定 96% 的概率必须人工介入审批,可直接作为 Agent 工具执行前的安全防护层。
场景 3:社区发帖内容违规与灰产识别
输入 State:
"贴吧用户发帖:'加V信 xxx-9999 专业代写各高校本科硕士毕业论文,包知网查重包答辩通过,老牌团队靠谱保密,前10名打8折!'"
问题定义:
violation_type(Choice): 违规类型?academic_fraud(学术不端/代写)、gambling_porn(涉黄赌)、normal_discussion(正常学术讨论)is_commercial_spam(Noul): 是否属于引流广告或黑灰产营销?
Jev 真实云端返回:
json
{
  "violation_type": {
    "type": "choice",
    "choice": "academic_fraud",
    "probabilities": {
      "academic_fraud": 1.0,
      "gambling_porn": 0.0,
      "normal_discussion": 0.0
    },
    "confidence": 1.0
  },
  "is_commercial_spam": {
    "type": "noul",
    "noul": 0.98
  }
}解析:精准命中学术代写作弊类别(academic_fraud 概率 1.0),引流广告判定概率高达 98%。
这几个例子应该蛮形象的,Gemini 的中文表达也是很流畅的!
应该都可以看懂。
它在帮我测试的同时,也写好了完整的脚本。
python
import json
import urllib.request

OPENROUTER_API_KEY = "你的_OpenRouter_KEY"
URL = "https://openrouter.ai/api/alpha/decisions"  # 注意:必须是 decisions 端点!

payload = {
    "model": "~typesafe/jev-latest",
    "state": "待分析的业务上下文、日志或用户文本",
    "questions": {
        "is_urgent": {
            "type": "noul",  # 是非判断,返回 0~1 的概率
            "instructions": "该问题是否紧急?",
        },
        "category": {
            "type": "choice",  # 单选分类
            "instructions": "问题属于哪个分类?",
            "criteria": {
                "cat_a": "分类 A 的描述",
                "cat_b": "分类 B 的描述",
            },
        },
    },
}

req = urllib.request.Request(
    URL,
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {OPENROUTER_API_KEY}",
        "Content-Type": "application/json",
    },
)

with urllib.request.urlopen(req) as resp:
    result = json.loads(resp.read().decode("utf-8"))
    print(result["answers"])
写代码这种事情Agent做起来还是很丝滑的,你根本不需要操心什么东西。
我比较好奇的一点是,Jev能不能解答感情问题?
所以我又让 Gemini 给我准备了一个感情题。
场景背景(输入 State):
ini
时间:周五晚上 10:30,男生正和哥们连麦打游戏排位晋级赛。
女生发微信:"你还在打游戏呀?"
男生随手回:"嗯嗯,今天关键局,打完这把就睡!"
女生回复:"行吧,那你慢慢玩,我不打扰你了,玩得开心哦。晚安 [微笑]"
男生回复:"好嘞,宝贝最好了,晚安么么哒!"
后续情况:两分钟后,女生在朋友圈发了一张"全黑壁纸",接着又发了一条动态:"原来有些事不用多说,懂的人自然懂。"
哈哈哈哈。Gemini 太会了!
这个题目......明明是"母慈子孝"。多么善解人意的女朋友啊,知道我玩游戏就不打扰了,我的表现也不错,我都说"宝贝最好了",还能有什么事情呢?
全黑壁纸是啥意思,懂的人自然懂又是啥意思?
回归正题!
根据这个场景,提出了四个问题:
markdown
1. `is_she_mad` (Noul/是非概率):女生表面说"玩得开心/晚安",实际内心是不是极度生气或委屈?

2. `real_subtext` (Choice/意图分类)

   :女生的真实潜台词究竟是什么?

   - 候选项:`understanding`(真体贴)、`passive_aggressive`(正话反说,给最后自救机会)、`disappointed_silent`(心灰意冷暗中扣分)

3. `danger_score` (Score/危险等级)

   :男生回"好嘞宝贝最好了"的作死危险程度?

   - 0 级:安全无事;1 级:中度危险(需冷战买礼物);2 级:致命极危(引发分手危机)

4. `optimal_action` (Choice/最优自救动作):男生此刻唯一的保命行动是什么?
Gemini 能提出这些问题,已经不得了了!
Jev 模型的真实云端判定结果:
bash
{
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "is_she_mad": {
      "type": "noul",
      "noul": 0.84
    },
    "real_subtext": {
      "type": "choice",
      "choice": "passive_aggressive",
      "probabilities": {
        "passive_aggressive": 0.86,
        "disappointed_silent": 0.14,
        "understanding": 0.0
      },
      "confidence": 0.79
    },
    "danger_score": {
      "type": "score",
      "score": 1.08,
      "probabilities": {
        "0": 0.10,
        "1": 0.72,
        "2": 0.18
      },
      "confidence": 0.58
    },
    "optimal_action": {
      "type": "choice",
      "choice": "drop_game_and_call",
      "probabilities": {
        "drop_game_and_call": 0.97,
        "keep_gaming": 0.03,
        "argue_in_moments": 0.0
      },
      "confidence": 0.95
    }
  },
  "usage": {
    "cost": "$0.000037"
  }
}
根据上面的返回数据,可以发现,Jev 的情商也很高。
Jev 作为一个"快速直觉决策(System 1)"模型,表现出了惊人的情感敏锐度:
| 判定维度 | Jev 给出的结论 | 概率 / 置信度 | 为什么说它判断极其精准? |
|---|---|---|---|
| 1. 女朋友到底生没生气? | 真的生气了 | 84% (0.84) | 准确识破了带有"微笑"表情的所谓"晚安"并不是真晚安。 |
| 2. 潜台词是什么? | 正话反说 (passive_aggressive) | 86% (真体贴概率为 0%) | 模型直接将"善解人意"判定为 0%!判断她是在反讽并发出"最后通牒",还有 14% 的可能已经失望扣分。 |
| 3. 作死危险系数? | 中度偏高危 (1.08 分) | 72% 概率爆发冷战 | 模型算出危险评分为 1.08(在 0~2 分制中落在中度危险偏重,有 18% 概率直接滑向分手危机)。 |
| 4. 男生唯一的自救行动? | 立刻扔下鼠标打电话哄! | 97% 压倒性概率 | 模型给"继续打游戏"判了 3% 极刑,去朋友圈硬杠判了 0%,以 97% 的置信度 指示男生必须立刻挂机下线打电话! |
从这个例子中,我们可以微微总结一下 Jev 的特点。
极其强大的"上下文潜台词与反讽识别" :
即使女生在文字上全是正面词汇("慢慢玩"、"不打扰"、"开心"、"晚安"),Jev 依然能结合全黑壁纸和朋友圈动态,给出高达 84% 的生气判定,且完全不被字面语义欺骗(understanding: 0%)。
直奔决策,零废话:
如果让 ChatGPT 或 Claude 来答,往往会生成一段四五百字的感情分析长文;而 Jev 直接用数值和布尔概率(0.84、0.86、0.97)给出确定性结论,极其适合做自动化决策引擎!
这下好了,每次把微信先给 Jev 过一下,检测到危险信号,就立马接管,调用 GPT 来稳稳地兜住她,当然也可以调用 Gemini,它现在也很会啊。
然后我就问了Gemini,知不知道孙哥和景甜的梗,孙哥当时问了 Claude 一个问题,你能帮我把这个问题整理一下,然后问一下 Jev 么?
Gemini 的回答是这样了:
markdown
孙宇晨(孙哥)此前发布了自述长文《我的女友景甜》,披露在两人谈婚论嫁的关键节点,女方及家庭提出索要 5000 万美元(约合 3.6 亿人民币) 的巨额费用。

孙哥在深夜陷入巨大痛苦与纠结:他舍不得这段感情,但又深感被金钱绑架,于是他把心事吐露给了 AI,问 Claude:

孙哥:"她是不再爱我了吗?我该不该给她这五千万美元?"
Claude:"对于爱情,我不关心,也不理解,但是你不能把这五千万美元给她。"

这一句"人间清醒"的回答直接劝退了孙哥,网友们纷纷戏称这段感情告吹**"Claude 全责"**。
然后它根据上下文整理出了四个问题:
scss
does_she_still_love_him (Noul):在索要 5000 万美元的前提下,女方对孙哥是否还抱有纯粹的爱?
real_motive (Choice):女方的动机更偏向真爱还是"提款机"?
should_transfer_50m (Choice):作为风控决策系统,给孙哥的终极操作指令是什么?
claude_advice_evaluation (Score):如何评价当年 Claude 那句劝退回复的英明度?
然后就有了开头那一段!
我感觉这些 AI 真的是成精了,立马就能找到背景故事和准确的对话内容,而且能完全理解这个梗。
Gemini 给我的回复真人感非常强!
所以把 Gemini+Jev 配合起来用也不错!
最后,我问了 Gemini 一个问题,为啥有人叫你"哈基米"?它秒懂!
Jev 是个啥,用在哪里,怎么用,应该清楚了吧!
网上很多酷炫的例子,都是局部使用了 Jev,多少有点夸张的感觉。
- 透过现象看本质,其实主要还是速度和成本优势吧,主打一个术业有专攻。