四、反向传播
1、反向传播的来源
1.1 神经网络训练的难题
据前文,咱们可以知道,只要神经元 和层数 足够多,模型理论上可以拟合 成任意函数。
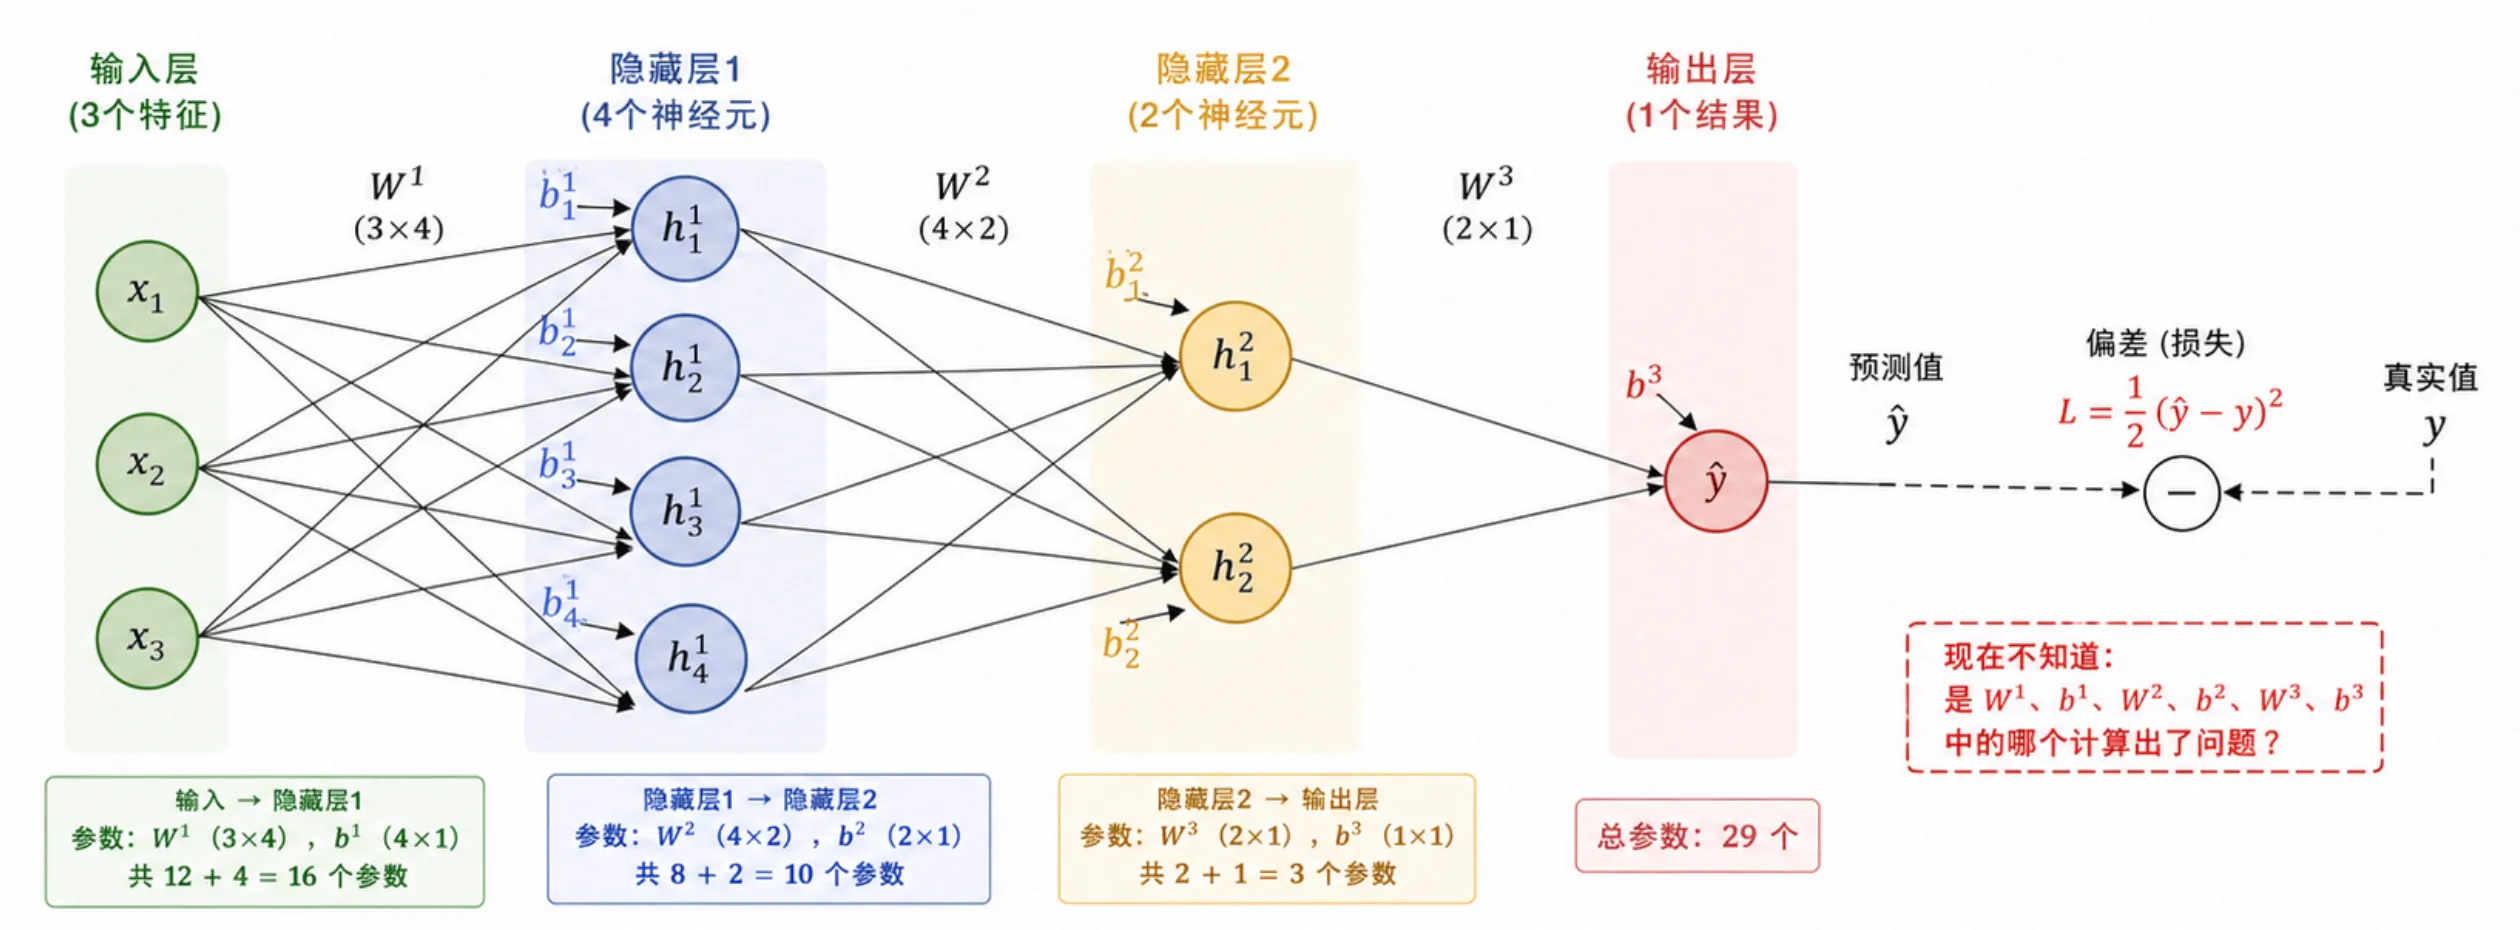
但是对于海量参数带来强大能力的同时,也带来了一个问题:当神经网络的预测出了错误,我们要如何调整这一些成千上万、上亿个参数?
因此,这一问题将神经网络的发展进行了断层,直到反向传播算法的出现,引入神经网络,训练问题才被解决。
1.2 反向传播的本质
反向传播 在职场上就是:层层追责。
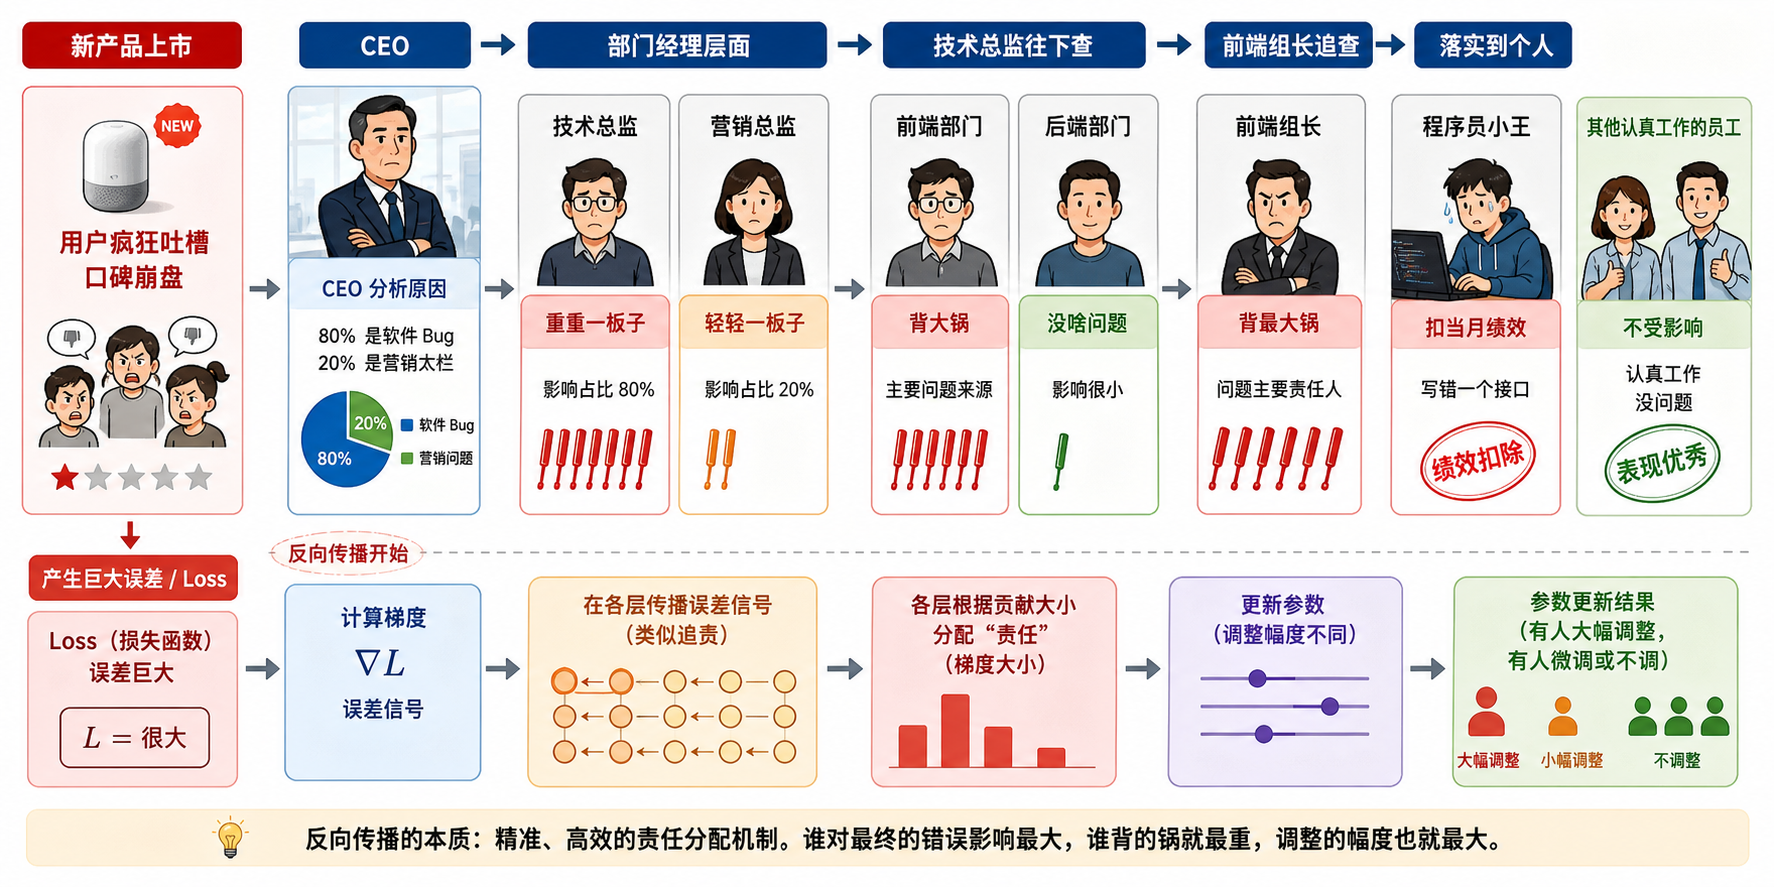
- CEO 找部门经理:CEO 分析后发现,这次崩盘 80% 是软件 Bug 造成的,20% 是营销太烂。于是技术总监挨了重重一板子,营销总监挨了轻轻一板子。
- 部门经理往下追:技术总监回去继续排查,发现 Bug 主要出在前端,后端没什么问题。于是前端组长背了最大的锅。
- 责任落实到个人 :前端组长最终查出,是程序员小王写错了一个接口。结果小王被扣了当月绩效(参数大幅调整 ),认真工作的同事则毫发无损(参数微调或不调)。
这就是反向传播的本质:从最终结果触发,逐层倒推责任分配机制,因此谁对最终误差的影响越大,谁对结果的影响才最大。
2、神经网络训练全流程
理解反向传播需要先将神经网络梳理一遍,方便理解反向传播的用途。
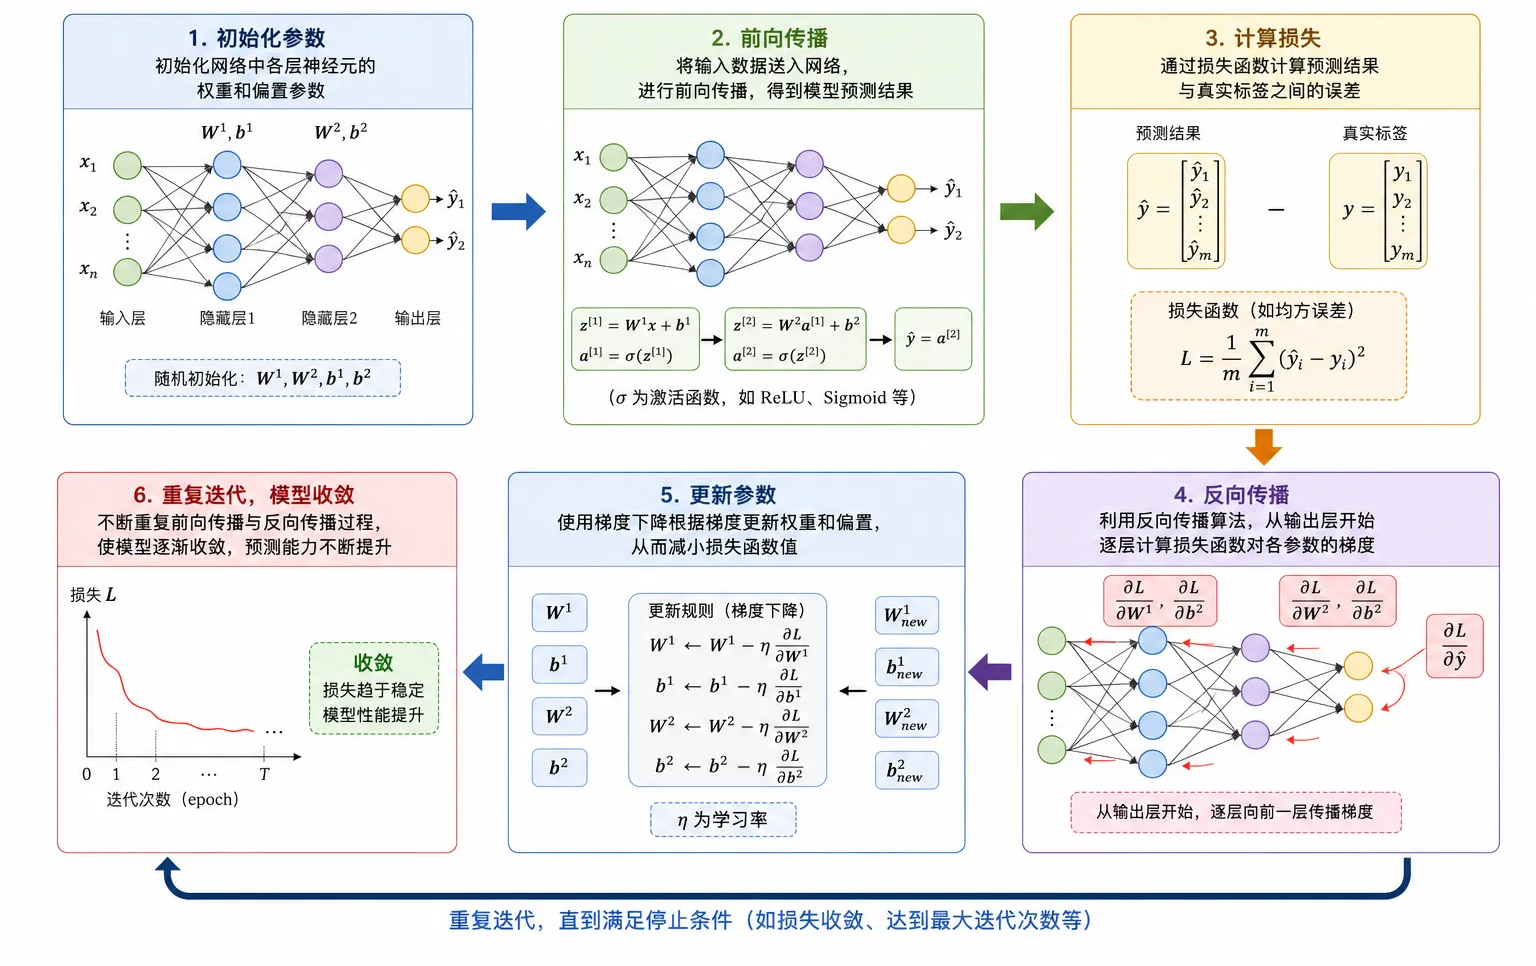
- 初始化网络中各层神经元的权重和偏置参数。
- 将输入数据送入网络进行前向传播,得到模型的预测结果。
- 通过损失函数计算预测结果与真实标签之间的误差。
- 利用反向传播算法,从输出层开始逐层计算损失对各参数的梯度。
- 使用梯度下降根据梯度更新权重和偏置,从而减小损失值。
- 不断重复以上过程,让模型逐步收敛,预测能力持续提升。
这样循环的大小主要是根据数据量来进行判断,每跑一个循环,被称为一次迭代(iteration),跑完所有数据一遍被称为 epoch。
2.1 前向传播
前向传播就是数据沿着网络从输入流向输出的过程。每个神经元接收上一层传来的特征向量,按各自的权重做线性加权求和、加上偏置,再经过非线性激活函数过滤,把信息重构为更高阶的特征,传递给下一层。
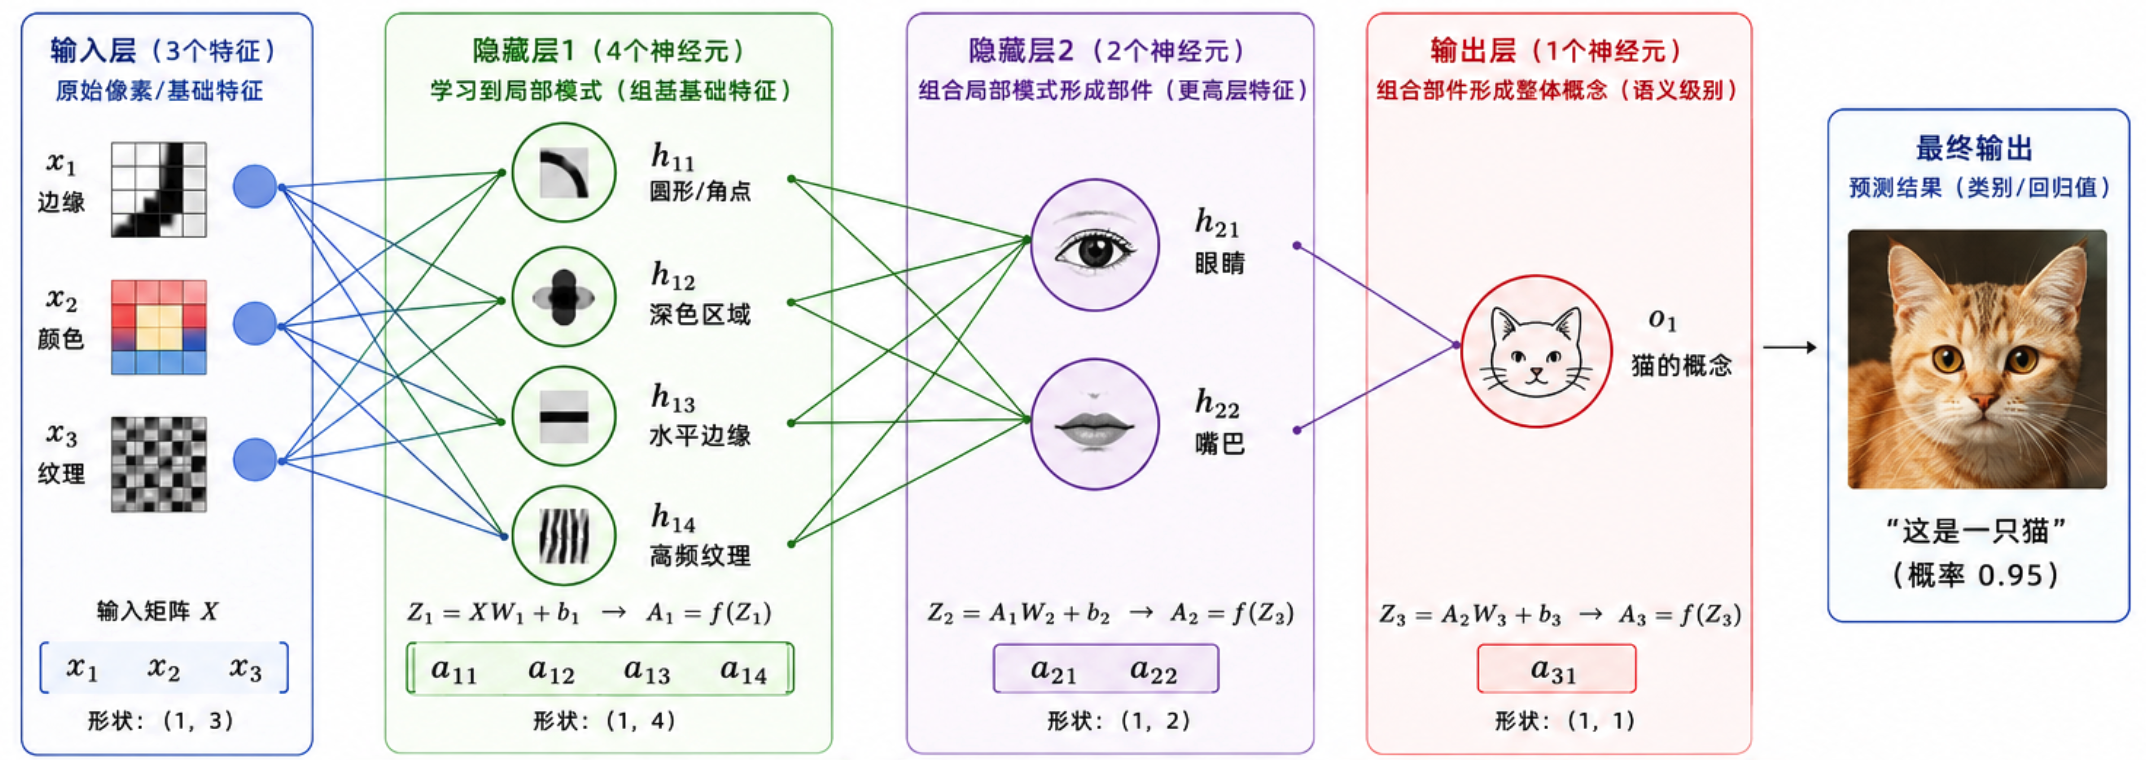
正是这种逐层抽象的机制,让神经网络具备了自动学习特征的能力,可以拟合远比传统机器学习更复杂的模式。
每个神经元做的事情都是同一套两步操作:
- 对上一层所有输出做线性变换:
- 用激活函数引入非线性,把结果作为新特征输出给下一层:
差别只在于每个神经元维护着自己的一套权重和偏置参数。
2.2 损失函数
前向传播结束后,我们得到了预测值 。但它和真实标签 y 之间往往有差距,这个差距需要被量化成一个具体的数字,才能指导后续的参数调整。这就是损失函数(Loss Function) 的作用。
线性回归中我们用过 MSE(均方误差):
L 越大,说明错得越离谱。问题随之而来:该怎么调整权重矩阵 W和偏置 b**,才能让** L变小?
在线性回归、逻辑回归里,我们的答案是梯度下降 :算出损失对每个参数的偏导数,组成一个向量------梯度,它指向损失上升最快的方向。要让损失下降,沿负梯度方向走一小步即可:
可一旦换到神经网络,事情就复杂多了。每个神经元的输出都是下一层的输入:
这是典型的复合函数嵌套 ,而且嵌套了好多层。要算出损失对深处某个参数的偏导数,必须借助一种强大的数学工具------链式法则。
2.3 链式法则
链式法则的核心思想很朴素:如果 x 影响 u**,**u 又影响 y,那么 x 对 y 的总影响等于这两段影响的乘积。
若 y=f(u),u=g(x),则:
举个例子,y = u^2,u = 2x-1,可以画成下面这张计算图:
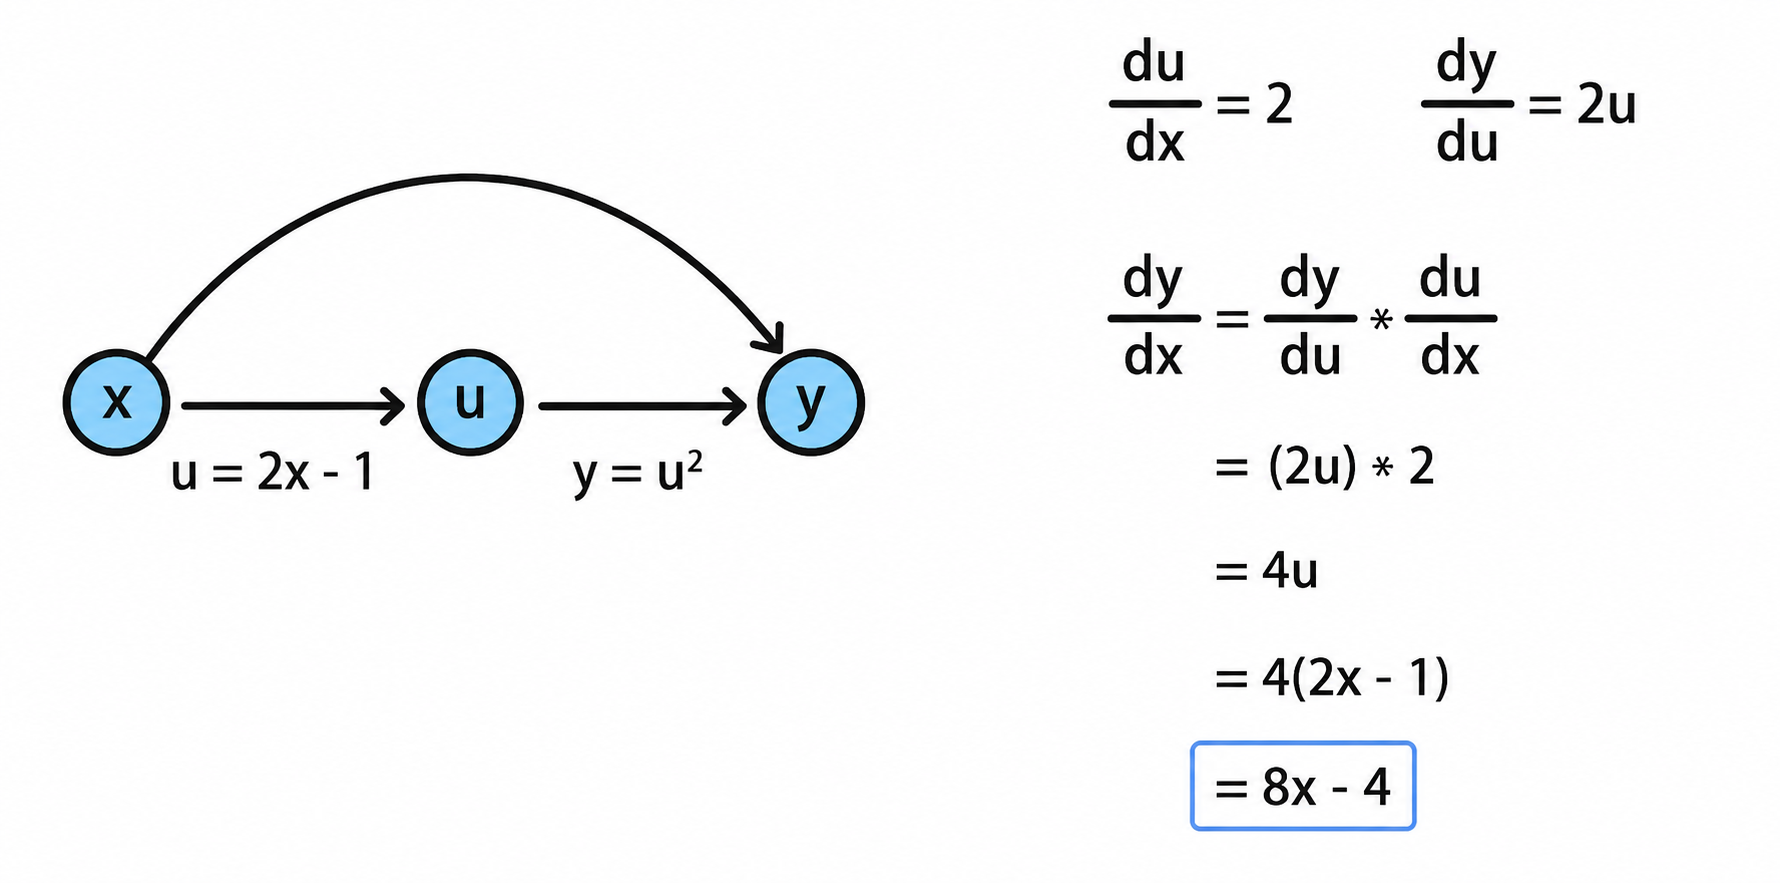
按链式法则:
代入 x=1:。意思是在 x=1 附近,x 每增加 0.001,y 大约会增加
。
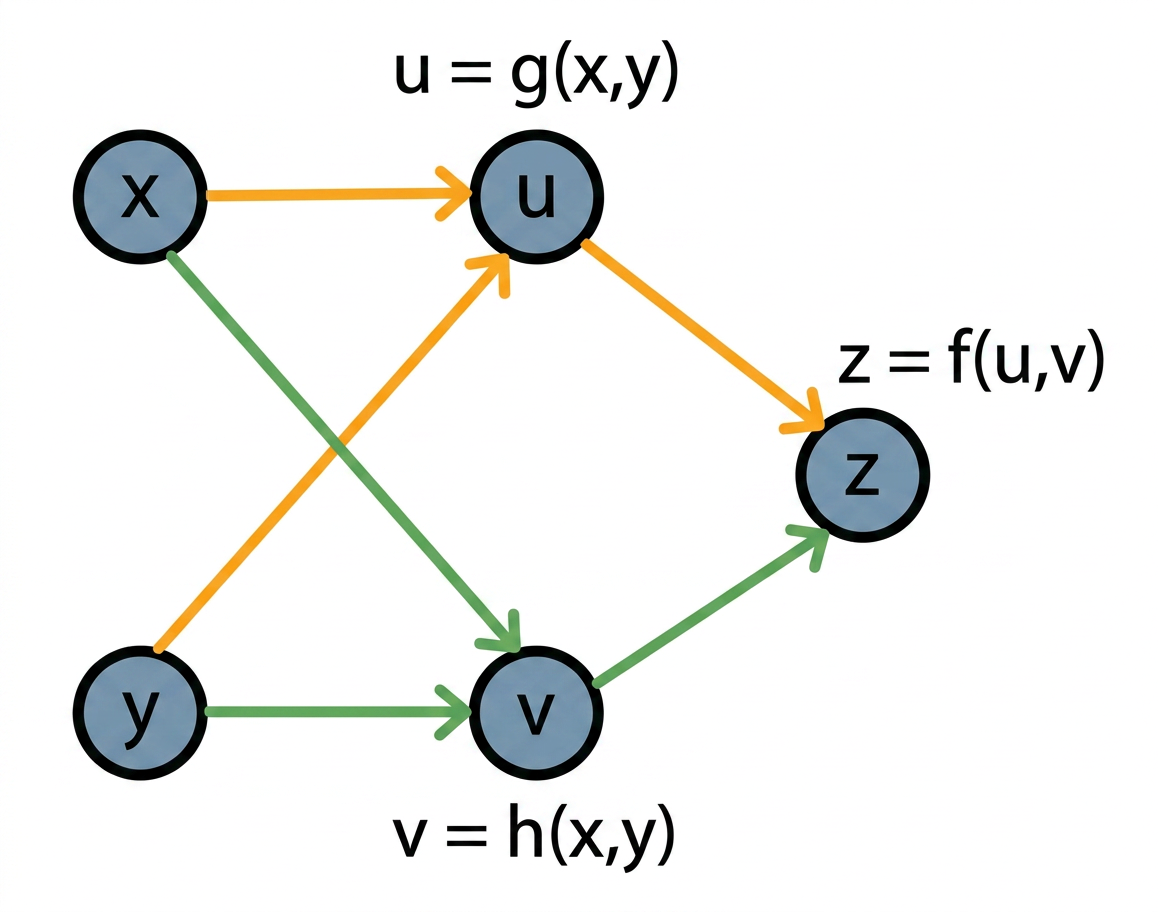
当函数有多个输入变量时,链式法则会变成"所有路径导数的和"。设 z = f(u, v),而 u = g(x,y)、v = h(x,y),那么:
2.4 反向传播
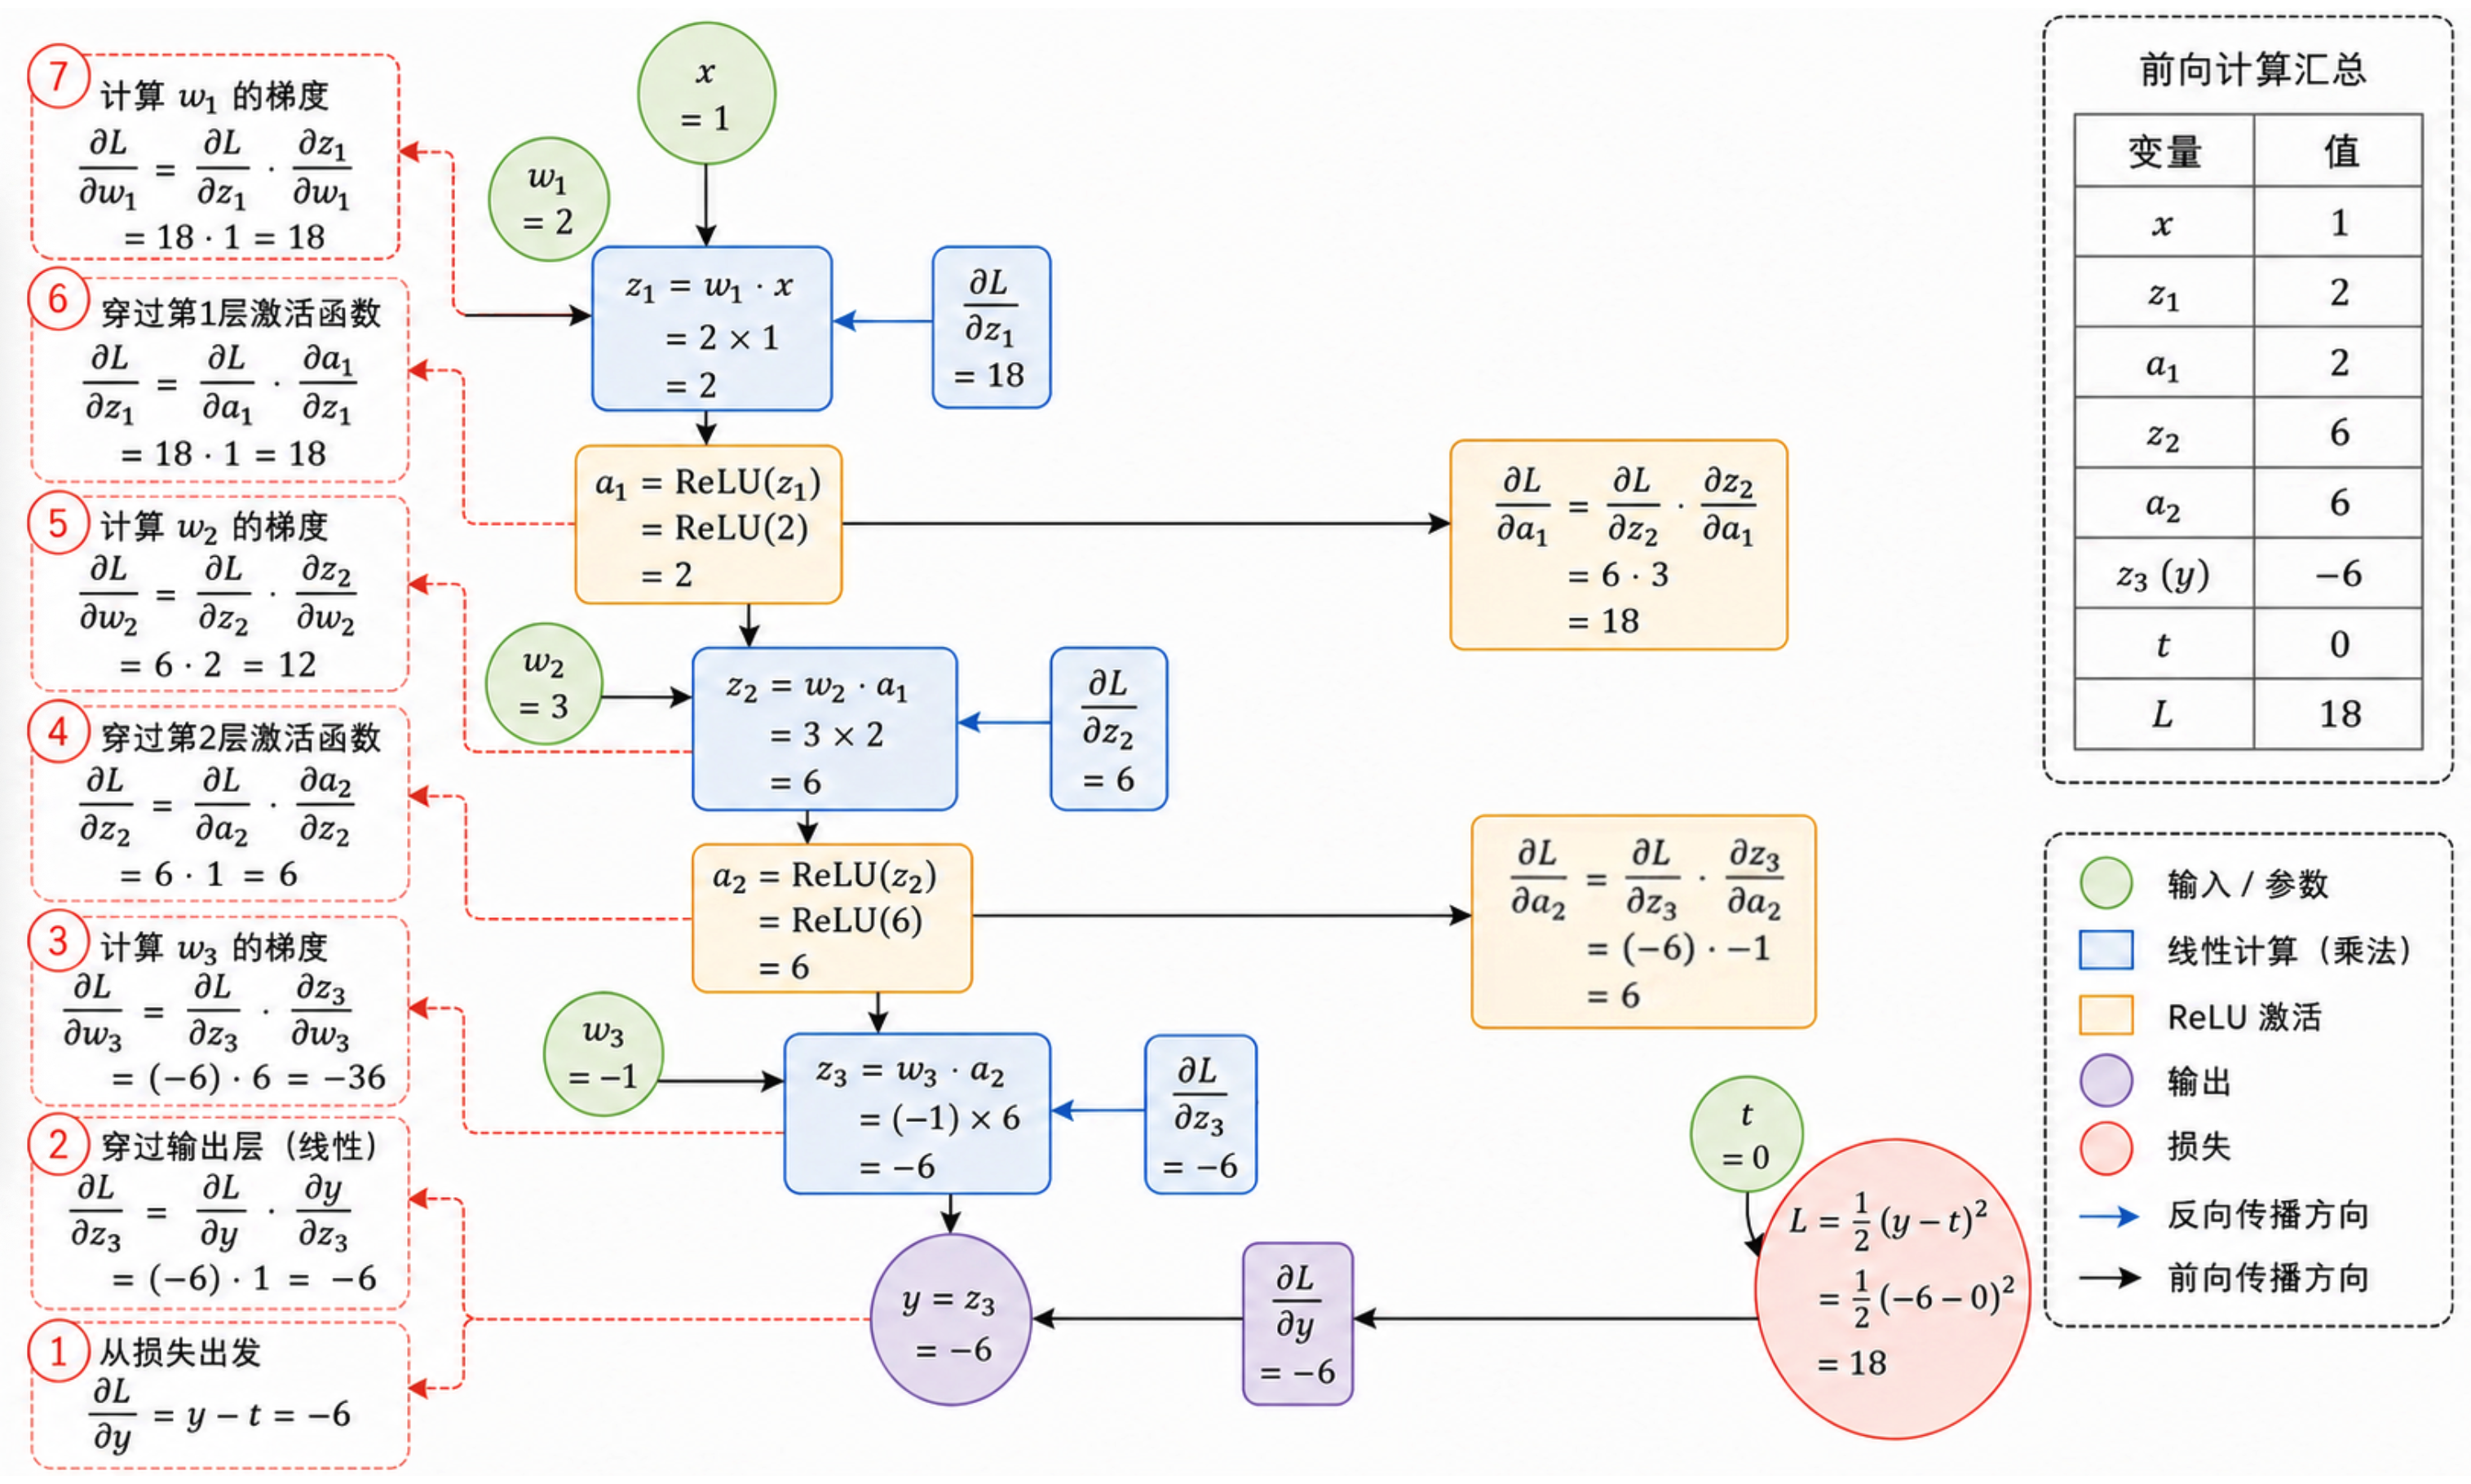
如下是一个极简的神经网络
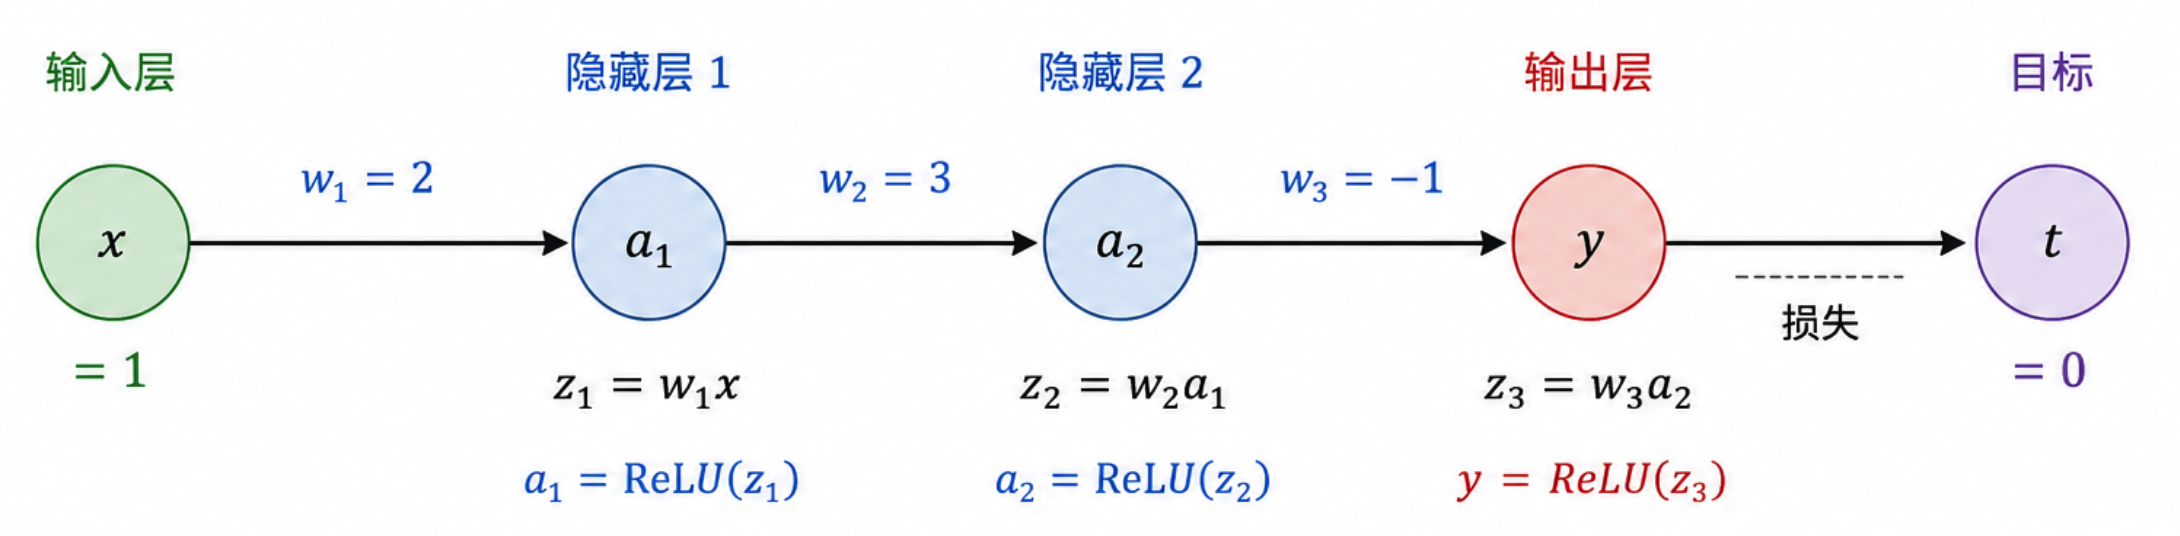
- 网络结构:3 层,每层 1 个神经元,无偏置;输入 x = 1,目标 t = 0;初始权重 w1 = 2,w2 = 3,w3 = -1。
- 激活函数 :为了让导数好算,把阶跃函数换成 ReLU------输入大于 0 时原样输出,否则输出 0。
- 损失函数 :MSE 的简化形式
(系数 \frac{1}{2} 是为了求导后系数为 1,更简洁)。
如下便是这神经网络的前向传播:
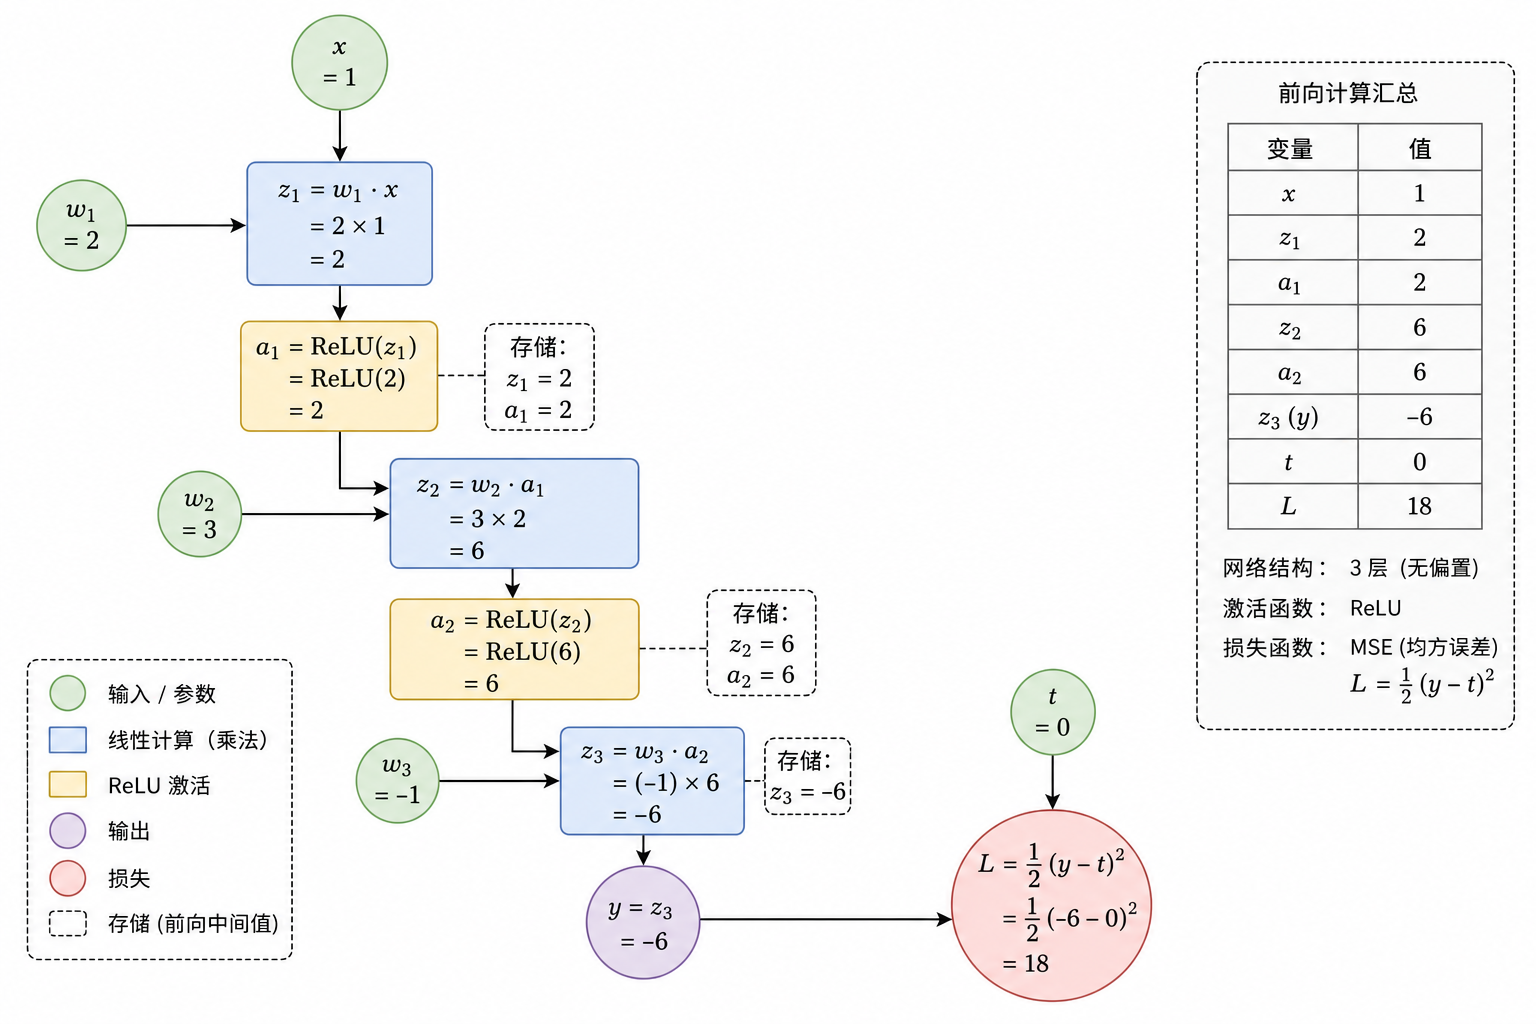
根据反向传播是从损失函数开始出发,利用链式法则进行反向偏导运算,先计算出梯度,后计算参数便于更新,让误差值变小。
因此便要使用ReLU进行求导运算,如下便是反向传播过程:
2.5 梯度下降
前向传播算出了误差,反向传播算出了梯度(指明了调整方向和力度)。接下来用梯度下降把参数往让损失下降的方向推一小步,再跑一次前向传播,验证误差是否真的变小了。
梯度下降公式:
η 便是学习率 ,用来更新梯度w ,也可以称为权重。
因此,在完成梯度下降更新参数后便又重新回到了前向传播。
这就是神经网络学习的本质:
前向传播算误差 \rightarrow反向传播算梯度 \rightarrow梯度下降更新参数 \rightarrow再次前向传播......
如此循环成千上万次,直到损失降到接近 0,模型就训练好了。
3、总结与代码实现
3.1 代码实现
python
import torch
import torch.nn as nn

# ── 数据 ────────────────────────────────────────
x = torch.tensor([[1.0]])
t = torch.tensor([[0.0]])

# ── 网络 ────────────────────────────────────────
model = nn.Sequential(
    nn.Linear(1, 1, bias=False),   # w1
    nn.ReLU(),
    nn.Linear(1, 1, bias=False),   # w2
    nn.ReLU(),
    nn.Linear(1, 1, bias=False),   # w3
)

# 初始化权重,与上面手算示例保持一致
with torch.no_grad():
    model[0].weight.fill_(2.0)
    model[2].weight.fill_(3.0)
    model[4].weight.fill_(-1.0)

# ── 损失函数 + 随机梯度下降优化器 ────────────────────────────
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

# ── 训练 100 轮 ──────────────────────────────────
for epoch in range(100):
    loss = criterion(model(x), t)   # 前向传播 + 计算损失
    optimizer.zero_grad()           # 清空上一轮残留的梯度
    loss.backward()                 # 反向传播,自动计算梯度
    optimizer.step()                # 梯度下降更新权重

    if epoch % 10 == 0:
        print(f"Epoch {epoch+1:3d} | 预测值: {model(x).item():7.4f} | 损失: {loss.item():.4f}")
输出:
python
Epoch   1 | 预测值: -1.2674 | 损失: 36.0000
Epoch  11 | 预测值: -0.0084 | 损失: 0.0002
Epoch  21 | 预测值: -0.0001 | 损失: 0.0000
Epoch  31 | 预测值: -0.0000 | 损失: 0.0000
...
Epoch  91 | 预测值: -0.0000 | 损失: 0.0000
3.2 总结
反向传播算法的提出,是深度学习历史上最重要的里程碑之一。
1986 年,Geoffrey Hinton、David Rumelhart 和 Ronald Williams 联合发表了一篇里程碑式的论文,正式将反向传播应用于多层神经网络的训练,向世人证明:多层网络不仅在理论上强大,在实践中也是完全可训练的。
不过反向传播虽然解决了"怎么训练"的问题,但受限于当时的算力和数据规模,神经网络的训练依旧很困难,加之传统机器学习算法 SVM 横空出世,神经网络又经历了一段低谷。直到 2012 年,Hinton 和他的学生 Alex、Ilya 用 GPU 算力配合反向传播算法,在 ImageNet 竞赛中以碾压式优势夺冠,深度学习才真正迎来爆发,并最终孕育出今天的大语言模型。