单 Agent 是"一个人扛所有活",多 Agent 是"一个团队各司其职"。当你发现 Prompt 越写越长、工具越堆越多、模型越来越迷糊时,就是时候上 LangGraph 了。
一、先说结论:为什么我们需要多 Agent?
做过 Agent 产品的同学大概率都踩过这样的坑:
一开始兴致勃勃写了个单 Agent,把所有 tool 描述、每个功能的 prompt 都塞进 system prompt,跑起来看着还挺像那么回事。可用着用着就发现------
- Token 爆炸:每次调用都把所有 prompt 一股脑塞给模型,实际执行的只是其中一小部分功能,剩下的全是"陪跑"。
- 干扰严重:无关信息堆在上下文里,模型思考时容易被带偏,准确率肉眼可见地下降。
- 没法并行:只有一个大脑,只能一步步来,效率拉满也是线性增长。
说白了,单 Agent 就是让一个人干所有工种:既是产品、又是研发、还得兼职测试。它能干,但干不好。
多 Agent 架构的核心思路很简单:拆分职责,每个 Agent 只带自己需要的最小 Prompt。
scss
Agent = LLM(大脑) + Harness(tool + mcp + rag + skill + ...)拆开之后你会发现三个明显收益:
- 准确率更高、Token 更省
每个子 Agent 只带必要 Prompt,没有冗余信息干扰。虽然 LLM 调用次数变多了,但单次消耗更低,总体更划算。 - 并行思考与处理
主 Agent 下发任务,子 Agent 并行开工,整体效率指数级提升。 - 多角色互纠,容错更强
就像 AutoGen 里模拟"法庭"一样,编程 Agent 写代码,测试 Agent 写测试,验证 Agent 验收。不同角色的视角互相制衡,比一个大脑自说自话靠谱得多。
单 Agent 拼的是 Prompt 长度,多 Agent 拼的是职责边界。
二、LangChain 还是 LangGraph?一句话讲清楚
很多人第一次接触这两个名字会懵:这俩到底啥关系?
先把基础盘理清楚:
- LangChain :提供 LLM API、Document Loaders、Splitter、Embedding、Vector Store、Output Parser、Memory 等基础模块 ,以及线性的工作流编排。
- LangGraph :在 LangChain 的基础上,把工作流编排从"一条直线"升级成网状结构。
用一张图理解:
css
LangChain:  A → B → C → D     (线性)

LangGraph:  A → B → C
                 ↘   ↗
                   D            (网状,可分支、可循环、可并行)
两者的底层基础设施是共享的------同样调 LLM、同样用 Tool、同样管 Memory,LangGraph 只是把"编排"这件事做得更灵活。
一句话总结:LangChain 是零件库 + 直线流水线,LangGraph 是零件库 + 可编程的网状车间。
三、LangGraph 的核心心智模型
LangGraph 的世界观其实就四件事:
| 概念 | 作用 |
|---|---|
| State(状态) | 工作流的共享数据,节点之间通过它传递信息 |
| Node(节点) | 一个函数,接收 state、返回 state 的变化 |
| Edge(边) | 连接节点的方向,决定"下一步去哪" |
| START / END | 图的两个特殊节点,一个开始、一个结束 |
再加上两个关键角色:
- Annotation:声明 state 长什么样,以及每个字段怎么更新(reducer)。
- StateGraph :图的容器,负责把所有节点、边组织起来,最后
compile()成可执行的工作流。
画成图就是:
css
START → 节点A → 节点B → END听起来简单?但正是这种"节点 + 组织方式"的抽象,才撑得起复杂多 Agent 协议。简单的东西能组合出复杂的东西,这才是好的抽象。
四、上手第一课:用 StateGraph 搭一条最短流水线
先看最小可运行例子,理解 StateGraph 的基本套路。
javascript
import {
    Annotation,
    END,
    START,
    StateGraph
} from '@langchain/langgraph';

// 1. 声明状态结构:只有一个 text 字段
const StateAnnotation = Annotation.Root({
    text: Annotation({
        // _prev 是进入当前节点前的旧值,next 是当前节点返回的新值
        // reducer 决定状态如何合并:这里简单地"用新值覆盖旧值"
        reducer: (_prev, next) => next,
        default: () => "",
    })
});

// 2. 定义节点:节点本质就是一个函数
//    输入 state,输出"对 state 的更新"
const step1 = (state) => ({ text: `${state.text} -> step1` });
const step2 = (state) => ({ text: `${state.text} -> step2` });

// 3. 实例化图并组织节点
const graph = new StateGraph(StateAnnotation)
    .addNode("step1", step1)
    .addNode("step2", step2)
    .addEdge(START, "step1")
    .addEdge("step1", "step2")
    .addEdge("step2", END)
    .compile();

// 4. 执行
const result = await graph.invoke({ text: "hello" });
console.log(result);
// { text: "hello -> step1 -> step2" }
几个关键点,划一下:
Annotation.Root用来声明 state 的字段;每个字段都能定义reducer和default。reducer是理解 LangGraph 的核心概念之一。它决定了"上一个节点的状态"和"当前节点的返回值"如何合并。你可以把它理解成数组reduce里的那个累加函数------状态怎么变,全靠它。- 节点就是普通函数,不需要继承、不需要装饰器,返回一个"状态更新对象"即可。
compile()相当于把设计图变成可执行的程序。
小技巧:LangGraph 还支持把图导出成 Mermaid,直接可视化整个流转关系:
ini
const drawable = await graph.getGraphAsync();
console.log(drawable.drawMermaid({ withStyles: true }));
这段输出的 Mermaid 文本可以直接贴到支持的 Markdown 里渲染成流程图,调试时非常爽。
五、分支与循环:让工作流"活"起来
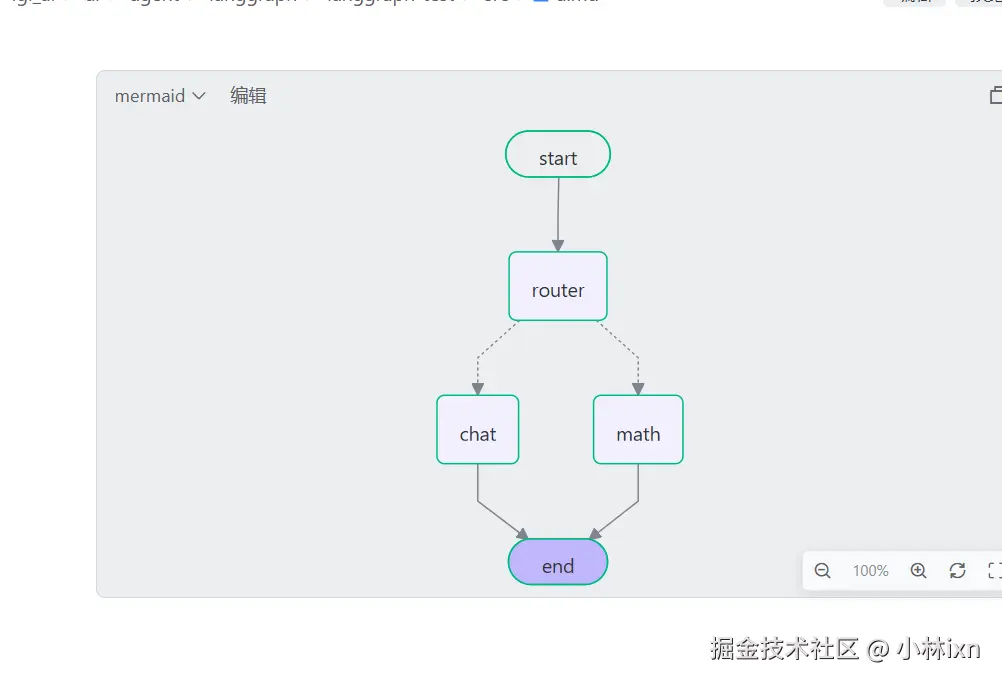
线性图只能跑一遍,而真实业务里更多是"条件分支 + 循环重试 "。这就是 addConditionalEdges 的用武之地。
5.1 条件路由:一个问题,两条路
想象一个场景:用户提问,如果是数学题就走计算节点,否则走聊天节点。
javascript
const StateAnnotation = Annotation.Root({
    query: Annotation({ reducer: (_p, n) => n, default: () => "" }),
    route: Annotation({ reducer: (_p, n) => n, default: () => "chat" }),
    answer: Annotation({ reducer: (_p, n) => n, default: () => "" })
});

// 路由节点:只负责"决定往哪走",不负责干活
const router = (state) => {
    const isMath = /[+-*/]/.test(state.query);
    return { route: isMath ? "math" : "chat" };
};

const mathNode = (state) => {
    try {
        return { answer: String(eval(state.query)) };
    } catch {
        return { answer: "表达式无法计算" };
    }
};

const chatNode = (state) => ({
    answer: `你说的是: ${state.query}`
});

const graph = new StateGraph(StateAnnotation)
    .addNode("router", router)
    .addNode("math", mathNode)
    .addNode("chat", chatNode)
    .addEdge(START, "router")
    // 关键:根据 state.route 决定下一跳
    .addConditionalEdges("router", (state) => state.route, {
        math: "math",
        chat: "chat"
    })
    .addEdge("math", END)
    .addEdge("chat", END)
    .compile();
⚠️ 温馨提示:这里用
eval()只是为了演示方便,生产环境千万不要这么写,把它当作把字符串当 JS 代码执行的"危险动作"记住就行。
5.2 循环重试:失败就再来一次
更典型的场景是"重试直到成功":
javascript
const attempt = (state) => {
    const tries = state.tries + 1;
    const ok = tries >= 3;       // 第 3 次才成功
    return {
        tries,
        ok,
        message: ok ? `第${tries}次成功` : `第${tries}次失败`
    };
};

const graph = new StateGraph(StateAnnotation)
    .addNode("attempt", attempt)
    .addEdge(START, "attempt")
    .addConditionalEdges("attempt",
        (state) => state.ok ? "done" : "retry",
        { retry: "attempt", done: END }
    )
.compile();你会发现这里的逻辑非常直白:节点负责干活,条件边负责决策。这种"职责分离"的设计,正是 LangGraph 相比手写 while 循环优雅的地方。
金句:节点管做事,条件边管决策------把控制流和业务逻辑分开,是多 Agent 可维护性的关键。
六、持久化:别让 Agent 每次都从零开始
聊完了控制流,必须聊一个被很多人忽视的能力:状态持久化。
场景想想就懂:
- Agent 执行到一半失败了,难道要从头再跑一遍?
- 用户提问后要等授权,暂停后如何从断点继续?
- 多个用户同时访问,怎么保证互不干扰?
LangGraph 给出的答案就是 Checkpointer。
6.1 MemorySaver:多会话隔离
ini
import { MemorySaver } from '@langchain/langgraph';

const checkpointer = new MemorySaver();
const app = graph.compile({ checkpointer });

// 通过 thread_id 区分不同会话
const user1 = { configurable: { thread_id: "用户-小张" } };
const user2 = { configurable: { thread_id: "用户-小李" } };

await app.invoke({}, user1);   // 小张第1次进入
await app.invoke({}, user2);   // 小李第1次进入
await app.invoke({}, user1);   // 小张第2次进入(会延续之前的 state)
await app.invoke({}, user2);   // 小李第2次进入
thread_id 就是会话的身份证 。同一 thread_id 会拿到上次执行留下的 state,不同 thread_id 互不影响。
MemorySaver 把状态放在内存里,适合开发调试;生产环境可以换成 SQLite、Redis、Postgres 等持久化方案,让状态跨进程、跨重启存活。
七、中断与恢复:Human-in-the-Loop 的正确姿势
这是我认为 LangGraph 最"惊艳"的能力之一。
想想一个转账 Agent:它算好了"向张三转账 $100",但不能直接执行 ,得等用户确认。传统的做法是"要么全自动、要么全手动",而 LangGraph 让你可以精确地在某个节点暂停,等人类输入后再恢复执行。
javascript
import {
    Annotation, END, START, StateGraph,
    Command, interrupt, MemorySaver
} from '@langchain/langgraph';
import { createInterface } from "node:readline/promises";

const StateAnnotation = Annotation.Root({
    actionSummary: Annotation({ reducer: (_p, n) => n, default: () => '' }),
    userInput: Annotation({ reducer: (_p, n) => n, default: () => '' }),
});

// 展示"待确认的动作"
const showTransfer = () => ({
    actionSummary: "向张三转账 $100"
});

// 中断等待用户输入
const waitConfirm = (state) => {
    const text = interrupt({
        hint: "输入 [确认] 或备注后回车,图才会继续",
        actionSummary: state.actionSummary,
    });
    return { userInput: String(text) };
};

const graph = new StateGraph(StateAnnotation)
    .addNode("showTransfer", showTransfer)
    .addNode("waitConfirm", waitConfirm)
    .addEdge(START, "showTransfer")
    .addEdge("showTransfer", "waitConfirm")
    .addEdge("waitConfirm", END)
    .compile({ checkpointer: new MemorySaver() });

const config = { configurable: { thread_id: "interrupt-demo" } };

// 第一次执行,会在 interrupt 处挂起
const paused = await graph.invoke({}, config);
console.log("待你确认", paused.__interrupt__?.[0]?.value);

// 等待用户输入
const rl = createInterface({ input: process.stdin, output: process.stdout });
const line = (await rl.question("> ")).trim();
await rl.close();

// 用 Command 恢复执行,把用户输入注入进去
const done = await graph.invoke(new Command({ resume: line }), config);
console.log("done", done);
几个关键理解点:
interrupt(payload)在节点内主动触发中断,payload 会被挂到结果的__interrupt__字段上,供外部读取。checkpointer是必需的,因为中断后状态得先存下来,恢复时才能接着跑。new Command({ resume: xxx })是恢复执行的方式,resume的值会成为interrupt()的返回值,代码从断点处继续往下走。
用一句话总结这个模式:
中断 = 暂停快照,Command = 恢复执行。二者的组合,让 Agent 可以优雅地"中途接管"。
这一套机制在真实产品里可以衍生出很多玩法:
- 危险操作前的人工审批
- 长流程中的多轮确认
- Agent 卡住时的人工纠偏
八、把这套东西串起来:多 Agent 落地要点
最后,把这一整篇的内容浓缩成一份落地清单,方便你随时回看:
- 先想清楚要不要拆
单 Agent 能用就别硬拆。当 Prompt 变长、Token 变贵、准确率开始飘时,才考虑多 Agent。 - 职责按"最小 Prompt 集"划分
每个子 Agent 只带自己需要的 Prompt 和 Tool,多余信息一律砍掉。 - 用 StateGraph 组织协作
主 Agent 作为"主管节点"下发任务,子 Agent 作为"工作节点"并行或串行执行。 - 控制流和业务逻辑分离
业务在节点里,决策在条件边里,这样图才好维护。 - 状态一定要可持久化
开发时MemorySaver,生产上 Redis/DB,thread_id做好会话隔离。 - 该中断就中断
危险操作、长流程节点,用interrupt + Command让人类拥有"最后一票否决权"。
九、写在最后
从 LangChain 到 LangGraph,本质是从"线性编排"到"网状编排"的一次升级。
多 Agent 不是为了炫技,而是为了在 Prompt 越来越长、任务越来越复杂的今天,让每一个"大脑"都能专注于自己那点事。
好的架构不是把所有能力塞给一个 Agent,而是让每个 Agent 只做它最擅长的事。