老炮踩坑录 · D02 · 技术深挖系列
· 基于「企业融合评估系统」真实源码
· 系统中拿到的每个企业的诊断数据维度都不一样,表头不固定,列数不固定,顺序也不固定。怎么导出一份整齐的Excel ?这篇文章,就从算法设计到每一行POI代码,进行完整的拆解。
⚠️提前预告:本文踩的最大一个坑,就是开篇承诺 "整齐",但核心算法用的
HashSet根本不保证顺序。读完你会看到我是怎么栽的。
引子
您好,文接上篇,见字如面。
做过Excel导出的朋友都知道,最头疼的不是填数据,是画表头。
固定表头简单------模板里画好,数据往里填就行。但如果表头是动态的呢?
这就是 POI 动态表头的核心难点。下面看真实业务场景。
业务场景
诊断系统返回的数据示例:
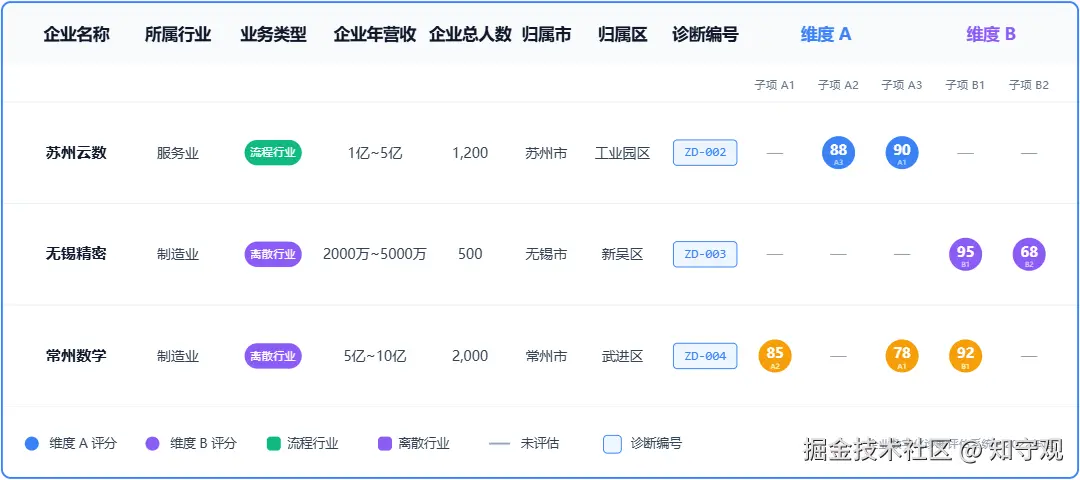 简化的数据结构(JSON):
json
{
  "groupData": [
    {
      "name": "维度A",
      "detail": [
        {"name": "子项A1", "value": "85"},
        {"name": "子项A2", "value": "92"}
      ]
    },
    {
      "name": "维度B",
      "detail": [
        {"name": "子项B1", "value": "78"},
        {"name": "子项B2", "value": "88"},
        {"name": "子项B3", "value": "95"}
      ]
    }
  ]
}
结构说明:
groupData[].name是一级表头,groupData[].detail[].name是二级表头,groupData[].detail[].value是数据值。
问题来了:每个企业返回的维度和子项不一样。
css
企业A:维度A[子项A1, 子项A2] + 维度B[子项B1]
企业B:维度A[子项A1, 子项A2, 子项A3] + 维度C[子项C1, 子项C2]  ← 多了A3和C
企业C:维度B[子项B1, 子项B2] + 维度C[子项C1] ← 多了B2但是导出Excel时,要一张表装下所有企业------表头必须是所有维度和子项的并集。
没有的填 "-",有的填上。
这个算法,我写了360行左右的代码。今天来完整拆解。
问题拆解
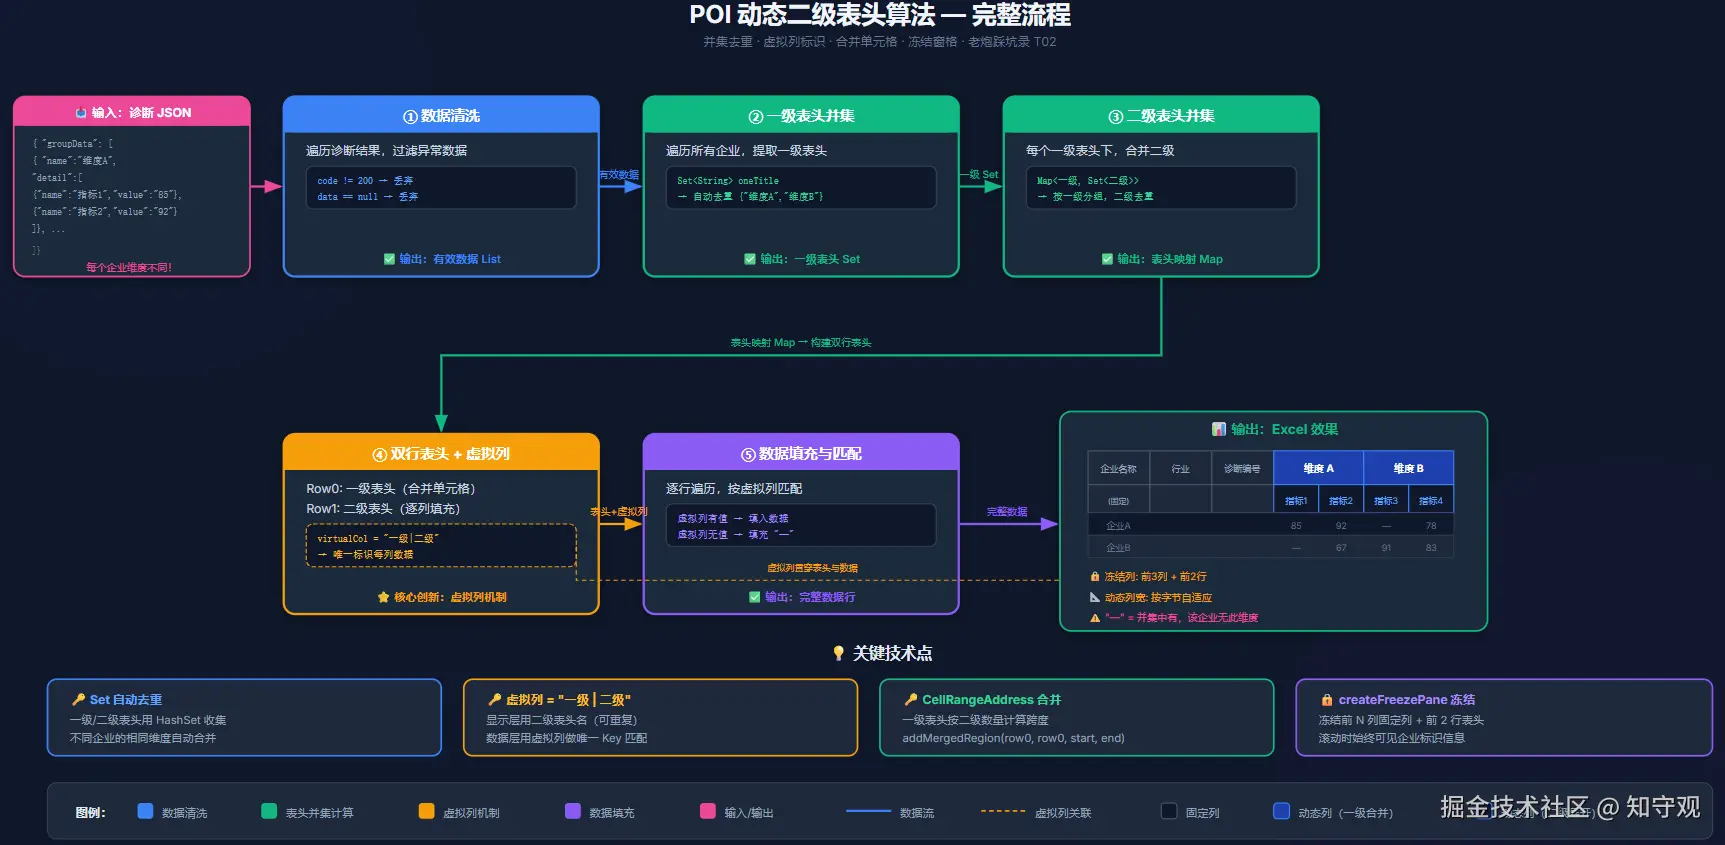
首先把问题拆成五步:
vbnet
第一步:数据清洗 → 过滤掉诊断系统返回异常的脏数据
第二步:一级表头并集 → 收集所有企业的一级表头(去重)
第三步:二级表头并集 → 对每个一级表头,收集其下所有二级表头(去重)
第四步:双行表头渲染 → 第一行一级表头(合并单元格),第二行二级表头
第五步:数据填充 → 按虚拟列Key匹配数据,没有的填"-"
第一步:数据清洗
诊断系统偶尔会返回异常数据(网络抖动、服务超时)。如果不过滤,后面构建表头时会报NPE错误。
java
List<Map<String, Object>> applyData = new ArrayList<>();
List<Map<String, Object>> queryData = applyInfoService.selectApplyInfoDiagnosisExport();

for (Map<String, Object> dataMap : queryData) {
    boolean flag = true;
    String resultStr = (String) dataMap.get("result");
    JSONObject result = JSONObject.parseObject(resultStr);

    // 检查1:HTTP状态码是否为200
    Integer code = result.getInteger("code");
    if (code == null || code != HttpServletResponse.SC_OK) {
        flag = false;
    }

    // 检查2:data节点是否存在
    JSONObject dataJson = result.getJSONObject("data");
    if (dataJson == null) {
        flag = false;
    } else {
        // 检查3:groupData数组是否存在且非空
        JSONArray jsonArray = dataJson.getJSONArray("groupData");
        if (jsonArray == null || jsonArray.size() == 0) {
            flag = false;
        }
    }

    if (flag) {
        applyData.add(dataMap);
    }
}
三层校验,层层过滤:
ini
原始数据
  → code != 200?→ 扔掉(诊断系统异常)
  → data == null?→ 扔掉(数据为空)
  → groupData 为空?→ 扔掉(没有维度数据)
  → 通过 → 加入有效数据集
第二步:一级表头并集
遍历所有企业数据,收集所有一级表头名称,用 HashSet 自动去重:
java
Set<String> oneTitle = new HashSet<>();

for (Map<String, Object> dataMap : applyData) {
    JSONObject result = JSONObject.parseObject((String) dataMap.get("result"));
    JSONObject dataJson = result.getJSONObject("data");
    JSONArray oneArray = dataJson.getJSONArray("groupData");

    if (oneArray != null) {
        for (Object objectOne : oneArray) {
            JSONObject jsonObjectOne = (JSONObject) objectOne;
            String nameLevelOne = jsonObjectOne.getString("name");
            oneTitle.add(nameLevelOne);  // HashSet自动去重
        }
    }
}
示例:
css
企业A返回:维度A, 维度B
企业B返回:维度A, 维度C
企业C返回:维度B, 维度C

并集结果:{维度A, 维度B, 维度C}  ← 3个,不重复
⚠️ 踩坑提示:HashSet 无序,表头会乱跳
这步当时我直接用 HashSet 去重,结果第一版导出的 Excel,表头顺序每次都不一样------今天"维度A"在第一列,明天可能在第三列。
原因 :HashSet 去重没问题,但它不保证插入顺序。开篇承诺"导出整齐的 Excel",这里就是个隐藏雷。
正确做法: 用 LinkedHashSet 替代 HashSet------既能去重,又保留首次出现的顺序。第三步的 HashMap 同理要换成 LinkedHashMap。重构章节会给出修正版。
第三步:二级表头并集
这是算法最复杂的一步。
目标: 对每个一级表头,收集其下所有二级表头(去重)。
难点: 不同企业的一级表头下的二级子项可能不同。
java
// 先收集每个企业各自的"一级→二级"映射关系
List<Map<String, Set<String>>> relaList = new ArrayList<>();

for (Map<String, Object> dataMap : applyData) {
    JSONObject result = JSONObject.parseObject((String) dataMap.get("result"));
    JSONObject dataJson = result.getJSONObject("data");
    JSONArray oneArray = dataJson.getJSONArray("groupData");

    Map<String, Set<String>> relaMap = new HashMap<>();
    if (oneArray != null) {
        for (Object objectOne : oneArray) {
            JSONObject jsonObjectOne = (JSONObject) objectOne;
            String nameLevelOne = jsonObjectOne.getString("name");
            JSONArray twoArray = jsonObjectOne.getJSONArray("detail");

            Set<String> twoTitle = new HashSet<>();
            if (twoArray != null) {
                for (Object objectTwo : twoArray) {
                    JSONObject jsonObjectTwo = (JSONObject) objectTwo;
                    twoTitle.add(jsonObjectTwo.getString("name"));
                }
            }
            relaMap.put(nameLevelOne, twoTitle);
            relaList.add(relaMap);
        }
    }
}

// 然后对每个一级表头,合并所有企业的二级表头(并集)
Map<String, Set<String>> titleMap = new HashMap<>();
for (String one : oneTitle) {
    Set<String> twoRealTitle = new HashSet<>();
    for (Map<String, Set<String>> stringSetMap : relaList) {
        for (Map.Entry<String, Set<String>> entry : stringSetMap.entrySet()) {
            if (entry.getKey().equals(one)) {
                twoRealTitle.addAll(entry.getValue());
            }
        }
    }
    titleMap.put(one, twoRealTitle);
}
示例:
css
维度A 在各企业中的子项:
  企业A: {子项A1, 子项A2}
  企业B: {子项A1, 子项A3}
  企业C: (没有维度A)

维度A 的二级表头并集:{子项A1, 子项A2, 子项A3}

最终 titleMap:
  维度A → {子项A1, 子项A2, 子项A3}
  维度B → {子项B1, 子项B2}
  维度C → {子项C1, 子项C2}
第四步:双行表头渲染
第一行:一级表头 + 合并单元格
css
企业名称 | 所属行业 | ... | 维度A(合并3列)     | 维度B(合并2列)| 维度C(合并2列)
         |         |     |                      |                 |
         |         |     | 子项A1|子项A2|子项A3  | 子项B1 |子项B2  | 子项C1 |子项C2
说明:
startLength是固定列数量(这里是 9,即企业名称、所属行业等 9 列)。动态表头从第 9 列(0-based)开始拼接。
⚠️ 关于 start + 1 的列偏移
下面的
CellRangeAddress(0, 0, start + 1, step)看起来像是把合并区域整体右移了一列,和startLength的定义对不上。这一处我特意保留原貌------它要么是生产代码里用 1-based 思维写的遗留,要么是start的语义和注释不同步。重构时我会改成符合 0-based 直觉的
new CellRangeAddress(0, 0, start, start + size - 1),并配上单元测试验证列对齐。
java
// 固定列的表头
StringBuffer titleBuffer = new StringBuffer();
titleBuffer.append("企业名称,企业所属行业,业务类型,企业年营业额,企业总人数,");
titleBuffer.append("归属市,归属区,当前所属等级,诊断编号,");

// 动态列的表头(一级表头,每个一级表头占N列,N=其下二级表头数量)
for (Map.Entry<String, Set<String>> entry : titleMap.entrySet()) {
    String key = entry.getKey();
    Set<String> value = entry.getValue();
    titleBuffer.append(key).append(",");
    // 一级表头后面的空位(给合并单元格留空间)
    for (int k = 0; k < value.size() - 1; k++) {
        titleBuffer.append("").append(",");
    }
}

// 填充到第一行
String[] row_first = titleBuffer.substring(0, titleBuffer.length() - 1).split("\\,");
HSSFRow row0 = sheet.createRow(0);
for (int i = 0; i < row_first.length; i++) {
    HSSFCell tempCell = row0.createCell(i);
    tempCell.setCellStyle(headerStyle);
    tempCell.setCellValue(row_first[i]);
}

// 合并一级表头的单元格
int start = startLength;  // 固定列数量
for (Map.Entry<String, Set<String>> entry : titleMap.entrySet()) {
    int size = entry.getValue().size();
    int step = start + size;
    // 第0行,从start+1列到step列,合并
    CellRangeAddress region = new CellRangeAddress(0, 0, start + 1, step);
    sheet.addMergedRegion(region);
    start = start + size;
}
第二行:二级表头 + 虚拟列标识
这里有一个精妙的设计------虚拟列。
java
// titleBuffer:  只存二级表头名称(用于Excel显示,可以重复)
// virtualColumn:存"一级表头-二级表头"(用于数据匹配,全局唯一)
StringBuffer virtualColumn = new StringBuffer(
    "企业名称,企业所属行业,业务类型,企业年营业额,企业总人数,归属市,归属区,当前所属等级,诊断编号,");

for (Map.Entry<String, Set<String>> entry : titleMap.entrySet()) {
    String key = entry.getKey();       // 一级表头
    Set<String> value = entry.getValue(); // 二级表头集合
    for (String twoTitle : value) {
        titleBuffer.append(twoTitle).append(",");              // 显示用
        virtualColumn.append(key + "-" + twoTitle).append(","); // 匹配用
    }
}
为什么需要虚拟列?
css
假设两个不同的一级表头下,有同名的二级表头:
  维度A → "优化得分"
  维度B → "优化得分"

Excel显示的是二级表头名称(可以重复):
  第一行:... | 维度A(合并1列)| 维度B(合并1列)
  第二行:... | 优化得分       | 优化得分

如果只用"优化得分"做Key来匹配数据,会冲突------不知道填的是维度A的还是维度B的。

用虚拟列"维度A-优化得分"和"维度B-优化得分"就能区分。
固定列的跨行合并
前几列(企业名称等)需要跨两行合并:
java
protected void setDataStyleAndHeight(Sheet sheet, Workbook wb) {
    // 第0-8列,跨第0-1行合并
    for (int i = 0; i <= 8; i++) {
        CellRangeAddress region = new CellRangeAddress(0, 1, i, i);
        sheet.addMergedRegion(region);
        // 设置四边边框
        RegionUtil.setBorderBottom(BORDER_THIN, region, sheet, wb);
        RegionUtil.setBorderTop(BORDER_THIN, region, sheet, wb);
        RegionUtil.setBorderLeft(BORDER_THIN, region, sheet, wb);
        RegionUtil.setBorderRight(BORDER_THIN, region, sheet, wb);
    }
}
原代码把这段写了137行------同样的4行代码重复9次。 一个for循环就能搞定。
第五步:数据填充
表头建好了,现在往里面填数据:
java
List<Map<String, Object>> excelDataList = new ArrayList<>();

for (Map<String, Object> dataMap : applyData) {
    Map<String, Object> excelData = new HashMap<>();

    // 固定列数据
    excelData.put("企业名称", (String) dataMap.get("enterpriseName"));
    excelData.put("企业所属行业", ...);
    excelData.put("业务类型", ...);  // 0→"离散行业", 1→"流程行业"
    excelData.put("企业年营业额", ...);  // 0→"2000万以下", 1→"2000万至5000万"...
    // ...

    // 动态列数据:按虚拟列Key匹配
    JSONObject dataJson = result.getJSONObject("data");
    for (Map.Entry<String, Set<String>> entry : titleMap.entrySet()) {
        String key = entry.getKey();           // 一级表头
        Set<String> value = entry.getValue();  // 二级表头集合

        for (String twoTitle : value) {
            boolean haveTwo = false;
            JSONArray oneArray = dataJson.getJSONArray("groupData");

            if (oneArray != null) {
                for (Object objectOne : oneArray) {
                    JSONObject jOne = (JSONObject) objectOne;
                    if (key.equals(jOne.getString("name"))) {  // 找到匹配的一级表头
                        JSONArray twoArray = jOne.getJSONArray("detail");
                        for (Object objectTwo : twoArray) {
                            JSONObject jTwo = (JSONObject) objectTwo;
                            if (twoTitle.equals(jTwo.getString("name"))) {
                                // 匹配上了!用虚拟列Key存数据
                                excelData.put(key + "-" + jTwo.getString("name"),
                                             jTwo.getString("value"));
                                haveTwo = true;
                            }
                        }
                    }
                }
            }
            if (!haveTwo) {
                // 该企业没有这个维度 → 填"-"
                excelData.put(key + "-" + twoTitle, "-");
            }
        }
    }
    excelDataList.add(excelData);
}
填充到Excel行:
java
String[] row_second_real = virtualColumn.substring(0, virtualColumn.length() - 1).split("\\,");

for (int m = 0; m < excelDataList.size(); m++) {
    HSSFRow tempRow = sheet.createRow(rowNum++);
    Map<String, Object> map = excelDataList.get(m);
    // ⚠️ 这里应该用 row_second_real.length(虚拟列总数),不是 map.size()
    // 原代码能跑只是因为填数据时所有虚拟列都 put了(命中的填值,未命中的填"-")
    // 一旦某列漏 put,map.size() 就会小于虚拟列数,整行错位
    for (int n = 0; n < row_second_real.length; n++) {
        HSSFCell tempCell = tempRow.createCell(n);
        tempCell.setCellStyle(contentStyle);
        // 用虚拟列Key取数据
        String data = (String) map.get(row_second_real[n]);
        if (data == null) data = "";
        tempCell.setCellValue(data);
    }
}
冻结列
java
sheet.createFreezePane(startLength, 2, startLength, 3);参数含义:
| 参数 | 值 | 含义 |
|---|---|---|
colSplit |
9 | 第9列以左冻结 |
rowSplit |
2 | 第2行以上冻结 |
leftmostColumn |
9 | 水平滚动时从第9列开始 |
topRow |
3 | 垂直滚动时从第3行开始 |
效果: 横向滚动时,企业名称等9列始终可见;纵向滚动时,两行表头始终可见。
自适应列宽
动态表头的宽度根据文字长度自动调整:
java
if (i > startLength) {  // 只处理动态列
    int byteLength = row_second[i].getBytes().length;
    if (byteLength <= 6) {
        sheet.setColumnWidth(i, byteLength * 512);   // 短文字,宽一点
    } else {
        sheet.setColumnWidth(i, byteLength * 256);   // 长文字,窄一点(能放下)
    }
}
算法总结图
为了让大家更好的理解算法逻辑,我画了一个整体流程图:
如果让我重构
360 行账本: 算法核心 80 行 + 样式设置 137 行 + POI 操作与拼装 143 行。重构主要砍前两块。
核心算法可以精简
360行代码中,真正有算法价值的只有并集计算部分(约80行),其余都是POI操作和样式设置。
如果用 Java 8 的Stream API重写并集计算:
java
// 一级表头并集(LinkedHashSet 保序,呼应开篇"整齐"承诺)
Set<String> oneTitle = applyData.stream()
    .map(d -> JSONObject.parseObject((String) d.get("result")))
    .map(r -> r.getJSONObject("data").getJSONArray("groupData"))
    .filter(Objects::nonNull)
    .flatMap(JSONArray::stream)
    .map(o -> ((JSONObject) o).getString("name"))
    .collect(Collectors.toCollection(LinkedHashSet::new));

// 二级表头并集(LinkedHashMap 保一级顺序,LinkedHashSet 保二级顺序)
Map<String, Set<String>> titleMap = applyData.stream()
    .map(d -> JSONObject.parseObject((String) d.get("result"))
        .getJSONObject("data").getJSONArray("groupData"))
    .filter(Objects::nonNull)
    .flatMap(JSONArray::stream)
    .map(o -> (JSONObject) o)
    .collect(Collectors.groupingBy(
        o -> o.getString("name"),
        LinkedHashMap::new,
        Collectors.flatMapping(
            o -> o.getJSONArray("detail").stream()
                .map(d -> ((JSONObject) d).getString("name")),
            Collectors.toCollection(LinkedHashSet::new)
        )
    ));
80行 → 20行。
⚠️ 兼容性提示:
Collectors.flatMapping是 Java 9+ API。本项目 Spring Boot 2.1.0 默认走 Java 8,这段重构代码直接拷过去跑不起来------要么升级 JDK,要么把flatMapping换成mapping+ 手动打平。
中间容器 relaList 是过度设计
第三步我先收集 List<Map<String, Set<String>>> relaList,再二次遍历合并到 titleMap。其实可以边遍历 applyData 边直接合并,省掉整个中间容器:
java
Map<String, Set<String>> titleMap = new LinkedHashMap<>();
for (Map<String, Object> dataMap : applyData) {
    JSONArray oneArray = JSONObject.parseObject((String) dataMap.get("result"))
        .getJSONObject("data").getJSONArray("groupData");
    if (oneArray == null) continue;
    for (Object objectOne : oneArray) {
        JSONObject jOne = (JSONObject) objectOne;
        Set<String> two = titleMap.computeIfAbsent(
            jOne.getString("name"), k -> new LinkedHashSet<>());
        JSONArray twoArray = jOne.getJSONArray("detail");
        if (twoArray == null) continue;
        for (Object objectTwo : twoArray) {
            two.add(((JSONObject) objectTwo).getString("name"));
        }
    }
}
一次遍历搞定,少一个容器、少一次嵌套循环。
样式代码应该提取
137行的 setDataStyleAndHeight() 应该用一个for循环替代:
java
for (int i = 0; i <= 8; i++) {
    CellRangeAddress region = new CellRangeAddress(0, 1, i, i);
    sheet.addMergedRegion(region);
    RegionUtil.setBorderBottom(BORDER_THIN, region, sheet, wb);
    RegionUtil.setBorderTop(BORDER_THIN, region, sheet, wb);
    RegionUtil.setBorderLeft(BORDER_THIN, region, sheet, wb);
    RegionUtil.setBorderRight(BORDER_THIN, region, sheet, wb);
}
137行 → 7行。
第五步四层嵌套循环的性能账
第五步数据填充是 4 层嵌套:企业数 N × 一级表头 M × 二级表头 K × 该企业 groupData 内层 m'×k'。最坏情况 O(N·M·K·m'·k')。企业数上百、维度十几个时就开始卡。
**优化方向:**把每家企业的数据预处理成 Map<虚拟列Key, value>,填充时直接 O(1) 查表,整体降到 O(N·K)。
导出逻辑应该下沉到Service
360行 POI 代码不应该在Controller里。应该提取到独立的 DiagnosisExportService:
java
// Controller只负责调度
@PostMapping("back/exportModel")
public void export(@RequestParam Integer paperid, HttpServletResponse response) {
    exportService.export(paperid, response);
}

// 导出逻辑在Service里
@Service
public class DiagnosisExportService {
    public void exportPlustekDiagnosis(HttpServletResponse response) {
        // 360行POI逻辑搬到这里
    }
}
老炮点评
老炮语录:
"动态表头的本质是集合的并集运算。" ------想通了这一点,360行代码可以缩到100行。但当时我想了三天才想通。
"虚拟列是解决同名冲突的关键。" ------不同一级表头下可能有同名的二级表头。用"一级-二级"拼接做唯一Key,简单有效。
"POI的代码不要写在Controller里。" ------360行POI操作和"接收请求"没有任何关系。它是"报表引擎"的事,不是"前台接待"的事。
"先跑通再优化,但别忘了优化。" ------360行代码跑了两年没出Bug。但每次看都想吐。代码不是写给自己看的,是写给半年后的自己看的。
"Excel导出最难的从来不是填数据,是画表头。" ------数据是确定的,表头是不确定的。处理"不确定性"才是真正的技术含量。
下期预告《雪花算法看似简单,但41位时间戳里藏了三个坑,我全踩了一遍》
下一篇,我拆解"雪花算法ID生成器"的完整实现------位运算、时钟回拨、分布式ID的坑。
我是老炮,18年仍然奋斗在一线的Java老兵。关注我,每期分享真实案例,让你少走弯路。