LIMIT 1:PostgreSQL 只取一行的高效查询姿势
标签:#PostgreSQL #性能优化 #SQL #LIMIT
一、前言
业务里有一大类查询只需要一行数据:判断是否存在、取最新一条、取最小 / 最大一条......
很多人不写 LIMIT,结果数据库把所有匹配行都扫完才返回------大部分工作白干:
sql
-- ❌ 查用户最新订单,没加 LIMIT:扫完全部匹配行
SELECT * FROM orders WHERE user_id = 10086 ORDER BY created_at DESC;

-- ✅ 只需要一行,加 LIMIT 1:找到第一行就停
SELECT * FROM orders WHERE user_id = 10086 ORDER BY created_at DESC LIMIT 1;
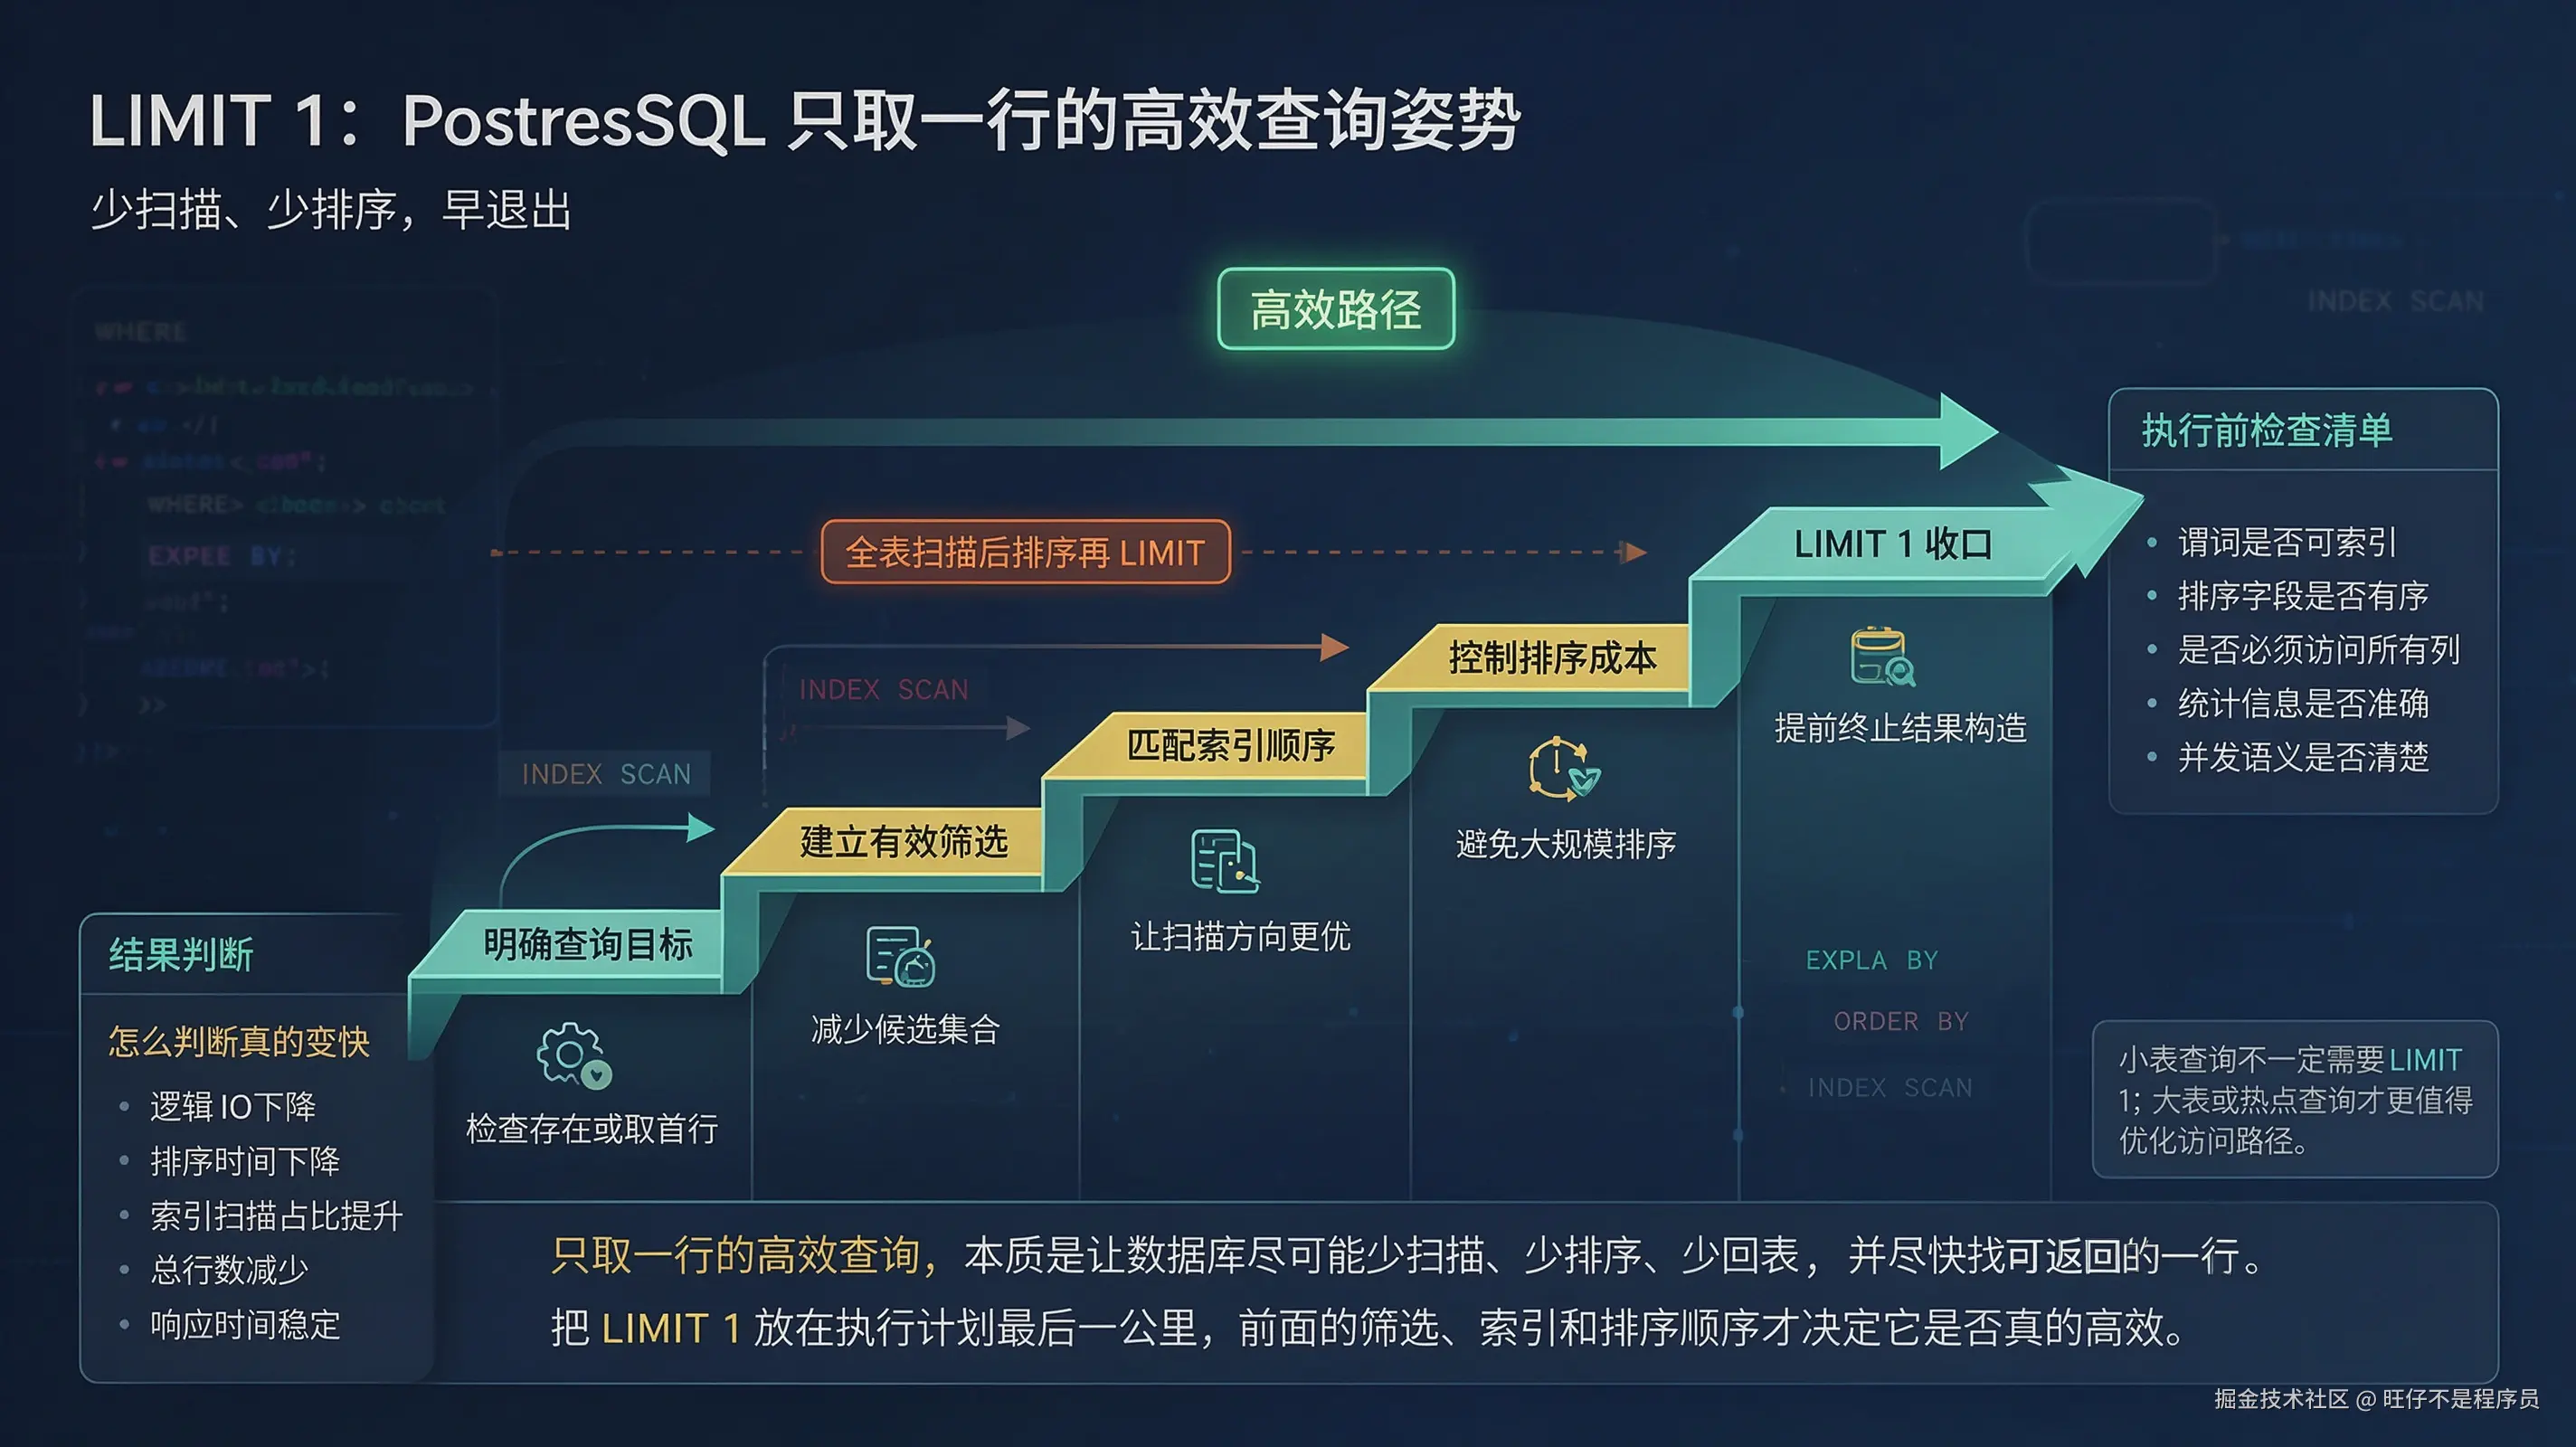
当只需要查询一行数据时,请使用 LIMIT 1------配合合适的索引,数据库"命中即停",扫描成本从"全量"降到"一条"。
二、核心开发规范
- 只需要一行数据 → 加
LIMIT 1:执行计划带 Limit 节点,取够行数即停止拉取(官方 EXPLAIN 文档明确:计划节点执行会因 LIMIT 而提前终止); - 要取"哪一行"必须配
ORDER BY:官方 7.6 明确------SQL 不承诺无 ORDER BY 时的返回顺序,没有排序的LIMIT 1取到的是不可预测的行子集; - 判断"是否存在"优先用
EXISTS:官方明确 EXISTS 子查询"只执行到能确定至少返回一行"就停,语义比SELECT ... LIMIT 1更清晰。
三、底层原理通俗讲解
- LIMIT 的加速原理 :执行计划在顶层放一个 Limit 节点------上层要几行,下层就喂几行,喂够立刻停止(官方 14.1 原话:plan node execution is stopped short by a LIMIT);没有 LIMIT,即使只需要一行,下层也会把匹配行全部扫完;
- 配合索引效果最大化 :
ORDER BY 列上有索引时,计划器直接用 Index Scan 按索引顺序取------从第一个叶子节点开始,取到第一条满足条件的行立即返回,既不用全表扫、也不用全量排序; - 为什么必须 ORDER BY(官方 7.6) :SQL 不承诺无 ORDER BY 时的行顺序------同一查询重复执行可能返回不同的行子集(官方原话:这不是 bug,是 SQL 不保证顺序的固有结果);要"最新一条 / 最小一条 / 固定那一条",必须用 ORDER BY 把顺序钉死;
- EXISTS 与 LIMIT 1 的关系 :判断存在性时,
EXISTS (SELECT 1 ...)同样"找到一行即停"(官方 9.24:子查询一般只执行到确定至少返回一行)------语义上表达"是否存在"更准确,LIMIT 1 则适合真正需要取回那行数据。
四、实战错误案例&优化方案
场景1:只需要一行却不加 LIMIT,全量扫描白干
表设计:orders 表 5000 万行,user_id 有索引,业务要"取用户最新一条订单"
❌ 错误写法(不加 LIMIT,扫完所有订单)
sql
SELECT * FROM orders WHERE user_id = 10086 ORDER BY created_at DESC;
-- 该用户 2000 条订单,2000 条全部扫完、全部排序
-- 应用层只拿第一条 → 99.95% 的工作白干
✅ 正确写法(LIMIT 1,命中即停)
sql
CREATE INDEX CONCURRENTLY idx_orders_user_created
  ON orders (user_id, created_at DESC);

SELECT * FROM orders WHERE user_id = 10086
ORDER BY created_at DESC LIMIT 1;
-- Limit 节点只从索引取 1 行即停
关键结论 :只需要一行就写 LIMIT 1 ------配合 (user_id, created_at DESC) 复合索引,按索引顺序取第一条即停,成本与返回行数成正比而不是与匹配行数成正比。
场景2:要"最新一条"却没排序 / 没索引
表设计:orders 表,status 有单列索引,要取"该状态下的最新订单"
❌ 错误写法(没 ORDER BY,取到"任意一条")
sql
SELECT * FROM orders WHERE status = 'ACTIVE' LIMIT 1;
-- 返回哪一行不确定!可能是最早的、可能是随机的
-- 官方 7.6:无 ORDER BY 时 LIMIT 取到的是不可预测的行子集
-- 同一查询重复执行,可能返回不同的行
✅ 正确写法(ORDER BY 钉死顺序 + 索引支撑)
sql
CREATE INDEX CONCURRENTLY idx_orders_status_created
  ON orders (status, created_at DESC);

SELECT * FROM orders WHERE status = 'ACTIVE'
ORDER BY created_at DESC LIMIT 1;
-- Index Scan Backward using idx_orders_status_created
-- 按 (status, created_at) 索引顺序,命中第一条即停
关键结论 :取"哪一行"必须 ORDER BY + 对应索引------没有 ORDER BY 的 LIMIT 1 结果不可预测(官方明确);ORDER BY 列进索引(等值列在前、排序列在后,呼应第 7 篇联合索引规则),才能"边扫边停"。
场景3:判断"是否存在"用全量查询
表设计:users 表,业务要判断"该邮箱是否已被注册"
❌ 错误写法(SELECT * 全量)
sql
SELECT * FROM users WHERE email = 'admin@xx.com';
-- 取回整行数据,应用层只判断"有没有" → 浪费
✅ 正确写法(EXISTS / SELECT 1 + LIMIT 1)
sql
-- 方式一:EXISTS(语义最清晰,官方:执行到确定至少一行即停)
SELECT EXISTS (SELECT 1 FROM users WHERE email = 'admin@xx.com');

-- 方式二:SELECT 1 ... LIMIT 1(只取 1 行,不取列数据)
SELECT 1 FROM users WHERE email = 'admin@xx.com' LIMIT 1;
-- 有行返回 = 存在;空结果 = 不存在
关键结论 :判断存在性优先 EXISTS (官方 9.24 明确提前终止语义);SELECT 1 ... LIMIT 1 次选------只取一行、不取业务列,两种都比 SELECT * 全量轻。
场景4:验证 LIMIT 的提前终止
表设计:orders 表,已建 (user_id, created_at DESC) 索引
✅ 正确验证(EXPLAIN 看 Limit 节点)
sql
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM orders WHERE user_id = 10086
ORDER BY created_at DESC LIMIT 1;
-- Limit  (cost=0.43..0.46 rows=1 ...) (actual time=0.05..0.05 rows=1)
--   -> Index Scan Backward using idx_orders_user_created
--        (actual time=0.05..0.05 rows=1)   ← 只取 1 行就停
-- 对比:去掉 LIMIT 1 后 rows=2000,扫描成本完全不同
关键结论 :EXPLAIN 是 LIMIT 是否生效的照妖镜 ------Limit 节点 + rows=1 说明命中即停;如果出现 rows=2000 或 Seq Scan,说明 LIMIT 没写或索引没对上。
五、绝对禁止的写法汇总
- 只需要一行却不加 LIMIT(扫完全部匹配行,99% 工作白干);
- 没有 ORDER BY 就用 LIMIT 1(官方:结果不可预测,重复执行可能返回不同行);
- 有 ORDER BY 却没有对应索引(退化成"全量排序再取一条",比不写 LIMIT 好不了多少);
- 判断"是否存在"用
SELECT *全量(应 EXISTS 或SELECT 1 ... LIMIT 1); - 用
LIMIT 1取"每个分组的第一行"(那是 DISTINCT ON / 窗口函数的活,LIMIT 管不了分组内取第一); - 建完索引不 EXPLAIN 验证 (
rows=1的 Limit 节点才是成功标志)。
六、最终评审口诀(记住不踩坑)
只需一行LIMIT 1,提前终止不白扫;
取哪一行ORDER BY,存在判断EXISTS好。
七、总结
- 何时用 :业务只需要一行数据时------取最新 / 最小 / 最大一条、判断是否存在,一律
LIMIT 1; - 怎么写 :
SELECT ... WHERE ... ORDER BY 列 LIMIT 1;------ORDER BY 钉死"取哪一行",LIMIT 1 保证"取到即停",索引保证"停得够快"; - 必配:ORDER BY(官方:无排序的 LIMIT 结果不可预测)+ 对应索引(等值列在前、排序列在后);
- 存在性判断 :优先
EXISTS (SELECT 1 ...)(官方:执行到确定至少一行即停); - 验证 :EXPLAIN 出现
Limit ... rows=1+Index Scan才是高效姿态。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 7.6 LIMIT and OFFSET(无 ORDER BY 时 LIMIT 取到不可预测的行子集)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 14.1 Using EXPLAIN(计划节点执行因 LIMIT 提前终止)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 9.24 Subquery Expressions(EXISTS 子查询只执行到确定至少返回一行)------ www.postgresql.org/docs/curren...