一篇关于数据融合平台选型的独立分析。不写通稿,只说真话。
阅读时间:约 11 分钟 | 标签:#数据融合平台 #数据集成 #数据治理 #国产数据库
做数据的人最头疼的,往往不是没有数据,而是数据太多、散在各处、口径还对不上。 一个业务指标,销售一套数、财务一套数、生产系统又是第三套数,谁也说不好哪个是真的。
于是"数据融合平台"成了搜索框里的高频词。但选型这件事,很多人第一步就走偏了:照着厂商的功能清单比长度,谁的模块多、谁的措辞漂亮,就倾向谁。
先亮结论:数据融合平台选型的本质是匹配度,不是功能清单的长度。 我一直持有一个观点------功能页越长的平台,越要警惕。真正决定你三年后是否还在用它的,是那几个跟你场景对得上的关键能力,而不是一堆你用不上的模块。
这篇文章给你一套可复用的选型框架:7 个维度怎么比、每个维度怎么量化、最后怎么落成决策。
文章目录
-
- 一、动笔之前,先回答一个更基本的问题
- [二、7 个维度:一张表看清该比什么](#二、7 个维度:一张表看清该比什么)
-
- [维度 1:连接器覆盖------数量不等于深度](#维度 1:连接器覆盖——数量不等于深度)
- [维度 2:批流一体------别为两套引擎付两份运维](#维度 2:批流一体——别为两套引擎付两份运维)
- [维度 3:实时同步------可靠性比"快"更值钱](#维度 3:实时同步——可靠性比"快"更值钱)
- [维度 5:数据质量------融合的及格线](#维度 5:数据质量——融合的及格线)
- [维度 6:数据治理与主数据------口径混乱的根](#维度 6:数据治理与主数据——口径混乱的根)
- 三、部署形态与成本:算三年,不算一个月
- [四、把 7 个维度合成一张决策表](#四、把 7 个维度合成一张决策表)
- 五、选型里最常见的四个错误
- [六、常见问题 FAQ](#六、常见问题 FAQ)
- 结语
一、动笔之前,先回答一个更基本的问题
搜索"数据融合平台怎么选"的人,默认自己需要一个平台。但相当一部分人真正缺的,可能不是平台,而是先把数据源、实时性和口径这三件事理清楚。
判断标准很朴素,看三个数:
- 数据源有多少:三五个,还是几十上百个?
- 实时性要求多高:T+1 的日报就够,还是风控要秒级?
- 有没有统一底座:是否已经有一套关系型数据库在承载核心业务?
如果答案是"数据源不多、T+1 够用、已有成熟数据库",上重平台往往得不偿失,一套轻量的集成工具加上人工治理就能扛住。反过来,数据源几十个、有实时要求、口径混乱,才值得认真选一个数据融合平台。
这一步想清楚,能直接筛掉一半的错误选型。下面的 7 个维度,是针对"确认需要平台"之后的那部分决策。
二、7 个维度:一张表看清该比什么
先给全景,再逐个拆。
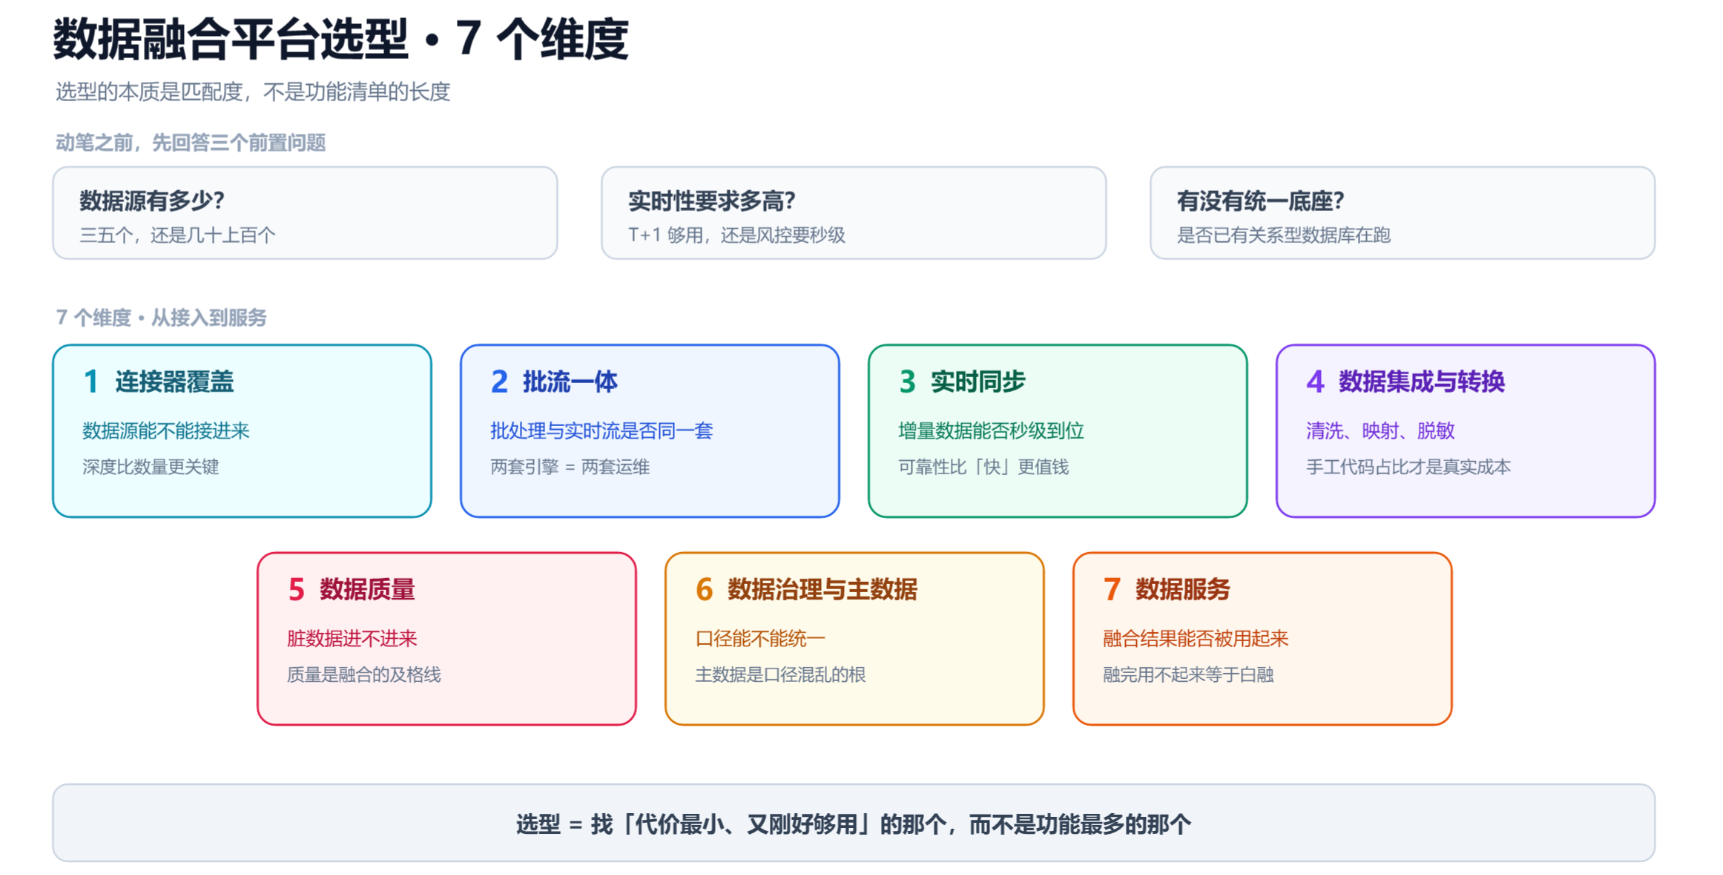
| 维度 | 要回答的问题 | 可量化指标 | 最容易被忽略的点 |
|---|---|---|---|
| 1 连接器覆盖 | 你的数据源能不能接进来 | 支持的数据源类型数 | 数量不等于深度,国产库适配常被漏掉 |
| 2 批流一体 | 批处理和实时流是不是同一套 | 批流是否统一引擎 | 两套引擎意味着两套运维 |
| 3 实时同步 | 增量数据能不能秒级到位 | 同步延迟、断点续传 | 可靠性比"快"更值钱 |
| 4 数据集成与转换 | 清洗、映射、脱敏能不能做 | 转换丰富度、易用性 | 手工写代码的比例才是真实成本 |
| 5 数据质量 | 脏数据进不进来 | 质量规则、血缘稽核 | 质量不是上线后补的 |
| 6 数据治理与主数据 | 口径能不能统一 | 元数据、主数据管理 | 主数据是口径混乱的根 |
| 7 数据服务 | 融合完的数据能不能被用起来 | API 化、数据目录 | 融完用不起来等于白融 |
下面挑最关键的几个展开。连接器覆盖、批流一体、实时同步这三个,属于"接入层"的硬功夫,多数团队先看这里;但我想把第 5、6 项也讲透------因为它们是决定"数据能不能被信任"的维度,恰恰是很多选型文章一笔带过的地方。
维度 1:连接器覆盖------数量不等于深度
厂商最爱说的一句话是"支持上百种数据源"。这句话本身没错,但你要追问一句:深度呢?
同样一个数据库连接器,有的平台只支持全量抽取,有的支持增量变更捕获(CDC);同样一个国产数据库连接器,有的只是挂了名字,有的能完整支持字段类型和 DDL 同步。
对于信创行业,这里有个更现实的问题:国产数据库的连接器深度,往往才是真正的门槛。 很多通用平台对 Oracle、MySQL 支持得不错,一到国产库,要么没有,要么只支持最低限度的全量搬运。如果你的数据底座已经换了国产数据库,选型时要把"国产库的连接器深度"当成一项专门指标去验证。
维度 2:批流一体------别为两套引擎付两份运维
"批流一体"这四个字现在被提得很多,但它到底解决什么问题,值得说清楚。
企业数据分两类:一类是历史全量数据,靠批量任务处理,T+1 出报表;一类是实时变化的数据,靠流式处理,秒级进结果。传统做法是两套引擎各干各的,结果就是两套代码、两套运维、两种口径。
批流一体的价值,是把这两类任务收敛到同一套引擎、同一个任务模型里。选型时问一句:批处理任务和实时流任务,是不是同一套调度、同一个开发界面? 如果是两套引擎拼在一起,那"批流一体"只是宣传口径,运维成本一分没省。
维度 3:实时同步------可靠性比"快"更值钱
实时同步的底层是 CDC(变更数据捕获),抓数据库的变更日志做增量同步。这一块选型时最容易踩的坑,是只盯着"同步延迟多少毫秒",却忽略了更值钱的东西:可靠性。
说一句可能得罪人的话:"秒级同步"谁都能标,但"断了能不能续传、同步结果怎么验证"才是分水岭。
这里我想点一个真实的判断标准。以金仓数据库的 KFS(Kingbase FlySync)为例,它走的是异构数据秒级增量同步路线,对标的是 Oracle GoldenGate 这类成熟的实时同步方案,两个能力值得单独拎出来说:双轨并行 和在线数据比对。
- 双轨并行,意味着新旧系统可以同时跑、随时回退------这对金融、政务这类"不能停机、不能出错"的场景是刚需,不是加分项;
- 在线数据比对,意味着同步结果可以校验,而不是"我相信它同步了"。
选型时拿这两个能力去问厂商,能快速分辨出谁是真做实时同步的,谁是拿个开源组件包装一下。
维度 5:数据质量------融合的及格线
数据融合,很多人只看到了"融合",没看到融合的前提是"可信"。脏数据融合得越多,污染得越彻底。
选型时看数据质量,别只看"支持多少种质量规则",看三件事:规则能不能前置到接入环节、质量结果有没有血缘可追溯、出问题能不能定位到源头。
我的判断是:数据质量不是上线后补的,它是数据融合的及格线。一个平台如果在质量上语焉不详,它的"融合"大概率是把垃圾数据搬得更快而已。
维度 6:数据治理与主数据------口径混乱的根
数据融合平台做到最后,都会撞上同一堵墙:同一个"客户"、同一个"产品",在不同系统里是不同的编码、不同的名字。 这就是主数据问题。
主数据不统一,融合出来的数据就是一锅口径混乱的杂烩。选型时要问:平台有没有主数据管理能力、元数据能不能统一管理、数据标准能不能落地成规则。这三个问题答不上来,平台就是个"高级搬运工"。
三、部署形态与成本:算三年,不算一个月
维度拆完了,还有两个横切问题:部署形态和成本。
部署形态看你的行业属性。金融、政务、能源这类强监管行业,私有化部署、国密加密、等保适配、国产 CPU/OS 环境能跑,是准入线,不是加分项。能用 SaaS 的行业,则可以把运维外包出去,换来的时间留给业务。
成本 要算三年,不算一个月。数据融合平台的隐性成本,主要在人力 和迁移:
- 人力:多少任务要手工写代码、多少要专人维护,这才是长期最大的开销;
- 迁移:平台上已经跑起来的口径、规则、调度,换平台的代价极高,选型阶段值得多花一周做 POC。
这里再补一句实在话:如果你已经在跑一套国产关系型数据库,数据融合能力**"长"在现有底座上**,往往比再引入一套独立平台更省。以金仓数据库(KingbaseES)为例,它本身定位就是融合数据库,关系、时序、向量等数据模型在一套引擎里,向上叠加同步与集成能力,对"既要存业务数据、又要做数据融合"的信创项目,意味着少养一套异构系统、少背一份迁移成本。
四、把 7 个维度合成一张决策表
维度拆完了,落到决策。我给一张按"场景"出发的表,比按"产品名"出发更有用:
| 你的场景 | 建议路线 | 为什么 |
|---|---|---|
| 数据源少 + T+1 够用 | 轻量集成工具 + 人工治理 | 别为低频需求上重平台 |
| 数据源多 + 实时要求高 | 重实时同步的平台 | 同步可靠性是硬指标 |
| 已有国产数据库底座 | 融合数据库原生能力 + 同步工具 | 少一套系统,口径天然统一 |
| 强监管 + 信创环境 | 国产数据库原生数据融合能力 | 合规、私有化、统一运维一条龙 |
| 口径混乱、主数据缺失 | 重数据治理的平台 | 先治口径,再谈融合 |
这张表想表达的核心判断是:选型不是"找功能最多的那个",而是"找代价最小、又刚好够用的那个"。 追求"功能最全",往往意味着为用不上的模块持续付费。
五、选型里最常见的四个错误
- 只看功能清单,不看深度。 功能页越长,越要警惕。用你自己的真实数据源、真实同步场景做 POC,比看任何功能列表都管用。
- 过早为"未来规模"买单。 数据源还没到几十个,就上分布式架构。按未来 6 到 12 个月的数据源增长规划就够了。
- 忽略实时同步的可靠性。 只测延迟,不测断点续传和结果校验。同步断了能不能恢复、结果对不对,才是生产里翻车最多的地方。
- 低估迁移成本。 口径、规则、调度一旦跑起来,换平台的代价极高。选型阶段多花一周验证,胜过上线后花一个月迁移。
六、常见问题 FAQ
Q1:数据融合平台选型最该先定什么?
先定数据源数量和实时性要求,这两个是硬约束,直接决定架构形态。
Q2:数据源不多,还用得上数据融合平台吗?
数据源三五个、T+1 够用、已有成熟数据库,优先用轻量集成工具,性价比更高。
Q3:批流一体到底是不是刚需?
如果你既有 T+1 批处理又有实时流需求,批流一体能省掉两套引擎的运维;只有单一批处理需求,不必强求。
Q4:实时同步选型最该看什么?
看可靠性:断点续传、双轨并行、在线数据比对,比单纯的"秒级"延迟更值钱。
Q5:信创环境怎么选数据融合能力?
优先看私有化部署、国产 CPU/OS 适配、国密与等保,以及国产库连接器深度和原生数据融合能力。
结语
把这一篇收成三句话,给正在做决策的人:
- 先问"是否需要平台",再谈选型------这一步筛掉一半的错误;
- 用 7 个维度做体检,别只盯着功能清单------同步可靠性、数据质量、主数据才是决定能不能用三年的;
- 用"场景"去匹配,用 POC 去验证------任何功能列表都替代不了你自己的数据。
一句话收尾:数据融合平台没有"最全的",只有"代价最小又刚好够用的"。选型的成熟,是从"追功能"走到"求匹配"。
本文基于公开信息独立撰写,不代表任何厂商立场。
李白客,信创行业独立观察者。关注数据库、AI 基础设施与国产化替代。