文章目录
- [第一章 日期函数](#第一章 日期函数)
-
- [1.1 获取当前日期、时间与时间戳](#1.1 获取当前日期、时间与时间戳)
- [1.2 提取日期部分:DATE() 函数](#1.2 提取日期部分:DATE() 函数)
- [1.3 日期加减运算:DATE_ADD() 与 DATE_SUB()](#1.3 日期加减运算:DATE_ADD() 与 DATE_SUB())
- [1.4 计算日期差值:DATEDIFF()](#1.4 计算日期差值:DATEDIFF())
- [1.5 综合案例一:生日记录表](#1.5 综合案例一:生日记录表)
- [1.6 综合案例二:留言表与时间窗口查询](#1.6 综合案例二:留言表与时间窗口查询)
- [1.7 总结与最佳实践](#1.7 总结与最佳实践)
- [第二章 字符串函数](#第二章 字符串函数)
-
- [2.1 字符集探测:CHARSET()](#2.1 字符集探测:CHARSET())
- [2.2 字节长度与字符长度:LENGTH() 的深度剖析](#2.2 字节长度与字符长度:LENGTH() 的深度剖析)
-
- [深度解惑:为什么 '通信102' 占用 9 个字节?为什么 '102' 不是 9 个字节?](#深度解惑:为什么 '通信102' 占用 9 个字节?为什么 '102' 不是 9 个字节?)
- 实战应用:查询学生姓名占用的字节数
- [2.3 大小写转换:UCASE() 与 LCASE()](#2.3 大小写转换:UCASE() 与 LCASE())
- [2.4 字符串拼接:CONCAT()](#2.4 字符串拼接:CONCAT())
- [2.5 字符串截取:LEFT()、RIGHT() 与 SUBSTRING()](#2.5 字符串截取:LEFT()、RIGHT() 与 SUBSTRING())
-
- [2.5.1 从两端定向截取:LEFT() 与 RIGHT()](#2.5.1 从两端定向截取:LEFT() 与 RIGHT())
- [2.5.2 灵活定位截取:SUBSTRING()](#2.5.2 灵活定位截取:SUBSTRING())
- [2.6 查找与替换:INSTR() 与 REPLACE()](#2.6 查找与替换:INSTR() 与 REPLACE())
-
- [2.6.1 查找首次出现位置:INSTR()](#2.6.1 查找首次出现位置:INSTR())
- [2.6.2 全局替换:REPLACE()](#2.6.2 全局替换:REPLACE())
- [2.7 字符串逐字比较:STRCMP()](#2.7 字符串逐字比较:STRCMP())
- [2.8 空白字符清理:LTRIM()、RTRIM() 与 TRIM()](#2.8 空白字符清理:LTRIM()、RTRIM() 与 TRIM())
- [2.9 综合实战:一个需求贯穿所有函数](#2.9 综合实战:一个需求贯穿所有函数)
- [第三章 数学函数](#第三章 数学函数)
-
- [3.1 绝对值函数:ABS()](#3.1 绝对值函数:ABS())
- [3.2 取整函数:CEILING() 与 FLOOR()](#3.2 取整函数:CEILING() 与 FLOOR())
- [3.3 格式化小数:FORMAT()](#3.3 格式化小数:FORMAT())
- [3.4 随机数生成:RAND()](#3.4 随机数生成:RAND())
- [3.5 取模运算:MOD()](#3.5 取模运算:MOD())
- [3.6 进制转换详解:BIN()、HEX() 与 CONV()](#3.6 进制转换详解:BIN()、HEX() 与 CONV())
-
- [3.6.1 BIN():十进制转二进制](#3.6.1 BIN():十进制转二进制)
- [3.6.2 HEX():十进制转十六进制](#3.6.2 HEX():十进制转十六进制)
- [3.6.3 CONV():通用进制转换](#3.6.3 CONV():通用进制转换)
- [3.6.4 关键限制:浮点数会被截断为整数](#3.6.4 关键限制:浮点数会被截断为整数)
- [3.7 综合案例:统计报表中的数值处理](#3.7 综合案例:统计报表中的数值处理)
- [第四章 其他函数](#第四章 其他函数)
-
- [4.1 会话与环境信息:USER() 与 DATABASE()](#4.1 会话与环境信息:USER() 与 DATABASE())
-
- [4.1.1 查询当前用户:USER()](#4.1.1 查询当前用户:USER())
- [4.1.2 查询当前数据库:DATABASE()](#4.1.2 查询当前数据库:DATABASE())
- [4.2 空值处理保险丝:IFNULL()](#4.2 空值处理保险丝:IFNULL())
- [4.3 数据安全摘要:MD5() 与 PASSWORD()](#4.3 数据安全摘要:MD5() 与 PASSWORD())
-
- [4.3.1 MD5 信息摘要算法](#4.3.1 MD5 信息摘要算法)
- [4.3.2 PASSWORD() 系统加密函数](#4.3.2 PASSWORD() 系统加密函数)
- [4.4 关键字冲突与命令行历史记录](#4.4 关键字冲突与命令行历史记录)
第一章 日期函数
在数据库应用开发中,日期与时间的处理几乎无处不在------从记录用户注册时间、订单生成时刻,到统计某段时间内的数据增长,再到计算会员有效期剩余天数。MySQL 提供了一套完备的日期函数,帮助开发者高效、精准地操作时间数据。本章将围绕日期函数的核心用法展开,从基础获取到复杂运算,再到实际业务场景中的典型应用,逐一深入讲解。
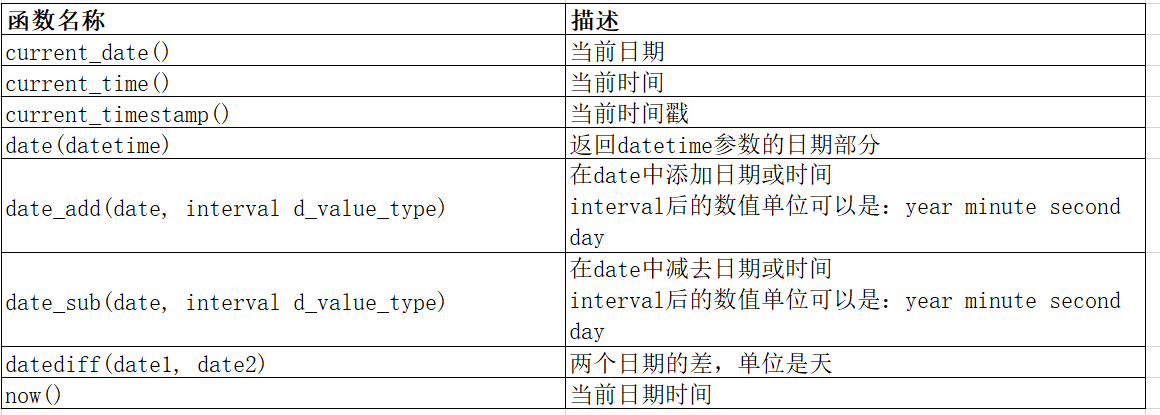
1.1 获取当前日期、时间与时间戳
MySQL 提供了三个最基本的函数,分别用于获取当前的日期、当前的时间以及当前的日期时间(时间戳)。它们的命名直观且易于记忆。
| 函数 | 返回类型 | 描述 | 示例返回值 |
|---|---|---|---|
CURRENT_DATE() |
DATE | 当前日期(年-月-日) | 2026-08-31 |
CURRENT_TIME() |
TIME | 当前时间(时:分:秒) | 14:23:45 |
CURRENT_TIMESTAMP() |
DATETIME / TIMESTAMP | 当前日期和时间 | 2026-08-31 14:23:45 |
注意 :
CURRENT_TIMESTAMP()与NOW()功能完全等价,二者可互换使用。
基础查询示例:
sql
SELECT CURRENT_DATE();
+----------------+
| CURRENT_DATE() |
+----------------+
| 2026-08-31     |
+----------------+

SELECT CURRENT_TIME();
+----------------+
| CURRENT_TIME() |
+----------------+
| 14:23:45       |
+----------------+

SELECT CURRENT_TIMESTAMP();
+---------------------+
| CURRENT_TIMESTAMP() |
+---------------------+
| 2026-08-31 14:23:45 |
+---------------------+
一个容易被忽视的细节 :这三个函数虽然返回不同的数据类型,但它们的"源头"都是系统时钟------系统内部存储的是一个完整的日期时间值(精确到秒甚至微秒)。CURRENT_DATE() 本质上是截取了完整时间戳的"年月日"部分,并将其余部分归零;CURRENT_TIME() 则截取了"时分秒"部分。因此,可以理解为所有时间获取函数均基于同一个完整的内部时间,只是在返回给用户时进行了不同的格式裁剪与类型封装 。这与后面要讲的 DATE() 提取函数原理相通。
1.2 提取日期部分:DATE() 函数
当我们有一个 DATETIME 或 TIMESTAMP 类型的字段时,往往只需要关注日期部分(例如统计某天发布的留言数量)。DATE() 函数可以轻松完成这一提取。
语法:
sql
DATE(datetime_value)- 参数:一个日期时间表达式(字段、常量或函数返回值)。
- 返回值:
DATE类型,仅包含年、月、日。
示例:
sql
SELECT DATE('2026-08-31 14:23:45');
+-----------------------------+
| DATE('2026-08-31 14:23:45') |
+-----------------------------+
| 2026-08-31                  |
+-----------------------------+

-- 与 NOW() 配合使用
SELECT DATE(NOW());
+-------------+
| DATE(NOW()) |
+-------------+
| 2026-08-31  |
+-------------+
在后面的留言表案例中,我们会看到 DATE() 如何用于控制显示格式。
在 MySQL 中,' '(单引号)主要用于表示字符串、日期时间等字面量,记住一句话:字符串/日期加 ' ',数字和 NULL 不加。
1.3 日期加减运算:DATE_ADD() 与 DATE_SUB()
在实际业务中,我们经常需要在某个日期基础上增加或减少一段时间 ,例如计算订单的预计送达日期、会员到期日等。DATE_ADD() 和 DATE_SUB() 正是为此而生。
语法:
sql
DATE_ADD(date, INTERVAL expr unit)
DATE_SUB(date, INTERVAL expr unit)date:起始日期或日期时间。INTERVAL:固定关键字。expr:一个整数,表示要增加或减少的数量(可以为负数,但建议使用对应的函数以保持语义清晰)。unit:单位,支持YEAR、MONTH、DAY、HOUR、MINUTE、SECOND、WEEK、QUARTER(表示"季度",1 QUARTER = 3 MONTH 4 QUARTER = 1 YEAR)等。
示例 - 增加日期:
sql
SELECT DATE_ADD('2017-10-28', INTERVAL 10 DAY);
+-----------------------------------------+
| DATE_ADD('2017-10-28', INTERVAL 10 DAY) |
+-----------------------------------------+
| 2017-11-07                              |
+-----------------------------------------+
示例 - 减少日期:
sql
SELECT DATE_SUB('2017-10-01', INTERVAL 2 DAY);
+---------------------------------------+
| DATE_SUB('2017-10-01', INTERVAL 2 DAY)|
+---------------------------------------+
| 2017-09-29                            |
+---------------------------------------+
灵活运用 :INTERVAL 后的单位可以非常精细,例如增加 3 小时 15 分钟?可以连续使用或使用复合单位(但标准写法是分别加减,或使用 INTERVAL '3:15' HOUR_MINUTE)。通常更推荐分步运算:
sql
SELECT DATE_ADD(DATE_ADD('2026-08-31 10:00:00', INTERVAL 3 HOUR), INTERVAL 15 MINUTE);另外,DATE_ADD 也可以接受负值来实现减法效果,但为了代码可读性,减法则优先使用 DATE_SUB。
1.4 计算日期差值:DATEDIFF()
统计两个日期之间相隔的天数 ,是会员活跃度分析、账龄计算等场景的常用操作。DATEDIFF() 函数直接返回天数差。
语法:
sql
DATEDIFF(date1, date2)- 返回
date1 - date2的天数(可正可负)。 - 只比较日期部分,忽略时间部分 (即使传入
DATETIME,也仅取日期计算)。
示例:
sql
SELECT DATEDIFF('2017-10-10', '2016-09-01');
+------------------------------------+
| DATEDIFF('2017-10-10', '2016-09-01') |
+------------------------------------+
| 404                                |
+------------------------------------+
若两个日期包含时间,差值仅依赖日期:
sql
SELECT DATEDIFF('2026-08-31 23:59:59', '2026-08-30 00:00:01');
+--------------------------------------------------------+
| DATEDIFF('2026-08-31 23:59:59', '2026-08-30 00:00:01') |
+--------------------------------------------------------+
| 1                                                      |
+--------------------------------------------------------+
虽然实际间隔不足两天,但按日期算只差 1 天。
1.5 综合案例一:生日记录表
假设我们需要创建一个简单的表来记录用户的生日,并希望插入当天的日期。
建表语句:
sql
CREATE TABLE tmp (
    id INT PRIMARY KEY AUTO_INCREMENT,
    birthday DATE
);插入当前日期:
sql
INSERT INTO tmp (birthday) VALUES (CURRENT_DATE());查询结果:
sql
SELECT * FROM tmp;
+----+------------+
| id | birthday   |
+----+------------+
| 1  | 2026-08-31 |
+----+------------+
陷阱警示 :如果尝试向 DATE 类型的字段插入 CURRENT_TIME(),会发生什么?
sql
INSERT INTO tmp (birthday) VALUES (CURRENT_TIME());
-- 执行成功,但会产生警告(Warning)
由于 CURRENT_TIME() 返回的是 '14:39:20' 这样的时间字符串,而 MySQL 在将时间字符串隐式转为 DATE 类型时,无法解析出有效的年月日,因此会将其转换为 '0000-00-00'(或根据 SQL 模式可能报错)。这提醒我们:数据类型必须严格匹配,日期字段就应传入日期值或完整的日期时间值(MySQL 会自动截取日期部分,但时间部分必须合法)。如果传入纯时间,结果将是无效日期,切勿依赖这种隐式转换。
1.6 综合案例二:留言表与时间窗口查询
我们构建一个留言表,包含留言内容和发送时间,并在此基础上实现两种常见查询需求:仅显示日期不显示时间,以及查询最近 2 分钟内发布的留言。
建表与数据插入:
sql
CREATE TABLE msg (
    id INT PRIMARY KEY AUTO_INCREMENT,
    content VARCHAR(30) NOT NULL,
    sendtime DATETIME
);

INSERT INTO msg (content, sendtime) VALUES ('hello1', NOW());
INSERT INTO msg (content, sendtime) VALUES ('hello2', NOW());
稍等片刻后再插入一条,以便后面观察时间窗口的效果。
需求一:显示所有留言信息,但发布日期只显示日期,不显示时间。
利用 DATE() 函数即可:
sql
SELECT content, DATE(sendtime) AS send_date FROM msg;
+---------+------------+
| content | send_date  |
+---------+------------+
| hello1  | 2026-08-31 |
| hello2  | 2026-08-31 |
+---------+------------+
需求二:查询在 2 分钟内发布的帖子。
这里的核心思路是:取当前时间 NOW(),然后判断留言的发送时间是否在"当前时间减去 2 分钟"之后。使用 DATE_ADD() 对 sendtime 进行加 2 分钟运算,再与 NOW() 比较。
sql
SELECT *
FROM msg
WHERE DATE_ADD(sendtime, INTERVAL 2 MINUTE) > NOW();
理解这条查询 :
对于每条留言,计算其 sendtime 加上 2 分钟后的时间点,如果这个时间点晚于当前时刻,说明该留言的发送时刻距离现在不足 2 分钟(因为 sendtime + 2分钟 > now() 等价于 sendtime > now() - 2分钟)。这种写法可读性强,直接体现了"未来 2 分钟边界"的概念。
也可以采用等价写法:
sql
SELECT *
FROM msg
WHERE sendtime > DATE_SUB(NOW(), INTERVAL 2 MINUTE);
两种方式效果相同,根据个人习惯选择。
1.7 总结与最佳实践
本章详细梳理了 MySQL 日期函数的核心成员:
| 函数 | 核心用途 |
|---|---|
CURRENT_DATE() / CURRENT_TIME() / CURRENT_TIMESTAMP() |
获取系统当前日期、时间、日期时间 |
DATE() |
从日期时间中提取日期部分 |
DATE_ADD() / DATE_SUB() |
对日期进行加减运算(支持年、月、日、时、分、秒等多种单位) |
DATEDIFF() |
计算两个日期之间的天数差(忽略时间) |
NOW() |
获取当前日期时间(与 CURRENT_TIMESTAMP() 同义) |
关键原则:
- 类型一致 :向
DATE字段插入值时应使用日期或日期时间类型,避免传入纯时间引发隐式转换问题。 - 时间窗口查询 :利用
DATE_ADD或DATE_SUB构建动态时间边界,比硬编码时间更灵活。 - 显示与存储分离 :存储时使用完整的
DATETIME可保留更多信息,显示时通过DATE()按需裁剪,满足不同场景需求。
第二章 字符串函数
如果说日期函数定义了数据的"时间刻度",那么字符串函数则赋予了数据库"文本手术刀"的能力。从用户输入的清洗、报表格式的组装,到数据迁移时的编码校验,字符串操作几乎渗透在每一个业务模块中。
MySQL 提供的字符串函数族极为丰富,但许多初学者容易陷入"逐个记忆函数名"的枯燥循环。本章将打破这种散点式学习,按照 "探测编码 → 计算长度 → 转换大小写 → 拼接组装 → 截取片段 → 查找替换 → 清理比较" 这条数据处理流水线,系统性地讲解所有核心字符串函数。同时,我们将深入剖析最易混淆的"字节 VS 字符"问题,彻底解开 UTF-8 变长编码的谜团。
2.1 字符集探测:CHARSET()
在拼接或处理字符串之前,首要任务是摸清数据的"出身"------字符集编码。不同编码下的存储规则和处理函数返回值可能存在天壤之别。
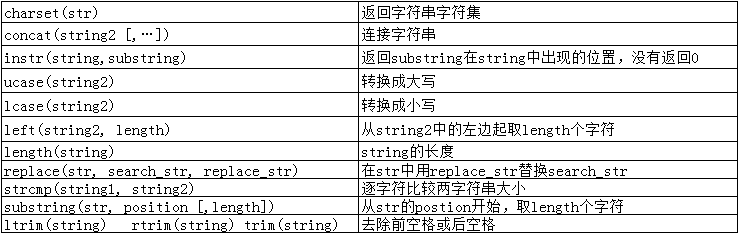
CHARSET(str) 函数用于返回字符串参数所使用的字符集名称。
语法:
sql
CHARSET(str)实战案例 :获取 EMP 表中员工姓名列 ename 的字符集。
sql
SELECT ename, CHARSET(ename) FROM EMP;该查询可能返回 utf8mb4、gbk 或 latin1 等结果。在多库多表关联查询时,若关联字段的字符集不一致,即便内容相同也无法匹配索引,甚至引发乱码。因此,CHARSET() 是数据迁移和异构系统对接时的"排障第一站"。
2.2 字节长度与字符长度:LENGTH() 的深度剖析
这是开发者最容易"翻车"的地方,也是面试中的高频考点。MySQL 提供了两个看似相近但本质不同的长度函数:
LENGTH(str):返回字符串所占用的字节数(Byte)。CHAR_LENGTH(str):返回字符串的字符数(Character)(视觉上的文字个数)。
核心法则 :一个字符占多少字节,完全取决于字符集。
| 字符集 | ASCII 字符(字母、数字、常见符号) | 常用中文字符 |
|---|---|---|
latin1 |
1 字节 | 不支持 |
GBK |
1 字节 | 2 字节 |
UTF-8 / utf8mb4 |
1 字节 | 3 字节(部分生僻字 4 字节) |
深度解惑:为什么 '通信102' 占用 9 个字节?为什么 '102' 不是 9 个字节?
很多初学者存在一个根深蒂固的误区:"UTF-8 中每个字符固定占 3 个字节" 。这个认知是完全错误的。
事实是 :UTF-8 是一种变长编码(1~4 字节)。为了兼容 ASCII 码,它采用了一套精妙的规则:
- ASCII 码范围(0~127) 内的字符,包括全部英文大小写字母(
a-z、A-Z)、全部数字(0-9)以及常见标点符号,在 UTF-8 中仅占用 1 个字节。 - 中文、日文、韩文(CJK)等非 ASCII 字符,在 UTF-8 中通常占用 3 个字节(部分扩展字符占用 4 字节)。
基于这个铁律,我们来拆解以下示例:
示例 1 :length('通信102')
'通':中文字符 → 占 3 字节'信':中文字符 → 占 3 字节'1':数字(ASCII)→ 占 1 字节'0':数字(ASCII)→ 占 1 字节'2':数字(ASCII)→ 占 1 字节- 总计 :3 + 3 + 1 + 1 + 1 = 9 字节
示例 2 :length('abc1你')
'a'、'b'、'c'、'1':均为 ASCII 字符 → 各占 1 字节,合计 4 字节'你':中文字符 → 占 3 字节- 总计 :4 + 3 = 7 字节
所以,'102' 单独出现时,只是三个独立的 ASCII 数字,每个占 1 字节,总共 3 字节。如果按照"固定 3 字节"的谬误去算,得到 9 字节,那就把变长编码当成了 UCS-4 定长编码,属于概念性错误。
实战应用:查询学生姓名占用的字节数
sql
SELECT name, LENGTH(name) AS byte_length, CHAR_LENGTH(name) AS char_length
FROM student;
假设 name 为 '张三',在 UTF-8 下,byte_length 为 6,char_length 为 2。这提醒我们:在设计数据库字段长度(如 VARCHAR(20))时,20 指的是字符数,而非字节数,但 MySQL 底层实际分配的存储空间会按最大字节数计算(如 utf8mb4 下 VARCHAR(20) 最多可占 80 字节)。
2.3 大小写转换:UCASE() 与 LCASE()
报表展示或用户输入归一化时,大小写转换是家常便饭。
UCASE(str)或UPPER(str):将字符串全部转为大写。LCASE(str)或LOWER(str):将字符串全部转为小写。
典型需求 :以首字母小写、其余字母保持不变的方式显示所有员工姓名。
实现思路:截取首字母 → 转小写 → 拼接上剩余部分。
sql
SELECT CONCAT(LCASE(SUBSTRING(ename, 1, 1)), SUBSTRING(ename, 2)) AS formatted_name
FROM EMP;
若 ename 为 'SMITH',则输出 'sMITH'。
2.4 字符串拼接:CONCAT()
CONCAT() 是构建动态报表语句的灵魂工具,支持连接两个或多个字符串参数。
语法:
sql
CONCAT(str1, str2, ..., strN)关键注意 :只要其中任何一个参数为 NULL,整个返回值即为 NULL。若存在 NULL 风险,可结合 IFNULL() 使用。
实战案例 :显示 exam_result 表中的信息,格式为"XXX的语文是XXX分,数学XXX分,英语XXX分"。
sql
SELECT CONCAT(name, '的语文是', chinese, '分,数学是', math, '分,英语是', english, '分') AS 成绩单
FROM exam_result;
2.5 字符串截取:LEFT()、RIGHT() 与 SUBSTRING()
提取身份证号中的出生日期、截取邮箱前缀、处理固定格式编码,都离不开截取函数。
2.5.1 从两端定向截取:LEFT() 与 RIGHT()
LEFT(str, length):从左边 起取length个字符。RIGHT(str, length):从右边 起取length个字符。
2.5.2 灵活定位截取:SUBSTRING()
SUBSTRING(str, position):从position开始截取到末尾。SUBSTRING(str, position, length):从position开始截取length个字符。
索引规则 :MySQL 中字符串位置从 1 开始计数,而非 0。
实战案例 :截取 EMP 表中 ename 字段的第二个到第三个字符。
sql
SELECT ename, SUBSTRING(ename, 2, 2) AS extracted FROM EMP;若 ename 为 'JONES',则提取结果为 'ON'(位置 2 是 'O',取 2 个字符得到 'ON')。
2.6 查找与替换:INSTR() 与 REPLACE()
在数据脱敏、敏感词过滤或业务标识更新时,查找和替换是最直接的手段。
2.6.1 查找首次出现位置:INSTR()
INSTR(str, substr) 返回 substr 在 str 中首次出现的位置索引。若找不到则返回 0。
sql
SELECT INSTR('Hello World', 'World'); -- 返回 7
SELECT INSTR('Hello', 'x');           -- 返回 0
2.6.2 全局替换:REPLACE()
REPLACE(str, search_str, replace_str) 将 str 中所有 出现的 search_str 替换为 replace_str(该操作默认区分大小写)。
实战案例 :将 EMP 表中所有名字里包含大写 S 的替换为 '上海'。
sql
SELECT ename, REPLACE(ename, 'S', '上海') AS replaced_name FROM EMP;若 ename 为 'SMITH',则结果为 '上海MITH'。该操作仅影响查询结果,不会修改表中原始数据(如需持久化,需配合 UPDATE 语句)。
2.7 字符串逐字比较:STRCMP()
STRCMP(str1, str2) 基于底层字符集的二进制排序规则,逐字符比较两个字符串的大小。
- 若
str1等于str2,返回0。 - 若
str1小于str2(字典序靠前),返回-1。 - 若
str1大于str2,返回1。
sql
SELECT STRCMP('A', 'B');   -- 返回 -1
SELECT STRCMP('B', 'A');   -- 返回 1
SELECT STRCMP('AB', 'AB'); -- 返回 0
该函数多用于 ORDER BY 自定义排序逻辑或 CASE WHEN 复杂条件分支中。
2.8 空白字符清理:LTRIM()、RTRIM() 与 TRIM()
用户输入的表单数据常常包含无意识的前后空格,直接存储会导致查询匹配失败(如 WHERE name = 'admin ' 无法匹配 'admin')。
LTRIM(str):去除字符串左侧(开头)的空格。RTRIM(str):去除字符串右侧(末尾)的空格。TRIM(str): 用于去除字符串首尾指定字符 ,完整语法为TRIM([BOTH | LEADING | TRAILING] '字符' FROM 字符串),其中BOTH表示去除两端、LEADING表示只去左侧、TRAILING表示只去右侧;如果直接写TRIM(字符串),则默认去除字符串首尾的空格。
sql
SELECT LTRIM('   Hello');   -- 返回 'Hello'
SELECT RTRIM('World   ');   -- 返回 'World'
SELECT TRIM('   MySQL   '); -- 返回 'MySQL'
2.9 综合实战:一个需求贯穿所有函数
假设有一张 EMP 员工表(字符集为 utf8mb4),包含 ename(姓名)和 job(职位)字段。现需完成以下数据清洗与报表输出:
- 探测
ename列的字符集。 - 查询每个员工姓名占用的字节数和字符数。
- 将职位全部转为小写。
- 将姓名格式化为"首字母大写,其余字母小写"。
- 过滤出姓名中包含字母
'A'的员工,并将所有'A'替换为'优'。 - 去除姓名中可能存在的两侧空格。
- 最终拼接生成一句话:"员工 姓名 的职位是 职位"。
完整 SQL 实现:
sql
SELECT
    CHARSET(ename) AS charset_used,
    ename AS original_name,
    LENGTH(ename) AS bytes_occupied,
    CHAR_LENGTH(ename) AS char_count,
    CONCAT(
        UCASE(SUBSTRING(TRIM(ename), 1, 1)),
        LCASE(SUBSTRING(TRIM(ename), 2))
    ) AS formatted_name,
    LCASE(job) AS job_lower,
    REPLACE(ename, 'A', '优') AS replaced_name,
    CONCAT('员工 ', TRIM(ename), ' 的职位是 ', LCASE(job)) AS introduction
FROM EMP
WHERE INSTR(ename, 'A') > 0;
第三章 数学函数
在数据库查询中,数值处理的需求同样频繁:计算折扣后的价格、统计平均分、生成随机抽样数据、格式化报表输出等。MySQL 提供了一套完整的数学函数,涵盖绝对值、取整、进制转换、随机数生成等常见运算。
与日期、字符串函数不同,数学函数通常具有确定性的运算逻辑(除 RAND() 外),且不受字符集影响。本章将按照"基础运算 → 取整与格式化 → 随机与取模 → 进制转换"的脉络,系统讲解所有核心数学函数。特别地,我们将深入探讨进制转换函数 BIN()、HEX()、CONV() 在处理浮点数时的底层机制,帮助开发者避开常见的"精度陷阱"。
3.1 绝对值函数:ABS()
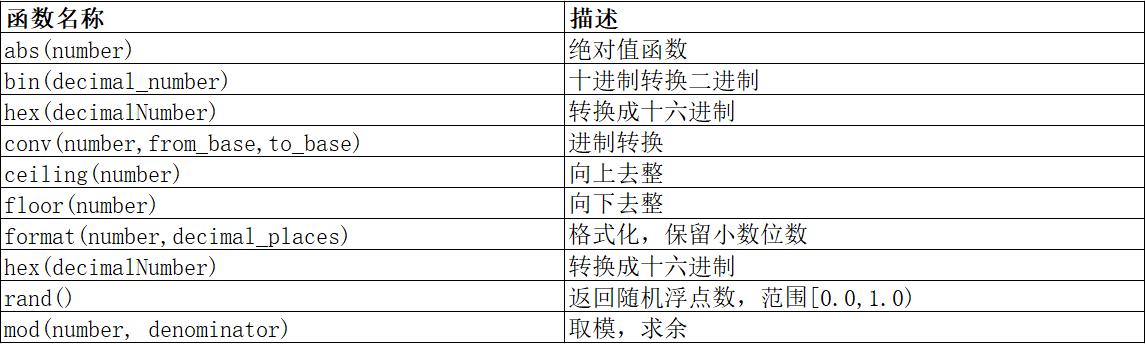
ABS(number) 返回数值的绝对值,即去掉符号后的非负值。 无论输入正数、负数还是零,结果均为其距离零点的距离。
语法:
sql
ABS(number)示例:
sql
SELECT ABS(-100.2);   -- 返回 100.2
SELECT ABS(100.2);    -- 返回 100.2
SELECT ABS(0);        -- 返回 0
该函数常用于消除负偏差,例如计算价格波动幅度或误差距离。
3.2 取整函数:CEILING() 与 FLOOR()
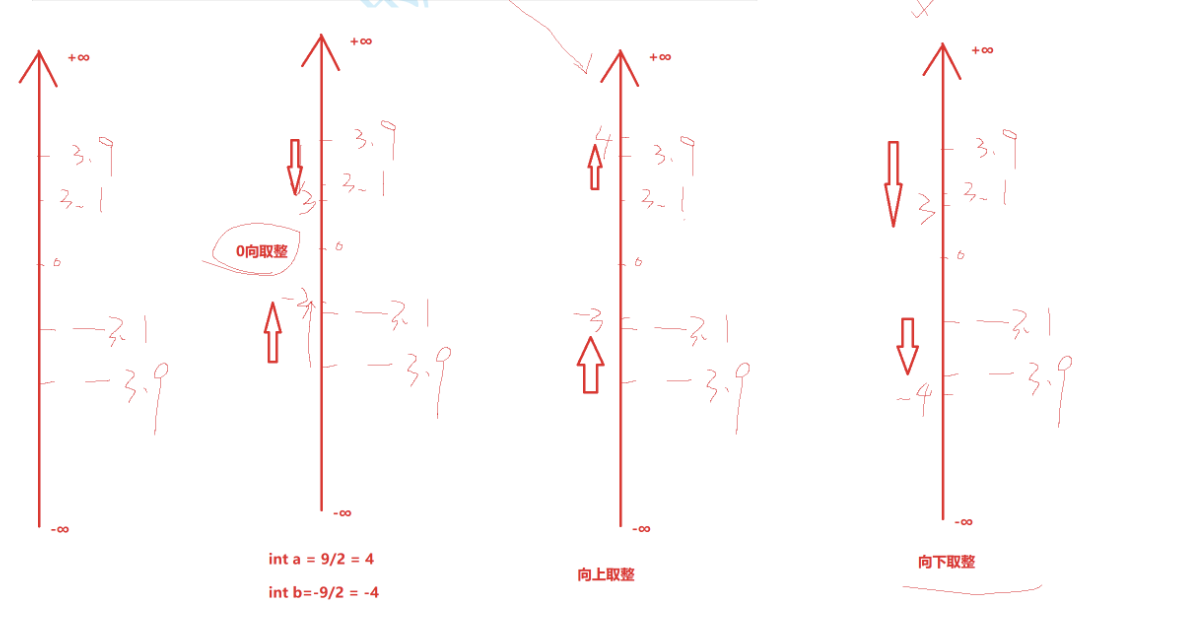
在分页计算、库存单位换算或区间统计时,取整操作不可或缺。MySQL 提供了方向明确的两种取整方式:
CEILING(number):向上取整,返回不小于参数的最小整数值(向正无穷方向取整)。FLOOR(number):向下取整,返回不大于参数的最大整数值(向负无穷方向取整)。
示例:
sql
SELECT CEILING(23.04);   -- 返回 24(大于 23.04 的最小整数)
SELECT CEILING(-23.04);  -- 返回 -23(大于 -23.04 的最小整数,即 -23)

SELECT FLOOR(23.7);      -- 返回 23(小于 23.7 的最大整数)
SELECT FLOOR(-23.7); -- 返回 -24(小于 -23.7 的最大整数,即 -24)需要注意:CEILING 与 FLOOR 对于负数的处理方向相反,开发者需根据业务语义(如计算租金天数、计费周期)谨慎选择。
3.3 格式化小数:FORMAT()
FORMAT(number, decimal_places) 将数字格式化为带有千位分隔符(逗号)的字符串,并四舍五入保留指定位数的小数。该函数返回的是字符串类型,而非数值类型,因此仅适用于展示层,不宜用于后续数学运算。
语法:
sql
FORMAT(number, decimal_places)示例:
sql
SELECT FORMAT(12345.6789, 2);   -- 返回 '12,345.68'(四舍五入保留两位)
SELECT FORMAT(12.3456, 2);      -- 返回 '12.35'
SELECT FORMAT(12.3, 2);         -- 返回 '12.30'(不足位补零)
3.4 随机数生成:RAND()
RAND() 返回一个随机浮点数,范围是 [0.0, 1.0) ------即包含 0,但不包含 1。 该函数在数据抽样、随机排序、生成测试数据等场景中极为实用。
基本用法:
sql
SELECT RAND();     -- 返回类似 0.4234234234 的随机值
SELECT RAND();     -- 每次执行结果均不同
进阶用法 :若需生成指定范围的随机整数(如 [min, max]),可结合 FLOOR 运算:
sql
SELECT FLOOR(RAND() * 100) + 1; -- 生成 1 到 100 之间的随机整数带种子的随机数 :RAND(seed) 支持传入整数种子。若种子固定,则随机序列完全可复现, 这在需要保证测试结果稳定性的场景下非常有用:
sql
SELECT RAND(100);   -- 每次执行该语句返回相同值
SELECT RAND(100);   -- 与上行结果一致
3.5 取模运算:MOD()
取余和取模在正数情况下结果相同,区别主要在负数:
取余看被除数符号,取模看除数符号。要看具体语言,% 不一定都是同一种规则。在 C、C++、Java、JavaScript、MySQL 里,% 通常按取余规则处理:结果符号跟被除数一致。例如 -5 % 3 = -2。
在大多数编程语言里:
/ 叫除法运算符 ,用于做除法;% 叫取余运算符(remainder operator),用于求两个数相除后的余数。
例如在 C/C++ 中:
cpp
7 / 3   // 除法,结果为 2(整数除法)
7 % 3 // 取余,结果为 1所以代码里一般说:/ 是除法运算符,% 是取余运算符。 "取模"更多是数学上的叫法,编程里 % 经常也被俗称为取模运算符。
MOD(number, denominator) 返回两个数相除的余数(取模运算)。其等价写法为 number % denominator。
语法:
sql
MOD(number, denominator)示例:
sql
SELECT MOD(10, 3);    -- 返回 1
SELECT MOD(10.5, 3);  -- 返回 1.5(支持浮点数取模)
SELECT MOD(10, 0); -- 返回 NULL(除数为零不合法)取模运算常用于判断奇偶性(MOD(id, 2) = 0 为偶数)、分库分表路由键计算,以及循环轮询逻辑中。
3.6 进制转换详解:BIN()、HEX() 与 CONV()
进制转换在 IP 地址存储、颜色值解析或底层协议处理中经常出现。MySQL 提供了三种相关的进制操作函数,但它们在底层存在一个极易被忽略的关键限制。
3.6.1 BIN():十进制转二进制
BIN(decimal_number) 将十进制数值转换为二进制字符串表示。
3.6.2 HEX():十进制转十六进制
HEX(decimal_number) 将十进制数值转换为十六进制字符串表示。
注:
HEX()具有"双重身份"------若参数为数字,则转换数字本身;若参数为字符串,则返回该字符串每个字符的十六进制编码。 此特性需格外注意。
3.6.3 CONV():通用进制转换
CONV(number, from_base, to_base) 是功能最强大的进制转换函数,可以将一个数从任意进制(2~36)转换为任意另一进制,返回值的字符串表示。
示例:
sql
SELECT BIN(10);                       -- 返回 '1010'
SELECT HEX(255);                      -- 返回 'FF'
SELECT CONV('1010', 2, 10);           -- 返回 '10'(二进制转十进制)
SELECT CONV('FF', 16, 10);            -- 返回 '255'(十六进制转十进制)
SELECT CONV(10, 10, 2);               -- 返回 '1010'(十进制转二进制)
3.6.4 关键限制:浮点数会被截断为整数
核心问题 :BIN()、HEX()(数字模式)以及 CONV() 在处理参数时,底层均将输入解释为 整数(BIGINT) 类型。
- 如果传入浮点数 (如
10.9),MySQL 会隐式截断小数部分 ,仅保留整数部分(10)进行进制转换。不会对小数部分做任何转换。 - 这意味着:
BIN(10.9)实际上执行的是BIN(10),返回'1010',小数.9被完全舍弃且无任何警告(取决于 SQL 模式)。
验证示例:
sql
SELECT BIN(10.9);      -- 实际返回 '1010',而非小数部分的二进制表示
SELECT HEX(15.99);     -- 返回 'F'(仅处理整数 15)
SELECT CONV(8.7, 10, 2); -- 返回 '1000'(仅处理整数 8)
因此,若需要对浮点数的小数部分进行精确的二进制或十六进制转换,MySQL 的原生函数无法直接做到。标准做法是:将整数部分与小数部分拆开分别处理,或在前端应用程序中完成此类精细转换。在数据库层面,应明确这些函数的整数特性,避免因隐式截断导致数据失真。
另外,CONV() 的 from_base 和 to_base 参数范围是 2 至 36(含),支持数字 0-9 及字母 A-Z 作为进制符号,满足了绝大部分业务对非十进制数据的处理需求。
3.7 综合案例:统计报表中的数值处理
假设有一张 product 商品表,包含 price(价格,浮点数)、sales(销量)字段。现需生成一份统计报表,要求:
- 计算每件商品的总销售额(价格 × 销量)。
- 对总销售额向上取整(确保计费不遗漏分毫)。
- 将结果格式化为保留两位小数的货币显示形式(带千分位分隔符)。
- 随机抽取 3 条商品数据进行核对验证。
SQL 实现:
sql
SELECT
    product_name,
    price,
    sales,
    CEILING(price * sales) AS ceiling_total,
    FLOOR(price * sales) AS floor_total,
    FORMAT(price * sales, 2) AS formatted_total,
    MOD(sales, 2) AS sales_parity  -- 1 为奇数,0 为偶数
FROM product
ORDER BY RAND()   -- 随机排序
LIMIT 3;
第四章 其他函数
在系统掌握了日期时间、字符串和数学运算之后,MySQL 工具箱中还剩下一组"多功能辅助函数"。它们虽然不像前三类那样自成体系,却在用户认证、环境探测、空值防御等关键业务场景中扮演着不可替代的角色。本章将重点讲解用户与数据库信息查询、空值处理、以及两种核心数据摘要加密函数,并结合实际的用户登录验证案例,剖析 MD5 与 PASSWORD 函数的底层特性及使用陷阱。
4.1 会话与环境信息:USER() 与 DATABASE()
在编写复杂脚本或调试多租户系统时,明确当前数据库连接的身份与操作环境是第一步。
4.1.1 查询当前用户:USER()
USER() 函数返回当前 MySQL 会话所使用的用户名和主机名组合,格式为 'username'@'hostname'。 这有助于在多用户环境下确认操作者身份。
示例:
sql
SELECT USER();
+----------------+
| USER()         |
+----------------+
| 'root'@'localhost' |
+----------------+
4.1.2 查询当前数据库:DATABASE()
DATABASE() 函数返回当前 USE 语句所指定的默认数据库名称。若当前未选择任何数据库,则返回 NULL。 在编写通用脚本时,常用该函数进行前置校验,避免误操作非目标库。
示例:
sql
SELECT DATABASE();
+------------+
| DATABASE() |
+------------+
| test_db    |
+------------+
4.2 空值处理保险丝:IFNULL()
在查询计算中,NULL 值具有传染性------任何与 NULL 进行的算术或拼接操作往往直接返回 NULL。IFNULL(val1, val2) 是处理这一问题的"第一道防线":当 val1 为 NULL 时返回 val2,否则返回 val1 本身。
语法:
sql
IFNULL(expression, replacement_value)示例:
sql
SELECT IFNULL('abc', '123');   -- val1 非空,返回 'abc'
+----------------------+
| IFNULL('abc', '123') |
+----------------------+
| abc                  |
+----------------------+

SELECT IFNULL(NULL, '123');    -- val1 为空,返回 '123'
+---------------------+
| IFNULL(NULL, '123') |
+---------------------+
| 123                 |
+---------------------+
在统计平均分、计算折扣价时,若字段允许为空,建议使用 IFNULL(column, 0) 将空值转为 0,以避免整条计算结果变成 NULL。
4.3 数据安全摘要:MD5() 与 PASSWORD()
在用户密码存储、数据完整性校验等场景中,明文存储是绝对的高危操作。MySQL 提供了两种常用的摘要(Digest)函数,它们将原始字符串通过特定算法映射为固定长度的"指纹"字符串 。核心特征 :输入任意长度,输出固定长度,且不可逆向推导(单向加密)。
4.3.1 MD5 信息摘要算法
MD5(str) 返回字符串的 32 位十六进制 MD5 摘要值。 无论输入的是 1 个字符还是 1MB 的文本,输出永远是 32 个字符的等长字符串(由数字 0-9 和字母 a-f 组成)。
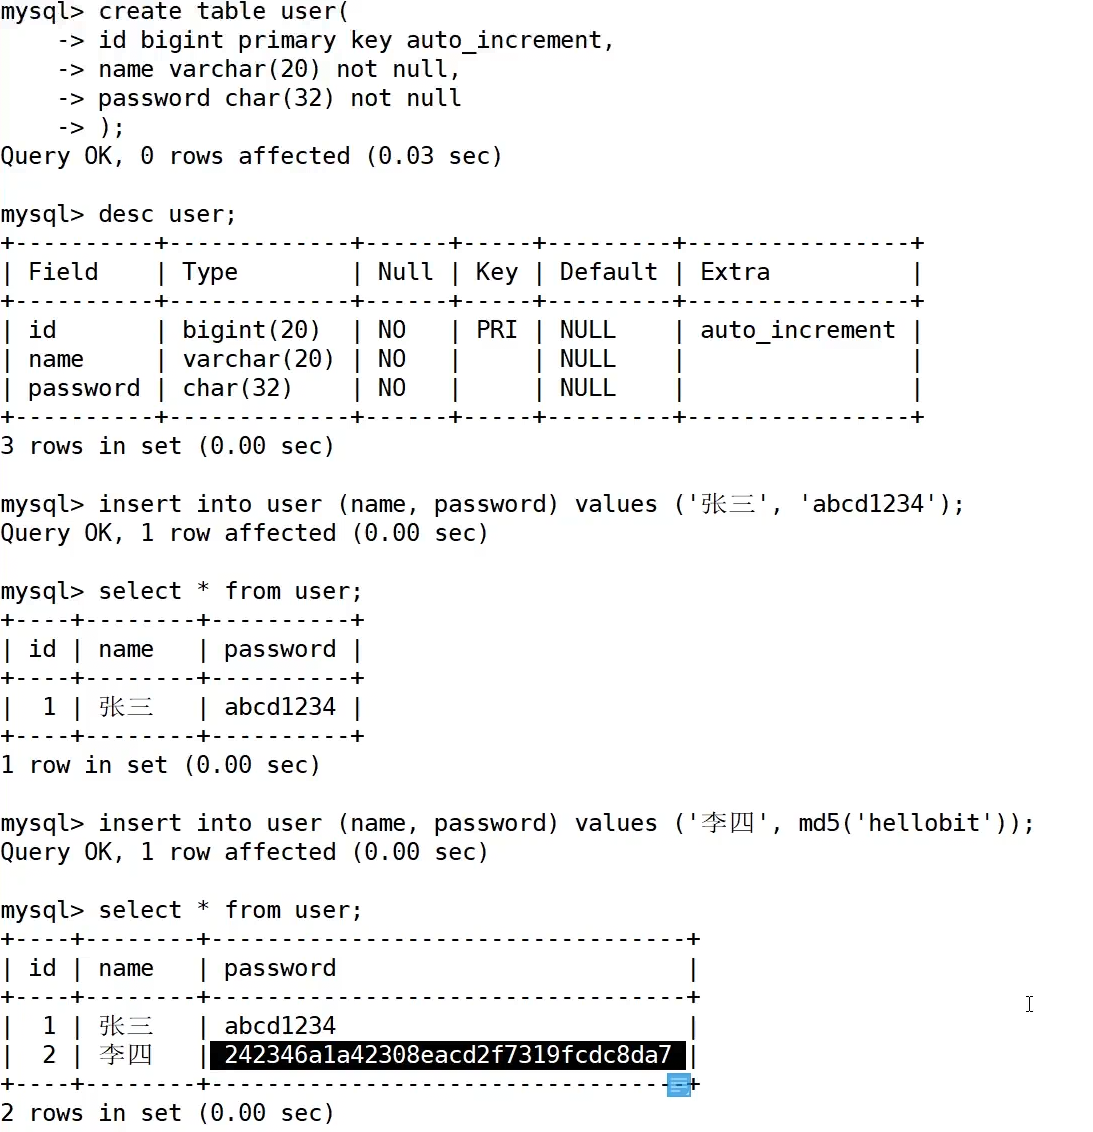
典型场景 :用户注册时,系统不存储明文密码 'hellobit',而是存储其 MD5 值 '242346a1a42308eacd2f7319fcde8da7'(32位)。在登录验证时,将用户输入的明文再次计算 MD5,与数据库存储的摘要值进行比对。
核心实战演示:
假设存在一张 user 用户表,其中 password 字段定义为 CHAR(32),恰好匹配 MD5 的固定长度。
sql
-- 插入两条记录:张三明文存储(绝不推荐),李四摘要存储
INSERT INTO user (name, password) VALUES ('张三', 'abcd1234');
INSERT INTO user (name, password) VALUES ('李四', MD5('hellobit'));
验证查询陷阱 :
若直接使用明文比对,将无法匹配摘要存储的记录:
sql
-- 错误写法:拿明文去匹配摘要值
SELECT name FROM user WHERE name='李四' AND password='hellobit';
-- 返回 Empty set(无结果)正确做法:查询时对用户输入的明文动态取摘要:
sql
-- 正确写法:输入明文同样经过 MD5 转换后再比对
SELECT name FROM user WHERE name='李四' AND password=MD5('hellobit');
+--------+
| name   |
+--------+
| 李四   |
+--------+
这揭示了 MD5 使用的铁律:存储时用 MD5(原文),查询比对时也必须用 MD5(用户输入),两端保持算法一致。
4.3.2 PASSWORD() 系统加密函数
PASSWORD() 是 MySQL 系统内部用于 mysql.user 权限表中密码字段加密的函数 (注意:MySQL 8.0 起已被废弃,但在老旧系统维护或历史数据迁移时依然常见)。与 MD5 不同,它返回的固定长度为 41 个字符 (格式为 * 加上 40 位十六进制大写字符)。
示例:
sql
SELECT PASSWORD('1223');
+-------------------------------------------+
| PASSWORD('1223')                          |
+-------------------------------------------+
| *0D7F7F31D85EF4BCE2C4BB738B9B3319F6D68B0F |
+-------------------------------------------+
观察结果可知,无论输入 '1223' 还是其他任意长度的字符串,输出始终保持 41 位的等长结构。
重要警示 :PASSWORD() 的加密算法与 MD5() 不同,且与 MySQL 版本强相关 (早期版本使用 PASSWORD,后期改用 caching_sha2_password)。在现代应用开发中,严禁将 PASSWORD() 用于业务表(如用户登录表)的密码加密,它仅服务于 MySQL 自身的权限体系。业务端应统一使用 MD5()、SHA1() 或更高级的 SHA2() 配合盐值(Salt)。
4.4 关键字冲突与命令行历史记录
在实际编写 SQL 涉及密码字段操作时,开发者可能会注意到一个现象:在 MySQL 命令行客户端中,当输入包含 PASSWORD(或 PASSWORD())关键字的语句后,若按上下方向键翻找历史命令,有时无法找到之前刚执行的那条插入或查询语句。
原因分析 :
PASSWORD 属于 MySQL 的保留关键字(Reserved Keyword)。在命令行交互环境中,客户端的词法解析器在处理历史缓存时,若遇到存在歧义或特殊语义的关键字,可能中断对该条完整 SQL 的记录,或者因关键字的敏感状态导致上下键检索失效(表现为按下后无响应或跳过该条记录)。
最佳规避方案 :
虽然不直接修改数据库行为,但在编写涉及加密函数或字段名与关键字冲突的 SQL 时,养成以下习惯可避免此类交互困扰:
- 若列名恰巧命名为了
password或user,务必使用反引号(`````)将列名包裹,例如:SELECT `password` FROM user WHERE `password` = MD5('xxx')。 - 对于函数调用(如
SELECT PASSWORD('123')),因为函数名大写且带括号,通常不被视为普通列名,但鉴于历史记录的兼容性问题,建议在命令行中采用复制粘贴执行替代上下键翻找,或使用\s查看状态后执行source脚本。
特别说明:此现象源于客户端交互层的词法缓存机制,不影响 SQL 在存储过程、触发器或应用程序驱动中的正常执行。