文章目录
- 前言
- 零、论文基本信息
- 一、问题背景:对话时间为什么不是事件时间
-
- [1. 两条容易混淆的时间轴](#1. 两条容易混淆的时间轴)
- [2. Temporal Inaccuracy:时间记错位置](#2. Temporal Inaccuracy:时间记错位置)
- [3. Temporal Fragmentation:连续经历被切成孤立点](#3. Temporal Fragmentation:连续经历被切成孤立点)
- [二、相关工作:TSM 与时间感知记忆的差别](#二、相关工作:TSM 与时间感知记忆的差别)
-
- [1. Factual Memory 与 Personalized Agent](#1. Factual Memory 与 Personalized Agent)
- [2. Graph-structured Memory](#2. Graph-structured Memory)
- [3. Hierarchical Memory](#3. Hierarchical Memory)
- [三、方法总览:Episodic Memory 与 Durative Memory 的双层结构](#三、方法总览:Episodic Memory 与 Durative Memory 的双层结构)
- [四、Episodic Memory:在 semantic timeline 上建立时间知识图](#四、Episodic Memory:在 semantic timeline 上建立时间知识图)
-
- [1. TKG 的基本表示](#1. TKG 的基本表示)
- [2. Entity Summary](#2. Entity Summary)
- [3. 图不是最终回答内容,而是时间索引](#3. 图不是最终回答内容,而是时间索引)
- [五、Durative Memory:从点状事件提炼持续主题与 Persona](#五、Durative Memory:从点状事件提炼持续主题与 Persona)
-
- [1. 动机:用户状态不是一个时间点](#1. 动机:用户状态不是一个时间点)
- [2. 按 semantic time 切片](#2. 按 semantic time 切片)
- [3. 收集实体并进行语义聚类](#3. 收集实体并进行语义聚类)
- [4. Topic Memory](#4. Topic Memory)
- [5. Persona Memory](#5. Persona Memory)
- [六、Semantic-time Guided Retrieval:先理解"问的是何时"](#六、Semantic-time Guided Retrieval:先理解“问的是何时”)
-
- [1. 解析查询的 temporal intent](#1. 解析查询的 temporal intent)
- [2. 构建混合记忆池](#2. 构建混合记忆池)
- [3. 语义召回](#3. 语义召回)
- [4. 对 Durative Memory 做时间过滤](#4. 对 Durative Memory 做时间过滤)
- [5. 从 TKG 找回时间有效的原始证据](#5. 从 TKG 找回时间有效的原始证据)
- [6. 时间优先、语义次优先的重排](#6. 时间优先、语义次优先的重排)
- [七、Hierarchical Memory Update:在线修事实,离线重摘要](#七、Hierarchical Memory Update:在线修事实,离线重摘要)
-
- [1. Lightweight Online Graph Update](#1. Lightweight Online Graph Update)
- [2. Sleep-time Summary Consolidation](#2. Sleep-time Summary Consolidation)
- [3. 两阶段更新的代价](#3. 两阶段更新的代价)
- 八、实验设置
-
- [1. 数据集](#1. 数据集)
- [2. Baselines](#2. Baselines)
- [3. Backbone 与评估](#3. Backbone 与评估)
- [九、主实验:TSM 的收益主要来自长历史与时间密集任务](#九、主实验:TSM 的收益主要来自长历史与时间密集任务)
-
- [1. LONGMEMEVAL_S:整体准确率提高 12.2 个百分点](#1. LONGMEMEVAL_S:整体准确率提高 12.2 个百分点)
- [2. 更换 Qwen3 后,整体仍领先但 Full Text 在局部更强](#2. 更换 Qwen3 后,整体仍领先但 Full Text 在局部更强)
- [3. LOCOMO:TSM 是最强 memory method,但不是最强输入策略](#3. LOCOMO:TSM 是最强 memory method,但不是最强输入策略)
- [4. Frontier Model 不能替代正确的 Memory Organization](#4. Frontier Model 不能替代正确的 Memory Organization)
- [十、消融实验:时间检索更稳定,Persona 收益更不均匀](#十、消融实验:时间检索更稳定,Persona 收益更不均匀)
-
- [1. 去掉时间过滤:Temporal 降幅最大](#1. 去掉时间过滤:Temporal 降幅最大)
- [2. 去掉 Durative Summary:偏好大幅下降,部分事实问题反而提高](#2. 去掉 Durative Summary:偏好大幅下降,部分事实问题反而提高)
- [3. 论文正文与 Table 3 存在数值不一致](#3. 论文正文与 Table 3 存在数值不一致)
- [十一、效率分析:TSM 更快召回,但总 Token 不是最低](#十一、效率分析:TSM 更快召回,但总 Token 不是最低)
- [十二、Embedding 敏感性与案例分析](#十二、Embedding 敏感性与案例分析)
-
- [1. Embedding 模型会影响效果](#1. Embedding 模型会影响效果)
- [2. Case Study:last weekend 如何被解析](#2. Case Study:last weekend 如何被解析)
- [十三、与 Agent Memory 系列方法的横向比较](#十三、与 Agent Memory 系列方法的横向比较)
- [十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:区分"记录时间"与"代码有效时间"](#1. Coding Agent:区分“记录时间”与“代码有效时间”)
- [2. Tool Agent:让工具结果带业务有效期](#2. Tool Agent:让工具结果带业务有效期)
- [3. Multi-Agent:共享记忆需要 temporal validity](#3. Multi-Agent:共享记忆需要 temporal validity)
- 十五、局限性与证据边界
-
- [1. 固定月粒度过于刚性](#1. 固定月粒度过于刚性)
- [2. 时间解析仍可能成为单点故障](#2. 时间解析仍可能成为单点故障)
- [3. Durative Summary 会引入过度概括](#3. Durative Summary 会引入过度概括)
- [4. LoCoMo 分类结果并非全面占优](#4. LoCoMo 分类结果并非全面占优)
- [5. 实验只跑一次](#5. 实验只跑一次)
- [6. 未验证百万 Token 长历史](#6. 未验证百万 Token 长历史)
- [7. 隐私、遗忘与摘要删除未展开](#7. 隐私、遗忘与摘要删除未展开)
- [8. 主要局限于个性化事实记忆](#8. 主要局限于个性化事实记忆)
- 十六、我的理解与启发
-
- [1. TSM 的本质是把 Time 从 metadata 提升为 retrieval key](#1. TSM 的本质是把 Time 从 metadata 提升为 retrieval key)
- [2. Durative Memory 补上了"事实"和"人格"之间的中间层](#2. Durative Memory 补上了“事实”和“人格”之间的中间层)
- [3. 时间应该是多尺度的,而不是单一月份](#3. 时间应该是多尺度的,而不是单一月份)
- [4. Retrieval Router 比全量 Temporal Filtering 更合理](#4. Retrieval Router 比全量 Temporal Filtering 更合理)
- [5. 记忆更新需要同时支持"失效"与"修订"](#5. 记忆更新需要同时支持“失效”与“修订”)
- 十七、总结
- 参考资料
前言
长期记忆系统通常会给每条记忆附上时间,但"有时间戳"并不等于"理解了时间"。
假设用户在 5 月 20 日说:"我计划 5 月 22 日去东京。"传统记忆系统很容易把这条信息记在 5 月 20 日,因为那是对话发生的时间。但真正需要参与推理的是 5 月 22 日------事件发生的时间。几天后用户又提到参观明治神宫、吃寿司和喝鸡尾酒,这些看似独立的点状记忆,其实共同描述了一次持续数天的东京旅行。
如果系统只按"什么时候聊到"排序,它会把未来计划错放到 5 月 20 日;如果系统只保存"去了神宫""吃了寿司"等离散 facts,它又无法形成"5 月东京之旅"这个持续状态。
在前面的 Agent Memory 系列中,A-MEM 解决了记忆如何自主建立关联,SEEM 解决了如何从碎片事实回到完整事件原文。这篇论文进一步追问:记忆应该沿哪一条时间轴组织?短时事件又如何沉淀成持续数周乃至数月的主题和 persona?
论文提出 Temporal Semantic Memory(TSM)。它的唯一核心增量可以概括为:
TSM 将 Agent Memory 的主时间轴从 dialogue time 改为事件真正发生的 semantic time,并在这条时间轴上把连续、相关的点状事实整合为 durative memory,使写入、检索和更新都受到事件有效时间而非聊天时间约束。
这不是简单地给向量检索加一个时间衰减项。TSM 同时改变了记忆的时间坐标、抽象粒度与检索顺序:先建立带有效时间的 Temporal Knowledge Graph,再按时间片形成 topic/persona,查询时解析用户真正询问的时间范围,最后用时间约束对语义候选进行过滤和重排。
零、论文基本信息
- 论文名称: Beyond Dialogue Time: Temporal Semantic Memory for Personalized LLM Agents
- 发表平台: Findings of ACL 2026
- 代码仓库: 未公开(正式论文和 ACL Anthology 页面未提供代码链接)
- 作者: Miao Su、Yucan Guo、Zhongni Hou、Long Bai、Zixuan Li、Yufei Zhang、Guojun Yin、Wei Lin、Xiaolong Jin、Jiafeng Guo、Xueqi Cheng
一、问题背景:对话时间为什么不是事件时间
1. 两条容易混淆的时间轴
长期对话中至少存在两种时间:
- Dialogue Time: 用户什么时候说出这句话;
- Semantic Time: 这句话描述的事情什么时候发生或有效。
二者可能相同,也可能相差很远。
- "我昨天去了医院":聊天发生在今天,事件发生在昨天;
- "我下周要去波士顿":聊天发生在本周,事件发生在未来;
- "我从 2022 年开始住在上海":聊天只是一个点,事实却跨越多年;
- "我不再喝咖啡了":新状态会让旧偏好失效。
如果记忆系统只记录 dialogue timestamp,排序、更新和检索都会偏离事实真正有效的时间。
2. Temporal Inaccuracy:时间记错位置
现有系统常把 chat turn 的时间当作 memory time。对于"5 月 28 日说,明天想吃寿司"这类表达,记忆可能被挂在 5 月 28 日,而不是 5 月 29 日。随后查询"东京旅行期间吃过什么"时,系统可能因为时间范围不匹配而漏召回。
3. Temporal Fragmentation:连续经历被切成孤立点
许多记忆框架抽取的是 point-wise memory:
- 5 月 22 日到达东京;
- 5 月 23 日参观明治神宫;
- 5 月 29 日吃寿司;
- 5 月底结束旅行。
每条都正确,但系统没有显式表示"这些活动属于一次东京旅行"。结果是 Agent 能回答某一个事实,却难以理解持续状态、偏好变化和长期模式。
在看完整方法之前,Figure 1 很直观地展示了 TSM 改变的两件事:把点状记忆校正到 semantic timeline,并进一步形成 durative memory。
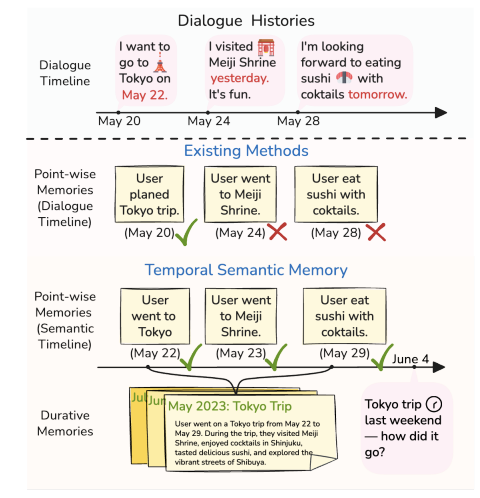
Figure 1:现有方法与 TSM 的时间建模差异。 TSM 将记忆放到事件实际发生的时间轴,并将连续事实整合为持续性记忆。
Figure 1 支持的核心结论是:TSM 不是只在检索时加入时间,而是从记忆写入开始就改变时间归属;durative memory 也不是另一条对话摘要,而是由 semantic timeline 上连续的事实聚合而来。
二、相关工作:TSM 与时间感知记忆的差别
1. Factual Memory 与 Personalized Agent
个性化 Agent 通常保存用户资料、偏好、计划和历史事件,用于跨 session 保持一致。Mem0、MemoryOS、LangMem 等方法分别从事实抽取、层级存储和长期记忆管理角度解决问题,但它们常以 chat turn 或抽取后的 memory item 为单位。
这些方法能够回答"用户喜欢什么",却未必能稳定回答:
- 用户什么时候开始喜欢它?
- 这种偏好维持了多久?
- 新信息是否已经让旧信息失效?
- 多条经历是否反映同一长期模式?
2. Graph-structured Memory
Mem0g、A-MEM、Zep 等方法用图连接实体、事实或 memory notes。图结构提升了关系检索和更新能力,尤其是 Zep 已经在边上记录 temporal validity。
TSM 对这条路线的批评是:时间写进图里,不代表检索阶段真正使用了时间。 如果 retrieval 仍主要按 embedding similarity 排序,图中的有效时间只参与存储,没有成为 query constraint。
3. Hierarchical Memory
RAPTOR、MemoryOS 等层级记忆通过摘要或层级存储压缩长历史。TSM 同样生成高层摘要,但它的聚合边界由固定 semantic-time slice 与实体聚类共同决定,而不是只按 session 或文本层级递归汇总。
因此 TSM 的最近邻并不是单一方法,而是 temporal knowledge graph 与 hierarchical summary 的组合。它真正新增的是:让两者共享同一条 semantic timeline,并把查询的 temporal intent 接入检索。
三、方法总览:Episodic Memory 与 Durative Memory 的双层结构
标准 Agent Memory 通常包含三个函数:
M = f c o n s t r u c t ( D ) M=f_{construct}(D) M=fconstruct(D)
M ′ = f u p d a t e ( M , D ′ ) M'=f_{update}(M,D') M′=fupdate(M,D′)
A = f r e t r i e v e ( M , Q ) A=f_{retrieve}(M,Q) A=fretrieve(M,Q)
其中 D D D 是历史对话, D ′ D' D′ 是新对话, M M M 是已有记忆, Q Q Q 是当前查询, A A A 是回答。TSM 没有改变这个三阶段定义,但改变了每个阶段使用时间的方式。
Figure 2 展示完整流程。左侧是写入与 consolidation,右侧是查询与时间约束检索。
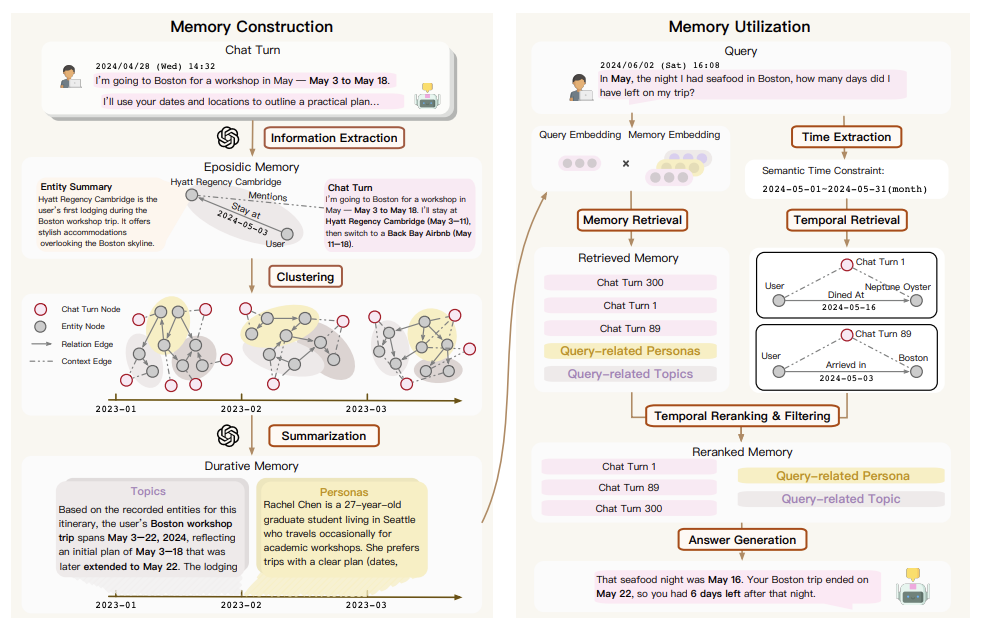
Figure 2:TSM 整体框架。 左侧从 chat turn 构建时间知识图并形成 topic/persona;右侧从查询解析 semantic time,对语义候选进行时间过滤与重排。
TSM 维护两类互补记忆:
- Episodic Memory: 带准确 semantic timestamp 的原子事实,以 Temporal Knowledge Graph 组织;
- Durative Memory: 从一段时间内的 episodic facts 抽象出的持续主题和 persona。
这两层的职责不同:episodic layer 负责"什么时候发生了什么",durative layer 负责"这段时期总体呈现了什么状态或模式"。
完整链路可以写成:
D → G → { G ( k ) } → { T o p i c z , P e r s o n a z } D\rightarrow G\rightarrow \{G^{(k)}\} \rightarrow \{Topic_z,Persona_z\} D→G→{G(k)}→{Topicz,Personaz}
q → T q → D s e m a n t i c ∪ S T → TemporalRerank → A q\rightarrow T_q\rightarrow D_{semantic}\cup S_T \rightarrow \operatorname{TemporalRerank}\rightarrow A q→Tq→Dsemantic∪ST→TemporalRerank→A
四、Episodic Memory:在 semantic timeline 上建立时间知识图
1. TKG 的基本表示
TSM 首先把对话抽取成带时间的关系事实:
G = { ( e s , r , e o , t ) ∣ t ∈ T } G=\{(e_s,r,e_o,t)\mid t\in\mathcal{T}\} G={(es,r,eo,t)∣t∈T}
其中:
- e s e_s es:主体实体;
- r r r:语义关系;
- e o e_o eo:客体实体;
- t t t:该事实真正有效的 semantic time;
- T \mathcal{T} T:所有可能的时间点或时间范围。
例如用户在 4 月 28 日说:"我 5 月 3 日至 18 日去波士顿参加 workshop。"系统应抽取:
( User , travels to , Boston , 2024 - 05 - 03 , 2024 - 05 - 18 ) (\text{User},\text{travels to},\text{Boston},2024\\text{-}05\\text{-}03,2024\\text{-}05\\text{-}18) (User,travels to,Boston,2024-05-03,2024-05-18)
而不是把事实放在 4 月 28 日。
2. Entity Summary
每个实体不仅有 canonical name,还维护一段从支持对话中生成的简短描述:
e ≜ ( n e , s e ) e\triangleq(n_e,s_e) e≜(ne,se)
n e n_e ne 是标准实体名, s e s_e se 是实体摘要。图节点负责关系定位,entity summary 则为后续聚类提供更丰富的语义。
3. 图不是最终回答内容,而是时间索引
论文明确说明,TKG 不直接作为唯一可检索记忆内容。它更像一个结构化时间索引,用于:
- 精确定位 semantic time;
- 检查新旧事实的时间一致性;
- 从事实反查原始 chat turn;
- 为 durative memory construction 提供实体集合。
这是一个重要设计判断。单条图事实往往缺少原因、方法和叙事细节,因此最终回答仍需原始对话和高层摘要。
五、Durative Memory:从点状事件提炼持续主题与 Persona
1. 动机:用户状态不是一个时间点
"用户这周做了三次烘焙"可能反映一次持续兴趣;"三个月内反复调整旅行计划"可能反映计划偏好。若每条 fact 独立存储,系统只能看到局部动作,看不到延续性。
TSM 将 temporal graph 按时间片切分,再在每个时间片内部做语义聚类和摘要。
2. 按 semantic time 切片
G = ⋃ k G ( k ) G=\bigcup_k G^{(k)} G=k⋃G(k)
G ( k ) = { ( e s , r , e o , t ) ∣ t ∈ [ τ k , τ k + 1 ) } G^{(k)}=\{(e_s,r,e_o,t)\mid t\in[\tau_k,\tau_{k+1})\} G(k)={(es,r,eo,t)∣t∈[τk,τk+1)}
[ τ k , τ k + 1 ) [\tau_k,\tau_{k+1}) [τk,τk+1) 是第 k k k 个时间区间。论文默认一个月为一个 slice。
这意味着 5 月 28 日谈到"去年夏天旅行"的事实会进入去年夏天的 semantic slice,而不是当前月份。
固定月粒度使实现简单,也构成论文最明显的边界:有些状态持续几小时,有些偏好持续几年,一个月并不总是合适。
3. 收集实体并进行语义聚类
对每个 slice,先收集其中出现的实体:
E ( k ) = { e ∣ e appears in G ( k ) } E^{(k)}=\{e\mid e\text{ appears in }G^{(k)}\} E(k)={e∣e appears in G(k)}
随后将实体名称 embedding 输入 Gaussian Mixture Model:
p ( z ∣ e ) = GMM ( h e n a m e ) p(z\mid e)=\operatorname{GMM}(h_e^{name}) p(z∣e)=GMM(hename)
其中 z z z 是潜在语义簇, h e n a m e h_e^{name} hename 是实体名称表示。实体被分配给概率最大的簇:
a ( e ) = arg max z p ( z ∣ e ) a(e)=\arg\max_z p(z\mid e) a(e)=argzmaxp(z∣e)
E z = { e ∈ E ( k ) ∣ a ( e ) = z } E_z=\{e\in E^{(k)}\mid a(e)=z\} Ez={e∈E(k)∣a(e)=z}
因此时间只决定"哪些事实有资格一起考虑",语义聚类再决定"这些实体是否描述同一主题"。
4. Topic Memory
对簇 E z E_z Ez,收集实体名称和摘要:
X z = { ( n e , s e ) ∣ e ∈ E z } X_z=\{(n_e,s_e)\mid e\in E_z\} Xz={(ne,se)∣e∈Ez}
再生成 topic:
T o p i c z = { τ k , s z , c z } Topic_z=\{\tau_k,s_z,c_z\} Topicz={τk,sz,cz}
s z = L L M s u m ( X z ) , c z = E m b e d d i n g ( s z ) s_z=LLM_{sum}(X_z),\qquad c_z=Embedding(s_z) sz=LLMsum(Xz),cz=Embedding(sz)
s z s_z sz 是主题摘要, c z c_z cz 是检索用向量。Topic 回答的是"这一时期围绕哪些主题发生了什么"。
5. Persona Memory
Topic 以实体摘要为输入,Persona 则回到这些实体对应的原始对话:
D z = { d ∣ d mentions e , e ∈ E z } D_z=\{d\mid d\text{ mentions }e,e\in E_z\} Dz={d∣d mentions e,e∈Ez}
P e r s o n a z = { τ k , p z , u z } Persona_z=\{\tau_k,p_z,u_z\} Personaz={τk,pz,uz}
p z = L L M s u m ( D z ) , u z = E m b e d d i n g ( p z ) p_z=LLM_{sum}(D_z),\qquad u_z=Embedding(p_z) pz=LLMsum(Dz),uz=Embedding(pz)
p z p_z pz 捕获用户在该时间片内较稳定的特征、偏好和行为模式, u z u_z uz 是它的向量表示。
Topic 与 Persona 的差别可以理解为:
- Topic 描述"这段时间谈论和经历了什么";
- Persona 描述"这些经历反映出用户是什么样的人"。
两者共同形成 durative memory,补足单点 facts 无法表达的持续状态。
六、Semantic-time Guided Retrieval:先理解"问的是何时"
1. 解析查询的 temporal intent
给定查询 q q q 与当前时间 t n o w t_{now} tnow,TSM 先解析事件应当成立的时间范围:
T q = P a r s e T i m e ( q , t n o w ) T_q=ParseTime(q,t_{now}) Tq=ParseTime(q,tnow)
论文使用 spaCy 处理显式和相对时间表达。例如查询时间是 2023-05-30,"last weekend"会被解析为 2023-05-22 至 2023-05-28。
这里解析的是 query 所指事件的时间,而不是 query 本身的发送时间。
2. 构建混合记忆池
M = M t o p i c ∪ M p e r s o n a ∪ M r a w M=M_{topic}\cup M_{persona}\cup M_{raw} M=Mtopic∪Mpersona∪Mraw
TSM 并未只检索摘要。Topic、Persona 和原始 chat turn 都进入候选池,避免高层 abstraction 丢失具体答案。
3. 语义召回
s s e m ( m ; q ) = s i m ( E n c ( q ) , E n c ( m ) ) s_{sem}(m;q)=sim(Enc(q),Enc(m)) ssem(m;q)=sim(Enc(q),Enc(m))
D = T o p K m ∈ M s s e m ( m ; q ) D=TopK_{m\in M}\ s_{sem}(m;q) D=TopKm∈M ssem(m;q)
论文默认 Top-K 为 25,embedding 使用 OpenAI text-embedding-3-small;附录另测了 Qwen text-embedding-v4。
这一步仍是普通 dense retrieval。TSM 的差异发生在随后:时间不是与相似度混成一个可被稀释的软分数,而是高优先级约束。
4. 对 Durative Memory 做时间过滤
K e e p ( m , T q ) = { I τ ( m ) ∈ T q , m ∈ M t o p i c ∪ M p e r s o n a 1 , m ∈ M r a w Keep(m,T_q)= \begin{cases} \mathbb{I}\\tau(m)\\in T_q, & m\in M_{topic}\cup M_{persona}\\ 1, & m\in M_{raw} \end{cases} Keep(m,Tq)={Iτ(m)∈Tq,1,m∈Mtopic∪Mpersonam∈Mraw
Topic 和 Persona 带有 time slice,因此必须与 T q T_q Tq 匹配;raw turn 不在这一步硬过滤,避免因为对话时间与事件时间不一致而误删。
这个不对称设计很合理:durative summary 的时间是构建时已经校正的 semantic time,可以直接过滤;raw turn 的 timestamp 只是 dialogue time,不能拿来代表事件时间。
5. 从 TKG 找回时间有效的原始证据
F T = { ( e s , r , e o , t ) ∈ G ∣ t ∈ T q } F_T=\{(e_s,r,e_o,t)\in G\mid t\in T_q\} FT={(es,r,eo,t)∈G∣t∈Tq}
S T = I d x ( F T ) S_T=Idx(F_T) ST=Idx(FT)
I d x ( ⋅ ) Idx(\cdot) Idx(⋅) 是 fact 与 chat turn 之间的双向索引。命中时间范围的 facts 会反向定位原始对话,使包含有效时间证据的 raw turns 获得更高优先级。
6. 时间优先、语义次优先的重排
TSM 定义二元排序键:
π ( m ; q ) = ( I τ ( m ) ∈ T q , s s e m ( m ; q ) ) \pi(m;q)=\left(\mathbb{I}\\tau(m)\\in T_q,s_{sem}(m;q)\right) π(m;q)=(Iτ(m)∈Tq,ssem(m;q))
R = S o r t m ∈ D π ( m ; q ) R=Sort_{m\in D}\ \pi(m;q) R=Sortm∈D π(m;q)
排序采用 descending lexicographic order:先比较是否满足 semantic-time constraint,再比较 embedding similarity。
这与常见的加权和不同。若写成 α s t i m e + ( 1 − α ) s s e m \alpha s_{time}+(1-\alpha)s_{sem} αstime+(1−α)ssem,非常相似但时间错误的记忆仍可能排在前面。词典序排序相当于声明:时间有效性优先于语义接近度。
七、Hierarchical Memory Update:在线修事实,离线重摘要
1. Lightweight Online Graph Update
新对话到来时,TKG 进行增量更新,不阻塞在线推理。
对实体执行:
- ADD: 新实体创建节点;
- MERGE: 映射到已有实体并合并新属性或证据。
对关系 fact 维护 v a l i d _ t i m e valid\_time valid_time 与 i n v a l i d _ t i m e invalid\_time invalid_time,并执行四类操作:
- DUPLICATE: 新旧事实重复;
- ADD: 新增关系;
- INVALIDATE: 旧事实不再有效;
- UPDATE: 更新已有事实或时间范围。
这让"用户现在改喝茶了"不仅新增一个事实,还能结束"用户喝咖啡"的有效区间。
2. Sleep-time Summary Consolidation
Topic 和 Persona 需要重新聚类与 LLM 摘要,成本更高。TSM 不在每轮对话后重算,而是:
- 定期执行,例如每月一次;或
- 当累计 turn 数超过阈值时执行。
这个设计把低延迟的事实维护与高成本的长期抽象分离。它类似人类睡眠期间的 memory consolidation,也使在线 recall 不需要再调用 LLM 做复杂抽取。
3. 两阶段更新的代价
Sleep-time consolidation 提高效率,却引入一致性窗口:在下一次 consolidation 之前,新事实已经进入 TKG,但 topic/persona 仍可能是旧版本。论文没有讨论如何标记这种"摘要滞后",也没有给出跨时间片重分配的增量算法。
八、实验设置
1. 数据集
LONGMEMEVAL_S
LongMemEval 测试信息抽取、多 session 推理、时间推理、知识更新、偏好与拒答。论文采用 LONGMEMEVAL_S:500 个问题,每个问题约 115K tokens、30 至 40 个 session。
没有使用约 1.5M tokens、约 500 sessions 的 LONGMEMEVAL_M,原因是计算成本。这意味着论文结论尚未验证百万 token 级历史。
LOCOMO
LoCoMo 包含 1,986 个问题,覆盖 temporal、multi-hop、open-domain、single-hop 和 adversarial。论文正文称单段对话约 16K 至 26K tokens,附录则写平均约 9K tokens;两个描述口径并不完全一致。
LoCoMo query 本身不带 timestamp,作者用 session start time 作为解析相对时间的参考。这是一个人为补充,可能影响 temporal evaluation 的现实性。
2. Baselines
- Full Text;
- Naive RAG;
- LangMem;
- A-MEM;
- MemoryOS;
- Mem0 / Mem0g;
- Zep。
3. Backbone 与评估
主要比较使用 GPT-4o-mini 与 Qwen3-30B-A3B-Instruct-2507。TSM 还把生成模型替换为 Gemini-3-Pro 与 Gemini-3-Flash,但 memory construction 仍使用 GPT-4o-mini。
所有准确率均由 GPT-4.1-mini 作为 LLM-as-a-Judge 评估。附录明确指出实验是固定配置下的 single run,没有多随机种子和显著性检验。
九、主实验:TSM 的收益主要来自长历史与时间密集任务
1. LONGMEMEVAL_S:整体准确率提高 12.2 个百分点
GPT-4o-mini ACC Temporal Multi-S K-Update S-User S-Asst S-Pref Full Text 56.80 31.58 45.45 76.92 87.14 89.29 36.67 Naive RAG 61.00 39.85 48.48 67.95 90.00 98.21 53.33 LangMem 37.20 15.79 20.30 66.67 60.00 46.43 60.00 A-MEM 62.60 47.36 48.87 64.11 92.86 96.43 46.67 Zep 60.20 36.50 47.40 76.90 81.40 81.80 30.00 MemoryOS 44.80 32.33 31.06 48.72 80.00 64.29 30.00 Mem0 53.61 40.15 46.21 70.12 81.43 41.07 60.00 TSM 74.80 69.92 69.17 80.77 87.14 94.64 40.00 \begin{array}{l|c|cccccc} \hline \text{GPT-4o-mini} & \text{ACC} & \text{Temporal} & \text{Multi-S} & \text{K-Update} & \text{S-User} & \text{S-Asst} & \text{S-Pref}\\ \hline \text{Full Text} & 56.80 & 31.58 & 45.45 & 76.92 & 87.14 & 89.29 & 36.67\\ \text{Naive RAG} & 61.00 & 39.85 & 48.48 & 67.95 & 90.00 & \mathbf{98.21} & 53.33\\ \text{LangMem} & 37.20 & 15.79 & 20.30 & 66.67 & 60.00 & 46.43 & \mathbf{60.00}\\ \text{A-MEM} & 62.60 & 47.36 & 48.87 & 64.11 & \mathbf{92.86} & 96.43 & 46.67\\ \text{Zep} & 60.20 & 36.50 & 47.40 & 76.90 & 81.40 & 81.80 & 30.00\\ \text{MemoryOS} & 44.80 & 32.33 & 31.06 & 48.72 & 80.00 & 64.29 & 30.00\\ \text{Mem0} & 53.61 & 40.15 & 46.21 & 70.12 & 81.43 & 41.07 & \mathbf{60.00}\\ \mathbf{\text{TSM}} & \mathbf{74.80} & \mathbf{69.92} & \mathbf{69.17} & \mathbf{80.77} & 87.14 & 94.64 & 40.00\\ \hline \end{array} GPT-4o-miniFull TextNaive RAGLangMemA-MEMZepMemoryOSMem0TSMACC56.8061.0037.2062.6060.2044.8053.6174.80Temporal31.5839.8515.7947.3636.5032.3340.1569.92Multi-S45.4548.4820.3048.8747.4031.0646.2169.17K-Update76.9267.9566.6764.1176.9048.7270.1280.77S-User87.1490.0060.0092.8681.4080.0081.4387.14S-Asst89.2998.2146.4396.4381.8064.2941.0794.64S-Pref36.6753.3360.0046.6730.0030.0060.0040.00
Table 1:LONGMEMEVAL_S 分类准确率(GPT-4o-mini)。 TSM 的整体、时间、多 session 与知识更新指标最佳,但单 session 偏好并不占优。
TSM 从 A-MEM 的 62.60% 提升到 74.80%,绝对提高 12.20 个百分点。提升最集中在两个与论文机制直接对应的类别:
- Temporal:47.36% → 69.92%,提高 22.56 个百分点;
- Multi-Session:48.87% → 69.17%,提高 20.30 个百分点。
这组结果为 semantic timeline 与 durative memory 提供了较强支持:时间正确定位改善 temporal query,跨月 topic/persona 帮助跨 session 汇总。
但 TSM 的 Single-Preference 只有 40.00%,低于 Mem0 与 LangMem 的 60.00%,也低于 Naive RAG 的 53.33%。作者用样本仅 30、方差较大来解释,但这仍是不能忽略的反例:durative persona 并未自动转化为更强的偏好回答。
2. 更换 Qwen3 后,整体仍领先但 Full Text 在局部更强
Qwen3-30B ACC Temporal Multi-S K-Update S-User S-Asst S-Pref Full Text 54.80 33.08 35.61 76.92 82.86 87.50 50.00 Naive RAG 60.80 36.84 47.73 65.38 91.43 98.21 70.00 LangMem 50.80 37.60 38.35 67.95 78.57 42.86 70.00 A-MEM 65.20 51.88 51.12 76.93 90.00 96.43 40.00 MemoryOS 49.60 28.57 36.84 61.54 72.86 92.86 33.33 Mem0 39.51 41.94 28.13 28.57 55.32 26.09 81.82 TSM 74.80 63.91 63.91 82.05 97.14 92.86 66.67 \begin{array}{l|c|cccccc} \hline \text{Qwen3-30B} & \text{ACC} & \text{Temporal} & \text{Multi-S} & \text{K-Update} & \text{S-User} & \text{S-Asst} & \text{S-Pref}\\ \hline \text{Full Text} & 54.80 & 33.08 & 35.61 & 76.92 & 82.86 & 87.50 & 50.00\\ \text{Naive RAG} & 60.80 & 36.84 & 47.73 & 65.38 & 91.43 & \mathbf{98.21} & 70.00\\ \text{LangMem} & 50.80 & 37.60 & 38.35 & 67.95 & 78.57 & 42.86 & 70.00\\ \text{A-MEM} & 65.20 & 51.88 & 51.12 & 76.93 & 90.00 & 96.43 & 40.00\\ \text{MemoryOS} & 49.60 & 28.57 & 36.84 & 61.54 & 72.86 & 92.86 & 33.33\\ \text{Mem0} & 39.51 & 41.94 & 28.13 & 28.57 & 55.32 & 26.09 & \mathbf{81.82}\\ \mathbf{\text{TSM}} & \mathbf{74.80} & \mathbf{63.91} & \mathbf{63.91} & \mathbf{82.05} & \mathbf{97.14} & 92.86 & 66.67\\ \hline \end{array} Qwen3-30BFull TextNaive RAGLangMemA-MEMMemoryOSMem0TSMACC54.8060.8050.8065.2049.6039.5174.80Temporal33.0836.8437.6051.8828.5741.9463.91Multi-S35.6147.7338.3551.1236.8428.1363.91K-Update76.9265.3867.9576.9361.5428.5782.05S-User82.8691.4378.5790.0072.8655.3297.14S-Asst87.5098.2142.8696.4392.8626.0992.86S-Pref50.0070.0070.0040.0033.3381.8266.67
Table 1(续):LONGMEMEVAL_S 分类准确率(Qwen3-30B)。 TSM 更换 backbone 后仍取得最高整体准确率。
TSM 在两个 backbone 上都得到 74.80%,但各类别分布不同。这说明整体分数稳定不等于行为完全稳定;Temporal 从 69.92 降到 63.91,Single-User 则从 87.14 升到 97.14。
3. LOCOMO:TSM 是最强 memory method,但不是最强输入策略
GPT-4o-mini ACC Temporal Multi-Hop Open-Domain Single-Hop Full Text 71.83 76.92 87.14 89.29 36.67 Naive RAG 63.64 67.95 90.00 98.21 53.33 A-MEM 64.16 64.11 92.86 96.43 46.67 Mem0g 68.44 58.13 47.19 75.71 65.71 Zep 58.44 61.65 71.79 88.57 91.07 TSM 76.69 71.03 66.67 58.33 84.30 \begin{array}{l|c|cccc} \hline \text{GPT-4o-mini} & \text{ACC} & \text{Temporal} & \text{Multi-Hop} & \text{Open-Domain} & \text{Single-Hop}\\ \hline \text{Full Text} & 71.83 & 76.92 & 87.14 & 89.29 & 36.67\\ \text{Naive RAG} & 63.64 & 67.95 & 90.00 & \mathbf{98.21} & 53.33\\ \text{A-MEM} & 64.16 & 64.11 & \mathbf{92.86} & 96.43 & 46.67\\ \text{Mem0g} & 68.44 & 58.13 & 47.19 & 75.71 & 65.71\\ \text{Zep} & 58.44 & 61.65 & 71.79 & 88.57 & \mathbf{91.07}\\ \mathbf{\text{TSM}} & \mathbf{76.69} & \mathbf{71.03} & 66.67 & 58.33 & 84.30\\ \hline \end{array} GPT-4o-miniFull TextNaive RAGA-MEMMem0gZepTSMACC71.8363.6464.1668.4458.4476.69Temporal76.9267.9564.1158.1361.6571.03Multi-Hop87.1490.0092.8647.1971.7966.67Open-Domain89.2998.2196.4375.7188.5758.33Single-Hop36.6753.3346.6765.7191.0784.30
Table 2:LOCOMO 分类准确率(GPT-4o-mini,节选)。 TSM 整体最佳,但 Multi-Hop 与 Open-Domain 明显落后部分 baselines。
在 GPT-4o-mini 下,TSM 整体 76.69%,优于其他 memory systems。Single-Hop 为 84.30,仅次于 Zep;Temporal 为 71.03。
但分类结果揭示了平均分掩盖的问题:TSM 的 Multi-Hop 只有 66.67,低于 A-MEM 的 92.86;Open-Domain 只有 58.33,远低于 Naive RAG 的 98.21。TSM 的时间过滤适合时间明确的个性化事实,却可能限制缺少时间锚点或依赖外部常识的问题。
在 Qwen3-30B 下,Full Text 整体为 74.87,高于 TSM 的 71.23。论文对此给出的解释是 LoCoMo 只有约 16K 至 26K tokens,可以完整放进 context window;当全部历史可直接输入时,任何 retrieval 都会承担信息损失风险。
这是一个很有价值的边界:记忆系统的优势会随历史长度增长而显现,并不意味着短上下文下应强制使用记忆检索。
4. Frontier Model 不能替代正确的 Memory Organization
在 LongMemEval 上,保持 GPT-4o-mini 构建记忆、只把最终生成模型替换为 Gemini-3-Pro 或 Gemini-3-Flash 后,TSM 的整体准确率分别为 74.60 和 79.60。Flash 更高,但 Pro 并没有稳定超越基础设置。
这说明更强生成模型不能自动修复错误时间组织;memory construction 和 temporal retrieval 仍然决定模型能看到什么证据。
十、消融实验:时间检索更稳定,Persona 收益更不均匀
Variant Overall S-User Temporal K-Update Multi-S S-Pref S-Asst TSM 74.80 87.14 69.92 80.77 69.17 40.00 94.64 w/o Temporal 72.80 87.14 63.91 79.49 71.43 33.33 91.07 w/o Persona/Summary 73.40 88.57 65.41 82.05 69.92 23.33 96.43 \begin{array}{l|c|cccccc} \hline \text{Variant} & \text{Overall} & \text{S-User} & \text{Temporal} & \text{K-Update} & \text{Multi-S} & \text{S-Pref} & \text{S-Asst}\\ \hline \text{TSM} & \mathbf{74.80} & 87.14 & \mathbf{69.92} & 80.77 & 69.17 & \mathbf{40.00} & 94.64\\ \text{w/o Temporal} & 72.80 & 87.14 & 63.91 & 79.49 & \mathbf{71.43} & 33.33 & 91.07\\ \text{w/o Persona/Summary} & 73.40 & \mathbf{88.57} & 65.41 & \mathbf{82.05} & 69.92 & 23.33 & \mathbf{96.43}\\ \hline \end{array} VariantTSMw/o Temporalw/o Persona/SummaryOverall74.8072.8073.40S-User87.1487.1488.57Temporal69.9263.9165.41K-Update80.7779.4982.05Multi-S69.1771.4369.92S-Pref40.0033.3323.33S-Asst94.6491.0796.43
Table 3:LONGMEMEVAL_S 消融实验。 去掉 temporal retrieval 后整体下降 2.0 分;去掉 topic/persona 后整体下降 1.4 分,但部分子类反而上升。
1. 去掉时间过滤:Temporal 降幅最大
移除 temporal reranking/filtering,只依赖 dense retrieval 后:
- Overall:74.80 → 72.80;
- Temporal:69.92 → 63.91,下降 6.01;
- Preference:40.00 → 33.33;
- Assistant:94.64 → 91.07。
Temporal 是最大稳定降幅,直接支持 semantic-time retrieval 的必要性。
但 Multi-Session 从 69.17 上升到 71.43。这说明硬时间优先并非所有查询都受益:跨 session 问题可能需要跨越多个时间段,过强的 temporal constraint 会排斥语义相关的较早记忆。
2. 去掉 Durative Summary:偏好大幅下降,部分事实问题反而提高
移除 topic/persona 后,整体降至 73.40,Temporal 降至 65.41,Preference 降到 23.33。Persona 对偏好建模确实重要。
但 Single-User、Knowledge-Update、Multi-Session 和 Single-Assistant 均出现不同程度提高。这表明摘要也会带来 distraction 或过度泛化。对精确事实查询,高层 persona 可能不如原始证据直接。
3. 论文正文与 Table 3 存在数值不一致
正式 Table 3 报告 w/o Persona/Summary 的 Overall 为 73.40 ,相对 Full TSM 下降 1.40;正文却写成 73.6、下降 1.2,并把若干子类差值四舍五入成不同数字。本文以正式表格为准。
十一、效率分析:TSM 更快召回,但总 Token 不是最低
Method ACC Summary In Summary Out Update In Update Out Total(k) P50/P95(s) A-MEM 62.60 214.66 42.82 1157.52 190.81 1605.81 5.12 / 11.89 Mem0 53.61 424.13 17.76 150.56 1152.62 1745.07 3.64 / 6.11 MemoryOS 44.80 2302.35 304.18 350.02 35.19 2991.74 1.63 / 3.95 TSM 74.80 1430.71 22.09 609.09 3.65 2065.54 1.57 / 2.39 TSM Sleep-Time − 1334.06 12.72 − − 1959.53 − \begin{array}{l|c|rrrrr|c} \hline \text{Method} & \text{ACC} & \text{Summary In} & \text{Summary Out} & \text{Update In} & \text{Update Out} & \text{Total(k)} & \text{P50/P95(s)}\\ \hline \text{A-MEM} & 62.60 & 214.66 & 42.82 & 1157.52 & 190.81 & 1605.81 & 5.12/11.89\\ \text{Mem0} & 53.61 & 424.13 & 17.76 & 150.56 & 1152.62 & 1745.07 & 3.64/6.11\\ \text{MemoryOS} & 44.80 & 2302.35 & 304.18 & 350.02 & 35.19 & 2991.74 & 1.63/3.95\\ \mathbf{\text{TSM}} & \mathbf{74.80} & 1430.71 & 22.09 & 609.09 & 3.65 & 2065.54 & \mathbf{1.57/2.39}\\ \text{TSM Sleep-Time} & - & 1334.06 & 12.72 & - & - & 1959.53 & -\\ \hline \end{array} MethodA-MEMMem0MemoryOSTSMTSM Sleep-TimeACC62.6053.6144.8074.80−Summary In214.66424.132302.351430.711334.06Summary Out42.8217.76304.1822.0912.72Update In1157.52150.56350.02609.09−Update Out190.811152.6235.193.65−Total(k)1605.811745.072991.742065.541959.53P50/P95(s)5.12/11.893.64/6.111.63/3.951.57/2.39−
Table 4:LONGMEMEVAL_S 效率比较。 TSM 召回延迟最低,但总 token 高于 A-MEM 和 Mem0;sleep-time update 可进一步减少构建成本。
TSM 的 recall P50/P95 是 1.57/2.39 秒,为表中最快。这来自把 LLM extraction、graph construction 与 summary generation 前移到 update 阶段:查询时只做时间解析、图过滤和局部 reranking。
然而 TSM 总 token 为 2,065.54K,高于 A-MEM 的 1,605.81K 与 Mem0 的 1,745.07K。它不是最省 token 的系统,而是用更高写入成本换更快读取和更高准确率。
Sleep-Time Update 将 total token 降至 1,959.53K,减少约 5.1%,但表中没有报告该变体的 Accuracy 和在线 latency。因此不能直接断言节省成本完全不影响效果。
十二、Embedding 敏感性与案例分析
1. Embedding 模型会影响效果
Embedding ACC Temporal Multi-Hop Open-Domain Single-Hop text-embedding-v4 73.01 68.51 60.80 59.55 80.37 text-embedding-3-small 76.69 71.03 66.67 58.33 84.30 \begin{array}{l|c|cccc} \hline \text{Embedding} & \text{ACC} & \text{Temporal} & \text{Multi-Hop} & \text{Open-Domain} & \text{Single-Hop}\\ \hline \text{text-embedding-v4} & 73.01 & 68.51 & 60.80 & \mathbf{59.55} & 80.37\\ \text{text-embedding-3-small} & \mathbf{76.69} & \mathbf{71.03} & \mathbf{66.67} & 58.33 & \mathbf{84.30}\\ \hline \end{array} Embeddingtext-embedding-v4text-embedding-3-smallACC73.0176.69Temporal68.5171.03Multi-Hop60.8066.67Open-Domain59.5558.33Single-Hop80.3784.30
Table 5:LOCOMO 上的 Embedding 模型比较。 OpenAI embedding 整体更强,但 Qwen embedding 在 Open-Domain 上略高。
这说明 TSM 的收益仍依赖第一阶段 semantic recall。时间过滤只能在候选集中重排,无法找回从 Top-K 就完全漏掉的记忆。
2. Case Study:last weekend 如何被解析
Figure 3 展示一个完整样例。用户在 2023-05-30 问:"我上周末试了哪种鸡尾酒配方?"系统将 last weekend 解析为 2023-05-22 至 2023-05-28,然后从 TKG 找到时间有效 facts,再提升对应 chat turns 的排序。
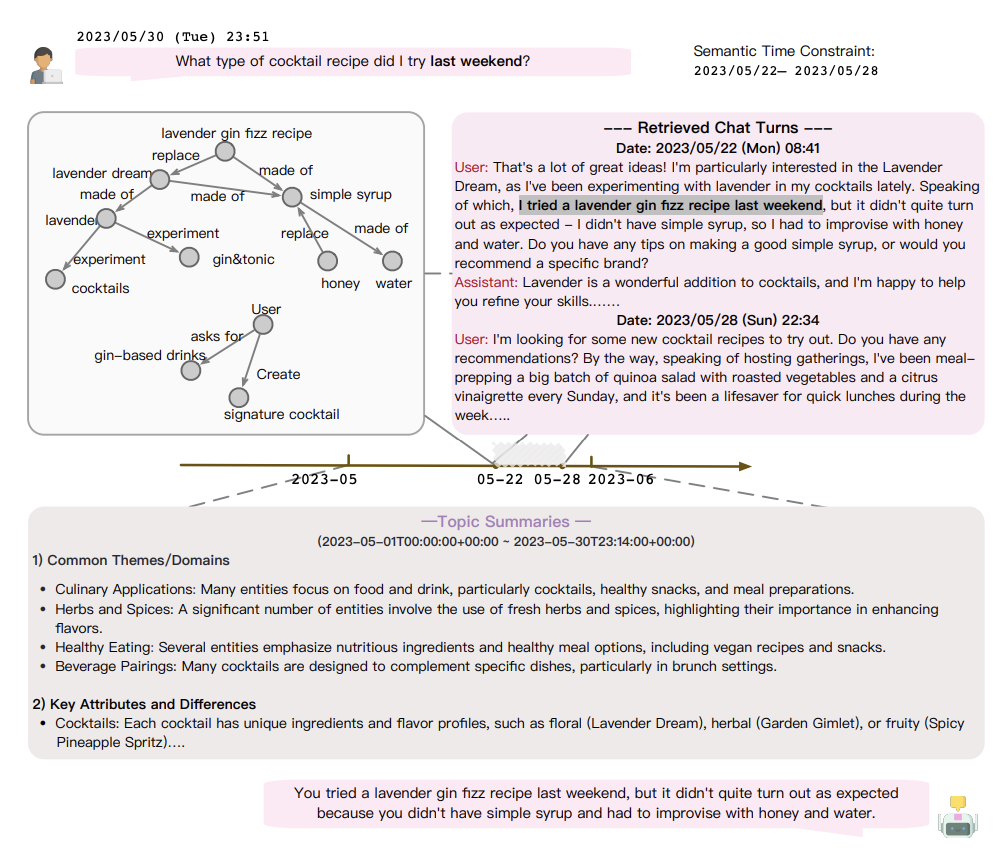
Figure 3:TSM 时间约束检索案例。 系统用"last weekend"的 semantic-time 范围定位相关对话,并回答 lavender gin fizz recipe。
案例还暴露了 TKG 的边界:图中能找到 lavender、gin、honey、simple syrup 等关系,却没有一条 fact 能独立组成完整回答。最终仍需要原始 chat turn 中"缺少 simple syrup,因此用 honey and water 替代"的叙述。
这再次说明 TKG 在 TSM 中是时间索引与证据导航层,而不是完整 memory content。
十三、与 Agent Memory 系列方法的横向比较
| 方法 | 主要组织轴 | 主要记忆单位 | 与 TSM 的关键差异 |
|---|---|---|---|
| Mem0 | 显著性与事实更新 | 提取后的 facts | TSM 将 fact 放到 semantic time,并进一步构建持续 topic/persona |
| A-MEM | 语义关联与自主演化 | 可链接的 memory notes | A-MEM 重点是 note 网络如何生长;TSM 重点是时间归属与时段抽象 |
| MAGMA | 多关系视图 | 多图或多维关系结构 | MAGMA 解决从多种关系组织记忆;TSM 将 semantic time 提升为主索引轴 |
| CoM | 上下文压缩与组织 | 压缩后的上下文记忆 | TSM 的摘要具有明确时间片,并由 TKG facts 约束其有效时间 |
| ReMemR1 | 写入时回访历史 | 可重访的历史记忆 | ReMemR1 缓解一次性写入的信息损失;TSM 解决记忆应归属哪个事件时间 |
| Mem²Evolve | 持续演进 | 随经验更新的记忆 | Mem²Evolve 关注内容或策略如何演化;TSM 显式维护 valid/invalid time 与周期性 consolidation |
| SEEM | 事件结构与 provenance | EEF、facts、raw passages | SEEM 从碎片事实恢复完整事件;TSM 从离散事件形成时间持续状态,并用 query time 约束 retrieval |
| TSM | Semantic timeline | TKG facts + topic/persona + raw turns | 核心是"事件时间校正---持续记忆形成---时间优先检索" |
SEEM 与 TSM 尤其互补。SEEM 的 provenance expansion 解决"命中一个事件片段后如何找回完整经历";TSM 解决"这些经历应该位于哪一时间段、怎样形成持续状态"。将 EEF 作为 TSM 的 episodic unit,再对 EEF 做跨月 consolidation,是一个自然的组合方向。
十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下是根据论文机制做出的工程推演,并非原论文已经验证的结果。
1. Coding Agent:区分"记录时间"与"代码有效时间"
开发对话中也存在两种时间:
- 用户何时告诉 Agent 某个架构决策;
- 该决策在哪个 commit、release 或 branch 范围内有效。
例如用户今天说"从 v2.3 开始不再使用 Redis",事实的 semantic time 应挂在 v2.3,而不是今天。Coding Agent 可以把 commit range 当作 v a l i d _ t i m e / i n v a l i d _ t i m e valid\_time/invalid\_time valid_time/invalid_time,防止旧方案污染当前实现。
Durative Memory 则可以从多次修改中总结"这个仓库长期采用事件驱动架构""测试通常使用 fake clock"等稳定工程模式。
2. Tool Agent:让工具结果带业务有效期
Tool Agent 调用天气、库存、日历或权限 API 时,response timestamp 不等于事实有效时间。一个航班信息可能描述明天,一份证书可能在下月到期。将业务有效期写入 memory,可避免后续只按调用时间检索过期结果。
3. Multi-Agent:共享记忆需要 temporal validity
多个 Agent 共享任务状态时,计划、分工和资源锁会不断变化。若只保留最新摘要,难以追溯变更;若只追加日志,又会积累冲突状态。TSM 式 valid/invalid interval 可以表达"Agent A 在阶段一负责检索,阶段二已移交 Agent B"。
但共享 persona 必须谨慎。对单用户有用的长期画像,在团队场景中可能把某个 Agent 的局部行为误归纳为全局规则。
十五、局限性与证据边界
1. 固定月粒度过于刚性
论文默认一个月作为 temporal slice。旅行可能持续三天,职业阶段可能持续数年。固定粒度会把跨月事件拆开,也会把月内不相关状态混在一起。作者将 adaptive granularity 留作未来工作。
2. 时间解析仍可能成为单点故障
ParseTime 依赖 spaCy。口语化表达、时区、节假日、文化差异和模糊描述都可能解析失败。"前阵子""项目上线后第二周""春节前"不一定能稳定映射为 T q T_q Tq。
由于 TSM 采用时间优先的词典序排序,一旦 T q T_q Tq 错误,错误时间约束可能比普通向量检索造成更严重的漏召回。
3. Durative Summary 会引入过度概括
Persona 是 LLM 对一个时间片内对话的归纳。偶然行为可能被总结成稳定偏好,多个独立主题也可能因聚类错误而合并。消融中去掉 summary 后若干事实类别反而提高,已经显示这种 distraction。
4. LoCoMo 分类结果并非全面占优
TSM 在 GPT-4o-mini 上的 Multi-Hop 与 Open-Domain 明显落后其他 baselines;在 Qwen3 上整体还落后 Full Text。这说明它更像 temporal/personalized memory 专项优化,而不是所有长上下文任务的通用最优方案。
5. 实验只跑一次
论文附录明确写明受计算资源限制,所有实验采用 fixed setting 的 single run。再加上 GPT-4.1-mini judge,表中几分的差距不一定具有统计显著性,特别是只有 30 个样本的 Preference 类别。
6. 未验证百万 Token 长历史
作者选择约 115K tokens 的 LONGMEMEVAL_S,而没有测试约 1.5M tokens 的 LONGMEMEVAL_M。Graph size、cluster stability、summary drift 与 update cost 在更长时间跨度下是否仍可控,仍未得到验证。
7. 隐私、遗忘与摘要删除未展开
用户删除一条原始对话后,相应 TKG edge、topic 和 persona 都需要重算。否则高层摘要仍可能保留已删除信息。论文没有讨论可验证删除、访问控制和 provenance audit。
8. 主要局限于个性化事实记忆
作者明确指出,本文关注 personalization。Procedural Memory、Agent learning experience 与 Multi-Agent shared memory 尚未验证。
十六、我的理解与启发
1. TSM 的本质是把 Time 从 metadata 提升为 retrieval key
许多系统已经保存 timestamp,但时间通常只是展示字段或 recency feature。TSM 真正有价值的变化,是让时间进入三个关键决策:
- 事实写到哪个位置;
- 哪些事实可以被聚合;
- 哪些候选有资格优先返回。
只有时间同时贯穿 construction、consolidation 和 utilization,semantic timeline 才不是一个附加标签。
2. Durative Memory 补上了"事实"和"人格"之间的中间层
单个事实太细,全局 persona 又太粗。TSM 的 monthly topic/persona 提供了一个带时间边界的中间层:用户可能在 5 月热衷鸡尾酒,但不能因此永久标记为鸡尾酒爱好者。
这种 time-bounded persona 比永久 user profile 更符合真实的人类变化。
3. 时间应该是多尺度的,而不是单一月份
我的理解是,TSM 下一步最重要的扩展不是更换聚类模型,而是建立多尺度时间结构:日、周、月、季度与事件自适应区间并存。查询"上周末"走日/周粒度,"过去几年我的工作变化"走年级粒度。
这可以把固定 GMM slice 改成 query-adaptive temporal pyramid,避免提前选定一个永远正确的粒度。
4. Retrieval Router 比全量 Temporal Filtering 更合理
LoCoMo 的反例说明,并非所有 query 都应先按时间过滤。可以先判断问题类型:
- 显式或隐式时间问题:启用 semantic-time constraint;
- 当前事实与知识更新:查询最新 valid interval;
- open-domain:弱化时间,优先语义或外部知识;
- 多跳跨时段:允许多个时间窗口并集。
这样的 router 可能同时保留 TSM 在 temporal task 的优势,并减少 open-domain 和 multi-hop 退化。
5. 记忆更新需要同时支持"失效"与"修订"
TSM 已经通过 invalid_time 表达事实失效,这是比只做 ADD/UPDATE 更成熟的一步。但实际系统还要区分:
- 事实过去为真、现在不再为真;
- 旧记忆从一开始就是错的;
- 两条事实适用于不同上下文;
- 用户要求删除而非修订。
它们对应不同的历史保留与摘要重算策略,不能统一当作 INVALIDATE。
十七、总结
TSM 针对 Agent Memory 的两个时间问题提出了完整方案:
- 用 semantic time 修正 dialogue time 带来的时间错位;
- 用 TKG 保存带有效时间的 episodic facts;
- 按时间片与语义簇构造 topic/persona durative memory;
- 解析查询的 temporal intent,并让时间有效性优先于语义相似度;
- 在线更新图事实,sleep-time 重建高层摘要。
在 LONGMEMEVAL_S 上,TSM 使用 GPT-4o-mini 获得 74.80% overall accuracy,相比 A-MEM 提升 12.20 个百分点;Temporal 和 Multi-Session 分别提升 22.56 与 20.30 个百分点。它同时取得 1.57/2.39 秒的最低 P50/P95 recall latency,但总 token 并非最低。
实验也给出清晰边界:短历史下 Full Text 可能更强,Open-Domain 和 Multi-Hop 并不稳定受益,固定月粒度与单次实验限制了结论强度,Persona Summary 还可能带来干扰。
一句话总结:
TSM 的关键贡献,是让 Agent 不再只记得"什么时候聊过",而是能够按照"事情何时发生、持续多久、何时失效"来构建和检索长期记忆。
参考资料
- Miao Su et al. Beyond Dialogue Time: Temporal Semantic Memory for Personalized LLM Agents. Findings of ACL 2026. https://aclanthology.org/2026.findings-acl.1496/
- Di Wu et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR 2025. https://arxiv.org/abs/2410.10813
- Adyasha Maharana et al. Evaluating Very Long-Term Conversational Memory of LLM Agents. ACL 2024. https://aclanthology.org/2024.acl-long.747/
- Preston Rasmussen et al. Zep: A Temporal Knowledge Graph Architecture for Agent Memory. https://arxiv.org/abs/2501.13956
- Wujiang Xu et al. A-MEM: Agentic Memory for LLM Agents. https://arxiv.org/abs/2502.12110
- Prateek Chhikara et al. Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. https://arxiv.org/abs/2504.19413