为什么一般1只需要检测读缓冲区有没有数据:
读缓冲区有数据:有连接请求/有数据发送
写缓冲区有数据:只说明读缓冲区有空可写,触发可写,并不是说明数据发送出去了
边沿非阻塞效率最高
边沿:只通知一次
非阻塞:尽量一次就把数据读完
边沿触发只在状态发生变化时通知一次,可以减少 epoll 的重复通知和线程唤醒;配合非阻塞 I/O,可以在一次事件到来后循环读取或写入数据,直到返回 EAGAIN,再处理其他事件。这样能够减少系统调用和无效等待,更适合高并发服务器。
关于paraserequestline 文件路劲转换解释:(联系main文件路径转换)
- 你新建一个文件夹,比如名字叫
webroot - 你自己把
1.jpg、index.html、404.html复制放进webroot - 启动服务器:
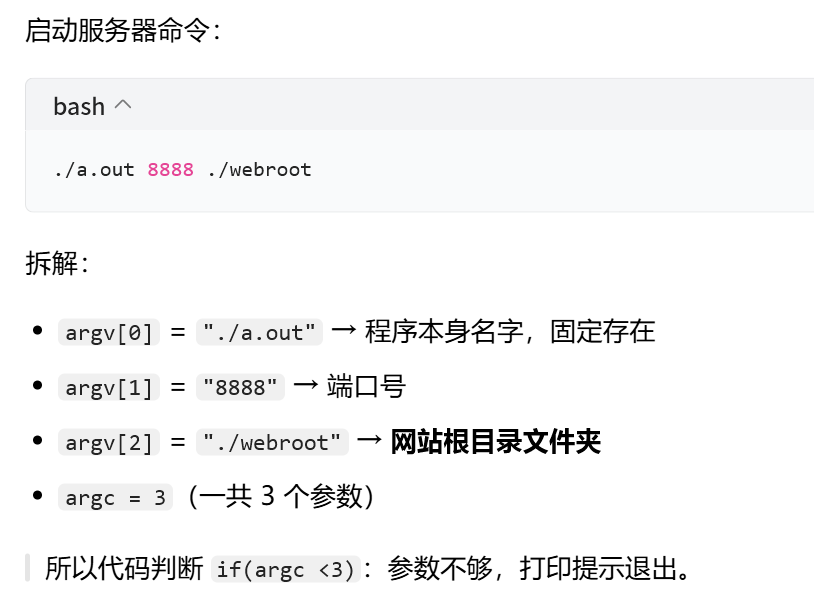
./a.out 8888 ./webrootmain里面chdir("./webroot"),服务器进程的查找起点切换到这个 webroot 文件夹
- 浏览器访问
http://127.0.0.1:8888/1.jpg - 浏览器发请求行
GET /1.jpg HTTP/1.1 - 代码解析拿到
path="/1.jpg",切掉第一个/得到"1.jpg" stat("1.jpg", &st):在当前工作目录 webroot 里面找1.jpg- ✅ 如果你提前放了 1.jpg → 找到,返回图片给浏览器
- ❌ webroot 里面没有 1.jpg → stat 返回 - 1,服务器返回 404 页面
关于read返回0
| fd 类型 | read 返回 0 代表含义 | 业务意义 |
|---|---|---|
| 普通本地文件 fd | 到达文件 EOF,文件所有数据读取完毕 | ✅ 本次读文件任务完成,正常结束 |
| socket 通信 fd | TCP 对端 close,连接断开 | ❌ 不是单条 HTTP 请求读完,是整个连接关闭 |
关于sendfile
零拷贝(zero copy) 传统方式:read把文件读到用户缓冲区 → send再把用户缓冲区数据拷贝到内核 socket 缓冲区
磁盘 → 内核页缓存 → 用户 buf → 内核 socket 缓冲区 → 网卡
sendfile:数据全程不经过用户态,在内核里直接从页缓存拷贝到 socket 缓冲区
磁盘 → 内核页缓存 → 内核 socket 缓冲区 → 网卡 减少一次内核→用户态拷贝,性能更高,文件服务器推荐。
简单http协议知识
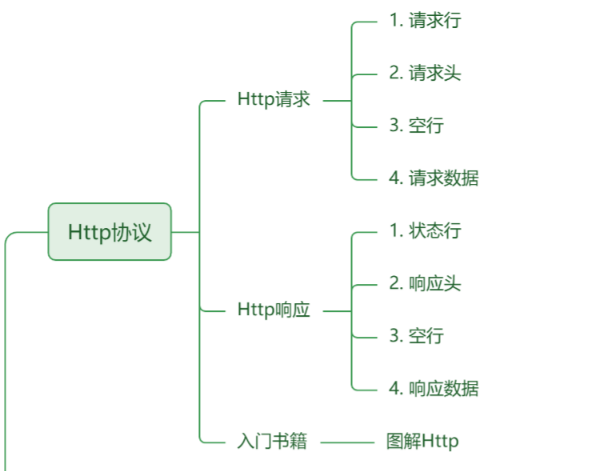
一、HTTP 请求(客户端 → 服务端)
- 请求行 :一行,格式
方法 资源路径 HTTP版本例子:GET /index.html HTTP/1.1包含:请求方法 (GET/POST)、请求的资源、HTTP 版本 - 请求头 :0~ 多行,
键: 值,携带附加信息 例子:Host: 127.0.0.1、User-Agent: xxx - 空行
\r\n:必须要有! 用来分隔请求头 和 请求数据(请求体)。 也就是你代码里要查找的\r\n\r\n,读到这个标记,代表请求头接收完毕。 - 请求数据(请求体) :POST 表单、上传数据;GET 请求没有请求体。
GET 请求完整示例报文
GET /test.html HTTP/1.1\r\n
Host: 127.0.0.1\r\n
User-Agent: curl/7.68.0\r\n
\r\n最后连续\r\n就是空行,后面没有请求数据。
二、HTTP 响应(服务端 → 客户端,你文件服务器要构造这个)
- 状态行 :一行,格式
HTTP版本 状态码 描述例子:HTTP/1.1 200 OK;HTTP/1.1 404 Not Found - 响应头 :0~ 多行,
键: 值,告诉浏览器资源信息 例子:Content-Type: text/html、Content-Length: 1024(文件大小) - 空行
\r\n:分隔响应头 和 响应数据(响应体) - 响应数据(响应体):真正的资源内容,html、图片、文件二进制数据。
就是你用
sendfile发给客户端的文件内容!
200 成功响应示例
HTTP/1.1 200 OK\r\n
Content-Type: text/plain\r\n
Content-Length: 12\r\n
\r\n
hello world!
http在哪里
通信文件描述符对应的缓冲区中,
关于SendDir发送的html网页可点击:
函数功能
功能:当用户请求访问目录时,这个函数自动生成 HTML 页面,列出文件夹内所有文件 / 子目录,带超链接,浏览器点击就能跳转。 头文件提前备好:
- 浏览器访问
/test/→ 服务器调用 sendDir,生成网页,页面里生成<a href="subdir/">subdir</a> - 用户点击这个链接
- 浏览器重新发起 TCP 报文(新的 HTTP 请求) ,请求
/test/subdir/ - 你的
ParesRequestLine解析请求行,拿到路径/test/subdir/ - stat 判断是文件夹 → 再次调用 sendDir,列出 subdir 里面内容,网页刷新,完成跳转
关于在RecieveHttpRequest里面pt - buf 两个指针相减,得到 int(重点)
指针减法规则(C 语言)
只有同一块数组空间、同类型指针 才能相减!
pt和buf都是char*,指向同一个字符数组buf。
int reqLen = pt - buf;buf:数组起始地址pt:\r\n的起始地址- 指针相减的结果 = 地址差 / 指针类型字节大小
char占 1 字节,所以pt - buf的结果,正好等于两个地址之间字符个数。
关于调试时的bug
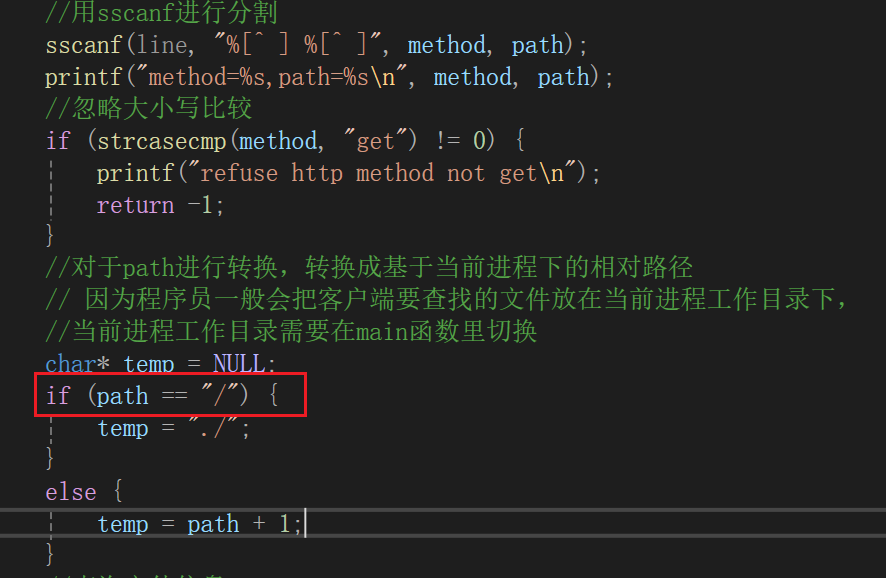
1.开头暴击:段错误,根据输出找到错误原因
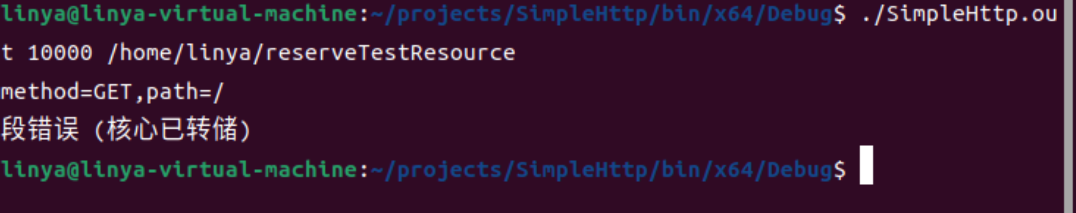
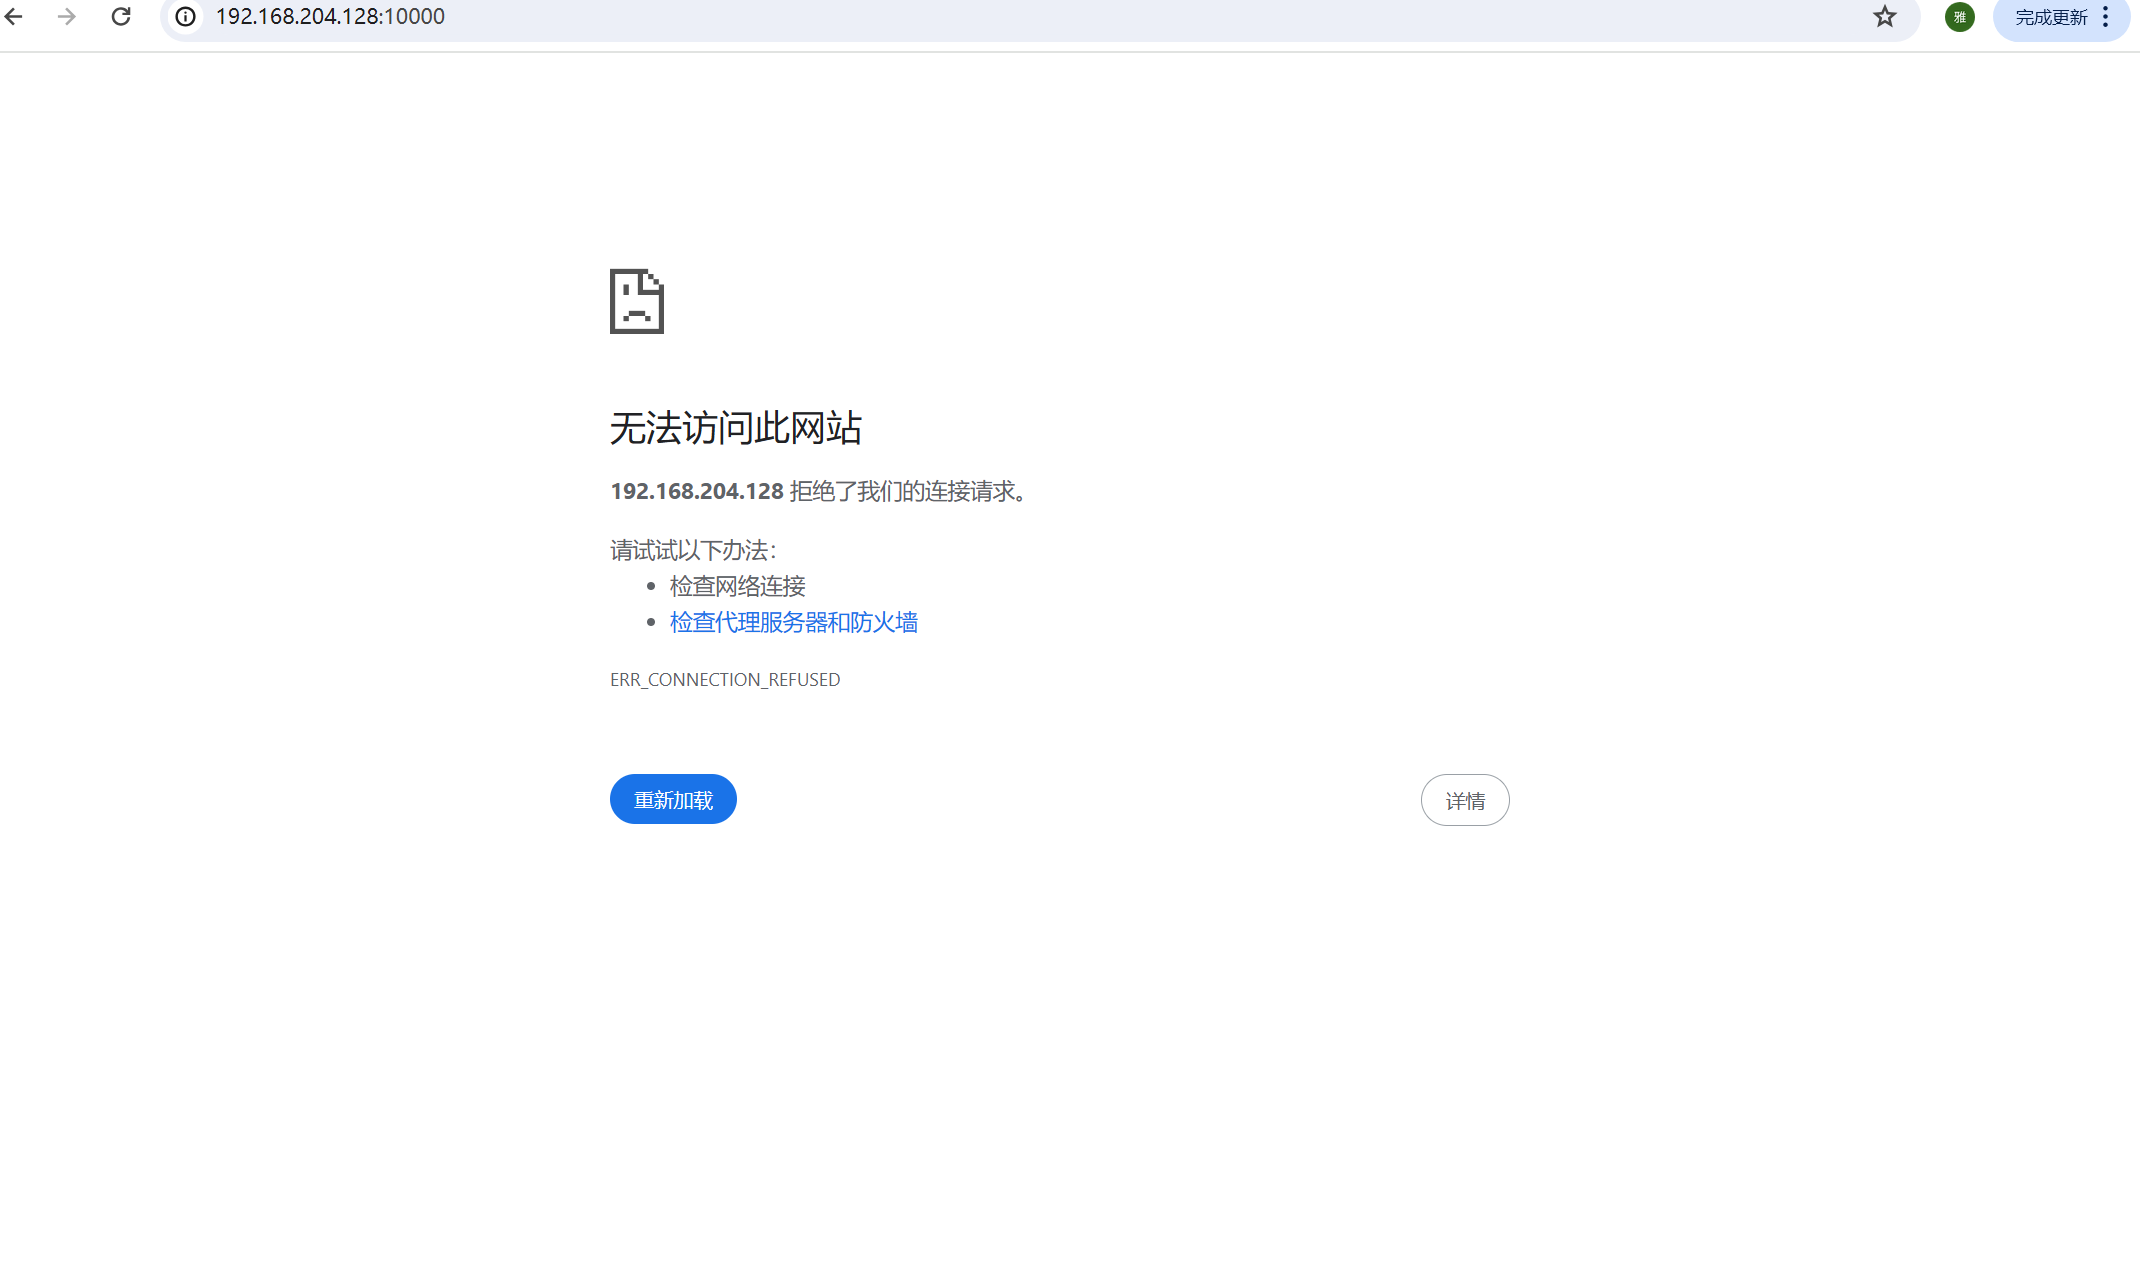
错因:ParesRequestLine里面
path是一个指针,"/" :双引号 → 字符串字面量 ,它不是单纯一个字符,是字符数组,编译器给你返回数组首地址 。"/"={ '/', '\0' },所以在这个if条件里,path指向的内容和"/"一样,但是他们的地址不一样,if条件永远无法成立,并且一旦path指向的内容和"/"一样,执行path+1,temp就是\0后续段错误,所以要用strcmp
bug2:sendfile里面 lseek会把文件描述符的指向,sendfile读的时候就是从文件最末端读,空的
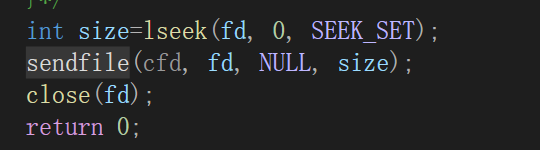
fd 里确实存放着完整文件内容,但 sendfile 不是直接把整个文件 "一次性丢给网卡" ,它受限于TCP 发送缓冲区 的剩余空间。哪怕文件完整,内核 socket 缓冲区装不下这么多字节,sendfile 就只会发送缓冲区能容纳的一部分数据,返回实际发送字节数,同时更新offset。所以必须循环。
关于最后一次的修改
问题 1:TCP 发送缓冲区满 → EAGAIN(大文件特有)
MP4 文件很大,sendfile 一次性推送大量数据。内核 socket 发送缓冲区容量有限,数据来不及发给浏览器,缓冲区很快塞满。
- 旧代码判断写错:遇到
EAGAIN的时候没有做重试逻辑,直接当成错误跳出循环。 - 结果:传输中途直接终止,视频加载卡住。
改完之后:识别
EAGAIN,usleep 短暂休眠,等 TCP 缓冲区被内核发走一部分、腾出空间,再继续 sendfile,大文件可以分段持续传输。
问题 2:客户端中途断连 → SIGPIPE(大文件更容易触发)
MP4 传输时间长,浏览器很可能在传输中途关闭页面 / 断开连接。
- 旧代码没有加 signal (SIGPIPE,SIG_IGN) :一旦继续向断开的 socket 写数据,系统直接抛出 SIGPIPE,直接杀死整个服务器进程。 现象就是网页视频转圈加载不出来,同时终端里程序直接退出。
改完之后:
signal(SIGPIPE,SIG_IGN):不再杀死进程,sendfile 返回-1,errno=EPIPE;- 代码捕获 EPIPE,主动 break 跳出发送循环,安全停止发送,服务器继续运行。
只写不杀死进程,不写遇到EAGAIN的时候没有做重试,视频死活加载不出来(文件太大,缓冲区塞满,直接跳出循环,服务器不发了)
**signal (SIGPIPE,SIG_IGN),并不会让进程直接死,一个文件没加载出来,点击返回,**发起新的 HTTP 请求去请求上一级目录页面,服务器可以正常接收、处理这个新 HTTP 请求