"回答看起来对"并不等于"这次执行是对的"。
做 Agent workflow 时,最容易被忽略的就是这件事。
例如在一个"取消订单"的工作流中,Agent 最后回复了用户"订单已取消"。这句话可能是真的,也可能是模型在工具调用失败后补出来的;它可能绕过了鉴权节点,也可能该进入人工审核时走错了分支。等到改了一段 prompt、换了模型,或者调整了节点配置,问题会变得更拆不清楚:我们究竟是在修复问题,还是在引入另一种退化?
这也正是开源项目 Workrun(一款强调 Local-first 的桌面端 Agent Workflow 自动化工具)在设计 Telemetry(遥测)与 Evaluation(评测)时最想解决的问题。
我没有把它们设计成两套独立的"附加功能":一套用来打日志,另一套用来跑测试。相反,Workrun 先保留一份可回放、经过脱敏的运行事实;本地诊断、成本指标、评测结果和版本比较,都是从这份事实派生出来的。
这篇文章会以一个订单取消 workflow 为例,介绍这套设计是怎样落地的,也会如实说明它目前的工程边界。
问题不只在最终输出
先看一个很典型的工作流:用户请求取消订单,Agent 需要先查询订单、检查权限和风控状态,再决定取消还是转人工审核。
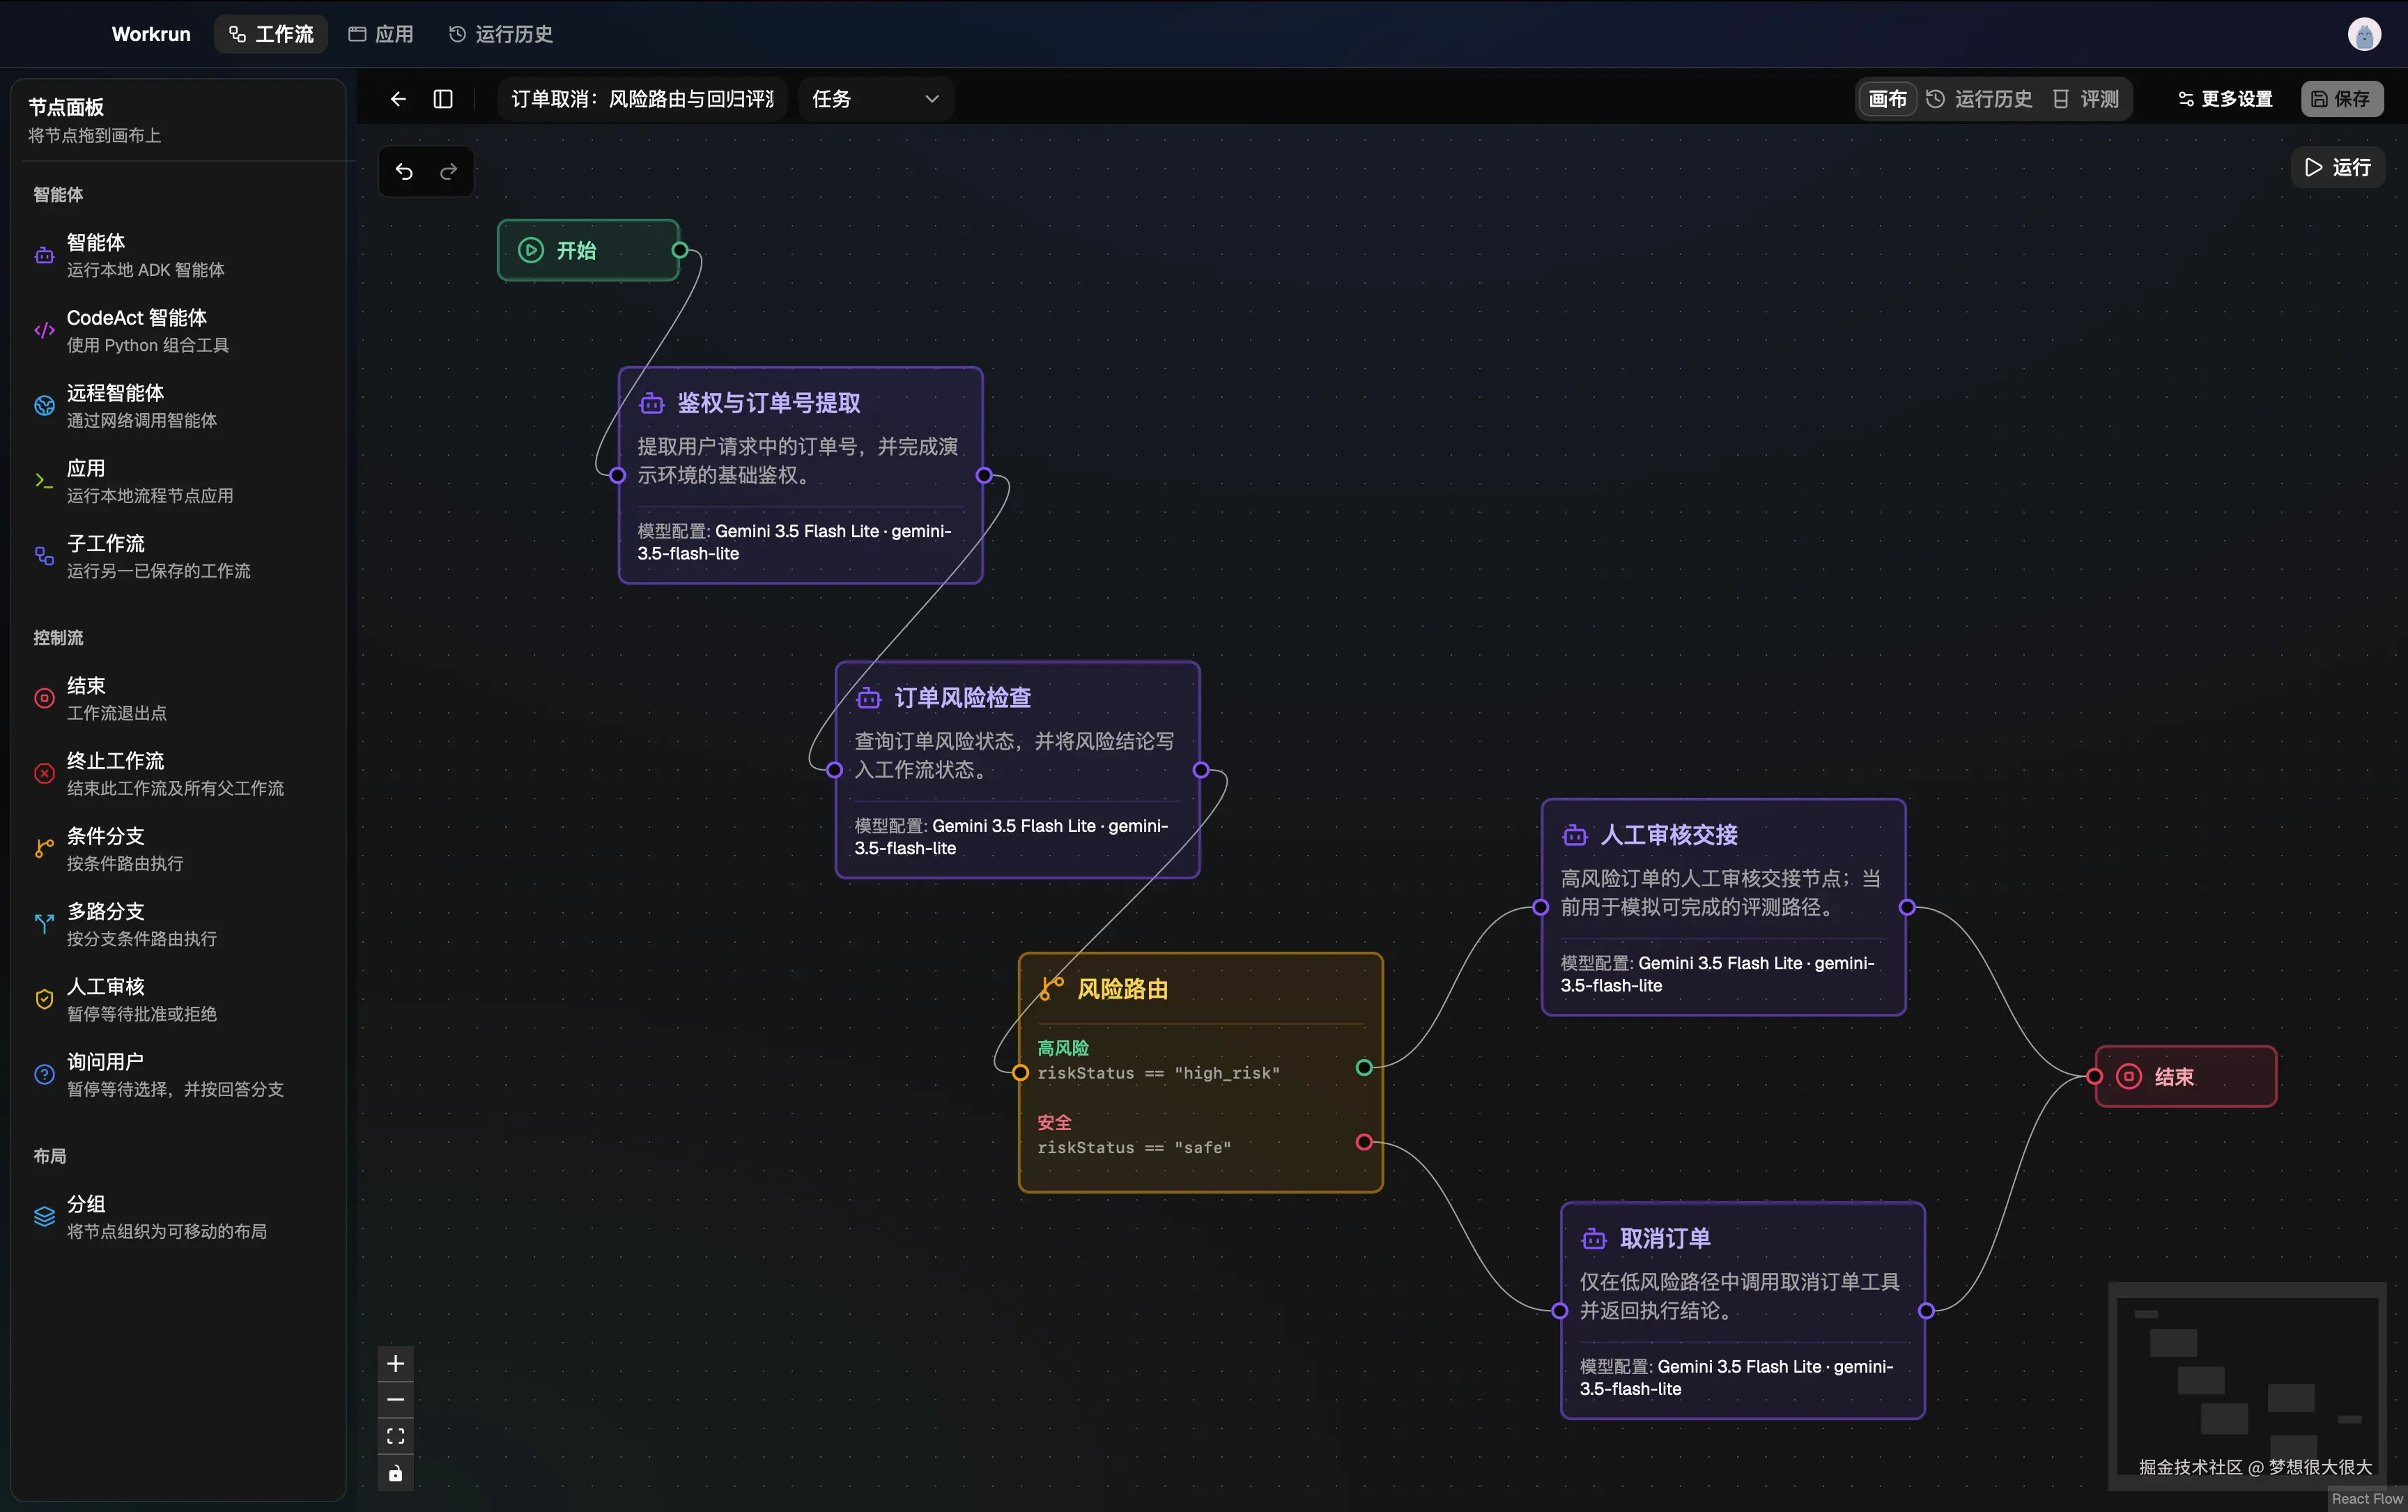
如果只验证最终文本,我们大概会写一个测试:输出中必须包含"订单 42 已取消"。但这远远不够:
lookup_order可能没有成功,模型却凭空猜了一个答案;cancel_order可能根本没被调用,模型只是"伪造"了成功回复;- 风控命中后本应转人工,工作流却依然继续执行了取消;
- 工具结果或最终输出可能带出了敏感字段;
- 新版本看起来还能回答问题,但 token、延迟和错误率已经明显变差。
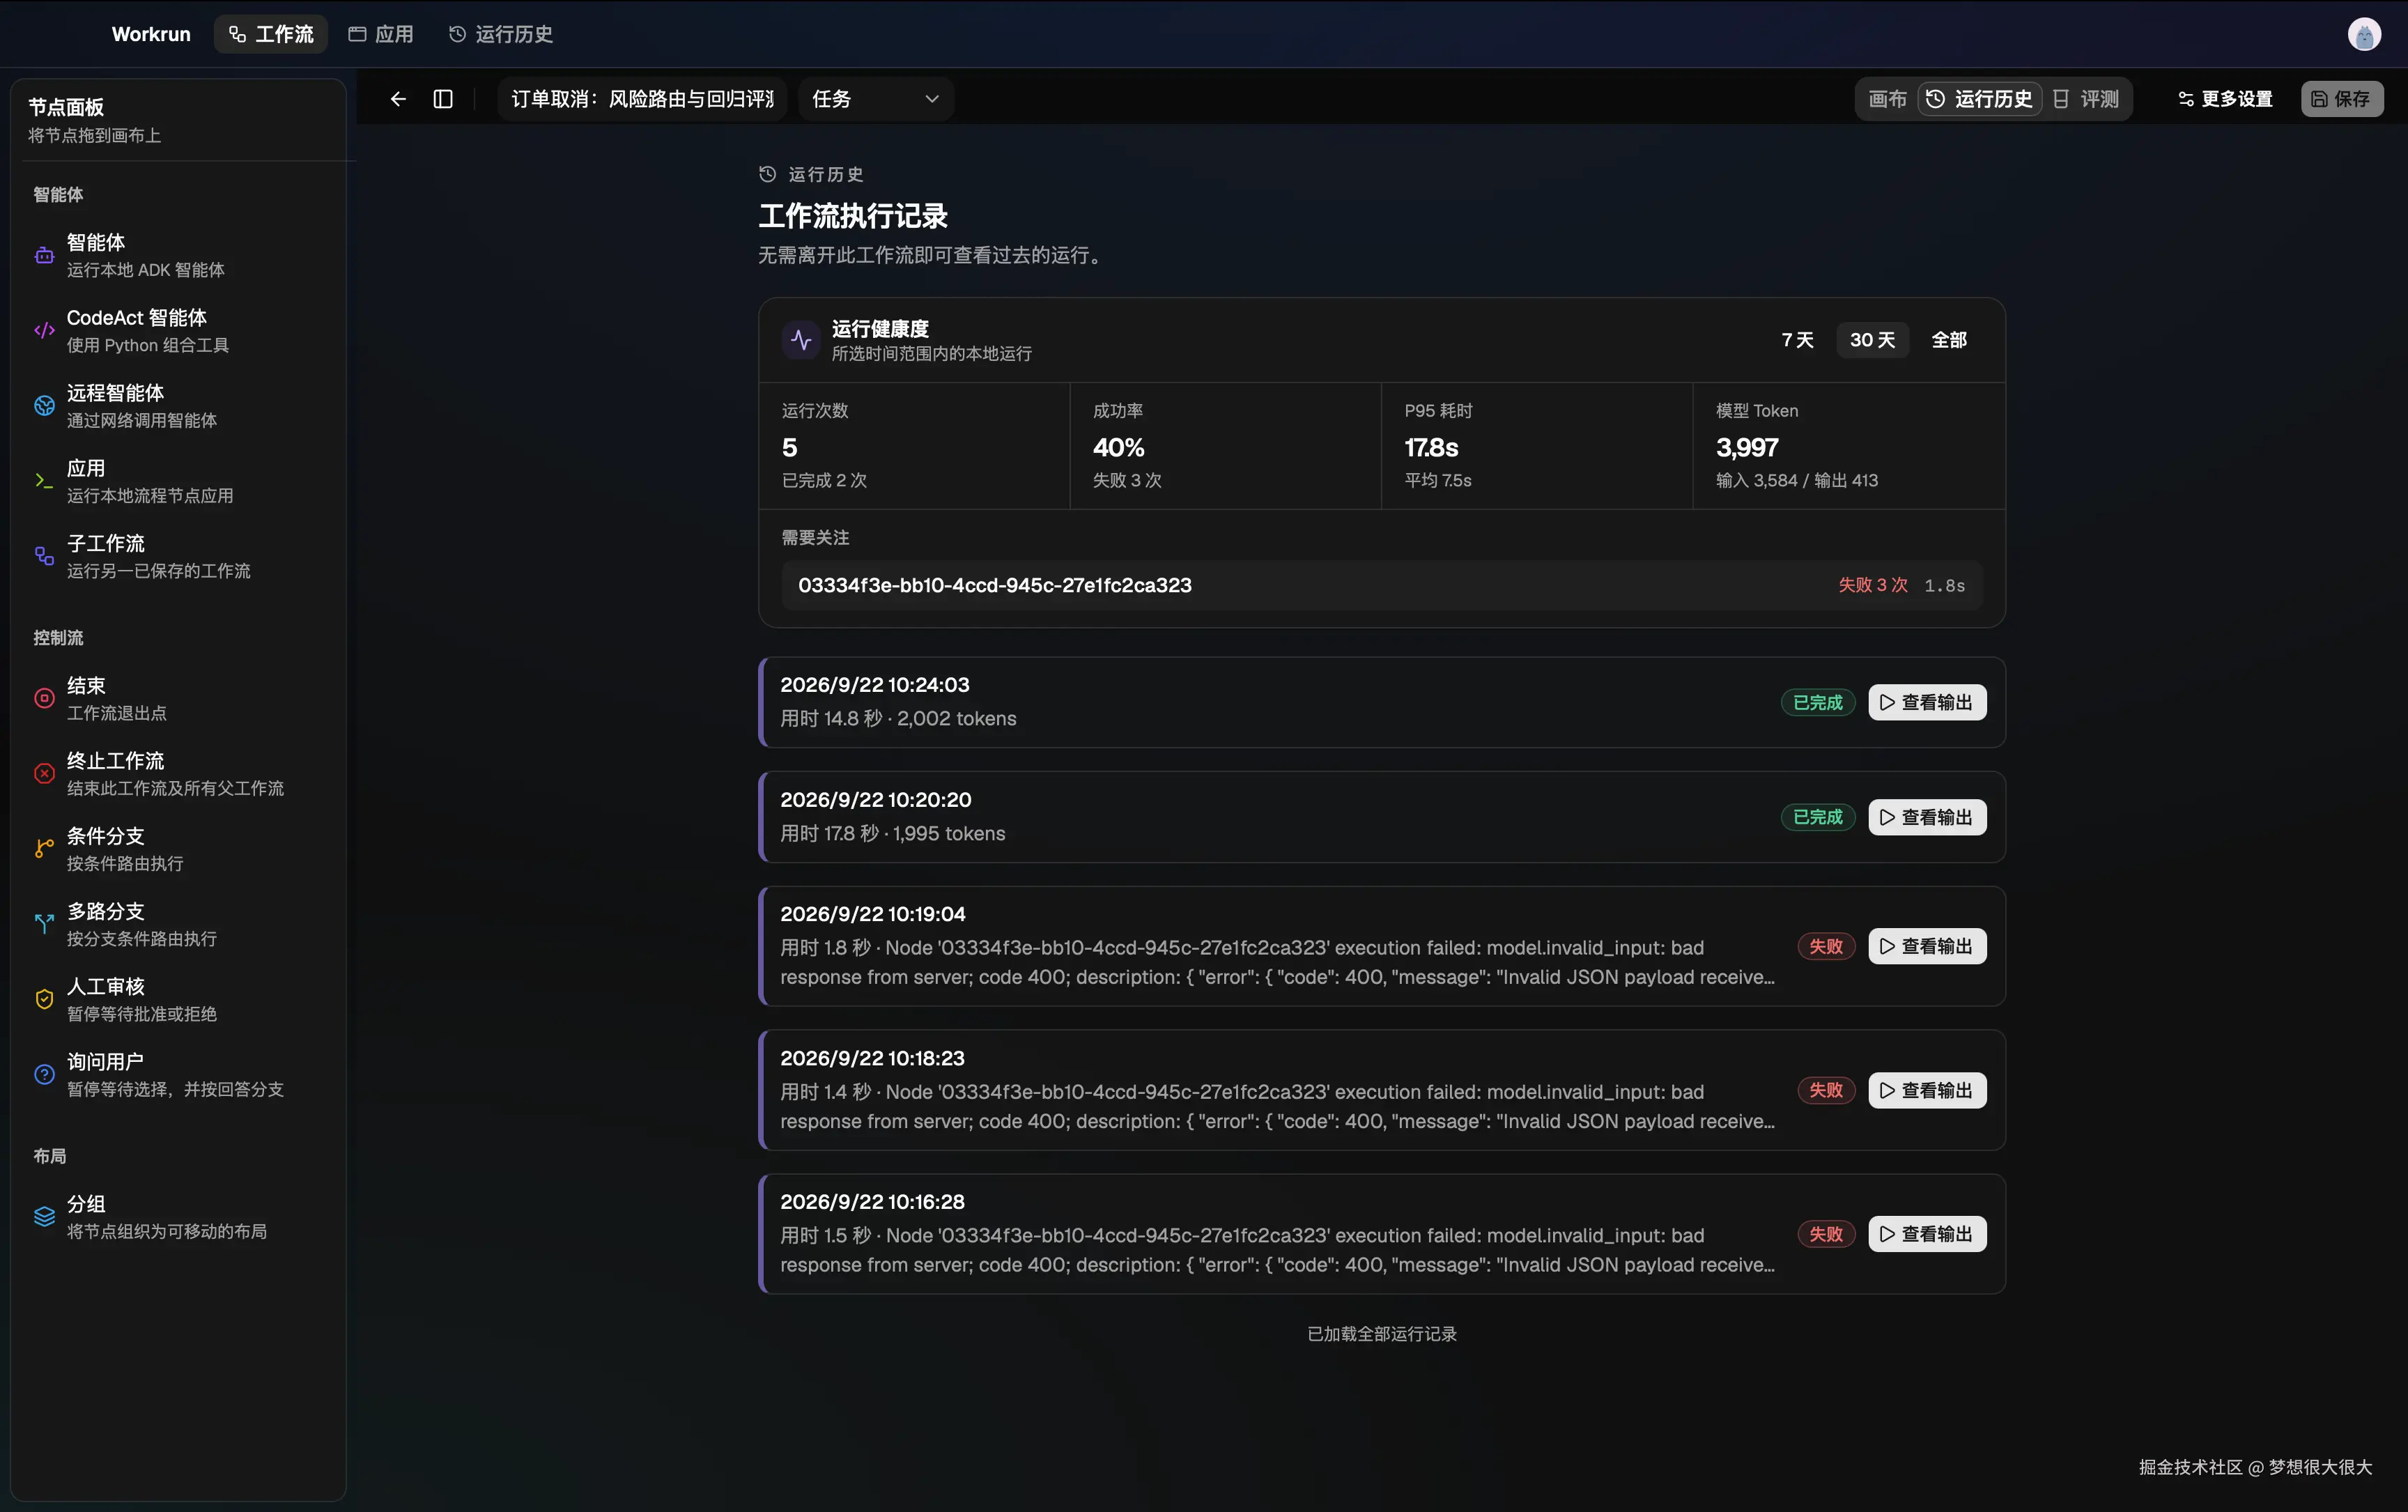
因此,我们希望一次运行结束后至少能回答两类问题:
- 这次运行中发生了什么? 哪个节点、模型调用或工具调用出了问题?(Telemetry 的职责)
- 这次运行的行为是否符合预期? 下一次修改后,是否发生了可识别的回归?(Evaluation 的职责)
前者是 Telemetry 的职责,后者是 Evaluation 的职责。它们的共同基础,是同一份运行证据。
一份运行事实,多个派生视图
Workrun 中,每一次 workflow 或 app 执行都会有一个 Run。运行过程中产生的事件会按顺序持久化到本地 Run History;输出面板、span、聚合指标和评测观察值都不是唯一事实来源,而是围绕事件日志建立的投影。
这个设计看起来朴素,但它带来了两个很重要的工程结果:
- 诊断信息与业务执行解耦:Span 是事件日志的派生投影;即使某次 telemetry 写入失败,Run 本身仍然完好保留,工作流绝不会因为"观测系统挂了"而崩溃。
- 评测不必再造一套平行的执行器:评测系统可以直接读取同一份经过处理的运行证据,评估真实的执行路径,而不是只对一个脱离 runtime 的模拟结果打分。
本地 telemetry:把运行过程变成可查询的数据
Workrun 的本地 telemetry 重点不是堆很多日志,而是把运行中的关键动作投影为可查询的 span。
对于 workflow,当前会记录三类核心 span:
workflow node:节点在哪一步执行、执行了多久、最后是否完成;model call:模型名、输入/输出 token、cache token、reasoning token、audio token、估算成本以及是否 BYOK;tool call:调用了什么工具、耗时多久、成功还是失败。
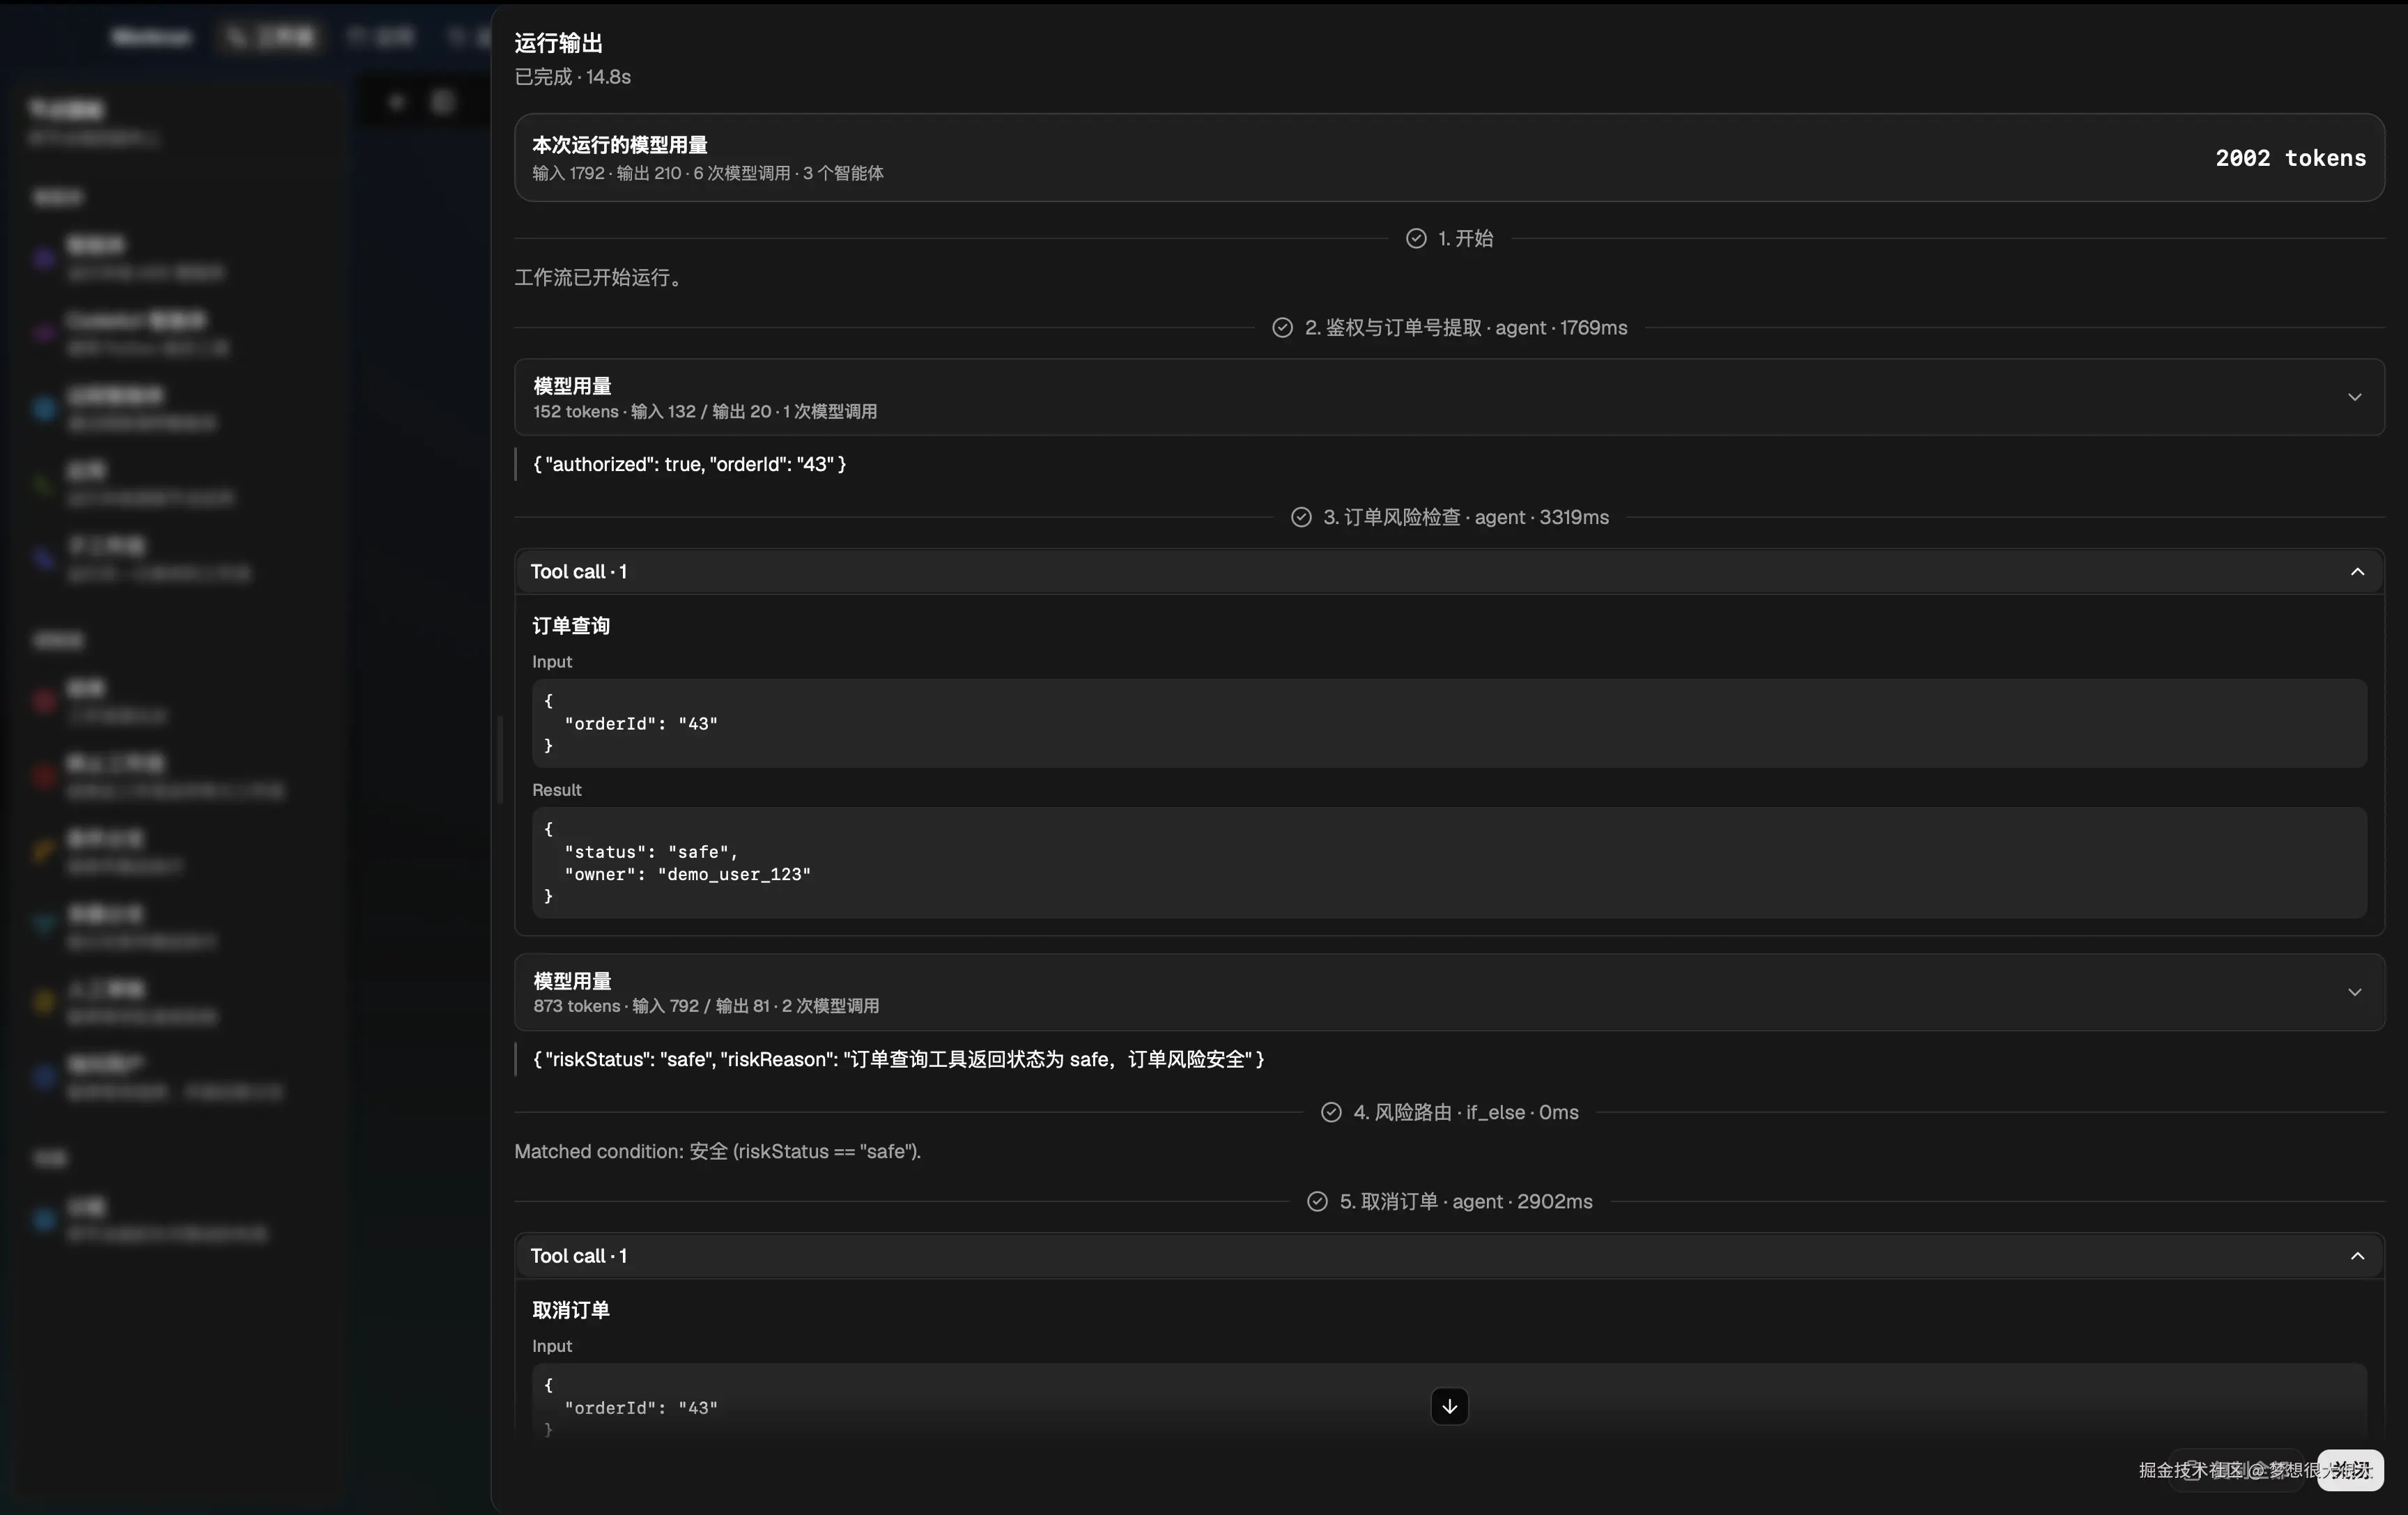
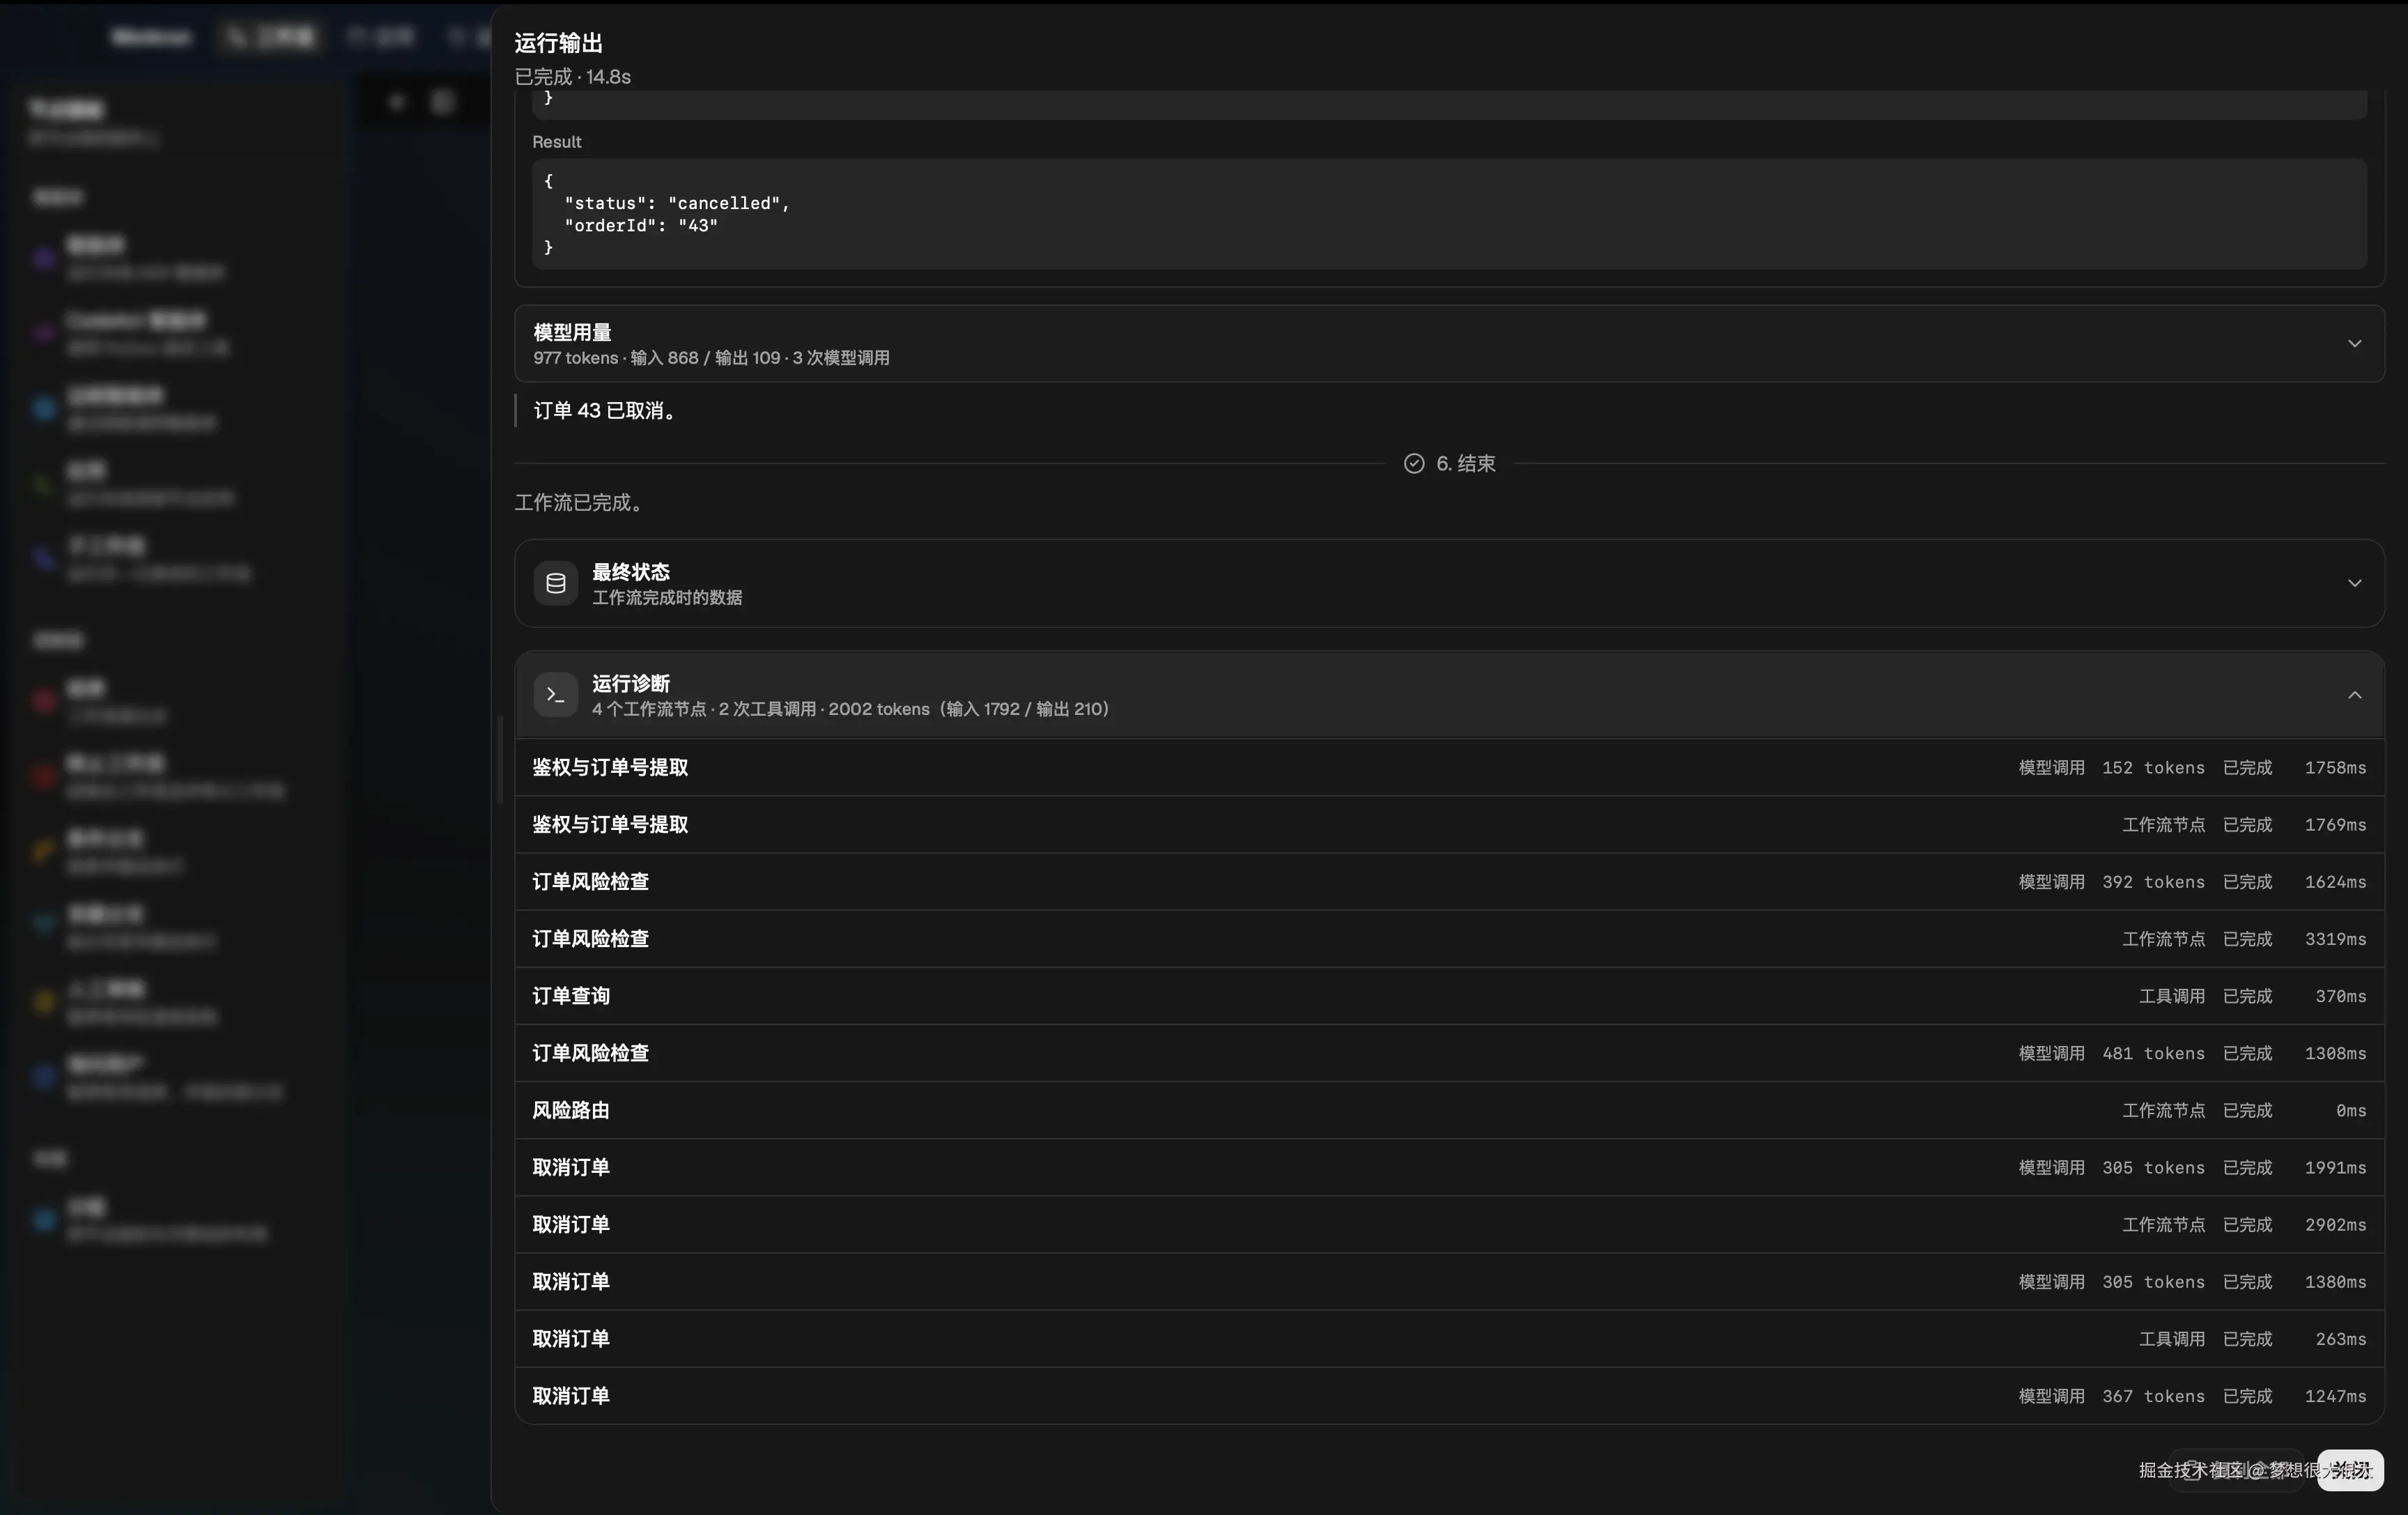
这些 span 都通过 run_id 关联到一条 Run。例如,下面是一条写入 run_events 的脱敏后模型调用事件:
json
{
  "type": "custom",
  "node": "risk_check",
  "event_type": "agent.model_call",
  "data": {
    "modelCallId": "4a563af4-5f36-4b5b-9ac5-2c6372b3164f",
    "model": "gpt-5",
    "startedAt": "2026-09-21T10:30:12Z",
    "endedAt": "2026-09-21T10:30:13Z",
    "durationMs": 842,
    "inputTokens": 320,
    "outputTokens": 45,
    "totalTokens": 365,
    "totalTokensEstimated": false,
    "cacheReadTokens": 128,
    "estimatedCostMicrousd": 730,
    "isByok": true
  }
}
这个事件会被投影为 model_call span;模型调用的内容不需要进入 span 表,查询时仍可在保留期内回到经过脱敏的事件证据。
在聚合层,Workrun 会按 workflow、版本和时间范围计算成功率、平均耗时、p50/p95、token 与估算成本。离线 evaluation 流量会和普通生产运行显式标记区分开,避免批量测试把日常运行指标冲高。
一个容易漏掉的细节:终态 span 收口
正常情况下,节点会收到 node_start → node_end,工具会收到 tool_call → tool_result 或 tool_error,span 会自然结束。
但真实系统里还有另一种情况:运行在节点或工具执行中被取消,或者因为异常提前失败。此时最后的事件未必能送达;如果不处理,本地历史里会留下永远处于 running 的 span。
Workrun 现在会在 Run 进入终态时,在同一个数据库事务 中收口仍处于 running 的 span:
- Run 正常完成时,遗留 span 标记为
completed; - Run 失败时,遗留 span 标记为
failed; - Run 取消或中断时,遗留 span 标记为
cancelled; - 已经有明确结束状态的 span 不会被覆盖。
这不是一个很"炫"的功能,却直接决定了历史数据是否可信。对诊断系统而言,终态一致性比多一个图表更重要。
OTLP:把本地诊断接入标准 tracing 工具
本地 Run History 适合在 Workrun 中快速复盘单次运行;当需要跨运行、跨服务,或者希望接入团队已有的 APM 系统时,Workrun 也支持把 tracing 数据导出到远端 OTLP collector。
项目设置中提供了 OTLP 端点:填入兼容 OTLP/gRPC 的 collector 地址并保存,重启后生效。未配置时,工作流完全在本地高能运行;配置后,Workrun 会将 workflow 和 ADK runtime 的 tracing context 实时导出到远端。
下图来自一条真实的"退款申请" workflow:它先提取结构化信息,随后调用模拟 CRM 查询,再根据工具结果生成 最终 JSON。该次运行在 Jaeger 中持续约 6.5 秒 ,共导出了 25 个 span:
text
workrun.workflow.run [Run ID, Workflow ID, Version, Thread ID]
├── run (Agent Loop 1: 语义解析)
│   └── call_llm
│       └── model.generate_content
│           ├── execute_stream
│           └── gen_ai.generate [Model: gpt-5, Tokens: 320/45]
├── run (Agent Loop 2: 工具调用)
│   ├── call_llm ──► gen_ai.generate
│   └── execute_tool: crm_lookup_user [Duration: 420ms]
└── run (Agent Loop 3: 最终响应生成)
    └── call_llm ──► gen_ai.generate
根 span workrun.workflow.run 附带 Run ID、workflow ID、版本和 thread ID;子 span 则清晰拆解出每轮 Agent 执行、模型请求(含 token 与 provider)和工具调用的耗时。这能一眼看出时间究竟是花在了"模型等待"还是"工具执行"上。
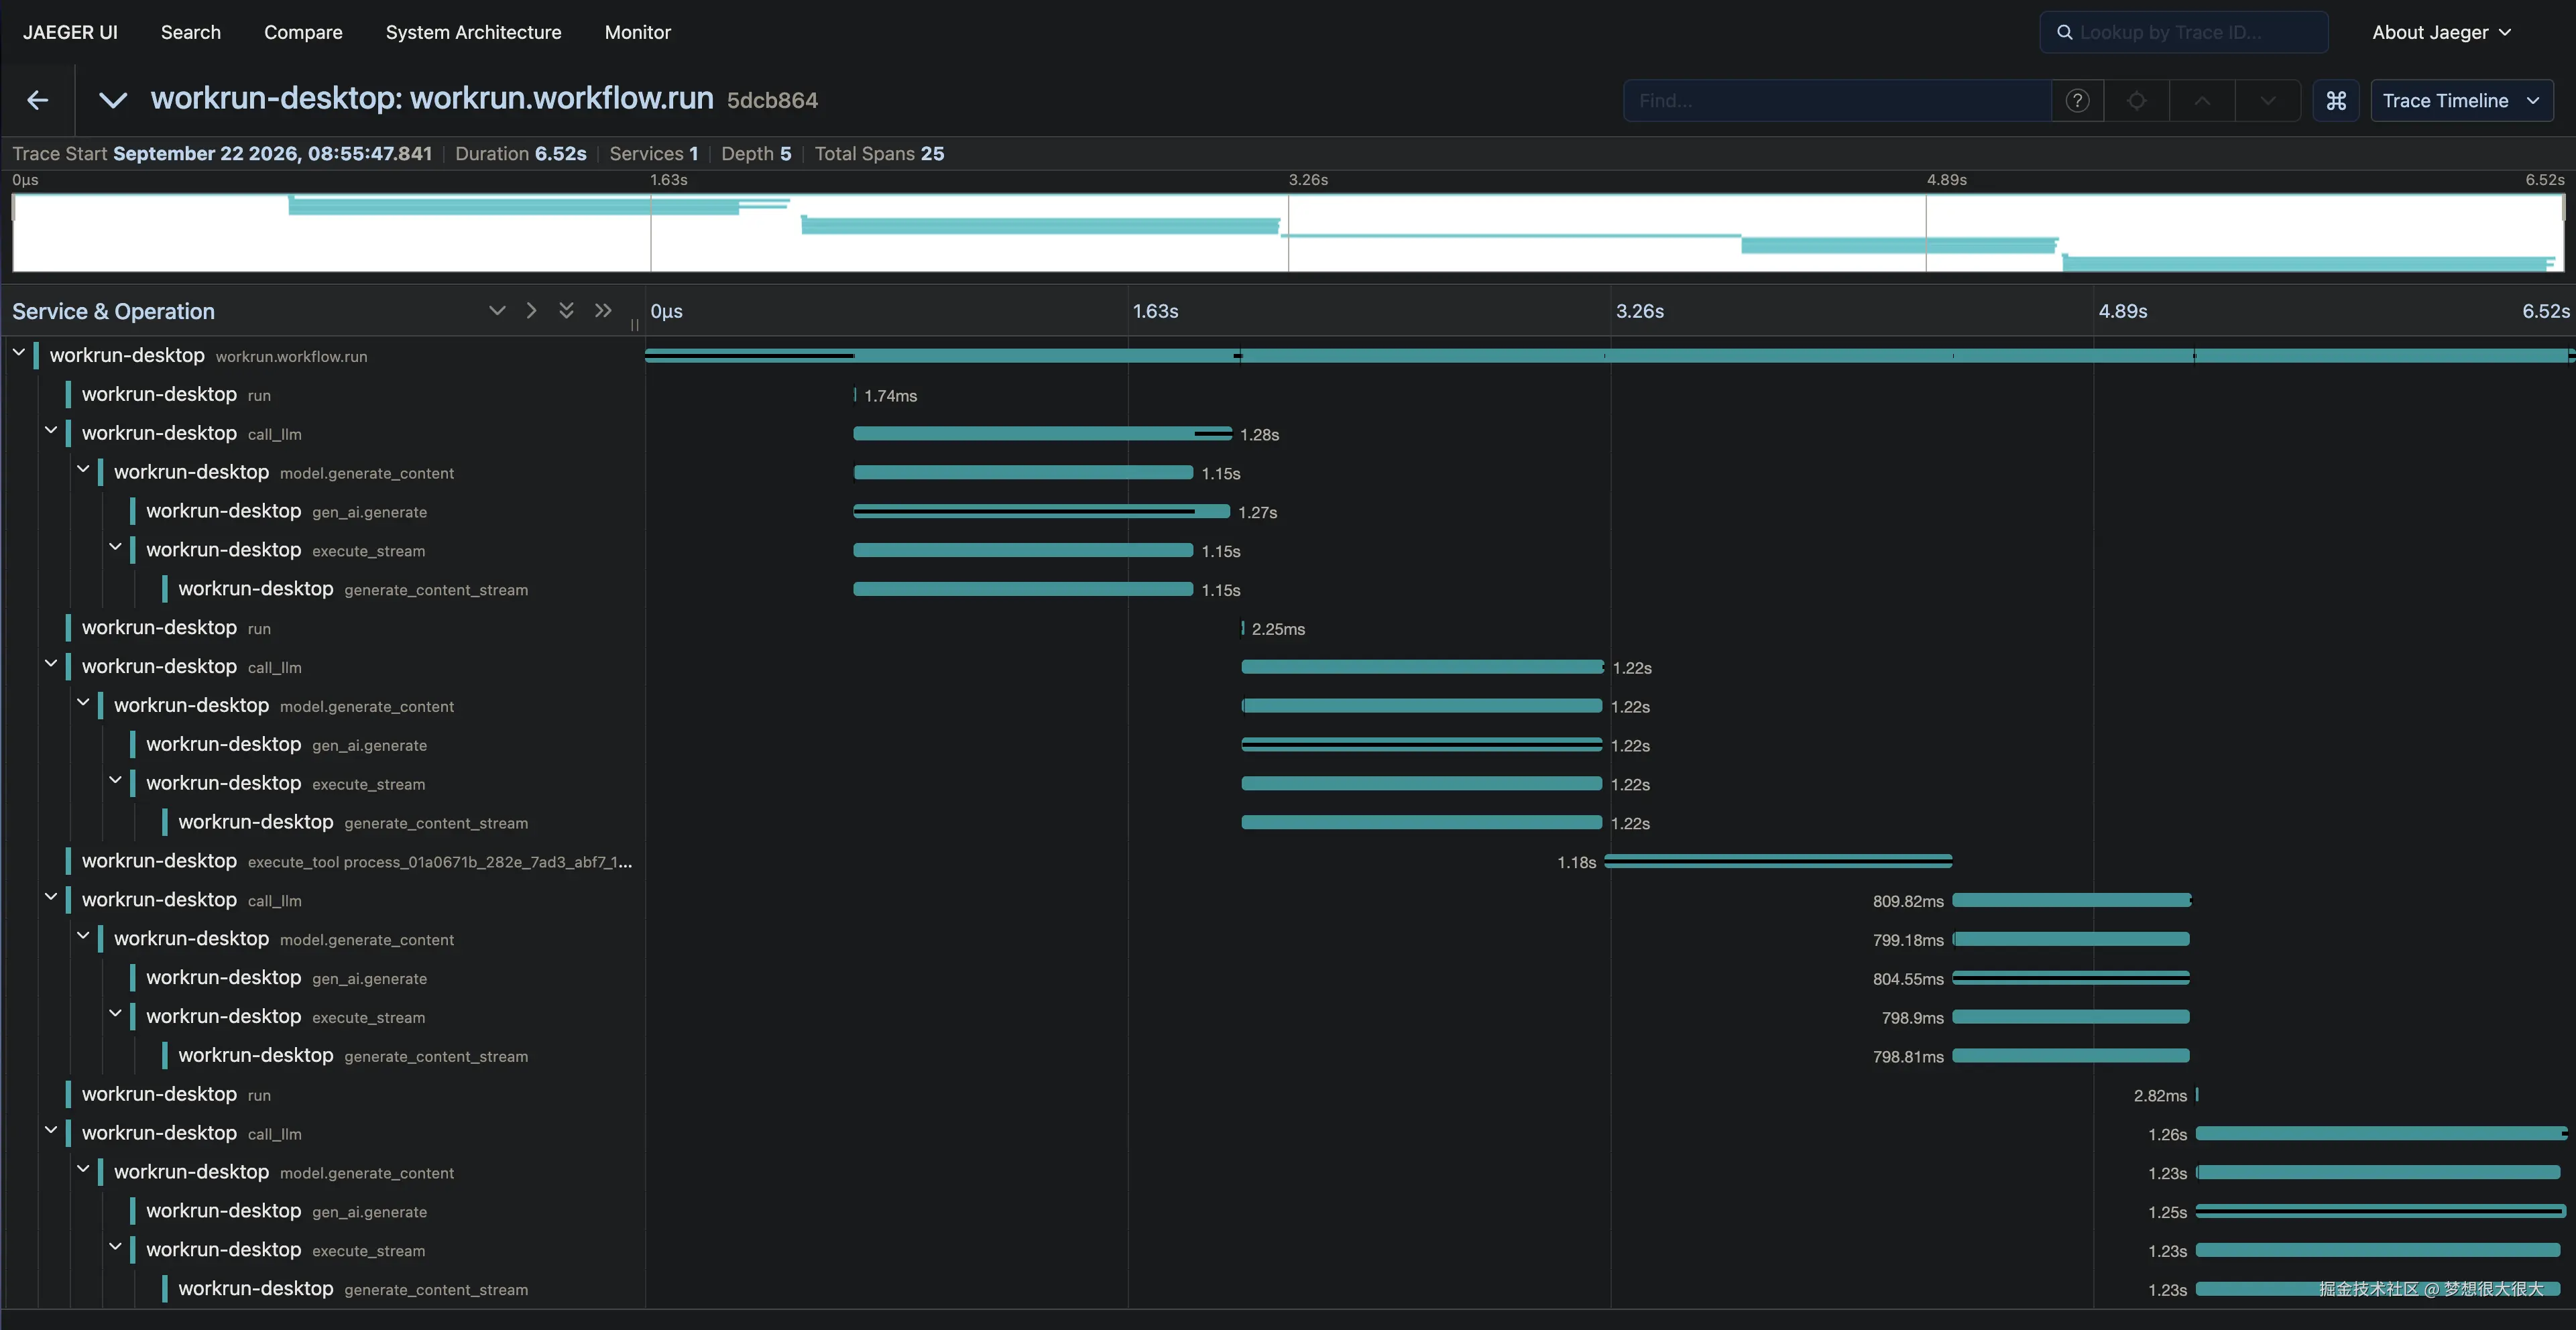
本地 Run History 用于面向作者的执行复盘,OTLP trace 则把同一次运行接入 Jaeger 或 Grafana Tempo。两者共享上下文标识,排查远端异常时,凭 run_id 就能精准锚定本地历史现场。
需要提醒的是,远端 collector 属于本地设备之外的数据系统。虽然 Workrun 会对事件进行脱敏,但 trace 仍包含部分运行元数据,应按照生产级基础设施规范来配置访问控制与保留期。
Evaluation:评估 workflow 行为,而不只评估答案
有了运行证据,下一步才是 Evaluation。
回到取消订单的例子。下面是一个"高风险订单不允许直接取消"的 Case 定义:
json
{
  "id": "cancel-order-with-risk",
  "name": "高风险订单转人工审核",
  "input": { "message": "请取消订单 42" },
  "expectation": {
    "assertions": [
      {
        "kind": "node_trajectory",
        "id": "expected-path",
        "mustExecute": ["authorization", "lookup_order", "risk_check", "manual_review"],
        "mustNotExecute": ["cancel_order"],
        "orderedNodes": ["authorization", "lookup_order", "risk_check", "manual_review"],
        "requireCompleted": true
      },
      {
        "kind": "route",
        "id": "risk-route",
        "nodeId": "risk_check",
        "expectedRoute": "risky"
      },
      {
        "kind": "tool_trajectory",
        "id": "lookup-only",
        "tools": [{ "name": "lookup_order", "args": { "orderId": "42" } }],
        "config": { "strictOrder": true, "strictArgs": true }
      }
    ]
  },
  "fixture": {
    "toolFixtures": [
      {
        "tool": "lookup_order",
        "args": { "orderId": "42" },
        "result": { "status": "high_risk", "owner": "user_123" }
      }
    ]
  }
}
配置了两个评测用例 高风险订单转人工审核 和 安全订单直接取消:
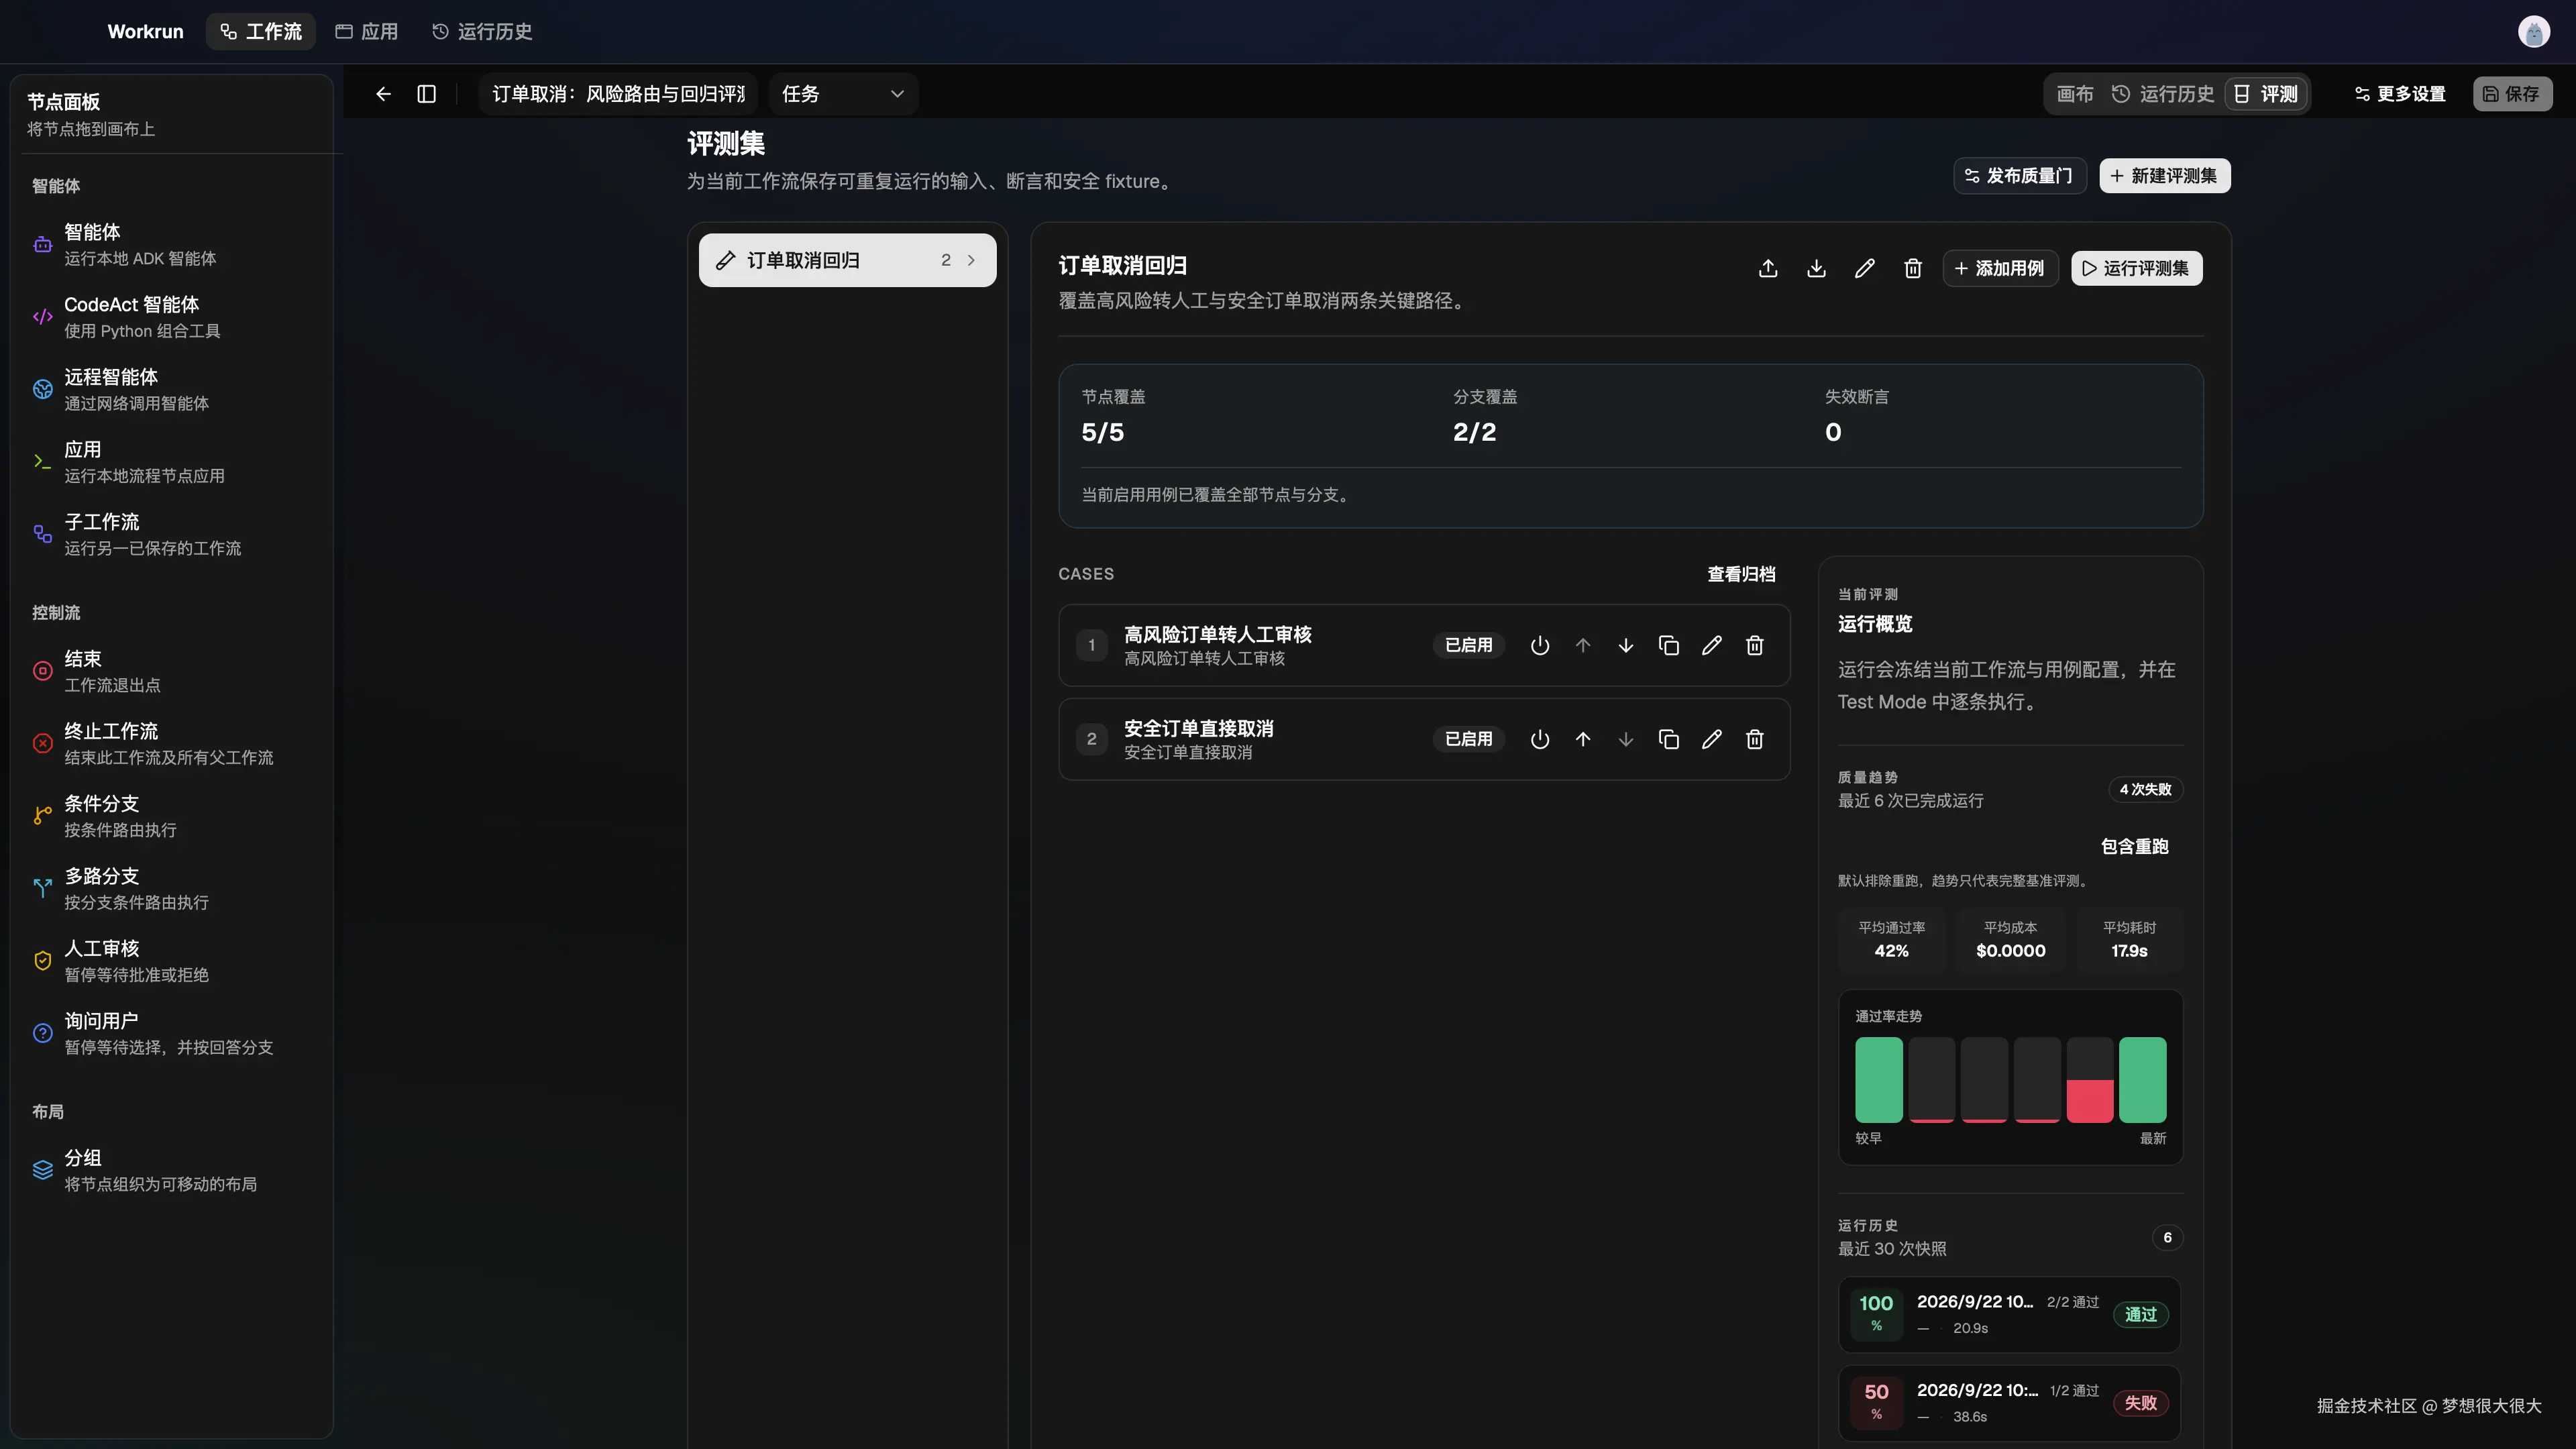
Workrun 当前的评测能力以确定性断言为主,支持:
- 最终文本的精确、包含或相似度匹配;
- 最终 JSON 的 JSONPath 断言;
- 工具轨迹、工具参数和返回结果匹配;
- 节点是否执行、是否完整执行、是否遵守预期顺序;
- 控制节点是否走到了指定 route;
- 指定节点的输出、文本和工具轨迹;
- 面向最终输出、工具参数或工具结果的安全断言。
编辑评测用例:
评测结果:
查看运行输出:
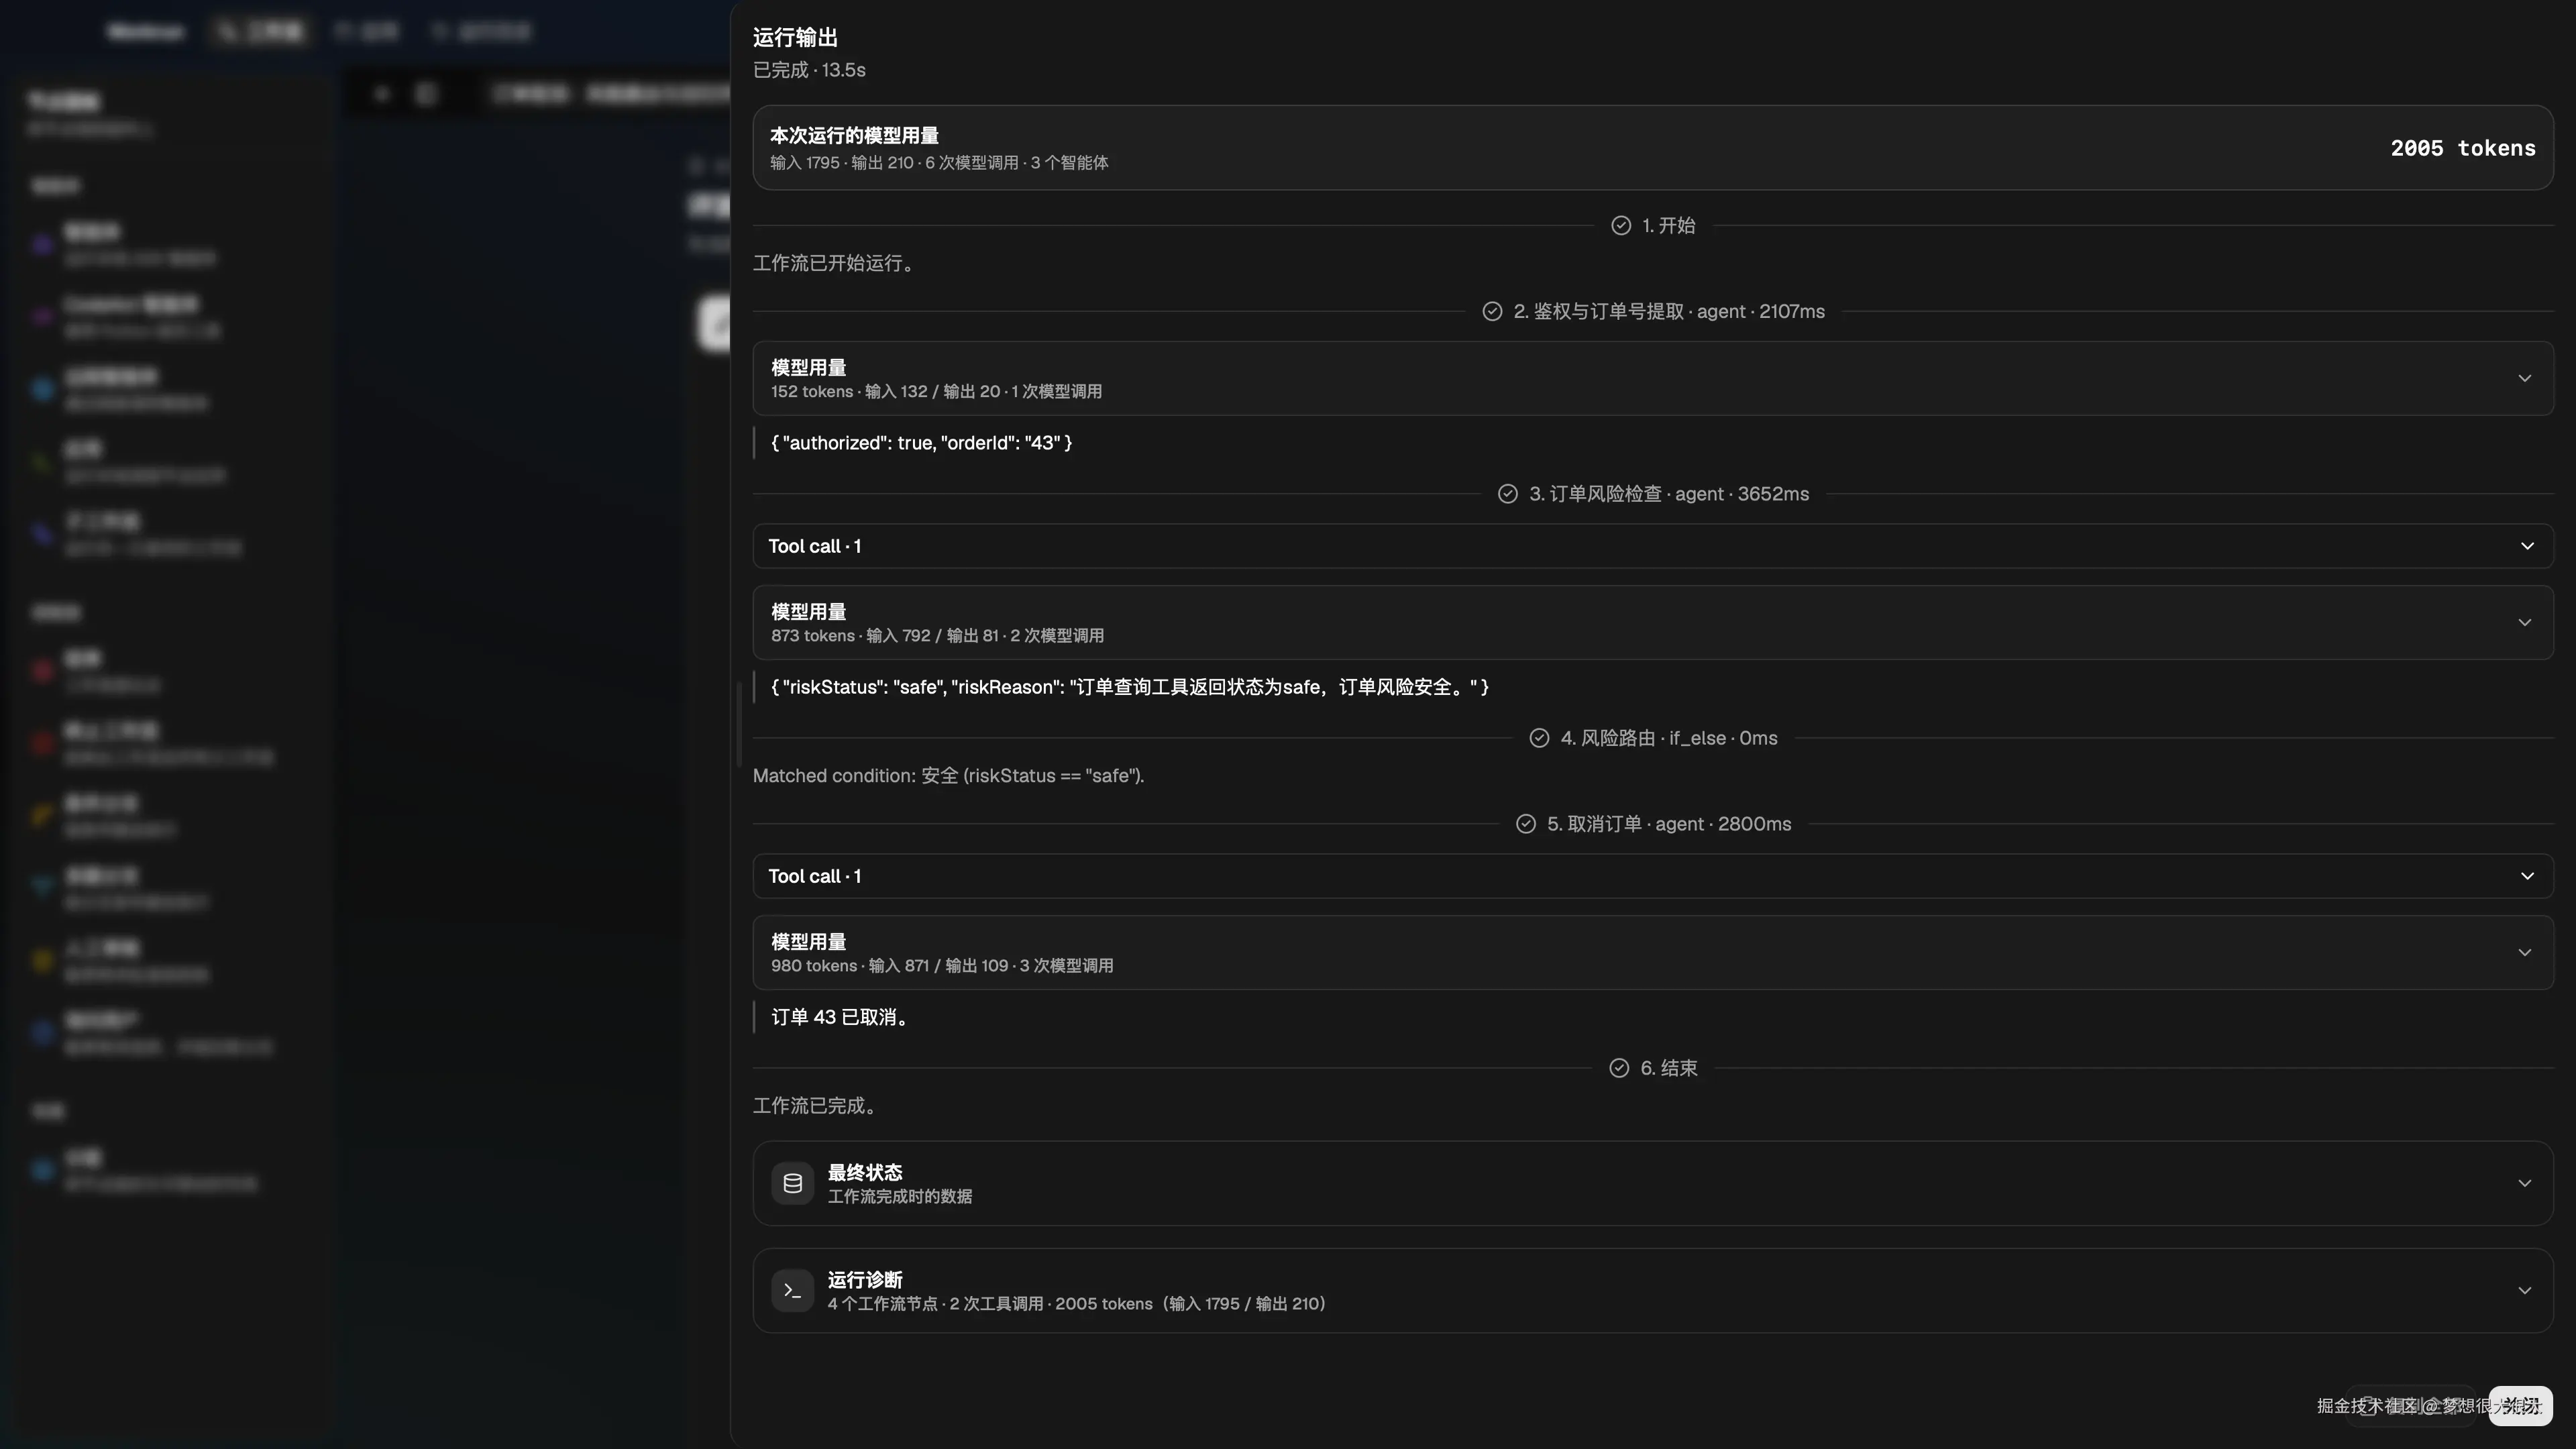
这使得"最终回答对了,但行为错了"不再会被轻易放过。比如模型回复了"订单已取消",却没有调用 cancel_order,工具轨迹断言会失败;如果风控命中却没有进入 manual_review,route assertion 会失败。最终文本只是证据的一部分,不再是唯一判据。
为什么离线评测不会真的取消订单
对涉及外部系统的 workflow 来说,测试安全性是第一位的。Workrun 的 evaluation 不会放开真实工具调用,而是通过 exact-match fixture 提供工具响应。
json
{
  "tool": "cancel_order",
  "args": { "orderId": "42" },
  "result": { "status": "cancelled" }
}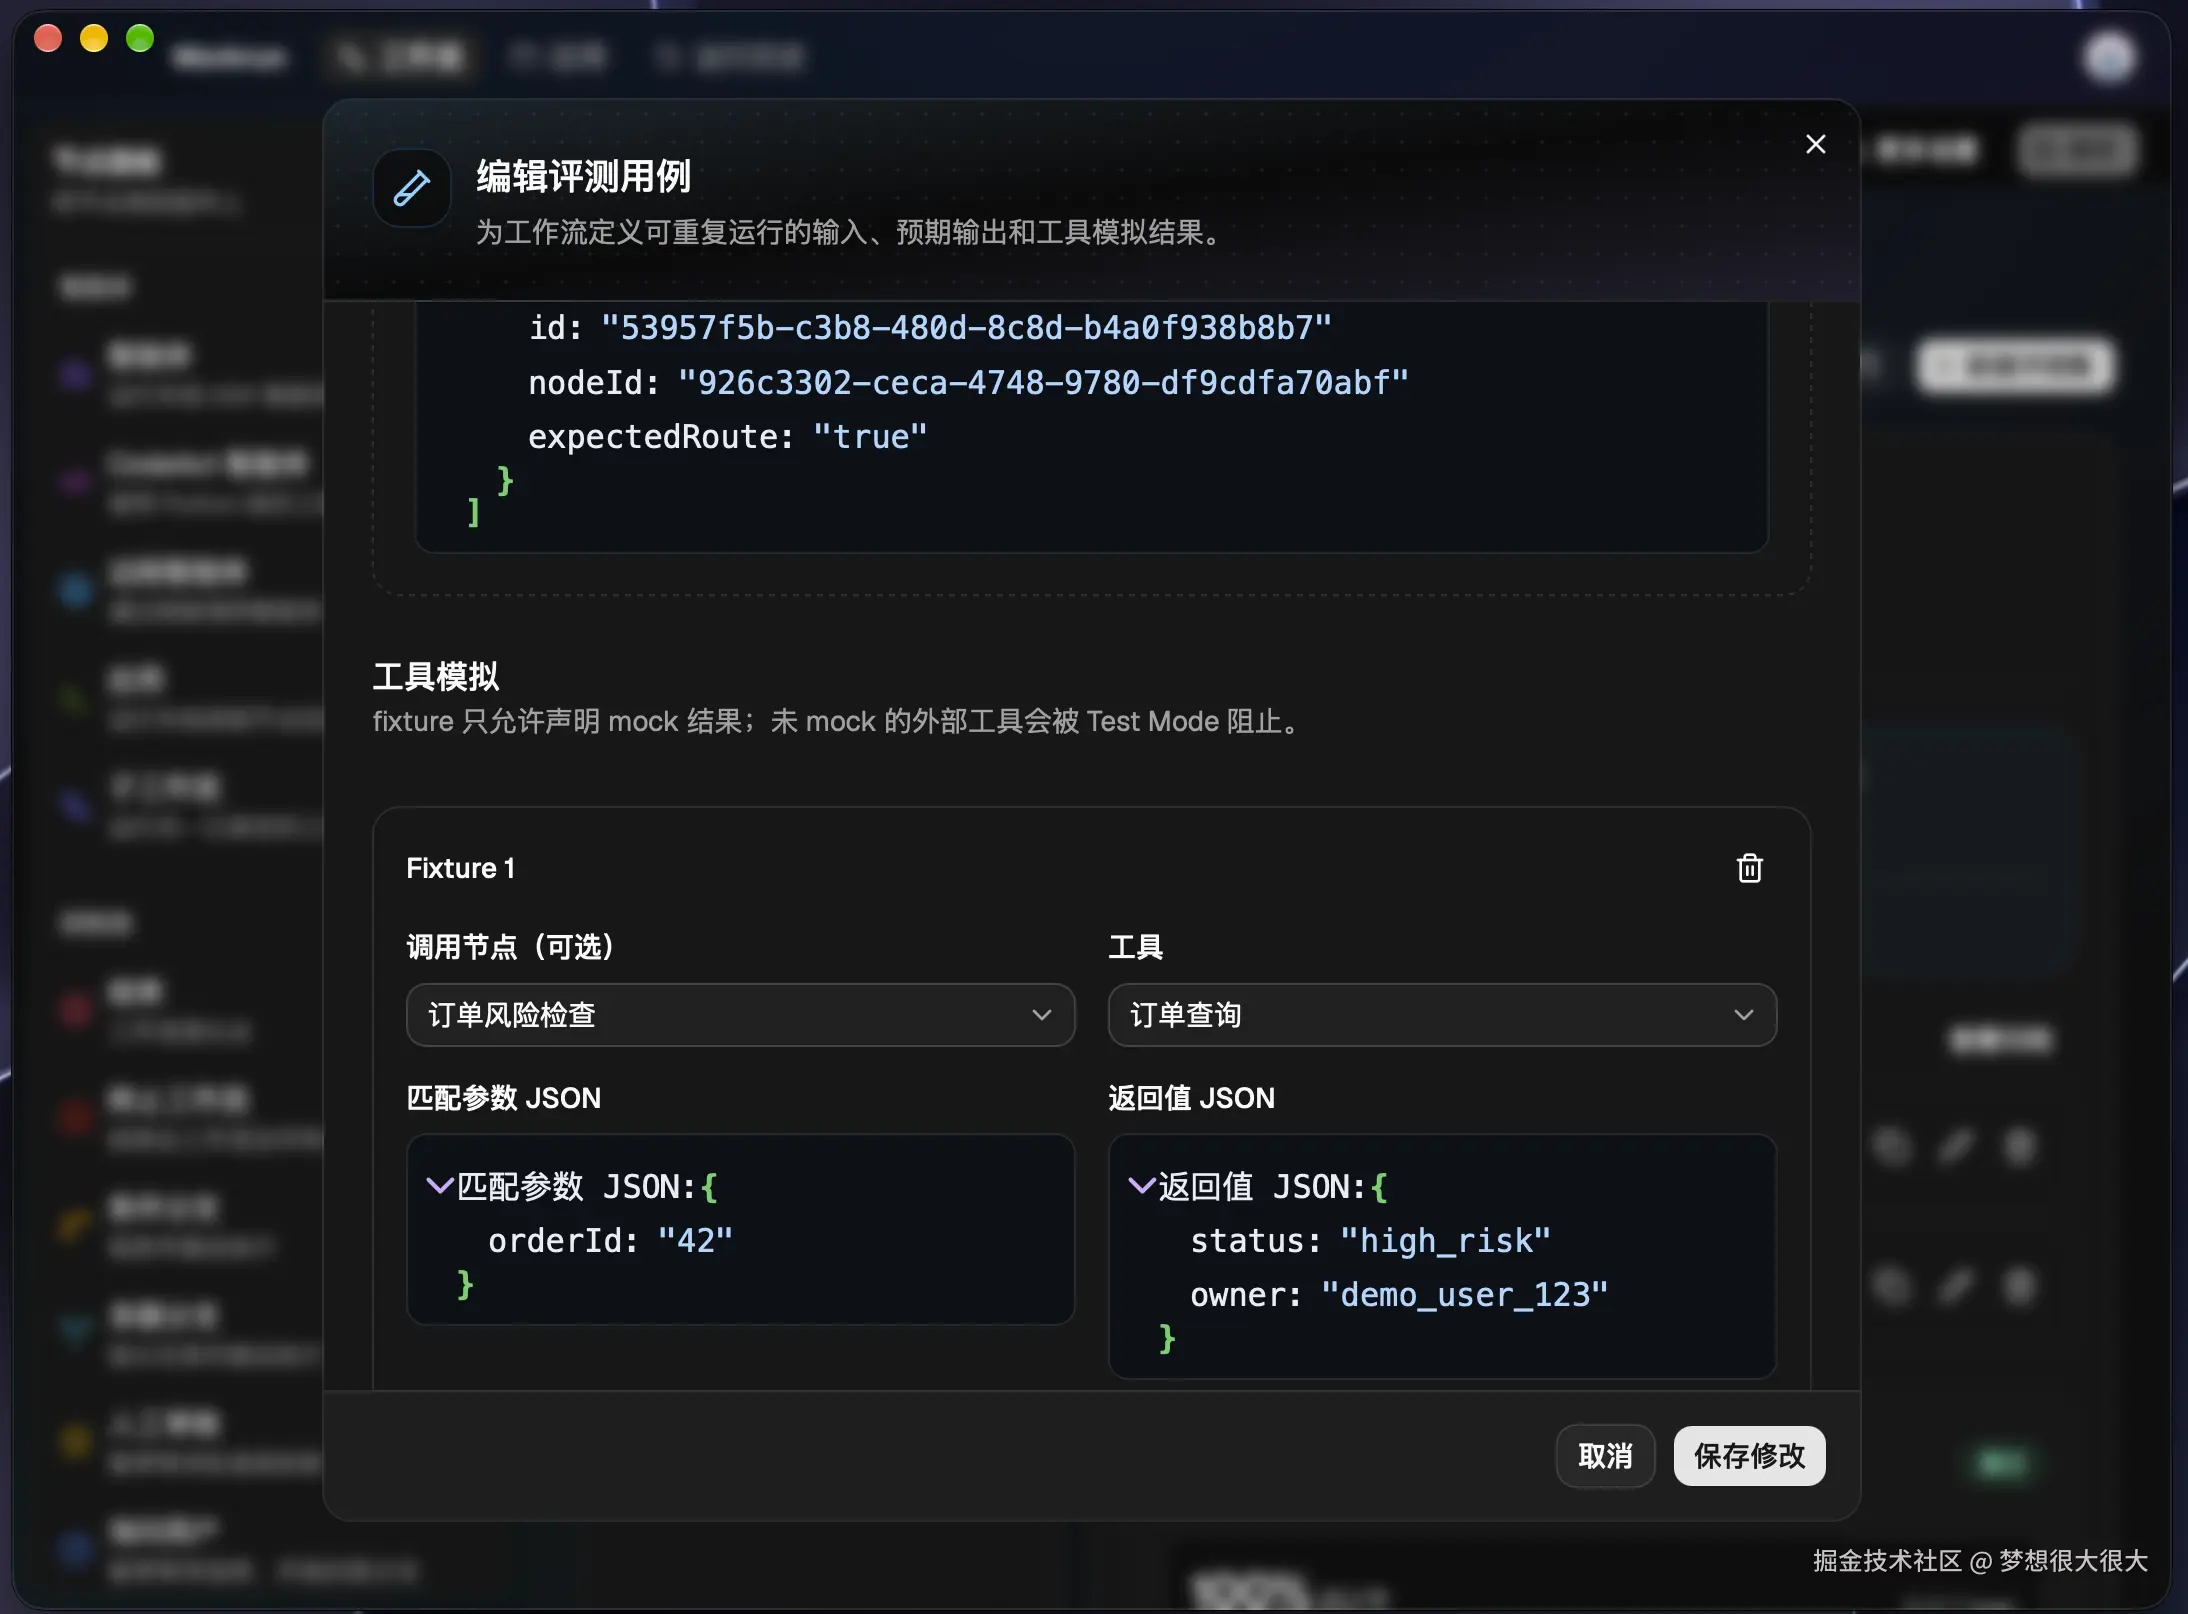
评测时,工具调用必须准确命中 fixture;没有 fixture 的调用会直接失败。这样做有几个好处:
- 🔒 安全性:评测不会真的写入订单系统;
- 🐛 暴露隐患:未预期的工具调用会暴露出来,而不是悄悄穿透到真实环境;
- 🧪 可复现:工具返回结果是稳定的,因此断言失败更容易解释和复现。
快照:为什么一次历史评测不会被后来的编辑改写
评测系统很容易犯一个错误:今天打开三周前的一次失败记录,却发现它正在用今天的 case 定义重新解释过去的运行。
Workrun 在创建 evaluation run 时,会冻结并生成快照(workflow snapshot、workflow fingerprint、suite/case、输入、预期、fixture 和 execution profile)。后续修改 prompt、节点、case 或 fixture,不会改写已经存在的评测证据。
这让版本比较有了实际意义:
text
v1.2.0:10 / 10 passed
v1.3.0: 9 / 10 passed

Regression:cancel-order-with-risk
原因:risk_check 后没有进入 manual_review
即使两个版本都能产出"看起来合理"的最终文本,版本差异仍然能指出:哪一个 case 从通过变成失败、哪一条 criterion 发生了退化,以及对应的执行证据是什么。
脱敏优先:证据有用,但不该成为新的泄露面
Run History 和 evaluation 都会接触到模型输出、工具参数和工具结果,这些地方最容易出现敏感数据。
Workrun 的做法是先建立脱敏的可见证据投影,再将其用于历史查看和评测。它会处理常见凭据字段、文本中的秘密模式,以及部分 PII;workflow 也可以配置明确的敏感字段。安全断言会保留"哪个路径命中"或"禁止文本出现了几次"这类结论,而不会把命中的敏感值再次写进评测结果。
发布前检查:可审计的旁路,而不是硬门禁
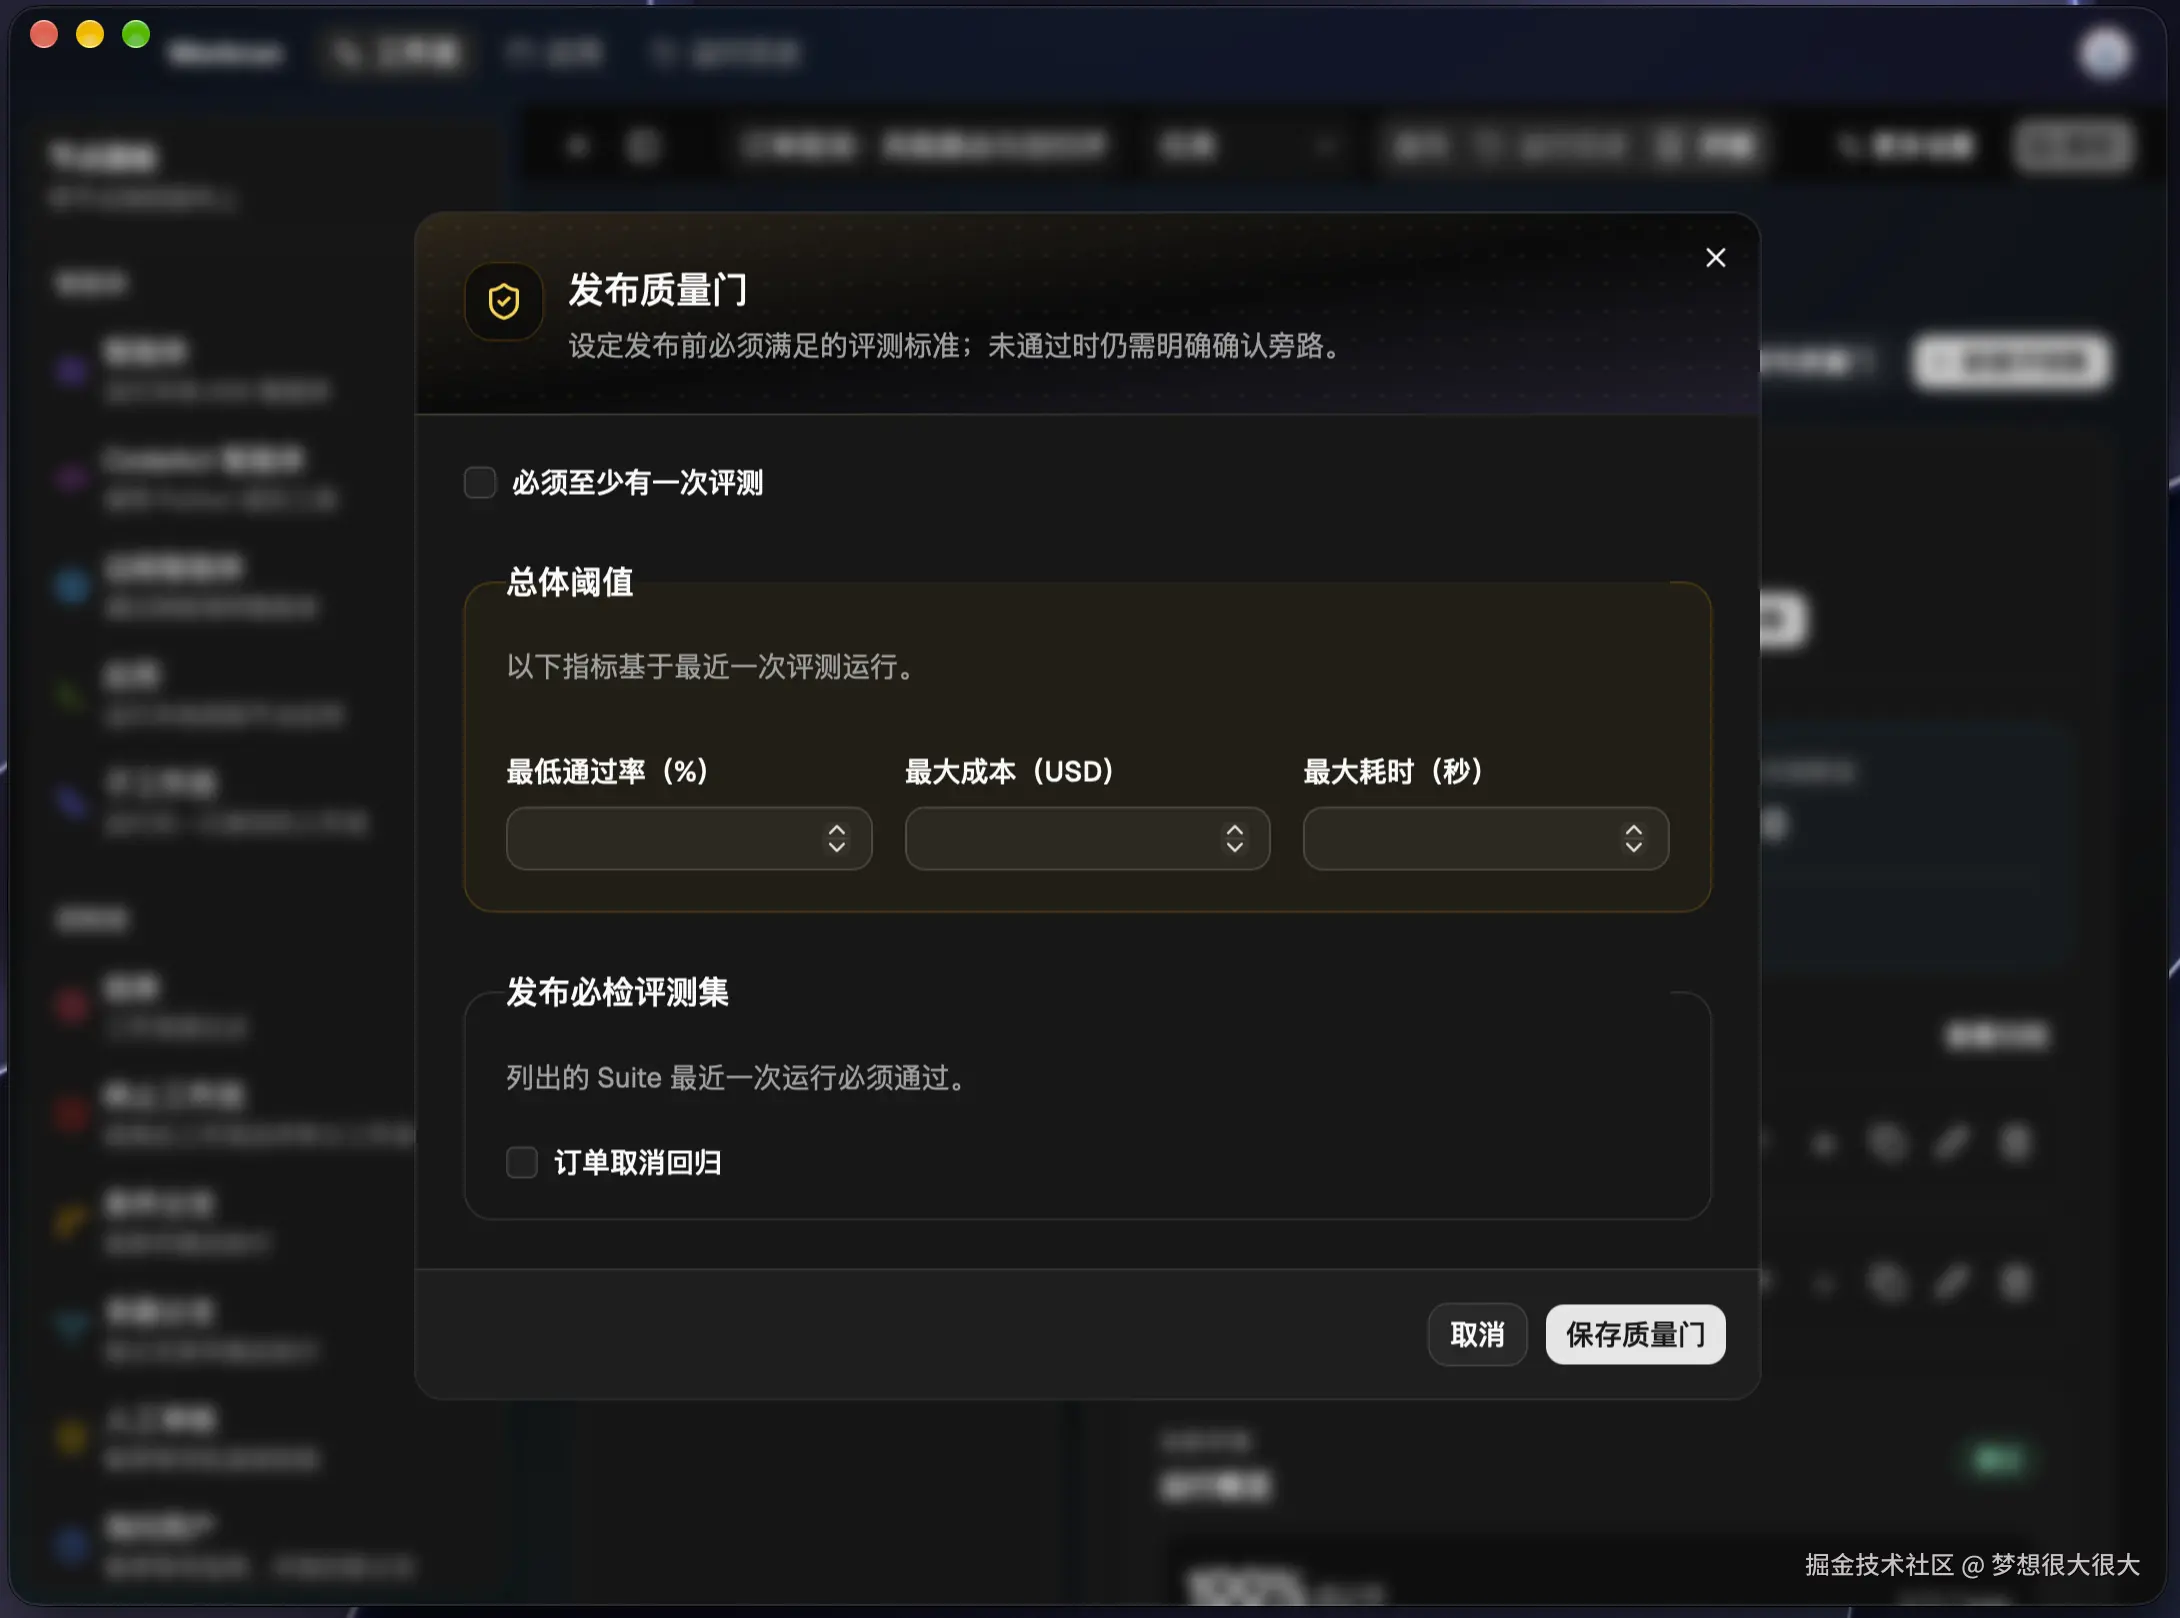
Workrun 可以为 workflow 配置发布前质量检查:例如最低通过率、最高成本、最长耗时,以及必须通过的 suite。检查的是当前 candidate workflow snapshot 对应的评测结果,而不是某个历史版本的旧数据。
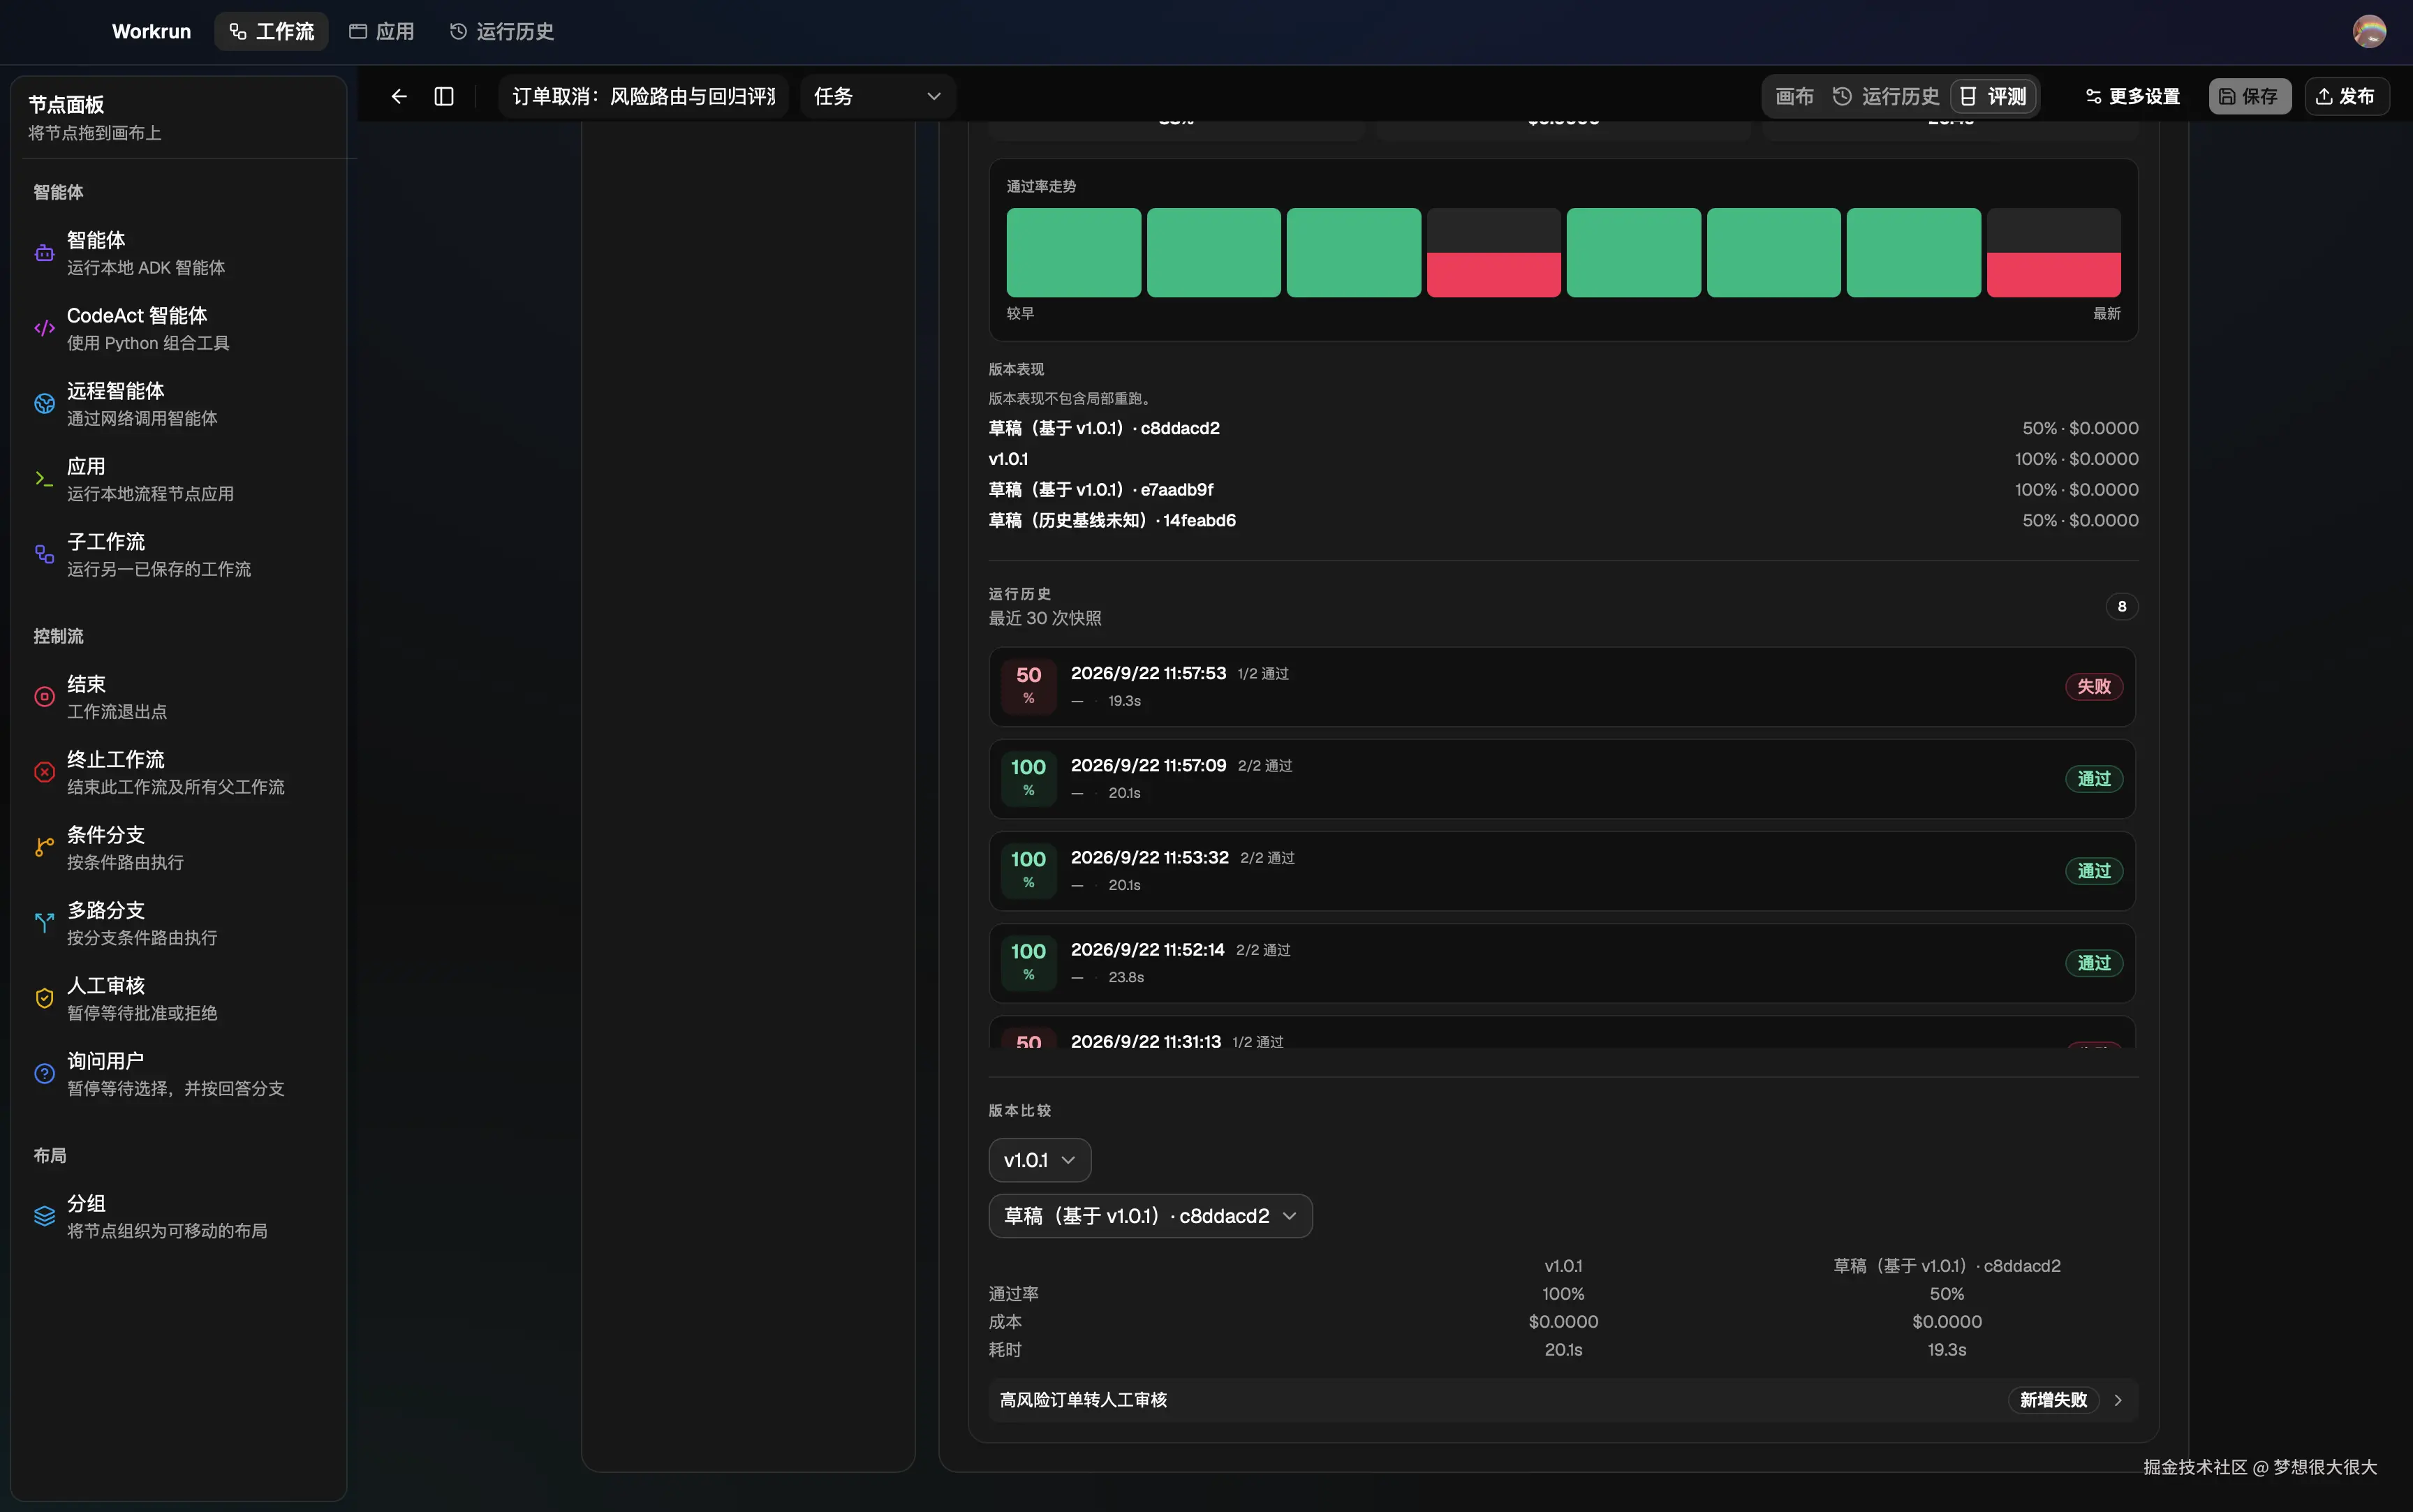
版本比较则给这次检查补上了"相对变化"的上下文。对同一个 suite,先为基线 workflow 运行一次评测;修改节点、prompt 或配置并保存后,再运行一次。每次运行都会冻结各自的 workflow snapshot,评测页会将不同快照(团队模式下也可对应已发布版本)列为可选的基线和候选版本。
选择两个版本后,Workrun 会并排展示通过率、估算成本和总耗时,并列出发生变化的 Case:新增失败、修复、持续失败或只存在于一侧的 Case。点开某个变化项,还可以逐条比较冻结的 criterion 判定。于是"高风险订单转人工审核 从通过变为失败"不只是一个红色状态,而能继续定位到是节点路径少了 manual_review、risk_route 命中了错误分支,还是工具轨迹出现了不应有的 cancel_order 调用。
对比总览:
对比详情:
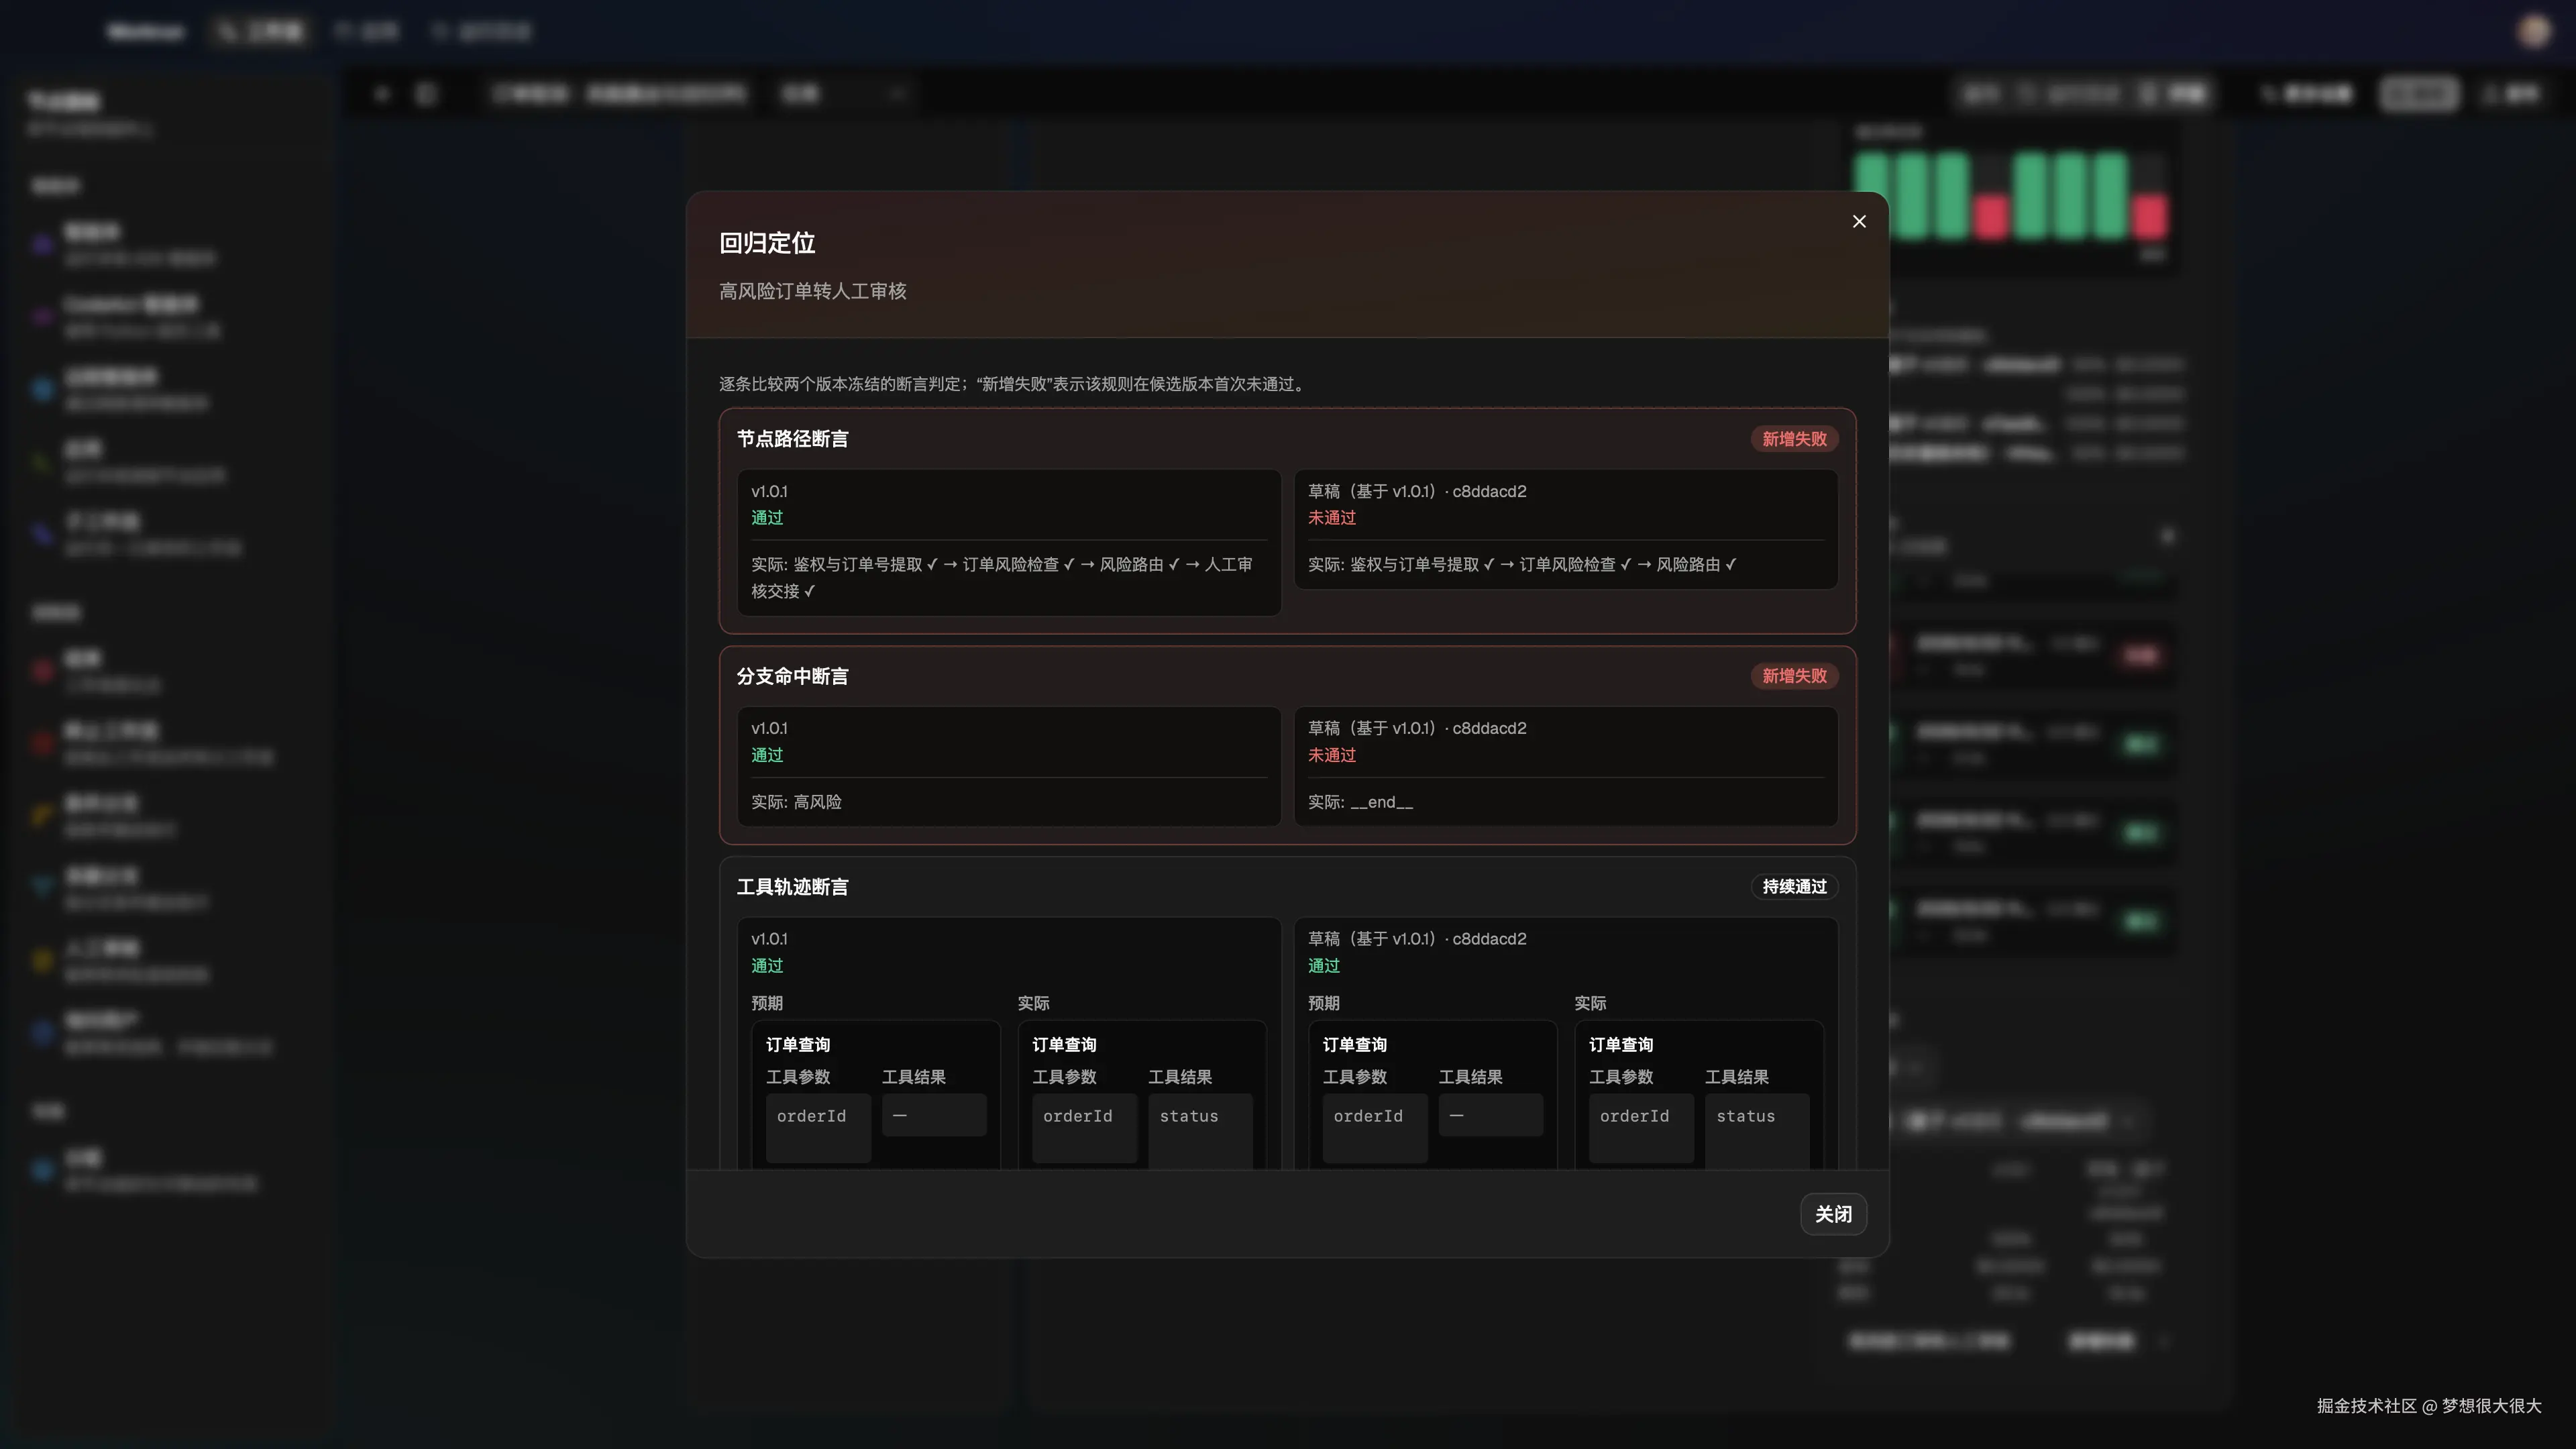
在个人模式中,没有语义化发布版本时,比较单位仍是不可变的 draft snapshot fingerprint;在团队模式中,发布后的版本号会成为更易辨认的比较对象。无论哪种模式,比较读取的是各版本最近一次非重试的完整评测运行,而不是将某次失败重试混入基线。
当前的产品语义是:如果检查未通过,发布界面会要求操作者显式确认旁路并填写原因,同时保存当时的质量策略和评测快照,供之后回看。
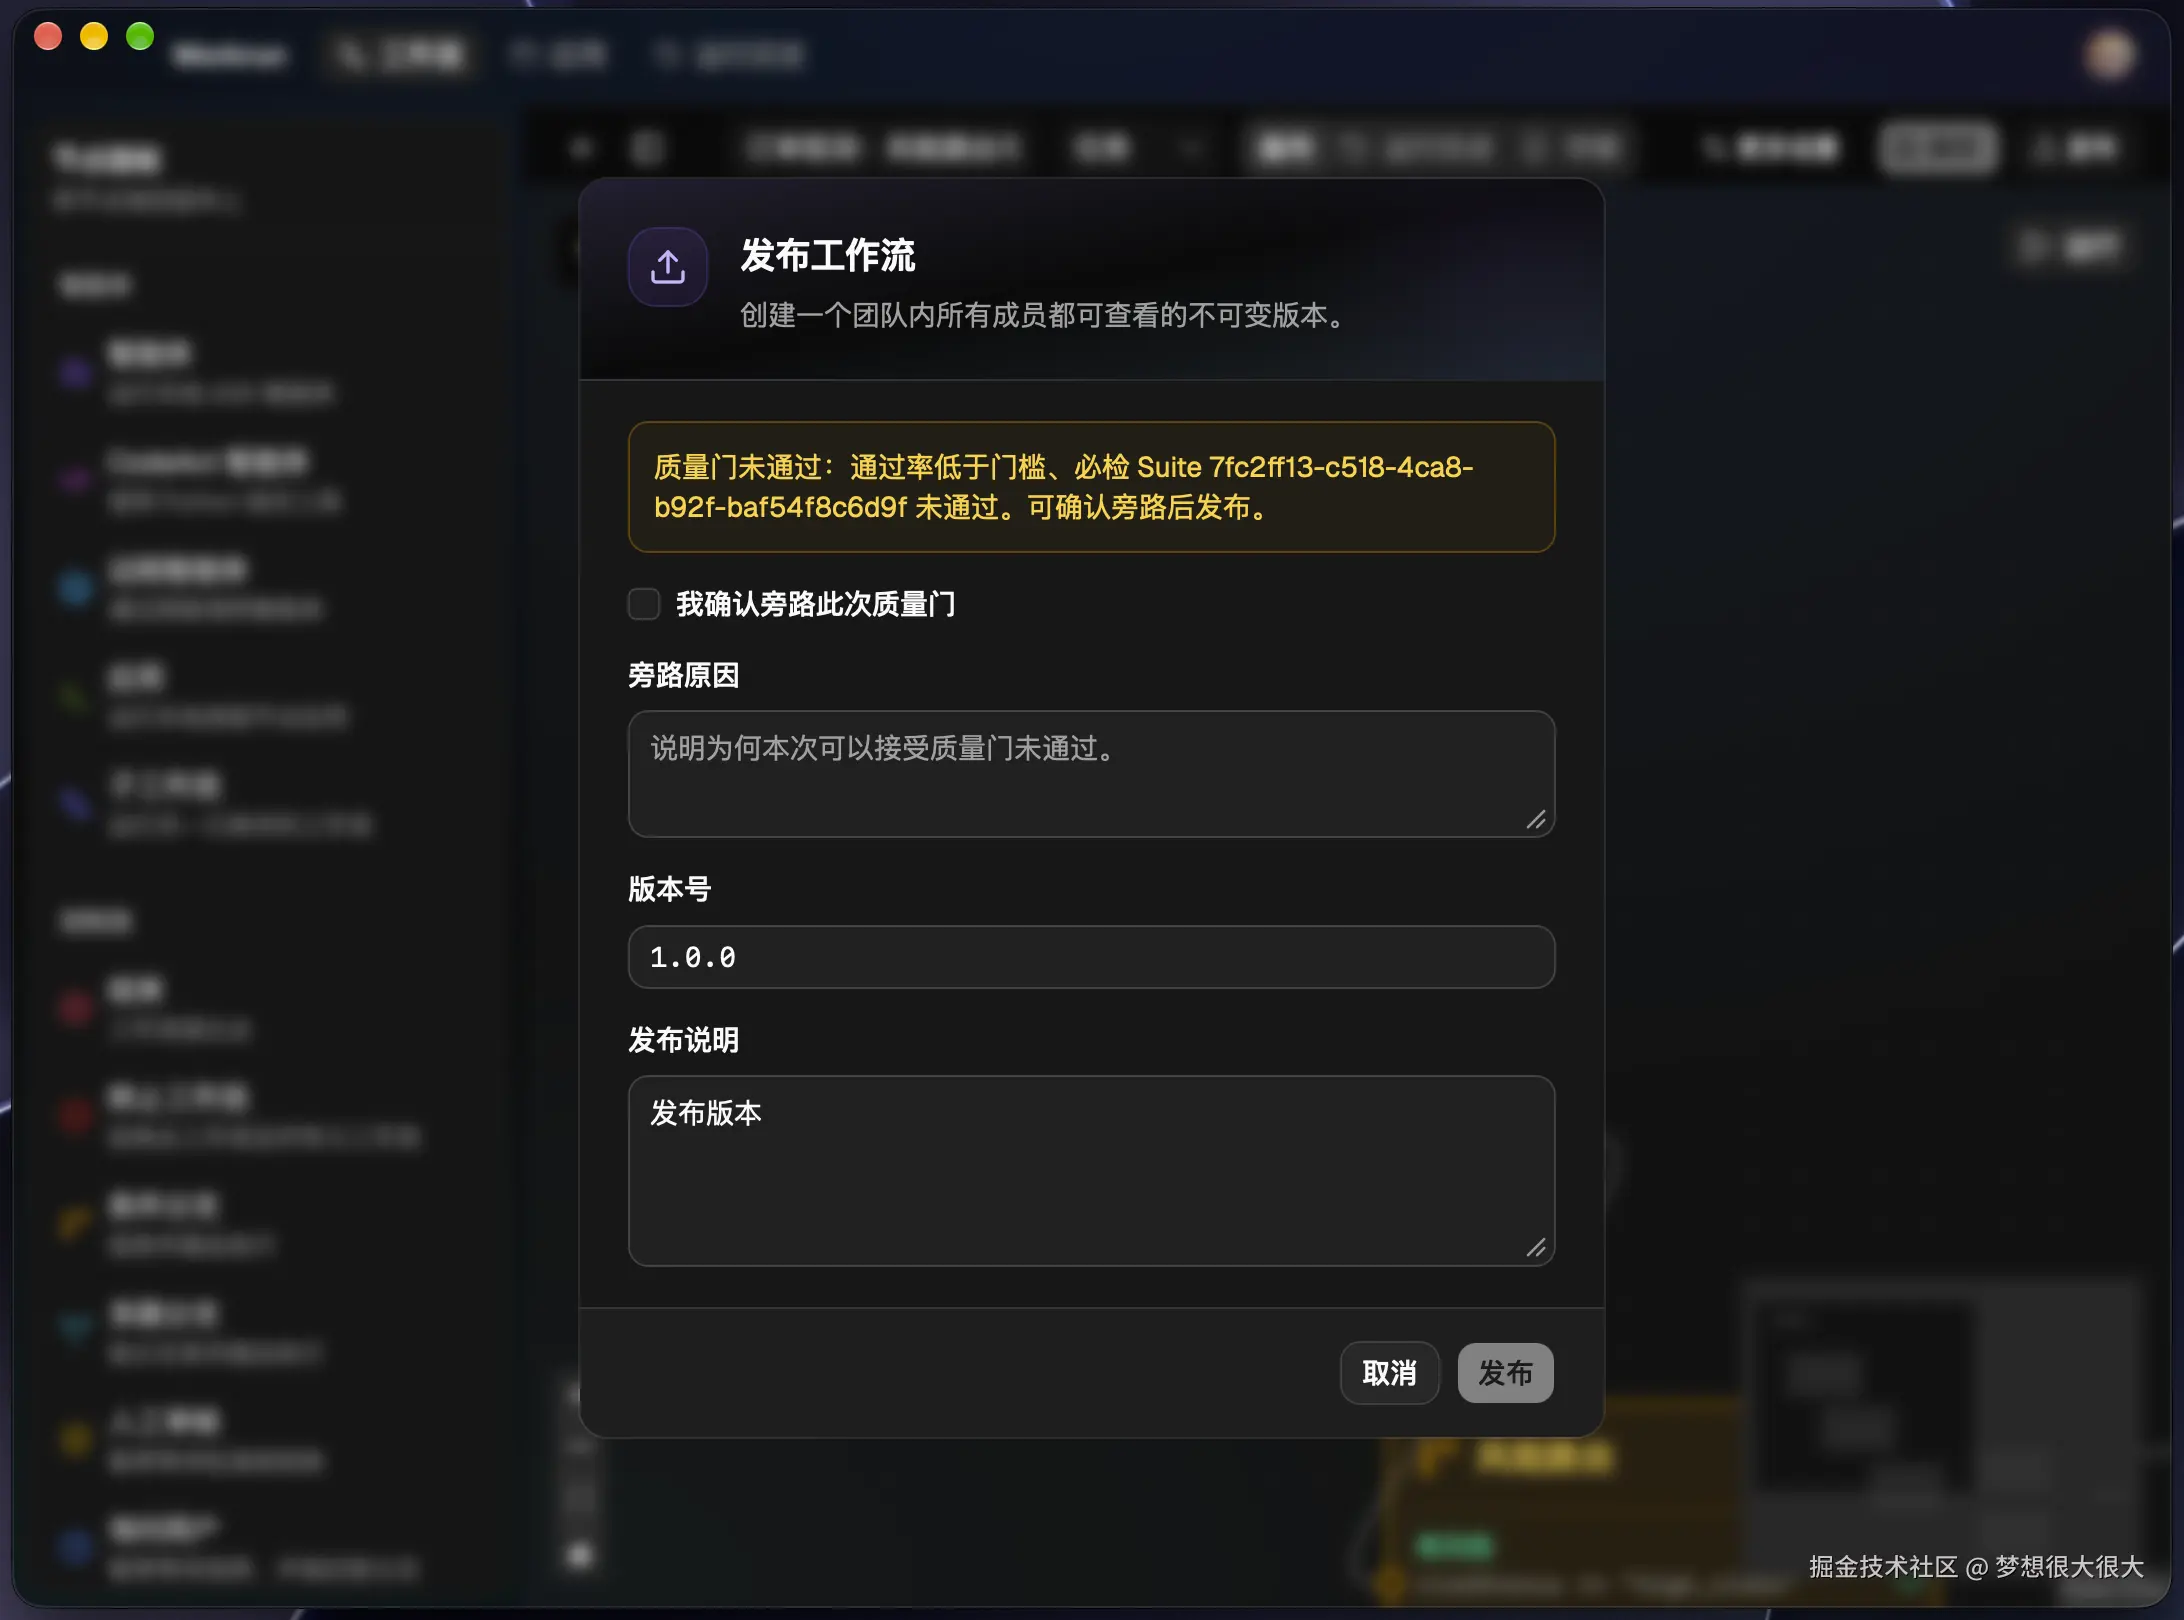
这是一种可审计的发布前质量检查,不是服务端不可绕过的强制发布门禁。把边界说清楚并不会削弱它的价值:在本地优先的工作流工具里,显式旁路和可追溯记录往往比静默忽略一次失败更有意义。
目前已经解决了什么,还有什么没有解决
到目前为止,Workrun 已经把几件通常容易断开的事情串了起来:
- ✅ 脱敏优先的本地运行历史;
- ✅ 节点、模型和工具维度的耗时、token、成本与错误诊断;
- ✅ 运行终态与 span 终态的 DB 事务级一致性;
- ✅ 基于真实 workflow runtime 的确定性评测;
- ✅ Fixture 隔离 和不可变评测快照;
- ✅ Case / Criterion 维度的版本回归比较;
- ✅ 可选的 OTLP 导出(已验证 Jaeger 链路)。
同时,它仍然有清晰的边界:
- 🚧 当前评测以确定性断言为主,还不是 LLM-as-a-judge 或 rubric 平台;
- 🚧 没有用 fixture 替代真实外部系统的端到端验收;
- 🚧 OTLP 仍然是可选诊断出口;
- 🚧 本地 span 也没有被设计成一套完整的 distributed tracing tree。
LLM-as-a-judge 是后续计划补上的能力。它更适合处理"回复是否专业""是否完整解释了风险""语气是否符合预期"这类难以写成固定规则的问题。但它会作为确定性断言的补充,而不是替代:工具是否被调用、路由是否正确、结构化字段是否存在,仍然应该优先由可复现、可解释的规则来判断。
结语
对 Agent workflow 来说,最先需要解决的往往不是"采集更多数据",而是让一次运行留下足够可信的证据:
能定位问题,能解释结果,能复现失败,也能在下一次修改后识别回归。
当运行事实、telemetry 和 evaluation 共享同一条证据链时,workflow 才开始从"能跑的自动化"变成真正可维护的工程系统。
Workrun 是一个开源项目,欢迎在 GitHub 查看源码与交流:1111mp/workrun-app