#
上一篇从裸机程序走到多任务系统,介绍了操作系统为什么需要管理资源,以及进程、上下文、栈和 PCB 这些概念。接下来还需要追问:操作系统毕竟也是软件,它凭什么暂停一个程序、保护另一段内存,又怎样让硬盘和网卡替自己工作?
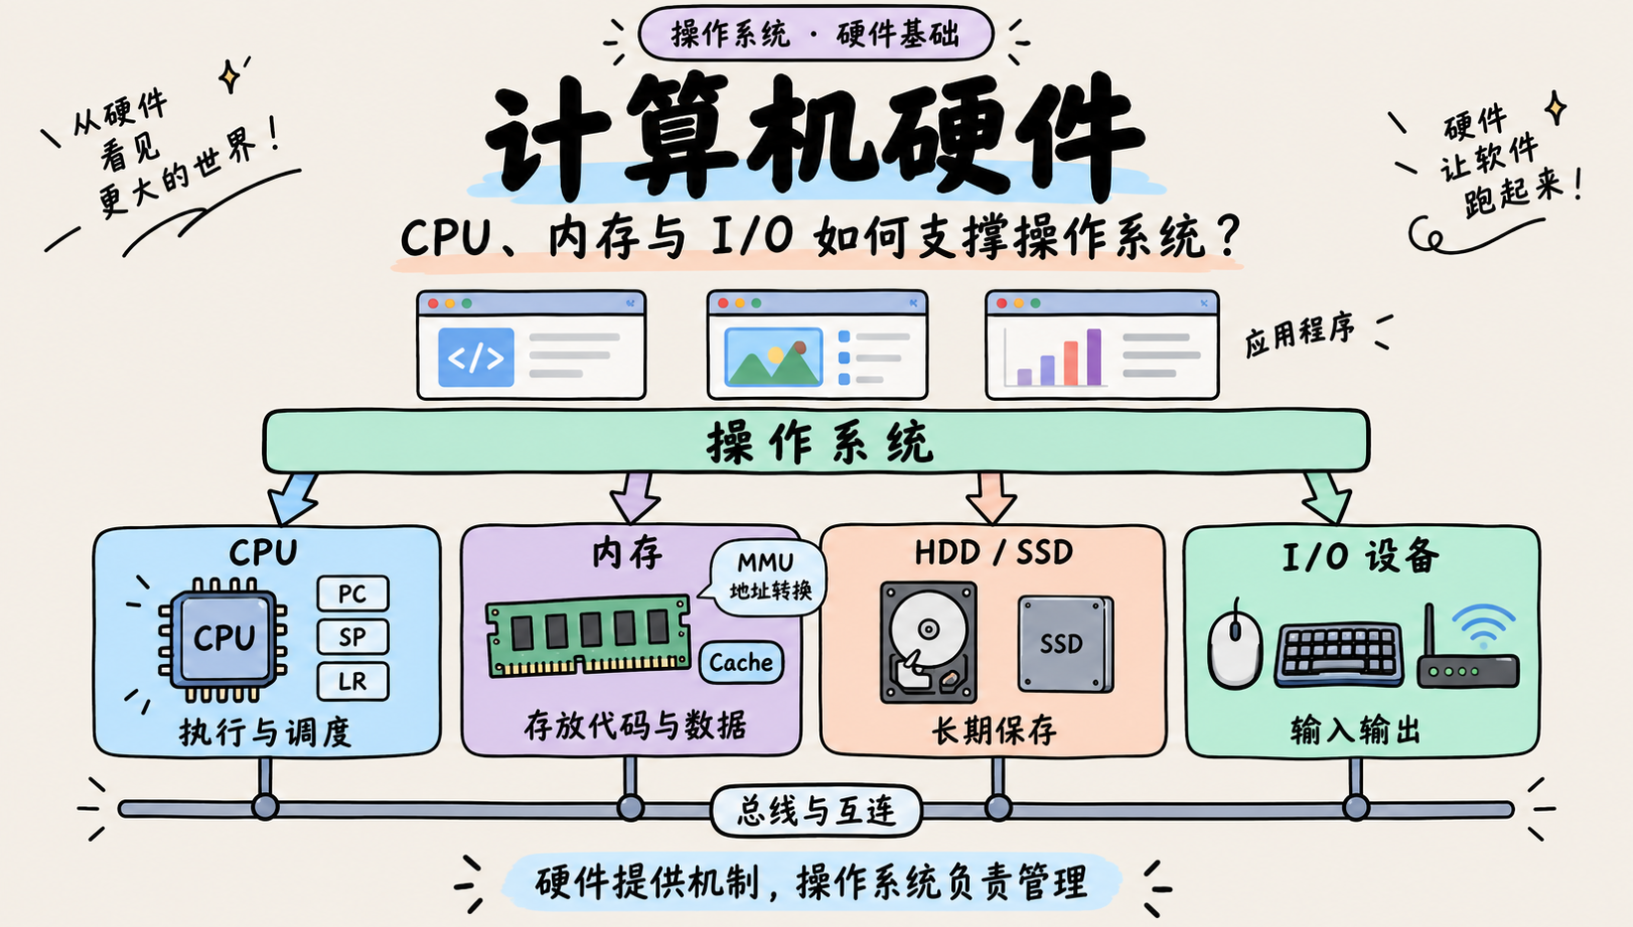
答案藏在硬件里。CPU 提供执行与特权机制,存储器保存指令和数据,控制器处理设备操作,总线连接各个部件,MMU 则参与地址转换与访问保护。
这篇文章从操作系统的需要出发,认识这些硬件的分工。重点不是记住某一款芯片的全部参数,而是理解:软件提出管理规则,硬件提供执行这些规则的基础机制。
一、先看全景:操作系统到底管理哪些硬件?
一台计算机可以先简化为以下几个部分:
text
计算机系统
├── CPU:执行指令
├── 主存 RAM:保存运行时的代码和数据
├── 外存 HDD / SSD:长期保存程序和数据
├── I/O 控制器与设备:完成输入、输出和通信
└── 总线与互连:连接上述部件这里先区分两个容易混淆的词:主存通常指系统运行时使用的内存,磁盘属于外存,不能把磁盘当作主存的一类。 CPU 内部也有寄存器和缓存,其中指令缓存就能保存指令,并不是"CPU 完全不存指令"。
站在操作系统的角度,每种硬件都会引出一组管理问题:
| 硬件资源 | 需要回答的问题 | 对应的操作系统机制 |
|---|---|---|
| CPU | 有限的处理器应该先运行谁,什么时候换人? | 进程、线程、调度、上下文切换 |
| 主存 | 空间如何分配,不同程序怎样隔离或共享? | 地址空间、虚拟内存、分页等 |
| HDD / SSD | 大量数据怎样组织,怎样根据文件名找到内容? | 文件系统、块设备管理 |
| I/O 设备 | 如何发出命令、传输数据、获知操作完成? | 驱动、中断、DMA、缓冲等 |
这些不是四套互不相干的功能。例如,程序读取一个文件,需要文件系统确定数据位置,需要驱动向设备发出请求,需要内存存放结果,还可能因为等待 I/O 而触发任务调度。
因此,学习硬件的目的,是看清操作系统各个模块为什么必须相互配合。
二、CPU 怎样执行程序:寄存器、指令与函数调用
1. CPU 核心、缓存和整颗芯片有什么区别?
谈到"CPU"时,我们有时指执行指令的处理器核心,有时指包含多个核心和其他部件的整颗处理器芯片。阅读硬件框图时,应该先看清边界。
下面是一个带有 ARM920T 的芯片结构示例:
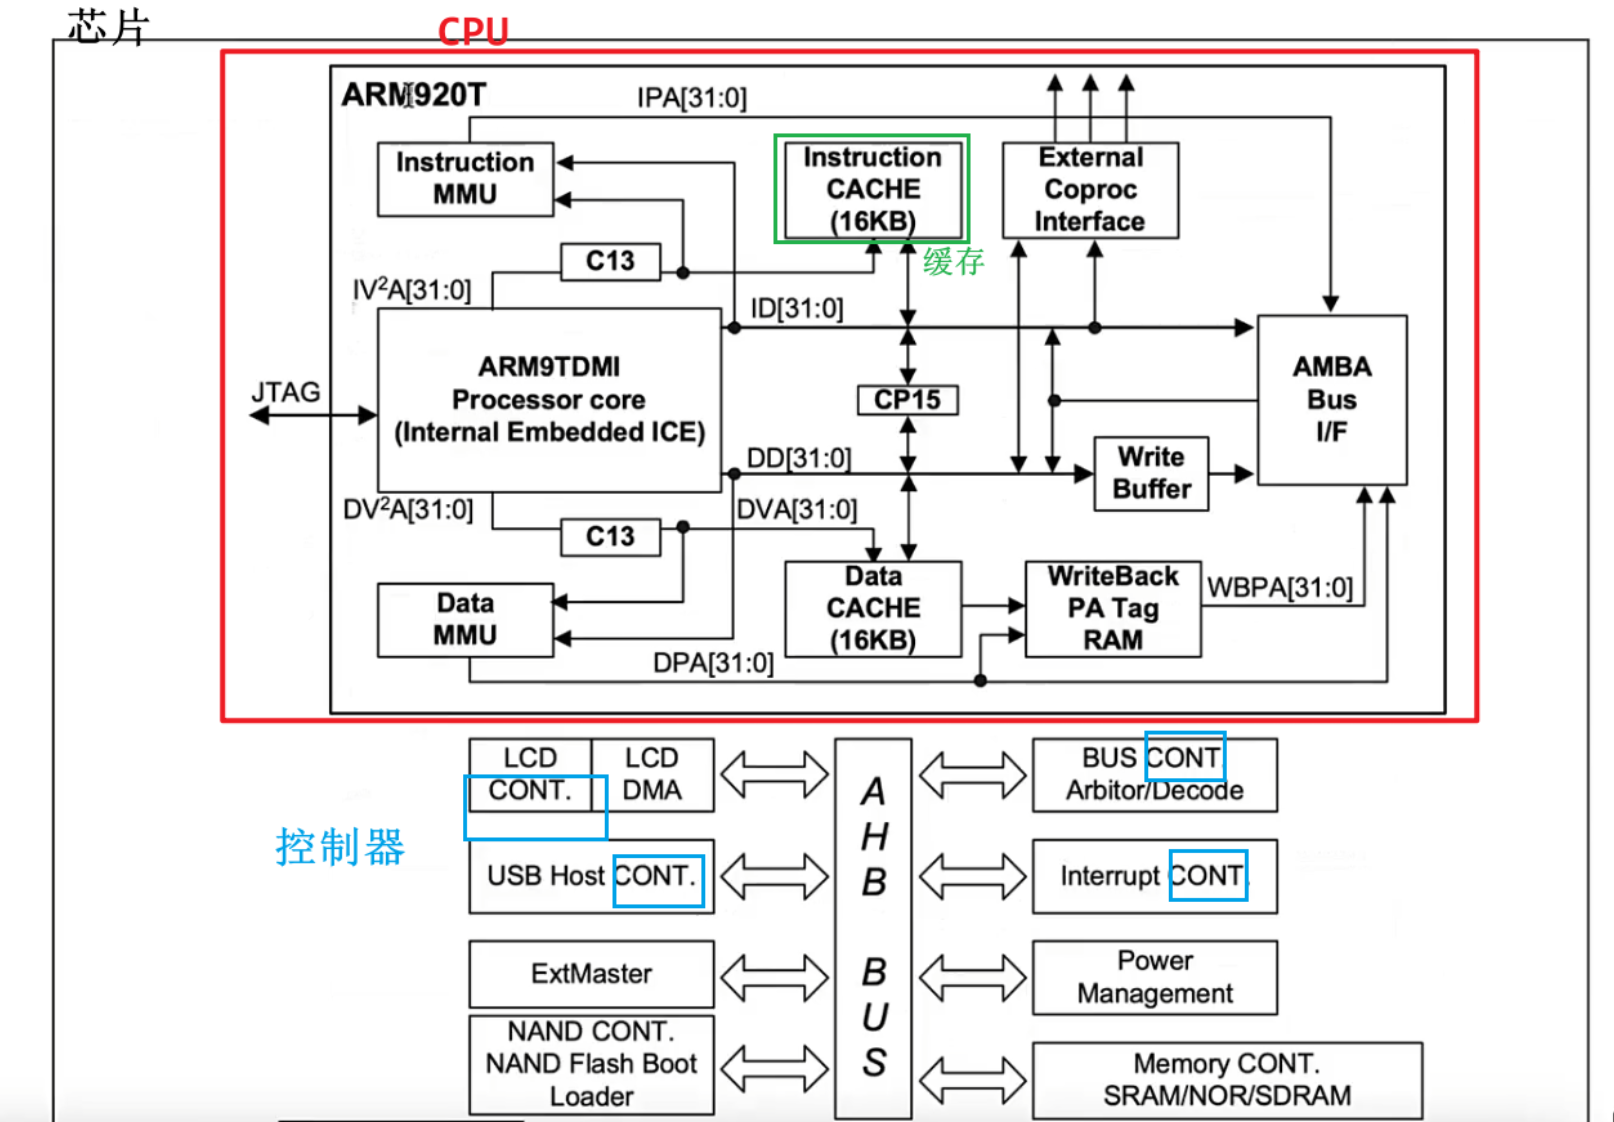
图中既有执行指令的核心,也有指令缓存、数据缓存、MMU 和总线接口;外围还有 LCD、USB、存储器等控制模块。它说明:能够运行系统的芯片,通常不只有一个做加法的计算部件,而是一组相互配合的硬件。
这种把处理器核心和多种控制模块集成起来的设计,常见于 SoC(System on Chip,片上系统)。不同芯片的布局与集成程度不同,不必把这张示例图当作所有计算机的固定结构。
2. 寄存器:保存眼前要用的值
CPU 执行指令时,需要快速取得操作数、地址和控制状态。**寄存器(Register)**就是离执行部件很近的一类存储资源,速度快、容量小,数量由体系结构规定。
以经典 32 位 ARM 为例,可以先认识这些寄存器:
| 寄存器 | 常见名称 | 主要用途 |
|---|---|---|
| R0~R12 | 通用寄存器 | 保存数据、地址、参数或中间结果等 |
| R13 | SP,栈指针 | 指示当前栈位置 |
| R14 | LR,链接寄存器 | 普通函数调用时保存返回位置 |
| R15 | PC,程序计数器 | 与当前指令执行位置及控制流有关 |
| CPSR 等 | 程序状态寄存器 | 保存条件标志及相关处理器状态 |
可以把 PC 理解为"执行到哪里",SP 理解为"当前调用现场在哪里",LR 理解为"调用结束以后回哪里"。但这只是帮助入门的概括,PC 的具体读取值、异常返回的地址规则等都与体系结构有关。
还要明确:寄存器可以通过指令直接引用。 比如 ADD R2, R0, R1 就明确指定了三个寄存器。普通加载、存储指令通常使用内存地址,由硬件决定相应数据是否从 Cache 取得,并不是程序每次都指定某个缓存位置。
3. 指令集:CPU 能理解哪些操作?
**指令集体系结构(ISA)**规定了软件能够使用的指令、寄存器、寻址方式和相关执行规则。它既包括计算,也包括数据搬运、跳转和系统控制等内容。
对于 ARM 这类采用加载/存储模型的指令集,可以用下面的示意代码理解一次计算:
asm
; 假设 R3、R4、R5 分别保存 a、b、c 的有效地址
LDR R0, [R3]       ; 从 a 所在地址加载数据
LDR R1, [R4]       ; 从 b 所在地址加载数据
ADD R2, R0, R1     ; 在寄存器之间完成加法
STR R2, [R5]       ; 把结果保存到 c 所在地址
这段代码只说明"加载 → 运算 → 存储"的关系,不是一个完整程序,也不代表编译器一定会按这个顺序生成代码。如果数据已经在寄存器里,就可能不需要重新加载;结果也不一定马上写回内存。
不能把它扩大为"所有 CPU 的运算指令都不允许内存操作数"。例如,x86 的部分运算指令允许使用内存操作数,具体规则需要看对应 ISA。
指令还包括条件比较、分支跳转、原子操作,以及配置系统状态等功能。一些底层操作需要特定指令或编译器内建函数支持,不能仅靠可移植的普通 C 语句完整表达。
4. PC、LR 和 SP 怎样配合函数调用?
假设有这样一段调用关系:
c
void f1(void)
{
    f2();
    f3();
}
执行到 f2() 时,CPU 不仅要转到 f2,还要保留回到 f1 后继续执行的位置。以 ARM 的普通带链接分支调用为例,可以概括为:
text
调用 f2:保存返回位置到 LR,跳转到 f2
执行 f2:完成它的工作
返回 f1:利用保存的返回位置继续执行
例如,简单叶子函数可以用 BX LR 返回。但如果 f2() 还要调用 g(),下一次调用就可能改写 LR。为了保留最初的返回位置,函数通常需要先把它保存到栈等合适位置,结束前再恢复。
栈还可以保存局部数据、需要保留的寄存器值,以及按调用约定放在栈上的参数。哪些内容在栈里、哪些在寄存器里,由调用约定和编译结果共同决定。
函数返回并不意味着所有寄存器都恢复原值。 ARM 的 AAPCS32 规定,R0~R3 可以承担参数、结果和临时值;调用者不能假设它们在调用后保持不变。这是正常约定,不是操作系统忘了保存现场。Arm AAPCS32 调用规范
这个区别很重要:调用一个函数,仍然是在推进同一条执行流;切换到另一个任务,则必须保留原任务将来继续运行所需的状态。
三、CPU 怎样支持操作系统:权限、中断和上下文
1. 用户态与内核态:为什么应用不能随便操作硬件?
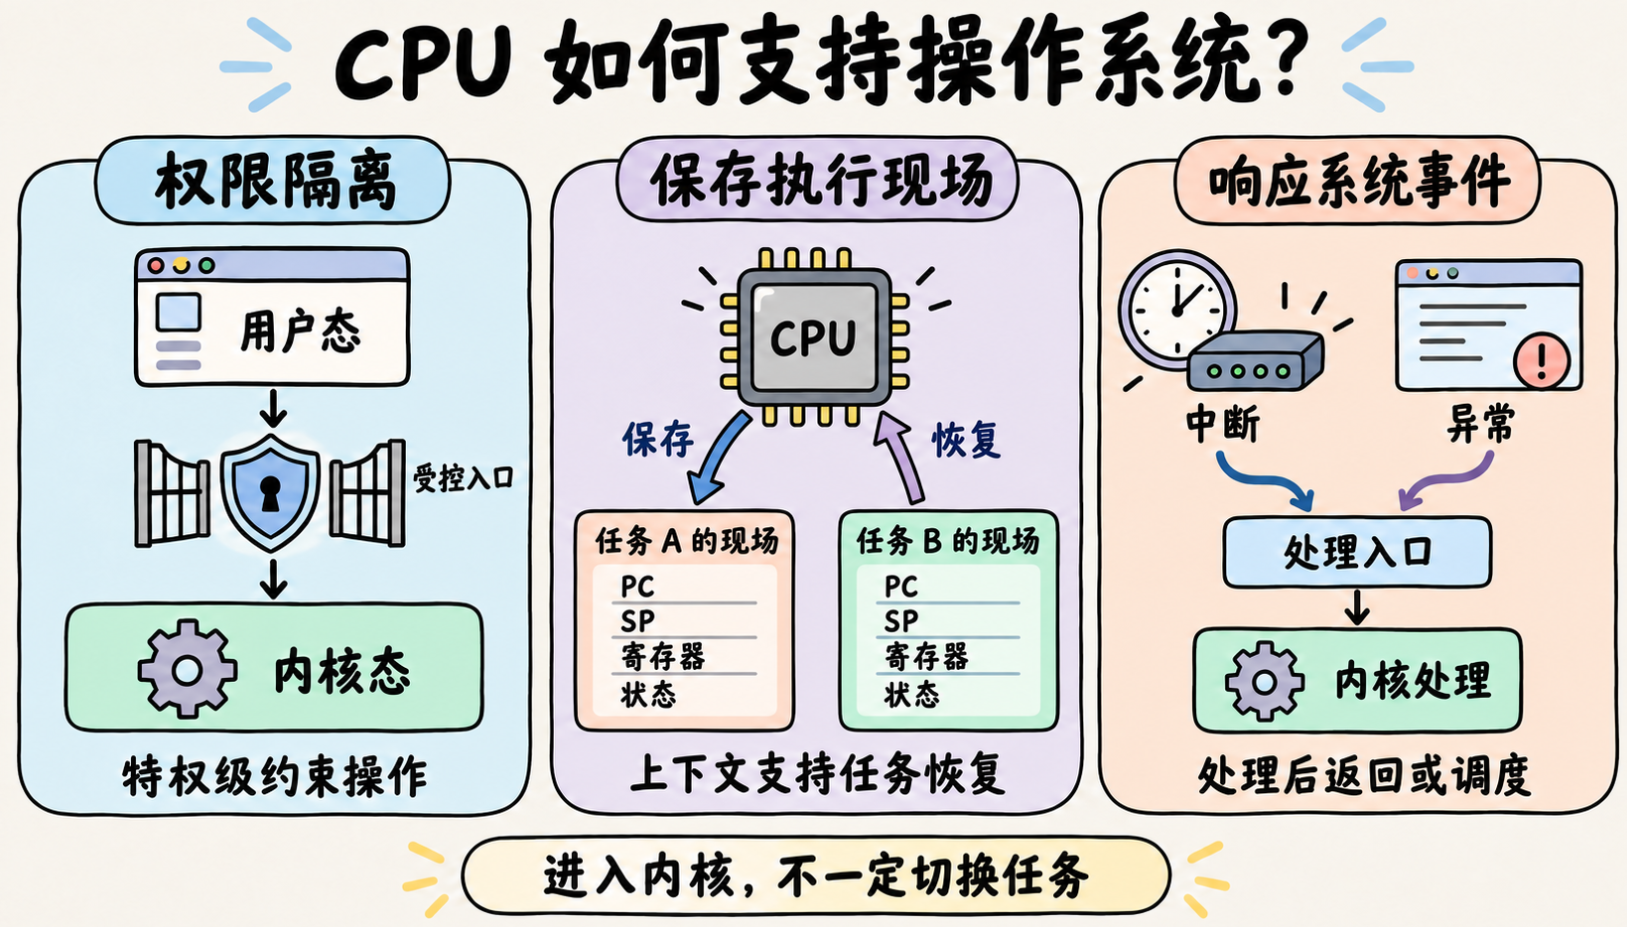
如果普通应用可以任意修改地址映射、关闭中断或覆盖内核内存,一个程序的错误就可能破坏整个系统。因此,CPU 提供不同的执行模式或特权级,让系统能够限制哪些操作可以由普通程序执行。
可以先理解为两种角色:
- 用户态:应用通常在这里运行,只能进行被允许的操作。
- 内核态:内核在这里执行受保护的系统操作,管理资源和访问权限。
应用需要读取文件、创建任务等服务时,可以通过系统调用进入内核提供的受控入口。CPU 按规定切换执行状态,内核检查请求并完成处理,再返回适当的执行位置。
这里要区分:用户态/内核态描述执行权限,用户空间/内核空间描述地址空间的划分,两者相关,但不是同一个概念。 内存隔离还需要地址转换和访问权限等机制配合,不能仅靠模式名称实现。
2. 经典 ARM 的工作模式:为什么不只有两种?
为了处理不同系统事件,经典 ARM 模型比"用户态与内核态"这组概括更细:
| 模式 | 典型用途或特点 |
|---|---|
| User | 普通用户程序,非特权模式 |
| System | 特权模式,与 User 共享通用寄存器组 |
| Supervisor,SVC | 复位、软件请求服务等相关的特权处理 |
| IRQ | 处理普通中断请求 |
| FIQ | 处理快速中断请求 |
| Abort | 处理取指或数据访问相关异常 |
| Undefined | 处理未定义指令等情况 |
这是理解 ARM9 等经典 ARM 处理器时常见的模型,不是所有 ARM 芯片统一采用的模式表。较新的体系结构还可能引入其他状态或模式。
特别是 Cortex-M 使用 Thread/Handler 等执行模型,并涉及 MSP、PSP 和 xPSR;不能把它与上述 IRQ/FIQ 模式及 CPSR 直接拼成一套寄存器模型。 xPSR 与教材中的"程序状态字"在概念上相关,但具体内容不是简单同名替换。Arm CMSIS:Cortex-M 核心寄存器
3. Banked Register:同一个 SP 名称,背后可以有不同寄存器
观察经典 ARM 寄存器图时,常会看到 R13_svc、R13_irq、R14_irq 等名字。这些不是每个任务分别拥有一颗 CPU,而是不同处理器模式可以使用不同的分组寄存器(Banked Register)。
例如,User 模式使用用户侧的 SP;进入 IRQ 模式后,CPU 使用 IRQ 对应的 SP。这样,中断处理程序就有机会使用另一块栈空间,而不会直接覆盖用户 SP。
text
User 模式                         IRQ 模式
用户侧 SP → 用户栈                SP_irq → IRQ 栈
               └── 接受中断后切换模式 ──→
在这个经典模型中,SVC、IRQ、Abort、Undefined 等异常模式有各自的 SP、LR;User 与 System 共享对应寄存器。FIQ 还拥有独立的 R8~R12,加上自己的 SP、LR,可以减少某些短中断处理流程中的保存与恢复工作。
不过,分组寄存器不等于自动完成任务上下文切换 ,也不会自动分配栈内存。栈地址仍需软件初始化;处理程序用了哪些共享寄存器、是否允许嵌套等,也会影响需要保存的状态。Arm 架构参考手册:寄存器模型
4. 中断与异常:CPU 为什么会暂停正常执行?
程序执行过程中,可能出现两类需要系统介入的事件:
| 类型 | 与当前指令的关系 | 例子 |
|---|---|---|
| 同步异常 | 由当前执行的指令或访问引起 | 系统调用指令、未定义指令、页访问故障等 |
| 异步中断 | 通常不由当前指令直接引起 | 定时器到期、网卡收到数据、设备完成 I/O |
有些体系结构把中断也统称为异常;上表是为了学习时区分事件来源。异常也不一定表示程序错误,例如系统调用本来就是有意请求内核服务。
CPU 接受中断以后,会按体系结构规定转到处理入口,并保留必要的返回状态;软件再补充保存所需现场,完成处理。
text
任务正在执行
    ↓
CPU 接受中断或检测到异常
    ↓
进入处理入口,保存必要状态
    ↓
内核处理事件
    ↓
返回原任务,或经调度后切换到其他任务
"除零是否产生异常""硬件自动保存哪些寄存器"等细节,都不能脱离具体架构和配置一概而论。
5. 多个任务怎样共享寄存器和栈指针?
对某个正在运行的执行环境而言,CPU 中呈现的是当前任务的寄存器值。假设任务 A 的栈指针指向 A 的栈,换成 B 以后,B 需要使用自己的 SP 和寄存器状态。
因此,切换的基本逻辑是:
- 保存 A 恢复执行所必需的寄存器与状态。
- 通过任务控制结构记录这些状态的保存位置。
- 根据需要切换地址空间等运行环境。
- 找到 B 的保存状态并恢复。
- 从 B 对应的位置继续执行。
上下文可能保存在内核栈、任务控制结构或其他关联区域,具体布局由系统实现决定。并不是所有系统都会把所有寄存器统一"压入用户栈"。
普通函数调用与任务切换的保存规则不同。任务可能在一条计算流程的中间被抢占,系统必须确保恢复之后不会丢失它需要的状态,包括相关条件标志等。不能笼统地说"任务切换不用保存程序状态"。
定时器中断、阻塞式系统调用等可以提供调度机会,但发生中断、进入内核,并不代表一定发生任务切换。事件处理完以后,继续运行原任务同样很常见。
6. 再往前看一点:流水线、多核与硬件多线程
CPU 还可以从不同层面提高执行效率:
| 机制 | 主要思路 | 不应混淆的地方 |
|---|---|---|
| 指令流水线 | 不同指令的取指、译码、执行等阶段重叠推进 | 主要提高吞吐能力,不保证单条指令延迟降低 |
| 多核 | 多个处理器核心各自执行指令 | 可让不同任务真正并行 |
| 硬件多线程 | 一个核心维护多个硬件线程状态,共享部分执行资源 | 多个逻辑 CPU 不等于同样数量的完整物理核心 |
软件线程是操作系统或运行时管理的执行流,硬件线程是处理器提供的执行资源。两者不是同一个层次的概念。
这部分暂时了解即可。对于操作系统,关键是认识到:可用执行资源有限,调度器需要在这些资源上安排任务,而任务之间仍要正确共享和保护数据。
四、存储层次:为什么有寄存器、Cache、主存和磁盘?
1. 速度、容量和成本不能只选最好的
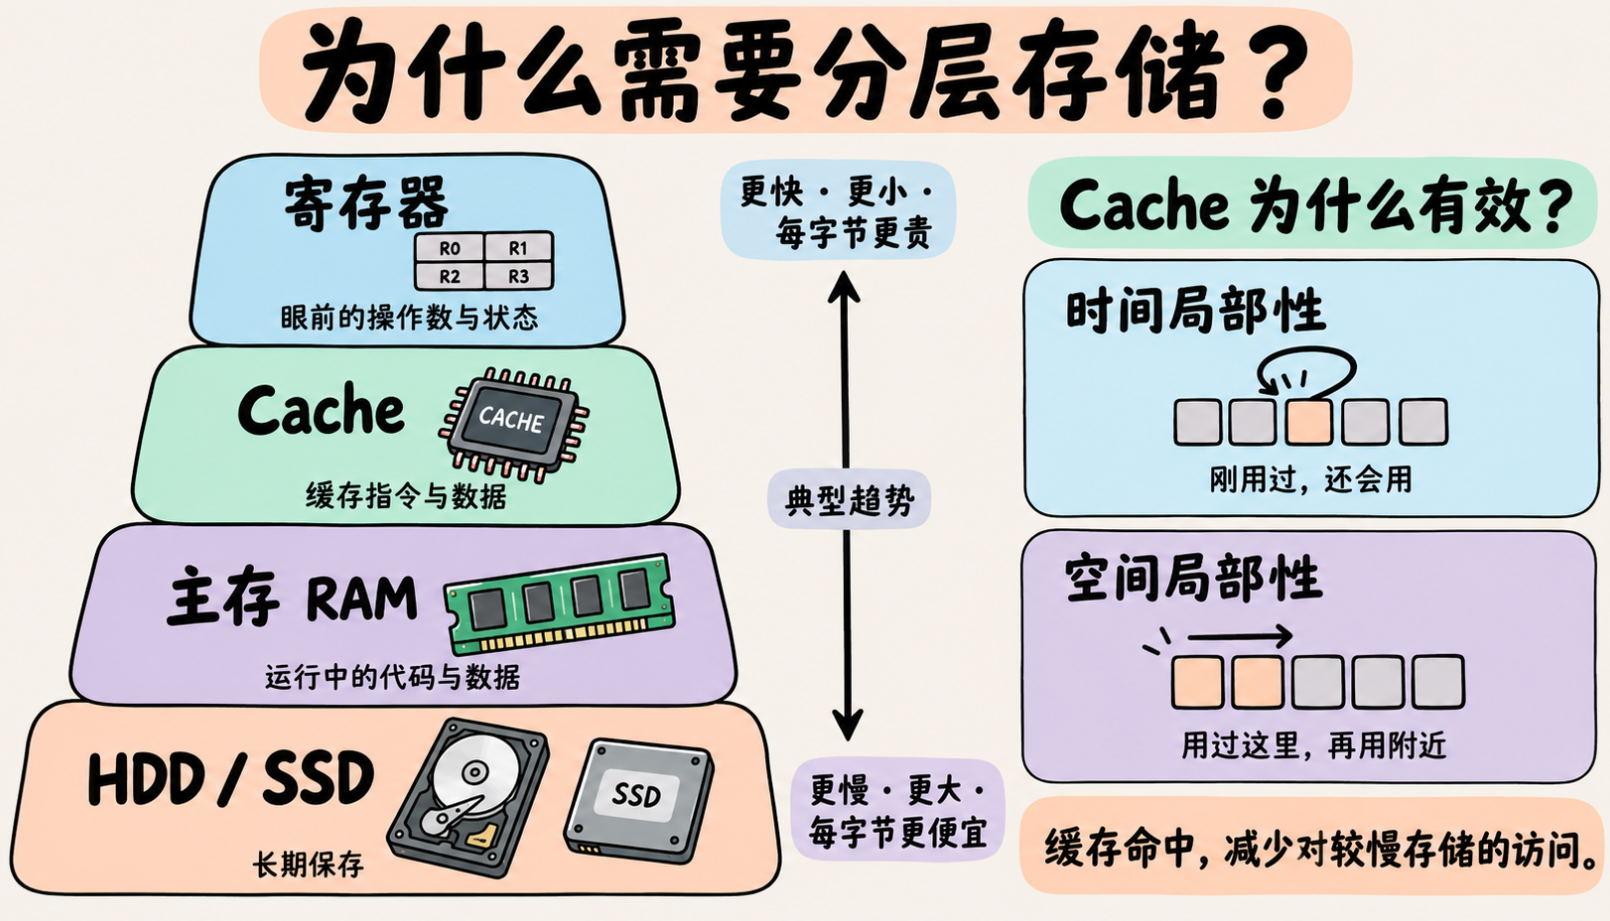
理想的存储器既要快,又要大,还要便宜。但不同存储技术存在取舍,因此计算机采用分层结构:
text
寄存器 → Cache → 主存 RAM → HDD / SSD通常越靠近 CPU 执行部件,访问延迟越低、容量越小、每字节成本越高;越往持久存储方向,容量更大、每字节成本更低,但访问延迟也更高。
这里说的是常见系统中的总体规律,不需要把某个固定延迟或容量当成所有机器都一致的参数。
| 层次 | 主要用途 | 典型特点 |
|---|---|---|
| 寄存器 | 保存正在运算的数据和执行状态 | 极小、极快,很多可由指令显式引用 |
| Cache | 缓存指令和数据,减少较慢层次的访问 | 较小、较快,普通缓存访问通常由硬件管理 |
| 主存 RAM | 承载活跃程序的代码和数据 | 容量较大,常见 DRAM 断电后丢失内容 |
| HDD / SSD | 长期保存文件与程序 | 容量大,具有非易失性 |
这不是说每次访问都必须依次读遍四层。寄存器已有数据就不必重新加载;Cache 命中也不需要再去主存;磁盘则通常通过 I/O 路径访问。
2. Cache 为什么有效:程序具有局部性
CPU 执行速度很快,如果频繁等待主存,执行效率就会受到影响。**高速缓存(Cache)**通过保存一部分指令和数据,减少访问更慢存储层的次数。
它之所以能发挥作用,是因为程序经常具有两种局部性:
- 时间局部性:刚访问过的数据,很可能很快再次访问,例如循环中反复使用的计数器。
- 空间局部性:访问一个位置后,很可能访问附近位置,例如顺序遍历数组。
Cache 通常以**缓存行(Cache Line)**为单位保存数据。很多处理器采用 64 字节缓存行,但这不是所有 CPU 必须遵循的固定值。
现代处理器还可能具有 L1、L2、L3 等多级缓存。访问一级缓存未命中,可能继续命中下一级;只有后续层次也无法满足时,才需要更远的访问。
所以,"缓存里保存经常使用的数据"只是直观理解。实际缓存行为还受到访问顺序、容量、映射和替换策略等影响。
3. 主存与外存:工作区和长期仓库
主存保存当前执行所需的代码和数据;HDD、SSD 等设备长期保存程序、照片和文档。
在常见的桌面或服务器系统中,程序启动时,系统会建立相应的内存映射,把需要的程序页放入主存。采用按需分页时,不必先把整个程序文件全部读入 RAM,再开始执行。
HDD 使用磁性盘片和磁头,访问可能包含寻道和旋转等待;SSD 通常使用闪存,没有机械寻道过程。虽然日常都被称作"硬盘",底层工作方式并不一样。
文件系统负责把持久存储中的数据组织成文件和目录,再通过块设备层、驱动等完成访问。设备的逻辑块大小、文件系统的块大小,不是必然相同的概念;更不能认为同一类设备的块大小永远一致。
五、I/O 与总线:CPU 怎样让设备替自己工作?
1. 驱动是软件,控制器是硬件
计算机通过 I/O(Input / Output,输入/输出)与外界交换数据,例如接收键盘输入、输出画面、读写存储设备或通过网卡通信。
不同设备的电气信号、协议和时序差异很大,不适合让每个应用都独立实现。因此,常见的分工是:
text
应用提出请求
    ↓
操作系统中的相关子系统
    ↓
设备驱动:准备命令、缓冲区和传输参数
    ↓
设备控制器:按硬件规则执行操作
    ↓
具体设备完成输入、输出或存储
驱动程序是软件,控制器是硬件。 CPU 执行驱动代码,按照设备规定访问寄存器、提交描述符或管理缓冲区;控制器负责落实具体的设备操作。
控制器与设备的边界因硬件而异:有的控制器位于 SoC 内部,有的在扩展卡上,有的功能由设备内部控制电路完成。它们并不一定都是主板上一颗独立的小芯片。
2. 用产生波形的例子理解"分工"
假设需要让某个引脚周期性输出高、低电平。CPU 可以执行代码反复翻转 GPIO,并用忙等待控制间隔。
这种方式可能占用大量 CPU 时间,也容易受到中断、调度等因素影响。它并不必然导致死机;真正的问题是时序控制成本较高。操作系统中的睡眠调用通常会让当前线程让出 CPU,也不能简单等同于裸机忙等待。
如果硬件有定时器或 PWM 外设,软件可以先配置周期、占空比和输出使能,然后由外设按配置自动产生波形。
text
CPU 设置参数 → 定时器 / PWM 持续输出波形
      ↓
CPU 可以继续执行其他工作控制器的价值正在这里:把重复、专门或对时序敏感的工作交给适合的硬件,减少 CPU 的逐步参与。
3. 操作完成以后,CPU 怎么知道?
常见方式包括轮询和中断:
- 轮询:软件反复检查状态,判断操作是否完成。
- 中断:设备在需要关注时发出通知,让 CPU 有机会执行处理程序。
对于较大数据传输,还可以使用 DMA(Direct Memory Access,直接内存访问):CPU 设置传输条件,DMA 控制器或具备相应能力的设备在授权范围内搬运数据,CPU 不必逐字节执行复制指令。
数据往往被放入主存缓冲区,并不一定全部留在控制器的数据寄存器里。驱动还可能需要处理地址映射、缓存一致性和传输完成状态等问题。
轮询、中断、DMA 也不是简单的三选一。一个设备可以通过 DMA 搬运数据,再用中断通知完成;某些高负载场景也会结合轮询使用。
4. 内存映射 I/O:有地址,不代表那就是 RAM
在采用**内存映射 I/O(MMIO)**的系统中,部分地址范围对应设备寄存器。CPU 对这些地址执行加载、存储操作,就可以与控制器交互。
因此,一个物理地址空间可以同时包含:
text
物理地址空间
├── RAM 对应的区域
├── 设备寄存器对应的区域
├── 固件等其他映射区域
└── 保留区域
准确说法是"地址空间中有 RAM 和设备映射",而不是"内存条分成数据内存和控制器"。设备访问还可能具有读写副作用,通常需要设置合适的设备内存属性,不能随意把它当成普通、可缓存的 RAM。
5. 总线与互连:命令和数据走哪条路?
CPU、内存和设备之间需要传输地址、数据和控制信息,总线与互连就是它们交换信息的基础设施。
教学时可以把它们画成连接多个部件的公共通道,但现代系统通常有多种连接方式:内存通道、片上互连、PCIe、USB 等承担不同职责,有些采用点对点链路,而不是所有设备共享一根线。
把一次设备操作串起来看,就很清楚了:驱动发出请求,CPU 通过相应互连访问控制器,控制器与设备完成交互,再通过状态或中断反馈结果。
6. 32 位系统为什么能使用 16 GB 的 U 盘?
先明确一个计算前提:如果一个地址空间使用 32 位地址,而且按字节编址,那么它包含:
text
2^32 字节 = 4,294,967,296 字节 = 4 GiB这描述的是对应地址空间的大小,不是外部存储设备的容量上限,也不能直接把"32 位 CPU"理解为"物理地址永远只有 32 位"。例如,x86 的 PAE 可以在受支持的处理器和系统上扩展可访问的物理内存,而不扩大单个 32 位进程的虚拟地址空间。
U 盘的数据不是作为一个必须完整占据 CPU 地址空间的巨大内存数组来访问的。以块存储为例,软件可以发出"读取某些逻辑块"的命令,再把结果分批传入 RAM 中的缓冲区。Microsoft:Physical Address Extension
text
16 GB U 盘中的数据
        ↓ 指定逻辑块并发出读取请求
控制器传输本次需要的数据
        ↓
RAM 中的一块缓冲区
        ↓
程序处理数据,然后继续读取下一批因此,内存地址空间与存储设备容量是不同维度的限制。能否完整使用某个设备,还要看存储协议、驱动、分区方式和文件系统等是否支持。
部分 32 位系统安装 4 GiB RAM 后可用容量较少,也与设备地址映射、硬件和系统版本限制有关,不能简单概括成"32 位电脑安装 4 GB 内存一定浪费"。
六、MMU:程序看到的地址怎样找到真实内存?
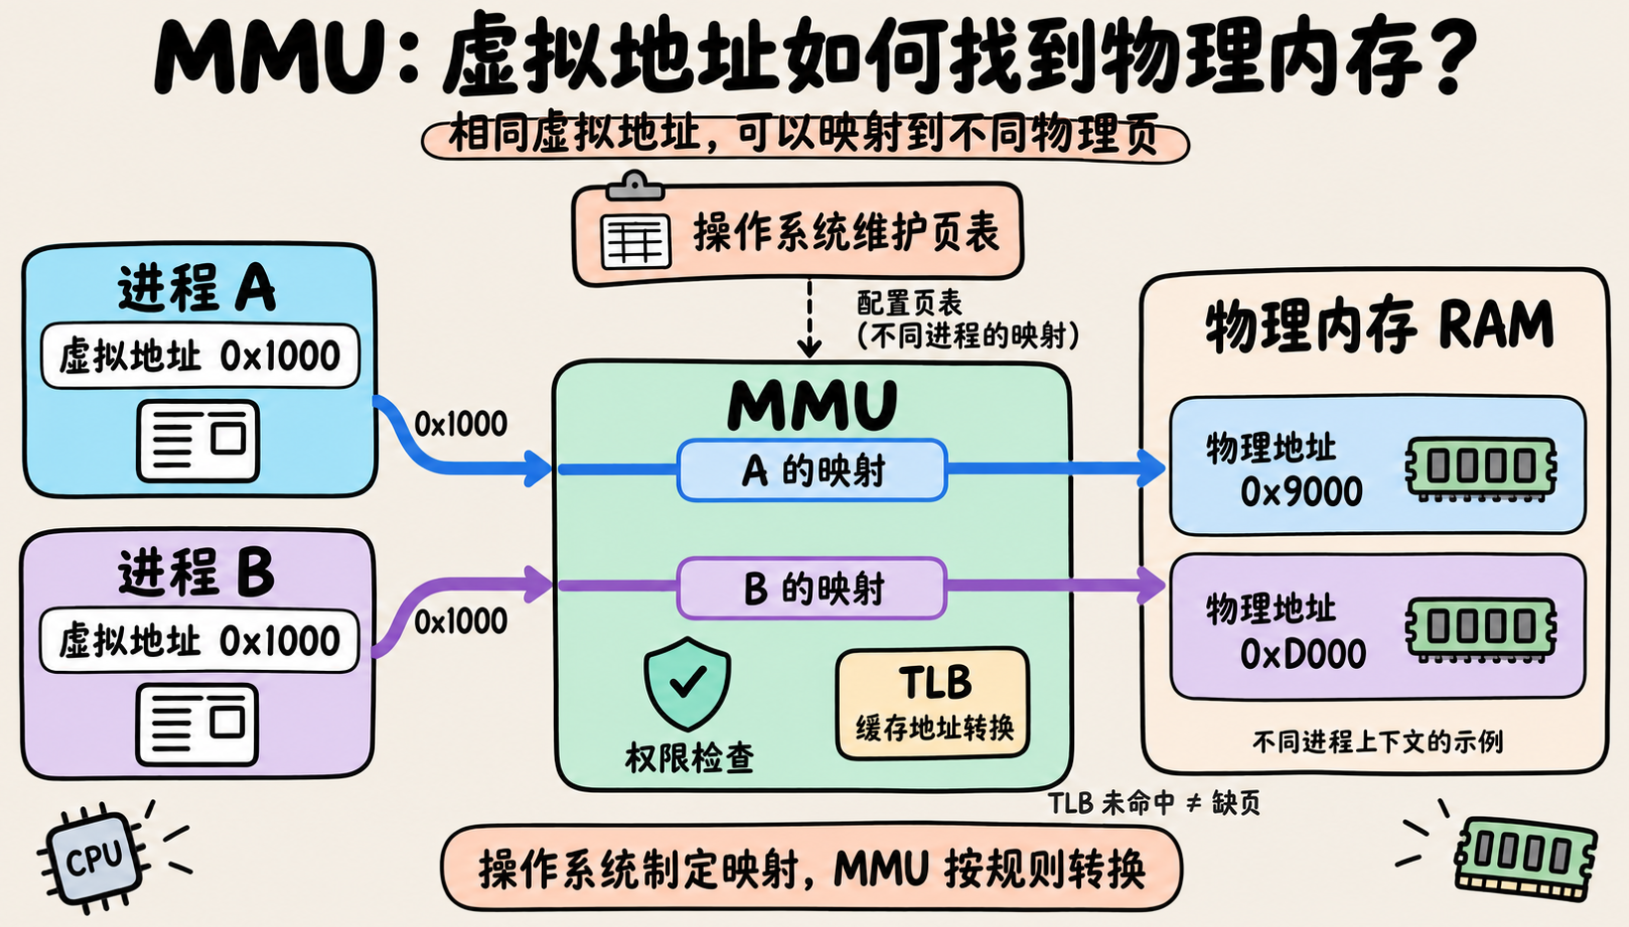
1. 为什么要让程序使用虚拟地址?
多个程序同时运行时,如果大家都直接管理真实 RAM 地址,就很难方便地隔离、搬移和共享内存。
常见的通用操作系统为进程提供虚拟地址空间。程序主要使用自己的虚拟地址,系统再把它映射到适当的物理位置。
这样,不同进程里相同的地址数值,也可以对应不同的物理内存:
text
进程 A:虚拟地址 0x1000 → 物理地址 0x9000
进程 B:虚拟地址 0x1000 → 物理地址 0xD000
这些只是便于说明的示例。若系统有意建立共享映射,不同进程也可以映射到同一物理页。
2. OS 制定映射,MMU 执行转换
MMU(Memory Management Unit,内存管理单元) 是参与地址转换和访问权限检查的硬件部件。
在常见分页系统中,分工可以概括为:
- 操作系统:建立和维护页表,决定映射关系、访问权限和内存属性。
- MMU:依据这些规则,在运行时完成地址转换及相关检查。
- TLB:缓存部分地址转换结果,减少重复查找页表的开销。
程序正常访存时,通常不需要每次都进入内核、让操作系统软件手工算一遍物理地址。硬件按已设置的规则处理常见路径;缺页或权限违规等情况,才可能触发异常并交给系统处理。MMU 除了转换地址,也参与访问保护和内存属性控制。AMD Zynq-7000 技术手册:MMU
3. 缺页不等于"程序一定写错了"
访问某个虚拟页时,如果所需映射尚未就绪,系统可能按需分配内存或从存储设备读入数据,再让程序继续执行。这可以是正常的按需分页行为。
如果访问本身不合法,例如写入只读页,系统则可能向程序报告错误或终止它。
另外,TLB 未命中不等于缺页。TLB 里没有记录,只能说明转换缓存没有命中;页表中仍可能存在合法、有效的映射。
Cache 与 TLB 也别混淆:前者主要缓存指令或数据,后者缓存地址转换信息。它们都能减少等待,但缓存的是不同内容。
虚拟内存也不只是"把磁盘当内存"。地址空间抽象、映射、隔离和共享都是它的重要作用,换入换出只是某些系统采用的机制之一。并且,并非所有嵌入式 CPU 都带有这类 MMU,不能把通用操作系统的内存模型套到所有单片机上。
七、把硬件与操作系统联系起来
回看这些部件,会发现它们分别解决了程序运行中的不同问题:
| 硬件基础 | 对操作系统的意义 |
|---|---|
| 寄存器、PC、SP 和状态寄存器 | 描述执行现场,为恢复任务提供基础 |
| 特权级与受控入口 | 限制普通应用的权限,保护核心系统操作 |
| 中断与异常 | 让系统及时处理外部事件和执行中的特殊情况 |
| Cache 与主存 | 平衡数据访问速度、容量和成本 |
| 控制器与 DMA | 分担设备控制与数据传输工作 |
| 总线与互连 | 连接 CPU、存储和外设 |
| MMU 与 TLB | 支持高效的地址转换与访问保护 |
学习操作系统时,可以反复使用一个问题检查自己是否理解:这个软件机制依靠了什么硬件能力,又在硬件之上增加了什么管理规则?
调度器决定谁运行,寄存器状态让任务能够恢复;内核决定谁能访问哪些内存,MMU 执行映射与权限检查;应用请求读取文件,文件系统、驱动和控制器共同完成数据访问。把这些关系接起来,进程、内存和 I/O 就不再是互不相关的章节。
如果这篇文章对你有帮助,欢迎点赞、评论、关注、收藏。你们的支持是我前进的动力!