前言
上篇文章介绍了数据治理的完整流水线:先用 MinerU 把 PDF、docx 等异构文档统一解析成Markdown格式,再调用多模态模型把图片替换为语义描述,最后依次完成去重、质量过滤和隐私脱敏三道清洗工序。如果大家跟着笔者实操下来,手里应该已经有了一批结构清晰的Markdown文档啦~
但干净的文档还不等于可以直接训练的数据集。一篇博士论文动辄十几万字,一篇漏洞分析可能只有三五百字,篇幅长短不一。大家都知道大模型的上下文长度是有限的,预训练阶段期望接收的是一条条规整的文本单元。本篇笔者要分享的就是如何将转化后的markdown文档切成合适的语义块并组装成LLamaFactory开箱即用的预训练数据集。
一、认识预训练切片
笔者知识库相关的文章中 一文带你了解RAG核心原理!不再只是文档的搬运工 和 RAG系统效果不达预期?一定要看看这篇详细高效的优化指南!分享过固定长度、递归、文档结构等几种分块算法。不过那两篇的背景是RAG知识库,现在面对预训练场景下的文本切片,目标不同,参数取法也略有不同。
1.1 为什么不能把整篇文档喂给模型?
原因主要有以下三点:
- 长度差异过大: 书籍章节、CVE 描述、短篇资讯的篇幅相差数百倍,直接一股脑全篇学习会导致大模型在批处理数据时样本长度严重不齐,短文本被大量填充符浪费算力。
- 模型存在上下文上限: 预训练配置里的
cutoff_len(大模型上下文长度,笔者在 大模型训练全流程实战指南工具篇(十)------ 小白也能懂的大模型训练参数万字详解 中介绍过该参数)决定了每次送入大模型的token长度,超长文档必须断开。 - 知识单元需要边界: 切片本质上是在告诉模型"这是一段相对完整的知识",边界切得合理,模型学到的上下文依赖才完整。
1.2 切片大小和上下文重合怎么定?
首先是切片长度会有些许不同,RAG中切片通常只有三五百字,因为RAG切片只承载"答案片段",靠检索命中;而预训练要让模型读懂完整的论述过程,块长建议要放宽到1000-2000字符。
上下文重合长度也略有不同,RAG中的overlap是为了方便检索时关键句被拦腰截断,而预训练中重叠的内容会被模型重复学习,重合过大既浪费token又容易造成局部过拟合,所以一般不需要重合
下面是笔者在处理本次网络安全预训练数据时使用的具体参数:
| 参数 | 笔者取值 | 作用与注意事项 |
|---|---|---|
块长 |
1500 字符 | 目标块长。太小语义会被切碎,太大长短样本失衡 |
最小块长 |
100 字符 | 小于该长度的文本块并入上一块,避免文本过短造成的残片 |
| 单节最大切片数 | 20 | 超过则告警,多半是塞进了整页表格或代码,需要人工看一眼 |
二、Markdown结构化切片实战
2.1 切片器的设计思路
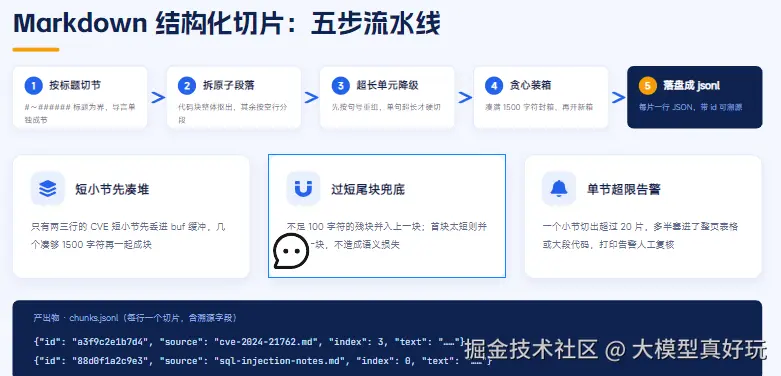
当前大家手里已经有统一的markdown语料,markdown格式的标题层级是天然的切片依据,只需要在它的基础上完成如下操作:
首先定义后面反复用到的正则,用来匹配标题和代码片段:
python
import os, re, glob, json, hashlib

INPUT_DIR = "./cleaned_md"                    # 第15篇产出的干净 Markdown 目录
OUTPUT_DIR = "./llamafactory_data"
CHUNK_PATH = os.path.join(OUTPUT_DIR, "chunks.jsonl")

CHUNK_SIZE, MIN_SIZE = 1500, 100
MAX_SLICES = 20                               # 单节切片数告警阈值

HEADING_RE = re.compile(r"^(#{1,6})\s+.+$", re.MULTILINE)
FENCE_RE = re.compile(r"```.*?```", re.DOTALL)
接下来按标题切分,以 #~###### 标题为边界把文档拆开,标题行保留在小节开头;另外很多文档在第一个标题之前还有一段导言,也要单独留出来:
python
def split_sections(md_text):
    """按标题切成小节,每节保留标题行;标题前的导言单独成节"""
    matches = list(HEADING_RE.finditer(md_text))
    if not matches:
        return [("", md_text.strip())]
    sections = []
    if matches[0].start() > 0:
        head = md_text[: matches[0].start()].strip()
        if head:
            sections.append(("", head))
    for i, m in enumerate(matches):
        end = matches[i + 1].start() if i + 1 < len(matches) else len(md_text)
        sections.append((m.group(0).strip(), md_text[m.start():end].strip()))
return sections然后再把拆分的小节进一步拆分为段落,一个小节可能由多段内容组成,不同段落之间通过空行来区分。不过这里要注意的是一些代码块中存在# 开头的注释行,也存在空行,因此应该先用正则将每段代码整块抠出来,再对剩余的内容按空行切分成段落:
python
def atomic_paragraphs(block):
    """拆出段落:代码块整体保留,其余按空行拆"""
    units, cursor = [], 0
    for m in FENCE_RE.finditer(block):
        for p in re.split(r"\n\s*\n", block[cursor:m.start()]):
            if p.strip():
                units.append(p.strip())
        units.append(m.group(0).strip())   # 围栏作为一个整体单元
        cursor = m.end()
    for p in re.split(r"\n\s*\n", block[cursor:]):
        if p.strip():
            units.append(p.strip())
    return units
经过上述拆分后的部分段落可能由于过分冗长,导致超过了长度限制,此时需要对长段落进一步处理,先按句号拆分成句子,再重新凑成 1500 字一组,能不切开句子就不切;万一某个句子单独就超过 1500 字,才按字数硬切:
python
def split_oversized(unit, size, overlap):
    """单个超长单元:先按句子降级,单句仍超长才硬滑窗;代码块不切"""
    if unit.lstrip().startswith("```"):
        return [unit]
    sents = re.findall(r".+?[。!?;\n.!?;]+", unit, flags=re.DOTALL) or [unit]
    pieces, buf = [], ""
    for s in sents:
        if len(s) > size:
            if buf:
                pieces.append(buf)
                buf = ""
            for i in range(0, len(s), size - overlap):
                pieces.append(s[i:i + size])
        elif len(buf) + len(s) <= size:
            buf += s
        else:
            pieces.append(buf)
            buf = (buf[-overlap:] if overlap else "") + s
    if buf:
        pieces.append(buf)
return pieces除了过长的情况,也可能出现某些段落的长度较短,小于设定的chunk_size,这时候就需要使用贪心算法遍历段落,如果下一段加入后还未超过chunk_size,就与上一段放在一个切片中;如果加入会超限制就新开一个切片,实现代码如下:
python
def pack_units(units, size):
    """把原子段落贪心装入块,放不下就封箱开新箱;超长单元先切后入库"""
    windows, cur = [], []

    def flush():
        if cur:  # 空箱子不封箱,否则会混进空切片
            windows.append("\n\n".join(cur))
            cur[:] = []

    for unit in units:
        if len(unit) > size:
            flush()
            windows.extend(split_oversized(unit, size))
            continue
        if not cur or len("\n\n".join(cur)) + 2 + len(unit) <= size:
            cur.append(unit)
        else:
            flush()
            cur.append(unit)
    flush()
    return windows
以上针对不同情况的文档处理函数编写完成后,就可以编写编排整篇文档的函数了。一篇文档里,大节、小节往往混在一起:比如一个 CVE 描述可能只有两三行,单独成 chunk 太短。笔者给这些短小节准备了一个 buf 数组:短小节先丢进 buf,几个凑够 1500 字后再一起成 chunk;遇到长小节时,先清空 buf,再让长小节按上面的规则自行切分。要是某个小节一口气切出 20 个以上 chunk,多半是里面塞了整页表格或大段代码,程序会打印一条告警,提醒人工检查:
python
def chunk_markdown(md_text, source):
    chunks, buf = [], []
    for title, block in split_sections(md_text):
        if len(block) >= CHUNK_SIZE:
            if buf:  # 先吐出积攒的短小节
                chunks.extend(pack_units(buf, CHUNK_SIZE))
                buf = []
            slices = pack_units(atomic_paragraphs(block), CHUNK_SIZE)
            if len(slices) > MAX_SLICES:
                print(f"[告警] {source} 小节《{title[:20]}》切出 {len(slices)} 片,请人工检查")
            chunks.extend(slices)
        else:
            buf.append(block)
            if len("\n\n".join(buf)) >= CHUNK_SIZE:
                chunks.append("\n\n".join(buf))
                buf = []
    if buf:
        chunks.extend(pack_units(buf, CHUNK_SIZE))

    merged = []  # 过短块优先并入上一块
    for c in chunks:
        if merged and len(c) < MIN_SIZE:
            merged[-1] += "\n\n" + c
        else:
            merged.append(c)
    if len(merged) > 1 and len(merged[0]) < MIN_SIZE:
        merged[1] = merged[0] + "\n\n" + merged[1]  # 首块没有上一块,只能并入下一块
        merged = merged[1:]

    records = []
    for i, text in enumerate(merged):
        cid = hashlib.md5(f"{source}-{i}-{text[:64]}".encode()).hexdigest()[:12]
        records.append({"id": cid, "source": source, "index": i, "text": text})
    return records
上面这段逻辑还有一个兜底,处理完chunk后还会遇到一些零碎的不足最小字数的chunk,这时候直接丢弃还是会造成语义损失,笔者一般会将这些小chunk并入前一个chunk的末尾;如果这些小chunk的前一个chunk也比较短(比如文档开头的导言只有几十个字),那就只能将其并入下一个chunk的头部。为了信息的完整最后给每个chunk算一个 id,并记下它来自哪个文件、排第几,后面判别环节淘汰任何一张卡片,都能顺着这两个字段找回原文。
最后编写入口函数,遍历目录下的所有markdown文档,逐篇切片,每张卡片写成一行JSON存进 chunks.jsonl:
python
def run_chunk():
    files = glob.glob(os.path.join(INPUT_DIR, "**", "*.md"), recursive=True)
    total = 0
    with open(CHUNK_PATH, "w", encoding="utf-8") as f:
        for path in files:
            with open(path, encoding="utf-8") as fp:
                records = chunk_markdown(fp.read(), os.path.basename(path))
            for r in records:
                f.write(json.dumps(r, ensure_ascii=False) + "\n")
            total += len(records)
    print(f"文档 {len(files)} 篇,产出切片 {total} 个 -> {CHUNK_PATH}")
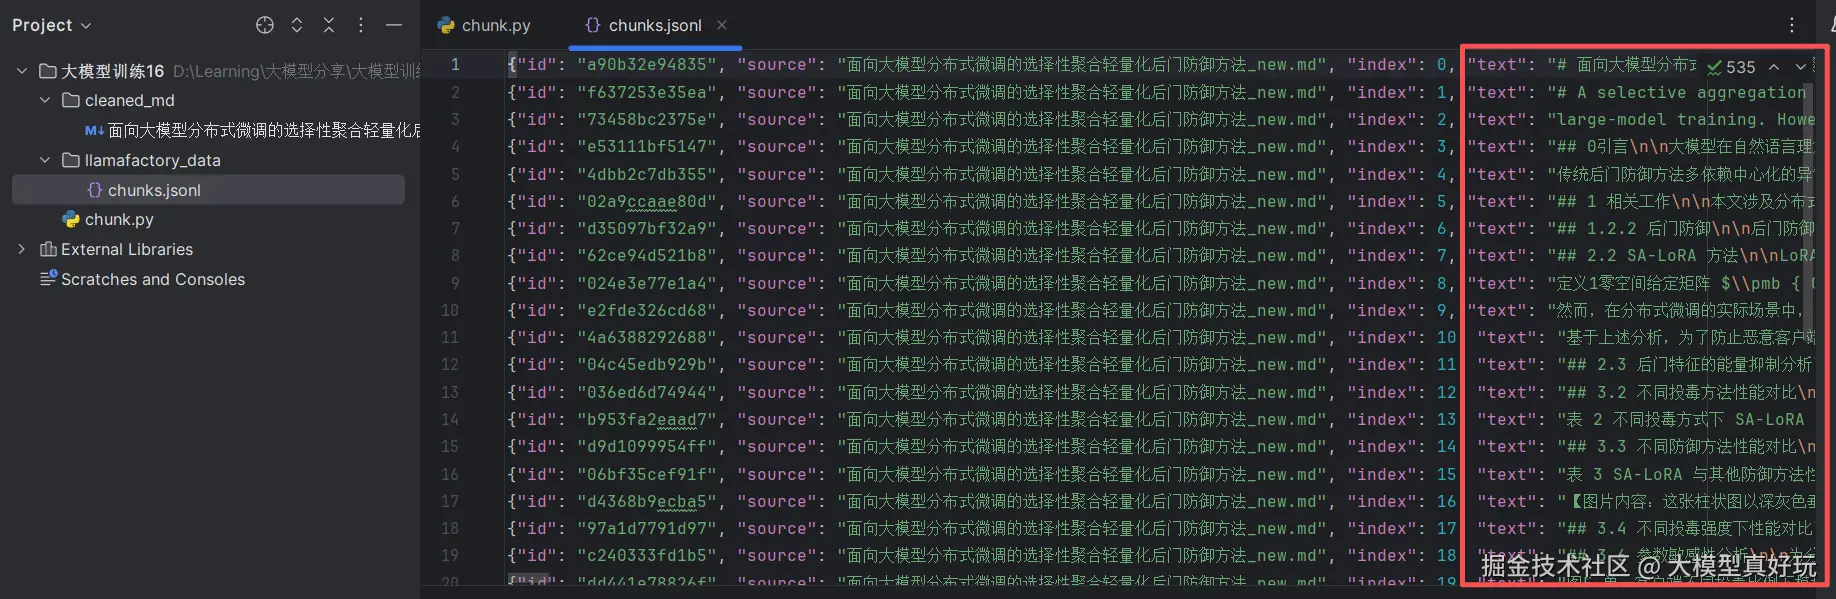
最后测试一下脚本效果:在指定目录下放入一份处理完成的 Markdown 文档,执行脚本后可以看到,指定文件夹内的 md 文档已经被切分成切片;检查切片内容,整体也比较完整。
2.2 中间产物抽检
运行完成如上代码之后会得到一个chunks.jsonl的文件,每行表示一个切片。建议运行完成后任意抽几条人工看看,确认一下标题有没有与正文正确衔接、代码块是否完整、参考文献区有没有混进来等不合理的地方,这一步的中间产物抽检能够帮助检查一下切片策略的参数合不合理,有不合理的地方再调整。
三、大模型判别切片
3.1 为什么切片还需要进一步大模型判别?
大家可能会问上篇文章已经做过大模型的文章质量判别,为什么还需要对切片再过一次大模型?主要是因为上篇文章还是文档级别的筛选,即使是合格的文档切片后也会出现一些新问题,比如论文正文质量很高,但末尾的参考文献列表、致谢、作者简介会被切成独立的小块;表格被分页截断后,某个切片可能只剩半张表头;OCR 残留的公式符号堆也可能集中在某一块里。这些碎片在整篇文档中占比很小,文档级过滤感知不到,切块后却成了独立样本,必须再筛一遍。
3.2 规则前置,模型兜底
鉴于工作实践中往往会考虑到节约成本,不会将每个切片都用大模型提示词过滤,一般会先用规则匹配快速筛除残片,只有拿不准的切片才交给大模型判别。具体代码如下:
python
DROP_TITLES = ("参考文献", "References", "致谢", "Acknowledgement",
               "目录", "作者简介", "版权声明", "版权所有")

def rule_filter(rec):
    """返回 (是否保留, 原因)"""
    text = rec["text"]
    plain = re.sub(r"[\s#>*\-|`\[\]()]", "", text)
    if len(plain) < MIN_SIZE:
        return False, "有效字数过少"
    first_line = next((ln for ln in text.splitlines() if ln.strip()), "")
    if any(k in first_line for k in DROP_TITLES):
        return False, f"无价值章节:{first_line[:20]}"
    lines = [ln for ln in text.splitlines() if ln.strip()]
    cite_hits = sum(bool(re.search(r"https?://|\[\d+\]|arxiv|doi", ln)) for ln in lines)
    if lines and cite_hits / len(lines) > 0.5:
        return False, "疑似参考文献/链接列表"
    symbol_ratio = len(re.findall(r"[^\w\s\u4e00-\u9fa5]", text)) / max(len(text), 1)
    if symbol_ratio > 0.35:
        return False, "特殊符号占比过高,疑似乱码"
    return True, ""
这四条规则分别对应字数残片、关键字匹配的无价值章节、参考文献列表和乱码情况。经过规则匹配后,再将剩余段落交给大模型,从多个维度进行评判。笔者一般会采用以下三个判别维度:
- 完整性: 标题后没有正文、半截表格、被截断的公式或代码,均可判别为不合格。
- 关联性: 广告导流、网站导航等与安全技术无关的内容。
- 洁净度: 残留乱码、无意义符号堆砌和排版噪声等。
针对以上三个维度编写的简单提示词如下。大模型服务沿用上一篇使用的阿里云百炼平台:
python
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from openai import OpenAI

JUDGED_PATH = os.path.join(OUTPUT_DIR, "chunks_judged.jsonl")
MAX_WORKERS = 8

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY", ""),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

JUDGE_PROMPT = """你是网络安全领域的语料质量审核员。请判断以下文本切片是否适合作为大模型预训练语料。

评估维度:
1. 完整性:不是标题残片、半截表格、被截断的公式或代码
2. 相关性:包含网络安全或计算机技术的实质知识,而非广告、导航、致谢、参考文献列表
3. 洁净度:无 OCR 乱码、无意义符号堆砌、无导流信息

只输出 JSON:{"keep": 1或0, "score": 0到10的整数, "reason": "简短理由"}"""


def judge_with_retry(rec, retries=3):
    for attempt in range(retries):
        try:
            resp = client.chat.completions.create(
                model="qwen-plus",
                messages=[{"role": "user",
                           "content": JUDGE_PROMPT + "\n---\n" + rec["text"][:3000]}],
                response_format={"type": "json_object"},
                temperature=0,
            )
            data = json.loads(resp.choices[0].message.content)
            rec.update(keep=bool(data.get("keep")), score=data.get("score", 0),
                       judge_reason=data.get("reason", ""))
            return rec
        except Exception as e:
            if attempt == retries - 1:
                rec.update(keep=True, score=-1, judge_reason=f"判别失败保留:{e}")
                return rec  # 失败默认保留,避免接口抖动误杀数据
            time.sleep(2 ** attempt)


def load_jsonl(path):
    if not os.path.exists(path):
        return []
    with open(path, encoding="utf-8") as f:
        return [json.loads(line) for line in f if line.strip()]


def run_judge():
    chunks, results = load_jsonl(CHUNK_PATH), load_jsonl(JUDGED_PATH)
    done_ids = {r["id"] for r in results}
    todo = []
    for rec in chunks:
        if rec["id"] in done_ids:
            continue
        ok, why = rule_filter(rec)
        if not ok:
            rec.update(keep=False, score=0, judge_reason="规则过滤:" + why)
            results.append(rec)
        else:
            todo.append(rec)

    with ThreadPoolExecutor(MAX_WORKERS) as pool:
        futures = {pool.submit(judge_with_retry, r): r for r in todo}
        for i, fut in enumerate(as_completed(futures), 1):
            results.append(fut.result())
            if i % 100 == 0:  # 每100条落盘一次,中断后可续跑
                with open(JUDGED_PATH, "w", encoding="utf-8") as f:
                    for r in results:
                        f.write(json.dumps(r, ensure_ascii=False) + "\n")
                print(f"已判别 {i}/{len(todo)}")

    with open(JUDGED_PATH, "w", encoding="utf-8") as f:
        for r in results:
            f.write(json.dumps(r, ensure_ascii=False) + "\n")
    dropped = sum(1 for r in results if not r.get("keep"))
    print(f"判别完成:共 {len(results)} 片,剔除 {dropped} 片")
执行结果如下,对于刚才得到的 31 个切片,剔除了其中 15 个。
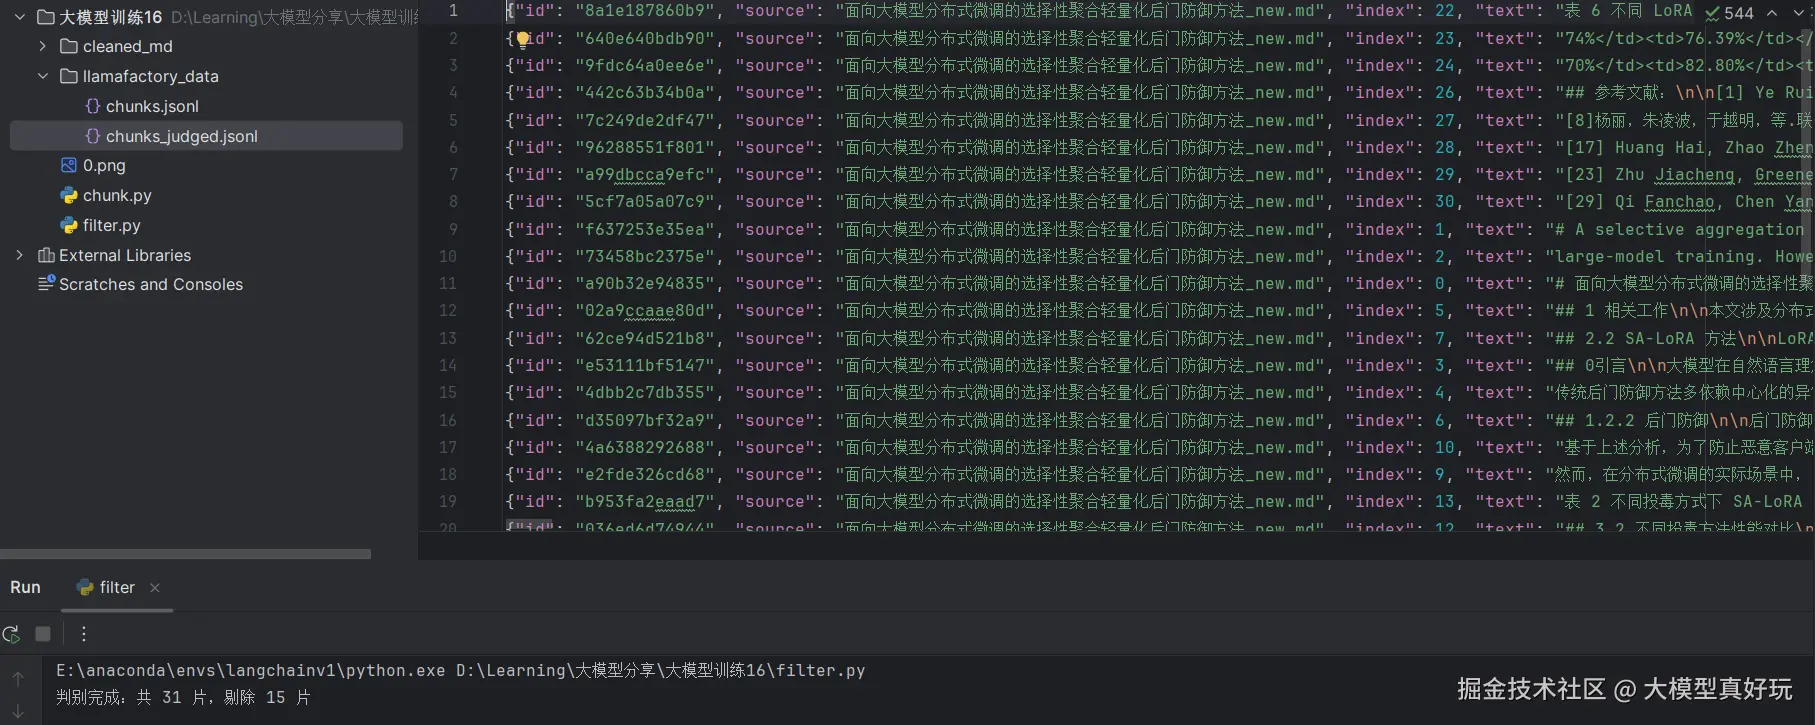
LLamaFactory 预训练数据集的格式非常简单:JSONL 文件每行一个 JSON 对象,对象中只需要一个 text 字段存放文本。如果大家有遗忘,可以回顾文章 大模型训练全流程实战指南工具篇(五)------大模型训练全流程步骤详解与对应工具推荐 中的数据格式。只要把上面处理得到的 chunks_judged.jsonl 文件中每行的 text 字段提取出来,就可以组织为数据。具体的预训练过程,笔者会在下篇文章中详解,同时说明预训练需要注意的相关事项。
以上就是本篇文章的全部内容。本文完整代码可关注笔者同名公众号:大模型真好玩 ,并私信 大模型训练 免费获取。
四、总结
本篇围绕预训练数据集的构建,先明确了预训练切片与 RAG 分块的目标差异,给出了块长、最小块长等参数建议;随后通过 Markdown 标题切分、段落原子化、超长单元降级、贪心装箱等步骤,实现了结构化切片;最后采用"规则前置、模型兜底"的策略,对切片进行质量判别,最终得到 LLamaFactory 可直接使用的 chunks_judged.jsonl。下一篇笔者将正式进入预训练实战,详细讲解LLamaFactory预训练过程及需要注意的关键事项,大家敬请期待~
除大模型训练外,笔者也在同步更新《深入浅出LangChain&LangGraph AI Agent 智能体开发》免费专栏,要说明该专栏适合所有对 LangChain 感兴趣的学习者,无论之前是否接触过 LangChain。该专栏基于笔者在实际项目中的深度使用经验,系统讲解了使用LangChain/LangGraph如何开发智能体,目前已更新 50 讲,并持续补充实战与拓展内容。欢迎感兴趣的同学关注笔者的掘金账号与专栏,也可关注笔者的同名微信公众号大模型真好玩 ,每期分享涉及的代码均可在公众号私信: LangChain智能体开发免费获取。