第 24 章 参数体系与调优
本章要解决的问题
temperature 到底该设 0 还是 0.7?线上环境还有几十个配置参数------哪些必须配、怎么调才能又快又准又省钱?
章节大纲
- 24.1 模型调用常用参数(temperature / top_p / max_tokens / stop / penalty / seed / stream)
- 24.2 中文主流模型参数差异对照(DeepSeek / Qwen / 豆包 / 混元 / GPT 系)
- 24.3 Agent 引擎参数(max_iterations / tool_choice / 重试 / 并发 / 上下文分配)
- 24.4 企业级应用配置参数(限流 / 熔断 / 缓存 / 超时分层 / 安全 / 可观测 / 配置中心)
- 24.5 调优方法论:五步法(基线 → 单因素 → 组合优化 → 回归 → 灰度)
- 24.6 调优技术:网格搜索 / 贝叶斯优化 / 场景化调优(幻觉抑制 / 延迟 / 成本)
24.1 模型调用常用参数
参数总览
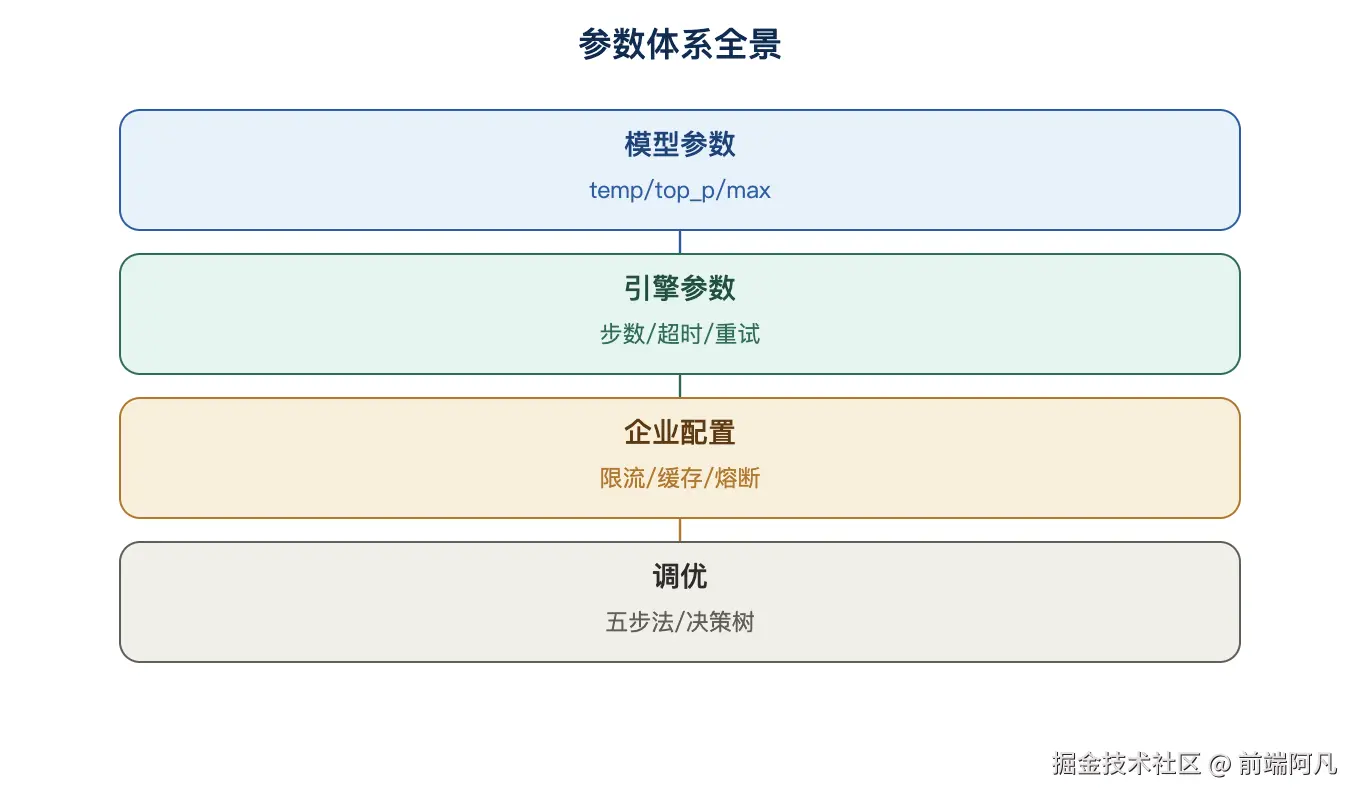
图 1:参数体系全景
| 参数 | 作用 | 取值范围 | 常见默认 | 调大 → | 调小 → | 注意 |
|---|---|---|---|---|---|---|
temperature |
输出随机性 | 0 ~ 2(多数 0~1) | 1.0 | 更发散、更易幻觉 | 更确定、易复现 | 建议与 top_p 二选一调 |
top_p |
核采样:累积概率截断 | 0 ~ 1 | 1.0 | 词汇池更大 | 更聚焦 | 建议与 temperature 不同时调 |
top_k |
只从前 K 候选采样 | 1 ~ 数百 | 视模型 | 候选更多 | 更保守 | OpenAI 系不支持 |
max_tokens |
单次生成最大长度 | 1 ~ 模型上限 | 视模型 | 更长输出 | 更省、更快 | 企业级必须设置 |
stop |
停止序列 | 字符串/数组 | 空 | --- | --- | 结构化输出收尾 |
frequency_penalty |
按频率惩罚 | -2 ~ 2 | 0 | 抑制重复 | 更易重复 | 代码/JSON 建议 0 |
presence_penalty |
按出现惩罚 | -2 ~ 2 | 0 | 引入新话题 | 守话题 | 客服可 +0.3~0.6 |
seed |
固定随机种子 | 整数 | 无 | --- | --- | 不保证完全复现 |
stream |
流式返回 | bool | false | --- | --- | 交互开 / 后台关 |
response_format |
输出格式约束 | text/json | text | --- | --- | 稳定首选 json_schema |
调参铁律:一次只改一个变量,每次调整后跑同一评测集对比。
按任务类型的推荐基线
| 任务类型 | 典型场景 | temperature | top_p | max_tokens | 说明 |
|---|---|---|---|---|---|
| 抽取/结构化 | 实体抽取、JSON、分类 | 0 ~ 0.2 | 0.1~0.3 | 通常宁小勿大 | 配 json_schema |
| 问答/知识库 | RAG 问答、客服 | 0.3 ~ 0.5 | 0.5~0.9 | 500~1500 | 平衡忠实与自然 |
| 决策/规划 | 计划生成、路由 | 0 ~ 0.3 | 0.3~0.7 | 800~2000 | 可加 self-consistency |
| 代码生成 | 补全、工具参数 | 0.1 ~ 0.3 | 0.5~0.9 | 视大小 | 工具调用建议 ≈0 |
| 创意写作 | 文案、营销、故事 | 0.7 ~ 1.0 | 0.9~1.0 | 较长 | 需要多样性 |
| 翻译/改写 | 中英互译、润色 | 0.3 ~ 0.5 | 0.7~0.9 | 中等 | 忠实度优先 |
| 总结/摘要 | 长文总结、纪要 | 0.2 ~ 0.4 | 0.7~0.9 | 中短 | 防遗漏关键信息 |
| 多步推理 | 复杂问题、数学 | 0 ~ 0.2 | 0.3~0.7 | 较长 | 配合 CoT/ReAct |
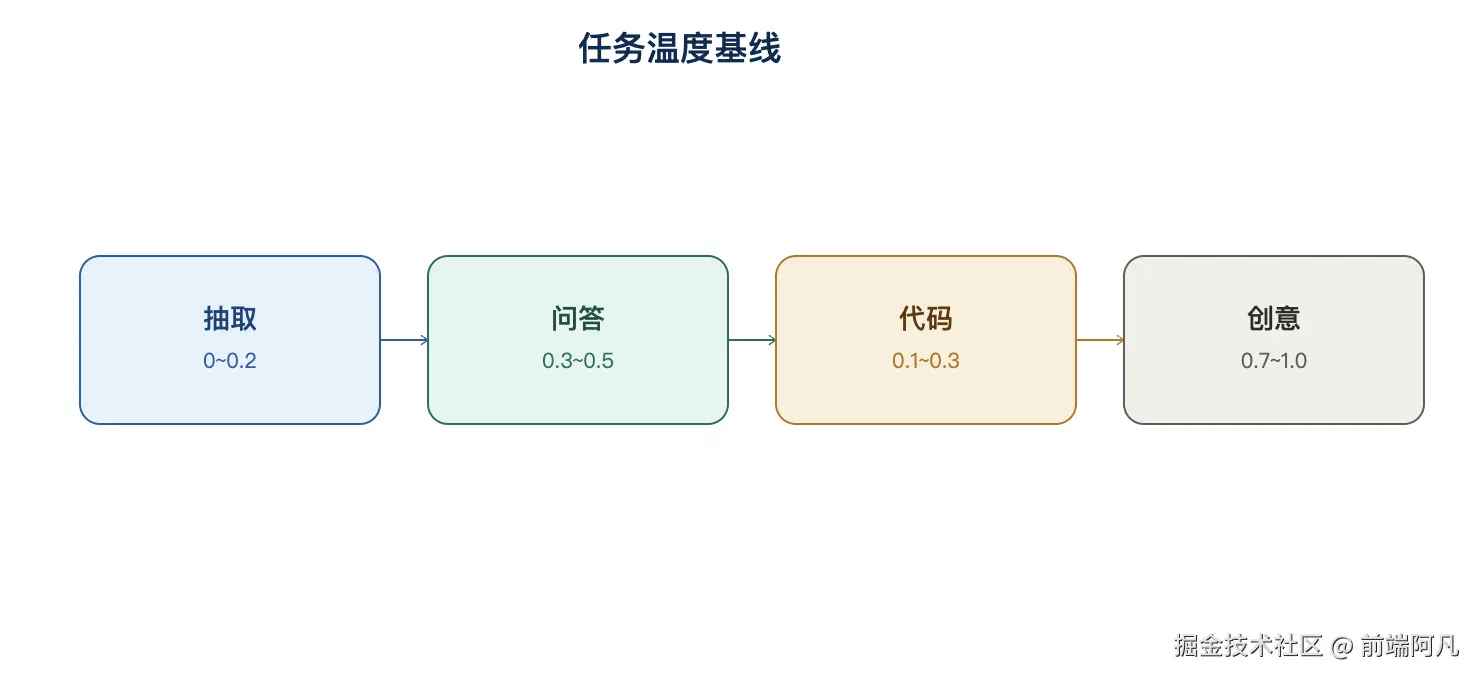
图 2:任务温度基线
调参起点策略 :不确定时,先跑
temperature = 0.2 / 0.5 / 0.8三个点 + 固定评测集各 20 条,看质量曲线再细化。
24.2 中文主流模型参数差异对照
| 能力/参数 | DeepSeek-V3 | DeepSeek-R1 | Qwen 通义 | 豆包 Doubao | 混元 Hunyuan | GPT-4o/o 系 |
|---|---|---|---|---|---|---|
| 兼容协议 | OpenAI 兼容 | OpenAI 兼容 | OpenAI 兼容 | OpenAI 兼容 | OpenAI 兼容 | 原生 |
temperature |
✅ | ⚠️ 建议不调 | ✅ | ✅ | ✅ | ✅ |
top_p |
✅ | ⚠️ | ✅ | ✅ | ✅ | ✅ |
top_k |
✅ | ✅ | ✅ | ✅ | ⚠️ | ❌ |
seed |
⚠️ | ⚠️ | ✅ | ✅ | ⚠️ | ✅ beta |
response_format |
✅ json | ⚠️ | ✅ | ✅ json | ✅ | ✅ json_schema |
| 推理输出 | 思维链 | 含 reasoning_content | 可配思考 | 可配思考 | ⚠️ | o 系带 reasoning |
| 上下文(约) | 128K | 128K | 32K~1M | 128K~256K | 256K~1M | 128K~1M |
跨模型迁移 3 条铁律:
- 推理模型通常不调 temperature/penalty(DeepSeek-R1、o 系、思考模式),可能影响思维链质量------具体行为因模型而异,变更前务必查模型文档并用评测集验证。
top_k是分水岭:迁到 OpenAI 系前必须去掉。- json 输出优先用
json_schema/json_object,而非提示词硬约束。
24.3 Agent 引擎参数
| 参数/配置 | 含义 | 推荐基线 | 调优方向 |
|---|---|---|---|
max_iterations |
最大循环轮数 | 简单 3 |
卡死调小;未完成查根因 |
max_tool_calls |
单轮工具调用次数 | 3~8 | 频繁失败→检查工具质量 |
tool_choice |
工具选择策略 | auto / required / none | 流水线 required;纯问答 none |
parallel_tool_calls |
工具并行 | true | 有依赖→false;独立→true |
| 工具重试 | 失败重试 | 2~3 次 + 1s/2s/4s 退避 | 过多→成本爆炸,加熔断 |
| 单工具超时 | 单次调用超时 | 5~30s 按类型 | 外部 API 10s+,本地 5s |
| 端到端超时 | 任务整体时限 | 30 |
超出→降级返回部分结果 |
| 上下文分配 | 系统/历史/工具/输出 | 系统 ≤10%、工具 ≤20%、输出留 30% | 溢出→压缩或转 RAG |
| 记忆保留 | 短期记忆轮数 | 8~12 轮 | 频繁遗忘→提炼摘要入长期 |
| 子 Agent 数量 | 多智能体并发 | 3~5(单任务) | 过多→通信开销大于收益 |
| 聚合等待 | Fan-in 等最慢分支 | 2~5s 或最长子任务 80% | 尾部敏感→缩短+部分聚合 |
24.4 企业级应用配置参数(40+ 项)
上线前逐项核对;⚠️ = 强烈建议必须配置。
A. 容量与限流
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| A1 ⚠️ | QPS 上限 | 配额 60%~70% | 429 雪崩 | 全部 |
| A2 ⚠️ | 并发上限 | 连接池+信号量 | OOM | 全部 |
| A3 | 排队策略 | 令牌桶+队列 ≤1000 | 排队过长 | 高并发 |
| A4 | 请求优先级 | 关键任务插队 | 低优先级饿死 | 混合流量 |
| A5 | 按租户配额 | QPS/日预算 | 单租户打爆共享池 | SaaS |
B. 弹性与降级
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| B1 ⚠️ | 熔断阈值 | 连续失败≥5 / 错误率≥30%(10s) | 级联故障 | 全部 |
| B2 ⚠️ | 降级响应 | 兜底话术/缓存/简化流程 | 直接失败 | 全部 |
| B3 ⚠️ | 备用模型 failover | DeepSeek→Qwen 等 | 单一模型单点 | 全部 |
| B4 | 慢启动恢复 | 半开探测渐进放量 | 恢复过快再熔断 | 全部 |
C. 缓存策略
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| C1 | 结果缓存 | 相同输入 TTL 5~60min | 数据过期 | 高频重复问答 |
| C2 | 语义缓存 | 相似度≥0.95 | 误命中 | FAQ/客服 |
| C3 ⚠️ | Prompt 缓存 | 固定系统提示词开 KV Cache | 成本高 2~10 倍 | 全部 |
| C4 | 会话缓存 | Redis 存会话状态 | 对话断裂 | 多轮对话 |
| C5 | 缓存失效 | 数据变更主动失效 | 陈旧数据合规风险 | 动态数据 |
D. 稳定性与超时分层
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| D1 ⚠️ | 连接超时 | 5~10s | 拖垮线程池 | 全部 |
| D2 ⚠️ | 首 Token 超时 | 10~30s | 体验差 | 交互 |
| D3 ⚠️ | 总时长超时 | 30s~5min 按任务 | 资源占用 | 全部 |
| D4 | 重试策略 | 1s/2s/4s 退避+抖动 ≤3 次 | 重试风暴 | 全部 |
| D5 | 幂等键 | idempotency-key | 重复扣费/执行 | 写入类 |
| D6 | 任务队列 | 长任务异步化+状态查询 | 请求积压 | 耗时任务 |
E. 安全参数
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| E1 ⚠️ | 内容审核 | 出入双向(关键词+模型) | 合规风险 | 对外服务 |
| E2 ⚠️ | 提示注入检测 | 工具输入/输出双侧 | 越权操作 | 含工具调用 |
| E3 ⚠️ | PII 脱敏 | 正则+模型识别 | 隐私泄露 | 全行业 |
| E4 | 工具白名单 | 仅暴露必需工具 | 攻击面大 | 全部 |
| E5 | 输出过滤 | 敏感词/URL/代码拦截 | 安全事故 | 全部 |
| E6 | 角色权限 RBAC | 工具调用鉴权 | 数据泄露 | 企业内网 |
F. 可观测性
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| F1 ⚠️ | 全链路追踪 | 每步 trace:prompt/tool/结果/token | 无法排错 | 全部 |
| F2 | 采样率 | 默认 100%,高流量 10% | 丢问题现场 | 高流量 |
| F3 ⚠️ | Token 计量 | 输入/输出/缓存分计 | 成本失控 | 全部 |
| F4 | 告警阈值 | 错误率>5% / P95>3s / 成本日增>50% | 问题放大 | 全部 |
| F5 | 质量指标 | 人工抽评+LLM-as-Judge | 质量下滑 | 全部 |
| F6 | 会话回放 | 关键会话原文存储 | 优化无据 | 客服类 |
G. 配置管理
| # | 配置项 | 推荐值 | 风险评估 | 场景 |
|---|---|---|---|---|
| G1 ⚠️ | 配置中心 | Apollo/Nacos/自建 | 散落代码改不动 | 全部 |
| G2 ⚠️ | 环境隔离 | dev/staging/prod 分离 | 串环境事故 | 全部 |
| G3 | 灰度参数 | 按比例/租户灰度 | 全量切换风险 | 全部 |
| G4 | 版本化 | 变更留痕可回滚 | 无法回溯 | 全部 |
| G5 | 预算封顶 | 日/月 Token 自动熔断 | 成本失控 | 全部 |
24.5 调优方法论:五步法
csharp
[1 基线建立] 固定评测集(≥50 条)+ 指标基线(正确率/成本/延迟)
        ↓
[2 单因素实验] 每次只改 1 个参数,跑全量评测集
        ↓
[3 组合优化] 找到敏感参数后做 2~3 维组合扫描(网格/贝叶斯)
        ↓
[4 回归验证] 用独立验证集确认无退化(防过拟合评测集)
        ↓
[5 灰度上线] 按租户/比例灰度,观察线上指标 24~48h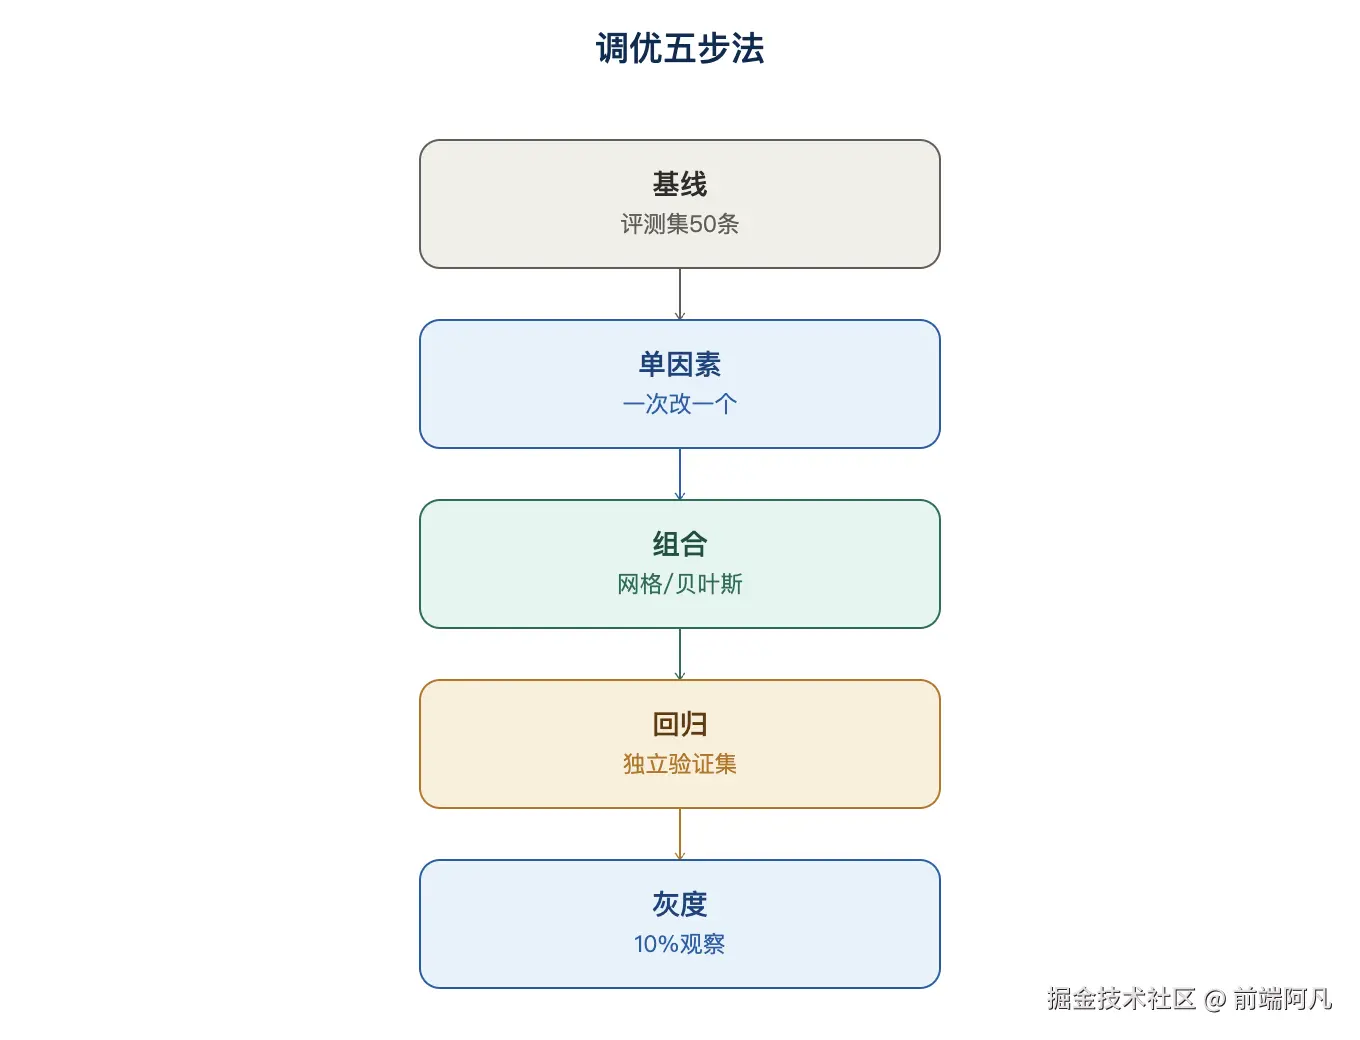
图 3:调优五步法
实验记录模板(每轮必填)
| 字段 | 内容 |
|---|---|
| 实验编号 | EXP-2026-08-07-001 |
| 目标指标 | 客服正确率 ≥90%,P95 延迟 <3s |
| 修改参数 | temperature: 0.5 → 0.3 |
| 评测集 | 100 条(20 场景 × 5 变体) |
| 结果 | 正确率 87%→92%,延迟持平 |
| 副作用 | 创意类回复多样性略降 |
| 结论 | ✅ 采用 / ❌ 回滚 / ⚠️ 需进一步验证 |
| 是否上线 | 灰度 10% → 观察 → 全量 |
| 备注 | 与 EXP-002(top_p)结论联动 |
24.6 调优决策树
csharp
现象:回答总是幻觉/编造
  └─→ ① temperature 调低(1.0→0.3)
      └─→ ② 加 RAG 检索约束 + "仅基于资料回答"
          └─→ ③ 开 json_schema 强制结构
              └─→ ④ 加 LLM-as-Judge 抽评

现象:回答重复/复读
  └─→ ① frequency_penalty 调高(0→0.5~1.0)
      └─→ ② 检查 prompt 示例是否过少

现象:上下文溢出 / 答不对历史
  └─→ ① 压缩历史(摘要+滑动窗口)
      └─→ ② 记忆保留条数调小(12→8)
      └─→ ③ 超长资料转 RAG

现象:Agent 卡死 / 死循环
  └─→ ① max_iterations 调小 + 每步 trace
      └─→ ② 检查工具是否返回"无法推进"的中间结果
      └─→ ③ 加"任务完成判断"步骤

现象:工具参数乱填
  └─→ ① temperature 调低(如 0~0.1)
      └─→ ② Schema 写严格 description + enum
      └─→ ③ 加工具结果校验与重试

现象:成本爆炸
  └─→ ① max_tokens 设上限
      └─→ ② 开 Prompt 缓存(KV Cache)
      └─→ ③ 小模型路由
      └─→ ④ 结果缓存 + 语义缓存

现象:响应太慢
  └─→ ① 开 stream 流式
      └─→ ② 减少 max_tokens 冗余
      └─→ ③ 并行化独立子任务(Fan-out)
      └─→ ④ 换更快模型 / 量化部署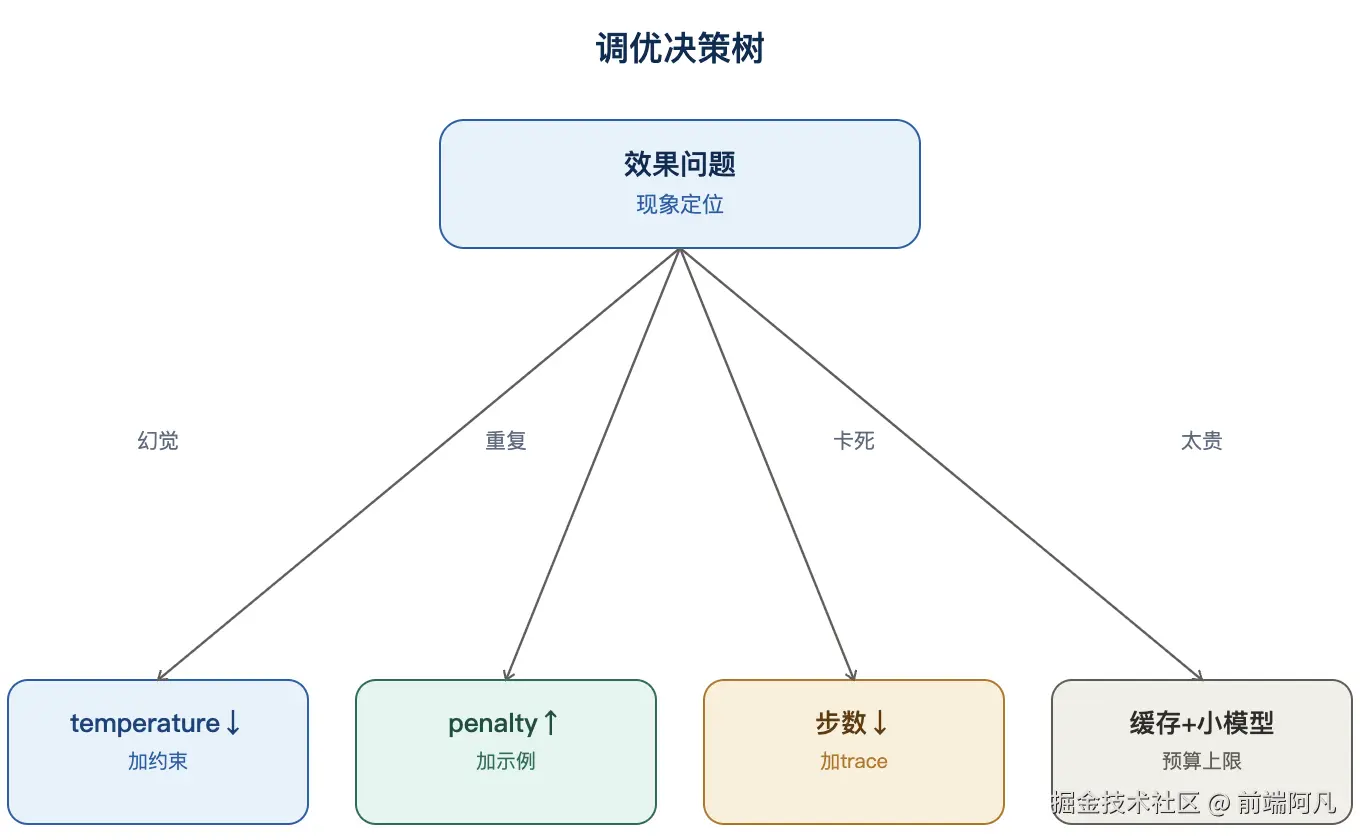
图 4:调优决策树
代码示例:OpenAI 兼容接口推荐基线
python
# 结构化抽取任务基线
resp = client.chat.completions.create(
    model="deepseek-chat",
    messages=[...],
    temperature=0.1,
    top_p=0.3,
    max_tokens=1000,
    response_format={"type": "json_object"},
    seed=42,           # 若模型支持
    stream=False,
)

# Agent 引擎层(伪代码:Agent 和 SlidingWindow 为框架内置类,此处仅示意配置结构)
agent = Agent(
    model=model,
    max_iterations=8,
    max_tool_calls=5,
    tool_choice="auto",
    parallel_tool_calls=True,
    tool_retry=3,
    tool_timeout=10,
    timeout=120,
    memory=SlidingWindow(rounds=10),
)
🛠 解决方案(章末三件套)
- 常见问题 :
- "为什么我调了 temperature 没效果?" → 检查是否用了推理模型(R1/o 系等,temperature 可能不生效或行为不同),或没跑评测集只凭感觉看。
- "为什么线上配置和开发环境不一样?" → 缺少配置中心与环境隔离(G1/G2),参数散落代码。
- "为什么成本总超预算?" → 未设 max_tokens 上限、未开 Prompt 缓存、未做预算封顶(G5)。
- 解决方案:调优决策树 + 企业级配置清单模板(40+ 项),详见《参数调优速查表》(附录 C)。
- 实战提示 :
- 所有参数变更记录进实验模板,保证可复现、可回滚。
- 先调"影响最大的 3 个":temperature、max_tokens、缓存开关,其他参数按需。
- 上线前用企业级配置清单(表五)逐项过一遍,至少覆盖所有 ⚠️ 项。