第 26 章 案例二:企业知识库问答 Agent
本章要解决的问题
企业文档中心几万份 PDF,怎么让 Agent 精准回答「我们公司的报销标准是什么」?
章节大纲
- 26.1 文档处理与向量检索(Qwen + 内网知识库)
- 26.2 RAG + 反思 + 评估自检
- 26.3 MCP 集成企业系统
- 26.4 评测与上线
- 🛠 解决方案:知识库问答幻觉抑制方案 + 检索质量评估
26.1 文档处理与向量检索
26.1.1 场景与挑战
场景:企业内部文档中心,几万份 PDF(制度、流程、项目文档),员工随时提问。
三个挑战:
- 文档格式杂:PDF(含扫描件)、Word、Excel、PPT------要先解析。
- 数据敏感 :内网数据不能出域 → 私有化部署或数据脱敏(第 2/22 章)。
- 问题多样:制度查询、流程咨询、项目检索------需要精准检索。
26.1.2 文档处理管线(第 8 章完整实践)
示例代码:以下代码演示核心结构,省略了异常处理、日志和完整 import。
python
import os
from typing import List, Dict

def parse_document(path: str) -> str:
    """解析各种格式 → 纯文本"""
    ext = os.path.splitext(path)[1].lower()
    if ext in (".pdf",):
        return parse_pdf(path)          # 文本型 PDF
    if ext in (".docx", ".doc"):
        return parse_word(path)
    if ext in (".xlsx", ".xls"):
        return parse_excel(path)        # 表格转文本
    if ext in (".png", ".jpg"):
        return ocr_image(path)          # 扫描件 → OCR
    return ""

def build_index(doc_dir: str):
    """全量建索引:解析 → 分块 → 向量化 → 存储"""
    chunks = []
    for root, _, files in os.walk(doc_dir):
        for fname in files:
            text = parse_document(os.path.join(root, fname))
            for chunk in split_into_chunks(text, size=600, overlap=80):
                chunks.append({
                    "text": chunk,
                    "metadata": {
                        "source": fname,
                        "dept": infer_dept(fname),   # 部门过滤
                        "type": infer_type(fname),   # 制度/流程/项目
                        "updated": file_mtime(fname),
                    },
                })
    vector_store.add_documents(chunks)   # Qwen embedding 向量化
    return len(chunks)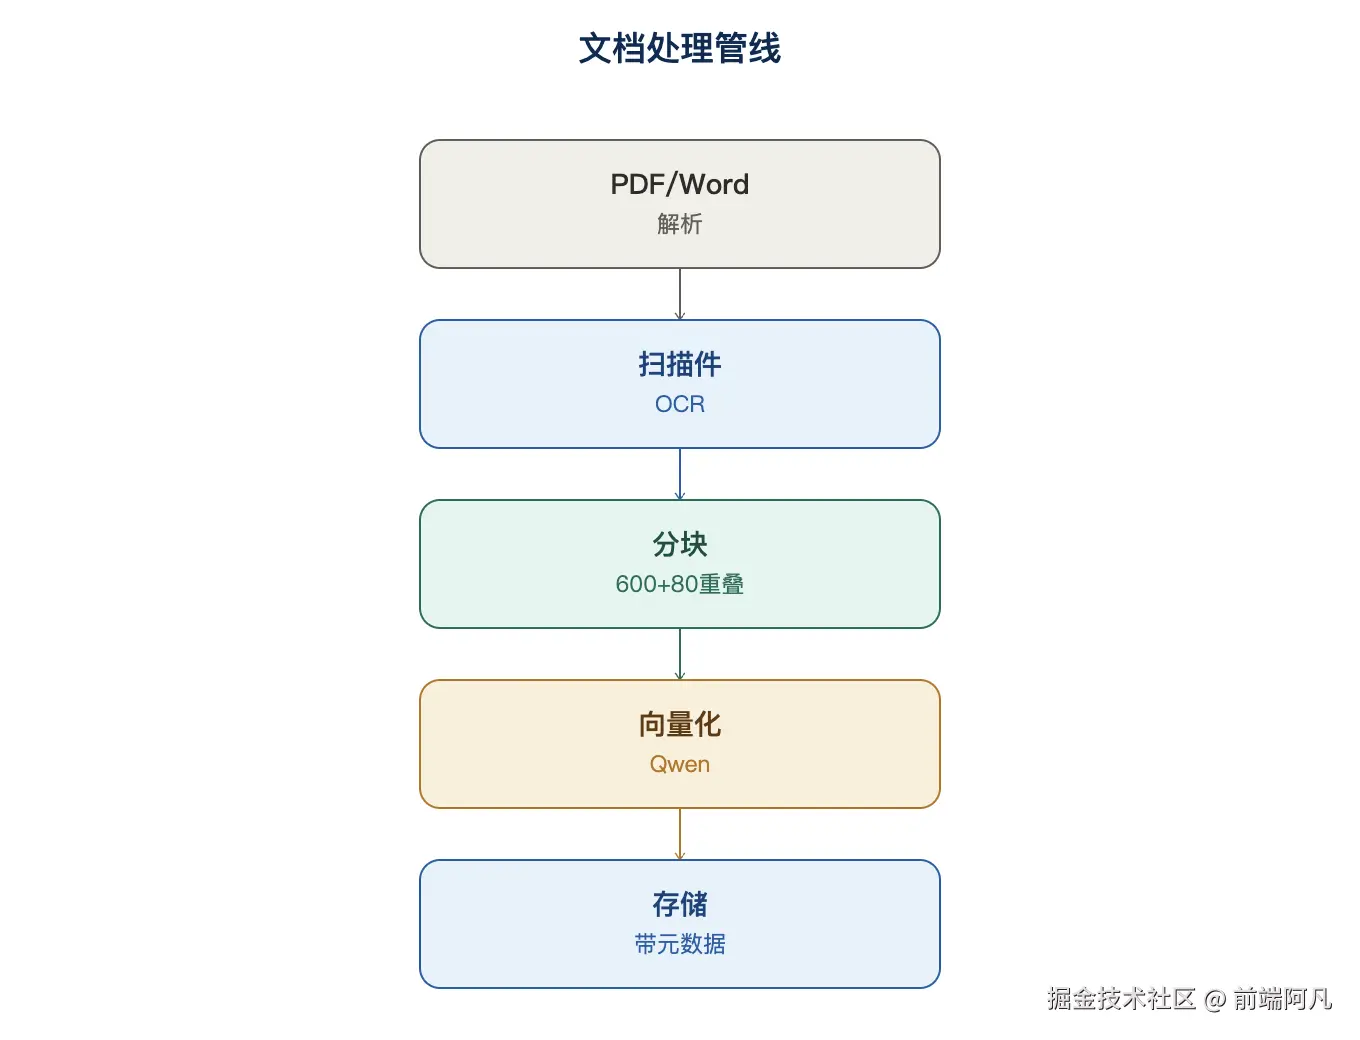
图 1:文档处理管线
关键设计:
- 解析要"识别失败":解析不了的文档(加密/乱码)要标记并告警,不能静默丢失。
- 元数据三件套 :
source(出处可追溯)、dept(部门过滤)、type(类型过滤)------检索的"筛子"。 - 扫描件走 OCR:PDF 分两种------文本型直接解析,扫描型先 OCR。
26.1.3 检索优化(第 8 章)
python
def retrieve_for_query(question, filters=None):
    # 混合检索:向量 + BM25 + RRF 融合
    results = hybrid_retrieve(question, filters=filters, top_k=20)
    # 重排:Cross-Encoder 精排 Top-20 → Top-3
return rerank(question, results, top_k=3)检索质量三步:混合检索(召回全)→ 重排(排序准)→ 过滤(范围对)。
26.2 RAG + 反思 + 评估自检
26.2.1 三件套组合:让回答"可信任"
知识库问答最大的风险是幻觉(编造制度条款)。组合三件套压制幻觉:
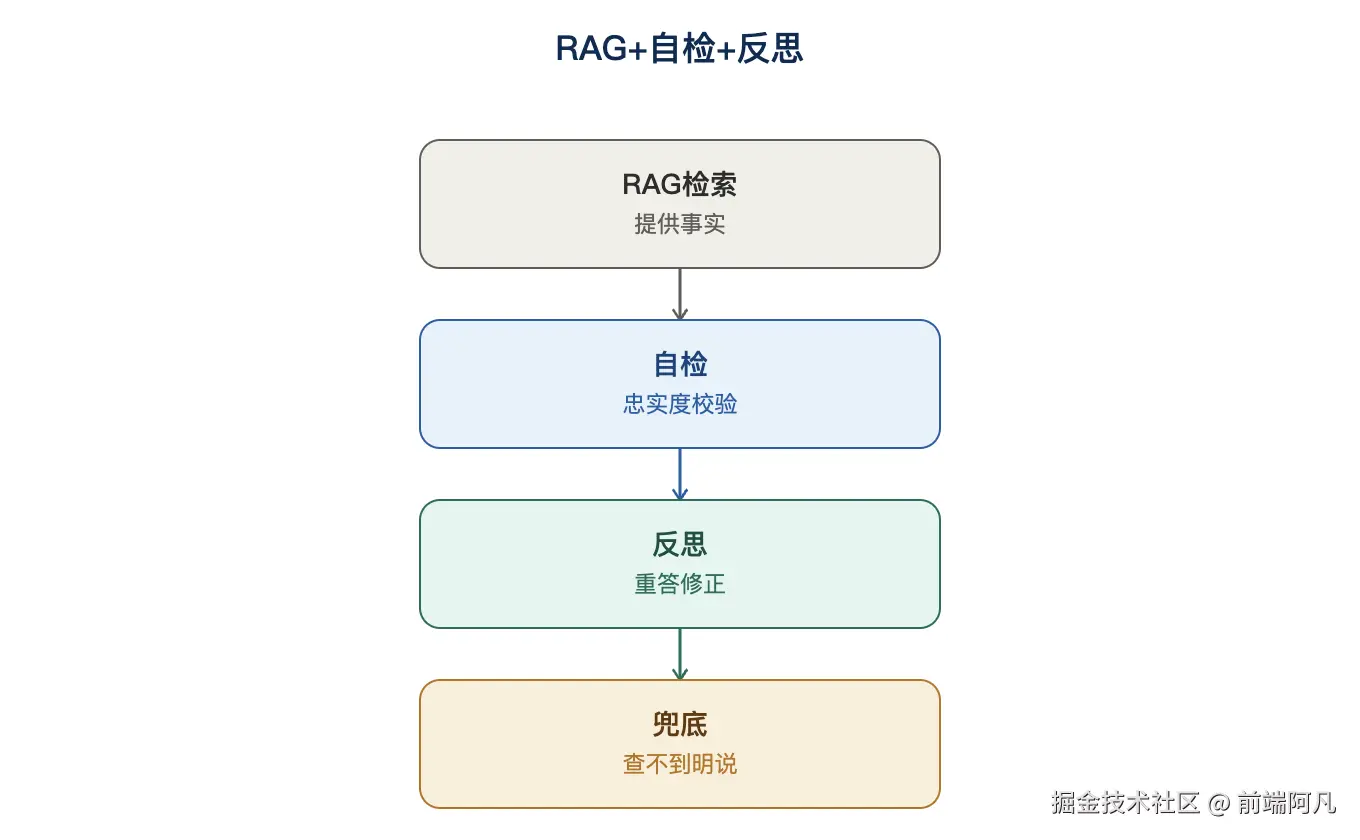
图 2:RAG+自检+反思
css
[RAG] 检索相关资料(提供事实)
  ↓
[自检] 规则校验(必含引用出处)+ 忠实度检查(第17章)
  ↓
[反思] 有引用但不确定 → 重查/重答(第13章)
  ↓
[兜底] 资料不足 → 明确说"未查到",不硬答
26.2.2 忠实度自检实现
python
def faithfulness_check(answer, sources):
    """检查回答是否忠实于资料:每个关键断言都要能在资料中找到依据"""
    resp = llm_judge(f"""检查回答中的每个断言是否都能在参考资料中找到依据。
回答:{answer}
资料:{sources}
只输出 JSON:{{"faithful": bool, "unsubstantiated": ["无依据的断言"]}}""")
    return resp

def knowledge_answer(question, filters=None):
    sources = retrieve_for_query(question, filters)
    if not sources:
        return "未在知识库中找到相关资料,建议联系行政部确认。", []
    answer = llm.chat(
        system="你是企业知识库助手。仅基于资料回答,并注明出处(文件名)。",
        user=f"【资料】{sources}\n【问题】{question}",
        temperature=0.2,          # 知识问答用低温度
    )
    # 忠实度自检,不通过 → 反思重答
    check = faithfulness_check(answer, sources)
    if not check["faithful"]:
        answer = llm.chat(
            system="基于资料重新回答,修正以下无依据的内容:"
                   f"{check['unsubstantiated']}",
            user=f"【资料】{sources}\n【问题】{question}",
            temperature=0.1,
        )
    return answer, sources
兜底原则 :查不到就说查不到(附建议渠道)------比编造一个看似合理的答案好 100 倍(第 8 章"没有就说没有")。
26.2.3 出处可追溯
回答必须带出处(哪个文件、哪个版本),这是企业知识库的硬要求:
python
return f"{answer}\n\n【出处】{sources[0]['metadata']['source']}({sources[0]['metadata']['updated']})"出处 = 可信任的最后一道证明------员工能自己打开原文件核对。
26.3 MCP 集成企业系统
26.3.1 知识库 Agent 要连什么
不只是问答,还要能联动企业系统:
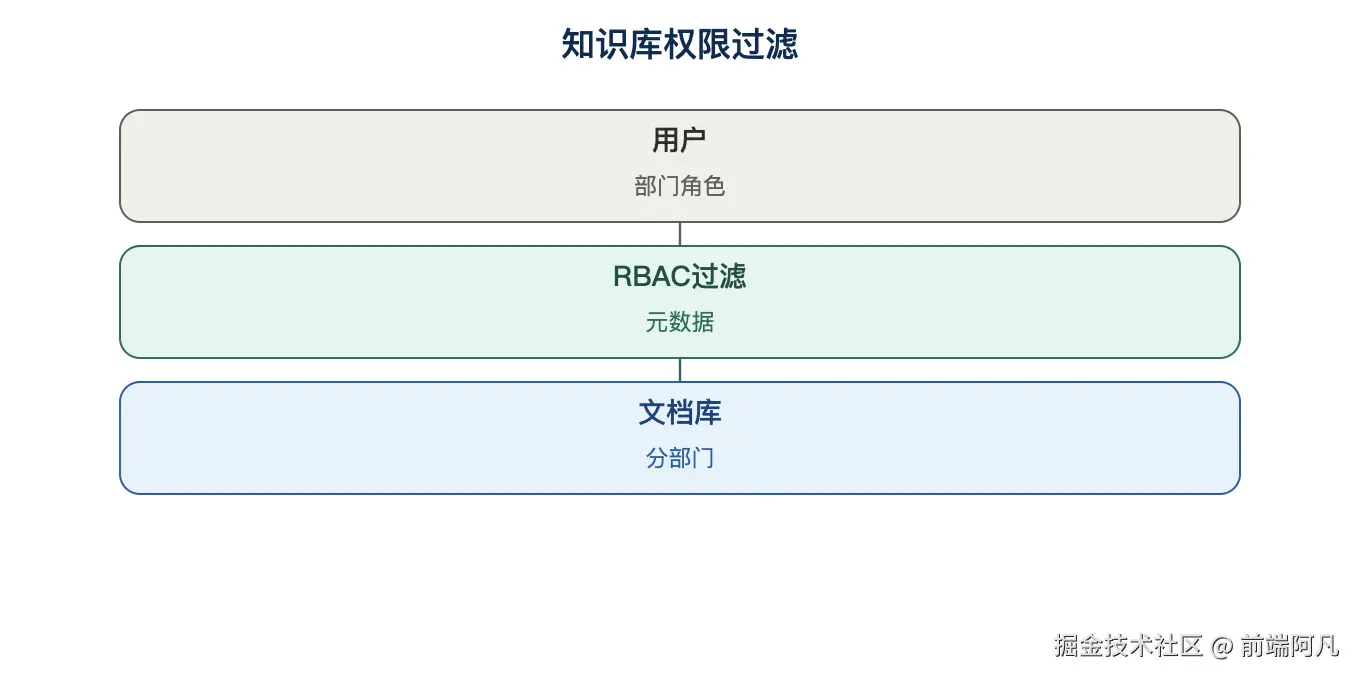
图 3:知识库权限过滤
| 系统 | 用途 | 接入方式 |
|---|---|---|
| OA 系统 | 查审批流程状态 | MCP Server |
| HR 系统 | 查假期/薪资制度 | MCP Server |
| 项目管理系统 | 查项目文档 | MCP Server |
| 内部 Wiki | 实时内容 | MCP Server |
26.3.2 用 MCP 接入(第 7 章实践)
python
from fastmcp import FastMCP

mcp = FastMCP("oa-integration")

@mcp.tool()
def query_approval_status(approval_id: str) -> dict:
    """查询 OA 审批状态。用户询问审批进度/结果时使用。"""
    # 内部 OA API 封装
    return oa_api.get_approval(approval_id)

@mcp.tool()
def query_leave_policy(department: str) -> dict:
    """查询假期制度。用户询问年假/病假/调休时使用。"""
    return hr_api.get_leave_policy(department)

# 注册进 Agent:MCP 发现的工具 = 知识库 Agent 的动态工具集价值:知识库 Agent 从"纯问答"升级为"问答 + 操作"------问完制度还能直接查自己的审批状态。
26.4 评测与上线
26.4.1 知识库专项评测(第 8/20 章)
python
EVAL_SET = [
    {"question": "报销标准是什么?", "gold_docs": ["报销制度-v3.pdf"],
     "check": "含金额上限且注明出处"},
    {"question": "年假怎么休?", "gold_docs": ["休假管理办法.pdf"],
     "check": "按制度回答"},
    {"question": "去年的团建费怎么报?", "gold_docs": [],   # 无此文档
     "check": "明确说未查到,不编造"},
    {"question": "扫描件里的制度也查得到吗?", "gold_docs": ["旧制度-扫描版.pdf"],
     "check": "OCR 后能检索"},
    ...
]
# 指标:检索命中率 / 忠实度 / 幻觉率 / 出处覆盖率
26.4.2 上线要点
| 事项 | 说明 |
|---|---|
| 私有化部署 | 内网数据不出域(第 2/22 章) |
| 文档更新机制 | 新文档入索引 + 旧版本标记(防止旧版误导) |
| 权限过滤 | 不同部门看到不同文档(RBAC,第 22 章) |
| 监控 | 检索命中率周报 + 幻觉率抽评(第 20 章) |
| 反馈闭环 | 员工点踩的答案回流评测集(第 18/20 章) |
26.4.3 更新索引的工程细节
python
# 文档变更 → 增量更新(别全量重建,费时费钱)
def sync_index():
    changed = detect_changed_docs()          # 对比文件指纹
    for doc in changed:
        vector_store.delete(filter={"source": doc["name"]})  # 删旧
        index_document(doc)                                  # 加新
    # 版本冲突:同标题多版本 → 只保留最新(按 updated 排序)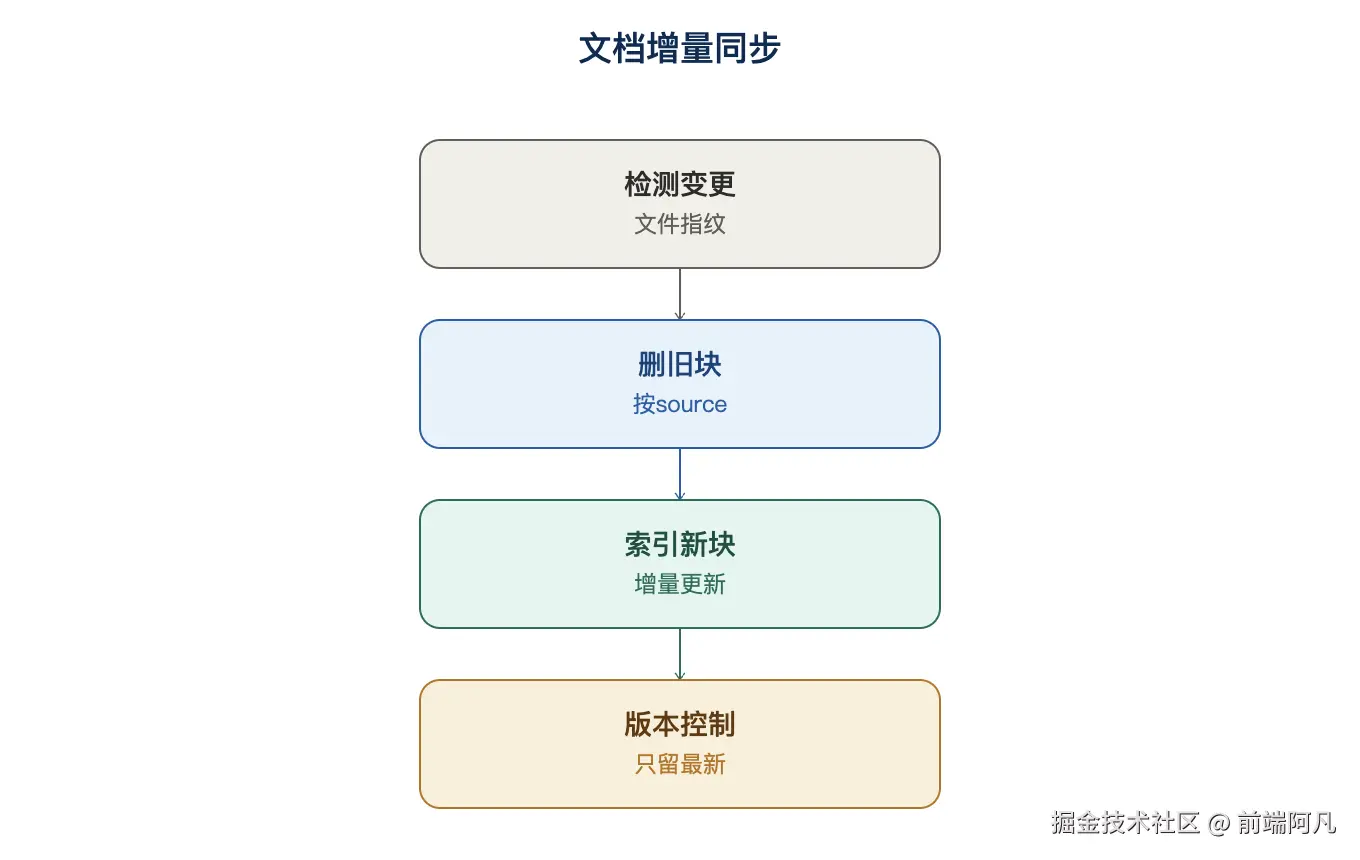
图 4:文档增量同步
🛠 解决方案:知识库问答幻觉抑制方案 + 检索质量评估
常见问题
- "答案编造制度条款":约束松 + 无出处。对策:仅基于资料 + 忠实度自检 + 强制带出处(26.2)。
- "检索不到扫描件内容":没 OCR。对策:扫描型 PDF 走 OCR(26.1.2)。
- "旧版制度误导用户":多版本并存无过滤。对策:版本标记 + 只保留最新(26.4.3)。
- "A 部门能查到 B 部门的机密":无权限过滤。对策:RBAC 元数据过滤(第 22 章)。
- "文档更新了但 Agent 答的还是旧的":索引未同步。对策:增量同步 + 文件指纹检测(26.4.3)。
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 编造条款 | 约束松 | 仅基于资料 + 忠实度自检 + 出处 |
| 扫描件查不到 | 无 OCR | OCR 管线 |
| 旧版误导 | 多版本未过滤 | 版本标记 + 保留最新 |
| 越权查看 | 无权限过滤 | RBAC 过滤 |
| 答旧内容 | 索引未同步 | 增量同步 |
实战提示
- 出处是知识库的信任根基:回答必带文件名 + 版本,员工能自己核对。
- 幻觉抑制三件套:低温度(0.2)+ 忠实度自检 + 查不到就明说。
- 元数据过滤别省:部门/类型/版本过滤让检索精准十倍。
- 文档生命周期要管理:新增/更新/废弃都要反映到索引。
- 内网数据安全第一:私有化部署或脱敏,数据出域要评估(第 22 章)。