前言
在知识库问答(RAG)系统迭代过程中,最大的痛点往往不是检索功能不可用,而是无法量化检索效果好坏。
调切片大小、改向量/关键词权重、换 Embedding 模型后,我们基本只能"肉眼看结果",非常主观,无法回答这些关键问题:
-
检索结果到底有没有真正命中标准答案?
-
标准切片排第几,是否满足业务要求?
-
向量检索、关键词检索分别贡献多少得分?
-
本次迭代到底是优化了还是变差了?
-
测评指标全部为 0,是代码问题、标注问题、还是数据集不匹配?
为了解决上述问题,我在辞溯知识库项目二期落地了一套完整可闭环的 RAG 检索测评系统,实现:数据集准备 → 自动检索 → 指标计算 → 记录落库 → 可视化分析。
本文结合真实项目源码,完整拆解整套测评方案的设计、实现、踩坑经验与后续优化方向。
一、整体测评流程
整套评测链路完全标准化、可重复运行,流程如下:
text
准备评测数据集
        |
        v
选择知识库和检索策略
        |
        v
执行向量检索 + 关键词检索
        |
        v
候选集合合并、去重、排序
        |
        +--> 取最终 Top-K(用于指标计算)
        |
        +--> 保存完整候选明细(用于问题溯源)
        |
        v
对比召回切片ID & 人工标注切片ID
        |
        v
计算 Precision@K / Recall@K / MRR / nDCG@K
        |
        v
保存评测记录 & 管理端可视化展示
系统提供两种使用模式,适配不同研发场景:
-
命令行离线评测:本地快速跑批,输出 JSON 报告,适合调参对比。
-
管理端页面评测:持久化每次评测记录,支持大盘指标 + 单用例细节排查。
二、评测数据集标准化设计
评测是否靠谱,完全取决于数据集是否标准。我采用轻量 JSON 数组格式,每条数据对应一条检索测试用例。
2.1 数据集示例
json
[
  {
    "case_id": "monorepo-advantages-001",
    "question": "Monorepo架构有什么优势",
    "relevant_chunk_ids": [
      "30465673-88ea-41f0-a5a0-da496592f3df"
    ],
    "k": 6
  }
]
2.2 字段说明
| 字段 | 说明 |
|---|---|
| case_id | 测试用例唯一ID,用于关联指标与候选明细 |
| question | 用户检索问题 |
| relevant_chunk_ids | 核心:人工标注的正确切片ID(document_chunks.id) |
| k | 参与指标计算的 Top-K 数量 |
避坑重点 :
relevant_chunk_ids不能填文档ID、知识库ID、自定义ID。只要 ID 不匹配数据库真实切片 ID,无论内容多相似,指标直接为 0。
三、混合检索核心实现(向量+关键词)
项目采用 向量语义检索 + Postgres 全文关键词检索 双路混合方案,兼顾语义泛化与关键词精准匹配。
3.1 混合检索流程
text
向量候选 Top10
        +
关键词候选 Top10
        |
        v
按 chunk_id 合并去重
        |
        v
最终分 = 向量分 * 0.7 + 关键词分 * 0.3
        |
        v
按最终分降序排序
        |
        v
输出最终 Top-K 结果
3.2 核心代码
python
async def hybrid_search_with_trace(
    session: AsyncSession,
    *,
    knowledge_base_id: UUID,
    query: str,
    limit: int | None = None,
) -> RetrievalTrace:
    # 1. 问题向量化,用于语义检索
    query_embedding = await embed_query(query)

    # 2. 只检索有效、已发布、未删除的文档切片
    base_filters = (
        DocumentChunk.knowledge_base_id == knowledge_base_id,
        Document.status == DocumentStatus.READY,
        Document.publication_status == DocumentPublicationStatus.PUBLISHED,
        Document.is_deleted.is_(False),
    )

    # 3. 向量检索召回 Top10
    vector_rows = (
        await session.execute(
            select(DocumentChunk, Document.original_name, distance.label("distance"))
            .join(Document, Document.id == DocumentChunk.document_id)
            .where(*base_filters)
            .order_by(distance)
            .limit(settings.vector_candidate_k)
        )
    ).all()

    # 4. 关键词全文检索召回 Top10
    keyword_rows = (
        await session.execute(
            select(DocumentChunk, Document.original_name, rank.label("rank"))
            .join(Document, Document.id == DocumentChunk.document_id)
            .where(*base_filters, DocumentChunk.content_tsvector.op("@@")(ts_query))
            .order_by(rank.desc())
            .limit(settings.keyword_candidate_k)
        )
    ).all()

    # 5. 合并去重、加权打分、排序
    candidates = sorted(merged.values(), key=lambda item: item.score, reverse=True)
    final_limit = limit or settings.final_top_k

    # 6. 返回完整候选池 + 最终TopK,实现无侵入测评
    return RetrievalTrace(
        candidates=candidates,
        selected=candidates[:final_limit],
    )
设计亮点 :正常问答业务只使用 selected,测评使用完整 candidates,完全不影响原有业务逻辑。
四、全量候选池快照:问题溯源核心
如果只存最终 Top-K 结果,我们只能知道"有没有命中",但无法回答:
-
标准切片到底有没有进候选池?
-
为什么没进 TopK?向量分低还是关键词分低?
-
和上榜结果差距多少分?
因此我新增 retrieval_evaluation_candidates 表,保存每一条候选切片的完整打分快照(不存正文,避免数据冗余与敏感信息)。
4.1 核心存储字段
| 字段 | 说明 |
|---|---|
| evaluation_run_id | 所属评测任务ID |
| case_id | 测试用例ID |
| chunk_id / document_id | 切片ID、文档ID |
| rank | 最终排序名次 |
| vector_score / keyword_score / final_score | 分项得分 + 混合得分 |
| is_relevant | 是否为标准答案切片 |
| is_selected | 是否进入最终 Top-K |
| strategy_version | 检索策略版本,用于版本对比 |
4.2 候选落库核心代码
python
trace = await hybrid_search_with_trace(
    session,
    knowledge_base_id=knowledge_base_id,
    query=case.question,
    limit=case.k,
)

selected_chunks = trace.selected
retrieved_ids = [str(chunk.chunk_id) for chunk in selected_chunks]
relevant_ids = set(case.relevant_chunk_ids)

# 全量候选落库,用于事后分析
for rank, chunk in enumerate(trace.candidates, start=1):
    session.add(
        RetrievalEvaluationCandidate(
            evaluation_run_id=run.id,
            case_id=case.case_id,
            chunk_id=chunk.chunk_id,
            document_id=chunk.document_id,
            document_name=chunk.document_name,
            rank=rank,
            vector_score=chunk.vector_score,
            keyword_score=chunk.keyword_score,
            rerank_score=chunk.rerank_score,
            final_score=chunk.score,
            is_relevant=str(chunk.chunk_id) in relevant_ids,
            is_selected=rank <= len(selected_chunks),
            strategy_version=chunk.strategy_version,
        )
    )
五、四大检索指标原理与代码实现
系统采用工业界常用的四个检索指标:Precision@K、Recall@K、MRR、nDCG@K,分别衡量精准度、召回完整性、靠前程度、整体排序质量。
5.1 Precision@K 精确率
Top-K 结果中,有效相关切片的占比。
Precision@K = TopK 相关数量 / TopK 总数量
5.2 Recall@K 召回率
所有标准切片中,有多少被 Top-K 成功召回。
Recall@K = TopK 相关数量 / 全部标准切片数量
5.3 MRR 平均倒数排名
关注第一个正确结果的位置,越靠前分数越高。
MRR = 1 / 第一个相关切片排名
5.4 nDCG@K 归一化折损累计增益
综合相关性 + 排序位置,位置越靠前,收益越高,是最全面的排序指标。
python
def ndcg_at_k(
    retrieved_ids: Sequence[str],
    relevant_ids: set[str],
    k: int,
) -> float:
    selected = _unique_prefix(retrieved_ids, k)
    if not relevant_ids:
        return 0.0
    # 计算实际DCG
    dcg = sum(
        1.0 / log2(rank + 1)
        for rank, chunk_id in enumerate(selected, start=1)
        if chunk_id in relevant_ids
    )
    # 理想最大DCG
    ideal_length = min(len(relevant_ids), k)
    ideal_dcg = sum(
        1.0 / log2(rank + 1)
        for rank in range(1, ideal_length + 1)
    )
    return dcg / ideal_dcg if ideal_dcg else 0.0
5.5 全局指标平均
python
def average_metrics(metrics: Sequence[RetrievalMetrics]) -> RetrievalMetrics:
    if not metrics:
        return RetrievalMetrics(0.0, 0.0, 0.0, 0.0)
    count = len(metrics)
    return RetrievalMetrics(
        precision_at_k=sum(item.precision_at_k for item in metrics) / count,
        recall_at_k=sum(item.recall_at_k for item in metrics) / count,
        reciprocal_rank=sum(item.reciprocal_rank for item in metrics) / count,
        ndcg_at_k=sum(item.ndcg_at_k for item in metrics) / count,
    )
六、数据表与接口设计
6.1 三张核心表
-
retrieval_evaluation_datasets:评测数据集本体 -
retrieval_evaluation_runs:单次评测任务汇总指标 -
retrieval_evaluation_candidates:逐题候选明细(用于问题定位)
6.2 核心接口
| 方法 | 接口 | 作用 |
|---|---|---|
| POST | /api/v1/knowledge-bases/{id}/retrieval/evaluate |
执行一次评测 |
| GET | /api/v1/knowledge-bases/{id}/retrieval/runs |
查询历史评测列表 |
| GET | /api/v1/retrieval/evaluations/{id} |
查看评测详情与候选明细 |
6.3 详情响应示例
json
{
  "case_id": "monorepo-advantages-001",
  "retrieved_chunk_ids": [
    "6f6bd250-b484-4506-842d-0e53073320b8"
  ],
  "relevant_chunk_ids": [
    "30465673-88ea-41f0-a5a0-da496592f3df"
  ],
  "metrics": {
    "precision_at_k": 0.0,
    "recall_at_k": 0.0,
    "reciprocal_rank": 0.0,
    "ndcg_at_k": 0.0
  },
  "candidates": [
    {
      "chunk_id": "6f6bd250-b484-4506-842d-0e53073320b8",
      "rank": 1,
      "vector_score": 0.8123,
      "keyword_score": 0.5000,
      "final_score": 0.7186,
      "is_relevant": false,
      "is_selected": true,
      "strategy_version": "hybrid-v1"
    }
  ]
}
七、两种评测使用方式
7.1 管理端页面评测
访问路径:/admin/retrieval-evaluations
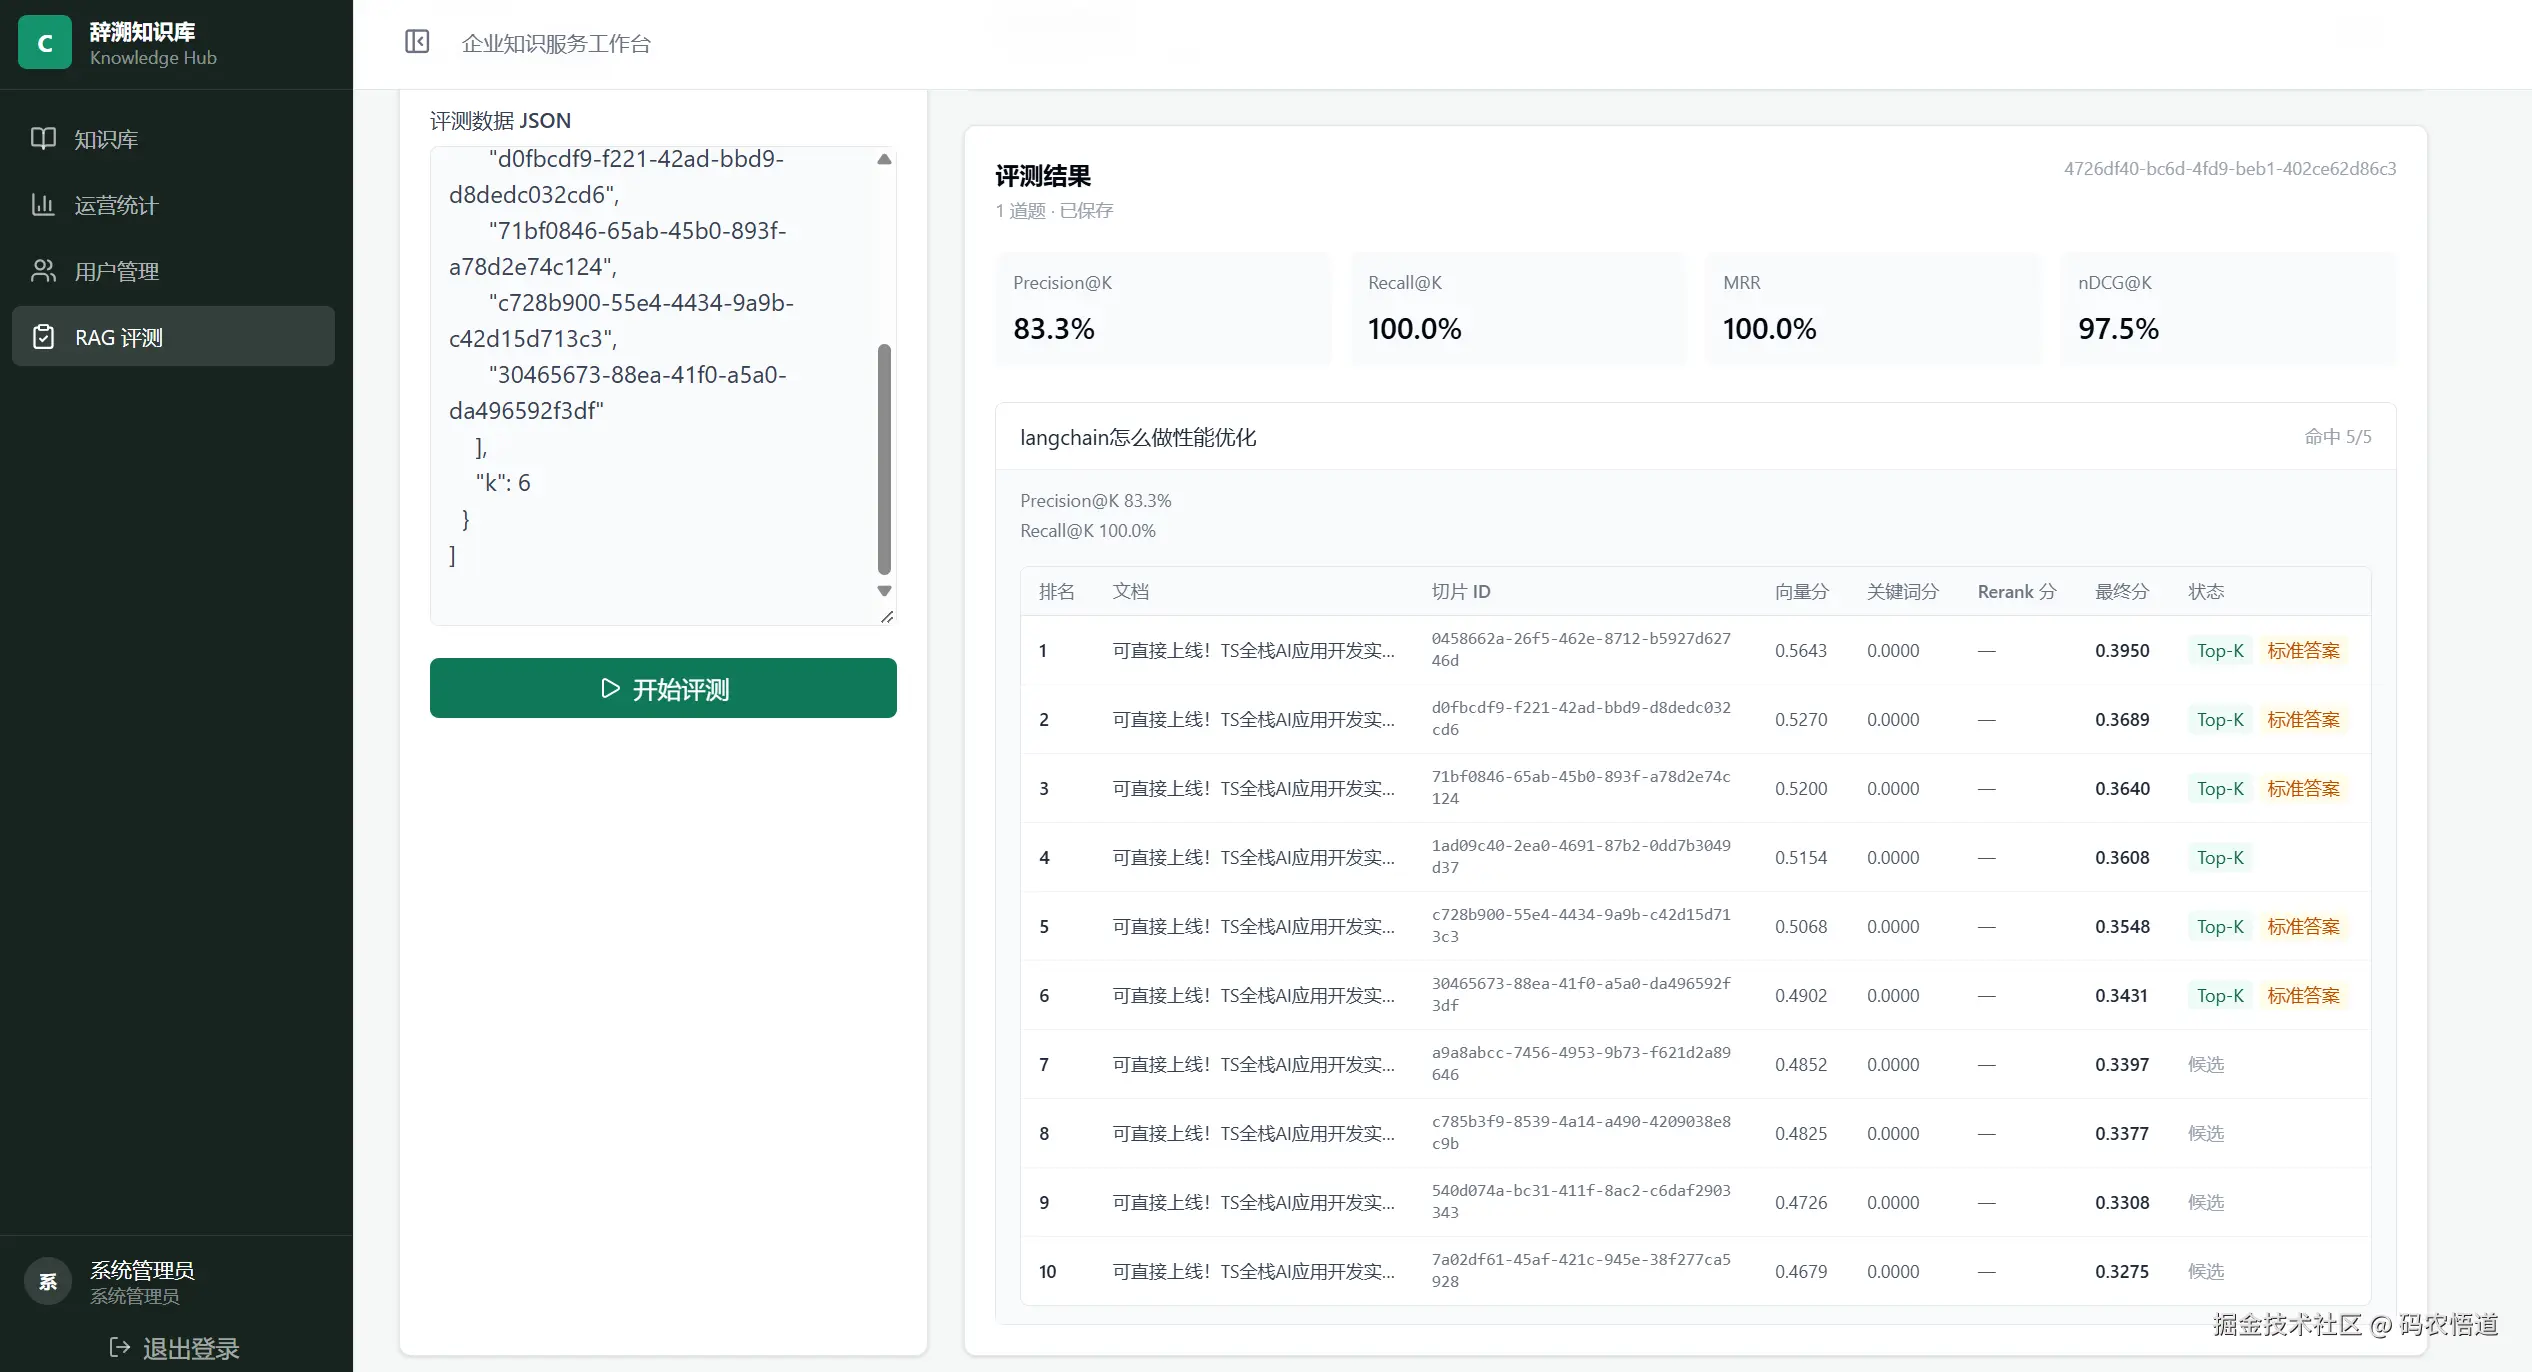
功能:上传数据集、一键评测、查看大盘指标、逐题分析分数明细,支持历史版本对比。
效果展示:
7.2 命令行离线评测
脚本路径:scripts/evaluate_retrieval.py
bash
cd cisu-knowledge-api
uv run python -m scripts.evaluate_retrieval \
  --knowledge-base-id xxx \
  --dataset ./eval.json \
  --output ./report.json
八、测评指标全0 快速排查手册
指标归零99%不是代码bug,优先按下面顺序排查:
-
切片ID填错 :必须是
document_chunks.id -
知识库不匹配:标准切片必须属于当前评测知识库
-
文档状态非法:必须是已发布、未删除、就绪状态
-
PowerShell换行符问题:反引号后不能有空格
-
只命中文档、没命中切片 :测评是切片级精准匹配
九、单元测试覆盖
python
def test_retrieval_evaluation_metrics() -> None:
    # c1、c2为标准答案,c1排在第2位
    metrics = evaluate_retrieval(
        ["c3", "c1", "c2"],
        {"c1", "c2"},
        3,
    )
    assert metrics.precision_at_k == pytest.approx(2 / 3)
    assert metrics.recall_at_k == 1.0
    assert metrics.reciprocal_rank == pytest.approx(1 / 2)
十、当前局限与后续迭代方向
-
预留
rerank_score,待接入重排模型测评 -
中文分词基于 Postgres simple,可优化分词能力
-
命令行报告可补充候选明细
-
同步任务需改造为异步队列,支持大数据集评测
-
目前只测检索,未来可拓展回答质量、引用准确性、拒答测评
十一、总结
本次 RAG 测评改造的核心价值:把主观感受,变成可量化、可复现、可对比的工程能力。
核心要点:
-
基于切片ID构建标准数据集,实验可复现
-
四大指标全面量化检索效果
-
全量候选快照落库,问题可精准溯源
后续迭代 Embedding、调权重、接入 Rerank、优化检索策略,都可以用这套体系做客观对比,极大提升 RAG 迭代效率与稳定性。