大家好!近期我基于前端技术栈(Next.js + LangGraph.js),独立落地了 ResumeGraph 智能简历优化 Agent MVP 项目。 效果如下:
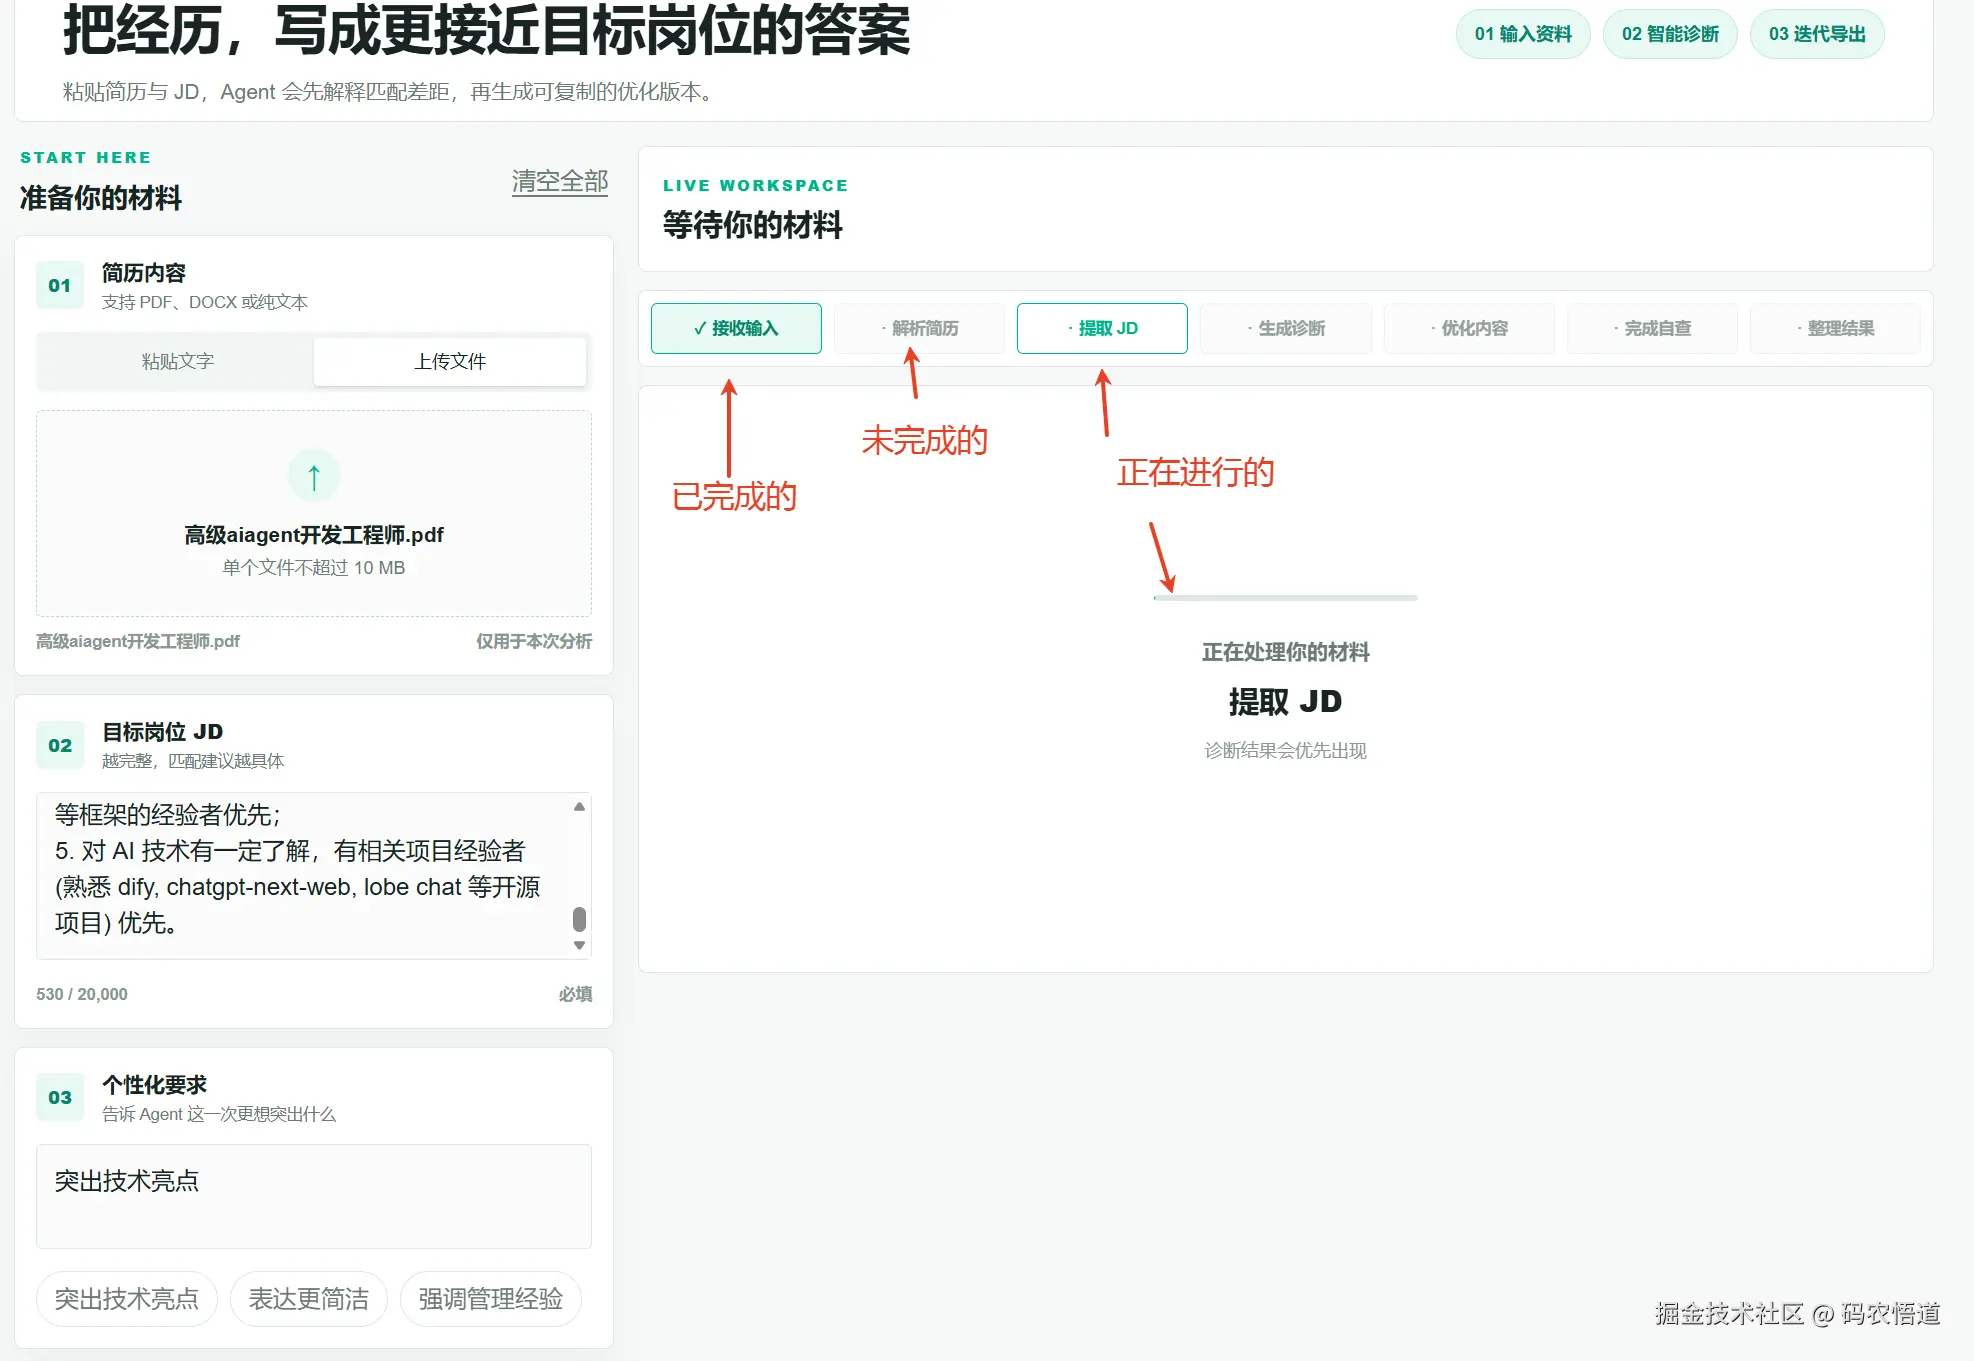
执行过程中
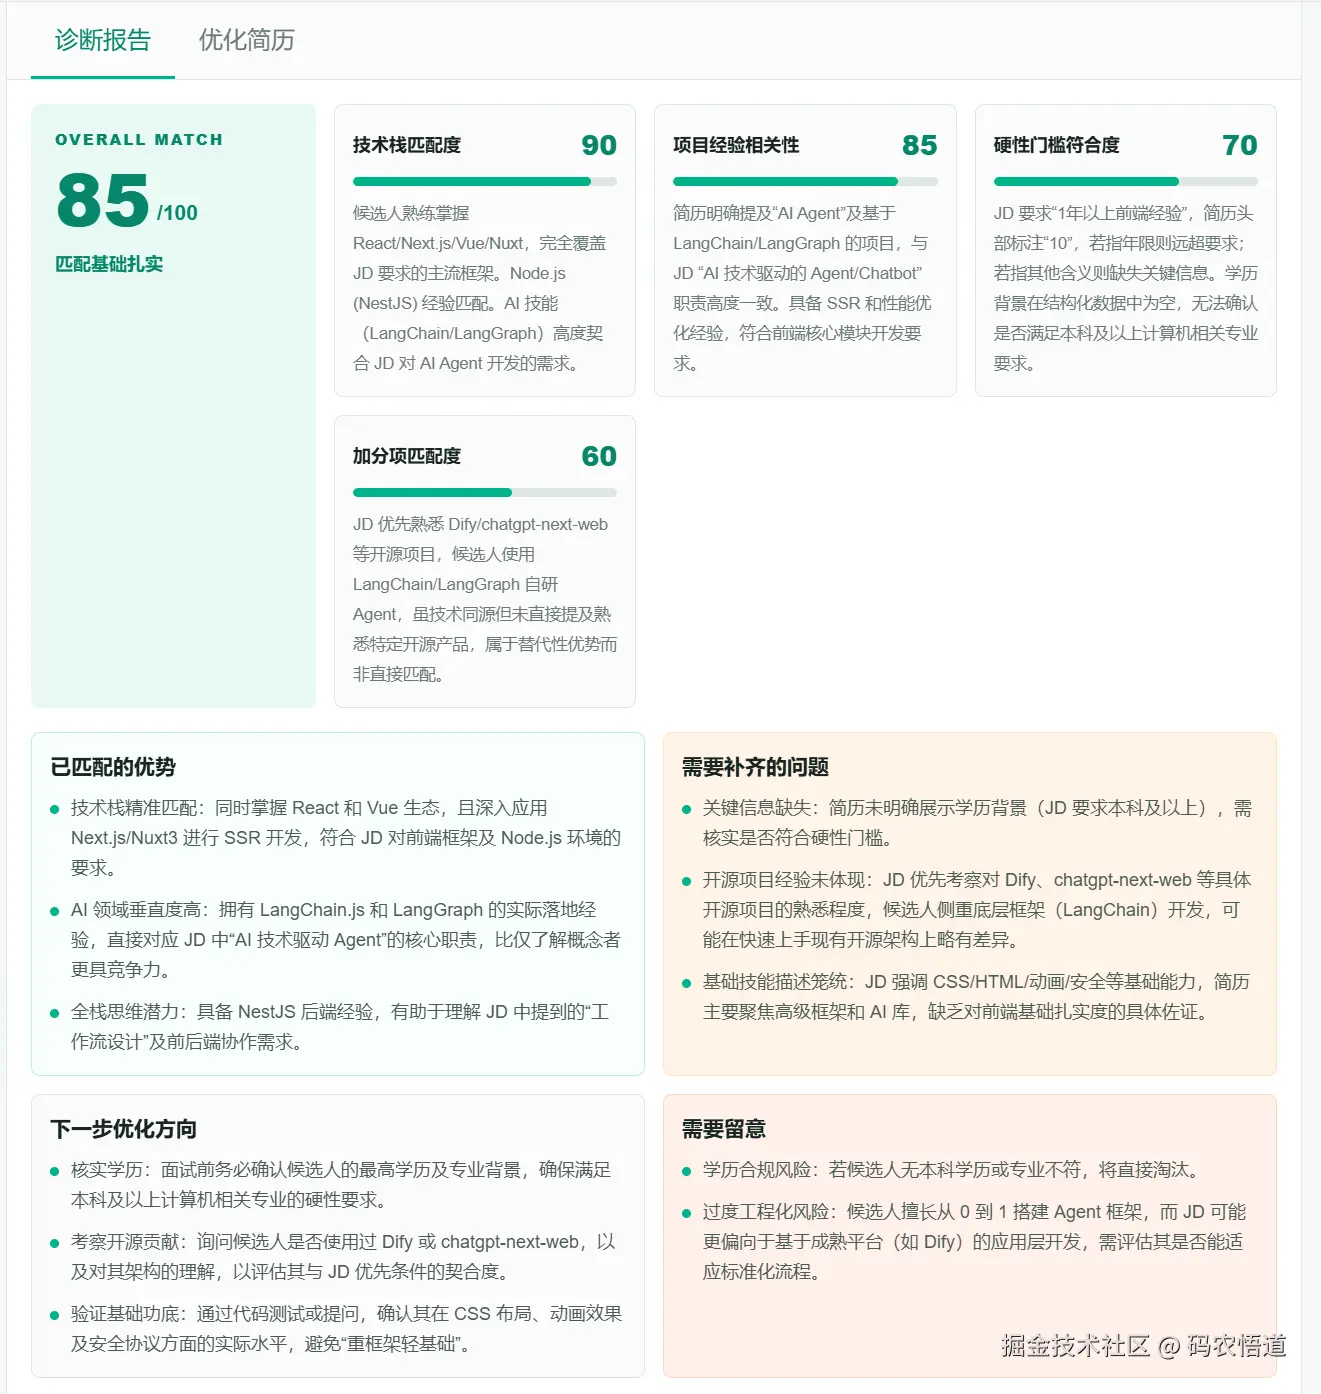
 诊断报告
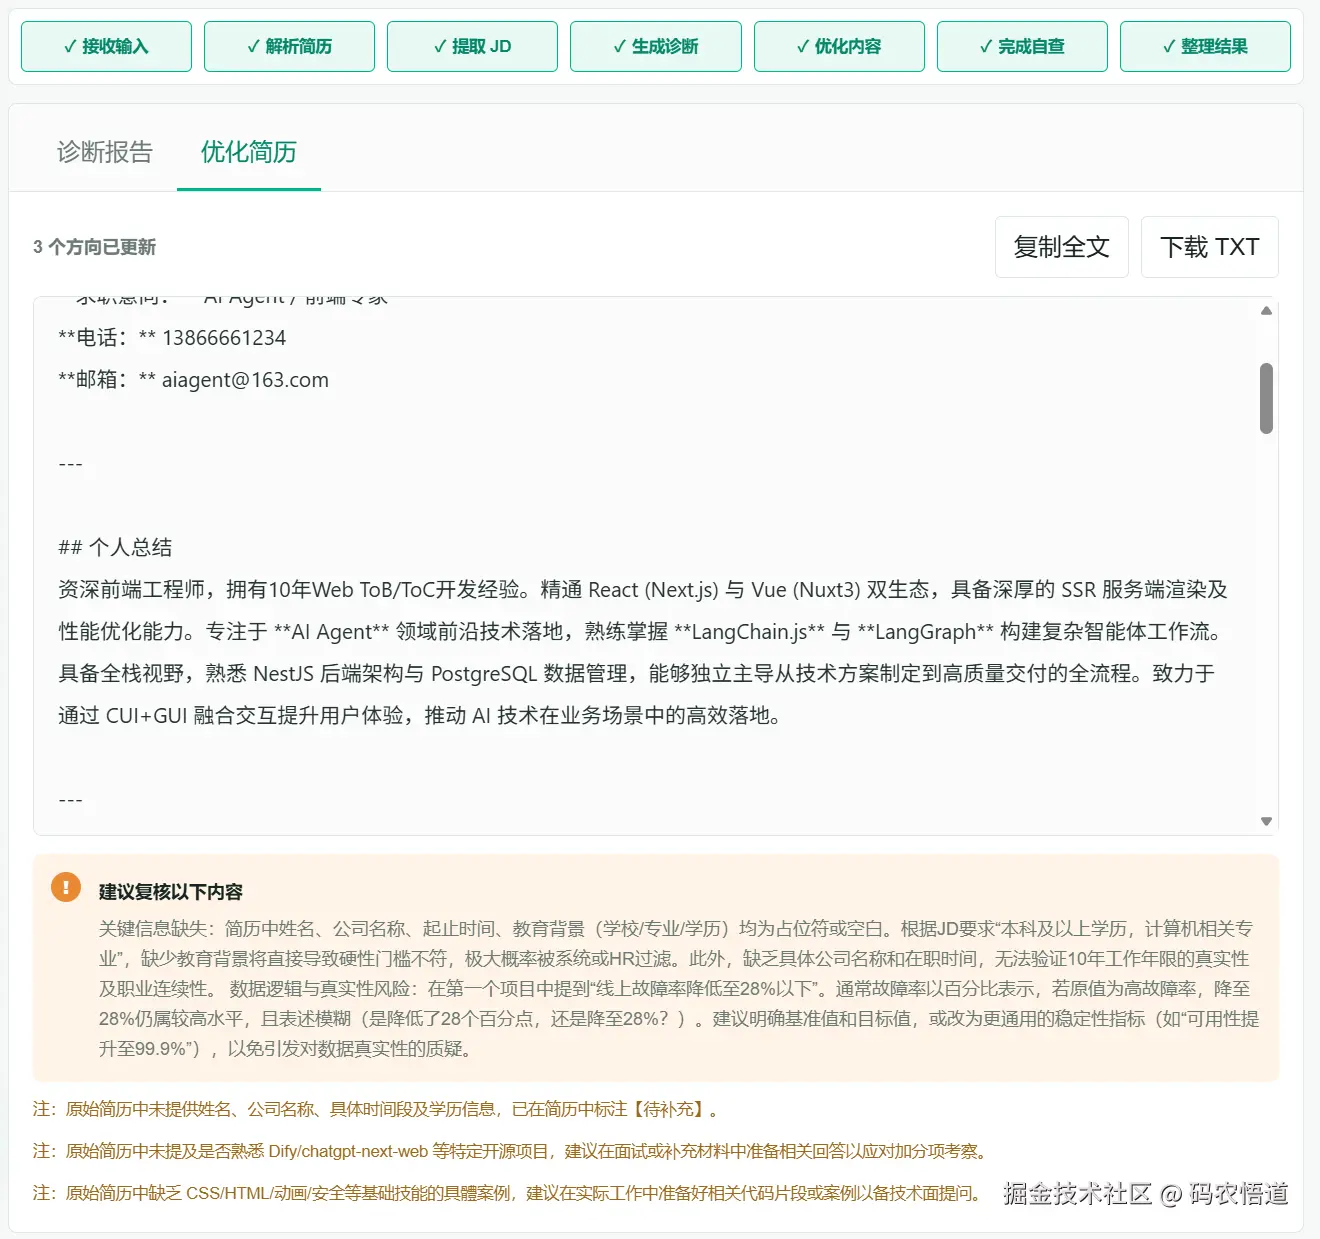
优化简历和建议
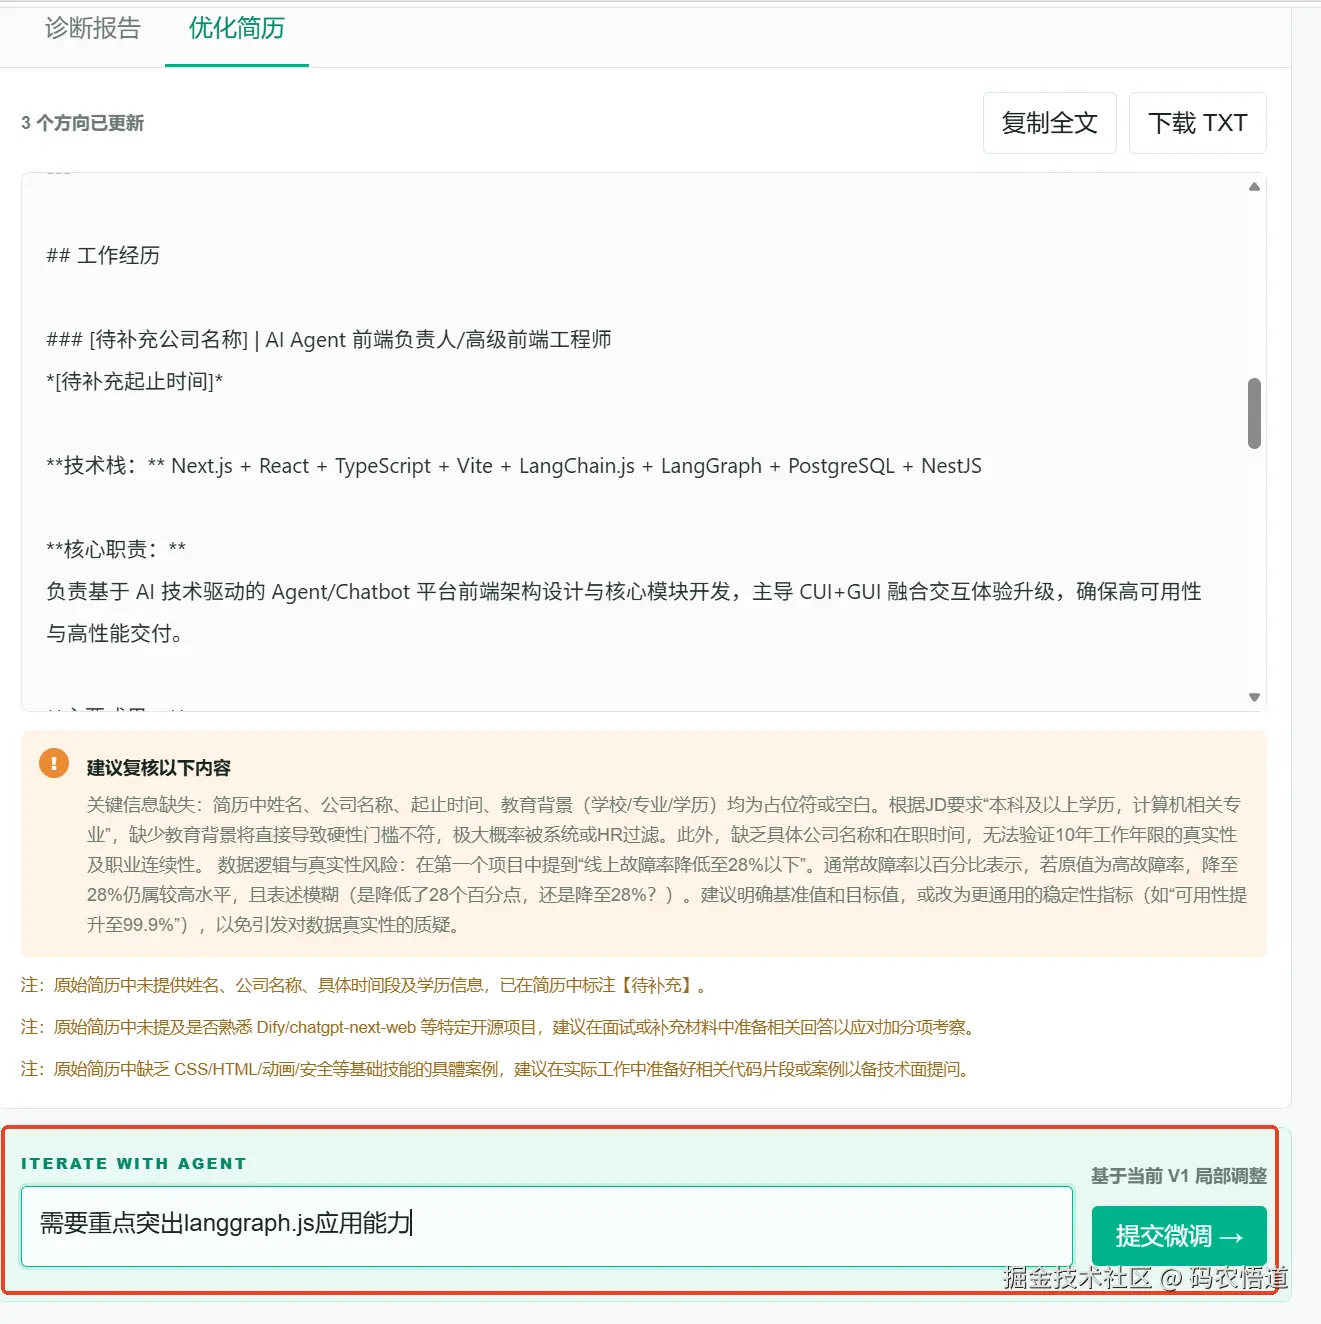
微调:
不同于传统后端主导、重模型、轻体验的大模型开发方案,本项目全程以前端产品思维和工程思维驱动,依托前端轻量化全栈能力,低成本实现了可编排、可自查、可多轮迭代、高交互体验的标准化AI工作流,精准解决了市面主流AI简历工具仅浅层润色、不匹配岗位、内容不可信、无法迭代优化的核心痛点。
本文将从前端开发者专属视角 ,完整复盘项目架构设计、技术选型逻辑、核心代码实现与实战踩坑经验,重点拆解前端工程师落地轻量化AI Agent的天然差异化优势和落地方法论。个人实践有限,仅作技术交流分享,欢迎各位大佬指正交流、共同进步。
一、项目背景:行业痛点 + 前端AI落地新机遇
多数求职者的核心短板,并非缺少项目与工作经历,而是无法贴合目标岗位JD,精准提炼、包装个人履历,导致简历匹配度低、通过率差。目前主流的人工优化、通用AI润色方案,均存在明显短板,无法满足精细化求职优化需求:
-
人工简历优化:付费成本高、迭代周期长,无法支撑用户针对不同岗位快速微调简历,适配性和灵活性极差。
-
通用AI一键润色:仅完成语句通顺、格式美化等表层优化,不深度解析岗位核心诉求与能力模型,无法针对性补齐简历与岗位的能力缺口,优化效果流于形式、缺乏针对性。
-
传统单Prompt AI方案:全量业务逻辑堆砌在单一提示词中,执行流程混乱、模型输出不可控,极易虚构数据、夸大工作成果,且无任何风控自查机制,存在严重的求职诚信风险。
行业固有认知中,AI Agent开发是后端、算法工程师的专属领域,但本次实战让我明确:轻量化C端AI应用落地,前端工程师具备独一无二的天然优势 。我们深耕用户交互、精通流式体验优化、擅长轻量化全栈部署、贴合产品落地逻辑,能够跳出"单纯调用大模型"的浅层思维,真正落地可用、好用、可产品化的AI应用,这也是前端入局AI开发的核心突破口。
基于以上行业痛点与前端技术优势,本项目摒弃传统简历美化工具的单一定位,以前端工程化思维搭建一套标准化、闭环式AI工作流:
Plain
输入简历与JD → 解析简历结构 → 提取岗位要求 → 匹配诊断 → 针对性优化 → 真实性自查 → 多轮微调 → 复制/导出二、项目整体架构:前端全栈轻量化AI落地方案
项目采用 Next.js App Router 前端全栈架构,是典型的前端独立主导、全程自主落地的生产级AI Agent方案。依托Next.js成熟的服务端能力,无需搭建复杂后端服务、无需跨栈学习,即可一站式承载客户端交互、API接口服务、AI工作流编排、文件解析处理、短时会话状态存储等全链路核心能力。整体架构边界清晰、轻量化易部署、业务可快速拓展,完美适配前端开发者的技术栈与落地习惯。
整体架构流程
Plain
Browser
  ├─ 简历上传/文本输入、JD录入(前端核心交互能力)
  ├─ SSE流式进度实时消费(前端AI核心体验优势)
  ├─ 诊断报告、优化简历可视化预览
  └─ 多轮微调、复制下载轻量化操作
Next.js App Router(前端全栈核心载体)
  ├─ 客户端页面交互与视图渲染
  ├─ 服务端标准化业务API接口
  └─ 服务端AI能力调度、工作流节点执行
Server-only Services
  ├─ 文件解析与文本提取
  ├─ 匿名短时会话状态管理
  ├─ LangChain模型调用与结构化输出
  ├─ LangGraph标准化工作流编排
  └─ PostgreSQL状态存储与自动降级兜底
核心模块分工
严格遵循前端工程化单一职责原则,对项目模块进行精细化拆分,实现代码高解耦、高可读、易迭代、易维护:
-
app/page.tsx:前端核心工作台,负责用户交互、SSE流式数据消费、全量结果可视化渲染 -
app/api/optimize/route.ts:首次简历优化核心接口,处理文件表单上传与初始化优化逻辑 -
app/api/optimize/iterate/route.ts:多轮自定义微调接口,支撑用户精细化迭代优化需求 -
lib/server/input/extract.ts:PDF/DOCX文件校验与文本解析核心逻辑 -
lib/server/graph/workflow.ts:LangGraph AI工作流节点定义与完整执行链路编排 -
lib/server/graph/model.ts:大模型能力封装与本地演示模型适配 -
lib/server/session/*:会话状态存储管理与数据库降级策略实现 -
lib/shared/contracts.ts:前后端统一数据结构与Zod校验规则,保障视图层稳定渲染
三、技术选型:贴合前端栈,高效落地产品级AI应用
本次技术选型全程坚守适配前端技术栈、低门槛落地、体验优先、可迭代拓展的核心原则,无需深耕后端、算法复杂技术,依托前端现有技能体系,即可独立落地生产级轻量化AI Agent。
1. Next.js(前端全栈核心)
Next.js是前端开发者落地轻量化AI应用的最优解之一。依托App Router + Node.js运行时,一站式支撑客户端交互、服务端文件处理、SSE流式响应、环境变量隔离等核心能力,完美规避Edge环境下Buffer解析、文件处理、数据库连接的兼容问题。无需独立搭建后端服务,大幅降低前端开发者入局AI项目的技术门槛与开发成本。
2. LangChain.js
原生JS/TS技术栈,完全适配前端开发习惯,零跨栈学习成本。核心价值在于通过Zod结构化约束大模型输出,彻底解决AI输出自由、格式混乱、内容不可控的行业痛点,让诊断评分、能力维度、优势短板、优化建议等核心数据标准化、结构化,保障前端视图层可稳定解析、可视化渲染,从源头规避AI应用体验BUG。
3. LangGraph.js(AI工作流核心)
深度适配JS生态,赋予前端开发者自主拆解、编排、迭代AI业务逻辑的核心能力。将复杂的多阶段简历优化流程,拆解为多个单一职责的可执行节点,实现流程可编排、可回溯、可迭代,彻底告别传统臃肿、不可控的单Prompt开发模式,无需后端介入,前端即可独立完成AI业务的架构设计与迭代优化。
Plain
ingest → parseResume → parseJobDescription → diagnose → optimize → selfCheck → result4. PostgreSQL
轻量化状态存储方案,仅用于存储短生命周期会话数据,包含匿名会话信息、简历诊断结果、优化版本数据等,支撑多轮微调的上下文完整恢复。默认30分钟TTL自动过期,适配轻量化工具定位,同时搭配内存降级策略,完美适配前端项目本地开发、快速演示、轻量化部署的核心场景。
5. Tailwind CSS
依托Tailwind快速搭建高密度工作台式UI,实现左侧输入、右侧结果可视化的清晰布局,界面简洁紧凑、交互流畅。充分发挥前端UI搭建、交互优化的核心优势,彻底摆脱传统AI工具"功能可用、体验粗糙"的普遍问题。
四、核心功能实现(前端视角+完整源码)
本章节以前端工程化、产品化视角,拆解项目核心落地逻辑,重点分享如何用前端思维解决AI应用不稳定、体验差、不可迭代的核心痛点。
4.1 Zod结构化契约:从源头保障前端渲染稳定
从前端开发视角来看,大模型输出的不确定性,是AI产品体验崩坏的核心诱因。自由无规范的文本输出,极易出现字段缺失、数值越界、格式混乱等问题,大幅增加前端兼容适配成本。因此我通过Zod强定义标准化数据结构,强制模型输出规范结构化数据,实现AI输出可预测、前端渲染零兼容成本,从源头稳住产品体验。
Plain
export const diagnosisSchema = z.object({
  score: z.number().int().min(0).max(100),
  dimensions: z.array(
    z.object({
      label: z.string(),
      score: z.number().int().min(0).max(100),
      note: z.string(),
    }),
  ),
  strengths: z.array(z.string()),
  gaps: z.array(z.string()),
  risks: z.array(z.string()),
  recommendations: z.array(z.string()),
});
export const optimizationSchema = z.object({
  resumeText: z.string().min(1),
  changedSections: z.array(z.string()),
  changeSummary: z.string(),
  factWarnings: z.array(z.string()),
});
4.2 LangGraph工作流编排:前端自主掌控AI业务链路
这是前端独立落地生产级AI Agent的核心能力体现。通过LangGraph拆解单一职责节点,将传统串行执行逻辑优化为并行执行+结果汇合的高效模式,简历解析与JD解析同步推进,有效提升整体响应效率。同时多轮微调功能完全复用核心链路,仅替换自定义指令参数,代码复用率高、扩展性强,全程TS编码、类型安全、逻辑清晰,完全贴合前端工程化开发规范。
Plain
const graphBuilder = new StateGraph(ResumeState)
  .addNode("ingest", async () => ({}))
  .addNode("parseResume", async (state) => ({
    parsedResume: await parseResume(state.resumeText),
  }))
  .addNode("parseJobDescription", async (state) => ({
    jobProfile: await parseJobDescription(state.jobDescription),
  }))
  .addNode("diagnose", async (state) => ({
    diagnosis: await diagnose(
      state.resumeText,
      state.jobDescription,
      state.parsedResume!,
      state.jobProfile!,
    ),
  }))
  .addNode("optimize", async (state) => ({
    optimization: await optimize(
      state.resumeText,
      state.jobDescription,
      state.diagnosis!,
      state.mode === "iterate" ? state.instruction : state.preferences,
    ),
  }))
  .addNode("selfCheck", async (state) => ({
    validation: await selfCheck(state.resumeText, state.optimization!, state.jobDescription),
  }))
  .addNode("result", async () => ({}))
  .addEdge(START, "ingest")
  .addEdge("ingest", "parseResume")
  .addEdge("ingest", "parseJobDescription")
  .addEdge(["parseResume", "parseJobDescription"], "diagnose")
  .addEdge("diagnose", "optimize")
  .addEdge("optimize", "selfCheck")
  .addEdge("selfCheck", "result")
  .addEdge("result", END);
4.3 双模型兜底:适配前端本地开发与演示场景
针对前端项目本地调试、开源演示、无密钥运行的高频场景,我设计了真实大模型+本地模拟模型双运行模式,无OpenAI密钥也能完整跑通项目全流程,彻底解决传统AI项目"无密钥无法运行"的痛点,大幅降低前端AI项目的开发、调试、分享与二次开发门槛。
Plain
const model = hasLiveModel()
  ? new ChatOpenAI({
      apiKey: config.openAiApiKey,
      model: config.openAiModel,
      configuration: {
        baseURL: config.baseUrl,
      },
      temperature: 0.2,
    })
  : undefined;
以简历解析功能为例,无真实模型时自动降级本地模拟逻辑,保障页面交互、流程跳转、结果渲染完全正常,不影响项目演示与二次开发:
Plain
export async function parseResume(text: string): Promise<ParsedResume> {
  if (!model) return localParseResume(text);
  const structured = model.withStructuredOutput(parsedResumeSchema, {
    name: "parse_resume",
  });
  return structured.invoke([
    ["system", "你是简历结构化解析器。只从用户提供的简历中提取事实,不要补造任何经历。"],
    ["human", `请把以下简历解析为结构化数据。nn${text}`],
  ]);
}
4.4 SSE流式输出:前端AI产品的核心体验壁垒
极致体验优化,是前端工程师做AI Agent最大的差异化壁垒。传统后端AI方案多等待模型推理完成后一次性返回结果,长耗时推理任务会让页面处于空白加载状态,用户极易误以为程序卡死、功能失效。而前端可通过SSE流式通信,实现分阶段进度推送、增量内容渲染,将黑盒化的模型推理过程完全透明化,从根本上解决AI产品交互生硬、反馈缺失的核心痛点。
Plain
return new Response(run.stream, {
  status: 200,
  headers: {
    "Content-Type": "text/event-stream; charset=utf-8",
    "Cache-Control": "no-cache, no-transform",
    Connection: "keep-alive",
    "X-Accel-Buffering": "no",
    "X-Session-Id": run.session.sessionId,
  },
});
服务端实时推送流程启停、阶段完成、诊断就绪、简历增量更新、异常报错等全量事件,前端逐帧渲染状态与内容,让用户全程感知执行进度,彻底消除等待焦虑,这是纯后端AI方案无法实现的体验优势。
4.5 安全文件解析:前端全栈能力闭环
依托Next.js服务端能力,前端可独立完成文件上传、合法性校验、内存解析的全链路闭环能力,无需依赖第三方后端接口。所有PDF/DOCX文件均在内存中解析、不落地存储,兼顾用户隐私与系统安全,同时通过文件签名、格式、大小三重校验,精准拦截无效、破损、非法文件,大幅提升系统稳定性。
Plain
const buffer = Buffer.from(await file.arrayBuffer());
const signature = buffer.subarray(0, 4).toString("ascii");
if (isPdf && signature !== "%PDF") {
  throw new InputError("UNSUPPORTED_FILE", "文件内容不是有效的 PDF。");
}
if (isDocx && buffer.subarray(0, 2).toString("hex") !== "504b") {
  throw new InputError("UNSUPPORTED_FILE", "文件内容不是有效的 DOCX。");
}
项目基于 pdf-parse 解析PDF文档、mammoth 解析DOCX文档,同时适配扫描型PDF无可复制文字的场景,给予用户清晰友好的提示,细节体验拉满。
4.6 数据库自动降级:适配前端轻量化部署逻辑
前端轻量化项目的核心诉求是低配置、易部署、零障碍可用。因此我设计了短时匿名会话机制与双存储降级策略,默认30分钟会话TTL,优先使用PostgreSQL持久化状态;当数据库未启动、配置缺失或异常时,自动降级为内存存储,不会因环境配置问题导致项目功能瘫痪,极大提升了项目的稳定性和可演示性。
Plain
export const SESSION_TTL_MS = 30 * 60 * 1000;

async function withDatabaseFallback<T>(operation: () => Promise<T>, fallback: T): Promise<T> {
  try {
    return await operation();
  } catch (error) {
    warnDatabaseFallback(error);
    return fallback;
  }
}
五、前端体验设计:打造AI产品差异化核心竞争力
传统AI工具普遍存在"重功能、轻体验"的通病,仅机械输出最终结果,交互生硬、进度反馈缺失、用户感知薄弱。而前端主导开发AI产品的核心优势,就是以用户体验为核心,重构AI产品交互逻辑。
本项目摒弃单调的空白加载模式,采用轻量化工作台可视化布局:左侧统一收纳简历上传、JD录入、个性化需求输入,操作集中高效;右侧分层实时展示执行进度、岗位匹配诊断报告、优化后简历内容,支持随时多轮微调、一键复制、文件下载。依托前端交互优化能力,实现进度透明、结果分层、即时迭代的优质体验,用户无需等待最终简历生成,即可提前查看岗位短板与优化建议,体验远超传统流水线式AI工具。
六、实战踩坑与解决方案(前端AI专属问题)
汇总本次前端独立落地AI Agent过程中遇到的专属问题,结合前端技术特性整理针对性解决方案,可直接复用至各类前端AI项目开发:
-
单Prompt流程混乱,前端视图适配困难:早期单Prompt混杂多类业务逻辑,模型输出杂乱无章,前端无法标准化渲染。解决方案:通过LangGraph拆分单一职责节点,实现流程标准化、输出结构化,完美适配前端视图层渲染逻辑。
-
AI自由输出易虚构内容,导致体验翻车:模型为优化效果易虚构数据、夸大经历,误导用户。解决方案:搭建系统提示约束+前端风险提示+独立自查节点的三层风控体系,坚守真实优化原则。
-
Next环境PDF解析兼容异常:Next Turbopack环境下,pdf-parse默认Worker路径失效,文件解析报错。解决方案:手动注入Worker配置,精准适配Next服务端运行环境。
-
数据库依赖导致项目无法演示:本地开发常出现数据库未启动、配置缺失问题,导致功能瘫痪。解决方案:双存储自动降级策略,无数据库环境仍可完整使用核心功能。
-
大模型长耗时引发用户卡顿误判:模型推理延迟高,静态加载反馈单一,用户易判定页面卡死。解决方案:SSE分阶段流式推送,前端增量渲染进度与内容,实时同步运行状态。
Plain
function ensurePdfWorker() {
  if (pdfWorkerReady) return;
  PDFParse.setWorker(getPdfWorkerData());
  pdfWorkerReady = true;
}
七、本地运行与工程规范
项目全程遵循前端标准化工程化规范,代码整洁规范、开箱即用,非常适合前端开发者学习、调试与二次开发:
Plain
# 依赖安装 & 本地启动
pnpm install
pnpm dev

# 启动PostgreSQL(可选,不启动也可正常演示核心功能)
docker compose up -d

# 前端代码质量校验
pnpm lint
pnpm exec tsc -p tsconfig.json --noEmit
pnpm build
pnpm format:check
项目集成Prettier自动格式化工具,配合TS强类型约束,保证代码风格统一、类型安全,完全贴合前端日常开发工程规范。
八、项目总结:重新定义前端AI Agent的核心价值
通过本次ResumeGraph项目全流程落地,我收获了核心认知:当下AI应用的核心壁垒,早已不是"会不会调用大模型",而是能否将零散的AI能力工程化、稳定化、产品化、体验化,而这正是前端工程师的核心竞争力。
相较于后端、算法工程师,前端开发者落地轻量化AI Agent,拥有三大不可替代的核心优势:
-
极致产品体验优势:深耕用户交互、流式渲染、可视化展示,能够解决绝大多数AI产品"反馈不透明、等待卡顿、交互生硬"的通病,让AI从"可用功能"升级为"好用产品"。
-
轻量化全栈落地优势:依托Next.js全栈能力,无需依赖后端服务,前端可独立完成页面、接口、文件处理、AI工作流的全链路开发,落地效率更高、成本更低、迭代更灵活。
-
工程化稳定优势:熟练运用TS类型约束、模块化拆分、标准化输出,有效解决AI输出不确定性的行业难题,让AI项目从"临时Demo"升级为可迭代、可上线的生产级产品。
本项目的核心价值,不在于复杂的模型调用与算法优化,而在于以前端工程思维和产品思维,将零散的大模型能力,梳理为稳定、可信、可迭代、高体验的标准化业务工作流。后续将持续迭代OCR扫描件识别、简历版本管理、标准文档导出、行业专项优化、面试题预测等功能,持续完善前端AI Agent的产品形态。
写在最后
AI时代正在拓宽前端开发者的职业边界,我们早已不再是单纯的页面开发者,而是可以独立落地完整AI产品的全栈创造者。本次实践只是我对前端AI落地的一次粗浅探索,项目架构与代码仍有诸多优化空间,欢迎各位技术伙伴交流探讨、互相学习。希望这篇复盘,能帮助更多前端同学打破AI开发壁垒,掌握轻量化AI Agent的落地思路,解锁前端开发的全新可能性!