一、概念
**归一化(Normalization)就是把数据按某种规则缩放到统一的尺度上,消除不同维度之间"量纲"和"数量级"的差异,让模型公平地对待每一个特征。**它不改变数据的相对关系,只改变数据的"刻度"。
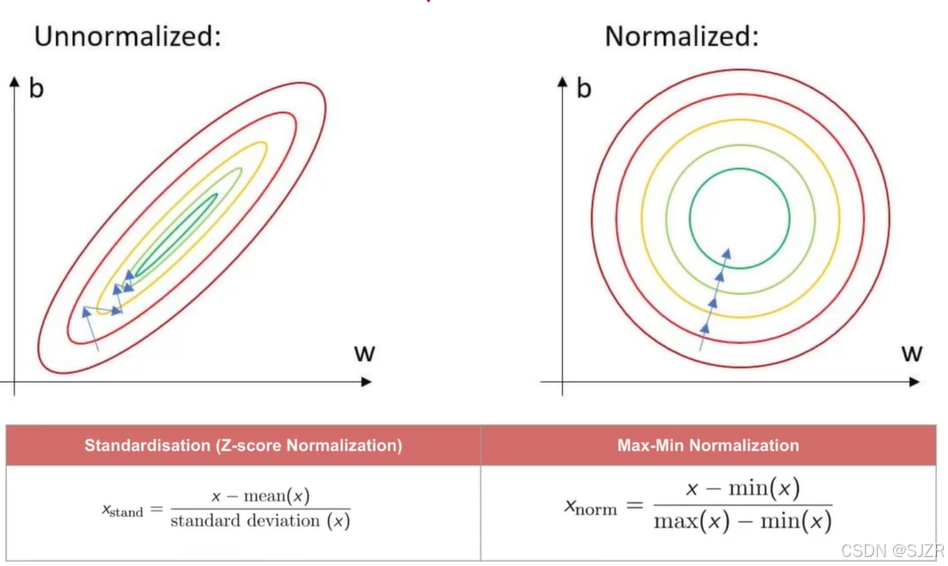
结合实例理解,假设你要预测房价,只用两个特征:
| 样本 | 面积(㎡) | 房间数 | 真实房价(万) |
|---|---|---|---|
| A | 120 | 3 | 400 |
| B | 85 | 2 | 280 |
| C | 200 | 5 | 700 |
- 面积的数值范围是 85~200(量级上百)
- 房间数的数值范围是 2~5(量级个位)
如果直接丢进线性模型 y=w1x1+w2x2+by = w_1 x_1 + w_2 x_2 + by=w1x1+w2x2+b,会发生两件事:
1. 权重失去可比性。 面积每增加 1㎡,房价可能涨 2 万;房间数每增加 1 间,房价可能涨 30 万。但因为面积的数值大 40 倍,它的权重 w1w_1w1 会被压到很小(约 0.05 量级),而 w2w_2w2 会很大(约 30 量级)。无法通过"看权重大小"来判断哪个特征更重要。
2. 梯度下降走得极其别扭(更本质的原因)。 损失函数的等高线会变成一个极度拉长的椭圆。梯度方向总是垂直于等高线,所以更新轨迹会变成"之字形锯齿":在长轴方向来回震荡,在短轴方向挪动极慢。学习率只能迁就最陡的方向,导致收敛慢几十倍甚至不收敛。
归一化之后,等高线接近正圆,梯度直指圆心,几步就能到位。这也是为什么归一化常常能让训练速度提升一个数量级。
二、不同层次的归一化
| 层次 | 对象 | 目的 | 典型方法 |
|---|---|---|---|
| ① 特征层 | 输入数据的每一列(特征) | 消除量纲,加速收敛 | Min-Max、Z-score、MaxAbs |
| ② 网络层 | 神经网络中间的激活值 | 防止内部协变量偏移、稳定梯度、允许更大学习率 | BatchNorm、LayerNorm、RMSNorm |
| ③ 向量层 | 单个样本向量 | 只看方向不看大小 | L2 归一化(单位向量) |
1、Min-Max 归一化(最"标准"的归一化)
x′=x−xminxmax−xmin∈0,1x' = \frac{x - x_{\min}}{x_{\max} - x_{\min}} \quad \in 0, 1x′=xmax−xminx−xmin∈0,1
手算 :面积列 xmin=85, xmax=200x_{\min}=85,\ x_{\max}=200xmin=85, xmax=200
- A: (120−85)/(200−85)=35/115≈0.304(120-85)/(200-85) = 35/115 \approx 0.304(120−85)/(200−85)=35/115≈0.304
- B: (85−85)/115=0(85-85)/115 = 0(85−85)/115=0
- C: (200−85)/115=1.0(200-85)/115 = 1.0(200−85)/115=1.0
特点 :保留原始分布形状(线性变换),输出严格有界。
缺点 :对异常值极度敏感 。若 C 的面积是 2000㎡,则 A、B 都会被压缩到 0.02 附近,区分度几乎消失。
适用:图像像素(0~255 → 0~1)、边界明确的物理量、神经网络输入层。
2、 Z-score 标准化(Standardization,严格说叫"标准化"而非"归一化")
x′=x−μσ,μ=1n∑xi, σ=1n∑(xi−μ)2x' = \frac{x - \mu}{\sigma},\qquad \mu=\frac{1}{n}\sum x_i,\ \ \sigma=\sqrt{\frac{1}{n}\sum(x_i-\mu)^2}x′=σx−μ,μ=n1∑xi, σ=n1∑(xi−μ)2
变换后均值为 0、标准差为 1,无固定上下界。
手算 :面积均值 μ=135\mu=135μ=135,标准差 σ≈47.6\sigma\approx47.6σ≈47.6
- A: (120−135)/47.6≈−0.315(120-135)/47.6 \approx -0.315(120−135)/47.6≈−0.315
- B: (85−135)/47.6≈−1.05(85-135)/47.6 \approx -1.05(85−135)/47.6≈−1.05
- C: (200−135)/47.6≈1.366(200-135)/47.6 \approx 1.366(200−135)/47.6≈1.366
特点 :均值和标准差比 min/max 稳健一些,输出以 0 为中心。
适用 :绝大多数场景的默认首选,尤其是数据近似高斯分布时。
3、MaxAbs 缩放
x′=xmax(∣x∣)∈−1,1x' = \frac{x}{\max(|x|)} \quad \in -1, 1x′=max(∣x∣)x∈−1,1
只做除法不做减法,不破坏稀疏性 (0 还是 0)。
适用:稀疏矩阵、TF-IDF 文本特征、已经以 0 为中心的数据。
4、RobustScaler(抗异常值版)
x′=x−medianQ3−Q1x' = \frac{x - \text{median}}{Q_3 - Q_1}x′=Q3−Q1x−median
用中位数和四分位距代替均值和标准差。
适用:含大量离群点的工业数据、传感器异常读数。
5、L2 归一化(向量层)
x′=x∥x∥2\mathbf{x}' = \frac{\mathbf{x}}{\|\mathbf{x}\|_2}x′=∥x∥2x
把每个样本向量缩成单位长度 ,只保留方向信息。
适用:文本 TF-IDF 向量后接余弦相似度、对比学习中的 embedding、SVM/RBF 核之前。
三、概念及用法区分
| 术语 | 严格含义 | 日常用法 |
|---|---|---|
| 归一化 Normalization | 缩放到固定区间(如 0,1) | 泛指一切尺度变换 |
| 标准化 Standardization | 减均值除标准差,结果无界 | 常与归一化混用 |
| 正则化 Regularization | 指加惩罚项抑制过拟合(L1/L2/Dropout) | 英文拼写相近,常被听错 |
| BatchNorm / LayerNorm | 网络内部的归一化层 | 也叫"BN层""LN层" |
四、激活函数和归一化特点
归一化负责把数据"送到激活函数最好用的区间",激活函数负责在这个区间里"做非线性变换"。 归一化决定了激活函数的输入 zzz 落在哪里,而激活函数的导数 f′(z)f'(z)f′(z) 又决定了梯度能不能传回去。