新一代 Claude 模型有一个很好用的特性,在 Claude Code 里调 effort 不会让 prompt cache 失效。但我收到了很多相关提问:effort 到底是什么,什么时候该用哪一档,为什么需要 effort 这个设置。
为了回答这些问题,我仔细翻了评测数据,也在日常工作里自己测了不同的 effort。
总的来看,effort 调节的是 Claude 做多少验证和边界测试,以及它自己拿多少主意。在验证和边界测试更有用的领域,比如硬件、代码审查和安全,调高 effort 的效果更好。
日常写代码时,我用的流程是先让模型反过来问我需求,用 low 实现,我审一遍它做出来的东西,最后用 high 做验证。
effort 是什么
effort 告诉模型你大致希望它在这个任务上花多少算力,和你对任务难度的估计有一定关系。
可以这样理解。如果有人让你连续做 12 个小时,你大概会认为对方就是要你全力以赴。如果同样的事只给你 1 个小时,你会先交出一个满足需求的最好版本,然后预期再迭代。
你也可能会反驳说这事至少要 3 个小时,然后花 3 个小时把它做完。
effort 也是这个意思。Claude 在任何档位都会合理地完成任务,effort 越高,它越会自己做判断、自己做验证。
effort 曲线
Fable 5.1 和 Opus 5.5 的 effort 曲线是目前最好的,每升一档,benchmark 分数和消耗的 token 都会上升。
图中的 Terminal-Bench 3.0 结果,每个模型跑的是同样 70 个任务,4 个 GPU 任务没有算进去。Opus 5.5 的测试晚了大约三周,单次回复上限 128k token,不能访问 GitHub 和 PyPI。Opus 5 的 max 取的是它 effort-120 的那次运行。
这在实际使用中意味着什么?为了弄清楚,我在不同 effort 下试了几类任务,也把 benchmark 仔细读了一遍。
用不同 effort 做同一个东西
要理解模型怎么工作,最好的办法是做实验。我在 Opus 5.5 上用几个不同档位做同样的任务,看它分别会做哪些事。实际测的任务范围很广,这里只拿几个简单的例子说明。
需求不明确的构建任务
如果我让 Claude 「做一个个人健身和训练记录 app」,effort 会大幅改变 app 的完成度,Claude 一路上替我做的决定也会变多。low 档做出来的只是一个记录表加一张简单的图。档位越高,app 越复杂、细节越多。max 档还多了一张热力图。
如果我想要一个简单的底子再往上迭代,low 就够了。如果想让 Claude 一次拿出最好的版本,就用 max。
需求大致明确的设计任务
如果任务已经说得比较清楚,但我还想和 Claude 一起探索一下呢?我试着让它重新设计 Claude Code 的 /config 菜单。每一档给出的思路都差不多,都是用子菜单和更好的搜索。
low 档用了 1 分钟,给了一个能表达思路的交互草图,但看起来不太像 Claude Code。
max 档用了 28 分钟,给了一个很像 Claude Code 的样稿,还附带了好几个不同流程的演示。
如果我的目的是反复迭代、给反馈,low 快得多。max 一上来就给出成品度高得多的东西。就这个任务而言,我更倾向于用 low 先看懂 Claude 的思路。
需求非常明确的构建任务
如果我给 Claude 很多细节呢?我先让 Claude 就健身 app 详细地问我一轮,把得到的需求文档交给不同模型、不同档位去实现。
有了这份需求文档,各个模型的表现接近了很多。做出来的设计长得差不多,实现也相似,只在细节上不同。max 档的 Claude 还花时间把几处细节简化了。
小结
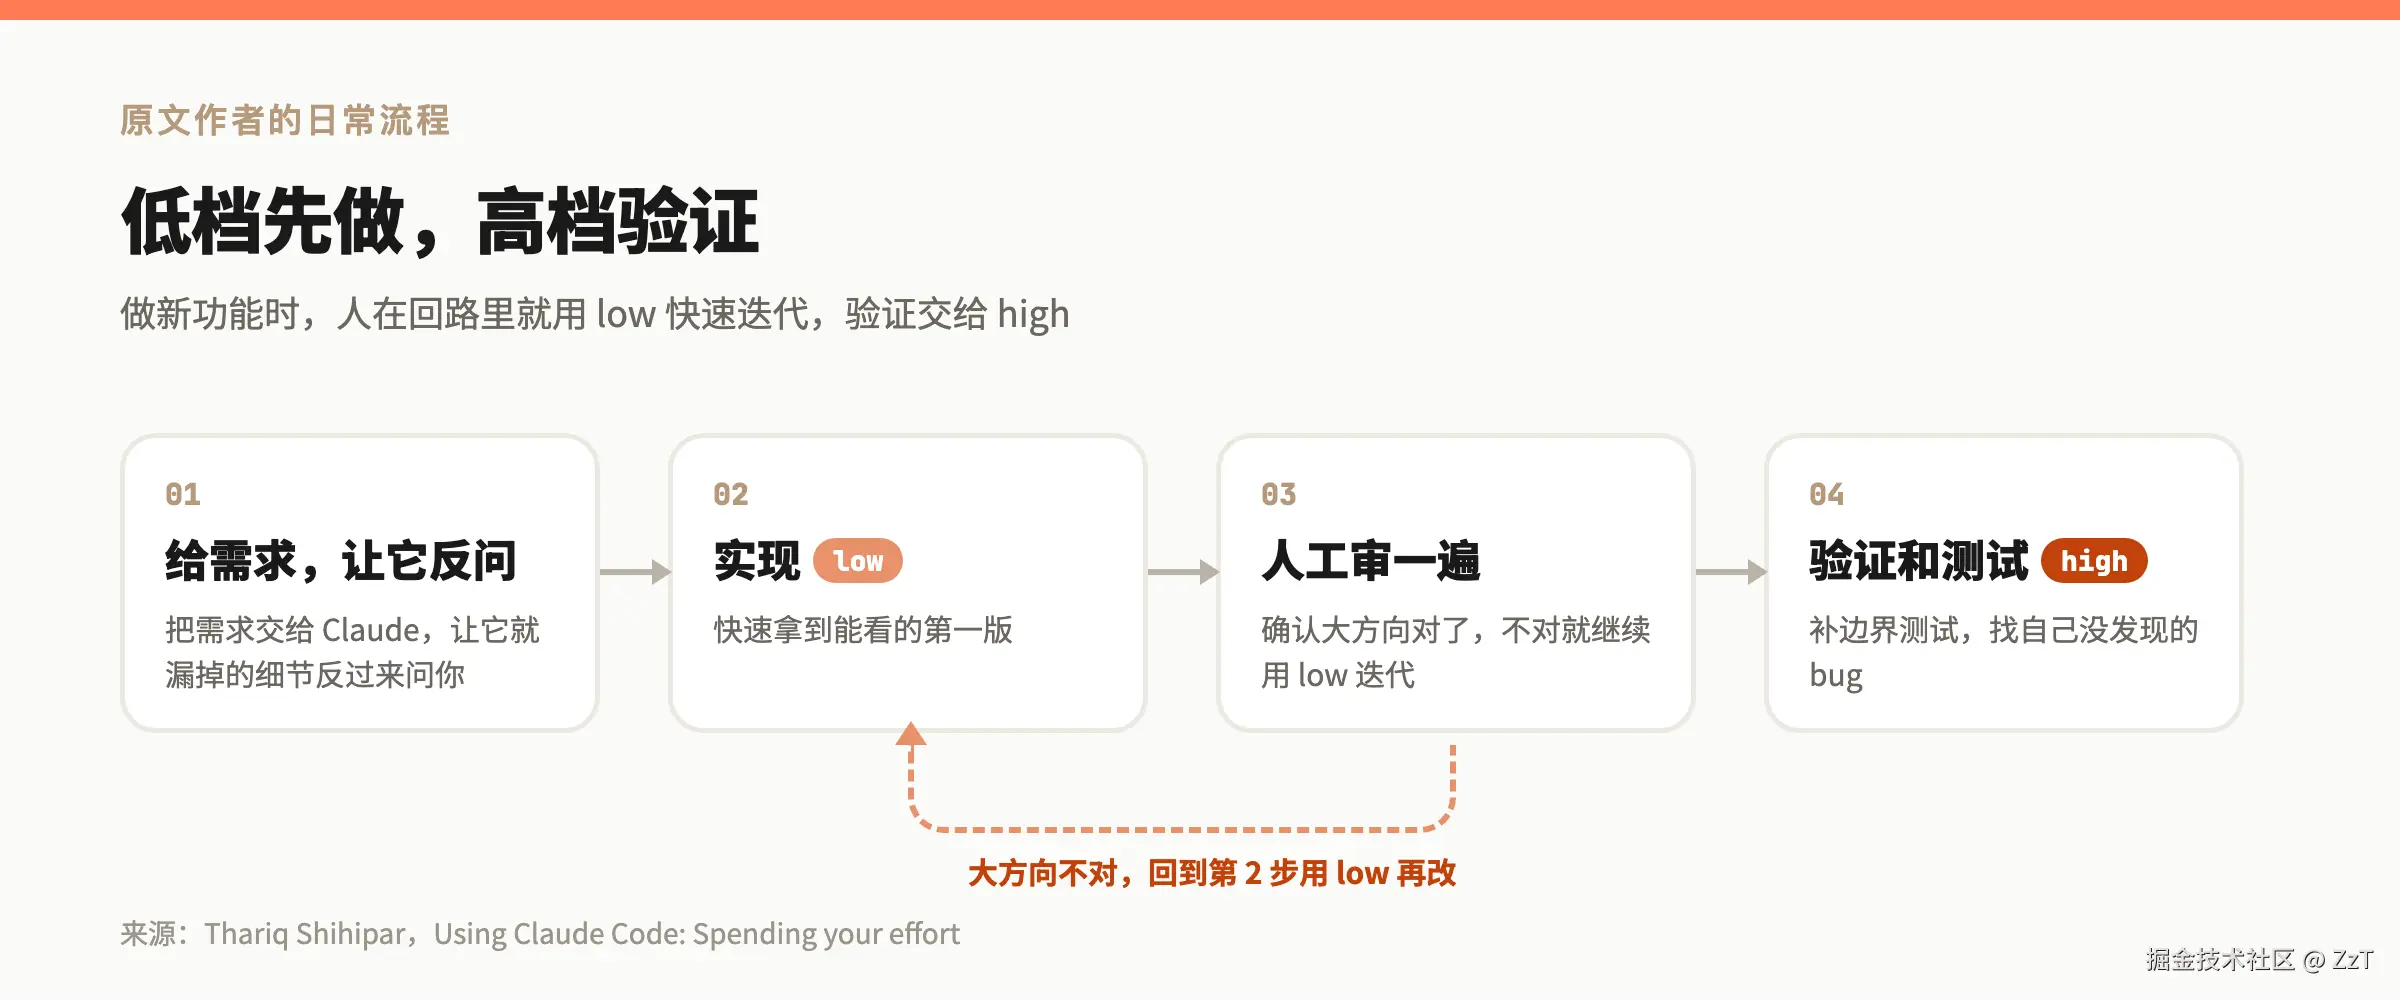
日常软件开发,尤其是做新功能时,选哪一档很大程度上取决于我想参与多少。low 档让 Claude 很快给出一个起点。档位越高,做完的活越多,但 Claude 替我做的假设也越多。
我做功能开发时一直在用的一个流程很有效:
- 把需求给 Claude,让它就我漏掉的细节反过来问我
- 用 low 实现
- 审一遍,确认大方向对了,需要的话继续用 low 迭代
- 用 high 做验证和测试
难题上,effort 怎样影响结果
上面这些显然是简单例子,Claude 完全做得出来。如果差别在于 Claude 能不能把任务做成呢?
要找这类难题,得去看 benchmark。我选了一个自己喜欢的社区 benchmark,Terminal-Bench 3.0。
Terminal-Bench 3.0 的题目大致分为安全、硬件、机器学习、科学、软件、运维和媒体几类。全部题目可以在 GitHub 上看到。题目来自社区,任何人都能贡献。
这些题目值得读一读,能感受到模型面对的是什么样的问题。很多任务的范围和难度让我吃惊,比我平时遇到的任务复杂得多。比如:
- 硬件(
retro-console-soc):用 Verilog 做一台能装进小型 FPGA 的 8 位游戏机,并渲染一个测试 ROM。 - 科学(
takens-embedding-lean):用 Lean 4 形式化证明 Takens 嵌入定理。 - 机器学习(
mp-checkpoint-consolidation):把一个混合专家模型 checkpoint 的 16 个分片合并成一个文件,并复现参考 logits。 - 运维(
intrastat-meldung):端到端地完成一家公司月末的欧盟贸易统计申报。 - 媒体(
layout-config-recreation):把一张海报图重建成可编辑的排版文件。
隐藏边界情况多的任务,effort 越高越有用
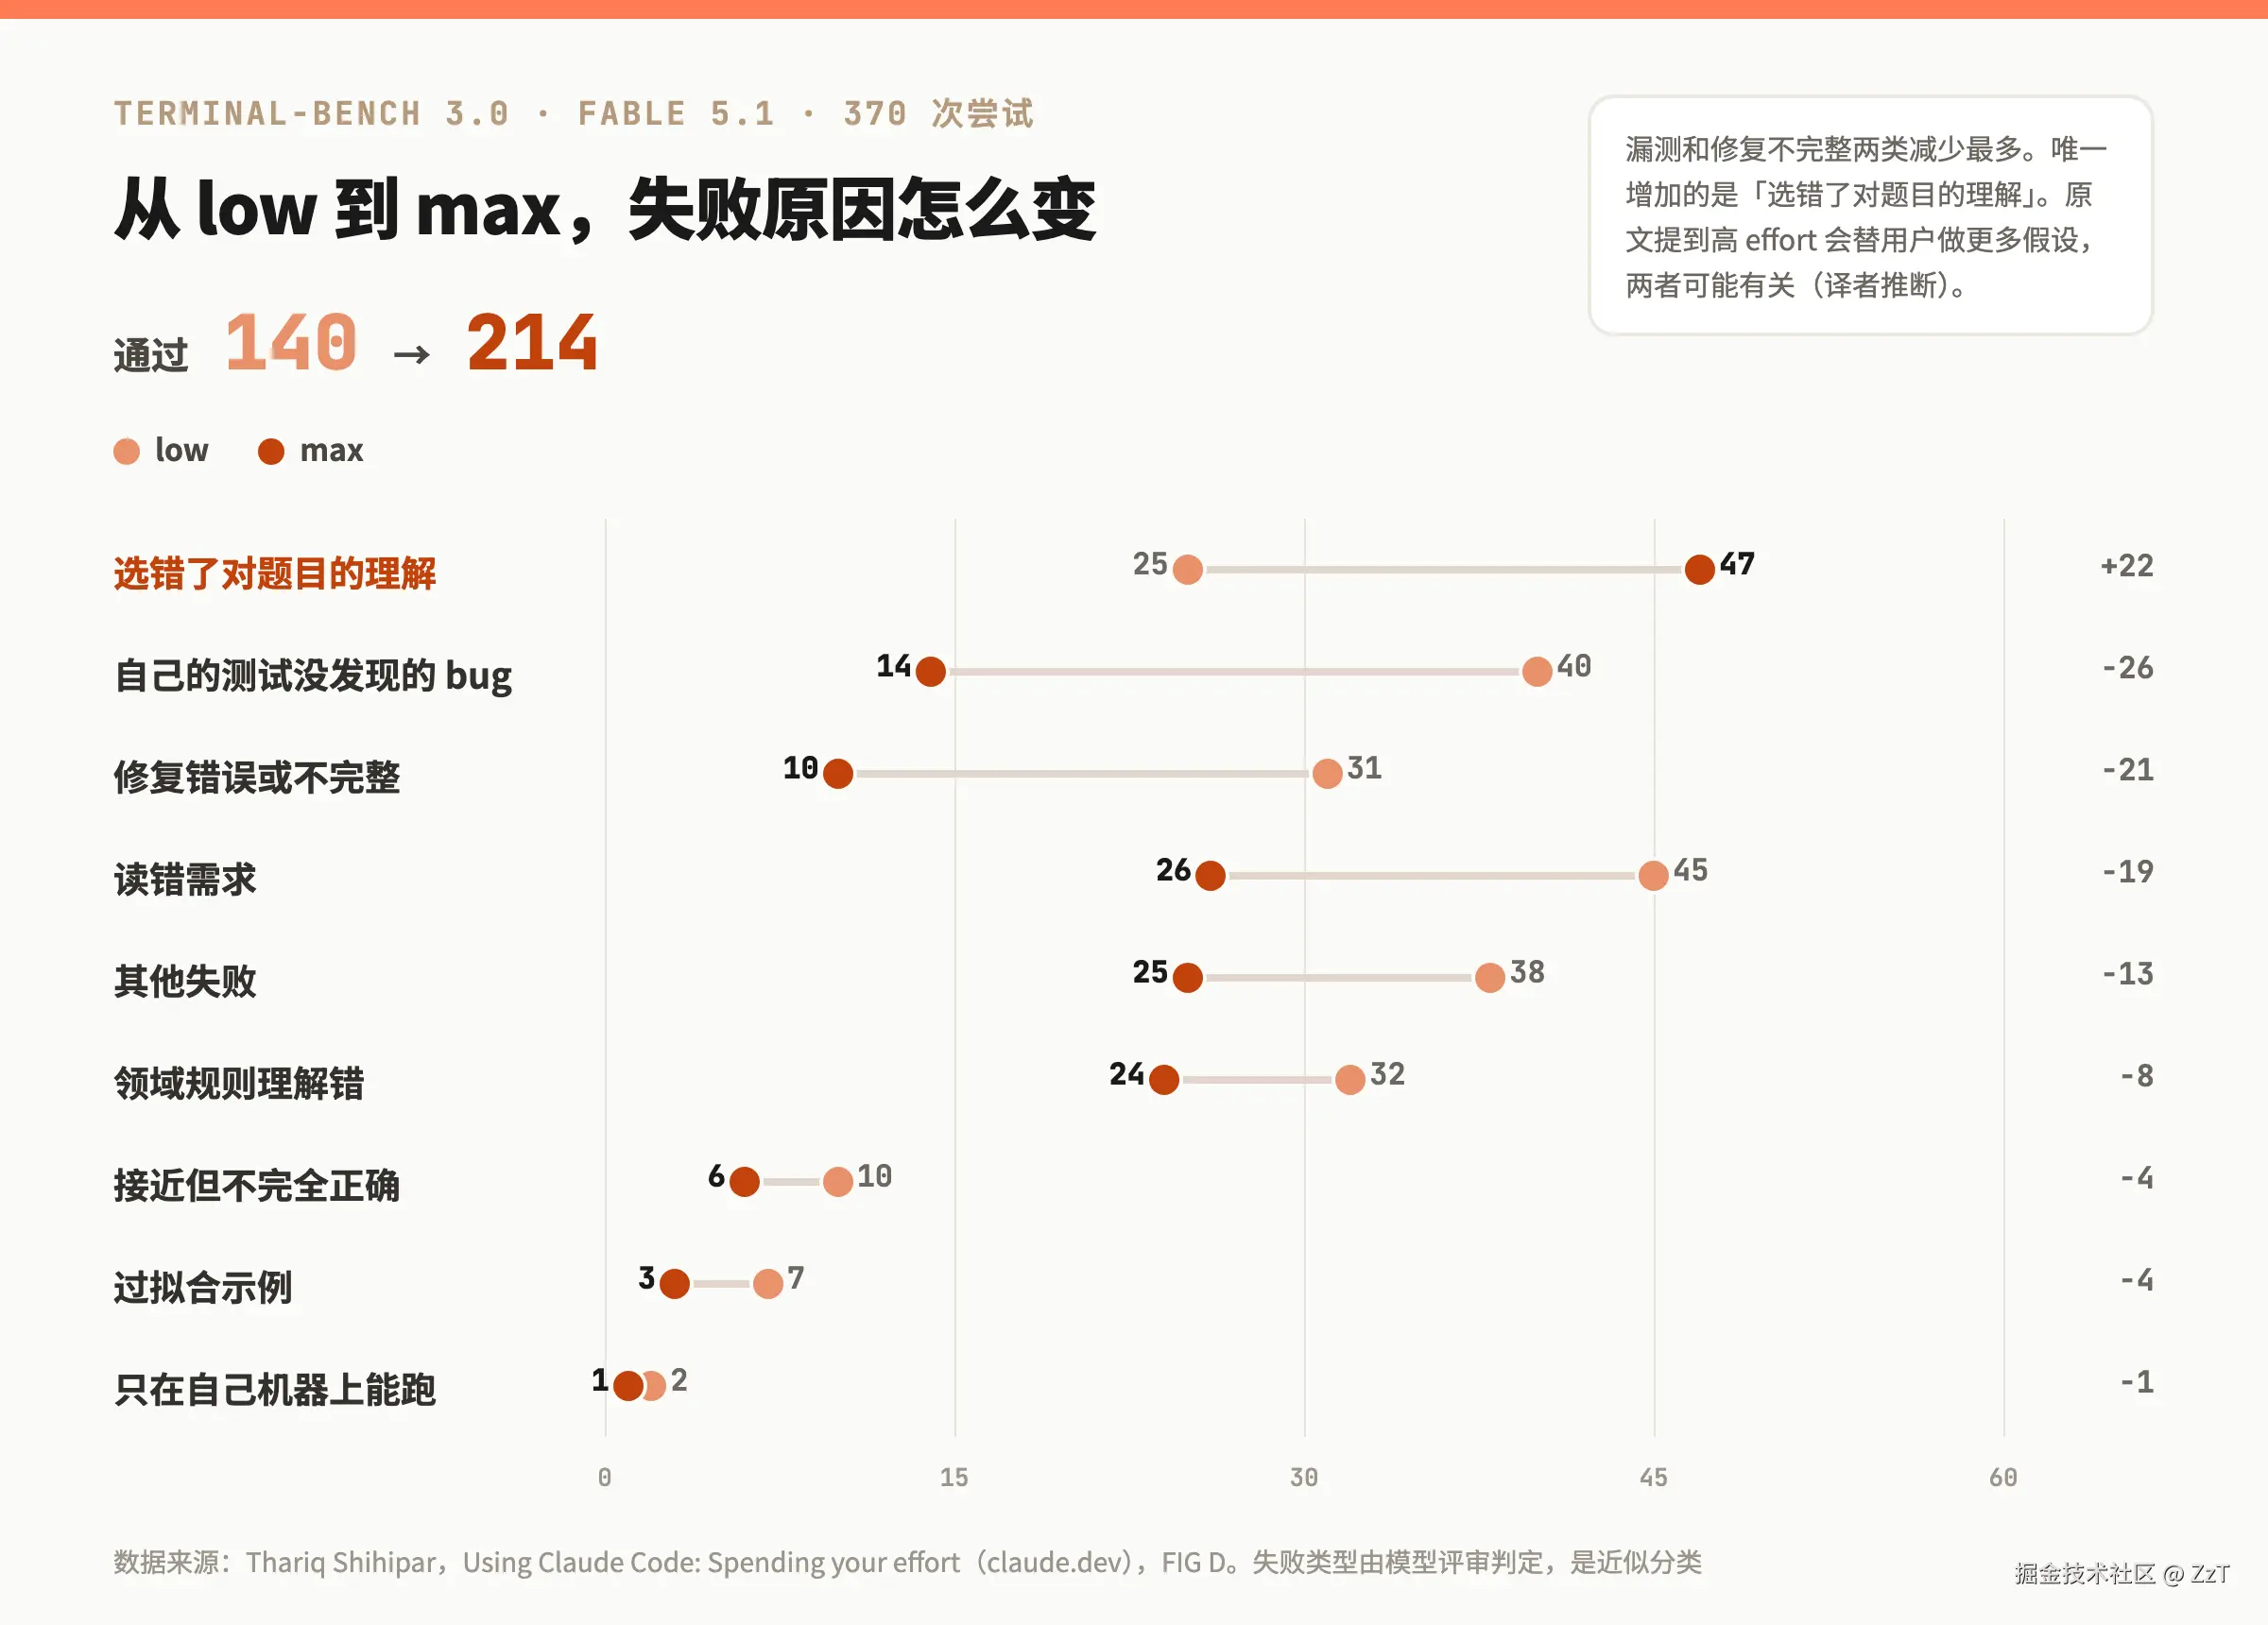
读完 Terminal-Bench 3.0 的结果,我最大的收获是,高 effort 最适合隐藏边界情况很多的任务。
一个典型例子是 html-js-filter。这道题要求写一个 HTML 清洗器,挡住所有把 JavaScript 偷偷塞进页面的方式。Fable 5.1 在 low 档是 5 次通过 1 次,到 xhigh 是 5 次全过。¹
low 档一次尝试大约 2 分钟。每次都是一遍写完过滤器,然后拿一个手写的页面测一下。
high 档一次大约 33 分钟。在我跟踪的那次运行里,它先以挑错的角度审了一遍自己的初稿,然后去读已安装的解析器源码找 bug,跑了很多干净的测试用例,直到输出和输入一致,又跑了一套标准的 XSS 测试集,最后写了一个随机文档的 fuzzer。
HTML 清洗器这种边界情况多的任务,多花这份工夫完全值得。性能优化、安全审查这类对生产质量要求高的复杂任务,也值得多花 token 求周全。
但不是每个任务都需要这么高的 effort。
本节开头的图是 Terminal-Bench 3.0 的全部结果,按失败原因分类。总体看,调高 effort 会减少因为漏掉边界情况而失败的次数,但模型思路错了的时候,调高 effort 救不回来。
effort 在哪些领域帮助更大
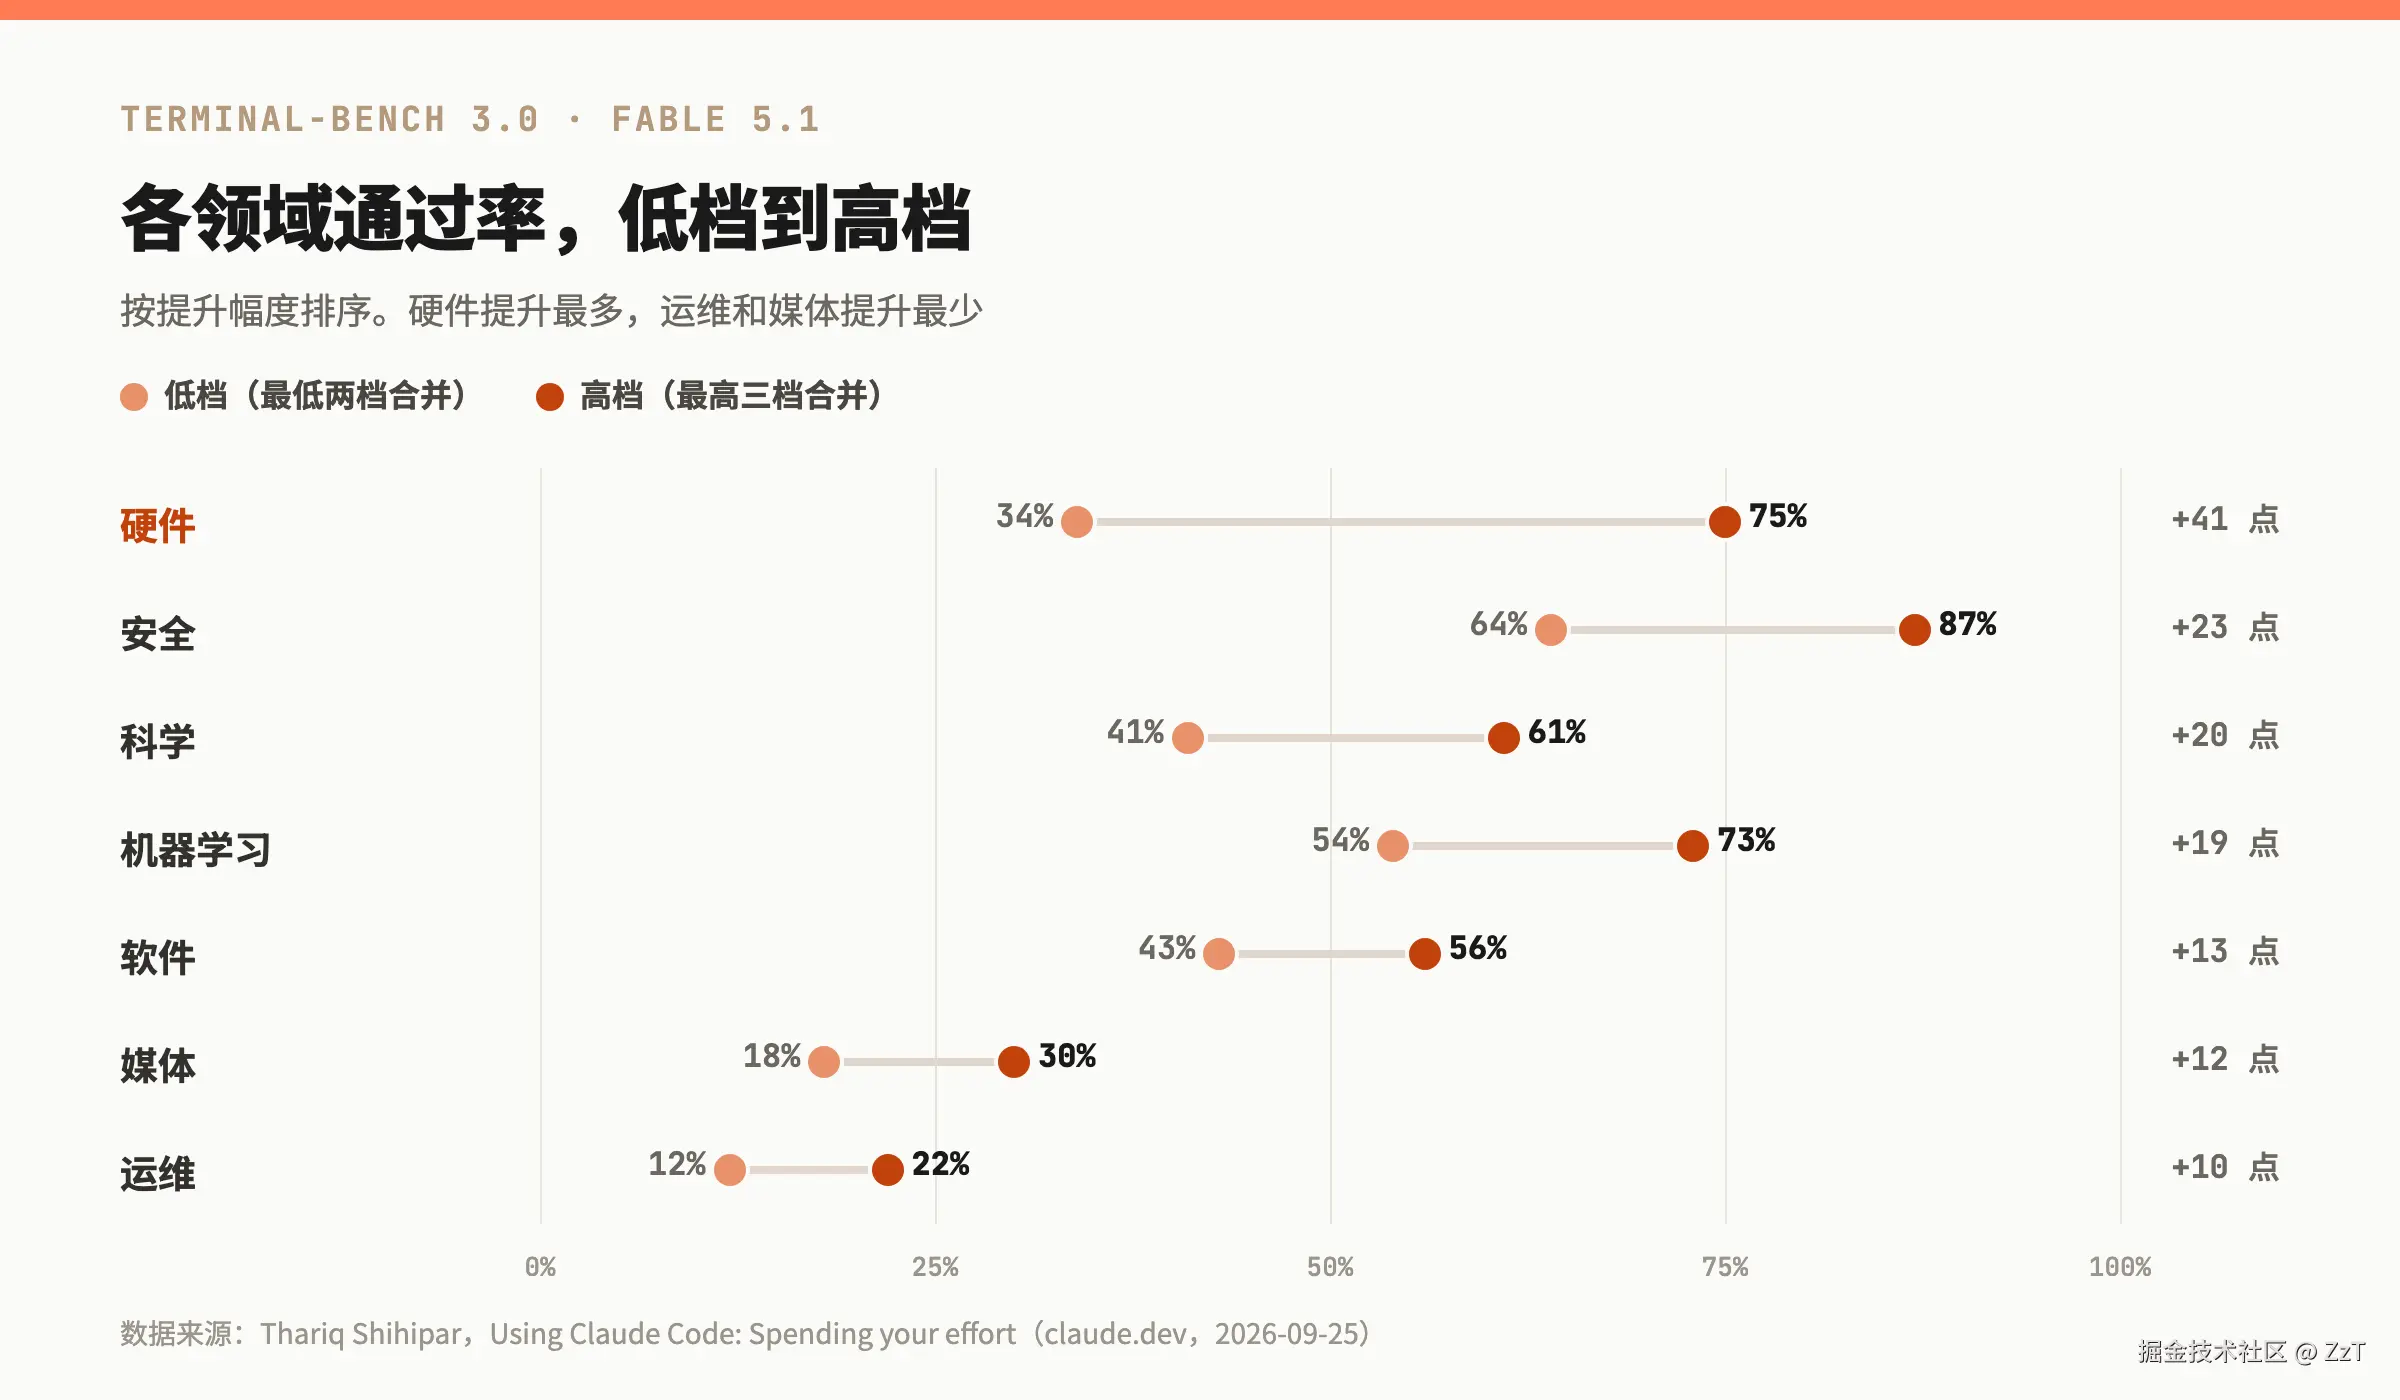
在 Terminal-Bench 3.0 上评测这些模型,让我印象最深的一点是,有些领域从 effort 中获益比其他领域多。
因为每个类别的题目不多,低档合并了每个模型最低的两档,高档合并了最高的三档。
为了说明这一点,我从不同领域挑了几道 Opus 5.5 在 low 档失败、在高档成功的题,成功的原因主要是它测试并处理了边界情况。
mvcc-lsm-compaction 要求根据崩溃报告修复一个存储引擎的 bug,并且不能破坏 compaction。Opus 5.5 在 low 档 5 次全败,在 xhigh 档 5 次成功 4 次。low 档每次大约 1 分钟,Claude 没有先构建代码、也没有先跑复现脚本就动手改,也没检查自己新写的测试能不能抓到原来的 bug。xhigh 档大约 11 分钟,Claude 先复现了崩溃,写了一个随机化测试,拿一个从不做 compaction 的参考实现作对照,还检查了自己的测试在修了一半的代码上会不会失败。
cli-2ph-simplex 要求用 Python 写一个命令行线性规划求解器。Opus 5.5 在 low 档 5 次全败,在 high 档 5 次全过。low 档一遍写完求解器,拿几个小问题检查一下,大约 1 万 token 就停了。Claude 在最后的回复里提醒说大问题上可能会慢,但没有去验证。high 档里,Claude 拿一个独立的暴力求解器作对照,在随机问题上测试自己的求解器,然后给更大的问题计时,碰到了运行太久或崩溃的情况,再回头改了搜索逻辑。
gsea-proteomics 要求在蛋白质组学数据上做基因集富集分析,找出八种处理中哪些和目标组织相似。Opus 5.5 在 low 档 5 次全败,在 high 档 5 次成功 4 次。low 档里,Claude 选了一种听起来合理的数据预处理方式,按这一种方式跑完分析就报告结果。high 档里,Claude 试了两种预处理方式,发现显著的处理组名单变了,于是先查清原因,再选出正确的那种。
如果有人在回路里,Claude 可能会问用户这个问题该怎么设置。没有人在回路里的时候,高 effort 表现更好。
Claude Code 里什么时候用哪一档
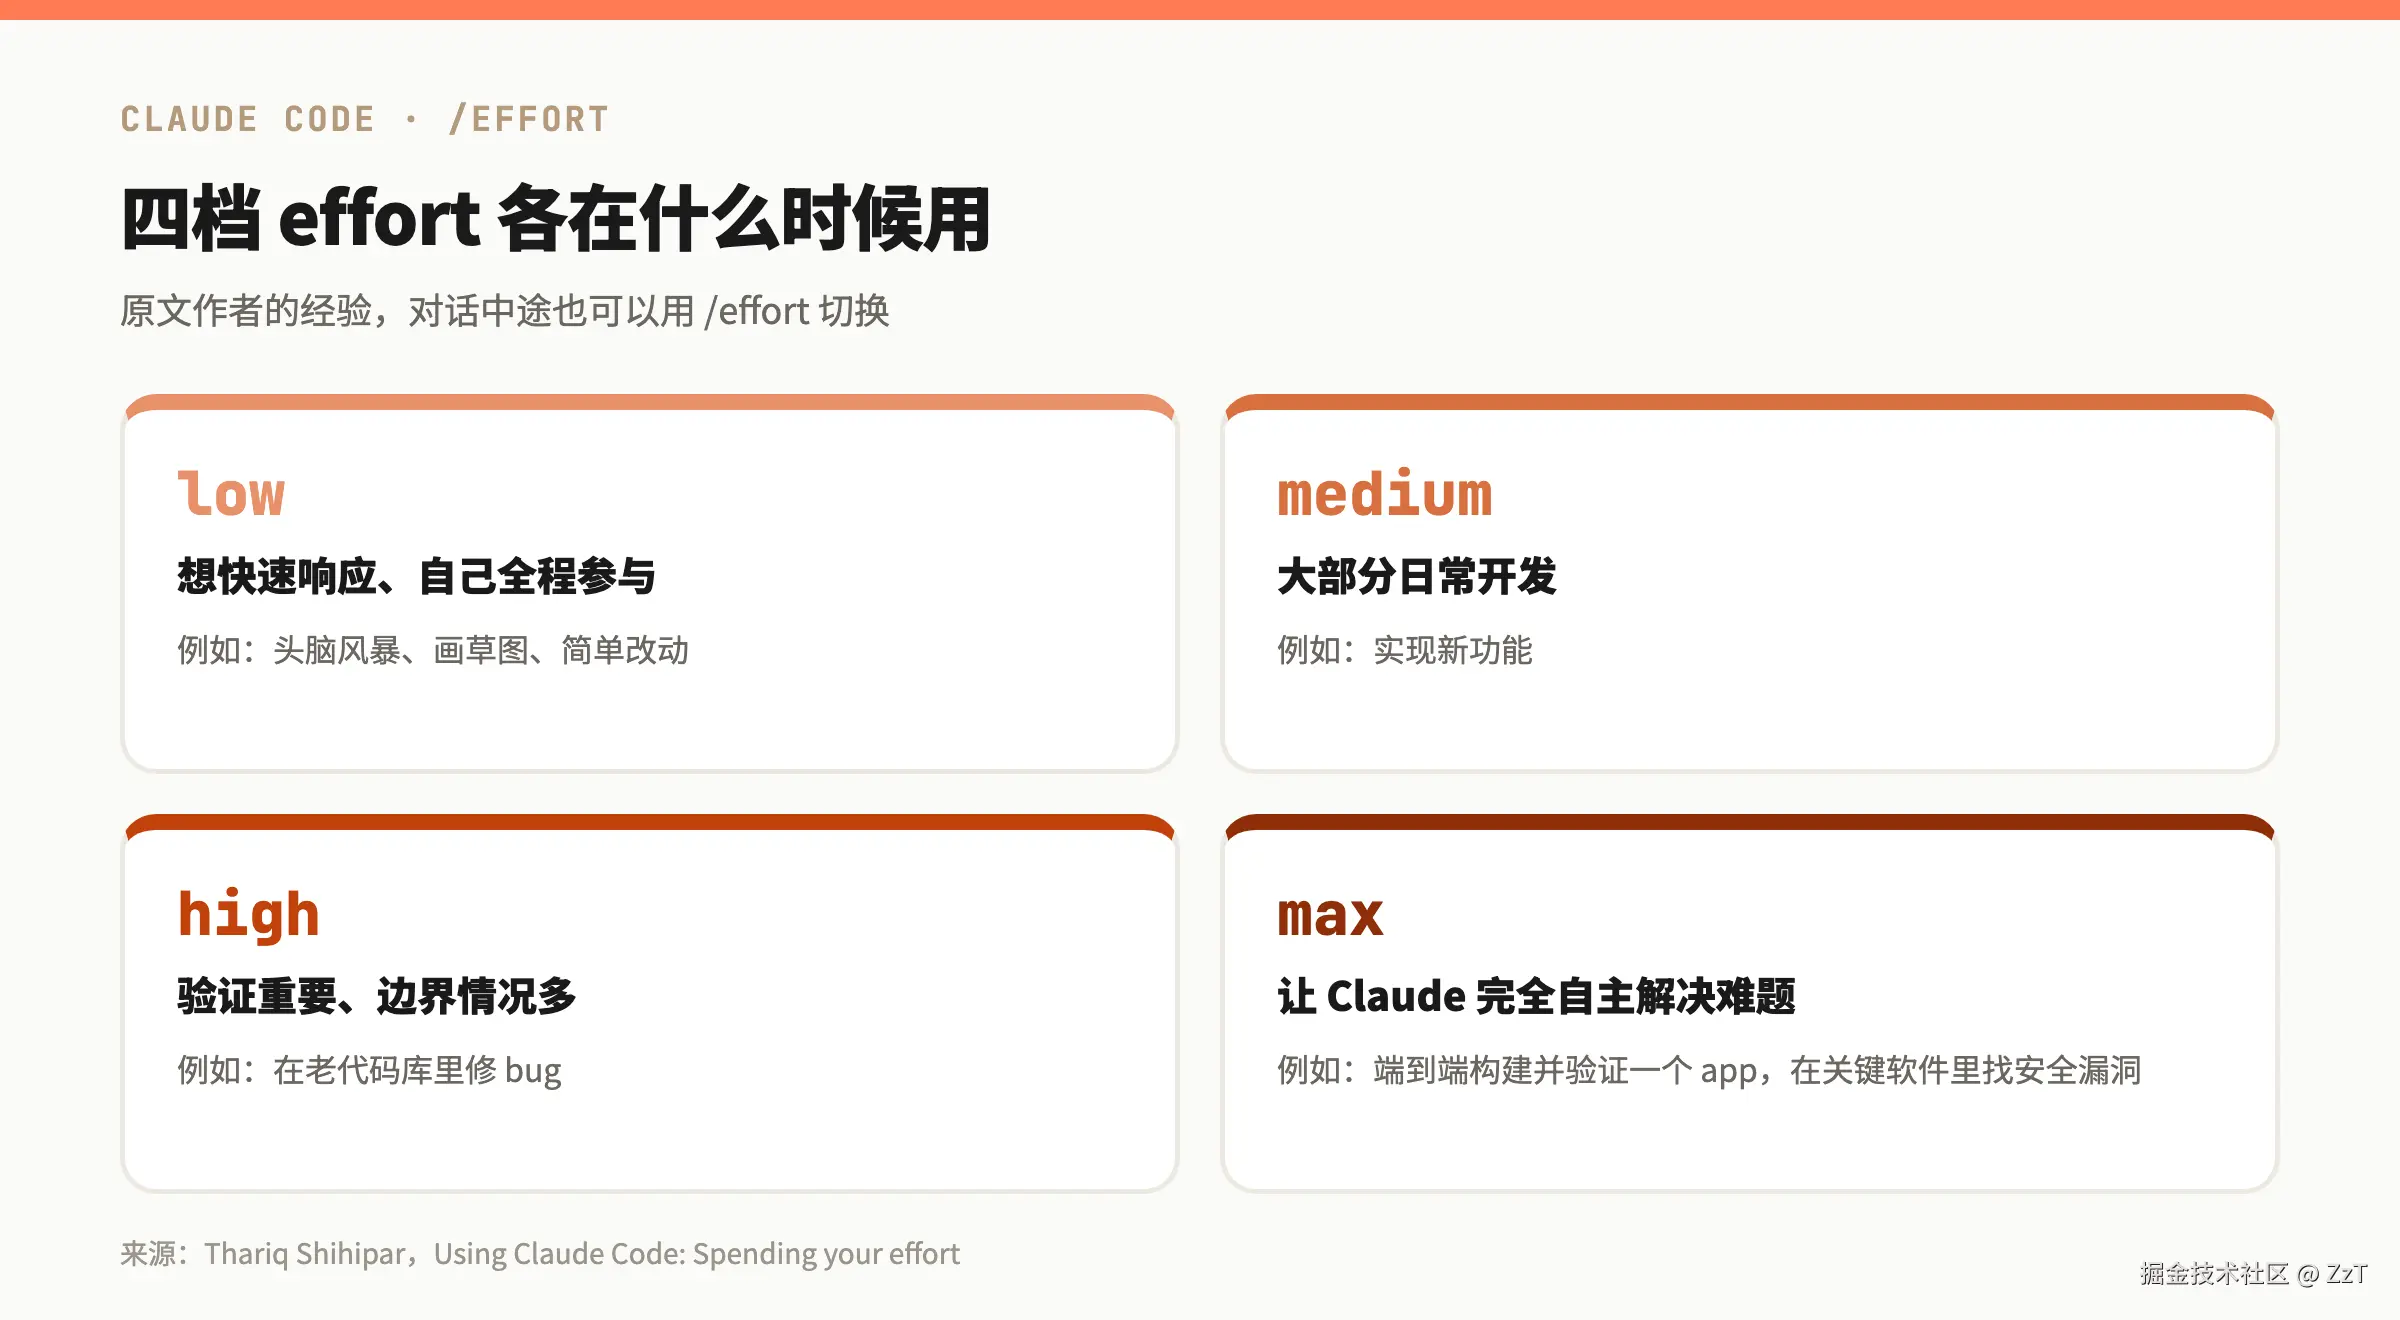
我自己的经验是这样:
- low:想要快速响应、我全程参与的时候,比如头脑风暴、画草图、简单改动。
- medium:大部分日常开发工作,比如实现新功能。
- high:验证很重要或者边界情况多的工作,比如在老代码库里修 bug。
- max:想让 Claude 完全自主解决难题的时候,比如端到端地构建并验证一个 app,或者在关键软件里找安全漏洞。
可以按任务给 Opus 5.5 和 Fable 5.1 换档,甚至在对话中途用 Claude Code 的 /effort 切换,看看和你的直觉是否一致。
¹ 关于数字的说明:这些数据来自我们的内部运行,每个任务跑 5 次,Fable 5.1 关闭了生产环境的安全干预。在 Claude 的产品里,Fable 5.1 的安全机制会把部分安全类请求转给 Opus。安全类任务也是在断网环境下跑的,所以这里各任务的数字和公开排行榜、发布公告对不上。文中的具体例子来自单次运行,有些用的是中间档位。
原文:Using Claude Code: Spending your effort,作者 Thariq Shihipar(Anthropic Claude Code 团队),2026-09-25。本文为中文翻译。
同系列的前一篇讲 model 和 effort 分别管什么,中文编译见《/model 和 /effort 到底该怎么配置》。