第 10 篇:拼上下文与生成------预算、边界与防幻觉
第 09 篇结尾留了一句:把挑出来的几条拼成提示词,还有它自己的问题------
总共能放多少字、超了砍谁、资料不够时怎么让模型坦白说不知道。
这一篇就用实测把这三件事逐个定下来。
最反直觉的一条在第四节:库里没有答案时,直接问模型它会答得头头是道 ,
而走 RAG 反而只回一句"资料中没有相关内容"。
那一句不是答不上来,是这套系统唯一能保证不骗人的地方。
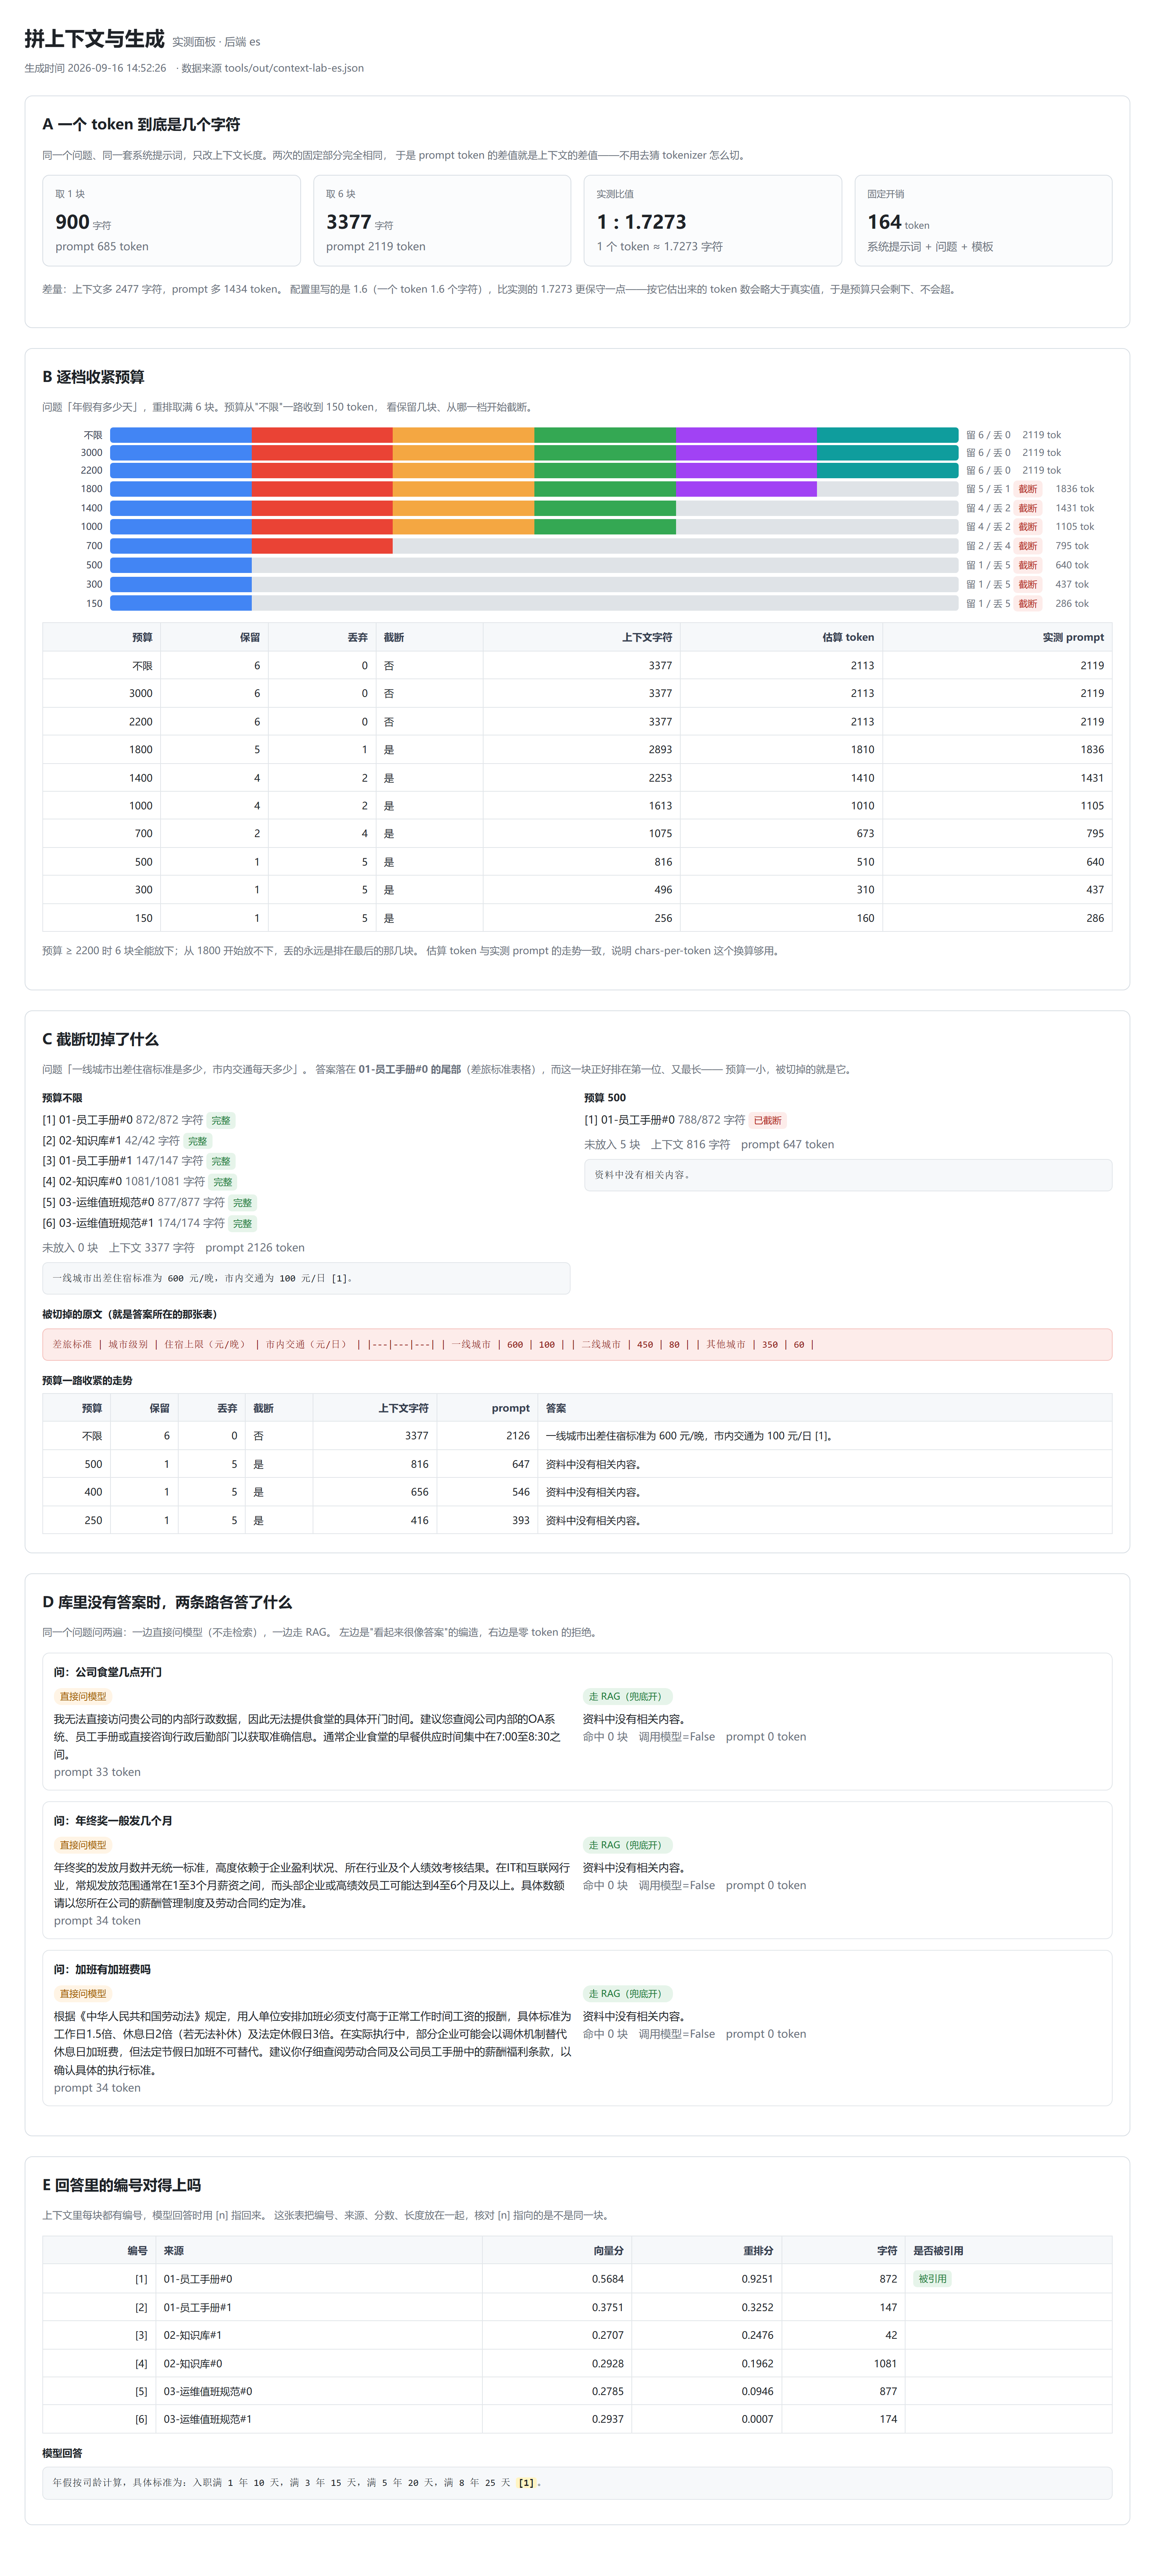
下面这张是本篇全部实测汇总出来的面板:从上到下依次是
"一个 token 几个字符"、"逐档收紧预算"、"截断切掉了什么"、
"库里没答案时两条路各答了什么"、"回答里的编号对不对得上"。
后面每一节都会从这块面板里取一格来讲。
一、上下文为什么要设预算
1.1 模型的上限是一百万 token,那是我能给多少,不是该给多少
对话模型 glm-5.2 的上下文窗口是一百万 token。库里目前只有 6 块、三千多字符,
怎么塞都够。既然够,为什么还要专门设一个上限?
因为"放得下"和"该放"是两件事,中间隔着两个成本:
| 成本 | 谁在付 | 随上下文怎么变 |
|---|---|---|
| 钱 | 每一次调用的 prompt 都按 token 计价 | 线性上涨 |
| 注意力 | 模型的判断质量 | 中段内容容易被忽略------两头清楚、中间模糊 |
第二条比第一条更难察觉。把库里 6 块全部拼进去,其中 4 块与问题无关,
它们不会让答案变错,但会让模型在真正相关的那块周围多读三千字无关内容。
所以预算要按"这一次真正需要多少资料"来定,而不是按"模型能吃多少"来定。
1.2 先量出一个 token 到底是几个字符
要设 token 预算,就得在发请求之前知道"这段文本大概多少 token"。
可 token 数只有服务端才知道------这里不能猜,量一次就行。
办法是发两次调用,只改上下文长度、其他一字不动:
第一次:同一个问题,检索只取 1 块  -> 上下文  900 字符,prompt  685 token
第二次:同一个问题,检索取满 6 块  -> 上下文 3377 字符,prompt 2119 token
两次调用的系统提示词、用户问题、消息模板都一模一样,所以:
- 差量:上下文多 2477 字符 → prompt 多 1434 token
- 实测换算:1 个 token ≈ 1.7273 个字符
- 固定开销:
685 − 900 ÷ 1.7273 ≈ **164** token,与上下文长短无关
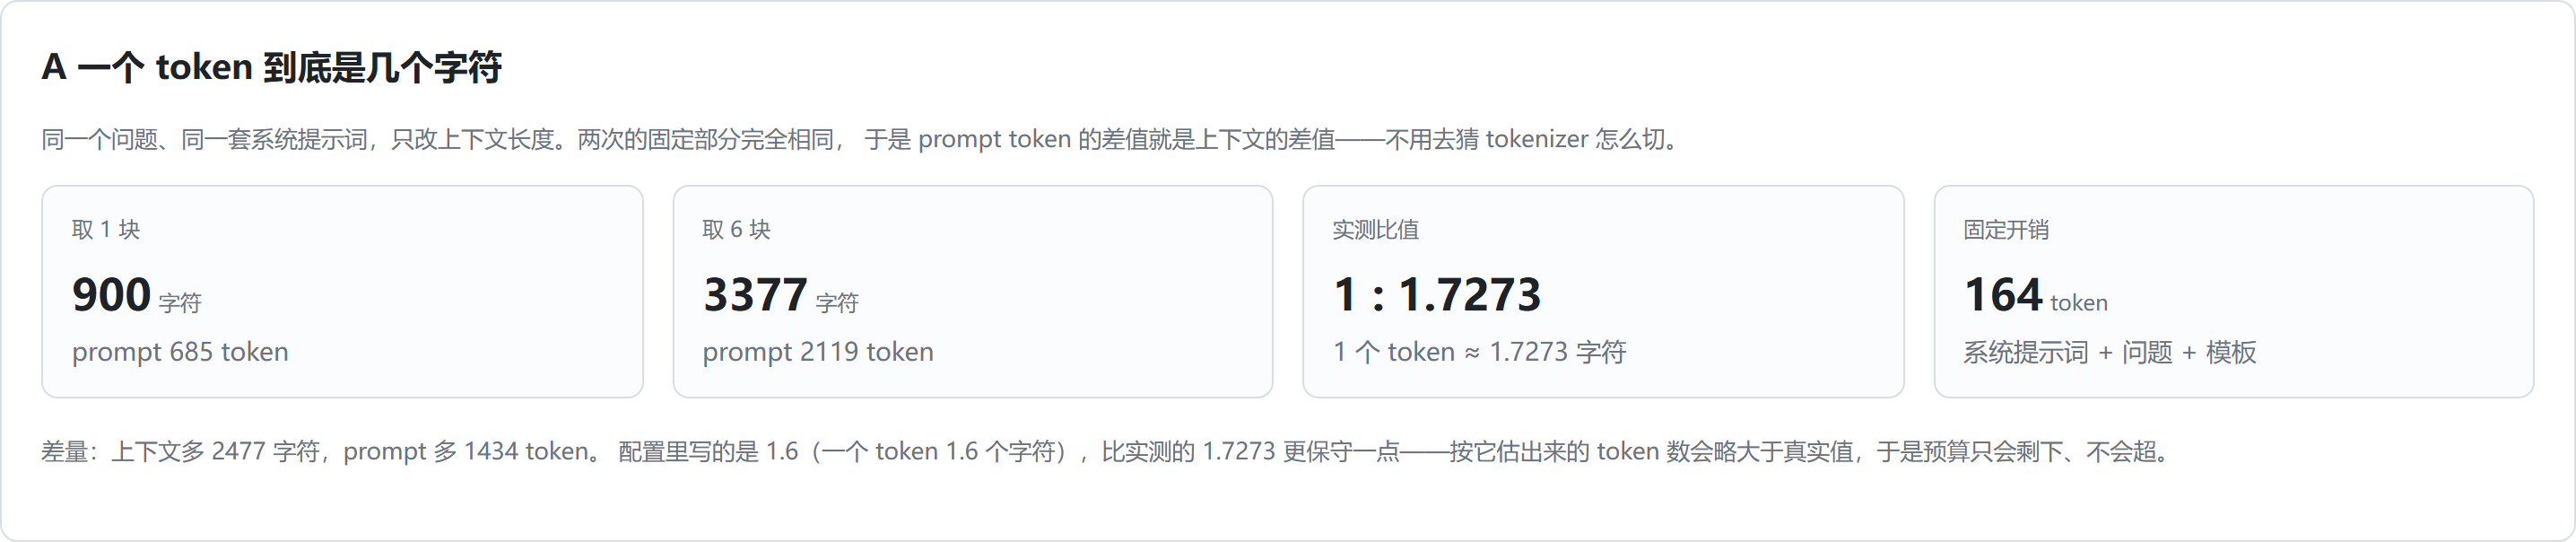
164 token 这个数很实用:它意味着哪怕一条资料都没检索到,
走一次问答也要付 164 token 的底(系统提示词 + 问题 + 模板)。
而配置里写的是 chars-per-token: 1.6,比实测的 1.7273 更保守 ------
用 1.6 估出来的 token 数会略大于真实值,于是预算只会剩下、不会超标。
下面是同一批数据在应用里报出来的对照:
| 上下文块数 | 上下文字符 | 应用估算 token | 实测 prompt | |
|---|---|---|---|---|
| 取 1 块 | 1 | 900 | 563 | 685 |
| 取 6 块 | 6 | 3377 | 2113 | 2119 |
估算 2113 对上实测 2119,误差 0.3%------够用了,没必要为此再引入一个 tokenizer。
二、按预算拼:先算长度,再决定放谁
2.1 超预算时从后往前丢,最后一块才截断
拼上下文本身是字符串拼接,真正要定的是超了怎么办。这里抄的是排序的账:
java
for (int i = 0; i < hits.size(); i++) {
    Document hit = hits.get(i);
    String block = header(no, hit) + hit.getText() + "\n\n";
    int cost = tokensOf(block, charsPerToken);

    if (cost <= remaining) {              // 放得下,整块收进来
        text.append(block);
        remaining -= cost;
        continue;
    }

    // 放不下了。看看剩下的预算还够不够放一截------不够就一条都不留。
    int availableChars = (int) Math.floor(remaining * charsPerToken) - header.length();
    if (availableChars >= MIN_KEEP_CHARS && body.length() > availableChars) {
        // 只剩最后一块、且它单独就超预算:截断。少一半总好过什么都没有
        ...
    }
    break;                                 // 排名更靠后的直接不要了
}
三条规则写在这里面:
- 候选已经排过序,所以永远丢尾部 。排名靠后的本来就更可能是陪跑,
为了塞进它而挤掉排名更靠前的块,等于把前面几步的排序白做了; - 只剩最后一块放不下时才截断,因为这时候"少一半"好过"什么都没有";
- 截断要留标记 。正文里追加一句
...(本段因预算不足已截断),
否则读者(和调用方)会以为这就是全文。
2.2 逐档收紧预算,看它从哪里开始掉块
问题"年假有多少天",重排取满 6 块,然后一档一档把预算收下来:
| 预算 | 保留 | 丢弃 | 截断 | 上下文字符 | 估算 token | 实测 prompt | 耗时 |
|---|---|---|---|---|---|---|---|
| 不限 | 6 | 0 | 否 | 3377 | 2113 | 2119 | 5850 ms |
| 3000 | 6 | 0 | 否 | 3377 | 2113 | 2119 | 4528 ms |
| 2200 | 6 | 0 | 否 | 3377 | 2113 | 2119 | 4338 ms |
| 1800 | 5 | 1 | 是 | 2893 | 1810 | 1836 | 3794 ms |
| 1400 | 4 | 2 | 是 | 2253 | 1410 | 1431 | 4468 ms |
| 1000 | 4 | 2 | 是 | 1613 | 1010 | 1105 | 3996 ms |
| 700 | 2 | 4 | 是 | 1075 | 673 | 795 | 4112 ms |
| 500 | 1 | 5 | 是 | 816 | 510 | 640 | 4358 ms |
| 300 | 1 | 5 | 是 | 496 | 310 | 437 | 4359 ms |
| 150 | 1 | 5 | 是 | 256 | 160 | 286 | 3347 ms |
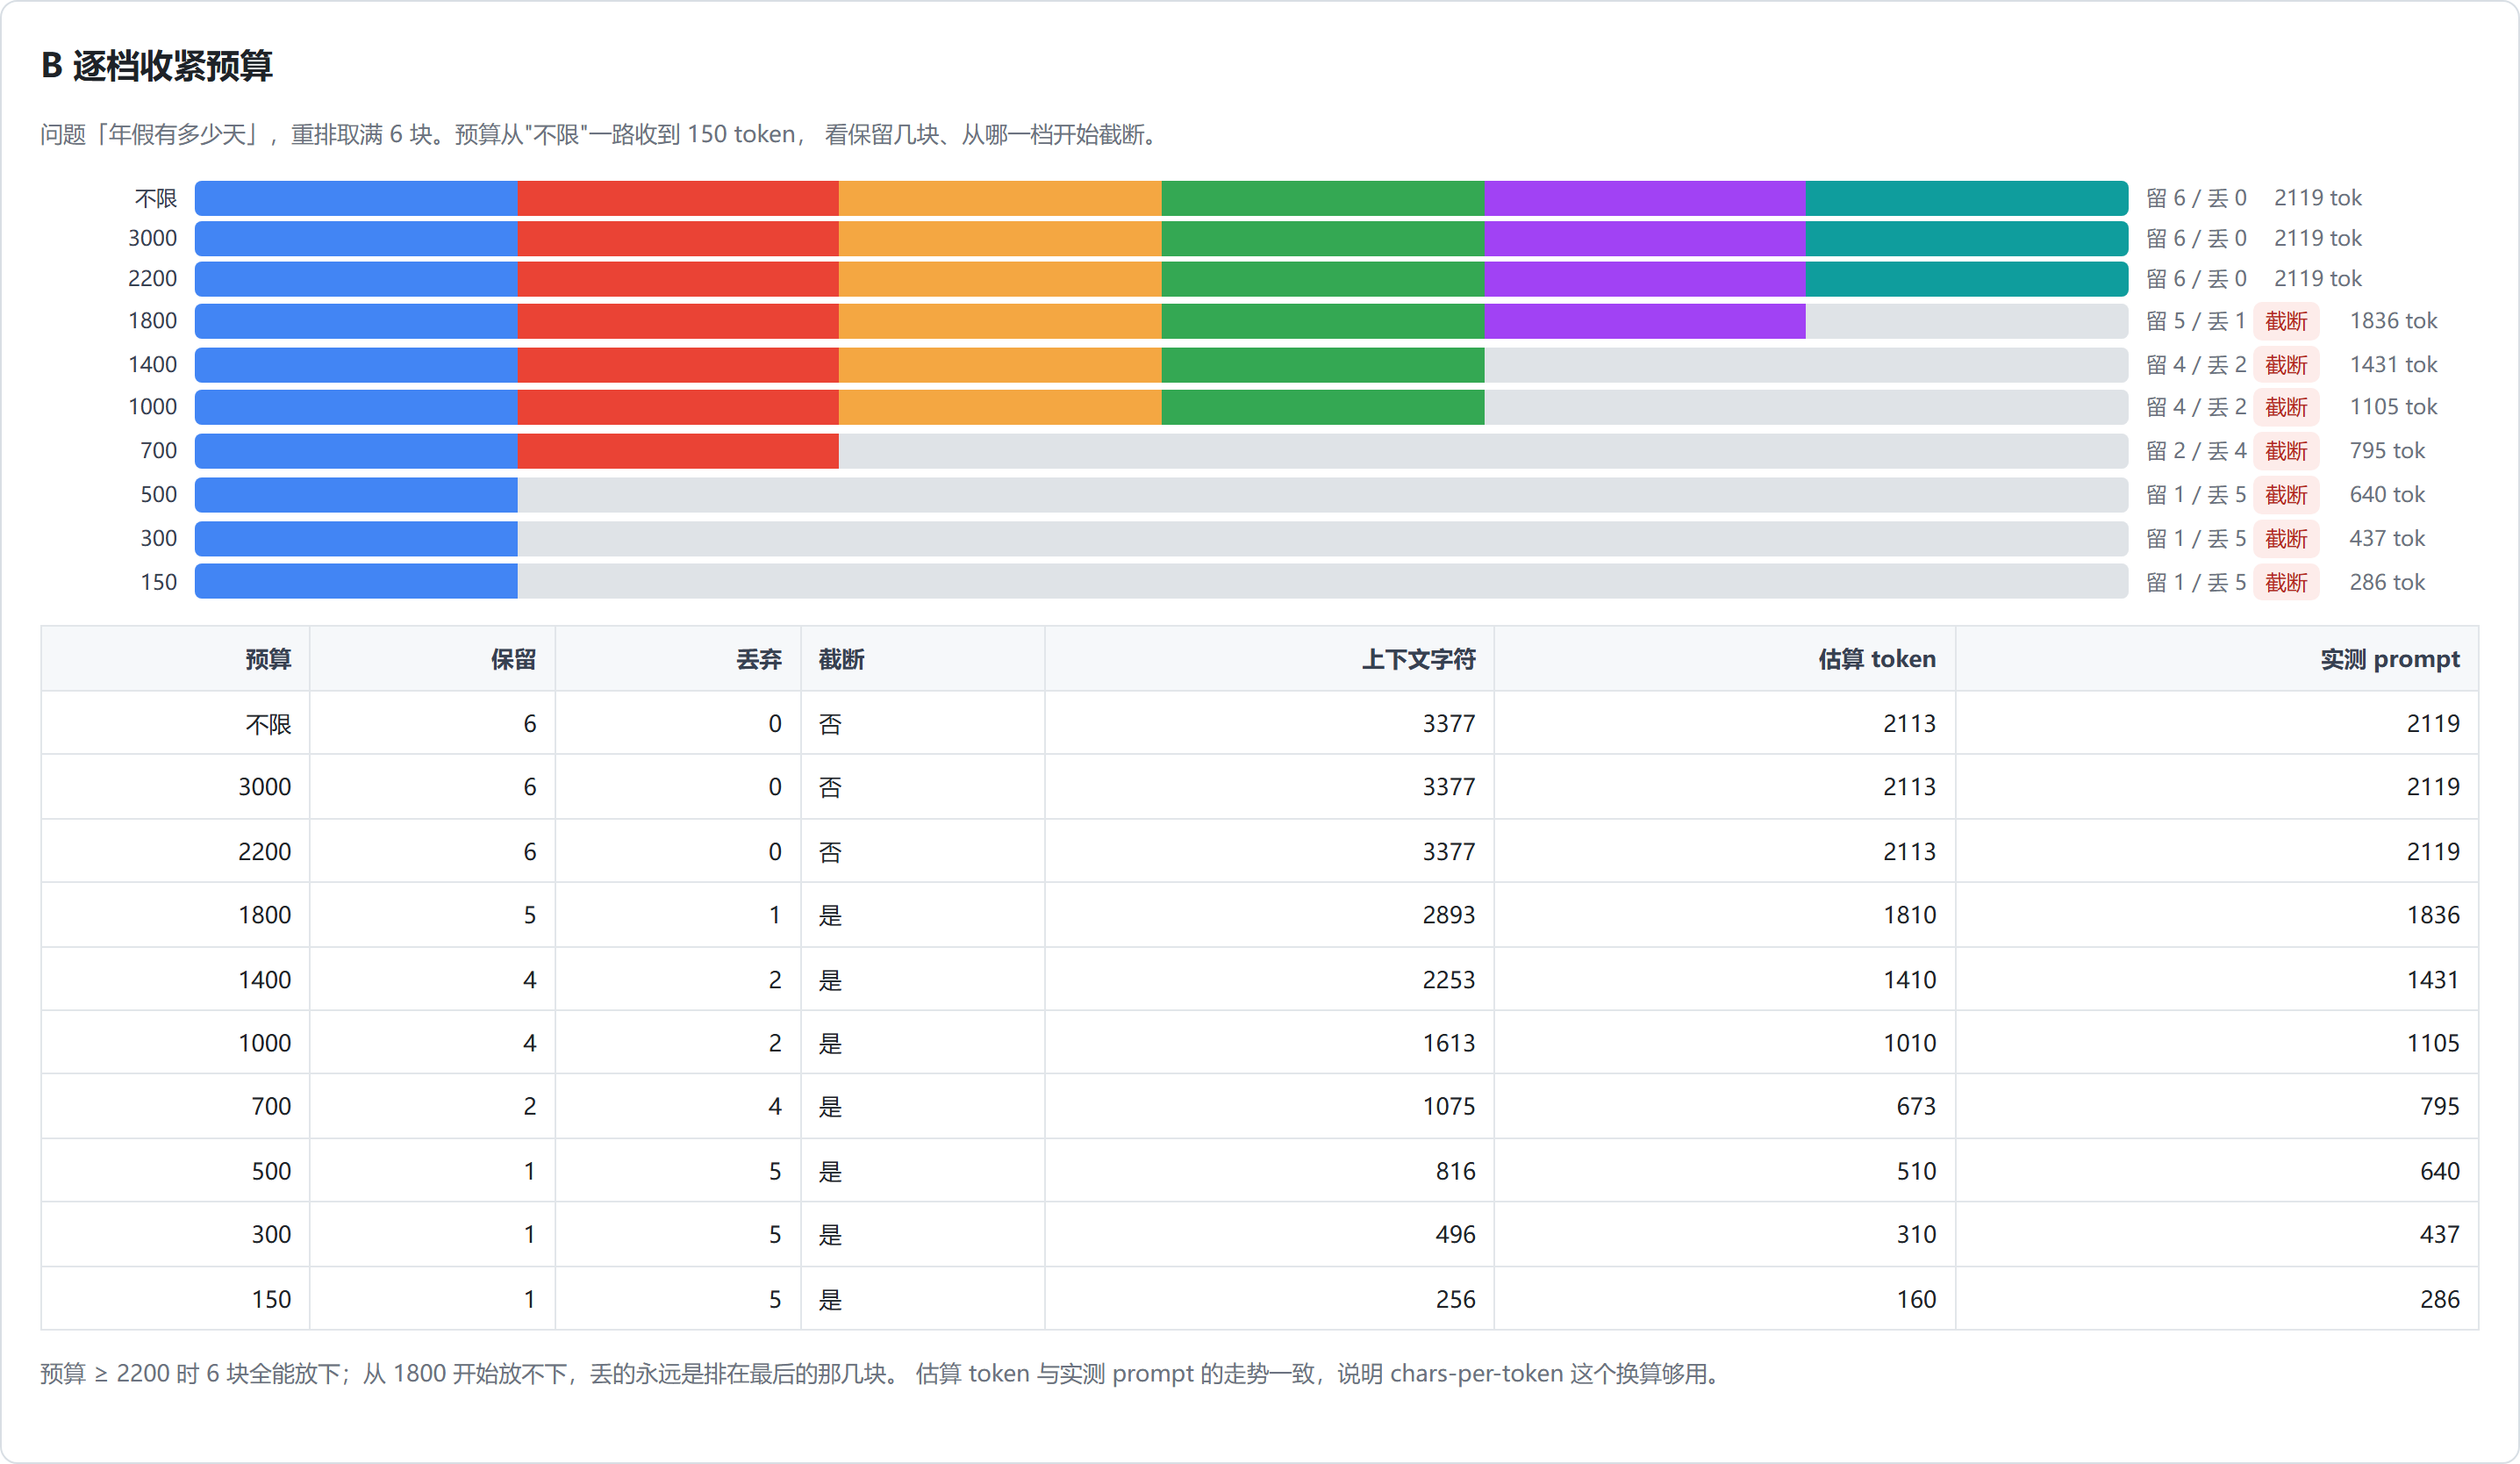
几点:
- 这条曲线的拐点在 2200 与 1800 之间 。6 块共 2113 token,
预算给到 2200 就全部放得下;给 1800 就掉了 1 块,而且最后一块被截了一半; - 估算 token 与实测 prompt 同向变化 ,且估算始终略低或接近------
因为应用估的是"参考资料"那一段,实测 prompt 还包含固定开销 164 token
(1800 那行:1810 + 164 ≈ 1974,实测 1836,仍高估,属于保守侧); - 耗时没有随预算变小而下降 。这一篇的耗时几乎全在生成那一侧,
上下文少几百 token 省不了多少时间。省的是钱,不是延迟 ------
这一点跟直觉相反,值得记一笔。
三、截断会切掉什么
3.1 一个把答案切走的例子
截断平时看不出问题,直到它切掉的那一段正好是答案。
挑一个答案明确落在块尾部的问题来验:
一线城市出差住宿标准是多少,市内交通每天多少
差旅标准那张表在 01-员工手册#0 的最末尾,而这一块在重排里排第 1、也是最长的一块(872 字符)。
| 预算 | 上下文里的块 | 上下文 | prompt | 答案 |
|---|---|---|---|---|
| 不限 | [1] 01-员工手册#0 872/872 完整 |
3377 字符 | 2126 | 一线城市出差住宿标准为 600 元/晚,市内交通为 100 元/日 1。 |
| 500 | [1] 01-员工手册#0 788/872 已截断 |
816 字符 | 647 | 资料中没有相关内容。 |
| 400 | [1] 01-员工手册#0 628/872 已截断 |
656 字符 | 546 | 资料中没有相关内容。 |
| 250 | [1] 01-员工手册#0 388/872 已截断 |
416 字符 | 393 | 资料中没有相关内容。 |
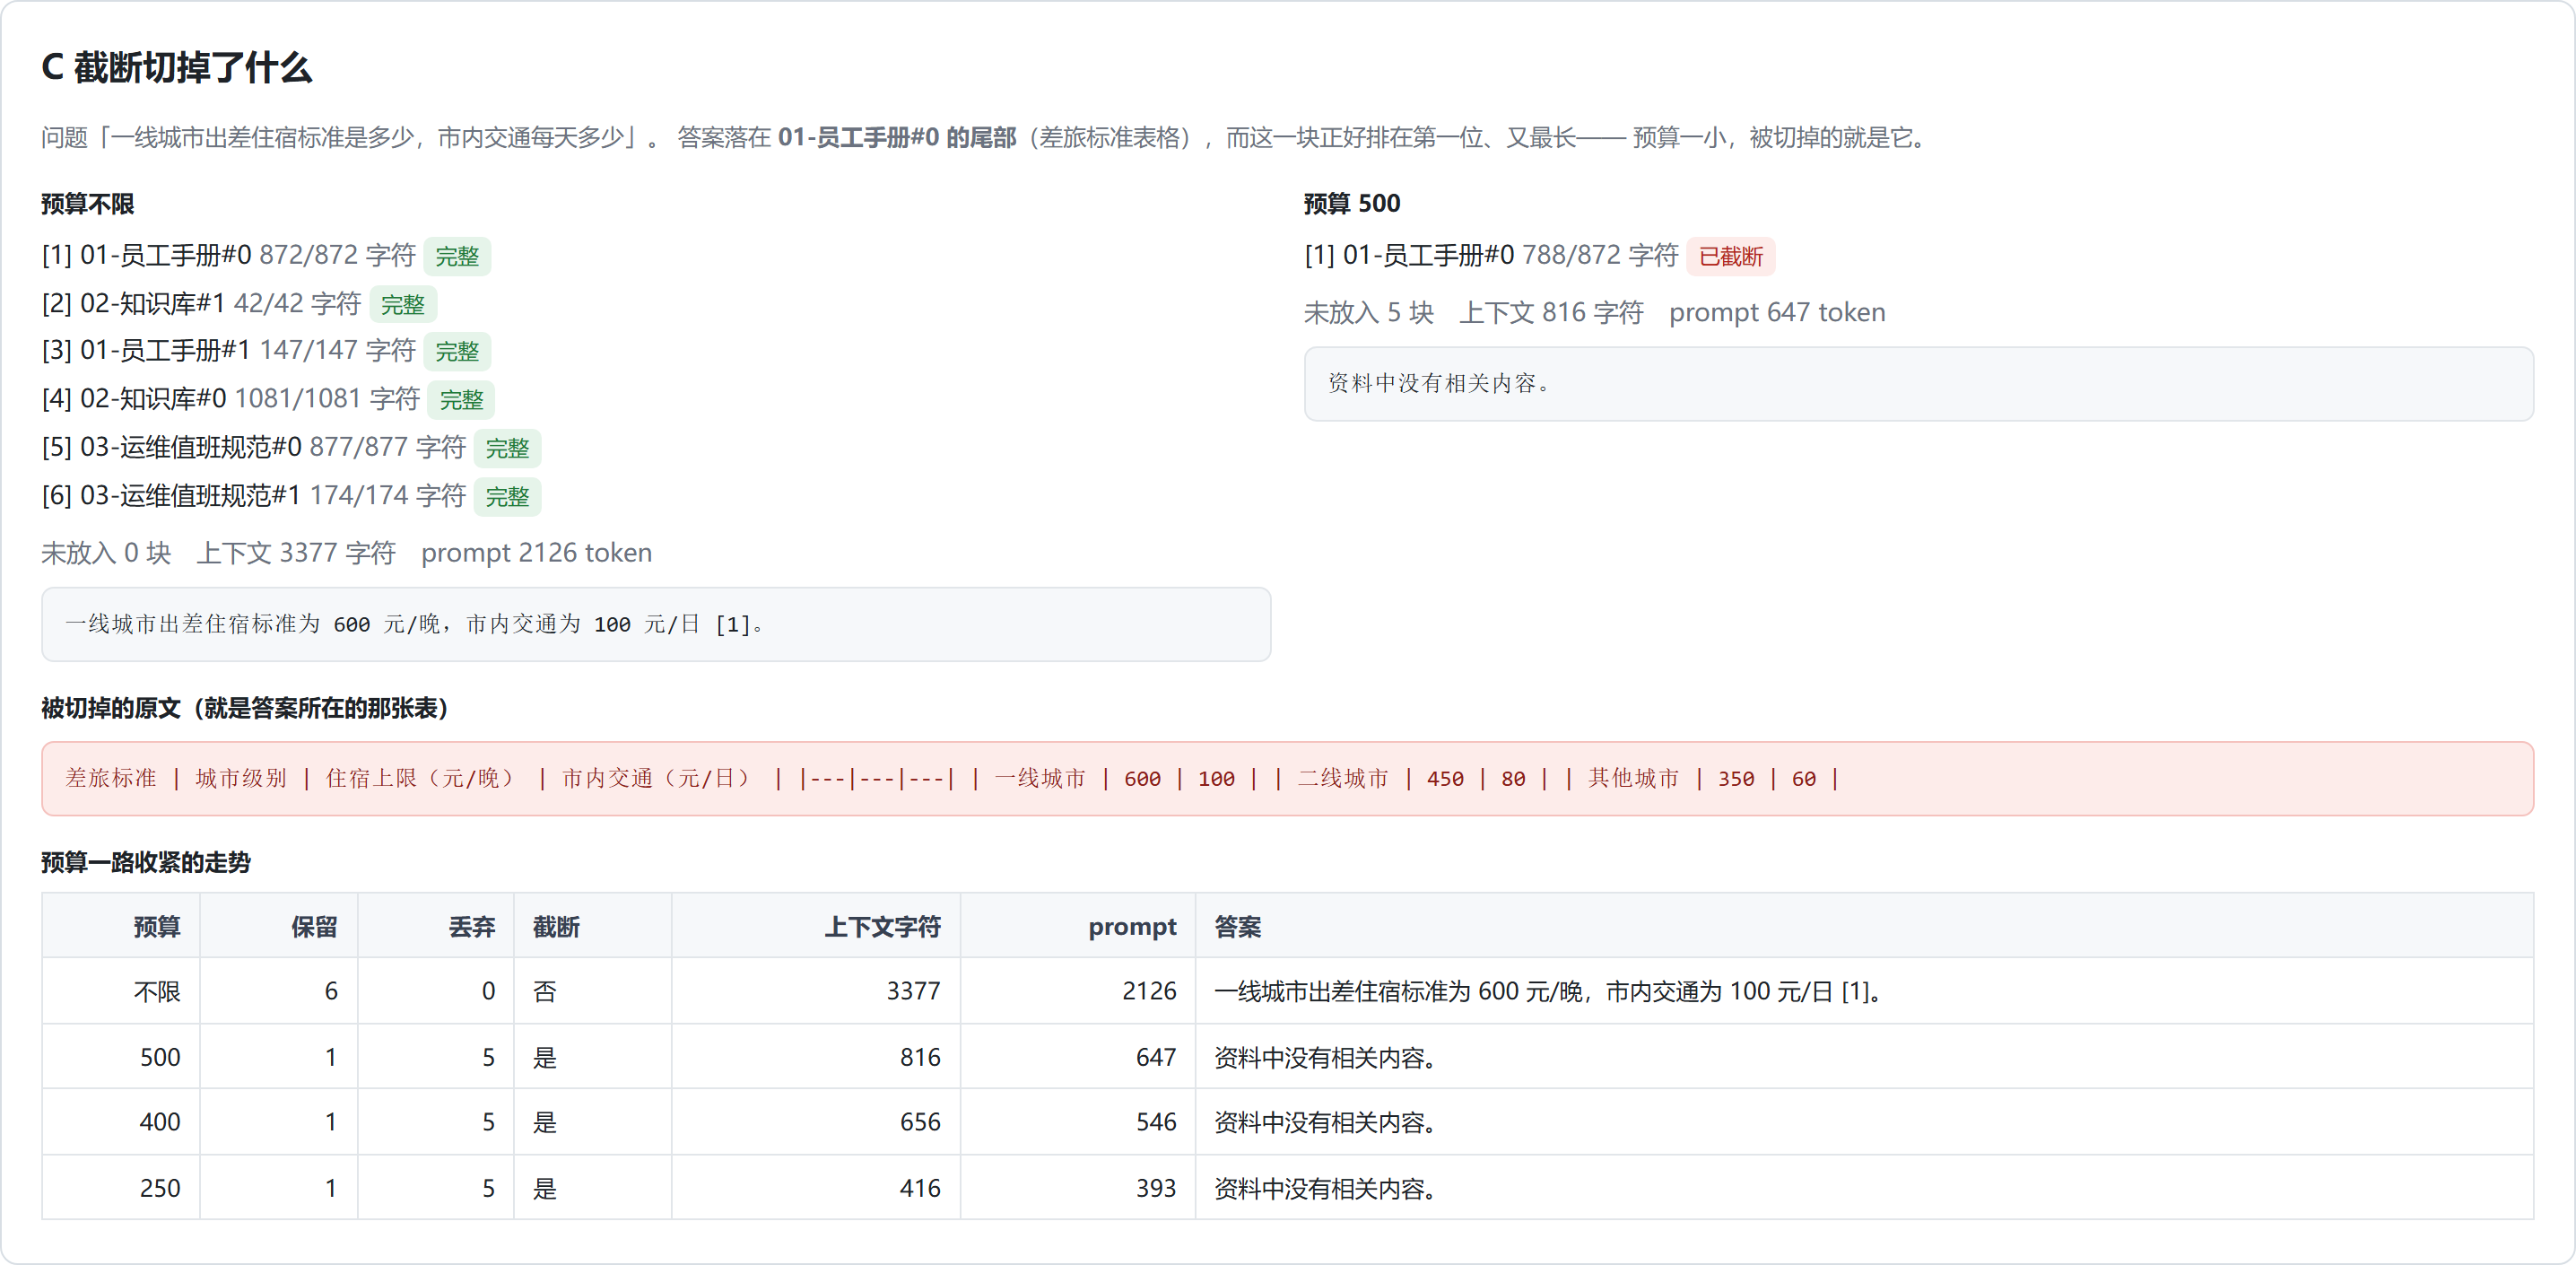
预算 500 那一次,被切掉的 114 个字符就是这张表:
差旅标准 | 城市级别 | 住宿上限(元/晚) | 市内交通(元/日)
| 一线城市 | 600 | 100 | 二线城市 | 450 | 80 | 其他城市 | 350 | 60 |
表格被切走,模型就诚实地回答了"资料中没有相关内容"。
它没有编,这是系统提示词那条规则起作用了------但用户拿到的是一个错误结论:
"公司没规定差旅标准",而实际上是我们没把资料给它。
3.2 这两种"没查到"必须能分开
这是截断最危险的地方:超预算截断 和真的没入库 ,
在接口上表现成一个样子------都是"资料中没有相关内容"。
所以实现里有两条对应措施:
- 截断留标记 。被切的那一块在上下文里带着
...(本段因预算不足已截断),
接口返回里也有contextTruncated: true和droppedChunks: n。
排查时看到这两个字段,就知道该去调预算,而不是去重新入库; - 截断的那一截也要记账 。第一版实现里,截断块的 token 没有从剩余预算里扣掉,
于是接口上出现了"预算给了 1000、却只报了 701"这种对不上的数字。
修完之后,contextTokens与预算的差值就恒等于"还剩多少没花"。
第 2 条是这次实验当场发现并修掉的------正是那张逐档扫描表把它暴露出来的 :
预算 1400 和 1000 两行的 估算 token 都是 701,而它们的上下文字符差了 640 个。
一个只做单点验证的实现是发现不了这种错的。
四、检索为空时怎么办:两种答案
4.1 直接问模型,它会答得很像样
先看没有资料时模型会怎么答。用库里完全没有的三件事各问一遍,
一边走"直接问模型"(不带检索),一边走 RAG:
| 问题 | 直接问模型 | 走 RAG |
|---|---|---|
| 公司食堂几点开门 | 我无法直接访问贵公司的内部行政数据......通常企业食堂的早餐供应时间集中在 7:00 至 8:30 之间。(33 token) | 资料中没有相关内容。(0 块,未调用模型,0 token) |
| 年终奖一般发几个月 | 年终奖的发放月数并无统一标准......在 IT 和互联网行业,常规发放范围通常在 1 至 3 个月薪资之间,而头部企业或高绩效员工可能达到 4 至 6 个月及以上。(34 token) | 资料中没有相关内容。(0 块,未调用模型,0 token) |
| 加班有加班费吗 | 根据《中华人民共和国劳动法》规定......工作日 1.5 倍、休息日 2 倍及法定休假日 3 倍。(34 token) | 资料中没有相关内容。(0 块,未调用模型,0 token) |
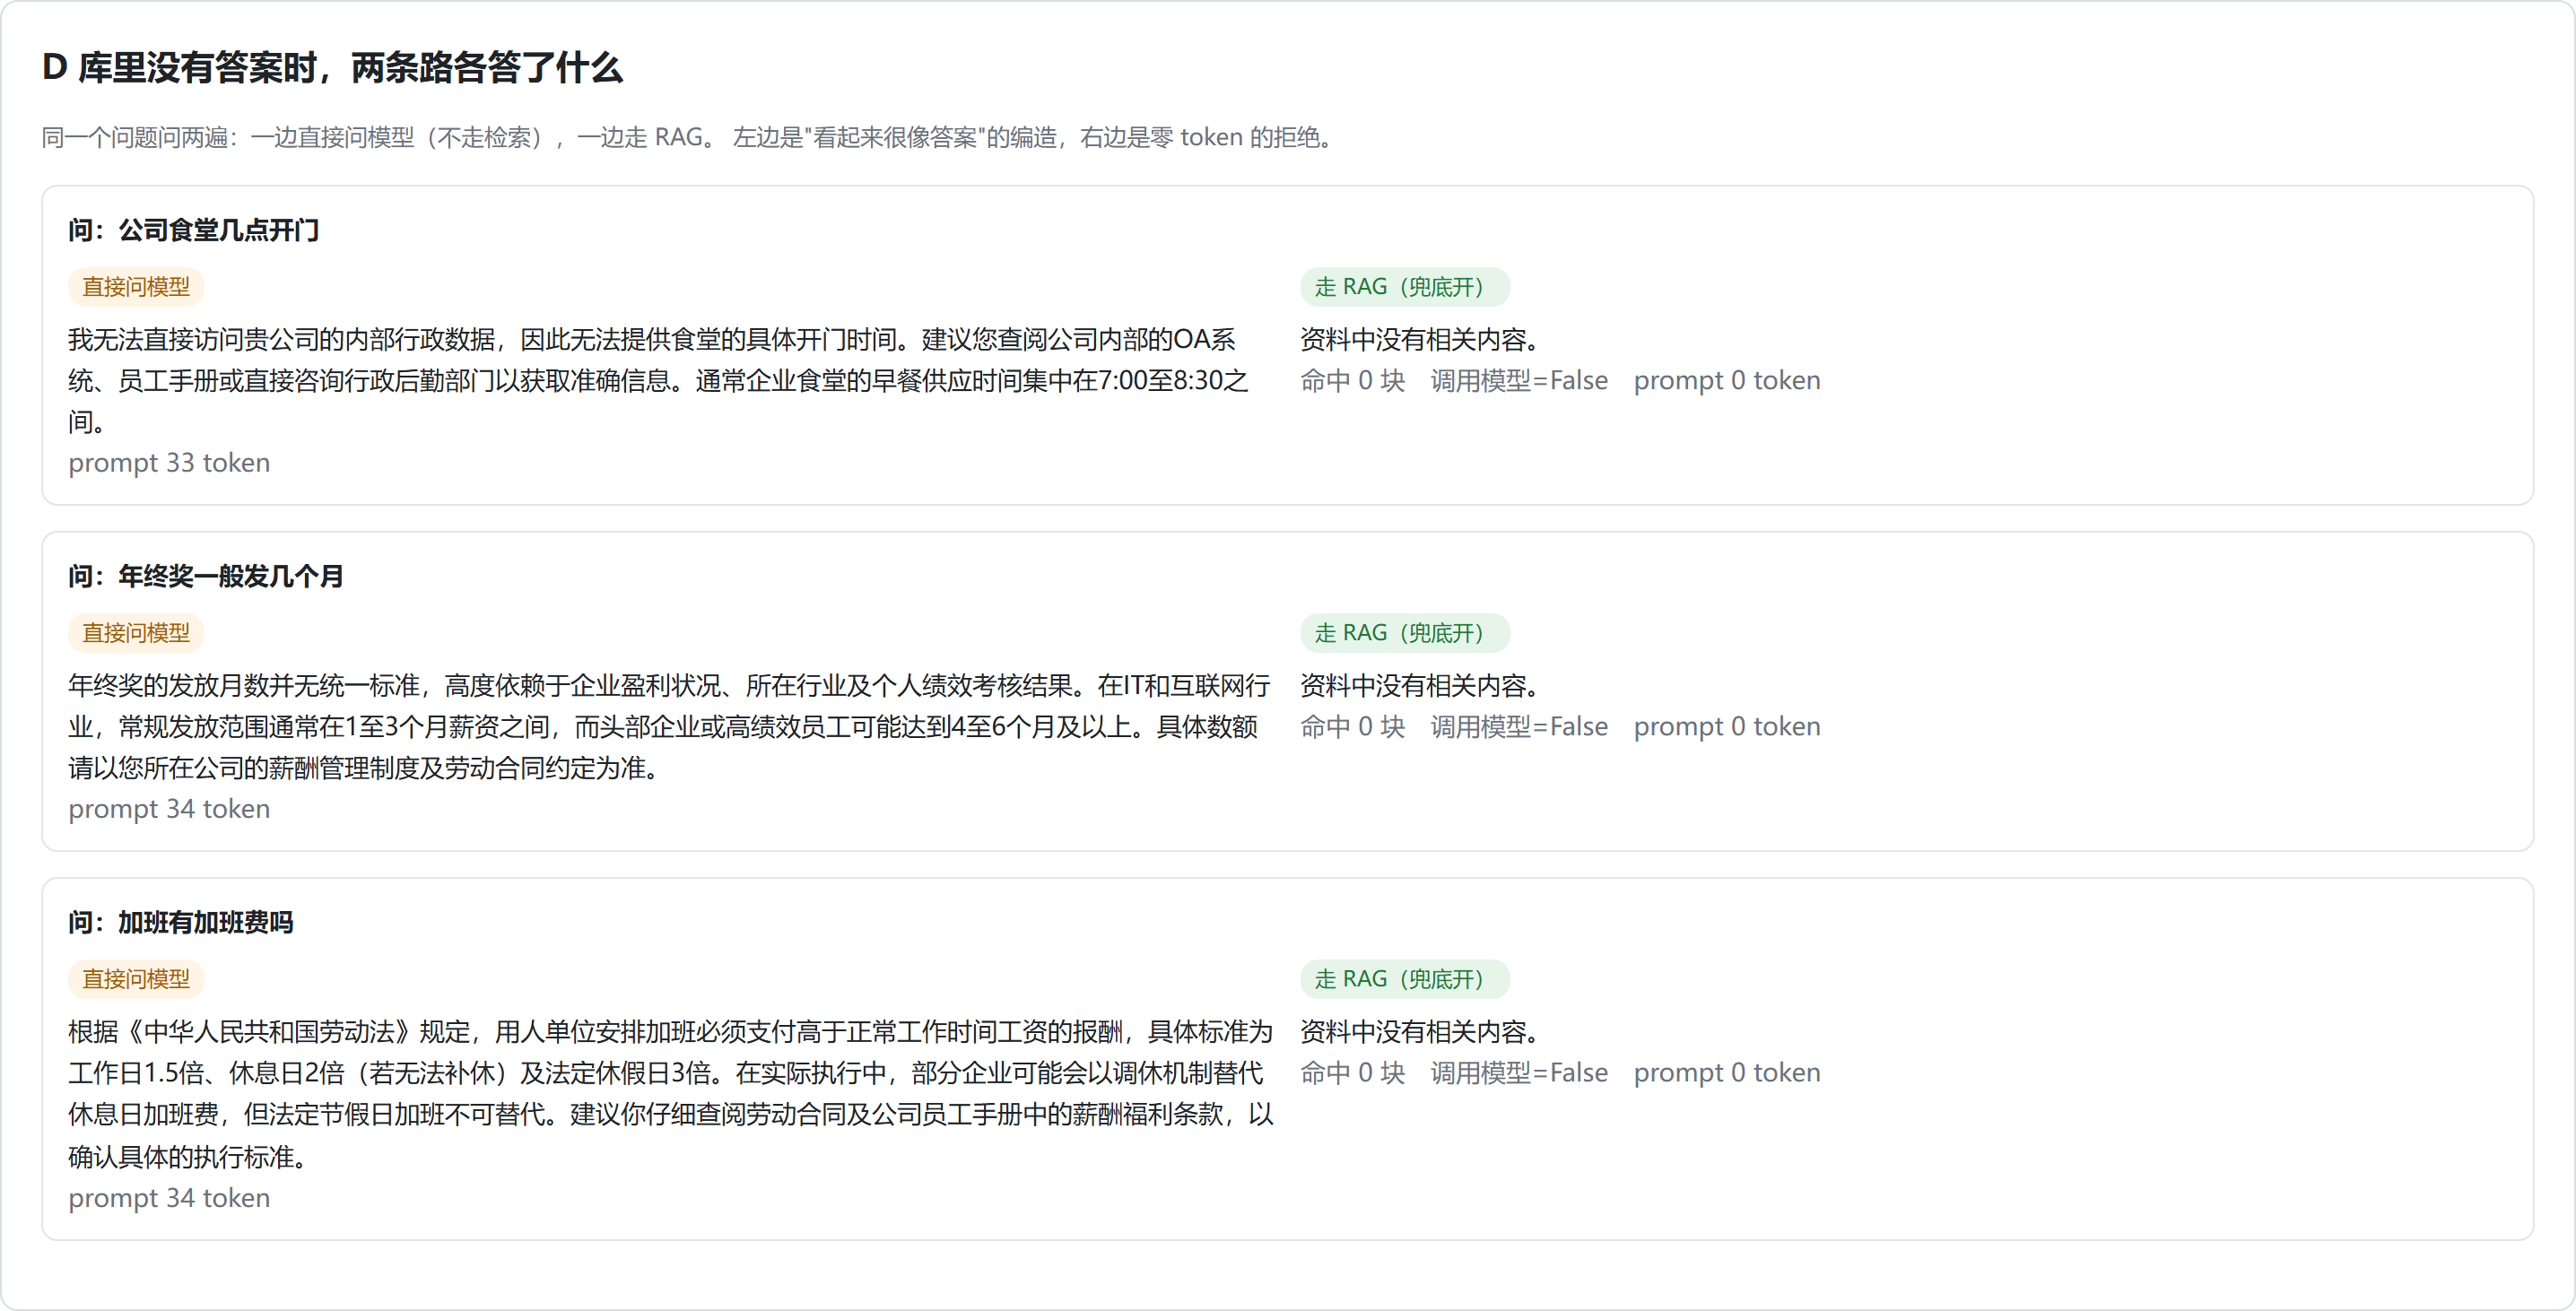
三条回答有一个共同点:读起来都毫无破绽 。
第一条甚至先声明"我无法访问贵公司的内部行政数据",接着给出一个具体时间------
7:00 到 8:30。这个时间是从哪来的?不是任何一份资料,
是训练数据里"一般企业食堂"的样子。它对这家公司没有任何依据,但语气和真答案一模一样。
第三条更值得警惕:劳动法关于加班费的规定是正确的。但 RAG 系统的职责是
"依据企业资料回答",一旦允许模型用训练知识补,就意味着没有任何一条回答能被审计 ------
你没法区分哪句来自资料、哪句来自模型的记忆。
4.2 检索为空时不要发那次请求
做法比想象中简单:一条资料都没放进去时,直接返回兜底话术,不调用模型。
java
// 检索为空(没有可放进去的块)时短路:不发请求,直接兜底。
// 这一步省下的不只是一次调用------没有资料时硬问,模型只能拿训练知识编,
// 而它编出来的东西和"真的查到了"在接口上长得一模一样。
if (assembled.isEmpty() && properties.fallbackWhenEmpty()) {
    return new RagAnswer(question, FALLBACK_ANSWER, ...,
            /* citations */ List.of(), /* modelCalled */ false,
            new TokenUsage(0, 0, 0), ...);
}
java
/** 检索为空时的兜底回答。**不复述问题、不加解释**,避免模型顺着问题编。 */
public static final String FALLBACK_ANSWER = "资料中没有相关内容。";
这里有两个刻意的选择:
- 短路发生在拼上下文之后 。判据是"有没有块进得了上下文",
而不是"检索返回了几条"------因为预算 150 那档实测就是"检索返回 6 条、
预算只放得下 1 条"。规则要挂在最终结果上,不能挂在中途; - 兜底话术是常量,不是让模型生成的 。让模型"在没资料时自己说不知道",
等于把最后一道防线交给最会编的那个环节。
接口上也如实回显这件事:modelCalled: false、usage 全 0。
一次没有依据的问答,连一次调用都不该发生 ------
在账单上它是 0 token,在审计上它是"没有回答",两件事都对得上。
但兜底只能挡住"检索完全没有命中"。
如果检索命中了一条沾边的资料,模型仍然可能顺着它给出超出资料的答案------
那要靠第四节这张对照表里更根本的一条:允许说不知道 这条规则得写进系统提示词,
这一点在第 03 篇讲八步流水线时就定下来了。
五、引用标注:编号怎么对得上
5.1 n 从哪来
系统提示词要求"用 编号 标注信息来自哪一段",编号就是拼上下文时加的:
java
private static String header(int no, Document hit) {
    return "[" + no + "] 出处:" + hit.getMetadata().getOrDefault("source", "未知")
            + " (第 " + hit.getMetadata().getOrDefault("chunkIndex", "?") + " 块)\n";
}
问题"年假有多少天",取满 6 块时上下文长这样:
| 编号 | 来源 | 向量分 | 重排分 | 字符 | 是否被引用 |
|---|---|---|---|---|---|
| 1 | 01-员工手册#0 | 0.5684 | 0.9251 | 872 | 被引用 |
| 2 | 01-员工手册#1 | 0.3751 | 0.3252 | 147 | |
| 3 | 02-知识库#1 | 0.2707 | 0.2476 | 42 | |
| 4 | 02-知识库#0 | 0.2928 | 0.1962 | 1081 | |
| 5 | 03-运维值班规范#0 | 0.2785 | 0.0946 | 877 | |
| 6 | 03-运维值班规范#1 | 0.2937 | 0.0007 | 174 |
模型回答:
年假按司龄计算,具体标准为:入职满 1 年 10 天,满 3 年 15 天,满 5 年 20 天,满 8 年 25 天 1。
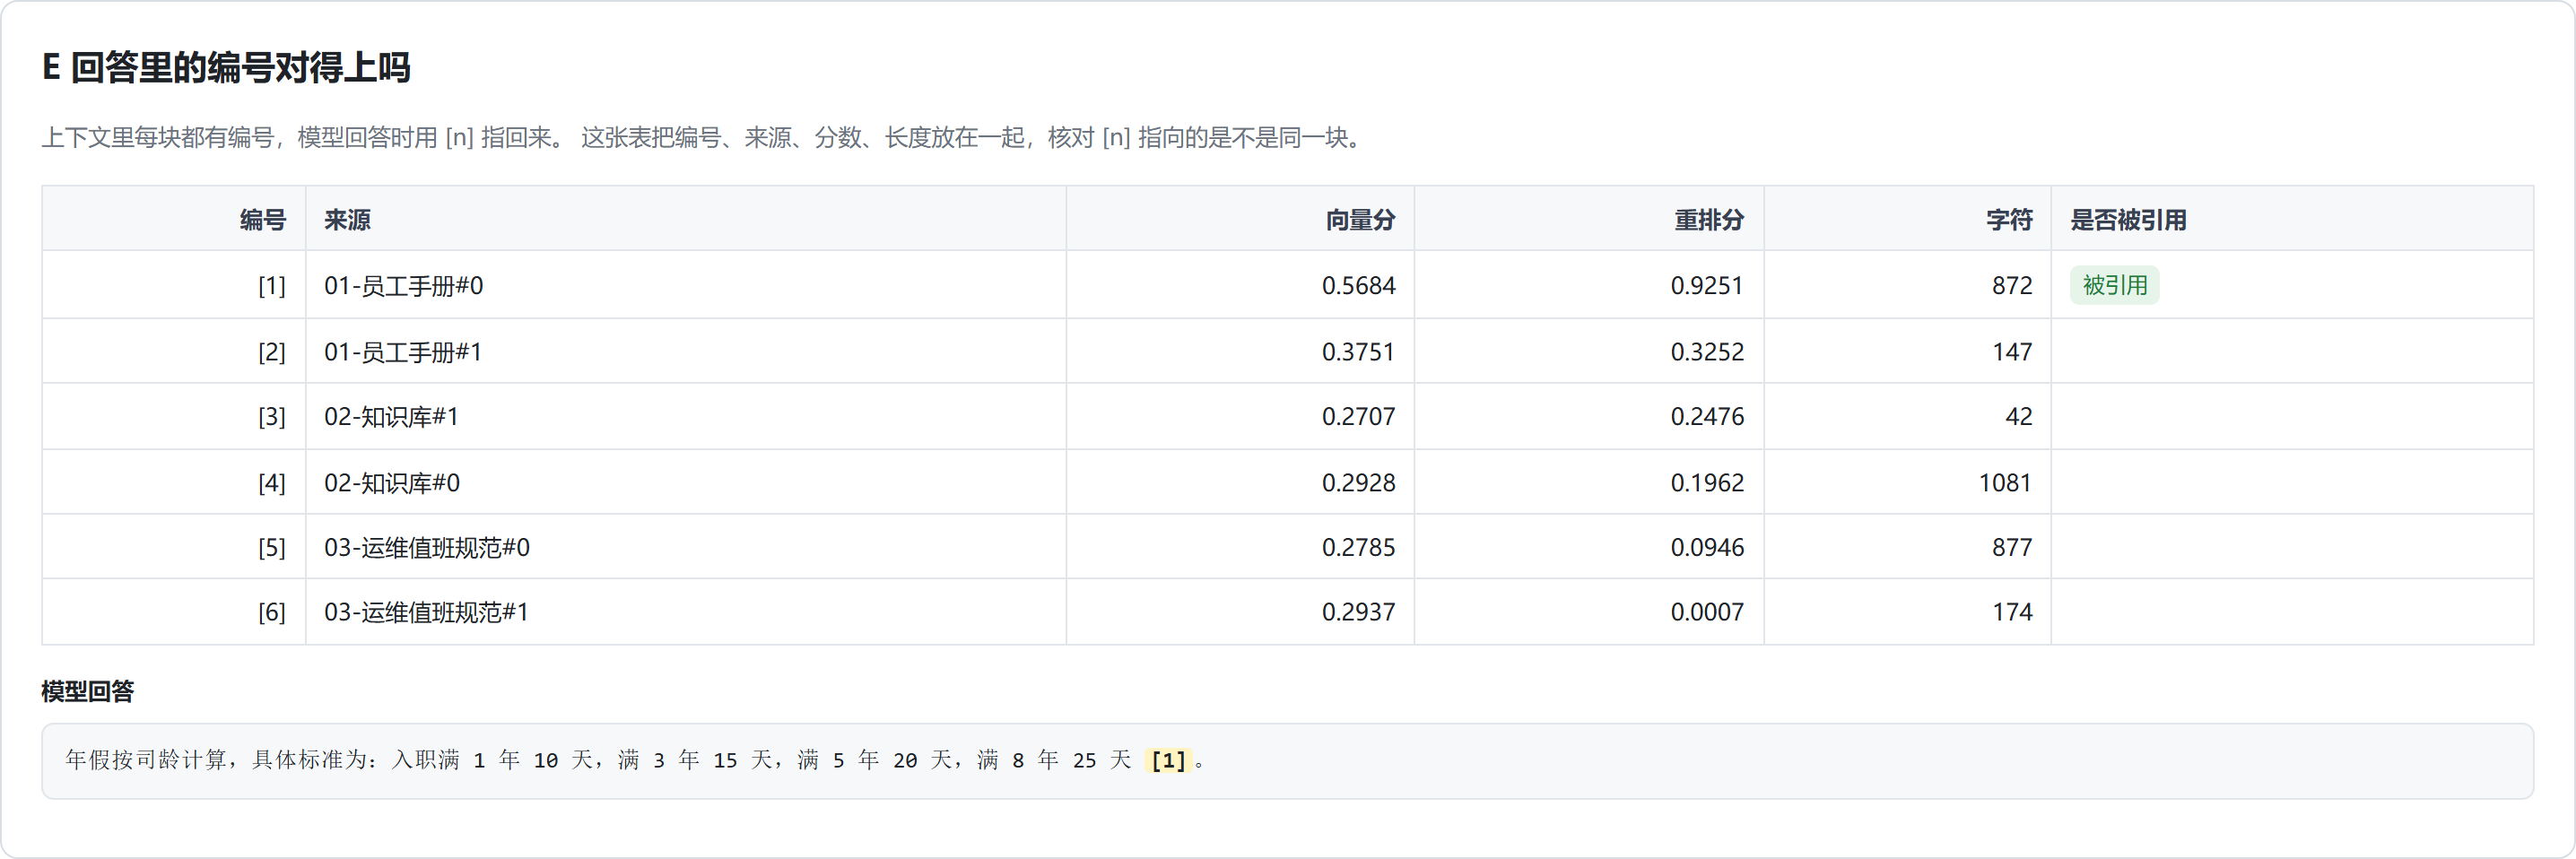
[1] 指回 01-员工手册#0,而年假那张表确实在这一块里。能溯源,回答才可被审计。
这套编号看着简单,但它是后面做"引用溯源"和"答案里出现了资料外的内容"
这类检查的唯一依据------没有编号,就没有任何办法判断模型说的哪句话来自哪里。
5.2 一个坑:重排之后,Document.score 已经不是向量分了
上表里"向量分"和"重排分"是两列不同的数,但它们最初指向同一个字段。
第 09 篇的重排实现里,为了让排序生效,构造新文档时是这么写的:
java
Document copy = Document.builder()
        .text(source.getText())
        .metadata(source.getMetadata())
        .score(row.rerankScore())            // ← Document.score 被重排分覆盖
        .metadata("rerankScore", row.rerankScore())
        .metadata("vectorScore", row.vectorScore())   // ← 原来的向量分挪进了元数据
        .build();
所以重排之后 hit.getScore() 拿到的是重排分 。
引用表如果直接用它当"向量分",就会出现两列数字一模一样------
第一版渲染出来就是这样,[1] 那行向量分和重排分都是 0.9251,看着就不对。
改法是优先从元数据取向量分:
java
private static Double vectorScoreOf(Document document) {
    Object value = document.getMetadata().get("vectorScore");
    return value instanceof Number number ? number.doubleValue() : document.getScore();
}这条坑的教训比代码本身更值:框架对象上的"分数"是会被上一环节改写的 。
凡是要把分数展示给人看的地方,都得先确认这个分数是不是还在它原来的含义上。
六、把这几条落到配置上
新增的三项配置都在 application.yml 的 rag 下,因为它们与用哪个模型、哪个向量库无关:
yaml
rag:
  # 拼进提示词的【参考资料】token 上限。超了就按名次从后往前丢,最后一块放不下则截断。
  # 注意这是**自己给自己设的预算**,不是模型的上下文上限(glm-5.2 有一百万)。
  context-budget-tokens: 3000
  # 字符数 ÷ token 数的估算比:一个 token 约等于几个字符。实测值见第 10 篇,换模型要重新量。
  chars-per-token: 1.6
  # 检索结果为空时是否短路:不调用模型,直接返回"资料中没有相关内容"。
  fallback-when-empty: true
接口也开放了单次覆盖,方便按场景调:
| 参数 | 作用 |
|---|---|
budget |
本次的上下文 token 预算;不传用配置值,传 0 表示不限制 |
topK |
最终拼进上下文的块数上限(第 08 篇已有的参数) |
rerank |
是否在检索与拼上下文之间插一次重排(第 09 篇已有的参数) |
三个参数的分工要说清楚:topK 管"要几条",budget 管"总共多少 token",
rerank 管"用谁排序"。它们会互相牵制------topK 给大了、
budget 给不够,最终进上下文的还是被 budget 卡住的那几条。
小结
这一篇把"候选 → 提示词"这一步的三个问题定下来了:
- 预算要自己设,理由是钱和注意力 ,不是模型装不下。
实测 1 个 token ≈ 1.7273 个字符,固定开销 164 token,配置里取 1.6 偏保守; - 超预算从后往前丢,最后一块才截断 。逐档扫描显示本库的拐点在 2200/1800 之间;
耗时几乎不随预算下降------省的是钱,不是延迟; - 截断会切走答案 。差旅标准那张表被切掉后,回答从"600 元/晚"变成
"资料中没有相关内容"------用户会误以为公司没规定; - 截断和没入库必须能分开 :靠
contextTruncated/droppedChunks两个字段,
以及截断块留在正文里的标记; - 检索为空时短路 ,连模型都不调。实测三个库外问题,
直接问模型三条全都给了"看着很像答案"的编造,走 RAG 是 0 token 的拒绝; - 兜底话术是常量,不是模型生成的。把最后一道防线交给最会编的环节不划算;
- 编号是溯源的唯一依据 ,而
Document.score会被重排覆盖------
向量分要另从vectorScore元数据取,否则引用表上两列数字会重合。
到这里,"检索 → 重排 → 按预算拼 → 生成 → 标注来源"这条问答主链路是完整且可审计的了。