|-----------------------------------------------------------------------------------------------------------------------------|
| 版本说明: 本文涉及的框架和模型版本变化较快。文中对 LlamaIndex、Milvus、BGE-M3、BGE Reranker 等关键行为按当前官方资料做了核验;若本地依赖版本与示例不同,应以当前安装版本的 API 文档和函数签名为准。 |
2026 年关键版本核验
|--------------------|-------------------------------------------------------------------------------------|------------------------------------------------|
| 组件 | 当前核验重点 | 官方来源 |
| Milvus | Milvus Lite 随 PyMilvus 提供;支持 sparse/dense、metadata 过滤、multi-vector 与 hybrid_search。 | https://milvus.io/docs/zh/milvus_lite.md |
| Milvus RRF | RRFRanker 按多路结果的排名位置融合;官方文档默认 k=60。 | https://milvus.io/docs/zh/rrf-ranker.md |
| BGE-M3 | 1024 维、最长 8192 token,支持 dense / sparse / multi-vector。 | https://huggingface.co/BAAI/bge-m3 |
| BGE Reranker v2 M3 | 多语言 Cross-Encoder/Reranker;query+passage 直接输出相关性分数。 | https://huggingface.co/BAAI/bge-reranker-v2-m3 |
1. 知识库构建优化
|-------------------------------------------------------------------------------------------------------------------------------|
| 原理解析: 知识库阶段决定了后续检索的上限。所谓"进阶",并不是把分块参数调得更复杂,而是开始把检索单元、返回单元、结构标签、层级关系和图关系分开设计。一个成熟的 RAG 系统往往不会让"切成什么块"和"最终给 LLM 什么上下文"完全等价。 |
|---------------------------------------------------------------------------------------------------------------------------|
| 原理解析: 可以把它理解成图书馆编目:检索卡片需要短、准、容易命中;真正借给读者的却应该是完整章节或完整资料。后面的父子分块、句子窗口、摘要检索、元数据过滤、层级索引和知识图谱,本质上都在解决"检索精度"和"上下文完整性"之间的矛盾。 |
1.1 分块优化
|-------------------------------------------------------------------------------------------------------------------------------------|
| 原理解析: 分块优化最容易出现的误区,是只盯着 chunk_size。真正重要的是"一个块承担什么职责"。如果一个块既要承担向量检索,又要承担答案上下文,往往会陷入两难:块太小,语义残缺;块太大,向量语义被稀释。进阶方案通过双层或动态窗口把两个职责拆开。 |
分块优化就是把文档拆分出检索专用小块做精准匹配,再通过映射还原完整大块给大模型生成回答,兼顾检索精度与上下文完整性的双层分块策略。
1.1.1 放大检索
|------------------------------------------------------------------------------------------------------------------|
| 原理解析: 放大检索可以概括为"细粒度命中,粗粒度返回"。第一次检索只负责找锚点;第二步则沿着父节点、句子位置或文档结构把锚点扩展成足够完整的上下文。这样既保留了小块检索的敏感度,也避免只把一句孤立文本交给生成模型。 |
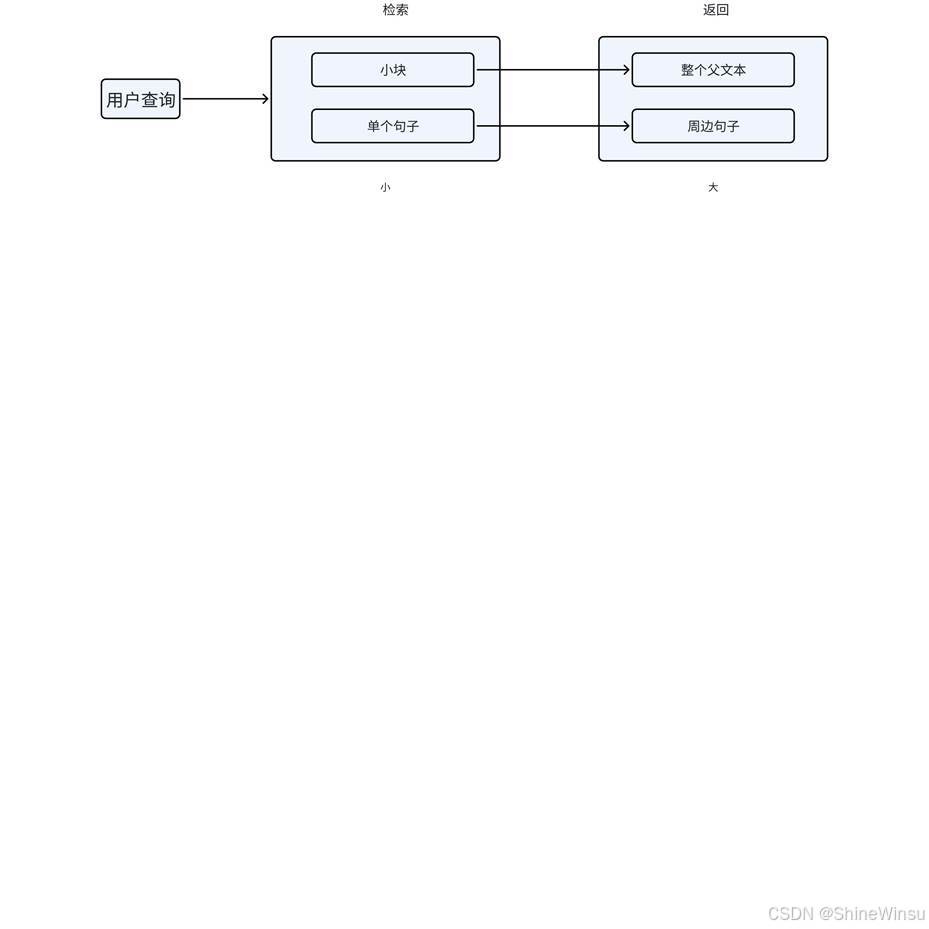
图 2 1.1.1 放大检索
核心思想:将用于检索的文本块与用于生成答案的文本块分离开。具体来说,检索时使用较小的块(提高匹配精度、降低噪声),而在获得检索结果后,再返回对应的较大的块(包含更丰富的上下文)给语言模型用于生成答案。这样既能保证检索的准确性,又能确保答案有充足的上下文支持。举例整部《三国演义》是知识库,提前按段落切成一块块文本片段。你的问题:关羽为何千里走单骑?
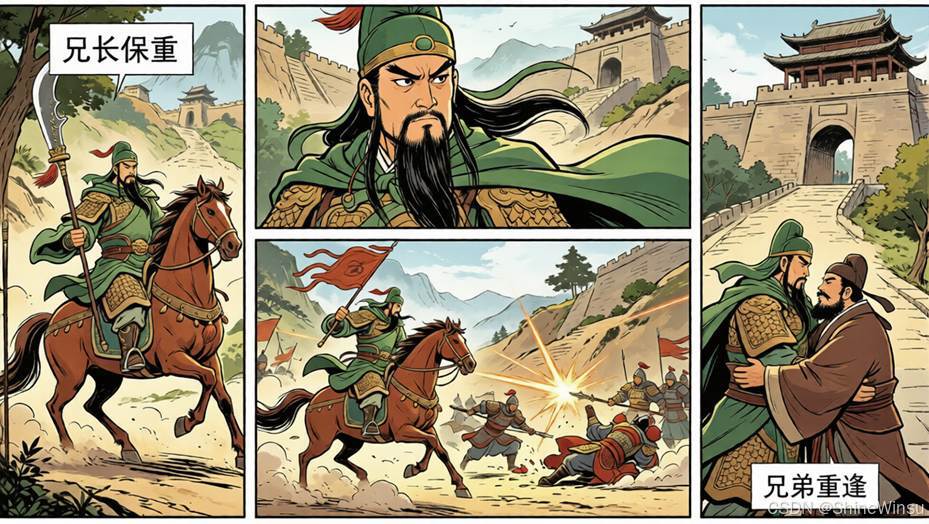
图 3 1.1.1 放大检索
普通基础检索系统只精准命中关键词「千里走单骑」那一小段文字,内容只有:关羽辞别曹操,单人匹马护送二位夫人出发。只有结果,没有前因,根本解释不出原因。放大检索(分块优化)
-
初次检索命中「千里走单骑」核心分块;
-
自动向前拓展相邻分块,调出前文:曹操厚待关羽、赐金银赤兔马、关羽得知刘备下落、立下降
汉不降曹的约定;
-
顺带保留后方相邻分块:过五关斩六将的铺垫;
-
把前后整片关联内容全部合并,再交给LLM回答。
对比效果
- 普通检索回答:关羽离开曹操去找刘备。(单薄,答不出根源)
- 放大检索回答:关羽暂降曹操后,虽受厚待,但心中不忘兄长刘备,偶然得知刘备所在,不愿背
弃旧主,于是挂印封金,千里奔赴寻兄。(逻辑完整、因果清晰)简单对应关系
-
单一段落「千里走单骑」=初次检索命中小块
-
往前拉取「约法三章、得知刘备消息」片段=放大检索向前拓展窗口
-
合并前后完整剧情=拓展后的完整上下文输入大模型
1.1.1.1 父子分块检索
|--------------------------------------------------------------------------------------------------------------------------------------|
| 原理解析: 父子分块中最关键的字段不是向量,而是父子映射关系。子块必须足够短、足够聚焦,并通过 parent_id、parent_full_text 或其他稳定标识能准确回到父块。只要映射关系不稳定,就可能出现"检索命中了 A,返回的却是 B"的严重错误。 |
父子分块:职责划分
|-----------|-----------------|--------------|
| 层级 | 主要职责 | 典型内容 |
| 子块 Child | 参与向量检索,文本短、主题集中 | 标题、关键词、单句 |
| 父块 Parent | 作为生成上下文,信息完整 | 完整段落、知识卡片、章节 |
将文档切分成小块(如句子)用于检索,每个小块存储一个指向父级大块(如段落、章节)的ID。检索时命中小块,但返回的是整个父级大块。父子分块把内容拆成两层:
层级
作用
本示例中的内容
子块(Child)
短小、语义聚焦,只用于检索
故事标题,如「桃园三结义」
父块(Parent)
完整、信息丰富,供LLM作上下
出处、背景、经过、结果、人物
文
检索流程:
用户 query → 向量检索命中子块 → 读取子块 metadata 中的 parent_full_text → 返回父块
全文
1.1.1.1.1 与普通分块的区别
对比项
普通分块
父子分块
入库文本
切片正文
子块标题(短文本)
返回给LLM的内容
命中的切片本身
子块关联的父块全文
信息完整性
取决于切片粒度
父块始终完整
典型场景
通用文档问答
知识卡片、FAQ、条目式百科
1.1.1.1.2 数据准备
parent_child_cards.json
{ "parent_id": "sgyy_001", "child_text": "桃园三结义", "card_fields": { "出处": "《三国演义》第一回 宴桃园豪杰三结义 斩黄巾英雄首立功", "背景": "东汉末年天下大乱,刘备、关羽、张飞在涿郡相遇,志同道合", "经过": "三人在张飞庄后桃园祭告天地,焚香礼拜,结为异姓兄弟,誓同生死", "结果": "刘关张正式结盟,随后招兵买马,共讨黄巾,开启蜀汉创业之路", "人物": "刘备、关羽、张飞" } }, { "parent_id": "sgyy_002", "child_text": "三顾茅庐", "card_fields": { "出处": "《三国演义》第三十八回 定三分隆中决策 战赤壁新野烧火", "背景": "刘备新野寄居,闻诸葛亮有经天纬地之才,欲请其出山辅佐", "经过": "刘备带关、张两次未遇,第三次方在隆中见到诸葛亮,诚恳请教天下大势", "结果": "诸葛亮献上《隆中对》,分析三分天下之策,遂出山辅佐刘备", "人物": "刘备、诸葛亮、关羽、张飞" } }, { "parent_id": "sgyy_003", "child_text": "过五关斩六将", "card_fields": { "出处": "《三国演义》第二十七回 美髯公千里走单骑 汉寿侯五关斩六将", "背景": "关羽得知刘备下落,决意离开曹操,护送二位嫂嫂寻兄", "经过": "连过东岭、洛阳、汜水、荥阳、黄河五关,斩孔秀、韩福、孟坦、卞喜、王植、秦琪 六将", "结果": "关羽冲破重重阻拦,终与刘备会合,忠义之名传扬天下", "人物": "关羽、曹操、廖化、二位嫂嫂" } }, { "parent_id": "sgyy_004", "child_text": "长坂坡当阳桥断喝", "card_fields": { "出处": "《三国演义》第四十一回 刘玄德携民渡江 赵子龙单骑救主", "背景": "曹操大军南下,刘备携百姓撤退,于长坂坡遭曹军追击,形势危急", "经过": "赵云单骑七进七出救阿斗;张飞率二十骑断后,于当阳桥大喝「燕人张翼德在 此!」", "结果": "曹军疑有伏兵不敢前进,刘备得以脱身;赵云怀抱阿斗杀出重围", "人物": "张飞、赵云、刘备、曹操、阿斗(刘禅)" } }, { "parent_id": "sgyy_005", "child_text": "赤壁之战", "card_fields": { "出处": "《三国演义》第四十九回 七星坛诸葛祭风 三江口周瑜纵火", "背景": "曹操率八十万大军南下,孙刘联盟共抗曹操,战于赤壁", "经过": "周瑜定火攻之计,诸葛亮借东风,黄盖诈降,火烧连环战船", "结果": "曹军大败,曹操败走华容道,三国鼎立格局由此奠定", "人物": "曹操、孙权、刘备、周瑜、诸葛亮、黄盖" } }, { "parent_id": "sgyy_006", "child_text": "草船借箭", "card_fields": { "出处": "《三国演义》第四十六回 用奇谋孔明借箭 献密计黄盖受刑", "背景": "周瑜限诸葛亮十日内造十万支箭,欲借机为难;孔明立军令状却言只需三天", "经过": "第三日大雾,孔明率二十条草船逼近曹营,擂鼓呐喊,曹军万箭齐发射向草人", "结果": "草船满载箭矢而归,超额完成任务,周瑜叹服其神机妙算", "人物": "诸葛亮、周瑜、鲁肃、曹操" } }, { "parent_id": "sgyy_007", "child_text": "空城计", "card_fields": { "出处": "《三国演义》第九十五回 马谡拒谏失街亭 武侯弹琴退仲达", "背景": "街亭失守,司马懿大军逼近西城,诸葛亮身边仅有少数老弱残兵", "经过": "孔明令大开城门,自己在城楼上焚香抚琴,神态自若", "结果": "司马懿疑有伏兵,引兵退去;诸葛亮得以保全,后称「空城计」", "人物": "诸葛亮、司马懿、马谡" } }
字段
含义
parent_id
父块唯一标识,用于节点ID与metadata关联
child_text
子块文本,写入向量库参与检索
card_fields
父块字段字典,运行时拼接为 parent_full_text
1.1.1.1.3 构建子节点
- 父块全文拼接
父块不在JSON中直接存储,而是由parent_card_text()动态拼接,便于统一格式:
1. 进行数据拼装
def parent_card_text(child_text: str, card_fields: dictstr, str) -> str:
lines = f"【三国演义 . 故事卡片】{child_text}", ""
for key, value in card_fields.items():
lines.append(f"{key}: {value}")
return "\n".join(lines)
函数说明:parent_card_text()
|-------------|------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| child_text | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| card_fields | dictstr, str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
- 构造TextNode
2. 把json数组转换成listTextNode
def build_child_nodes(records : listdict) -> listTextNode:
1. 创建一个空列表,用来存放转换后的所有节点
nodes :listTextNode = \[\]
2. 遍历获取到的records
for record in records:
parent_id = record"parent_id"
child_text = record"child_text"
card_fields = record"card_fields"
full_text = parent_card_text(child_text, card_fields)
创建TextNode
nodes.append(
TextNode(
text=child_text,
id=f"{parent_id}::c0",
metadata={
"parent_id":parent_id,
"child_text":child_text,
"parent_full_text":full_text, #用来作为上下文,返给提示词
}
)
)
return nodes
函数说明:build_child_nodes()
|---------|------------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | listTextNode | 返回用于向量索引的 TextNode 列表。 |
1.1.1.1.4 构建索引
3. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
函数说明:build_index()
|-------|------------------|---------------------------------------|
| 参数 | 类型/默认值 | 作用 |
| nodes | listTextNode | LlamaIndex 节点列表,通常包含 text 与 metadata。 |
| 返回值 | VectorStoreIndex | 返回构建完成的 VectorStoreIndex。 |
1.1.1.1.5 内容检索
4. 执行检索操作
def retrieve(query: str, index: VectorStoreIndex, top_k: int =1) -> str:
1. 根据已有的索引直接去查询
hits = index.as_retriever(similarity_top_k = top_k).retrieve(query)
2. 假如结果为空
if not hits:
return "未搜索到相关内容"
3. 处理相似度最高的数据
best = hits0.node
child_text = best.metadata.get("child_text", best.text)
score = hits0.score
header = f"【命中子块】{child_text} (相似度:{score:.4f})\n"
return header+best.metadata"parent_full_text"
函数说明:retrieve()
|-------|------------------|----------------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| index | VectorStoreIndex | 已经构建好的索引对象,用于执行检索。 |
| top_k | int;默认 1 | 召回候选数量;值越大召回更广,但噪声和后处理成本也更高。 |
| 返回值 | str | 返回与查询最相关的文本、窗口或节点结果;具体结构以当前实现为准。 |
步骤:
-
将用户query编码为查询向量。
-
在索引中做余弦相似度Top-K比对(默认K=1)。
-
取最高分命中的子节点。
-
从该节点metadata"parent_full_text"取出父块全文并返回。
1.1.1.1.6 完整代码
用来实现父子分块检索
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode
import config
import util
DATA_PATH = config.CHUNKING_DATA_PATH /"parent_child_cards.json"
1. 进行数据拼装
def parent_card_text(child_text: str, card_fields: dictstr, str) -> str:
lines = f"【三国演义 . 故事卡片】{child_text}", ""
for key, value in card_fields.items():
lines.append(f"{key}: {value}")
return "\n".join(lines)
2. 把json数组转换成listTextNode
def build_child_nodes(records : listdict) -> listTextNode:
1. 创建一个空列表,用来存放转换后的所有节点
nodes :listTextNode = \[\]
2. 遍历获取到的records
for record in records:
parent_id = record"parent_id"
child_text = record"child_text"
card_fields = record"card_fields"
full_text = parent_card_text(child_text, card_fields)
创建TextNode
nodes.append(
TextNode(
text=child_text,
id=f"{parent_id}::c0",
metadata={
"parent_id":parent_id,
"child_text":child_text,
"parent_full_text":full_text, #用来作为上下文,返给提示词
}
)
)
return nodes
3. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
4. 执行检索操作
def retrieve(query: str, index: VectorStoreIndex, top_k: int =1) -> str:
1. 根据已有的索引直接去查询
hits = index.as_retriever(similarity_top_k = top_k).retrieve(query)
2. 假如结果为空
if not hits:
return "未搜索到相关内容"
3. 处理相似度最高的数据
best = hits0.node
child_text = best.metadata.get("child_text", best.text)
score = hits0.score
header = f"【命中子块】{child_text} (相似度:{score:.4f})\n"
return header+best.metadata"parent_full_text"
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
2. json数组转换成node列表
nodes = build_child_nodes(records)
3. 建立向量索引
print("正在加载模型,请稍后...")
index = build_index(nodes)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, index))
1.1.1.2 句子窗口检索
|-------------------------------------------------------------------------------------------------------------|
| 原理解析: 句子窗口不预先保存固定大块,而是记录句子在原文中的位置。命中第 i 句后,通过 i-N, i+N 动态切片恢复上下文。它特别适合叙事性文本、教材、判决书、会议记录等上下句关联很强的内容。 |
|----------------------------------------------------------------------------------------------------------------------------------------------------|
| 2026 核验与实践补充: 版本核验:LlamaIndex 当前仍提供 SentenceWindowNodeParser 这类句子窗口节点解析能力。它的价值并不是"把更多文字塞给模型",而是把检索粒度和生成上下文粒度分开:检索时尽量细,生成时再恢复窗口,从而兼顾命中精度与语义完整性。 |
父子分块与句子窗口的核心区别
|-------|----------|----------------|
| 维度 | 父子分块 | 句子窗口 |
| 检索单元 | 预先设计的子块 | 单句 |
| 返回上下文 | 静态父块全文 | 命中句前后 ±N 句动态拼接 |
| 适合内容 | FAQ、知识卡片 | 叙事文本、教材、长段落 |
以单个句子为检索单位,命中某个句子后,动态返回该句子前后若干句(例如前后各N句)作为上下文窗口,不依赖预先定义的大块。举例:你拿着一本完整的小说,把书中每一句单独裁成一张独立小纸条,检索时只匹配单张小纸条上的文字;一旦找到那张匹配的句子纸条,立刻从整本小说里拉出这张纸条前面N张、后面N张纸条,拼成一段完整阅读上下文,全程不用提前把几十句打包成固定大段落。
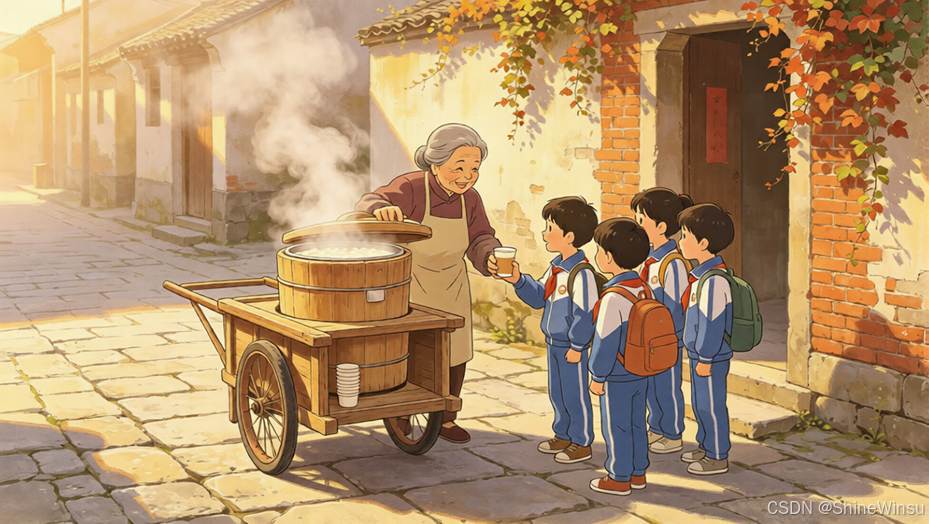
图 4 1.1.1.2 句子窗口检索
比如小说原文段落:
-
清晨巷口飘着豆浆热气。
-
老奶奶推着木车缓缓停下。
-
她掀开保温桶盖子。
-
甜香瞬间漫满整条街道。
-
上学的孩子纷纷围了上来。
-
老奶奶笑着递出温热纸杯。
设定N=1,检索关键词「甜香瞬间漫满整条街道」(对应第4句,单句检索命中)系统不会依赖提前划分好的大段文本,直接动态抓取前1句(3)+命中句(4)+后1句(5),完整返回窗口:她掀开保温桶盖子。甜香瞬间漫满整条街道。上学的孩子纷纷围了上来。
1.1.1.2.1 与父子分块的区别
对比项
父子分块
句子窗口
检索单元
子块标题(极短)
单句(较短)
返回内容
预置的父块全文
命中句±N句动态窗口
上下文来源
metadata中静态存储
DOC_REGISTRY按序号动态截取
典型场景
知识卡片、FAQ
叙事文本、教材段落、判决书
1.1.1.2.2 数据准备
sentence_window_passages.json
{ "doc_id": "test_001", "title": "春日校园清晨", "sentences": \[ "天刚蒙蒙亮,校园的路灯还未熄灭。", "保洁阿姨推着清扫车慢慢走过梧桐大道。", "几滴露水从嫩绿的树叶上轻轻滑落。", "早读的学生背着书包,三三两两走进教学楼。", "走廊里渐渐响起朗朗的读书声。", "阳光穿过玻璃窗,落在摊开的语文课本上。", "讲台上老师拿起粉笔,准备开启今日课堂。", "窗外几只麻雀落在窗台,叽叽喳喳不停吵闹。", "第一节课的铃声准时响彻整个校园。"
},
{
"doc_id": "test_002",
"title": "周末公园野餐",
"sentences":
"周六一早,一家人收拾好野餐篮出门。",
"公交车穿过闹市区,直达城市中央公园。",
"草坪上开满金黄色的小野花,微风轻轻吹拂。",
"爸爸铺开格子餐垫,妈妈拿出水果与三明治。",
"小朋友提着泡泡机,在草地上肆意奔跑追逐。",
"湖边的锦鲤成群结队,争抢游客投喂的鱼食。",
"远处凉亭里,几位老人坐着拉二胡唱戏曲。",
"午后云层散开,暖融融的阳光铺满整片草地。",
"临近傍晚,大家收拾垃圾,不舍地踏上归途。"
},
{
"doc_id": "test_003",
"title": "雨夜居家读书",
"sentences":
"窗外下起连绵细雨,敲打玻璃窗发出沙沙声响。",
"我泡上一杯温热的桂花乌龙茶放在书桌旁。",
"暖黄台灯照亮书页,隔绝室外所有喧嚣。",
"指尖轻轻翻过印着墨香的纸质小说。",
"书中描写山间云海的段落,让人心生向往。",
"偶尔抬头,能看见窗台绿植被雨水打湿叶片。",
"客厅猫咪蜷在毛毯上,发出均匀轻微的呼噜声。",
"雨夜安静舒缓,最适合静下心品读文字。"
},
{
"doc_id": "test_004",
"title": "山间徒步游记",
"sentences":
"清晨七点,我们驱车抵达山脚下的徒步起点。",
"石阶两旁长满野生蕨类植物与各色山花。",
"山泉顺着岩石缝隙流淌,水质清冽甘甜。",
"行至半山腰,云雾缠绕在连绵青山之间。",
"停下脚步远眺,整片山谷尽收眼底十分壮阔。",
"随身携带的面包与矿泉水,是路上全部补给。",
"登顶后站在观景台,能看见远处村落袅袅炊烟。",
"夕阳西下时分,我们沿着原路缓步下山。",
"回到山脚时,天边已经铺满淡紫色晚霞。"
},
{
"doc_id": "test_005",
"title": "老街小吃集市",
"sentences":
"傍晚时分,老城老街的小吃摊陆续支起炉灶。",
"糖炒栗子的焦甜香气顺着巷风四处飘散。",
"手工馄饨店老板快速擀皮、包馅、下锅煮制。",
"铁板豆腐滋滋作响,撒上辣椒与孜然调味。",
"来往行人拎着小吃,边走边说笑十分热闹。",
"白发老奶奶守着酒酿小圆子小摊,温和招呼客人。",
"灯笼依次点亮,复古街道瞬间充满烟火气息。",
"直至深夜,巷内依旧留存未散的食物香气。"
}
]
字段
含义
doc_id
段落唯一标识,用于节点ID与窗口回溯
title
篇名,展示在命中结果与窗口标题中
sentences
预切分句子列表
1.1.1.2.3 构建句级节点
- 文档注册表DOC_REGISTRY
窗口拼接需要知道同一篇的全部句子,因此在建节点前调用register_documents() :
DOC_REGISTRY: dictstr, dict = {}
def register_documents(records: listdict) -> None:
"""将 JSON 段落写入全局 DOC_REGISTRY,供 format_window 使用。"""
DOC_REGISTRY.clear()
for rec in records:
DOC_REGISTRYrec\["doc_id"] = {
"title": rec"title",
"sentences": rec"sentences",
}
函数说明:register_documents()
|---------|--------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | None | 无返回值;更新全局文档注册表。 |
- 自定义分句函数
2. 分句函数
def make_sentence_spliter(sentences: liststr) ->Callable\[str, liststr]:
def _split(_text : str) -> liststr:
return list(sentences)
return _split
函数说明:make_sentence_spliter()
|-----------|----------------------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| sentences | liststr | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | Callable\[str, liststr] | 返回当前处理步骤的结果对象或状态。 |
函数说明:_split()
|-------|-------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| _text | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | liststr | 返回当前处理步骤的结果对象或状态。 |
- 构造句级TextNode
4. 把json数据转换成TextNode列表
def build_sentence_nodes(records: listdict) -> listTextNode:
register_documents(records)
nodes: listTextNode = \[\]
for record in records:
doc_id = record"doc_id"
title = record"title"
sentences = record"sentences"
创建句子的切分工具
parser = SentenceWindowNodeParser.from_defaults(
window_size=1,
sentence_splitter=make_sentence_spliter(sentences),
)
doc_nodes =
parser.get_nodes_from_documents(Document(text="".join(sentences)))
for i, node in enumerate(doc_nodes):
node.metadata"sentence_index" = i
node.metadata"doc_id" = doc_id
node.metadata"doc_title" = title
node.id_ = f"{doc_id}::s{i}"
nodes.extend(doc_nodes)
return nodes
函数说明:build_sentence_nodes()
|---------|------------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | listTextNode | 返回句级 TextNode 列表。 |
- 序号标签生成
1. 为句子生成序号标签
def make_labels(count : int) -> liststr:
circled = "①②③④⑤⑥⑦⑧⑨⑩"
if count <= len(circled):
return list(circled:count)
return f"{i+1}." for i in range(count)
函数说明:make_labels()
|-------|-------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| count | int | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | liststr | 返回用于展示句序的标签列表。 |
1.1.1.2.4 构建建索引
5. 构建向量索引
def build_index(nodes: listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
1.1.1.2.5 内容检索
以命中句为中心,在同一篇内取前后各N句:
- 窗口拼接
6. 以命中句为中心,前后扩展N句
def format_window(
doc_id:str,
center_index:int,
before: int =1,
after: int=1,
) -> str:
doc = DOC_REGISTRYdoc_id
sentences = doc"sentences"
title = doc"title"
labels = make_labels(len(sentences))
lo = max(0, center_index - before)
hi = min(len(sentences) -1, center_index + after)
body = "\n".join(f"{labelsi} {sentencesi}" for i in range(lo, hi+1))
return f"【{title} . 句子窗口】 \n {body}"
函数说明:format_window()
|--------------|----------|-----------------|
| 参数 | 类型/默认值 | 作用 |
| doc_id | str | 文档唯一标识,用于回溯原文。 |
| center_index | int | 命中句在原文句子列表中的位置。 |
| before | int;默认 1 | 窗口向前扩展的句子数。 |
| after | int;默认 1 | 窗口向后扩展的句子数。 |
| 返回值 | str | 返回拼接后的窗口上下文字符串。 |
- 检索函数
7. 执行检索:用户提问->拿到相似度最高的一句文本->再进行一个前后窗口大小的扩展
def retrieve(
query:str,
index: VectorStoreIndex,
top_k: int=1,
N: int=1,
) -> str:
1. 在索引中检索
hits = index.as_retriever(similarity_top_k=top_k).retrieve(query)
2. 对结果进行判断
if not hits:
return "未找到相关的内容"
best = hits0
node = best.node
doc_id = node.metadata"doc_id"
doc_title = node.metadata"doc_title"
center=node.metadata"sentence_index"
labels = make_labels(len(DOC_REGISTRYdoc_id"sentences"))
3. 拼装返回结果
header = (
f"【命中句】{doc_title} . {labelscenter} {node.text}\n"
f"(相似度:{best.score:.4f})\n"
)
4. 提取窗口内容
window = format_window(doc_id, center, before=N, after=N)
return header +"\n"+window
1.1.1.2.6 完整代码
处理句子窗口检索
from typing import Callable
from llama_index.core import Document, VectorStoreIndex
from llama_index.core.base.embeddings.base import similarity
from llama_index.core.node_parser import SentenceWindowNodeParser
from llama_index.core.schema import TextNode
import config
import util
数据路径
DATA_PATH = config.CHUNKING_DATA_PATH / "sentence_window_passages.json"
全局的文档登记册
DOC_REGISTRY: dictstr, dict = {}
1. 为句子生成序号标签
def make_labels(count : int) -> liststr:
circled = "①②③④⑤⑥⑦⑧⑨⑩"
if count <= len(circled):
return list(circled:count)
return f"{i+1}." for i in range(count)
2. 分句函数
def make_sentence_spliter(sentences: liststr) ->Callable\[str, liststr]:
def _split(_text : str) -> liststr:
return list(sentences)
return _split
3. 把json正片文档做登记
def register_documents(records : listdict) -> None:
DOC_REGISTRY.clear()
for record in records:
DOC_REGISTRYrecord\["doc_id"] = {
"title": record"title",
"sentences": record"sentences"
}
4. 把json数据转换成TextNode列表
def build_sentence_nodes(records: listdict) -> listTextNode:
register_documents(records)
nodes: listTextNode = \[\]
for record in records:
doc_id = record"doc_id"
title = record"title"
sentences = record"sentences"
创建句子的切分工具
parser = SentenceWindowNodeParser.from_defaults(
window_size=1,
sentence_splitter=make_sentence_spliter(sentences),
)
doc_nodes =
parser.get_nodes_from_documents(Document(text="".join(sentences)))
for i, node in enumerate(doc_nodes):
node.metadata"sentence_index" = i
node.metadata"doc_id" = doc_id
node.metadata"doc_title" = title
node.id_ = f"{doc_id}::s{i}"
nodes.extend(doc_nodes)
return nodes
5. 构建向量索引
def build_index(nodes: listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
6. 以命中句为中心,前后扩展N句
def format_window(
doc_id:str,
center_index:int,
before: int =1,
after: int=1,
) -> str:
doc = DOC_REGISTRYdoc_id
sentences = doc"sentences"
title = doc"title"
labels = make_labels(len(sentences))
lo = max(0, center_index - before)
hi = min(len(sentences) -1, center_index + after)
body = "\n".join(f"{labelsi} {sentencesi}" for i in range(lo, hi+1))
return f"【{title} . 句子窗口】 \n {body}"
7. 执行检索:用户提问->拿到相似度最高的一句文本->再进行一个前后窗口大小的扩展
def retrieve(
query:str,
index: VectorStoreIndex,
top_k: int=1,
N: int=1,
) -> str:
1. 在索引中检索
hits = index.as_retriever(similarity_top_k=top_k).retrieve(query)
2. 对结果进行判断
if not hits:
return "未找到相关的内容"
best = hits0
node = best.node
doc_id = node.metadata"doc_id"
doc_title = node.metadata"doc_title"
center=node.metadata"sentence_index"
labels = make_labels(len(DOC_REGISTRYdoc_id"sentences"))
3. 拼装返回结果
header = (
f"【命中句】{doc_title} . {labelscenter} {node.text}\n"
f"(相似度:{best.score:.4f})\n"
)
4. 提取窗口内容
window = format_window(doc_id, center, before=N, after=N)
return header +"\n"+window
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
2. json数组转换成node列表
nodes = build_sentence_nodes(records)
3. 建立向量索引
print("正在加载模型,请稍后...")
index = build_index(nodes)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, index))
1.1.2 总结摘要
|---------------------------------------------------------------------------------------------------------------------|
| 原理解析: 摘要检索是一种"用浓缩文本做索引、用完整原文做证据"的策略。摘要越像主题标签,召回速度越快;但摘要天然会丢细节,因此不能让摘要直接替代原文作为最终证据。最稳妥的做法是:摘要只参与召回,生成阶段仍回源到完整文档。 |
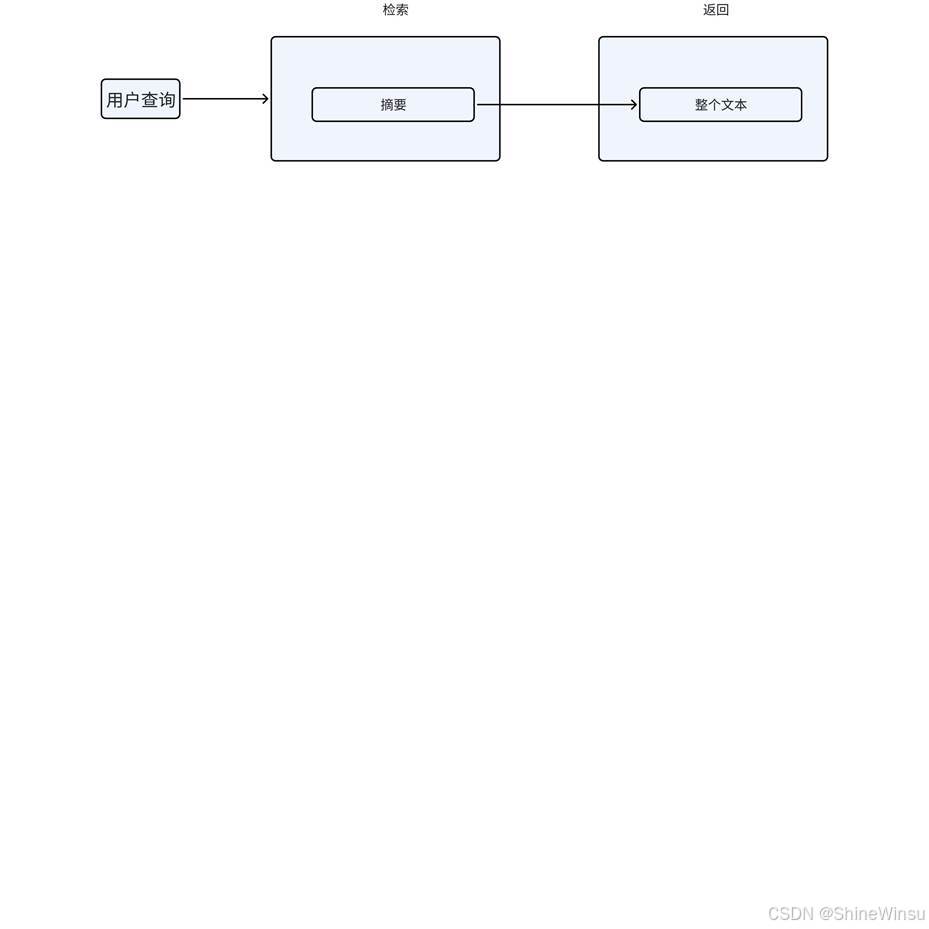
图 5 1.1.2 总结摘要
核心思想:先对大块文本生成摘要,在摘要上进行检索,再根据检索结果获取原始大块内容。其实和放大检索的思路非常的相似。优势:过滤噪音,检索极快。尤其适合处理那种废话很多、核心观点分散的长文档。劣势:细节丢失。如果你的问题非常刁钻(问某个小实验的数据),摘要里可能根本没写。示例:
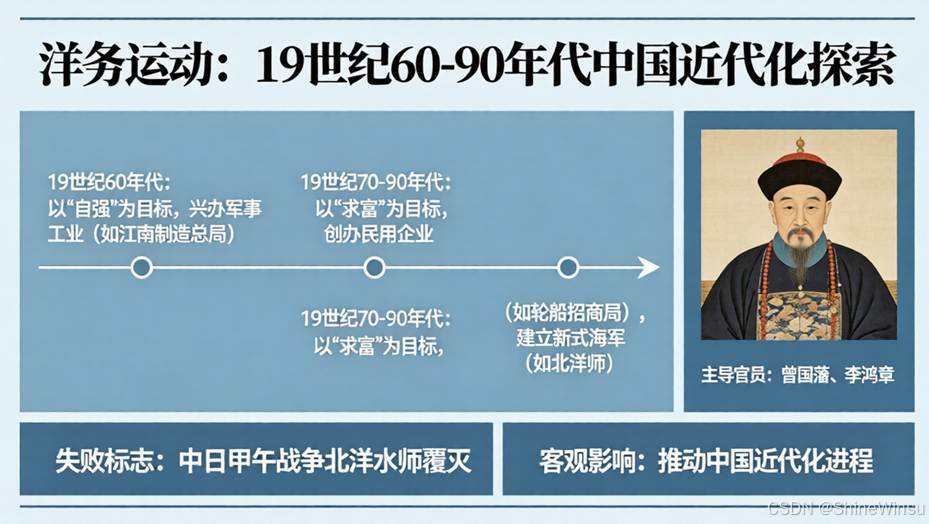
图 6 1.1.2 总结摘要
比如历史上"洋务运动"有10页内容,包含:背景、代表人物、具体措施、失败原因、历史评价等,这10页内容可以生成一段摘要."洋务运动是19世纪60-90年代清政府以'自强''求富'为目标的改革运动,由曾国藩、李鸿章等地方官员主导,主要内容包括兴办军事工业、民用企业、建立新式海军。运动最终在中日甲午战争中失败,但客观上推动了中国近代化进程。"生成过程
-
用户问:"洋务运动是谁主导的?主要内容是什么?"
-
系统在摘要库中检索,命中上面这段摘要
-
返回完整的10页内容给AI生成答案
1.1.2.1 与放大检索的区别
对比维度
放大检索
总结摘要
核心思路
用小单位检索,命中后从原文结构里放大/扩
用摘要检索,命中后从metadata取回
展返回
整篇原文
一句话概括
命中一句→扩前后N句;命中标题→读父
命中摘要→读完整长文
块全文
向量库里的text
原文中的一小段(单句、标题等)
人工/LLM写出的摘要(二次加工)
是否仍是原文
是,直接从原文切分
否,摘要是浓缩后的新文本
返回内容
局部上下文(窗口±N句)或预置父块
整篇完整原文
可调(如 before/after )
范围是否可调
一般不可调,返回全文
原文信息是否完整
完整保留,仅检索粒度变细
摘要层会丢失部分细节
保留
检索粒度
细(可定位到某一句/某标题)
粗(只能匹配到整个主题)
适合的问题类型
「某句/某步发生了什么」
「某主题讲了什么、谁主导、主要内
容」
1.1.2.2 数据准备
summary_retrieval_topics.json
{ "topic_id": "topic_001", "title": "洋务运动", "summary": "洋务运动是 19 世纪 60-90 年代清政府以「自强」「求富」为目标的改革运动, 由曾国藩、李鸿章等地方官员主导,主要内容包括兴办军事工业、民用企业、建立新式海军。运动最终 在中日甲午战争中失败,但客观上推动了中国近代化进程。", "original_text": "【第1页·背景】\\n19 世纪中叶,清政府在内忧外患下面临统治危机。第 二次鸦片战争后,列强加紧侵略,传统兵制与工业落后,朝野出现「师夷长技以制夷」的呼声。\\n\\n 【第2页·代表人物】\\n曾国藩、李鸿章、左宗棠、张之洞等地方督抚是洋务运动的主要推动者;中央以 奕訢等为辅。他们主张在维护封建制度前提下学习西方技术。\\n\\n【第3页·指导思想】\\n以「自强」 「求富」为口号:前期强调军事自强,后期侧重民用企业与财富积累。\\n\\n【第4页·军事工业】 \\n1861 年起设安庆内军械所,后建江南制造总局、福州船政局、天津机器局等,仿制枪炮、轮船。 \\n\\n【第5页·民用企业】\\n1872 年轮船招商局成立,另有开平矿务局、汉阳铁厂、上海机器织布局 等,采用官督商办等形式。\\n\\n【第6页·海军建设】\\n1888 年编成北洋海军,拥有定远、镇远等铁甲 舰,一度号称亚洲第一舰队。\\n\\n【第7页·文教措施】\\n设同文馆、派遣幼童留学,翻译西书,创办 新式学堂,传播近代科学知识。\\n\\n【第8页·失败原因】\\n根本目的在于维护清朝统治,未触动封建 体制;管理腐败、依赖外国技术与顾问;各派系掣肘,缺乏统筹。\\n\\n【第9页·甲午战败】\\n1894--- 1895 年甲午战争中北洋海军覆没,标志着洋务运动在军事上的失败。\\n\\n【第10页·历史评价】\\n洋 务运动未能使中国富强,但客观上引进机器生产与近代企业制度,培养了一批技术人才,推动了中国早 期近代化进程。" }, { "topic_id": "topic_002", "title": "贞观之治", "summary": "贞观之治是唐太宗李世民在位前期(627---649 年)出现的治世局面。在魏徵、房 玄龄、杜如晦等大臣辅佐下,推行轻徭薄赋、任贤纳谏、完善三省六部与科举法制,击败东突厥、稳定 边疆,使经济恢复、吏治清明,成为唐代及中国古代著名的盛世典范。", "original_text": "【第1页·时代背景】\\n隋朝末年天下大乱,李渊起兵入关建立唐朝。626 年玄武门之变后,李世民即位为唐太宗。即位之初,突厥南下、户口锐减、府库空虚,亟需休养生息与 整饬吏治。\\n\\n【第2页·核心人物】\\n唐太宗李世民善于纳谏、任贤使能;魏徵以直言敢谏著称;房 玄龄、杜如晦并称「房谋杜断」,辅佐制定典章制度;长孙无忌等亦参与朝政,形成较稳定的君臣协作 格局。\\n\\n【第3页·治国理念】\\n奉行「水能载舟,亦能覆舟」的民本思想,强调轻徭薄赋、戒奢崇 俭。主张「为政之要,在于得人」,把选贤任能与听取不同意见作为治国根本。\\n\\n【第4页·政治措 施】\\n完善三省六部制,明确中书决策、门下审议、尚书执行的分工;精简机构、裁汰冗官;推行科 举,扩大寒门入仕渠道;修订《贞观律》,强调慎刑恤囚。\\n\\n【第5页·经济与赋役】\\n推行均田制 与租庸调制,减轻农民负担;鼓励垦荒、兴修水利;定户籍、均赋税,使流亡人口渐次复业,农业生产 逐步恢复。\\n\\n【第6页·军事与边防】\\n击败东突厥,被尊为「天可汗」,稳定北方边疆;设羁縻府 州管理归附部族;在保障安全前提下减少大规模用兵,使百姓得以安居。\\n\\n【第7页·纳谏与吏治】 \\n设立谏官制度,魏徵等常于廷议指陈时政得失;严惩贪污,提倡廉明;太宗多次自省,把纳谏视为巩 固统治的重要手段。\\n\\n【第8页·文教与科举】\\n重视教育,设弘文馆、崇文馆培养人才;完善科举 考试,扩大取士范围;整理典籍、刊定五经义疏,推动学术与文化繁荣。\\n\\n【第9页·社会状况】\\n 物价相对稳定,史载「商旅不行,牛马野宿」;人口增长、户口回升;吏治较为清明,社会矛盾有所缓 和,百姓生活较隋末大乱时期明显改善。\\n\\n【第10页·历史评价】\\n贞观年间(627---649 年)政治 较清明、经济恢复、国力强盛,史称「贞观之治」,被视为中国古代治世典范之一。其经验在于任贤纳 谏、轻徭薄赋、厉行法治,对后世影响深远。" }, { "topic_id": "topic_003", "title": "辛亥革命", "summary": "辛亥革命是 1911 年以孙中山为代表的革命派推翻清朝统治、结束两千多年君主 专制的民主革命。武昌起义后各省响应,1912 年建立中华民国,颁布《临时约法》,传播民主共和思 想,但未能彻底完成反帝反封建任务。", "original_text": "【第1页·时代背景】\\n20 世纪初,清政府签订《辛丑条约》后民族危机 加深,立宪骗局与皇族内阁引发不满,各地会党、新军与知识分子秘密活动,革命思想广泛传播。\\n\\n 【第2页·核心人物】\\n孙中山提出三民主义,领导同盟会及后续革命团体;黄兴、宋教仁等组织武装起 义;黎元洪等新军将领在武昌起义中发挥关键作用。\\n\\n【第3页·指导思想】\\n以民族、民权、民生 为纲领,主张推翻君主专制,建立民主共和国,实行平均地权等社会改革设想。\\n\\n【第4页·主要过 程】\\n1911 年 10 月 10 日武昌起义爆发,随后湖南、陕西、江西等省相继独立,清帝溥仪于 1912 年 2 月退位。\\n\\n【第5页·重要成果】\\n1912 年 1 月 1 日孙中山在南京就任临时大总统, 颁布《中华民国临时约法》,确立共和政体。\\n\\n【第6页·历史局限】\\n革命果实被袁世凯等旧势力 窃取,未彻底铲除封建土地制度与帝国主义特权,中国半殖民地半封建社会性质未根本改变。\\n\\n【第 7页·历史评价】\\n辛亥革命是中国近代史上里程碑式的民主革命,极大推动了思想解放与政治制度变 革,为后续新民主主义革命创造了条件。" }, { "topic_id": "topic_004", "title": "百家争鸣", "summary": "百家争鸣是春秋战国时期社会大变革催生的思想文化繁荣局面,涌现儒、道、墨、 法、兵等诸多学派。儒家主张仁礼德治,道家提倡无为而治,墨家倡导兼爱非攻,法家重法治集权,各 派相互辩论著书,奠定中华传统思想根基。", "original_text": "【第1页·时代背景】\\n春秋战国分封制瓦解,诸侯争霸战乱频繁,旧礼乐 制度崩坏。士人阶层崛起,各国君主招揽人才,宽松社会环境允许自由讲学论道,催生多元思想流派。 \\n\\n【第2页·儒家学派】\\n创始人孔子,核心主张仁、礼、德治;孟子提出仁政、性善论;荀子主张 礼法并用、性恶论,重视教化与礼制约束。经典有《论语》《孟子》《荀子》。\\n\\n【第3页·道家学 派】\\n老子著《道德经》,提倡道法自然、无为而治;庄子主张逍遥自由,看淡功名利禄,追求精神超 脱,反对人为干预事物发展。\\n\\n【第4页·墨家学派】\\n墨子创立,代表平民阶层利益,核心思想兼 爱、非攻、尚贤、节用,反对战争与贵族奢靡,推崇实用技术与平等友爱。\\n\\n【第5页·法家学派】 \\n商鞅、韩非为代表,主张以严刑峻法治理国家,强化君主中央集权,重农抑商,顺应时代变革,成为 秦国统一的治国理论。\\n\\n【第6页·其他学派】\\n兵家以孙武《孙子兵法》为核心,总结战争谋略; 阴阳家研究阴阳五行、天道运转;名家专注逻辑辩论,辨析名实关系。\\n\\n【第7页·历史影响】\\n百 家争鸣是中国历史第一次思想解放运动,各派学说相互融合碰撞,塑造传统政治、伦理、哲学体系,深 刻影响后世两千多年社会发展。" }, { "topic_id": "topic_005", "title": "安史之乱", "summary": "安史之乱是755至763年安禄山、史思明发动的叛乱,唐朝由盛转衰的转折点。战 乱摧毁北方经济,中央权威衰落,藩镇割据形成,边疆管控削弱,盛唐繁荣局面彻底终结。", "original_text": "【第1页·时代背景】\\n唐玄宗开元盛世后期,玄宗怠于朝政,重用李林 甫、杨国忠,朝政腐败。均田制瓦解,府兵制崩溃,边疆节度使手握军政财大权,地方势力膨胀。\\n\\n 【第2页·叛乱爆发】\\n755年范阳、平卢、河东三镇节度使安禄山以讨伐杨国忠为名起兵,迅速占领洛 阳、长安,唐玄宗出逃蜀地,马嵬坡兵变赐死杨贵妃。\\n\\n【第3页·叛乱进程】\\n安禄山称帝后被儿 子安庆绪刺杀;史思明击杀安庆绪,后又被其子史朝义所杀。唐朝依靠郭子仪、李光弼联合回纥兵力耗 时八年平定叛乱。\\n\\n【第4页·直接破坏】\\n黄河中下游城镇焚毁,人口锐减,农田荒芜,经济重心 开始逐步向南转移,国库空虚国力大幅衰退。\\n\\n【第5页·政治变局】\\n朝廷无力彻底铲除叛军残 余,被迫册封降将为节度使,各地藩镇拥兵自重,藩镇割据长期延续,中央集权大幅弱化。\\n\\n【第6 页·边疆危机】\\n唐朝抽调西北边防军队平叛,西域防御空虚,吐蕃趁机侵占河西、安西大片土地,丧 失对西域长期控制。\\n\\n【第7页·历史评价】\\n安史之乱终结盛唐盛世,社会、政治、军事、经济全 面衰退,此后唐朝长期陷入内耗,再也无法恢复往日强盛。" }, { "topic_id": "topic_006", "title": "新文化运动", "summary": "新文化运动兴起于1915年,以《新青年》为阵地,陈独秀、李大钊、鲁迅等倡导民 主与科学,抨击封建礼教,提倡白话文,后期传播马克思主义,为五四运动与新民主主义革命奠定思想 基础。", "original_text": "【第1页·时代背景】\\n辛亥革命未能改变旧思想旧文化,封建礼教根深蒂 固,尊孔复古思潮泛滥。先进知识分子意识到制度变革需先完成思想解放,发起思想革新运动。\\n\\n 【第2页·发展阶段】\\n前期1915-1919年,核心口号民主(德先生)、科学(赛先生);五四运动后进 入后期,大量知识分子转向传播马克思主义。\\n\\n【第3页·代表人物与刊物】\\n陈独秀创办《青年杂 志》后改名《新青年》;李大钊最早系统介绍马克思主义;鲁迅以小说批判封建礼教;胡适主张文学革 命、改用白话文。\\n\\n【第4页·核心主张】\\n批判三纲五常、封建旧道德;反对文言文,推行通俗白 话文;倡导个性解放、男女平等,普及现代科学观念破除封建迷信。\\n\\n【第5页·文学革命成果】\\n 废除晦涩古文,白话小说、白话诗歌兴起,普通民众更容易接触文字与新思想,文化传播门槛大幅降 低。\\n\\n【第6页·思想转向】\\n俄国十月革命后,李大钊发表《我的马克思主义观》,系统宣传唯物 史观、阶级斗争理论,马克思主义在中国广泛传播。\\n\\n【第7页·历史意义】\\n猛烈冲击封建传统思 想禁锢,促进青年思想觉醒,为五四运动爆发提供思想支撑,也为中国共产党诞生准备理论与人才条 件。" }, { "topic_id": "topic_007", "title": "商鞅变法", "summary": "商鞅变法是战国秦孝公时期推行的全面改革,废除井田制、奖励耕战、推行郡县 制、严刑峻法整顿吏治。极大增强秦国国力,奠定统一六国基础,但严刑苛法也激化社会矛盾。", "original_text": "【第1页·变法背景】\\n战国初期秦国地处西陲,经济落后、贵族势力强 大,国力远不及中原各国。秦孝公求贤图强,卫鞅入秦获得重用,主持变法革新。\\n\\n【第2页·两次变 法分期】\\n第一次侧重户籍、军功、农业激励;第二次推进土地制度、郡县、统一度量衡,改革更加彻 底全面。\\n\\n【第3页·经济改革措施】\\n废除井田制,承认土地私有允许买卖;重农抑商,奖励耕 织;统一度量衡,刺激农业生产与国家赋税收入。\\n\\n【第4页·军政制度革新】\\n废除世卿世禄制, 设立二十等军功爵,士兵杀敌可晋升获土地;推行什伍连坐户籍制度,强化基层管控。\\n\\n【第5页·地 方行政变革】\\n全国划分县制,由中央直接任免官吏,取代贵族封地,中央集权制度初步建立。\\n\\n 【第6页·变法结局】\\n秦孝公去世后旧贵族反扑,商鞅被车裂处死,但变法法令完整保留,秦国持续受 益。\\n\\n【第7页·历史评价】\\n变法让秦国经济、军事实力远超六国,为秦始皇统一全国铺路;但严 苛律法、重刑高压也造成百姓负担沉重,埋下秦朝速亡隐患。" }, { "topic_id": "topic_008", "title": "郑和下西洋", "summary": "郑和下西洋是明永乐至宣德年间大规模远洋航海活动,郑和率领船队七次远航西太 平洋、印度洋,到访三十余国,宣扬明朝国威、开展朝贡贸易,是古代世界规模空前航海行动,后因海 禁政策终止。", "original_text": "【第1页·时代背景】\\n明成祖朱棣登基后国力强盛,希望海外诸国臣服朝 贡,同时搜寻建文帝下落,派遣郑和组建巨型船队出海远航。\\n\\n【第2页·船队规模】\\n船只体量领 先世界,宝船长宽远超同期西方船只,船员单次出海两万余人,配备航海图、罗盘、天文定位技术。 \\n\\n【第3页·航行范围】\\n途经东南亚、马来半岛、印度半岛,最远抵达波斯湾、东非沿岸,访问三 十多个海外国家与地区。\\n\\n【第4页·主要活动】\\n赏赐丝绸瓷器换取香料、珠宝、异兽;建立朝贡 外交,调解海外小国冲突;传播中原农耕、手工业技术。\\n\\n【第5页·历史价值】\\n开辟多条远洋航 线,促进中外经济文化交流,展现明代先进造船与航海技术,扩大中华文明海外影响力。\\n\\n【第6页· 终止原因】\\n耗费巨额国库银两,朝中文官认为无实质经济收益;明仁宗、宣宗之后推行海禁,停止远 洋航行,航海档案大量损毁。\\n\\n【第7页·历史局限】\\n航行以政治扬威为核心,无殖民扩张意图, 未发展民间海外贸易,缺乏持续经济驱动力,航海事业难以长期延续。" }
字段
含义
topic_id
主题唯一标识,用于节点ID与metadata关联
title
主题名称,展示在命中结果与原文标题中
summary
摘要文本,写入向量库参与检索
original_text
完整长文,存入metadata,检索命中后取回
1.1.2.3 构建摘要节点
2. 把json数组转换成listTextNode
def build_summary_nodes(records : listdict) -> listTextNode:
1. 空列表接受结果
nodes: listTextNode = \[\]
2. 遍历json结果
for record in records:
topic_id = record"topic_id"
title = record"title"
summary = record"summary"
original_text = record"original_text"
nodes.append(
TextNode(
text=summary,
id=f"{topic_id}::summary",
metadata={
"topic_id":topic_id,
"title":title,
"summary":summary,
"original_text":original_text,
}
)
)
return nodes
函数说明:build_summary_nodes()
|---------|------------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | listTextNode | 返回当前处理步骤的结果对象或状态。 |
1.1.2.4 构建索引
3. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
1.1.2.5 内容检索
4. 执行检索操作
def retrieve(query: str, index: VectorStoreIndex, top_k:int=1) -> str:
1. 根据摘要去查询
hits = index.as_retriever(similarity_top_k=top_k).retrieve(query)
if not hits:
return "未找到相关内容"
best = hits0
node = best.node
title = node.metadata"title"
summary = node.metadata"summary"
original_text = node.metadata"original_text"
header = f"【命中摘要】 {title} . {summary}\n(相似度: {best.score:.4f})\n"
return header + "\n" + format_original_text(title, original_text)
1.1.2.6 完整代码
实现总结摘要的分块优化
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode
from openpyxl.styles.builtins import title
import config
import util
数据集的路径
DATA_PATH = config.CHUNKING_DATA_PATH / "summary_retrieval_topics.json"
1. 拼装原始文本的展示
def format_original_text(title: str, original_text: str) -> str:
lines = f"【{title} , 完整的原文】"
lines.append(original_text)
return "\n".join(lines)
2. 把json数组转换成listTextNode
def build_summary_nodes(records : listdict) -> listTextNode:
1. 空列表接受结果
nodes: listTextNode = \[\]
2. 遍历json结果
for record in records:
topic_id = record"topic_id"
title = record"title"
summary = record"summary"
original_text = record"original_text"
nodes.append(
TextNode(
text=summary,
id=f"{topic_id}::summary",
metadata={
"topic_id":topic_id,
"title":title,
"summary":summary,
"original_text":original_text,
}
)
)
return nodes
3. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
4. 执行检索操作
def retrieve(query: str, index: VectorStoreIndex, top_k:int=1) -> str:
1. 根据摘要去查询
hits = index.as_retriever(similarity_top_k=top_k).retrieve(query)
if not hits:
return "未找到相关内容"
best = hits0
node = best.node
title = node.metadata"title"
summary = node.metadata"summary"
original_text = node.metadata"original_text"
header = f"【命中摘要】 {title} . {summary}\n(相似度: {best.score:.4f})\n"
return header + "\n" + format_original_text(title, original_text)
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
2. json数组转换成node列表
nodes = build_summary_nodes(records)
3. 建立向量索引
print("正在加载模型,请稍后...")
index = build_index(nodes)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, index))
函数说明:format_original_text()
|---------------|--------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| title | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| original_text | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
1.1.3 添加元数据
|----------------------------------------------------------------------------------------------------------------------|
| 原理解析: 元数据过滤解决的是"语义相似但业务上不应该混在一起"的问题。比如年份、科室、权限、作者、地区、产品类型等条件,本质上不是语言理解问题,而是结构化约束。先过滤再向量检索,通常比单纯依赖 embedding 更稳定。 |
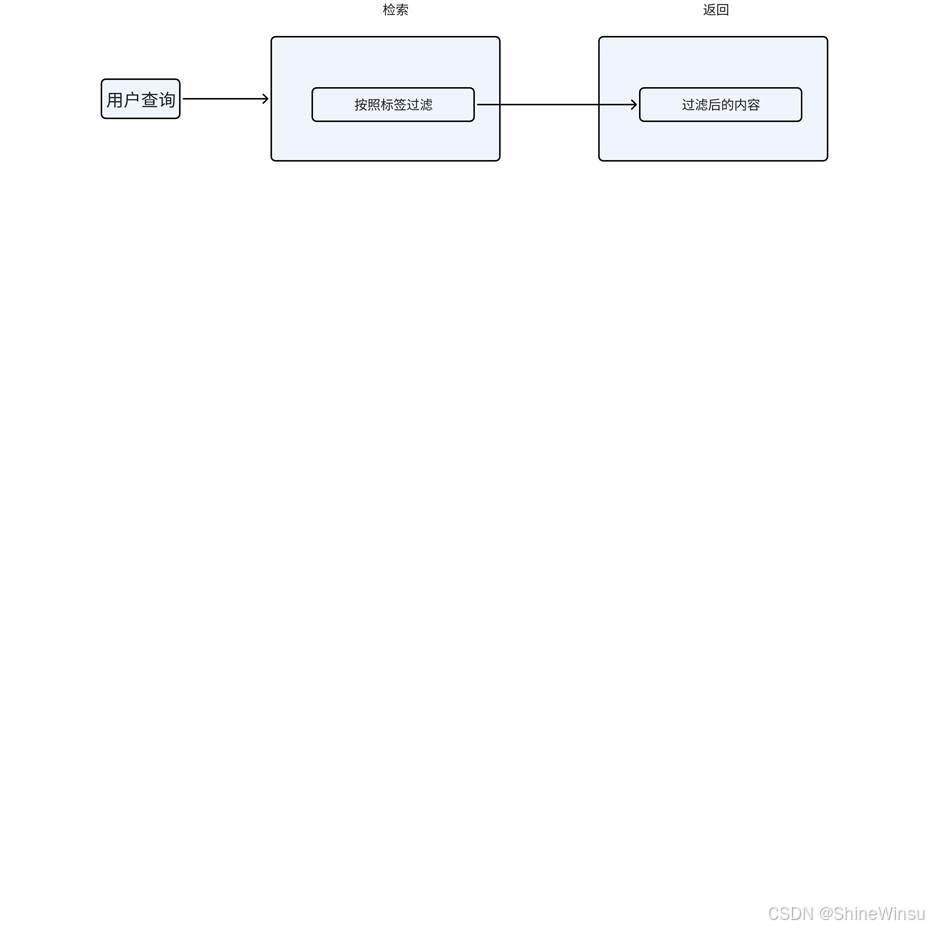
图 7 1.1.3 添加元数据
核心思想:在文本块上附加结构化的标签信息(元数据),检索时先用元数据过滤缩小范围,再进行语义匹配,从而提高检索的精准度和相关性。优势:极速缩小范围。可以直接排除掉90%不相关的干扰项。劣势:标注成本高,维护难。如果数据量大,给每个块打标签很累;标签打错了,就彻底搜不到了。示例:
图 8 1.1.3 添加元数据
你在大学图书馆想找"作者钱钟书写的围城"。
- 没有元数据:你只能全量搜索,几乎是一个灾难。
- 附加元数据:每本藏书自带分类标签:
◦图书分类:文学◦作者:钱钟书◦书名:围城
- 检索过程:图书馆系统先执行过滤器(Filter):只筛选「作者为钱钟书」且「书名是围城」的书
籍,藏书范围瞬间缩减到3本,精准找到目标图书。
1.1.3.1 与普通分块的区别
对比项
普通分块
元数据过滤检索
入库文本
切片正文
标签
结构化过滤
无
metadata精确匹配
返回内容
命中切片
书目卡片+位置信息
典型场景
通用文档
图书馆、商品目录、工单系统
1.1.3.2 数据准备
metadata_catalog.json
{ "book_id": "bk_001", "title": "Python编程:从入门到实践", "author": "埃里克·马瑟斯", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "零基础 Python 入门,涵盖变量、循环、函数、文件读写与小型项目实战,适合大一 计算机公共课参考。" }, { "book_id": "bk_002", "title": "流畅的Python", "author": "Luciano Ramalho", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "进阶 Python 读物,讲解数据模型、函数式特性、面向对象与元编程,适合有基础的 同学深入阅读。" }, { "book_id": "bk_003", "title": "Python网络爬虫从入门到精通", "author": "李明", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "借出", "text": "介绍 requests、BeautifulSoup、Scrapy 等爬虫技术,含反爬与数据清洗案例, 期末项目常用参考书。" }, { "book_id": "bk_004", "title": "数据结构与算法:Python语言描述", "author": "迈克尔·古德温", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "用 Python 讲解链表、栈、队列、树与图,配套leetcode风格习题,算法课实验常 用。" }, { "book_id": "bk_005", "title": "深度学习入门:基于Python的理论与实现", "author": "斋藤康毅", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "从感知机到 CNN、RNN,使用 NumPy 手写神经网络,人工智能选修课推荐书目。" }, { "book_id": "bk_006", "title": "Java核心技术 卷I", "author": "凯·霍斯特曼", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "Java 基础语法、集合框架与并发入门,程序设计类课程经典教材,与 Python 无直 接关系。" }, { "book_id": "bk_007", "title": "红楼梦", "author": "曹雪芹", "category": "文学", "floor": "二楼", "zone": "文学区", "status": "在馆", "text": "中国古典四大名著之一,人文学院中国古代文学课必读,馆藏精装本含脂评。" }, { "book_id": "bk_008", "title": "活着", "author": "余华", "category": "文学", "floor": "二楼", "zone": "文学区", "status": "在馆", "text": "当代文学代表作,讲述普通人命运起伏,现当代文学导读课推荐,借阅量常年靠前。" }, { "book_id": "bk_009", "title": "百年孤独", "author": "加西亚·马尔克斯", "category": "文学", "floor": "二楼", "zone": "文学区", "status": "借出", "text": "魔幻现实主义经典,外国文学专题常用,含人物关系图附录,适合论文写作引用。" }, { "book_id": "bk_010", "title": "中国通史", "author": "吕思勉", "category": "历史", "floor": "一楼", "zone": "社科区", "status": "在馆", "text": "通史类入门读物,梳理先秦至近代重大事件,中国史纲要课程参考书。" }, { "book_id": "bk_011", "title": "全球通史", "author": "斯塔夫里阿诺斯", "category": "历史", "floor": "一楼", "zone": "社科区", "status": "在馆", "text": "从文明起源到现代世界的全球视角通史,世界史导论课常用教材。" }, { "book_id": "bk_012", "title": "万历十五年", "author": "黄仁宇", "category": "历史", "floor": "一楼", "zone": "社科区", "status": "借出", "text": "以万历朝若干切片剖析明代政治运作,历史系讨论课高频借阅书目。" }, { "book_id": "bk_013", "title": "经济学原理", "author": "曼昆", "category": "经济", "floor": "一楼", "zone": "社科区", "status": "在馆", "text": "微观与宏观经济学入门,含供需、弹性、GDP 与货币政策,经管学院大一必修。" }, { "book_id": "bk_014", "title": "西方哲学史", "author": "罗素", "category": "哲学", "floor": "一楼", "zone": "社科区", "status": "在馆", "text": "从古希腊到近代哲学流派梳理,哲学导论课经典,含柏拉图、康德等章节。" }, { "book_id": "bk_015", "title": "Python数据分析实战", "author": "陈刚", "category": "计算机", "floor": "二楼", "zone": "文学区", "status": "在馆", "text": "pandas 与 matplotlib 入门,含 CSV 清洗与可视化案例;因临时盘点误架至二楼 文学区,实际属计算机类。" }, { "book_id": "bk_016", "title": "机器学习", "author": "周志华", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "借出", "text": "西瓜书,涵盖决策树、SVM、神经网络等,人工智能专业核心教材,当前全部借出。" }, { "book_id": "bk_017", "title": "围城", "author": "钱钟书", "category": "文学", "floor": "二楼", "zone": "文学区", "status": "在馆", "text": "现代文学讽刺小说代表作,现代文学史课程推荐,语言幽默适合休闲阅读。" }, { "book_id": "bk_018", "title": "算法导论", "author": "Cormen", "category": "计算机", "floor": "三楼", "zone": "理工区", "status": "在馆", "text": "CLRS 经典算法教材,分治、动态规划、图算法与复杂度分析,研究生与竞赛选手常 用。" }, { "book_id": "bk_019", "title": "人类简史", "author": "尤瓦尔·赫拉利", "category": "历史", "floor": "一楼", "zone": "社科区", "status": "在馆", "text": "从认知革命到科学革命的人类文明叙事,通识课热门借阅,非严格学术史著作。" }, { "book_id": "bk_020", "title": "三体", "author": "刘慈欣", "category": "文学", "floor": "二楼", "zone": "文学区", "status": "在馆", "text": "科幻长篇,含黑暗森林法则等设定,图书馆科幻主题书展推荐,兼涉物理与宇宙学概 念。" }
1.1.3.3 汇总metadata词汇表
1. 汇总数目中metadata字段的所有取值
def build_vocab(records : listdict) -> dictstr, set\[str]:
1. 初始化空字典,key是字段名 value当前字段出现过的所有取值的集合
vocab : dictstr, set\[str] = {}
2. 遍历结果
for record in records:
for key, value in record.items():
if key in SKIP_FILTER_KEYS:
continue
vocab.setdefault(key, set()).add(str(value))
3. 返回完整的取值集合映射
return vocab
函数说明:build_vocab()
|---------|-------------------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | dictstr, set\[str] | 返回当前处理步骤的结果对象或状态。 |
1.1.3.4 解析query过滤条件
2. 从用户输入的问题中,去解析出过滤条件
def filters_from_query(query: str, vocab: dictstr, set\[str]) -> dict:
1. 定义一个过滤条件变量
filters : dictstr, str = {}
2. 把词汇表平铺开,逐个与query进行对比
pairs = (key, val) for key, vals in vocab.items() for val in vals
pairs.sort(key=lambda item: len(item1), reverse=True)
for key, val in pairs:
if key not in filters and val in query:
filterskey = val
return filters
函数说明:filters_from_query()
|-------|-------------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| vocab | dictstr, set\[str] | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | dict | 返回当前处理步骤的结果对象或状态。 |
1.1.3.5 构建元数据节点
3. 把json数组转换成listTextNode
def build_nodes(records :listdict) -> listTextNode:
nodes : listTextNode = \[\]
for record in records:
meta = {key : value for key, value in record.items()}
search_text = f"{record'title'}"
nodes.append(
TextNode(
text=search_text,
id_ = record"book_id",
metadata=meta,
)
)
return nodes
函数说明:build_nodes()
|---------|------------------|-----------------------------|
| 参数 | 类型/默认值 | 作用 |
| records | listdict | 从 JSON/CSV 等数据源读取出的结构化记录列表。 |
| 返回值 | listTextNode | 返回当前处理步骤的结果对象或状态。 |
1.1.3.6 构建索引
4. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
1.1.3.7 内容检索
5. 拼装单条数目的命中结果
def format_hit(hit : NodeWithScore) -> str:
meta = hit.node.metadata
title = meta.get("title")
author = meta.get("author")
floor = meta.get("floor")
zone = meta.get("zone")
category = meta.get("category")
status = meta.get("status")
return (
f"- 《{title}》 {author}| {floor} {zone}| {category} | {status}"
f"相似度:{hit.score: .4f}"
)
6. 把过滤条件进行格式化
def format_filters(filters : dict) -> str:
if not filters:
return "无法识别出有效的过滤条件"
parts =\[\]
for key, value in filters.items():
label = FIELD_LABELS.get(key)
parts.append(f"{label}={value}")
return "、".join(parts)
7. 实现检索-需要加上过滤条件
def retrieve_hits(
query: str,
index: VectorStoreIndex,
filters: dict | None=None,
top_k: int=3
) -> listNodeWithScore:
metadata_filters = None
if filters:
metadata_filters = MetadataFilters(
filters=ExactMatchFilter(key=key, value=value) for key, value in
filters.items()
)
return index.as_retriever(similarity_top_k=top_k,
filters=metadata_filters).retrieve(query)
8 对外提供的检索
def retrieve(
query:str,
index:VectorStoreIndex,
vocab: dictstr, set\[str],
total: int,
top_k:int=3,
) -> str:
auto_filters = filters_from_query(query, vocab)
lines =
"【场景】 大学生再图书馆找书"
f"同学输入:{query}"
f"【解析出来的过滤条件】:{format_filters(auto_filters)}"
f"----(全库){total}本书,获取{top_k}本----"
f"----元数据过滤{format_filters(auto_filters)},语义top_k{top_k}----"
filtered = retrieve_hits(query, index, filters=auto_filters or None,
top_k=top_k)
lines.extend(format_hit(hit) for hit in filtered)
return "\n".join(lines)
函数说明:format_hit()
|-----|---------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| hit | NodeWithScore | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
函数说明:format_filters()
|---------|--------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| filters | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
函数说明:retrieve_hits()
|---------|-----------------------|------------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| index | VectorStoreIndex | 已经构建好的索引对象,用于执行检索。 |
| filters | dict | None;默认 None | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| top_k | int;默认 3 | 召回候选数量;值越大召回更广,但噪声和后处理成本也更高。 |
| 返回值 | listNodeWithScore | 返回当前处理步骤的结果对象或状态。 |
1.1.3.8 完整代码
元数据过滤检索
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode, NodeWithScore
from llama_index.core.vector_stores import MetadataFilters, ExactMatchFilter
import config
import util
数据集的目录
DATA_PATH = config.CHUNKING_DATA_PATH / "metadata_catalog.json"
统计一下哪些属性可以参与分类
FIELD_LABELS = {
"author" : "作者",
"category": "分类",
"floor": "楼层",
"zone": "区域",
"status":"借阅状态",
"title": "书籍名称"
}
统计一下哪些属性可以直接跳过
SKIP_FILTER_KEYS = {
"book_id", "text"
}
1. 汇总数目中metadata字段的所有取值
def build_vocab(records : listdict) -> dictstr, set\[str]:
1. 初始化空字典,key是字段名 value当前字段出现过的所有取值的集合
vocab : dictstr, set\[str] = {}
2. 遍历结果
for record in records:
for key, value in record.items():
if key in SKIP_FILTER_KEYS:
continue
vocab.setdefault(key, set()).add(str(value))
3. 返回完整的取值集合映射
return vocab
2. 从用户输入的问题中,去解析出过滤条件
def filters_from_query(query: str, vocab: dictstr, set\[str]) -> dict:
1. 定义一个过滤条件变量
filters : dictstr, str = {}
2. 把词汇表平铺开,逐个与query进行对比
pairs = (key, val) for key, vals in vocab.items() for val in vals
pairs.sort(key=lambda item: len(item1), reverse=True)
for key, val in pairs:
if key not in filters and val in query:
filterskey = val
return filters
3. 把json数组转换成listTextNode
def build_nodes(records :listdict) -> listTextNode:
nodes : listTextNode = \[\]
for record in records:
meta = {key : value for key, value in record.items()}
search_text = f"{record'title'}"
nodes.append(
TextNode(
text=search_text,
id_ = record"book_id",
metadata=meta,
)
)
return nodes
4. 构建索引
def build_index(nodes : listTextNode) -> VectorStoreIndex:
embed_model = util.get_embed_model()
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
5. 拼装单条数目的命中结果
def format_hit(hit : NodeWithScore) -> str:
meta = hit.node.metadata
title = meta.get("title")
author = meta.get("author")
floor = meta.get("floor")
zone = meta.get("zone")
category = meta.get("category")
status = meta.get("status")
return (
f"- 《{title}》 {author}| {floor} {zone}| {category} | {status}"
f"相似度:{hit.score: .4f}"
)
6. 把过滤条件进行格式化
def format_filters(filters : dict) -> str:
if not filters:
return "无法识别出有效的过滤条件"
parts =\[\]
for key, value in filters.items():
label = FIELD_LABELS.get(key)
parts.append(f"{label}={value}")
return "、".join(parts)
7. 实现检索-需要加上过滤条件
def retrieve_hits(
query: str,
index: VectorStoreIndex,
filters: dict | None=None,
top_k: int=3
) -> listNodeWithScore:
metadata_filters = None
if filters:
metadata_filters = MetadataFilters(
filters=ExactMatchFilter(key=key, value=value) for key, value in
filters.items()
)
return index.as_retriever(similarity_top_k=top_k,
filters=metadata_filters).retrieve(query)
8 对外提供的检索
def retrieve(
query:str,
index:VectorStoreIndex,
vocab: dictstr, set\[str],
total: int,
top_k:int=3,
) -> str:
auto_filters = filters_from_query(query, vocab)
lines =
"【场景】 大学生再图书馆找书"
f"同学输入:{query}"
f"【解析出来的过滤条件】:{format_filters(auto_filters)}"
f"----(全库){total}本书,获取{top_k}本----"
f"----元数据过滤{format_filters(auto_filters)},语义top_k{top_k}----"
filtered = retrieve_hits(query, index, filters=auto_filters or None,
top_k=top_k)
lines.extend(format_hit(hit) for hit in filtered)
return "\n".join(lines)
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
vocab = build_vocab(records)
2. json数组转换成node列表
nodes = build_nodes(records)
3. 建立向量索引
print("正在加载模型,请稍后...")
index = build_index(nodes)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, index, vocab, total=len(records)))
1.2 结构化管理
|----------------------------------------------------------------------------------------------|
| 原理解析: 当知识库规模扩大后,扁平向量库会越来越难管理。结构化管理的目标,是把"文档之间有什么层级、实体之间有什么关系"显式保存下来,让检索器可以先缩小范围,再进行精确匹配。 |
RAG结构化管理,是对原始文档、切片向量、元数据、知识库分区做标准化、分层、可约束的结构化组织方案,区别于无规则乱切、无标签、不分库的非结构化粗放存储。核心目标:解决传统RAG痛点------检索混杂、上下文错乱、权限混乱、更新困难、多文档冲突、召回冗余。
1.2.1 层级索引
|-------------------------------------------------------------------------------------------------------------------------|
| 原理解析: 层级索引适合天然存在目录树的知识:组织架构、商品类目、课程体系、产品手册、法规章节。它不是一次性在全库里找 Top-K,而是像导航一样逐层缩小范围。优点是可解释、易控;代价是层级设计和 metadata 维护必须稳定。 |
通过建立文档的父子节点层级结构,在每个节点上存储数据摘要,从而实现对文本块的快速定位与检索。
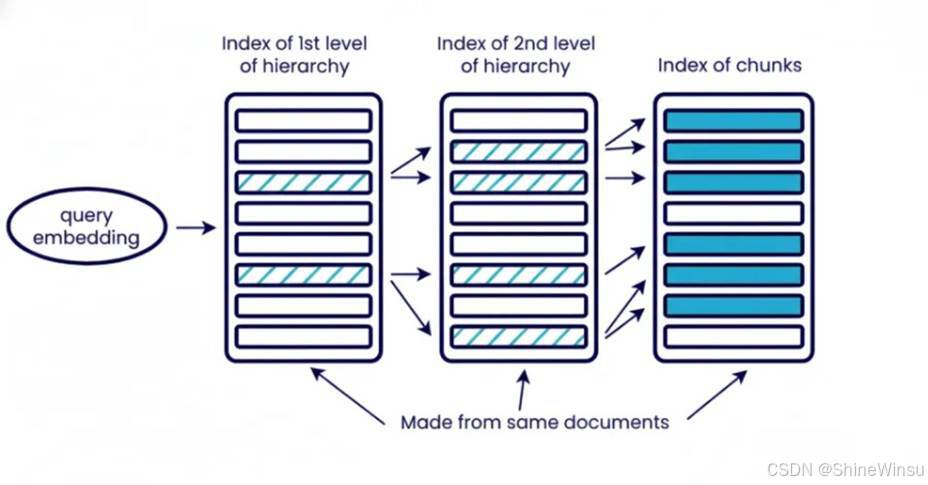
图 9 1.2.1 层级索引
核心思想:通过建立文档的父子节点层级结构,在每个节点上存储数据摘要,从而实现对文本块的快速定位与检索。层级索引采用先定位大类,再逐层缩小,最后精检叶子的策略:优势(Pros):
- 快准狠:通过层层过滤,能迅速排除掉无关紧要的"废话"分支。
劣势(Cons):
- 路径依赖:如果你的"目录"写得太烂,第一层就会迷路,导致根本找不到底层的正确答案。
示例:
图 10 1.2.1 层级索引
你周末和朋友去了一个大商场购物整个商场=全部知识库(原始文档)层级索引=商场多层级导览+分区目录用户提问=你要买一件商品检索过程=快速找到商品,不用逛完整栋商场第一层:顶层索引|商场整层导览牌(最高粗粒度)商场结构:商场一共5层,每层有一块巨型导览牌
- 1楼:美妆首饰
- 2楼:女装
- 3楼:男装运动
- 4楼:家电数码
- 5楼:餐饮影院
对应RAG:顶层大分块索引把海量文档按大类拆分,只存每一大类的简短摘要、主题标签,不存原文细节。作用:第一步快速过滤无关大类。第二层:中层索引|楼层内分区指示牌(中等粒度)锁定3楼男装运动后,楼层走廊有分区标牌:301区:篮球装备302区:跑步鞋服303区:户外登山304区:休闲男装对应RAG:段落级分块索引在大类文档内部,再拆分成更小主题块,存储每个段落块的向量。作用:缩小到精准主题片区,排除同楼层无关区域。第三层:底层细粒度索引|货架商品标签(最小粒度)进入302跑步专区,每个货架贴着标签:缓震跑鞋、竞速跑鞋、训练跑鞋,货架内才是一双双具体鞋子(原文细节)。对应RAG:句子/小节细粒度向量库片区内部拆分最小文本单元,保存完整细节向量,最终拿来做精准匹配、上下文生成。作用:精准定位你真正需要的细节内容。
1.2.1.1 与普通检索区别
对比项
普通检索
层级索引
索引数量
1个
多个(区域/专柜/商品)
缩小方式
无
逐层向量检索+metadata过滤
数据结构
扁平切片
树形JSON
典型场景
通用文档
商场导购、电商类目、组织架构
1.2.1.2 数据准备
字段
层级
含义
zone
楼层区域名称,写入区域节点 text
第一层
zone_desc
区域概述,与 zone 拼接后参与区域层 embedding
第一层
shelves
第一层
专柜合集
shelf
第二层
品类专柜名称
shelf_desc
第二层
专柜描述,与路径拼接后参与专柜层embedding
books
第三层
商品数组
title
第三层
商品名称,存入metadata用于展示
call_no
第三层
货号/位置编码,存入metadata
text
第三层
商品详情,写入商品节点text参与向量检索
levelIndexChunk.json
{ "zone": "B1 美食广场", "zone_desc": "中式快餐、西式简餐、奶茶甜品与休闲小食,适合逛街用餐与外卖自取", "shelves": \[ { "shelf": "中式快餐", "shelf_desc": "盖饭、面食、川湘菜快餐与地方特色小吃", "books": \[ { "title": "黄焖鸡米饭套餐", "call_no": "B1-F01-A01", "text": "B1 美食广场中式快餐:黄焖鸡米饭经典套餐,含米饭、配菜与例汤,出餐 快,适合单人午餐。" }, { "title": "重庆小面", "call_no": "B1-F01-A02", "text": "B1 美食广场中式快餐:重庆小面,麻辣鲜香,可选豌杂或牛肉浇头,适合 嗜辣顾客。" }, { "title": "广式烧腊双拼饭", "call_no": "B1-F01-A03", "text": "B1 美食广场中式快餐:烧鸭叉烧双拼饭,广式风味,附例汤,适合家庭简 餐。" }, { "title": "兰州牛肉拉面", "call_no": "B1-F01-A04", "text": "B1 美食广场中式快餐:正宗兰州拉面,清汤牛肉,可加煎蛋、萝卜,清淡 饱腹。" }, { "title": "剁椒鱼头单人套餐", "call_no": "B1-F01-A05", "text": "B1 美食广场中式快餐:剁椒鱼头配米饭,鲜辣入味,分量充足,爱吃湘菜 人群首选。" }
},
{
"shelf": "西式简餐",
"shelf_desc": "汉堡、披萨、意面与轻食沙拉",
"books":
{
"title": "经典牛肉汉堡套餐",
"call_no": "B1-F02-B01",
"text": "B1 美食广场西式简餐:经典牛肉汉堡套餐,含薯条与可乐,适合青少年与
上班族。"
},
{
"title": "玛格丽特披萨",
"call_no": "B1-F02-B02",
"text": "B1 美食广场西式简餐:9 寸玛格丽特披萨,芝士与番茄底,适合两人分
享。"
},
{
"title": "凯撒鸡肉沙拉",
"call_no": "B1-F02-B03",
"text": "B1 美食广场西式简餐:凯撒鸡肉沙拉,低油轻食,适合健身与控卡人群。"
},
{
"title": "黑椒牛柳意面",
"call_no": "B1-F02-B04",
"text": "B1 美食广场西式简餐:黑椒牛柳意面,酱汁浓郁,搭配烤面包片,单人正
餐优选。"
},
{
"title": "奥尔良烤翅小食桶",
"call_no": "B1-F02-B05",
"text": "B1 美食广场西式简餐:8只奥尔良烤翅桶,外焦里嫩,逛街休闲解馋小
食。"
}
},
{
"shelf": "奶茶甜品",
"shelf_desc": "新式茶饮、鲜榨果汁、蛋糕与冰淇淋",
"books":
{
"title": "珍珠奶茶大杯",
"call_no": "B1-F03-C01",
"text": "B1 美食广场奶茶甜品:招牌珍珠奶茶大杯,可选少糖去冰,逛街解渴首
选。"
},
{
"title": "杨枝甘露",
"call_no": "B1-F03-C02",
"text": "B1 美食广场奶茶甜品:杨枝甘露,芒果西柚椰奶,夏季人气甜品。"
},
{
"title": "草莓千层蛋糕",
"call_no": "B1-F03-C03",
"text": "B1 美食广场奶茶甜品:草莓千层切片蛋糕,适合下午茶与生日小聚。"
},
{
"title": "鲜榨橙汁",
"call_no": "B1-F03-C04",
"text": "B1 美食广场奶茶甜品:100%鲜榨橙汁无添加,补充维C,老人小孩均可饮
用。"
},
{
"title": "海盐芝士冰淇淋",
"call_no": "B1-F03-C05",
"text": "B1 美食广场奶茶甜品:海盐芝士单球冰淇淋,咸甜口感,解暑冰品。"
}
},
{
"shelf": "地方特色小吃",
"shelf_desc": "关东煮、炸串、馄饨、生煎等街边特色小吃",
"books":
{
"title": "鲜肉生煎包4个装",
"call_no": "B1-F04-D01",
"text": "B1 美食广场地方特色小吃:上海鲜肉生煎,皮薄爆汁,搭配醋汁食用风味
更佳。"
},
{
"title": "关东煮全家福套餐",
"call_no": "B1-F04-D02",
"text": "B1 美食广场地方特色小吃:萝卜、鱼豆腐、福袋、丸子组合关东煮,热汤
暖胃。"
},
{
"title": "荠菜鲜肉大馄饨",
"call_no": "B1-F04-D03",
"text": "B1 美食广场地方特色小吃:手工荠菜馄饨,汤底鲜香,清淡易消化。"
}
}
]
},
{
"zone": "1F 时尚服饰",
"zone_desc": "运动户外、男女装、鞋包配饰与潮流品牌,面向日常穿搭与换季采购",
"shelves":
{
"shelf": "运动品牌",
"shelf_desc": "跑步鞋、篮球鞋、运动服与健身装备",
"books": \[
{
"title": "Nike Air Zoom 跑步鞋",
"call_no": "1F-S01-D01",
"text": "1F 时尚服饰运动品牌:Nike Air Zoom 缓震跑步鞋,适合日常慢跑与健
身房训练。"
},
{
"title": "Adidas 三叶草休闲卫衣",
"call_no": "1F-S01-D02",
"text": "1F 时尚服饰运动品牌:Adidas 三叶草连帽卫衣,经典版型,春秋百搭。"
},
{
"title": "李宁超轻跑鞋",
"call_no": "1F-S01-D03",
"text": "1F 时尚服饰运动品牌:李宁超轻系列跑鞋,透气网面,适合长距离跑步。"
},
{
"title": "Under Armour 训练短裤",
"call_no": "1F-S01-D04",
"text": "1F 时尚服饰运动品牌:Under Armour 速干训练短裤,吸汗透气,适合
HIIT 与力量训练。"
},
{
"title": "乔丹高帮篮球鞋",
"call_no": "1F-S01-D05",
"text": "1F 时尚服饰运动品牌:高帮实战篮球鞋,护脚踝,耐磨橡胶底,室内外球
场通用。"
},
{
"title": "安踏速干运动T恤",
"call_no": "1F-S01-D06",
"text": "1F 时尚服饰运动品牌:冰丝速干短袖,透气不粘身,夏季运动专用。"
}
},
{
"shelf": "女装精选",
"shelf_desc": "连衣裙、针织、大衣与职场通勤装",
"books":
{
"title": "法式碎花连衣裙",
"call_no": "1F-S02-E01",
"text": "1F 时尚服饰女装精选:法式碎花连衣裙,收腰 A 字版型,适合约会与度
假。"
},
{
"title": "羊毛双面呢大衣",
"call_no": "1F-S02-E02",
"text": "1F 时尚服饰女装精选:中长款羊毛双面呢大衣,秋冬保暖,适合通勤与聚
会。"
},
{
"title": "真丝衬衫",
"call_no": "1F-S02-E03",
"text": "1F 时尚服饰女装精选:真丝衬衫,垂坠感好,适合办公室与正式场合。"
},
{
"title": "软糯针织开衫",
"call_no": "1F-S02-E04",
"text": "1F 时尚服饰女装精选:薄款羊毛针织开衫,空调房保暖,多色百搭内搭外
穿均可。"
},
{
"title": "高腰垂感西装阔腿裤",
"call_no": "1F-S02-E05",
"text": "1F 时尚服饰女装精选:垂感西装阔腿裤,藏肉显瘦,搭配衬衫西装打造通
勤穿搭。"
}
},
{
"shelf": "男装商务",
"shelf_desc": "西装、衬衫、休闲裤与商务皮鞋",
"books": [
{
"title": "修身商务西装套装",
"call_no": "1F-S03-F01",
"text": "1F 时尚服饰男装商务:深灰修身西装两件套,适合面试、婚礼与商务会
议。"
},
{
"title": "免烫长袖衬衫",
"call_no": "1F-S03-F02",
"text": "1F 时尚服饰男装商务:免烫长袖衬衫,抗皱易打理,上班族常备。"
},
{
"title": "头层牛皮德比鞋",
"call_no": "1F-S03-F03",
"text": "1F 时尚服饰男装商务:头层牛皮德比鞋,经典黑色,搭配西裤与休闲裤均
可。"
},
{
"title": "弹力商务休闲西裤",
"call_no": "1F-S03-F04",
"text": "1F 时尚服饰男装商务:高弹力西裤,久坐不紧绷,日常通勤商务两用。"
},
{
"title": "纯色羊毛针织毛衣",
"call_no": "1F-S03-F05",
"text": "1F 时尚服饰男装商务:圆领纯色羊毛
衣,内搭衬衫,秋冬商务穿搭打
底。"
}
]
},
{
"shelf": "鞋包配饰",
"shelf_desc": "单肩包、双肩包、帆布鞋、皮鞋、丝巾、帽子腰带",
"books":
{
"title": "大容量通勤托特包",
"call_no": "1F-S04-G01",
"text": "1F 时尚服饰鞋包配饰:皮质托特包,可容纳14寸电脑,职场女性通勤必
备。"
},
{
"title": "复古帆布小白鞋",
"call_no": "1F-S04-G02",
"text": "1F 时尚服饰鞋包配饰:基础款小白帆布鞋,搭配裙装裤装都适配。"
},
{
"title": "皮质自动扣男士腰带",
"call_no": "1F-S04-G03",
"text": "1F 时尚服饰鞋包配饰:头层牛皮商务腰带,自动扣设计,适配各类西裤。"
}
}
]
},
{
"zone": "2F 生活百货",
"zone_desc": "美妆护肤、母婴亲子、家居收纳与数码配件,覆盖家庭日常消费",
"shelves":
{
"shelf": "美妆护肤",
"shelf_desc": "面部护理、彩妆、香水与男士理容",
"books": \[
{
"title": "兰蔻小黑瓶精华",
"call_no": "2F-L01-G01",
"text": "2F 生活百货美妆护肤:兰蔻小黑瓶肌底精华,修护维稳,适合初抗老人
群。"
},
{
"title": "雅诗兰黛持妆粉底液",
"call_no": "2F-L01-G02",
"text": "2F 生活百货美妆护肤:雅诗兰黛持妆粉底液,遮瑕持久,适合油性与混合
肌。"
},
{
"title": "MAC 子弹头口红",
"call_no": "2F-L01-G03",
"text": "2F 生活百货美妆护肤:MAC 子弹头口红经典色号,显色度高,礼盒装适合
送礼。"
},
{
"title": "科颜氏高保湿面霜",
"call_no": "2F-L01-G04",
"text": "2F 生活百货美妆护肤:高保湿修护面霜,干皮秋冬补水,缓解起皮泛红。"
},
{
"title": "男士控油爽肤水",
"call_no": "2F-L01-G05",
"text": "2F 生活百货美妆护肤:清爽控油男士爽肤水,收缩毛孔,改善出油痘痘
肌。"
}
},
{
"shelf": "母婴亲子",
"shelf_desc": "婴儿奶粉、纸尿裤、童装与益智玩具",
"books":
{
"title": "进口婴儿配方奶粉 3 段",
"call_no": "2F-L02-H01",
"text": "2F 生活百货母婴亲子:进口婴儿配方奶粉 3 段,适合 12-36 月龄,需咨
询导购。"
},
{
"title": "超薄透气纸尿裤 L 码",
"call_no": "2F-L02-H02",
"text": "2F 生活百货母婴亲子:超薄透气纸尿裤 L 码整箱装,柔软防漏,新生儿家
庭常备。"
},
{
"title": "乐高城市系列积木",
"call_no": "2F-L02-H03",
"text": "2F 生活百货母婴亲子:乐高城市系列积木,培养动手能力,适合 6 岁以上
儿童。"
},
{
"title": "婴儿纯棉连体睡衣",
"call_no": "2F-L02-H04",
"text": "2F 生活百货母婴亲子:A类纯棉婴儿爬服,无骨缝制,柔软亲肤,四季可
穿。"
},
{
"title": "儿童平衡滑步车",
"call_no": "2F-L02-H05",
"text": "2F 生活百货母婴亲子:无脚踏平衡车,锻炼幼儿平衡感,2-5岁儿童适
用。"
}
},
{
"shelf": "家居数码",
"shelf_desc": "厨房小电、收纳用品、手机配件与智能穿戴",
"books":
{
"title": "空气炸锅 4.5L",
"call_no": "2F-L03-I01",
"text": "2F 生活百货家居数码:4.5L 空气炸锅,少油健康,适合炸鸡翅、薯条与
复热。"
},
{
"title": "透明收纳箱三件套",
"call_no": "2F-L03-I02",
"text": "2F 生活百货家居数码:透明收纳箱三件套,可叠放,适合衣柜与换季储
物。"
},
{
"title": "MagSafe 磁吸手机壳",
"call_no": "2F-L03-I03",
"text": "2F 生活百货家居数码:MagSafe 磁吸手机壳,支持无线充电,多色可
选。"
},
{
"title": "Apple Watch 运动表带",
"call_no": "2F-L03-I04",
"text": "2F 生活百货家居数码:Apple Watch 硅胶运动表带,透气防汗,适合跑
步与游泳。"
},
{
"title": "小型多功能破壁机",
"call_no": "2F-L03-I05",
"text": "2F 生活百货家居数码:迷你破壁机,打豆浆、米糊、果汁,单人独居适
用。"
},
{
"title": "桌面理线收纳盒",
"call_no": "2F-L03-I06",
"text": "2F 生活百货家居数码:数据线充电器收纳盒,整理桌面杂乱线材。"
}
},
{
"shelf": "清洁日用品",
"shelf_desc": "洗衣液、抹布、吸尘器配件、卫浴清洁用品",
"books":
{
"title": "持久留香酵素洗衣液",
"call_no": "2F-L04-J01",
"text": "2F 生活百货清洁日用品:酵素去污洗衣液,去除油渍汗渍,衣物留香持
久。"
},
{
"title": "一次性加厚懒人抹布",
"call_no": "2F-L04-J02",
"text": "2F 生活百货清洁日用品:干湿两用懒人抹布,厨房擦油污、餐桌清洁专
用。"
},
{
"title": "玻璃去污清洁喷雾",
"call_no": "2F-L04-J03",
"text": "2F 生活百货清洁日用品:无痕玻璃清洁剂,擦窗户、镜子不留水痕。"
}
}
]
},
{
"zone": "3F 游乐影院",
"zone_desc": "电影院、电玩游乐厅、动漫手办、儿童乐园,休闲娱乐专区,适合朋友结伴、亲
子游玩",
"shelves":
{
"shelf": "影院票务套餐",
"shelf_desc": "电影单人票、双人观影套票、爆米花可乐小吃组合",
"books": \[
{
"title": "2D单人通用电影票",
"call_no": "3F-Y01-K01",
"text": "3F 游乐影院影院票务套餐:全时段2D电影通兑票,节假日通用,不限场
次。"
},
{
"title": "双人观影情侣套票",
"call_no": "3F-Y01-K02",
"text": "3F 游乐影院影院票务套餐:两张3D电影票+大桶爆米花+两杯可乐,情侣约
会优选。"
},
{
"title": "超大桶焦糖爆米花",
"call_no": "3F-Y01-K03",
"text": "3F 游乐影院影院票务套餐:影院经典焦糖爆米花,酥脆香甜,观影标配零
食。"
}
},
{
"shelf": "电玩游乐设备",
"shelf_desc": "抓娃娃机、赛车模拟机、投篮机、跳舞机游戏币套餐",
"books":
{
"title": "50枚电玩游戏币套餐",
"call_no": "3F-Y02-L01",
"text": "3F 游乐影院电玩游乐设备:50枚通用游戏币,全厅赛车、抓娃娃、投篮机
均可使用。"
},
{
"title": "大型毛绒抓娃娃兑换券",
"call_no": "3F-Y02-L02",
"text": "3F 游乐影院电玩游乐设备:兑换券可直接换取大号公仔,无需多次抓取。"
},
{
"title": "竞速赛车模拟体验卡",
"call_no": "3F-Y02-L03",
"text": "3F 游乐影院电玩游乐设备:专业赛车游戏机单次畅玩卡,仿真方向盘与油
门踏板。"
}
},
{
"shelf": "动漫手办周边",
"shelf_desc": "二次元手办、动漫海报、钥匙扣、卡通盲盒",
"books":
{
"title": "热门动漫角色手办",
"call_no": "3F-Y03-M01",
"text": "3F 游乐影院动漫手办周边:1/7比例高精度动漫人物手办,礼盒包装适合收
藏送礼。"
},
{
"title": "卡通人物盲盒单盒",
"call_no": "3F-Y03-M02",
"text": "3F 游乐影院动漫手办周边:系列卡通盲盒,随机款式,潮流年轻人收藏好
物。"
},
{
"title": "动漫烫金海报套装",
"call_no": "3F-Y03-M03",
"text": "3F 游乐影院动漫手办周边:高清覆膜动漫海报,可贴墙面装饰,一套含6张
不同角色。"
}
}
]
}
]
1.2.1.3 构建层级节点
1. 把json树形结构转换成三层节点列表
def build_nodes(tree : listdict) -> tuplelist\[TextNode, listTextNode,
listTextNode]:
1. 第一层
zones : listTextNode = \[\]
2. 第二层 专柜
shelves: listTextNode = \[\]
3. 第三层 具体的商品列表
leaves: listTextNode = \[\]
楼层
for zi, zone in enumerate(tree):
zone_id = f"z{zi}"
zones.append(
TextNode(
text=f"{zone'zone'}:{zone'zone_desc'}",
id_ = zone_id,
metadata={
"zone_id":zone_id,
"zone":zone"zone"
}
)
)
专柜层
for si, shelf in enumerate(zone"shelves"):
shelf_id = f"{zone_id}s{si}"
shelves.append(
TextNode(
text=f"{zone'zone'}/{shelf'shelf'}:
{shelf'shelf_desc'}",
id=shelf_id,
metadata={
"zone_id": zone_id,
"shelf_id": shelf_id,
"shelf": shelf"shelf"
}
)
)
商品层
for bi, item in enumerate(shelf"books"):
leaves.append(
TextNode(
text=item"text",
id_=f"{shelf_id}_b{bi}",
metadata = {
"shelf_id": shelf_id,
"title": item"title",
"call_no": item"call_no"
}
)
)
return zones, shelves, leaves
1.2.1.4 构建层级索引
对三组节点各建一个VectorStoreIndex ,共用同一个embed_model :
2. 构建三层向量索引
def build_indexes(tree : listdict) ->tupleVectorStoreIndex,
VectorStoreIndex, VectorStoreIndex:
embed_model = util.get_embed_model()
zones, shelves, leaves = build_nodes(tree)
def _make_index(nodes : listTextNode) ->VectorStoreIndex:
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
return _make_index(zones), _make_index(shelves), _make_index(leaves)
函数说明:build_indexes()
|------|---------------------------------------------------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| tree | listdict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | tupleVectorStoreIndex, VectorStoreIndex, VectorStoreIndex | 返回当前处理步骤的结果对象或状态。 |
函数说明:_make_index()
|-------|------------------|---------------------------------------|
| 参数 | 类型/默认值 | 作用 |
| nodes | listTextNode | LlamaIndex 节点列表,通常包含 text 与 metadata。 |
| 返回值 | VectorStoreIndex | 返回当前处理步骤的结果对象或状态。 |
1.2.1.5 内容检索
3. 执行三层检索
def retrieve_hits(
query:str,
zone_index: VectorStoreIndex,
shelf_index: VectorStoreIndex,
leaf_index: VectorStoreIndex,
shelf_top_k: int =2,
leaf_top_k: int =3,
) -> tupleNodeWithScore, list\[NodeWithScore, listNodeWithScore]:
1. 查出来的楼层
zone_hit = zone_index.as_retriever(similarity_top_k=1).retrieve(query)0
zone_id = zone_hit.node.metadata"zone_id"
2. 构造专柜查询的过滤条件
zone_filter = MetadataFilters(
filters=MetadataFilter(key="zone_id", value=zone_id,
operator=FilterOperator.EQ)
)
3. 查询专柜
shelf_hits = shelf_index.as_retriever(similarity_top_k=shelf_top_k,
filters=zone_filter).retrieve(query)
shelf_ids = hit.node.metadata\["shelf_id" for hit in shelf_hits]
4. 构造查询商品的过滤条件
shelf_filter = MetadataFilters(
filters=MetadataFilter(key="shelf_id", value=shelf_ids,
operator=FilterOperator.IN)
)
5. 商品层元数据
leaf_hits = leaf_index.as_retriever(similarity_top_k=leaf_top_k,
filters=shelf_filter).retrieve(query)
return zone_hit, shelf_hits, leaf_hits
1.2.1.6 完整代码
实现层级索引检索 分3层: 楼层->专柜->商品
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode, NodeWithScore
from llama_index.core.vector_stores import MetadataFilters, MetadataFilter,
FilterOperator
import config
import util
DATA_PATH = config.CHUNKING_DATA_PATH / "levelIndexChunk.json"
1. 把json树形结构转换成三层节点列表
def build_nodes(tree : listdict) -> tuplelist\[TextNode, listTextNode,
listTextNode]:
1. 第一层
zones : listTextNode = \[\]
2. 第二层 专柜
shelves: listTextNode = \[\]
3. 第三层 具体的商品列表
leaves: listTextNode = \[\]
楼层
for zi, zone in enumerate(tree):
zone_id = f"z{zi}"
zones.append(
TextNode(
text=f"{zone'zone'}:{zone'zone_desc'}",
id_ = zone_id,
metadata={
"zone_id":zone_id,
"zone":zone"zone"
}
)
)
专柜层
for si, shelf in enumerate(zone"shelves"):
shelf_id = f"{zone_id}s{si}"
shelves.append(
TextNode(
text=f"{zone'zone'}/{shelf'shelf'}:
{shelf'shelf_desc'}",
id=shelf_id,
metadata={
"zone_id": zone_id,
"shelf_id": shelf_id,
"shelf": shelf"shelf"
}
)
)
商品层
for bi, item in enumerate(shelf"books"):
leaves.append(
TextNode(
text=item"text",
id_=f"{shelf_id}_b{bi}",
metadata = {
"shelf_id": shelf_id,
"title": item"title",
"call_no": item"call_no"
}
)
)
return zones, shelves, leaves
2. 构建三层向量索引
def build_indexes(tree : listdict) ->tupleVectorStoreIndex,
VectorStoreIndex, VectorStoreIndex:
embed_model = util.get_embed_model()
zones, shelves, leaves = build_nodes(tree)
def _make_index(nodes : listTextNode) ->VectorStoreIndex:
return VectorStoreIndex(nodes=nodes, embed_model=embed_model)
return _make_index(zones), _make_index(shelves), _make_index(leaves)
3. 执行三层检索
def retrieve_hits(
query:str,
zone_index: VectorStoreIndex,
shelf_index: VectorStoreIndex,
leaf_index: VectorStoreIndex,
shelf_top_k: int =2,
leaf_top_k: int =3,
) -> tupleNodeWithScore, list\[NodeWithScore, listNodeWithScore]:
1. 查出来的楼层
zone_hit = zone_index.as_retriever(similarity_top_k=1).retrieve(query)0
zone_id = zone_hit.node.metadata"zone_id"
2. 构造专柜查询的过滤条件
zone_filter = MetadataFilters(
filters=MetadataFilter(key="zone_id", value=zone_id,
operator=FilterOperator.EQ)
)
3. 查询专柜
shelf_hits = shelf_index.as_retriever(similarity_top_k=shelf_top_k,
filters=zone_filter).retrieve(query)
shelf_ids = hit.node.metadata\["shelf_id" for hit in shelf_hits]
4. 构造查询商品的过滤条件
shelf_filter = MetadataFilters(
filters=MetadataFilter(key="shelf_id", value=shelf_ids,
operator=FilterOperator.IN)
)
5. 商品层元数据
leaf_hits = leaf_index.as_retriever(similarity_top_k=leaf_top_k,
filters=shelf_filter).retrieve(query)
return zone_hit, shelf_hits, leaf_hits
4. 把查询到的商品元数据格式化输出
def format_leaf_hit(hit:NodeWithScore) -> str:
metadata = hit.node.metadata
return (
f"- {metadata'title'} | 货号:{metadata'call_no'}"
f"| {hit.node.text} 相似度:{hit.score:.4f}"
)
5. 对外提供的检索方法
def retrieve(
query:str,
zone_index: VectorStoreIndex,
shelf_index: VectorStoreIndex,
leaf_index: VectorStoreIndex,
shelf_top_k: int =2,
leaf_top_k: int =3,
) -> str:
zone_hit, shelf_hits, leaf_hits= retrieve_hits(
query,
zone_index,
shelf_index,
leaf_index,
shelf_top_k=shelf_top_k,
leaf_top_k=leaf_top_k,
)
lines =
"【场景】 大型商场购物导购",
f"顾客输入:{query}",
f"①楼层区域:{zone_hit.node.metadata\['zone'} (相似度:
{zone_hit.score:.4f})",
"②专柜区域:"
- "、".join(
f"{hit.node.metadata'shelf'} (相似度:{hit.score:.4f})" for hit in
shelf_hits
),
f"-- 推荐商品 {leaf_top_k} --",
]
lines.extend(format_leaf_hit(hit) for hit in leaf_hits)
if not leaf_hits:
lines.append("未找到相关商品")
return "\n".join(lines)
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
2. 建立向量索引
print("正在加载模型,请稍后...")
zone_index, shelf_index, leaf_index = build_indexes(records)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, zone_index, shelf_index, leaf_index))
函数说明:format_leaf_hit()
|-----|---------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| hit | NodeWithScore | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
1.2.2 知识图谱
|-----------------------------------------------------------------------------------------------------------------|
| 原理解析: 知识图谱把"文本块"提升为"实体 + 关系"。向量检索擅长找语义相似,图检索擅长找关系链路;两者结合后,可以先用向量选中相关知识域,再用 BFS 等图遍历补齐实体关系,适合多跳问答和关联关系很强的场景。 |
核心思想:知识图谱是"关系网"。它不再关注文档在书里的第几页,而是关注"谁和谁有什么关系"。它把文档里的实体(人名、定理、地点)提取出来,用线连在一起,形成一个图状的知识结构。示例:
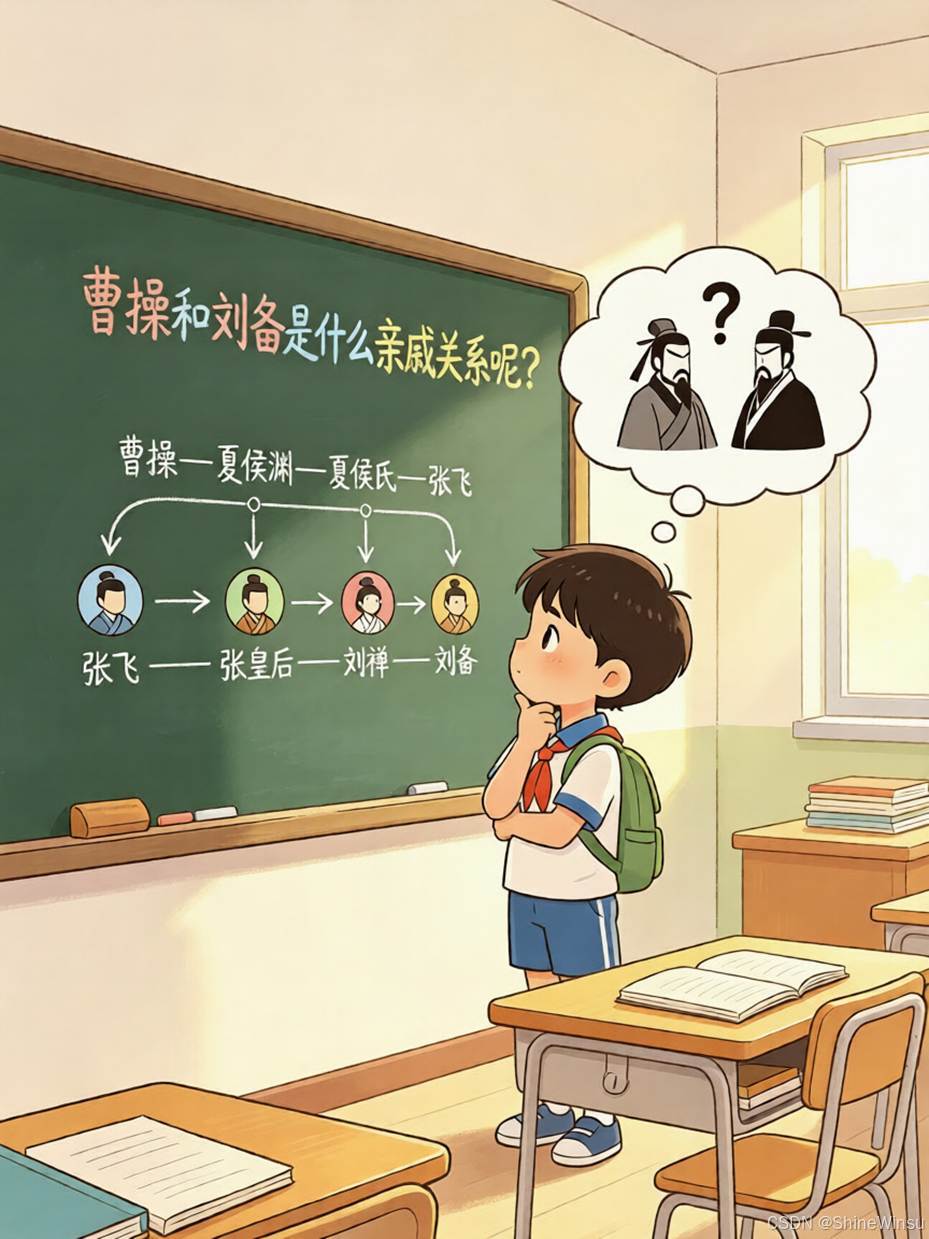
图 11 1.2.2 知识图谱
普通RAG:曹操和刘备是什么亲戚关系?。KG组织:你的脑子里有一张网
视图
曹魏集团
联姻纽带
蜀汉集团
族兄弟
夏侯渊
堂叔侄
夏侯氏
夫妻
张飞
父女
张皇后
夫妻
刘禅
父子
曹操
刘备
间接亲家
应用:当用户询问"曹操和刘备是什么亲戚关系?"时,AI不需要去翻所有章节,而是直接沿着图上的线(路径)就能秒回。优势(Pros):
- 逻辑推理:能回答跨文档、跨章节的复杂问题。
- 极低幻觉:关系是写死的,AI很难乱编。
劣势(Cons):
- 成本极高:像要把一整本课本里所有的关系都理出来,需要耗费大量算力或人工。
- 扩展性差:增加一个新知识点,可能要牵动整张网。
1.2.2.1 与普通索引的区别
对比项
普通分块
知识图谱
数据结构
扁平切片
entities+relations三元组
索引类型
VectorStoreIndex
PropertyGraphIndex
检索方式
向量Top-K
选域+BFS走路径+Graph+Vector
典型场景
通用文档
人物关系
1.2.2.2 数据准备
knowledgeGraphChunk.json
{ "id": "sanguo", "title": "三国演义", "scope": "东汉末年至三国归晋;刘备、关羽、张飞、曹操、诸葛亮、孙权等人物关系,以及桃 园结义、过五关斩六将、赤壁之战、三顾茅庐、夷陵之战等经典桥段", "entities": \[ {"name": "刘备"}, {"name": "关羽"}, {"name": "张飞"}, {"name": "曹操"}, {"name": "诸葛亮"}, {"name": "孙权"} \], "relations": \[ {"source": "刘备", "label": "结拜", "target": "关羽"}, {"source": "刘备", "label": "结拜", "target": "张飞"}, {"source": "刘备", "label": "二弟", "target": "关羽"}, {"source": "刘备", "label": "三弟", "target": "张飞"}, {"source": "关羽", "label": "过五关斩六将", "target": "曹操"}, {"source": "曹操", "label": "爱惜人才", "target": "关羽"}, {"source": "刘备", "label": "三顾茅庐", "target": "诸葛亮"}
},
{
"id": "science",
"title": "近代科学史",
"scope": "经典物理与相对论;牛顿、爱因斯坦、伽利略、开普勒、麦克斯韦、法拉第等人的发
现、师承关系与理论演进",
"entities":
{"name": "牛顿"},
{"name": "爱因斯坦"},
{"name": "伽利略"},
{"name": "开普勒"},
{"name": "麦克斯韦"},
{"name": "法拉第"},
{"name": "万有引力定律"},
{"name": "狭义相对论"},
{"name": "广义相对论"},
{"name": "微积分"},
{"name": "电磁理论"},
{"name": "运动三定律"}
,
"relations":
{"source": "牛顿", "label": "发现", "target": "万有引力定律"},
{"source": "牛顿", "label": "提出", "target": "运动三定律"},
{"source": "牛顿", "label": "发明", "target": "微积分"},
{"source": "伽利略", "label": "影响", "target": "牛顿"},
{"source": "开普勒", "label": "影响", "target": "牛顿"},
{"source": "爱因斯坦", "label": "提出", "target": "狭义相对论"},
{"source": "爱因斯坦", "label": "提出", "target": "广义相对论"},
{"source": "狭义相对论", "label": "发展自", "target": "万有引力定律"},
{"source": "广义相对论", "label": "推广", "target": "狭义相对论"},
{"source": "爱因斯坦", "label": "继承发展", "target": "牛顿"},
{"source": "法拉第", "label": "奠基", "target": "电磁理论"},
{"source": "麦克斯韦", "label": "建立", "target": "电磁理论"},
{"source": "麦克斯韦", "label": "影响", "target": "爱因斯坦"},
{"source": "伽利略", "label": "开创", "target": "运动三定律"}
},
{
"id": "zhenguan",
"title": "贞观之治",
"scope": "唐太宗李世民贞观年间治国;魏征谏言、房谋杜断、凌烟阁二十四功臣、贞观政要与
开元盛世前奏",
"entities":
{"name": "李世民"},
{"name": "魏征"},
{"name": "房玄龄"},
{"name": "杜如晦"},
{"name": "长孙皇后"},
{"name": "凌烟阁"},
{"name": "贞观之治"},
{"name": "玄武门之变"},
{"name": "李靖"},
{"name": "褚遂良"}
,
"relations":
{"source": "魏征", "label": "直言进谏", "target": "李世民"},
{"source": "房玄龄", "label": "辅佐", "target": "李世民"},
{"source": "杜如晦", "label": "辅佐", "target": "李世民"},
{"source": "房玄龄", "label": "搭档", "target": "杜如晦"},
{"source": "长孙皇后", "label": "劝谏", "target": "李世民"},
{"source": "李世民", "label": "设立", "target": "凌烟阁"},
{"source": "魏征", "label": "名列", "target": "凌烟阁"},
{"source": "李靖", "label": "名列", "target": "凌烟阁"},
{"source": "李世民", "label": "开创", "target": "贞观之治"},
{"source": "魏征", "label": "参与", "target": "贞观之治"},
{"source": "李世民", "label": "发动", "target": "玄武门之变"},
{"source": "褚遂良", "label": "侍书", "target": "李世民"}
},
{
"id": "hongloumeng",
"title": "红楼梦",
"scope": "贾宝玉、林黛玉、薛宝钗、王熙凤、贾母等贾府人物关系,以及大观园、木石前盟、
金玉良缘等核心线索",
"entities":
{"name": "贾宝玉"},
{"name": "林黛玉"},
{"name": "薛宝钗"},
{"name": "王熙凤"},
{"name": "贾母"},
{"name": "贾政"},
{"name": "大观园"},
{"name": "金陵十二钗"},
{"name": "袭人"},
{"name": "晴雯"}
,
"relations":
{"source": "贾宝玉", "label": "爱慕", "target": "林黛玉"},
{"source": "贾宝玉", "label": "金玉良缘", "target": "薛宝钗"},
{"source": "林黛玉", "label": "寄居", "target": "贾母"},
{"source": "薛宝钗", "label": "寄居", "target": "贾母"},
{"source": "王熙凤", "label": "协理", "target": "贾母"},
{"source": "贾政", "label": "父子", "target": "贾宝玉"},
{"source": "贾宝玉", "label": "居住", "target": "大观园"},
{"source": "林黛玉", "label": "居住", "target": "大观园"},
{"source": "薛宝钗", "label": "居住", "target": "大观园"},
{"source": "袭人", "label": "服侍", "target": "贾宝玉"},
{"source": "晴雯", "label": "服侍", "target": "贾宝玉"},
{"source": "王熙凤", "label": "列入", "target": "金陵十二钗"},
{"source": "林黛玉", "label": "列入", "target": "金陵十二钗"},
{"source": "王熙凤", "label": "管理", "target": "大观园"}
},
{
"id": "revolution",
"title": "辛亥革命",
"scope": "1894---1912 资产阶级民主革命;孙中山、黄兴、武昌起义、同盟会、中华民国临时
政府与清帝退位",
"entities":
{"name": "孙中山"},
{"name": "黄兴"},
{"name": "武昌起义"},
{"name": "同盟会"},
{"name": "袁世凯"},
{"name": "中华民国"},
{"name": "光绪帝"},
{"name": "慈禧太后"},
{"name": "黄花岗起义"},
{"name": "清帝退位"}
,
"relations":
{"source": "孙中山", "label": "创立", "target": "同盟会"},
{"source": "黄兴", "label": "参与", "target": "同盟会"},
{"source": "同盟会", "label": "发动", "target": "武昌起义"},
{"source": "武昌起义", "label": "推动", "target": "中华民国"},
{"source": "孙中山", "label": "就任临时大总统", "target": "中华民国"},
{"source": "黄兴", "label": "领导", "target": "黄花岗起义"},
{"source": "袁世凯", "label": "逼迫", "target": "清帝退位"},
{"source": "孙中山", "label": "让位", "target": "袁世凯"},
{"source": "慈禧太后", "label": "垂帘", "target": "光绪帝"},
{"source": "武昌起义", "label": "终结", "target": "清帝退位"}
},
{
"id": "tcm",
"title": "中医药知识",
"scope": "常见中药材性味归经、方剂组成与主治;人参、黄芪、当归、四君子汤、六味地黄丸
等关系网络",
"entities":
{"name": "人参"},
{"name": "黄芪"},
{"name": "当归"},
{"name": "白术"},
{"name": "茯苓"},
{"name": "四君子汤"},
{"name": "六味地黄丸"},
{"name": "熟地黄"},
{"name": "山药"},
{"name": "山茱萸"},
{"name": "甘草"},
{"name": "气血不足"},
{"name": "脾胃虚弱"}
,
"relations":
{"source": "人参", "label": "组成", "target": "四君子汤"},
{"source": "白术", "label": "组成", "target": "四君子汤"},
{"source": "茯苓", "label": "组成", "target": "四君子汤"},
{"source": "甘草", "label": "组成", "target": "四君子汤"},
{"source": "四君子汤", "label": "主治", "target": "脾胃虚弱"},
{"source": "熟地黄", "label": "组成", "target": "六味地黄丸"},
{"source": "山药", "label": "组成", "target": "六味地黄丸"},
{"source": "山茱萸", "label": "组成", "target": "六味地黄丸"},
{"source": "当归", "label": "配伍", "target": "黄芪"},
{"source": "当归", "label": "补血", "target": "气血不足"},
{"source": "黄芪", "label": "补气", "target": "气血不足"},
{"source": "人参", "label": "大补元气", "target": "气血不足"}
},
{
"id": "shuihu",
"title": "水浒传",
"scope": "北宋末年梁山好汉聚义;宋江、林冲、武松、鲁智深、李逵、晁盖等人物关系,以及
逼上梁山、景阳冈打虎、智取生辰纲等经典情节",
"entities":
{"name": "宋江"},
{"name": "林冲"},
{"name": "武松"},
{"name": "鲁智深"},
{"name": "李逵"},
{"name": "晁盖"},
{"name": "吴用"},
{"name": "高俅"},
{"name": "梁山泊"},
{"name": "景阳冈"},
{"name": "生辰纲"},
{"name": "招安"}
,
"relations":
{"source": "宋江", "label": "首领", "target": "梁山泊"},
{"source": "晁盖", "label": "奠基", "target": "梁山泊"},
{"source": "吴用", "label": "军师", "target": "梁山泊"},
{"source": "林冲", "label": "逼上", "target": "梁山泊"},
{"source": "武松", "label": "投奔", "target": "梁山泊"},
{"source": "鲁智深", "label": "投奔", "target": "梁山泊"},
{"source": "李逵", "label": "追随", "target": "宋江"},
{"source": "高俅", "label": "陷害", "target": "林冲"},
{"source": "武松", "label": "打虎于", "target": "景阳冈"},
{"source": "吴用", "label": "智取", "target": "生辰纲"},
{"source": "晁盖", "label": "参与", "target": "生辰纲"},
{"source": "宋江", "label": "接受", "target": "招安"},
{"source": "李逵", "label": "反对", "target": "招安"},
{"source": "鲁智深", "label": "反对", "target": "招安"},
{"source": "宋江", "label": "结义", "target": "武松"}
},
{
"id": "xiyou",
"title": "西游记",
"scope": "唐僧师徒西天取经;孙悟空、猪八戒、沙僧、白龙马与各路妖魔鬼怪的关系,以及大
闹天宫、三打白骨精、火焰山等情节",
"entities":
{"name": "孙悟空"},
{"name": "唐僧"},
{"name": "猪八戒"},
{"name": "沙僧"},
{"name": "白龙马"},
{"name": "观音菩萨"},
{"name": "如来佛祖"},
{"name": "白骨精"},
{"name": "牛魔王"},
{"name": "火焰山"},
{"name": "大闹天宫"},
{"name": "西天取经"}
,
"relations":
{"source": "唐僧", "label": "师父", "target": "孙悟空"},
{"source": "唐僧", "label": "师父", "target": "猪八戒"},
{"source": "唐僧", "label": "师父", "target": "沙僧"},
{"source": "白龙马", "label": "坐骑", "target": "唐僧"},
{"source": "观音菩萨", "label": "点化", "target": "孙悟空"},
{"source": "观音菩萨", "label": "安排", "target": "西天取经"},
{"source": "孙悟空", "label": "保护", "target": "唐僧"},
{"source": "孙悟空", "label": "发起", "target": "大闹天宫"},
{"source": "如来佛祖", "label": "镇压", "target": "孙悟空"},
{"source": "孙悟空", "label": "三打", "target": "白骨精"},
{"source": "牛魔王", "label": "占据", "target": "火焰山"},
{"source": "孙悟空", "label": "借扇灭", "target": "火焰山"},
{"source": "唐僧", "label": "完成", "target": "西天取经"},
{"source": "如来佛祖", "label": "封佛", "target": "孙悟空"}
}
]
字段
含义
id
知识域唯一标识,如 sanguo
title
领域名称,展示在命中结果中
scope
范围描述,写入锚点节点 text ,参与选域与 Graph+Vector
entities
实体列表,含 name 与 aliases
relation
三元组:source --- label →target
s
1.2.2.3 三元组注入器
返回一个KgExtractor实例(继承LlamaIndex的TransformComponent )。在PropertyGraphIndex建索引时自动调用,把JSON中的relations转成:
- EntityNode :图谱实体(如「刘备」「关羽」)
- Relation :关系边(如「结拜」「暂降」)
1. 创建工厂函数(注入三元组)
def make_kg_extractor(domain_by_id : dictstr, dict) -> TransformComponent:
内部类
class KgExtractor(TransformComponent):
@classmethod
def class_name(cls) -> str:
return "KgExtractor"
def call(
self,
nodes: SequenceBaseNode,
show_progress: bool = False,
**kwargs: Any,
) -> SequenceBaseNode:
逐个处理节点
for node in nodes:
domain = domain_by_idnode.metadata\["domain_id"]
kg_nodes: listEntityNode = \[\]
kg_relations: listRelation = \[\]
meta = {"domain_id": domain"id"}
for relation in domain"relations":
source_node = EntityNode(
name=relation"source",
label="ENTITY",
properties=meta,
)
target_node = EntityNode(
name=relation"target",
label="ENTITY",
properties=meta,
)
kg_nodes += source_node, target_node
kg_relations.append(
Relation(
label=relation"label",
source_id=source_node.id,
target_id=target_node.id,
properties=meta,
)
)
node.metadataKG_NODES_KEY = kg_nodes
node.metadataKG_RELATIONS_KEY = kg_relations
return nodes
return KgExtractor()
函数说明:make_kg_extractor()
|--------------|--------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| domain_by_id | dictstr, dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | TransformComponent | 返回当前处理步骤的结果对象或状态。 |
函数说明:class_name()
|-----|--------|-------------------|
| 参数 | 类型/默认值 | 作用 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
函数说明:call()
|---------------|----------------------|---------------------------------------|
| 参数 | 类型/默认值 | 作用 |
| nodes | SequenceBaseNode | LlamaIndex 节点列表,通常包含 text 与 metadata。 |
| show_progress | bool;默认 False | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| kwargs | Any | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | SequenceBaseNode | 返回当前处理步骤的结果对象或状态。 |
1.2.2.4 构建图级节点
2. 把JSON数组转换成listTextNode
def build_nodes(domains: listdict) -> listTextNode:
nodes: listTextNode = \[\]
for domain in domains:
nodes.append(
TextNode(
text=domain"scope",
id_=f"{domain'id'}",
metadata={"domain_id": domain"id"},
)
)
return nodes
1.2.2.5 构建图级索引
3. 构建图索引
def build_index(domains: listdict) -> PropertyGraphIndex:
1. 转换节点列表
nodes = build_nodes(domains)
2. 创建图属性的索引
graph_index = PropertyGraphIndex(
nodes=nodes,
kg_extractors= make_kg_extractor({domain\["id" : domain for domain in
domains }) ],
embed_model = embed_model,
)
3. 返回图索引的对象
return graph_index
1.2.2.6 内容检索
1.2.2.6.1 向量选域
库中有8个知识域,用户query需先锁定最相关的1个域,后续graph_answer只在该域的entities/relations上推理。
4. 判断当前用户查询的问题归属与哪个知识域 (利用LLM来判断)
def pick_domain(query: str, domains: listdict) -> str | None:
1. 整理每个域发送给大模型的内容
domain_lines = "\n".join(
f"- id={domain'id'},title={domain'title'},scope={domain'scope'}"
for domain in domains
)
2. 统计一下所有id的集合
valid_ids = {domain"id" for domain in domains}
3. 提示词
prompt = (
"你是一个知识域的分类器。根据用户的问题,从下列知识域中选择出来最匹配的一个。\n"
"只允许输出该域的id,不要输出任何无关的信息。\n"
"假如用户的问题与所有的知识域无关,直接输出 none。\n"
f"可供选择的知识域:\n{domain_lines}\n\n"
f"用户的问题:{query}\n"
"输出id或者none"
)
4. 访问LLM
response = llm.complete(prompt=prompt)
5. 分析返回的结果
text = response.text.strip().lower()
if text in {"none", "null", "无效", "无关"}:
return None
6. 解析domain_id
domain_id = text if text in valid_ids else next(
(domain"id" for domain in domains if domain"id" in text),
None
)
7. 判断获取到的domain_id
if domain_id is None:
return None
return next(domain for domain in domains if domain"id" == domain_id)
函数说明:pick_domain()
|---------|--------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| domains | listdict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | None | 返回当前处理步骤的结果对象或状态。 |
1.2.2.6.2 BFS广度优先检索
7. 采用BFS去遍历图中的边,找到两个节点之间的关系
def find_paths(domain:dict, source:str, target:str, limit: int =5) ->
listlist\[tuple\[str, str]]:
1. 邻接表
adj : dictstr, list\[tuple\[str, str]] = {}
2. 遍历所有的边(都按照有向边)
for relation in domain"relations":
adj.setdefault(relation"source", \[\]).append((relation"target",
relation"label"))
3. 需要BFS队列
queue: dequetuple\[str, list\[tuple\[str, str]]] = deque((source, \[(source, ""))])
4. 记录返回的路径
paths : listlist\[tuple\[str, str]] = \[\]
5. BFS主循环
while queue and len(paths) < limit:
node, path = queue.popleft()
节省计算量
if len(path) > 10:
continue
for neighbor, label in adj.get(node, \[\]):
if any(neighbor == step0 for step in path):
continue
new_path = path + (neighbor, label)
if neighbor == target:
paths.append(new_path)
elif len(new_path) <= 10:
queue.append((neighbor, new_path))
return paths
函数说明:find_paths()
|--------|-----------------------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| domain | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| source | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| target | str | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| limit | int;默认 5 | 最终返回或召回的最大条数。 |
| 返回值 | listlist\[tuple\[str, str]] | 返回当前处理步骤的结果对象或状态。 |
def format_path(path: listtuple\[str, str]) -> str:
text = path00
for name, label in path1::
text += f"---{label}→ {name}"
return text
函数说明:format_path()
|------|---------------------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| path | listtuple\[str, str] | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
1.2.2.6.3 Graph+Vector检索
10. 图向量索引检索
def retrieve_graph_hits(
query:str,
index:PropertyGraphIndex,
domain:dict,
top_k: int=2
) -> liststr:
results: liststr = \[\]
1. 先来用嵌入模型进行相似度转换成实体
search_query = build_graph_search_query(query, domain)
2. 调用图索引进行查询
hits = index.as_retriever(
sub_retrievers=
VectorContextRetriever(
graph_store=index.property_graph_store,
vector_store=index.vector_store,
embed_model=embed_model,
similarity_top_k=top_k,
)
).retrieve(search_query)
3. 遍历查询结果,提取文本
for hit in hits:
content = (hit.node.get_content(metadata_mode=MetadataMode.NONE) or "")
if content and content not in results:
results.append(content)
return results
函数说明:retrieve_graph_hits()
|--------|--------------------|------------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| index | PropertyGraphIndex | 已经构建好的索引对象,用于执行检索。 |
| domain | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| top_k | int;默认 2 | 召回候选数量;值越大召回更广,但噪声和后处理成本也更高。 |
| 返回值 | liststr | 返回当前处理步骤的结果对象或状态。 |
1.2.2.7 完整代码
用来实现结构化管理中的知识图谱
from collections import deque
from typing import Sequence, Any
from llama_index.core import PropertyGraphIndex, VectorStoreIndex
from llama_index.core.graph_stores import EntityNode, Relation
from llama_index.core.graph_stores.types import KG_NODES_KEY, KG_RELATIONS_KEY
from llama_index.core.indices.property_graph import VectorContextRetriever
from llama_index.core.schema import TransformComponent, BaseNode, TextNode,
MetadataMode
import config
import util
指定数据集
DATA_PATH = config.CHUNKING_DATA_PATH / "knowledgeGraphChunk.json"
嵌入模型
embed_model = util.get_embed_model()
LLM的实例
llm = util.get_dashscope_llm()
1. 创建工厂函数(注入三元组)
def make_kg_extractor(domain_by_id : dictstr, dict) -> TransformComponent:
内部类
class KgExtractor(TransformComponent):
@classmethod
def class_name(cls) -> str:
return "KgExtractor"
def call(
self,
nodes: SequenceBaseNode,
show_progress: bool = False,
**kwargs: Any,
) -> SequenceBaseNode:
逐个处理节点
for node in nodes:
domain = domain_by_idnode.metadata\["domain_id"]
kg_nodes: listEntityNode = \[\]
kg_relations: listRelation = \[\]
meta = {"domain_id": domain"id"}
for relation in domain"relations":
source_node = EntityNode(
name=relation"source",
label="ENTITY",
properties=meta,
)
target_node = EntityNode(
name=relation"target",
label="ENTITY",
properties=meta,
)
kg_nodes += source_node, target_node
kg_relations.append(
Relation(
label=relation"label",
source_id=source_node.id,
target_id=target_node.id,
properties=meta,
)
)
node.metadataKG_NODES_KEY = kg_nodes
node.metadataKG_RELATIONS_KEY = kg_relations
return nodes
return KgExtractor()
2. 把JSON数组转换成listTextNode
def build_nodes(domains: listdict) -> listTextNode:
nodes: listTextNode = \[\]
for domain in domains:
nodes.append(
TextNode(
text=domain"scope",
id_=f"{domain'id'}",
metadata={"domain_id": domain"id"},
)
)
return nodes
3. 构建图索引
def build_index(domains: listdict) -> PropertyGraphIndex:
1. 转换节点列表
nodes = build_nodes(domains)
2. 创建图属性的索引
graph_index = PropertyGraphIndex(
nodes=nodes,
kg_extractors= make_kg_extractor({domain\["id" : domain for domain in
domains }) ],
embed_model = embed_model,
)
3. 返回图索引的对象
return graph_index
4. 判断当前用户查询的问题归属与哪个知识域 (利用LLM来判断)
def pick_domain(query: str, domains: listdict) -> str | None:
1. 整理每个域发送给大模型的内容
domain_lines = "\n".join(
f"- id={domain'id'},title={domain'title'},scope={domain'scope'}"
for domain in domains
)
2. 统计一下所有id的集合
valid_ids = {domain"id" for domain in domains}
3. 提示词
prompt = (
"你是一个知识域的分类器。根据用户的问题,从下列知识域中选择出来最匹配的一个。\n"
"只允许输出该域的id,不要输出任何无关的信息。\n"
"假如用户的问题与所有的知识域无关,直接输出 none。\n"
f"可供选择的知识域:\n{domain_lines}\n\n"
f"用户的问题:{query}\n"
"输出id或者none"
)
4. 访问LLM
response = llm.complete(prompt=prompt)
5. 分析返回的结果
text = response.text.strip().lower()
if text in {"none", "null", "无效", "无关"}:
return None
6. 解析domain_id
domain_id = text if text in valid_ids else next(
(domain"id" for domain in domains if domain"id" in text),
None
)
7. 判断获取到的domain_id
if domain_id is None:
return None
return next(domain for domain in domains if domain"id" == domain_id)
5. 从用户的查询问题中去解析出来实体名称
def resolve_entities(query:str, domain: dict) -> liststr:
names : liststr = \[\]
surfaces = sorted(
(e\["name", e"name") for e in domain"entities"],
key = lambda item : len(item0),
reverse=True
)
for surface, canonical in surfaces:
if surface in query and canonical not in names:
names.append(canonical)
for relation in domain"relations":
pattern = f"{relation'source'}的{relation'label'}"
if pattern in query and relation"target" not in names:
names.append(relation"target")
return names
6. 宽松的查询条件下,转换实体的名称
def build_graph_search_query(query:str, domain:dict, top_k: int=3 )-> str:
VectorStoreIndex
1. 节点列表
nodes =
TextNode(
text = entity\["name",
metadata={"entity_name": entity"name"},
)
for entity in domain"entities"
]
hits = VectorStoreIndex(nodes=nodes, embed_model=embed_model).as_retriever(
similarity_top_k = min(top_k, len(nodes))
).retrieve(query)
2. 定义存放相似实体名的数组
similar_entities : liststr = \[\]
for hit in hits:
name = hit.node.metadata"entity_name"
if name not in similar_entities:
similar_entities.append(name)
if not similar_entities:
return query
3. 把原始的query与相似的实体名拼在一起
return f"{query} {' '.join(similar_entities)}"
7. 采用BFS去遍历图中的边,找到两个节点之间的关系
def find_paths(domain:dict, source:str, target:str, limit: int =5) ->
listlist\[tuple\[str, str]]:
1. 邻接表
adj : dictstr, list\[tuple\[str, str]] = {}
2. 遍历所有的边(都按照有向边)
for relation in domain"relations":
adj.setdefault(relation"source", \[\]).append((relation"target",
relation"label"))
3. 需要BFS队列
queue: dequetuple\[str, list\[tuple\[str, str]]] = deque((source, \[(source, ""))])
4. 记录返回的路径
paths : listlist\[tuple\[str, str]] = \[\]
5. BFS主循环
while queue and len(paths) < limit:
node, path = queue.popleft()
节省计算量
if len(path) > 10:
continue
for neighbor, label in adj.get(node, \[\]):
if any(neighbor == step0 for step in path):
continue
new_path = path + (neighbor, label)
if neighbor == target:
paths.append(new_path)
elif len(new_path) <= 10:
queue.append((neighbor, new_path))
return paths
8. 把查到的关联关系进行格式化
def format_path(path: listtuple\[str, str]) -> str:
text = path00
for name, label in path1::
text += f"-{label} -> {name}"
return text
9. 按照图中遍历的方式回答用户的提问
def graph_answer(query: str, domain: dict) -> str:
1. 从query中解析实体
entities = resolve_entities(query, domain)
2. 判断entities
if not entities:
return ""
3. 统计路径
lines: liststr = \[\]
for i , entity_a in enumerate(entities):
for entity_b in entitiesi+1::
paths = find_paths(domain, entity_a, entity_b)
path_text = ": ".join(format_path(path) for path in paths) if
paths else "无路径"
lines.append(f"{entity_a} -> {entity_b} : {path_text}")
return "\n".join(lines)
10. 图向量索引检索
def retrieve_graph_hits(
query:str,
index:PropertyGraphIndex,
domain:dict,
top_k: int=2
) -> liststr:
results: liststr = \[\]
1. 先来用嵌入模型进行相似度转换成实体
search_query = build_graph_search_query(query, domain)
2. 调用图索引进行查询
hits = index.as_retriever(
sub_retrievers=
VectorContextRetriever(
graph_store=index.property_graph_store,
vector_store=index.vector_store,
embed_model=embed_model,
similarity_top_k=top_k,
)
).retrieve(search_query)
3. 遍历查询结果,提取文本
for hit in hits:
content = (hit.node.get_content(metadata_mode=MetadataMode.NONE) or "")
if content and content not in results:
results.append(content)
return results
11. 封装对外提供的检索方法
def retrieve(
query:str,
domains: listdict,
index: PropertyGraphIndex,
top_k: int =1
) -> str:
1. LLM选域
domain = pick_domain(query, domains)
2. 判断选域结果
if domain is None:
return "没有命中任何与,检索内容与知识库内容无关"
3. BFS遍历查询结果
text = graph_answer(query, domain)
lines =
"【场景】 知识图谱检索",
f"用户输入内容:{query}",
f"内容命中的知识域:{domain\['title'}",
]
if text:
lines.extend(
" --- 知识图谱检索 --- ",
f" {text} ",
)
else:
graph_text = retrieve_graph_hits(query, index, domain, top_k = top_k)
if graph_text:
lines.append(" --- 图向量索引检索 --- ")
for str in graph_text:
lines.append(f"{str}:")
return "\n".join(lines)
if name == "main":
1. 获取数据集
records = util.load_records(DATA_PATH)
2. 建立图索引
print("正在加载模型,请稍后...")
index = build_index(records)
while True:
try:
query = input("\n请输入查询: ").strip()
except Exception:
print("\n退出")
break
if query.lower() in ("q"):
print("\n退出")
break
print("\n" + retrieve(query, records, index))
函数说明:resolve_entities()
|--------|-------------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| domain | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | liststr | 返回当前处理步骤的结果对象或状态。 |
函数说明:build_graph_search_query()
|--------|----------|------------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| domain | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| top_k | int;默认 3 | 召回候选数量;值越大召回更广,但噪声和后处理成本也更高。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |
函数说明:graph_answer()
|--------|--------|---------------------------|
| 参数 | 类型/默认值 | 作用 |
| query | str | 用户查询文本;进入检索或路由流程的原始问题。 |
| domain | dict | 当前函数的业务输入;具体含义结合本节调用位置理解。 |
| 返回值 | str | 返回当前处理步骤的结果对象或状态。 |