本文围绕一个已经跑通的动物姿态估计项目,介绍如何统一五类动物、20 个关键点的标注定义,训练并导出 YOLO11m-Pose 模型,再使用 PySide6、OpenCV 和 ONNX Runtime 构建支持图片、视频、摄像头的桌面系统。重点讨论标签转换、坐标还原、后台推理、结果导出,以及如何正确解读演示效果。
识别一张图片中有没有马,与判断马的眼睛、鼻尖、肘部、膝部和蹄爪分别在哪里,是两个层次的问题。前者属于目标检测,后者需要姿态估计:在识别类别和目标框的同时,为每个动物实例预测一组具有固定语义的关键点。
我在这个项目中使用 Animal-Pose 数据及标注,以 YOLO11m-Pose 为模型,训练输入尺寸为 640×640,最终做成了一套本地运行的动物姿态分析工作站。它既可以查看单张图片,也可以处理本地视频和摄像头输入,并把预测坐标保存下来,供后续分析使用。
先看系统实际效果:
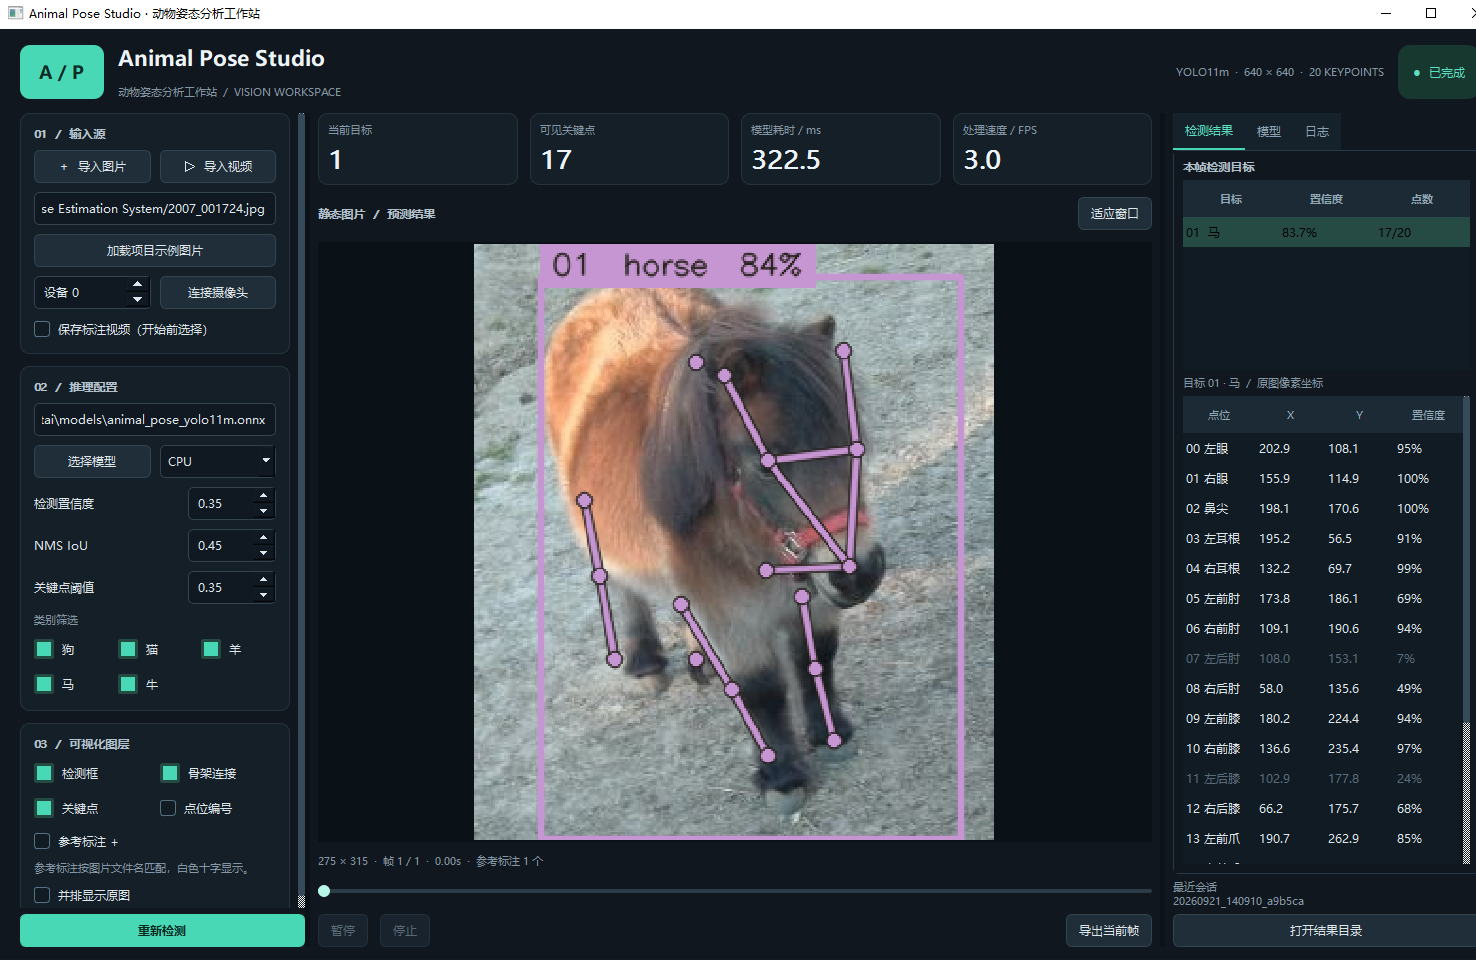
图中检测到一匹马,目标置信度为 83.7% ,当前阈值下显示 17/20 个关键点。界面还给出了模型耗时、处理速度和各关键点的原图坐标。后文会解释这些数字的含义,以及为什么不能把它们直接写成"模型准确率"。
本文中的数据分为两部分:模型接口、标注结构、系统功能和截图数值来自实际项目;训练章节的轮数、批大小等参数是供读者复现实验流程的参考配置。现有工程没有附带原始训练日志,因此不把这些参考值当作该权重的历史训练记录,也不补造测试集 mAP。
一、先明确任务:五种动物,共用一套 20 点定义
本项目的模型输出包括三部分:动物类别、目标边界框,以及每个实例的 20 个关键点。五个类别按模型实际顺序排列为:
text
0 → dog   → 狗
1 → cat   → 猫
2 → sheep → 羊
3 → horse → 马
4 → cow   → 牛
这里的顺序需要从数据配置和模型元数据核对,不能根据中文名称或英文名称重新排序。特别是 sheep、horse、cow,如果在部署时交换位置,模型可能已经检测正确,界面却会显示成其他动物。
姿态模型中的 20 个点也有固定顺序:
python
KEYPOINT_NAMES = [
    "left_eye",          # 0  左眼
    "right_eye",         # 1  右眼
    "nose",              # 2  鼻尖
    "left_ear",          # 3  左耳根
    "right_ear",         # 4  右耳根
    "left_front_elbow",  # 5  左前肘
    "right_front_elbow", # 6  右前肘
    "left_back_elbow",   # 7  左后肘,沿用数据集命名
    "right_back_elbow",  # 8  右后肘
    "left_front_knee",   # 9  左前膝
    "right_front_knee",  # 10 右前膝
    "left_back_knee",    # 11 左后膝
    "right_back_knee",   # 12 右后膝
    "left_front_paw",    # 13 左前爪
    "right_front_paw",   # 14 右前爪
    "left_back_paw",     # 15 左后爪
    "right_back_paw",    # 16 右后爪
    "throat",            # 17 喉部
    "withers",           # 18 鬐甲
    "tailbase",          # 19 尾根
]
"左"和"右"应按动物自身的解剖方向理解,不能简单理解成图片左侧和右侧。训练标签、左右翻转增强、模型输出解析、界面点位名称,都要使用同一套约定。
对于四足动物,还要注意数据集命名与不同物种解剖术语之间的差异。工程中保留原始英文点名,避免仅为了显示习惯修改语义,从而破坏标签与模型之间的对应关系。
二、数据准备:先读懂标注,再转换格式
2.1 数据从哪里来
Animal-Pose 是面向动物姿态估计的数据集,其关键点标注部分包含狗、猫、牛、马、羊五类动物。数据集还提供其他动物类别的边界框数据,使用时需要区分"有关键点的样本"和"只有目标框的样本"。数据来源可查看 Animal-Pose 官方主页。
本项目使用已有的 keypoints.json,不需要从零重新标注全部图片。对这份本地 JSON 进行统计,可以得到:
- 图片记录:4,608 条。
- 动物实例标注:6,117 条。
- 狗:1,771 个实例;猫:1,466 个实例;羊:1,078 个实例;马:960 个实例;牛:842 个实例。
这是这份标注文件的统计结果,不代表当前展示工程已经包含全部图片,也不是训练集、验证集、测试集各自的规模。一张图片可能包含多个实例,因此图片数量与标注数量不同。
2.2 这份 JSON 不宜直接当作标准 COCO 文件处理
文件顶层包含 images、annotations、categories、info。其中,当前版本的 images 是"图片 ID → 文件名"的字典,例如:
json
{
  "1": "2007_000063.jpg",
  "2": "2007_000175.jpg"
}
它不是所有 COCO 工具都默认使用的 image 对象列表。关键点也是嵌套的 20 组三元组,而不是已经展开的一维数组。直接套用一个通用转换器之前,应该先检查这些结构差异。
实例标注通过 image_id 找到图片,通过 category_id 找到类别,bbox 在本项目中按 [x, y, width, height] 解释,关键点则按 [x, y, visibility] 解释。
例如,项目示例图片 2007_000175.jpg 的标注框为:
text
bbox = [25, 34, 419, 271]图片实际尺寸为宽 500、高 332,因此转换为 YOLO 归一化框坐标后得到:
text
中心 x = (25 + 419 / 2) / 500 ≈ 0.469000
中心 y = (34 + 271 / 2) / 332 ≈ 0.510542
框宽   = 419 / 500            = 0.838000
框高   = 271 / 332            ≈ 0.816265
这些值与项目已有的 TXT 标签一致,也就为这里的 bbox 解释提供了实际交叉验证。
2.3 类别 ID 必须显式映射
这份 JSON 的类别 ID 从 1 开始,而 YOLO 标签从 0 开始。当前数据中两者恰好相差 1,但更稳妥的方式是通过类别名称建立映射:
python
model_names = ["dog", "cat", "sheep", "horse", "cow"]
name_to_class = {name: i for i, name in enumerate(model_names)}

category_to_class = {
    int(category["id"]): name_to_class[category["name"]]
    for category in data["categories"]
}
这样即使换来的标注文件使用不连续 ID,也不会因为直接减一而悄悄产生错误类别。
2.4 可见性标记与预测置信度是两回事
本地文件的关键点第三维只有 0 和 1。当前工程将 0 视为无有效标注,将正值视为有效标注;没有依据把其中的 1 进一步细分成"遮挡"或"完全可见"。
转换时保留本项目的 0/1 标记即可。对于没有有效标注的点,输出 0 0 0,不要把 (0,0) 当成一个真实的头部或肢体坐标。
这个处理与所核对版本的 YOLO Pose 损失实现相容:关键点是否参与位置监督的掩码由第三维是否非零确定。若使用其他训练框架,需要重新核对其可见性约定。Ultralytics v8.4.23 损失实现
推理阶段输出的第三维则是模型对关键点的预测分数。例如 0.95 不是标注文件中的可见性编码,不能直接与标注值 1 做数值误差比较。
2.5 转换为 YOLO Pose 标签
本项目的每个实例在 TXT 中占一行:
text
class_id cx cy width height x0 y0 v0 x1 y1 v1 ... x19 y19 v19一行总共有 1 + 4 + 20×3 = 65 个字段。框和关键点坐标都按原图宽高归一化,不是统一除以 640。640 是模型输入尺寸,原图可能是横图、竖图,也可能不是正方形。
下面给出一个适用于本项目 0/1 标注的单实例转换函数。它保留无标注点,对明显异常的数据直接报错,方便在批量转换时定位和人工核验。
python
import math


def annotation_to_yolo(ann, image_width, image_height, category_to_class):
    if image_width <= 0 or image_height <= 0:
        raise ValueError("图片尺寸无效")

    x, y, width, height = map(float, ann["bbox"])
    if not all(math.isfinite(v) for v in (x, y, width, height)):
        raise ValueError("框坐标包含非有限值")
    if width <= 0 or height <= 0:
        raise ValueError("目标框宽高必须大于零")
    if not (0 <= x < image_width and 0 <= y < image_height
            and x + width <= image_width and y + height <= image_height):
        raise ValueError("目标框越界,请核验原始标注")

    fields = [
        str(category_to_class[int(ann["category_id"])]),
        f"{(x + width / 2) / image_width:.6f}",
        f"{(y + height / 2) / image_height:.6f}",
        f"{width / image_width:.6f}",
        f"{height / image_height:.6f}",
    ]
    if len(ann["keypoints"]) != 20:
        raise ValueError("每个实例必须包含 20 个关键点槽位")

    for px, py, visibility in ann["keypoints"]:
        if visibility not in (0, 1):
            raise ValueError("本转换函数只接受当前数据集的 0/1 标记")
        if visibility == 0:
            fields.extend(["0.000000", "0.000000", "0"])
            continue
        if not (math.isfinite(px) and math.isfinite(py)
                and 0 <= px < image_width and 0 <= py < image_height):
            raise ValueError("有效关键点越界或含非法坐标,请核验")
        fields.extend([
            f"{px / image_width:.6f}",
            f"{py / image_height:.6f}",
            "1",
        ])

    assert len(fields) == 65
    return " ".join(fields)
批量转换时,先按 image_id 聚合实例,再读取对应原图获得宽高,将同一图片的所有实例一次性写入同名 TXT。不要在实例循环中反复用覆盖模式写文件,否则多目标图片最终只会留下最后一个动物。
我用上述函数转换了 2007_000175.jpg 对应的实例,并与工程已有 TXT 做数值比较:65 个字段在 1e-6 的绝对误差范围内一致。这能验证示例的类别、框和点位转换逻辑,但不能代替全量数据检查。
这个函数是文章中的转换示例,不代表当前部署工程已经执行过全量数据转换。完整训练前仍需逐张检查图片是否存在、标签是否越界、文件名是否重复,并输出异常清单。没有拿到图片的标注不能假定已经成为有效训练样本。
2.6 数据集划分与标注复查
数据划分以图片为单位,同一图片的多个动物必须进入同一个子集。若后续加入视频抽帧,还应按视频来源或拍摄场景分组,避免相邻帧同时出现在训练集和测试集中。
一种可采用的参考比例是训练集 80%、验证集 10%、测试集 10%。这只是后续实验设计建议,不是当前权重的已知划分记录。考虑到五类实例数量不均衡,应同时核查各子集的类别分布。
实际清洗时,我会优先抽查:左右关键点是否反标、腿部关节是否错位、多个动物是否串标、被遮挡部位是否被随意猜测,以及目标框是否覆盖对应动物。新增人工标注应沿用这套点位定义;对无法可靠定位的点保留无标注状态。
三、模型选择与训练:为什么使用 YOLO11m-Pose
3.1 必须使用 Pose 任务模型
这个项目使用的是 YOLO11m-Pose 。普通 yolo11m.pt 对应检测任务,而 yolo11m-pose.pt 对应关键点任务。只给检测模型换成带关键点的标签,不等于建立了姿态估计训练流程。YOLO11 的任务及权重命名可参考 官方模型文档。
选择 m 规格,是为了给多种动物外观和不同姿态留出一定的模型容量,同时控制部署复杂度。更小的 n/s 可以作为轻量化候选,更大的 l/x 可以作为精度实验候选,但本项目没有进行这些规格之间的受控对比,因此不能声称 m 已经被验证为最优。
这里更直接的工程依据是:项目已经有训练好的 m 规格 Pose 模型,ONNX 接口与五类、20 点定义一致,可以先完成完整的部署和验证闭环,再决定是否重新选择模型。
3.2 训练配置中的两个关键字段
数据目录可整理为:
text
animal_pose_dataset/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
├── labels/
│   ├── train/
│   ├── val/
│   └── test/
└── data.yaml
对应的参考 data.yaml:
yaml
path: D:/datasets/animal_pose_dataset
train: images/train
val: images/val
test: images/test

names:
  0: dog
  1: cat
  2: sheep
  3: horse
  4: cow

kpt_shape: [20, 3]
flip_idx: [1, 0, 2, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11, 14, 13, 16, 15, 17, 18, 19]
kpt_shape: [20,3] 声明每个实例包含 20 个三维关键点槽位;flip_idx 声明水平翻转后的左右点对应关系。例如左眼与右眼互换,左前膝与右前膝互换,而鼻尖、喉部、鬐甲、尾根保持自身索引。相关字段的定义见 Ultralytics Pose 数据格式。
这份翻转映射由本项目的 20 点顺序推导,不能照搬人体 17 点的配置。调试数据增强时,可以把一张原图和水平翻转后的标注一起画出来,直接观察左右语义是否正确。
3.3 训练参考代码
训练和部署建议使用不同虚拟环境:训练环境需要 Ultralytics 和 PyTorch;桌面部署使用 ONNX Runtime,不必再加载完整的训练框架。
实际 ONNX 的元数据显示其导出工具版本为 8.4.23。它可以作为核对接口的版本线索,但不能仅凭这项信息还原全部训练依赖。
下面是同任务的训练入口示例,数据目录、显卡编号和批大小需要按自己的环境调整:
python
from ultralytics import YOLO


if __name__ == "__main__":
    model = YOLO("yolo11m-pose.pt")
    model.train(
        data="animal_pose_dataset/data.yaml",
        imgsz=640,
        epochs=150,       # 参考值,不是现有权重的已知训练轮数
        batch=8,          # 按显存调整
        device=0,         # 对应训练环境中的 GPU
        workers=4,
        patience=30,
        seed=42,
        project="runs/animal_pose",
        name="yolo11m_pose",
    )
训练接口及验证方式参考 Ultralytics Pose 文档。Windows 使用多进程数据加载时保留 if __name__ == "__main__" 入口保护。
从官方预训练 Pose 权重开始时,需要确认训练器按照自定义数据集建立了五类、20 点的任务输出。预训练模型原有的点位语义不会自动变成动物的 20 个点;最终应检查训练日志中的模型结构,并核验导出后的 names、kpt_shape 和输出张量。
训练完成后,至少保留数据划分清单、配置文件、训练参数、最佳权重、训练曲线和验证结果。仅留下一个 ONNX 文件虽然可以部署,但不利于解释模型来源或复现实验。
四、导出 ONNX:部署前先核对模型接口
训练完成后,可按下面的参考方式导出与本系统相容的模型:
python
from ultralytics import YOLO


if __name__ == "__main__":
    model = YOLO("runs/animal_pose/yolo11m_pose/weights/best.pt")
    model.export(
        format="onnx",
        imgsz=640,
        batch=1,
        dynamic=False,
        half=False,
        simplify=True,
        opset=17,
        nms=False,
    )
这里保留原始预测输出,由 Python 执行 NMS。nms=False 等参数与本项目已有模型的导出元数据一致;更换导出版本后,仍应检查实际输出,不应只靠文件名判断。导出接口参考 Ultralytics Export 文档。
当前工程实际加载的文件为 models/animal_pose_yolo11m.onnx,其输入和输出为:
text
输入:[1, 3, 640, 640]
输出:[1, 69, 8400]
任务:pose
关键点形状:[20, 3]
69 个通道的组成是:
text
4 个框参数 + 5 个类别分数 + 20 × 3 个关键点参数 = 69这份模型的输出没有额外的 objectness 通道。解码时,前 4 个通道是框,接下来 5 个是类别分数,其余 60 个才是关键点。如果沿用其他 YOLO 版本的"4+1+类别数"偏移,所有关键点都会读错。
可以用下面的短脚本在部署前检查模型:
python
import onnxruntime as ort

session = ort.InferenceSession(
    "models/animal_pose_yolo11m.onnx",
    providers=["CPUExecutionProvider"],
)
print("input:", session.get_inputs()[0].shape)
print("output:", session.get_outputs()[0].shape)
print("metadata:", session.get_modelmeta().custom_metadata_map)
系统还会检查模型文件是否存在、输入类型是否受支持、类别集合是否正确,以及元数据中的关键点定义是否一致。模型不相容时,在加载阶段给出错误,避免继续显示看似正常、实际错误的预测结果。
五、推理实现:最容易出错的是坐标,而不是画线
5.1 用 Letterbox 保持动物的原始比例
原图不一定是正方形。如果直接将一张竖图拉伸成 640×640,动物身体的宽高比例会变化,推理输入也可能偏离训练和验证时的预处理方式。
本系统采用等比例缩放加补边。设原图宽高为 W、H,目标边长为 640,则:
text
r = min(640 / W, 640 / H)
new_width  = round(W × r)
new_height = round(H × r)
将图像缩放到 new_width × new_height 后,用像素值 114 补齐到 640×640,同时记录实际添加的左边距和上边距。核心代码如下:
python
import cv2
import numpy as np


def letterbox(image, size=640):
    height, width = image.shape[:2]
    ratio = min(size / width, size / height)
    new_width = round(width * ratio)
    new_height = round(height * ratio)

    left = round((size - new_width) / 2 - 0.1)
    top = round((size - new_height) / 2 - 0.1)
    right = size - new_width - left
    bottom = size - new_height - top

    resized = cv2.resize(image, (new_width, new_height))
    padded = cv2.copyMakeBorder(
        resized, top, bottom, left, right,
        cv2.BORDER_CONSTANT, value=(114, 114, 114),
    )
    tensor = np.ascontiguousarray(
        padded[:, :, ::-1].transpose(2, 0, 1)[None],
        dtype=np.float32,
    ) / 255.0
    return tensor, ratio, (left, top)
这一步同时完成 BGR 转 RGB、HWC 转 NCHW、增加 batch 维度和数值归一化。
样例截图中的原图宽高为 275×315。按照上述规则计算,缩放后约为 559×640,左右共需补 81 个像素,具体分成左 40、右 41。这个例子说明:补边不一定对称到每边完全相等,坐标还原时应使用实际保存的整数边距。
5.2 先筛选目标,再还原关键点
将 [1,69,8400] 转换成 [8400,69] 后,每一行都是一个候选结果。处理顺序为:
- 排除包含非有限值的候选结果。
- 从 5 个类别分数中找到最高分及对应类别。
- 根据检测置信度和类别筛选条件保留候选框。
- 将框从中心点宽高形式转换为
xyxy,执行按类别 NMS。 - 读取该目标的 20×3 关键点,并恢复到原图坐标。
NMS 按类别进行,避免两个不同物种的重叠框仅因位置接近就相互抑制。当前工程还限制了进入 NMS 的候选数量及最终目标数量,降低异常输出或密集场景带来的计算开销。
假设某关键点在输入张量对应图像中的坐标为 (x_model, y_model),则原图坐标为:
text
x_original = (x_model - left) / ratio
y_original = (y_model - top)  / ratio
不要在这里再乘一次 640:本模型导出的关键点坐标已经位于模型输入图像的像素空间。也不要只减去补边、不除缩放比例,否则非 640 尺寸图片上的点位会整体偏移。
5.3 检测阈值与关键点阈值分别控制什么
系统提供三个常用参数,默认值分别是:检测置信度 0.35、NMS IoU 0.45、关键点阈值 0.35。
检测置信度决定一个动物实例是否保留。关键点阈值决定这个实例上的哪些点被画出来。NMS IoU 则用于判断同类候选框之间是否存在过高重叠。
因此,检测到一匹马,不代表它的 20 个点都应该显示。某条腿受到遮挡时,相关关键点的分数可能较低;为了让结果容易判断,可以暂时隐藏这些点,而不是为了画出完整骨架而强行连线。
连线时要求两个端点都达到阈值,并位于原图范围内。导出 JSON 时仍然保留全部 20 个点及其原始预测分数,便于后续分析,不把显示过滤误当成模型没有输出。
5.4 不要给四足动物套用人体骨架
本项目直接沿用标注中的连接关系,共 15 条:
python
SKELETON = [
    (0, 1), (0, 2), (1, 2), (0, 3), (1, 4),
    (2, 17), (18, 19),
    (5, 9), (6, 10), (7, 11), (8, 12),
    (9, 13), (10, 14), (11, 15), (12, 16),
]
这份文件已经使用 0 基索引 ,不需要再减一。如果习惯性地执行 index - 1,索引 0 会变成 Python 中的 -1,错误连接到最后一个点,程序甚至不一定报错。
骨架连接只决定可视化拓扑,本身不等于额外训练出来的骨骼约束。当前关系也不会把每个点都连接成一棵完整的树,因此画面中的某些点没有与躯干连线,并不自动意味着推理失败。
六、系统搭建:把推理能力变成可操作的桌面工具
6.1 技术栈与模块划分
桌面部分使用 PySide6;图像、视频读写由 OpenCV 处理;张量操作和后处理使用 NumPy;模型由 ONNX Runtime 执行。
采用这个组合的直接收益是:部署端不必依赖 PyTorch,界面也能直接访问本机文件和摄像头。模型、渲染、采集和窗口逻辑分开,后续修改阈值策略或界面布局时,不必同时重写全部代码。
工程结构如下:
text
project/
├── main.py                    # 桌面入口
├── infer.py                   # 命令行入口
├── models/
│   └── animal_pose_yolo11m.onnx
├── keypoints.json
├── animal_pose/
│   ├── schema.py              # 类别、关键点、配置与标注读取
│   ├── engine.py              # 模型加载、预处理、NMS、坐标还原
│   ├── worker.py              # 后台采集与推理、会话导出
│   ├── render.py              # 框、关键点、骨架与标注叠加
│   ├── storage.py             # 图片与 JSON 写入、日志
│   └── ui.py                  # 桌面界面与交互
├── tests/
├── requirements.txt
├── requirements-lock.txt
├── install.bat
└── start.bat
同一套 engine.py 和 worker.py 同时供 GUI 与命令行调用,避免出现"界面效果正确,批处理脚本却用了另一套预处理"的问题。
6.2 界面按操作顺序组织
窗口左侧是输入源、推理参数和图层开关;中间展示画面及运行指标;右侧显示目标列表、20 点坐标、模型信息和日志。
图片导入后会开始检测。用户可以滚轮缩放、拖动平移、双击复位,也可以并排显示原图。点击右侧目标,就能查看它的关键点坐标;低分或越界点使用灰色显示。
当需要核对模型预测与数据标签时,可以打开参考标注图层。系统按图片文件名查找 keypoints.json,以白色十字显示标注,以彩色圆点显示预测。标注只用于显示,不会被送入模型参与预测。
这个匹配机制要求图像仍然对应原始坐标系。如果同名图片已经被裁剪、旋转或缩放,原始 JSON 坐标不能直接叠加。真实业务系统中,可以进一步使用样本 ID、尺寸校验或图像摘要代替仅按文件名匹配。
6.3 后台推理,让界面保持响应
如果在按钮回调中直接执行模型加载和视频循环,主线程会长期被占用,表现为窗口无法拖动、按钮不响应,甚至显示"未响应"。
本项目将模型加载、采集、推理和逐帧导出放入 InferenceWorker 后台线程。主线程负责窗口、控件和画面显示。Qt 支持通过信号和槽进行线程间通信,但 QThread 对象本身与它执行的 run() 不在同一线程上下文中,共享状态仍需正确同步。Qt QThread 官方说明
实际代码中,停止请求使用 threading.Event,配置更新、暂停状态和帧缓冲使用锁保护。界面不直接修改正在参与推理的数组,而是把下一帧需要使用的参数交给后台线程读取。
每次检测会话创建一次推理引擎,视频帧循环复用同一个 ONNX Session;不会每读一帧就重新加载模型。
6.4 画面刷新只保留最新结果
把所有帧都加入界面事件队列,并不能保证流畅。当后台产出快于界面绘制时,队列反而会不断增长,用户看到的画面越来越滞后。
本项目使用一个容量为一帧的共享缓冲:后台写入最新结果,界面用定时器取走当前可用的结果。核心思路可以简化为:
python
# 后台线程发布结果
with self._lock:
    self._latest = packet

# 主线程取走最新结果
with self._lock:
    packet = self._latest
    self._latest = None
界面的刷新定时器为 40 ms,这只是检查新结果的间隔,并不意味着模型能达到 25 FPS。模型每秒只能处理 3 帧时,界面仍然只能获得约 3 次新的推理结果。
这里被覆盖的是待显示的旧帧。视频逐帧 JSON 和已开启的录像在后台处理,因此"预览没有显示每一帧"与"推理结果没有保存每一帧"是两件不同的事。该缓冲也不负责清理摄像头驱动内部可能存在的队列,实时延迟仍需实机测量。
6.5 图片、视频、摄像头采用不同控制方式
图片完成一次推理后停留在结果画面。显示图层修改立即生效;修改检测置信度、类别或 NMS 后,需要点击"重新检测",重新计算实例结果。
本地视频按顺序解码和处理,支持暂停、继续及进度定位。推理速度低于原视频帧率时,处理过程会放慢,优先保留逐帧结果。录制模式关闭跳转,避免导出文件的时间顺序被打乱。
摄像头按设备编号打开,持续读取画面直到用户停止或设备出错。摄像头录制根据程序读取帧后的时间戳补写上一张结果,使低推理帧率下的录像播放时长接近实际处理期间的时长。这个时间戳不是硬件曝光时间戳,录像保存的也是推理预览,不能替代独立的高帧率原始视频记录。
6.6 关闭窗口也属于功能设计
停止时先通知后台结束循环,再释放 VideoCapture、VideoWriter 和输出文件。窗口关闭时若后台仍在处理当前帧,会等待其正常结束,而不是强制销毁正在使用的线程。
异常处理覆盖模型缺失、图片损坏、视频无法打开、摄像头占用或断开等情况,并把详细信息写入轮转日志。日志文件达到约 3 MB 后轮转,保留有限数量的历史文件,便于现场定位问题。
操作系统或设备驱动的读取若发生阻塞,停止仍需等待底层调用返回。这属于后续设备接入验收的一部分;仅把推理放到后台线程,并不能解决所有硬件阻塞问题。
七、结果导出:图片之外,还要保存可复用的数据
单张效果图适合展示,但后续统计、误差分析或行为研究通常需要坐标。因此,系统会按会话建立独立目录:
text
outputs/日期_时间_随机标识/
├── session.json        # 来源、模型信息、参数、处理状态、帧数和耗时
├── predictions.jsonl   # 每个处理帧一行,包含目标框和关键点
└── annotated.mp4       # 开启录制时生成;必要时回退为 AVI
GUI 中的"导出当前帧"还会保存一张标注图片及同名 JSON。命令行图片模式会自动输出 annotated.png。
predictions.jsonl 每行对应一个已处理帧,包含帧号、时间戳、原图尺寸、当帧推理参数、耗时,以及每个目标的类别、置信度、边界框和关键点。
坐标格式明确约定为:
text
bbox_xyxy = [x1, y1, x2, y2]        # 原图像素
keypoints = [[x0, y0, score0], ...] # 共 20 个点,原图像素
关键点顺序记录在会话信息中。按帧保存参数也有实际意义:如果用户在视频处理过程中改变阈值,后续分析可以知道哪些帧使用了哪些设置。
JSONL 逐行写入,不需要把整段视频的预测结果堆在内存中。普通写入和 flush 并不等于断电级持久化保证;进程被强杀时,最后写入的数据或尚未封装完成的视频仍可能损坏。长期部署还应增加存储容量监控和归档策略。
八、效果分析:怎样读懂"样例.png"
回到开头的实际界面截图,当前参数为检测置信度 0.35、NMS IoU 0.45、关键点阈值 0.35,使用 CPU 后端。
8.1 83.7% 是这个目标的检测分数
右侧目标列表显示马的置信度为 83.7% ,画面标签显示 84%,只是两处显示精度不同:列表保留一位小数,画面标签取整数百分比。
这个数值反映当前模型对该候选目标的预测分数,不是"整个数据集的识别准确率",也不代表已经通过校准的真实正确概率。将它写成"系统准确率达到 83.7%"是不成立的。
8.2 17/20 表示通过显示规则的点数
模型输出仍然包含全部 20 个点,界面根据阈值和图像边界检查显示其中的 17 个。例如截图中左后肘约为 7%、左后膝约为 24%,在当前 35% 的关键点阈值下会被灰显或隐藏。
因此,"17/20"不能解释为 17 个点预测正确,更不能用 17÷20 计算姿态准确率。它统计的是当前的显示条件,不是与人工标注比较后的正确数量。
从画面可以观察到,系统已经将马的面部和部分肢体点位叠加到目标上,头部及腿部连线也能显示出来。但具体点位是否满足精度要求,仍需结合标注逐点检查,尤其是遮挡、透视缩短和前后腿重叠部位。
8.3 322.5 ms 与 3.0 FPS 的统计范围不同
截图中的 322.5 ms 是该帧 ONNX 模型调用耗时。3.0 FPS 则由单帧采集或取帧、预处理、推理、后处理所花时间计算,不包含界面绘制、导出和视频播放等待。
只对模型耗时取倒数,1000 / 322.5 ≈ 3.10。考虑预处理等开销后,界面显示约 3.0 是可以理解的。但这是截图中的一次观测,没有完整硬件信息、预热策略和长时间统计,不能当作所有 CPU 的统一性能,也不能据此声称系统达到 25 或 30 FPS 实时处理。
若要做正式性能报告,应固定输入规模和目标数量,记录 CPU/GPU 型号、运行后端、线程配置、预热次数,再统计连续帧的平均耗时和 P95 延迟,并单独测量采集到显示的端到端延迟。
8.4 如何进一步评估模型
本次展示工程没有完整训练日志和测试集评估报告,所以文章不提供未经测量的 mAP、OKS 或 PCK 数值。
补齐模型评估时,可分别统计目标框检测指标和关键点定位指标;关键点评估要明确无标注点如何屏蔽、OKS 的尺度和参数如何设定,或者 PCK 使用哪种归一化尺度与阈值。动物 20 点的设置不能不加核对地套用人体 17 点评估协议。
更有价值的分析还包括:按五个类别分别评估,按遮挡程度、目标大小、单目标与多目标场景分别检查。固定数据划分和评估协议后,再比较不同模型规格或输入尺寸,结论才具有可比性。
九、验证与部署:从能运行到便于复现
9.1 工程测试覆盖了什么
当前工程已有 16 项自动化测试通过,覆盖图像预处理、按类别 NMS、坐标还原、异常输出、中文文件路径、原始标注与已有 TXT 的一致性,以及真实 ONNX 模型对样例图的推理。
视频集成测试使用由示例图片生成的短视频,验证帧序号、时间戳、逐帧结果和输出视频帧数;另外测试暂停、定位和停止。摄像头相关测试模拟无法打开与读取中断,检查错误反馈及资源释放。界面测试会运行实际模型,检查目标表、20 点坐标表并保存窗口截图。
这些测试说明软件链路在覆盖范围内工作正常,不代表已经完成真实复杂视频的精度评估,也不等于实体摄像头、GPU 或连续运行数天的稳定性验收。
执行方式:
powershell
.\.venv\Scripts\python.exe -m pip install -r requirements-dev.txt
.\.venv\Scripts\python.exe -m pytest -q
9.2 启动桌面系统
新环境建议安装 Python 3.12 x64,创建项目虚拟环境后安装运行依赖:
powershell
py -3.12 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
.\.venv\Scripts\python.exe main.py
依赖安装完成后,也可以直接运行项目的 start.bat。如果希望启动后自动检测项目示例:
powershell
.\.venv\Scripts\python.exe main.py --demo项目同时提供锁定版本文件,便于重现已经验证的运行环境。复制到其他电脑时,重新创建虚拟环境,不直接复制原机器的 .venv。
9.3 模型路径如何处理
默认路径由源码所在位置计算。在 animal_pose/schema.py 中:
python
from pathlib import Path

ROOT = Path(__file__).resolve().parent.parent
model_path = ROOT / "models" / "animal_pose_yolo11m.onnx"
加载时得到的是绝对路径,但不把某个盘符写死,也不依赖启动命令所在的工作目录。这里的 parent.parent 对应当前模块位于 animal_pose/ 子目录;如果把代码搬到项目根目录,层级也要相应调整。
另外,系统会将用户上次选择的模型绝对路径保存到 settings.local.json。移动项目后,如果仍然读取到旧路径,重新选择模型或删除该配置文件,即可回到自动计算的默认位置。
9.4 不打开窗口也可以推理
对于批处理集成或调试,可使用同一套后台逻辑的命令行入口:
powershell
# 图片
.\.venv\Scripts\python.exe infer.py --source 2007_000175.jpg

# 本地视频,保存标注录像
.\.venv\Scripts\python.exe infer.py --mode video --source "D:\videos\animal.mp4" --record

# 摄像头,Ctrl+C 请求正常停止
.\.venv\Scripts\python.exe infer.py --mode camera --source 0 --record
默认运行在 CPU。界面也提供 CUDA 和 DirectML 选项,但选择后端之前必须安装相应 Runtime 并满足其驱动依赖;仅切换下拉框不会自动获得 GPU 加速。当前实测结果以 CPU 为准。
十、继续走向现场应用,还需要补哪些能力
这套工程已经具备本地展示、参数调节、视频处理、结构化导出和基础异常处理能力,适合作为动物姿态项目的桌面验证平台。
如果进一步用于养殖场或其他现场场景,我会按实际需求依次补充三类能力。
首先是数据与评估。采集固定机位、夜间、遮挡、运动模糊等真实场景数据,沿用一致的标注规则,建立独立测试集。展示数据上的视觉效果,不能直接代表现场分布下的效果。
其次是设备与性能。测试真实摄像头、输入视频编码和目标 GPU,明确延迟上限,再决定是否使用更小模型、优化采集策略或更换推理后端。需要多路输入时,应单独设计任务调度与资源限制,而不是简单增加多个无限循环。
最后是业务输出。如果需要跨帧行为分析,应引入目标跟踪和时序处理;当前界面中的"01、02"只是本帧目标序号,不是稳定的跟踪 ID。步态、异常行为或健康状态判断也需要额外的定义、数据和验证,不能仅凭绘制出的骨架就宣称已经实现。
目前尚未实现 RTSP 接入、自动重连、多路并行和跨帧跟踪,长期存储管理与现场稳定性也需要继续验收。把这些边界写清楚,后续扩展才能有明确的目标和验证标准。
这个项目给我的一个实际体会是:姿态系统的可靠性很大程度上来自细节的一致性。类别编号对齐、20 点顺序不变、预处理与训练相容、原图坐标还原正确,用户才有可能信任界面上看到的每一个点。把这些基础做好后,模型效果与系统体验的进一步优化才有清晰的依据。
项目链接:https://download.csdn.net/download/weixin_45776000/93483893