一.函数
1.函数是什么
程中的函数和数学中的函数有一定的相似之处.
数学上的函数, 比如 y = sin x , x 取不同的值, y 就会得到不同的结果.
编程中的函数, 是一段 可以被重复使用的代码片段 .
(1)求数列的和,不使用函数
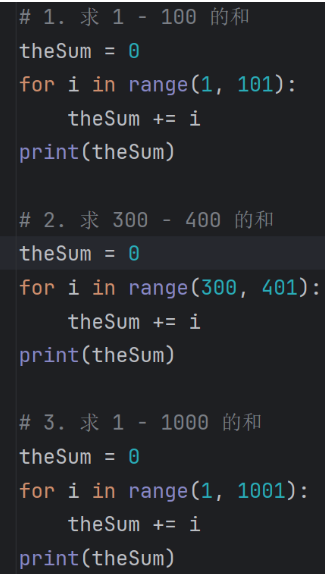
可以发现, 这几组代码基本是相似的, 只有一点点差异. 可以把重复代码提取出来, 做成一个函数
实际开发中, 复制粘贴是一种不太好的策略. 实际开发的重复代码可能存在几十份甚至上百份.
一旦这个重复代码需要被修改, 那就得改几十次, 非常不便于维护.
(2)求数列的和,使用函数
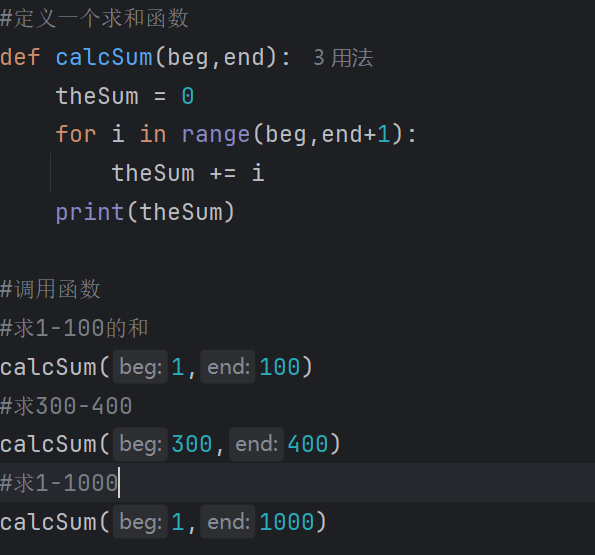
可以明显看到,重复的代码已经被消除了,也没有那么冗余了。
2.语法格式
(1)创建函数或者定义函数
bash
def 函数名(形参列表):
    函数体
    return 返回值

# def:define定义
# 形参列表中可以有多个形参,多个形参(形式参数)之间用逗号分隔
# 函数体要带有一定的缩进(带有缩进的代码才是函数内部的语句)
# 函数执行到 return 就意味着执行完了,return 后面的值就是函数的返回值
(2)调用函数或者使用函数
bash
函数名(实参列表)            // 不考虑返回值
返回值 = 函数名(实参列表)   // 考虑返回值

# 这里的实参个数要和形参个数匹配- 函数定义并不会执行函数体内容,必须要调用才会执行,调用几次就会执行几次。
看代码:
bash
def test1():
   print('hello')

# 如果光是定义函数, 而不调用, 则不会执行
函数必须先定义,再使用:
bash
test3()          # 还没有执行到定义, 就先执行调用了, 此时就会报错.
def test3():
    print('hello')
动漫里释放技能之前, 需要大喊招式的名字, 就是 "先定义, 再使用".
3.函数参数
在函数定义的时候, 可以在 ( ) 中指定**"形式参数" (简称 形参), 然后在调用的时候, 由调用者把"实际参数"(简称 实参)**传递进去.
这样就可以做到一份函数, 针对不同的数据进行计算处理.
前面这段代码中,beg、end 就是函数的形参;1、100 / 300、400 就是函数的实参。
- 在执行 sum(1, 100) 的时候,就相当于 beg = 1、end = 100,然后在函数内部就可以针对 1-100进行运算。
- 在执行 sum(300, 400) 的时候,就相当于 beg = 300、end = 400,然后在函数内部就可以针对 300-400 进行运算。
实参和形参之间的关系, 就像签合同一样.
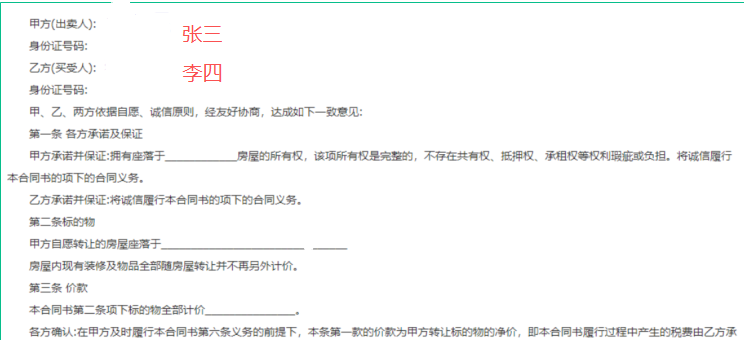
甲方、乙方就相当于形参,张三、李四就是实参。
bash
def 签合同(甲方, 乙方):
    合同内容....
签合同('张三', '李四')
签合同('张三', '王五')
签合同('张三', '赵六')
注意:
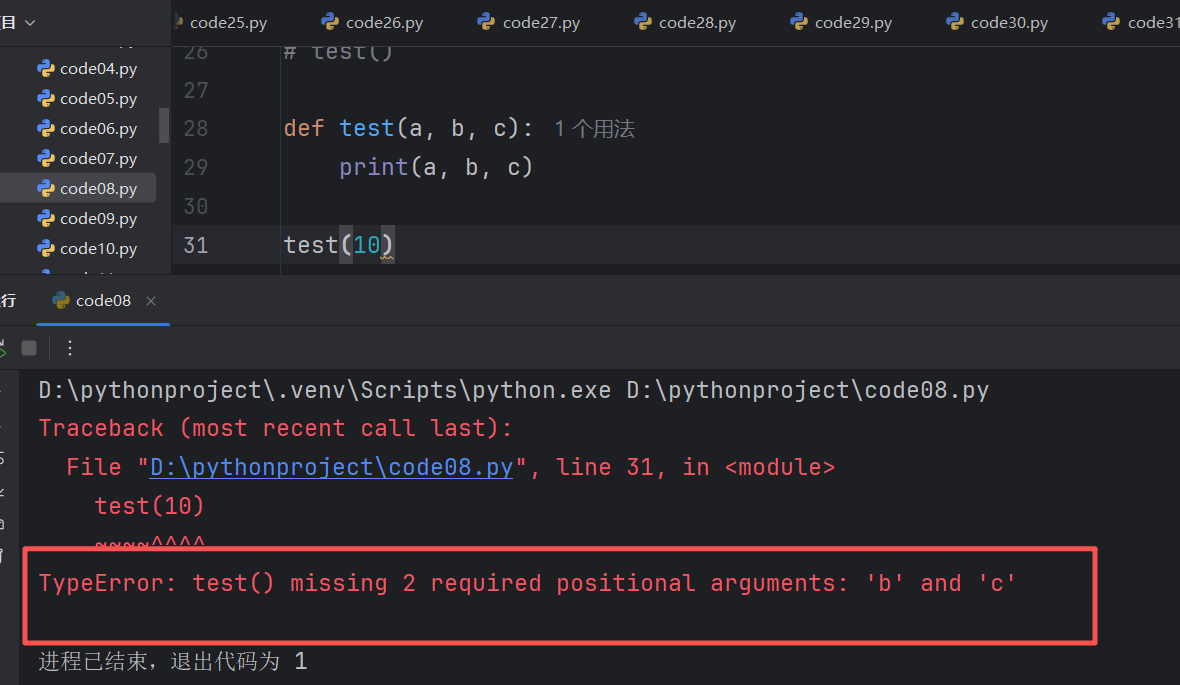
- 一个函数可以有一个形参, 也可以有多个形参, 也可以没有形参.
- 一个函数的形参有几个, 那么传递实参的时候也得传几个. 保证个数要匹配.
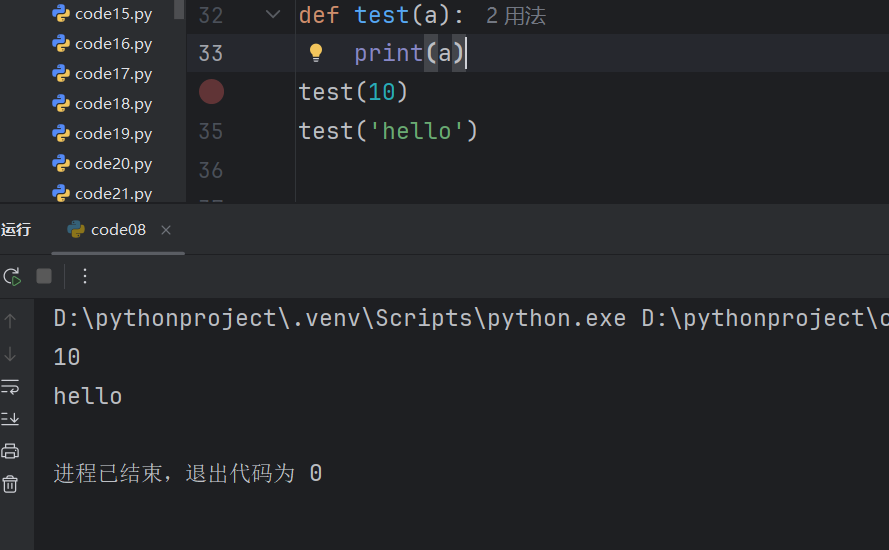
- 和 C++ / Java 不同, Python 是动态类型的编程语言, 函数的形参不必指定参数类型. 换句话说, 一个函数可以支持多种不同类型的参数.
4.函数返回值
函数的参数可以视为是函数的 "输入", 则函数的返回值, 就可以视为是函数的 "输出" .
此处的 "输入", "输出" 是更广义的输入输出, 不是单纯指通过控制台输入输出.
我们可以把函数想象成一个 "工厂". 工厂需要买入原材料, 进行加工, 并生产出产品.
函数的参数就是原材料, 函数的返回值就是生产出的产品.
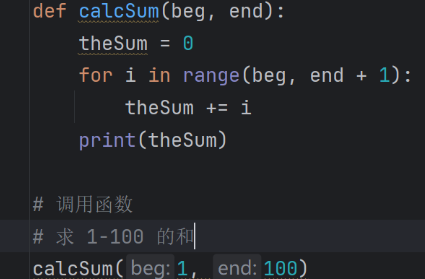
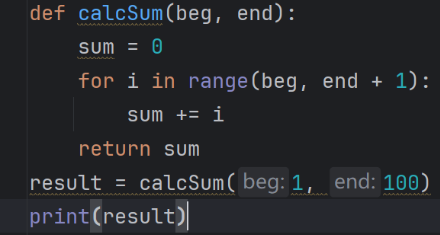
这两个代码的区别就在于, 前者直接在函数内部进行了打印, 后者则使用 return 语句把结果返回给函数调用者, 再由调用者负责打印.一般倾向于第二种写法
实际开发中我们的一个通常的编程原则, 是 "逻辑和用户交互分离". 而第一种写法的函数中, 既包含了计算逻辑, 又包含了和用户交互(打印到控制台上). 这种写法是不太好的, 如果后续我们需要的是把计算结果保存到文件中, 或者通过网络发送, 或者展示到图形化界面里, 那么第一种写法的函数, 就难以胜任了.
而第二种写法则专注于做计算逻辑, 不负责和用户交互. 那么就很容易把这个逻辑搭配不同的用户交互代码, 来实现不同的效果.
(1)一个函数中可以有多个 return 语句
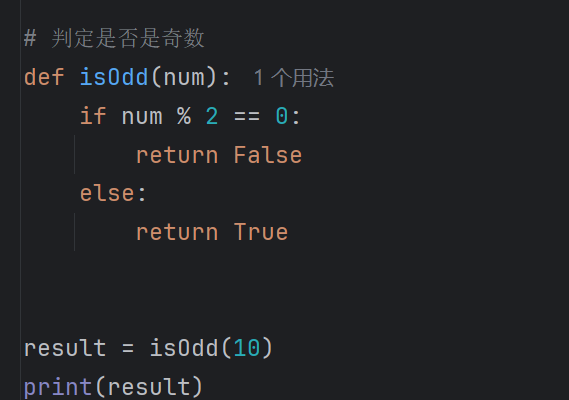
(2)执行到 return 语句,函数就会立即执行结束,回到调用位置
下面这段代码和上一段代码的逻辑是等价的。
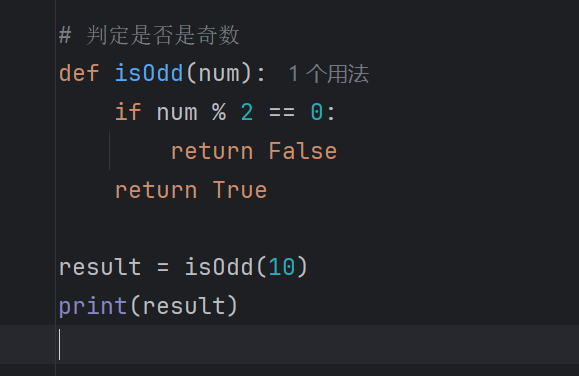
如果 num 是偶数, 则进入 if 之后, 就会触发 return False , 也就不会继续执行 return True
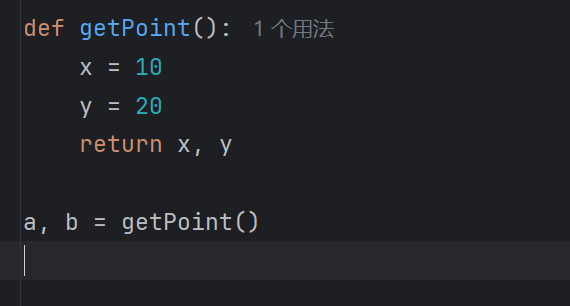
(3)一个函数是可以一次返回多个返回值的. 使用 , 来分割多个返回值.
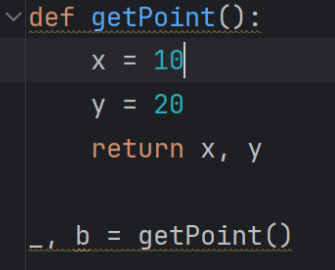
(4)如果只想关注其中的部分返回值, 可以使用 _ 来忽略不想要的返回值.
5.变量作用域
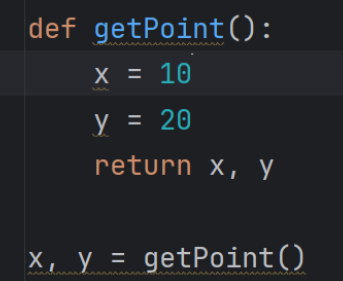
在这个代码中, 函数内部存在 x, y, 函数外部也有 x, y.但是这两组 x, y 不是相同的变量, 而只是恰好有一样的名字.
(1)变量只能在所在的函数内部生效.
在这个函数 getPoint() 内部定义的 x、y 只是在函数内部生效。一旦出了函数的范围,这两个变量就不再生效了。
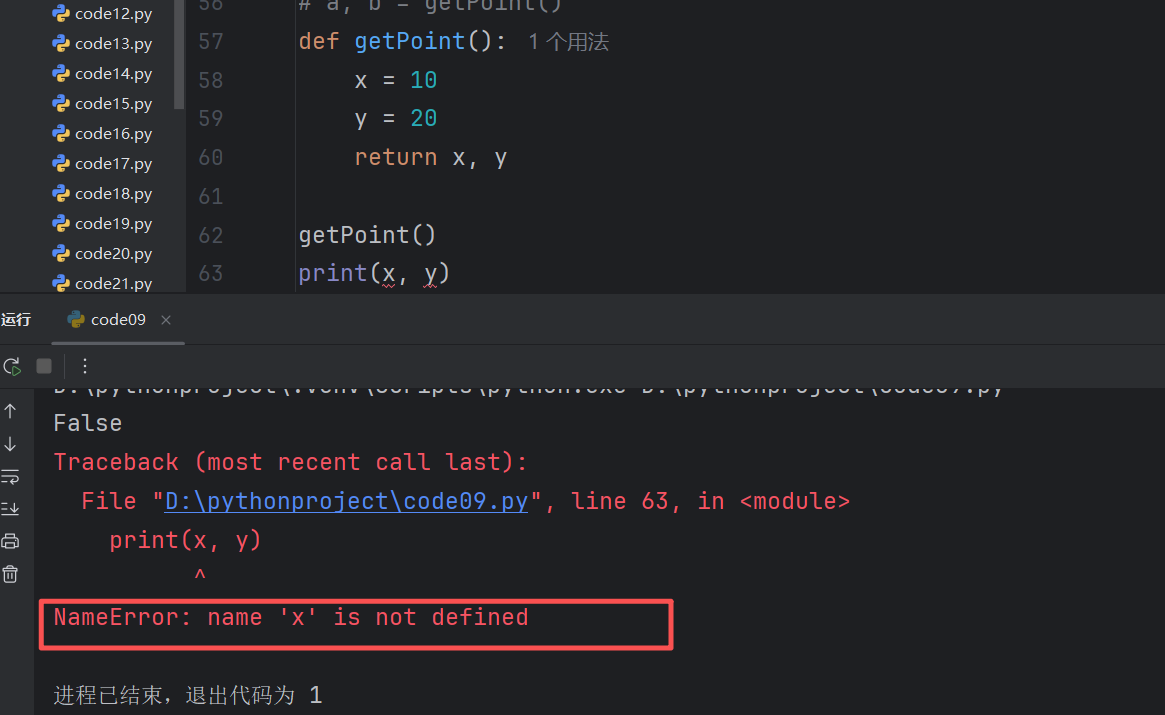
(2)在不同的作用域中允许存在同名的变量
虽然名字相同, 实际上是不同的变量.
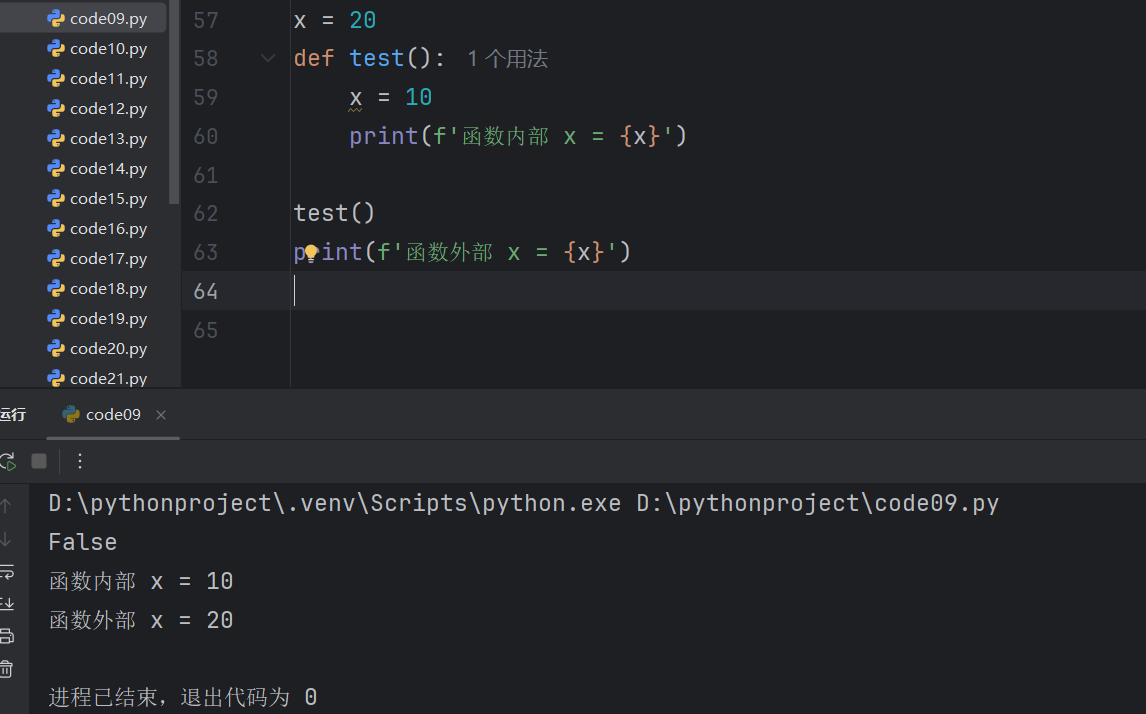
注意:
- 在函数内部的变量也称为 "局部变量"。
- 不在任何函数内部的变量也称为 "全局变量"。
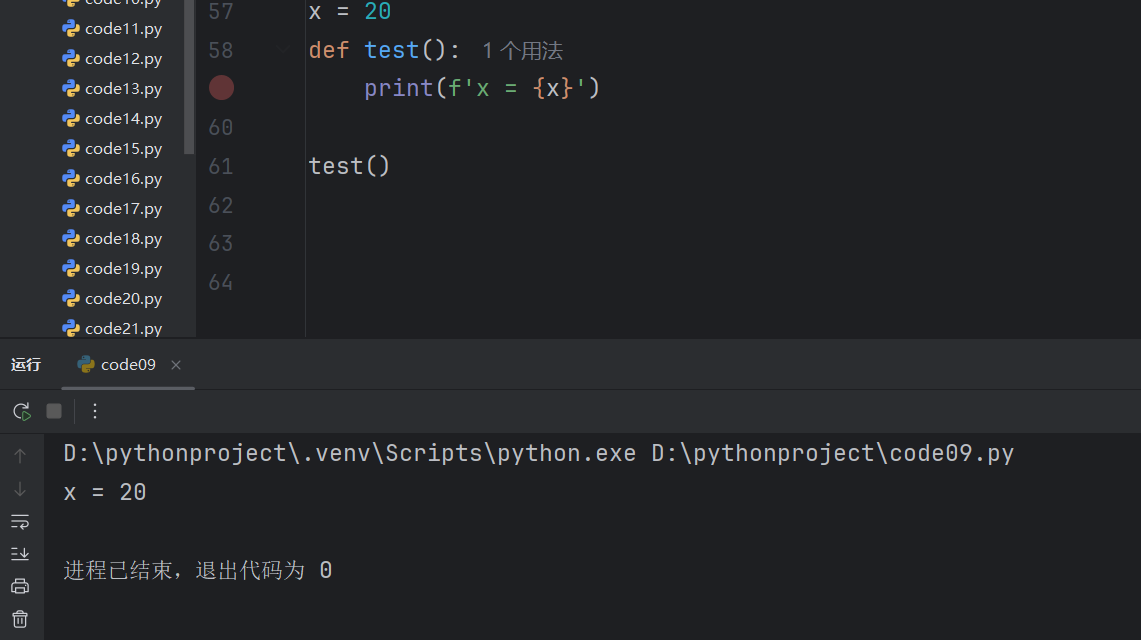
(3)如果函数内部尝试访问的变量在局部不存在,就会尝试去全局作用域中查找
(4)如果是想在函数内部修改全局变量的值,需要使用 global 关键字声明
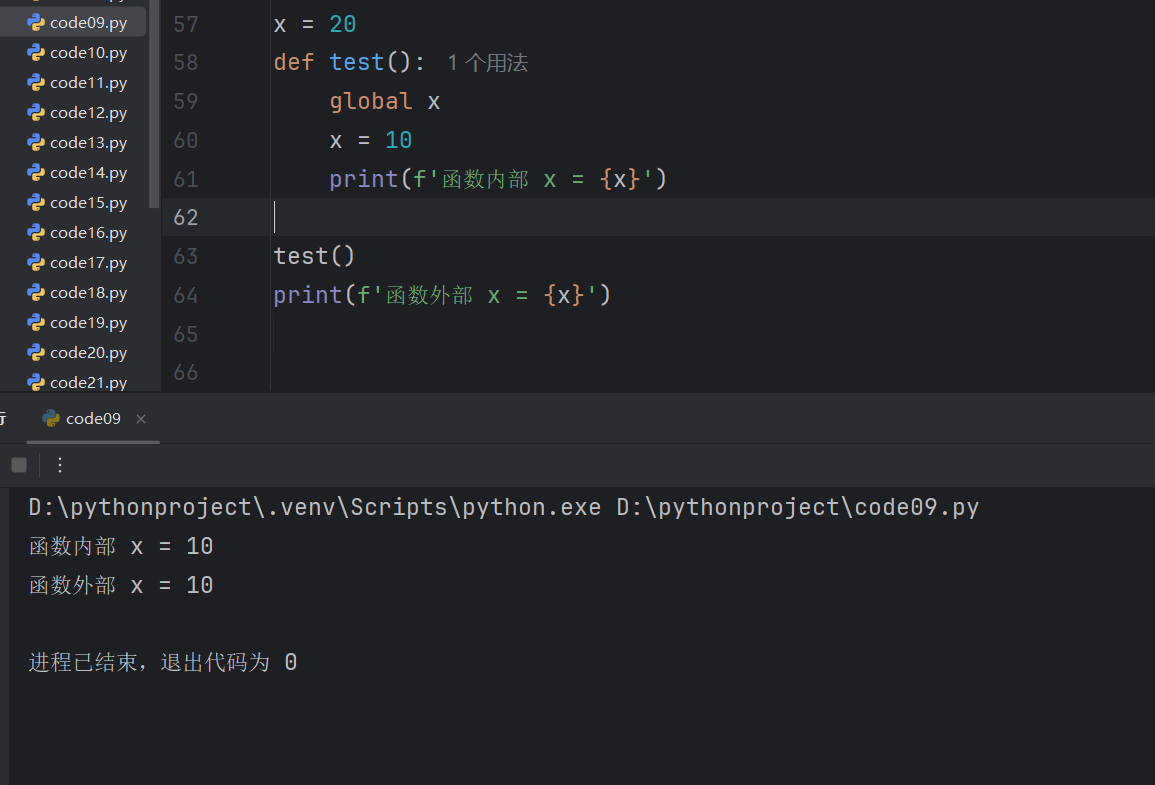
如果此处没有 global,则函数内部的 x = 10 就会被视为是创建一个局部变量 x,这样就和全局变量 x 不相关了。
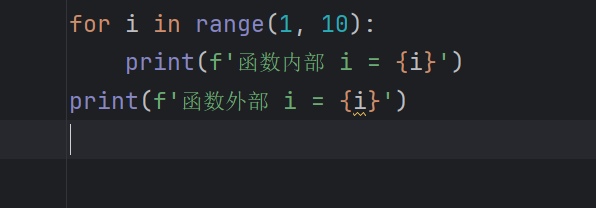
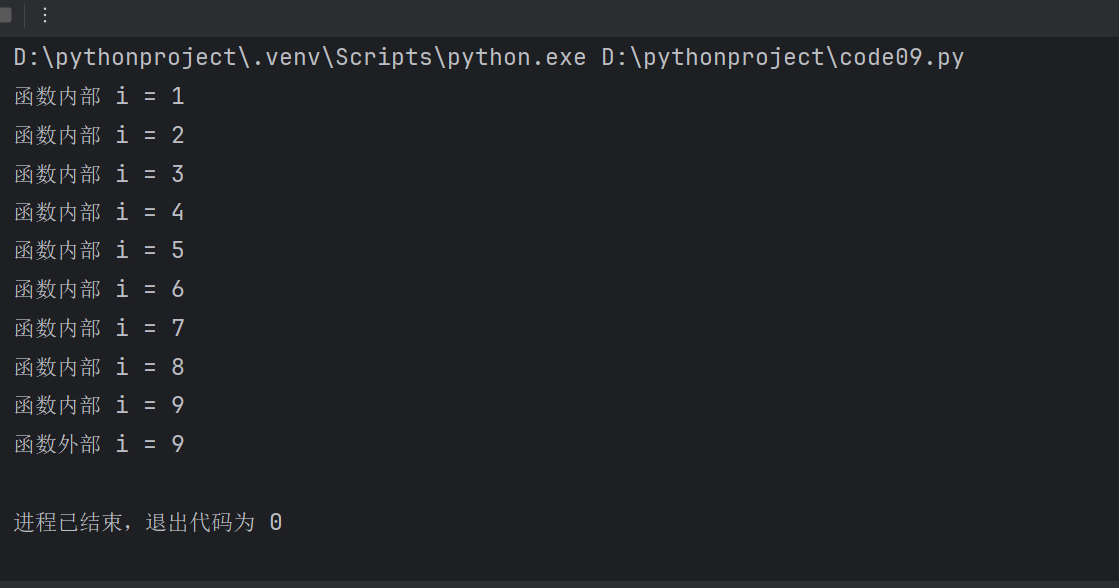
(5)if / while / for 等语句块不会影响到变量作用域
换而言之, 在 if / while / for 中定义的变量, 在语句外面也可以正常使用.
6.函数执行过程
- 调用函数才会执行函数体代码,不调用则不会执行。
- 函数体执行结束(或者遇到 return 语句),则回到函数调用位置,继续往下执行。
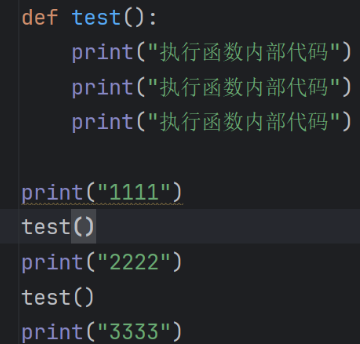
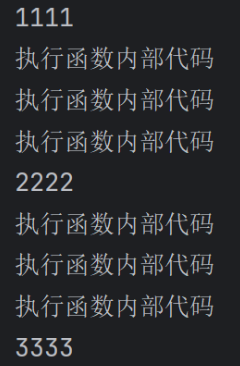
这个过程还可以使用 PyCharm 自带的调试器来观察。
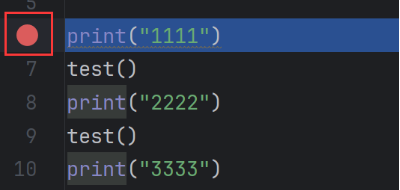
- 点击行号右侧的空白,可以在代码中插入断点。
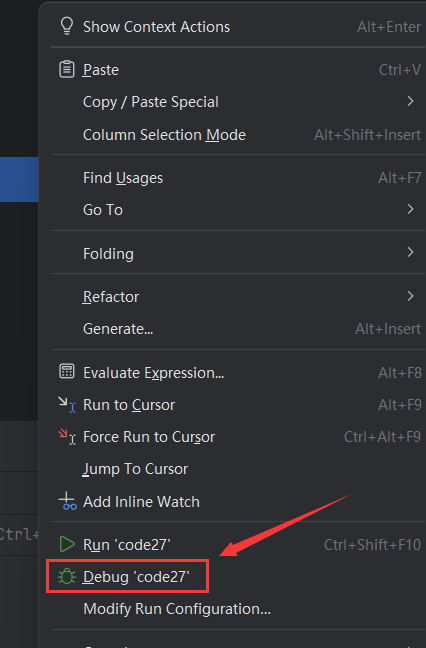
- 右键,Debug,可以按照调试模式执行代码。每次执行到断点,程序都会暂停下来
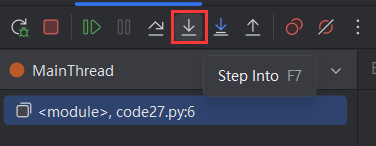
使用 Step Into (F7) 功能可以逐行执行代码
7.链式调用
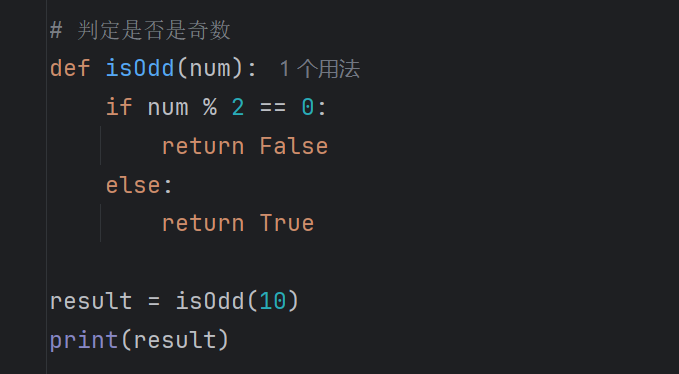
实际上也可以简化成:
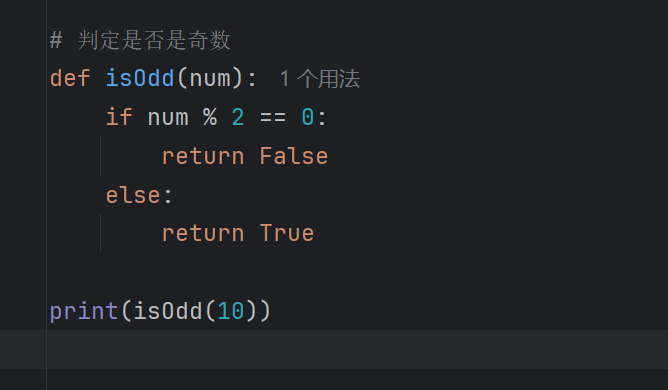
把一个函数的返回值作为另一个函数的参数,这种操作称为链式调用。链式调用先执行 () 里面的函数,再执行外面的函数,换句话说,调用一个函数就需要先对它的参数求值。
8.嵌套调用
函数内部还可以调用其他的函数,这个动作称为 "嵌套调用 "。
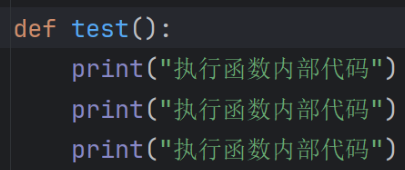
在test函数内部调用了 print 函数,这里就属于嵌套调用。
(1)一个函数里面可以嵌套调用任意多个函数
函数嵌套的过程是非常灵活的.
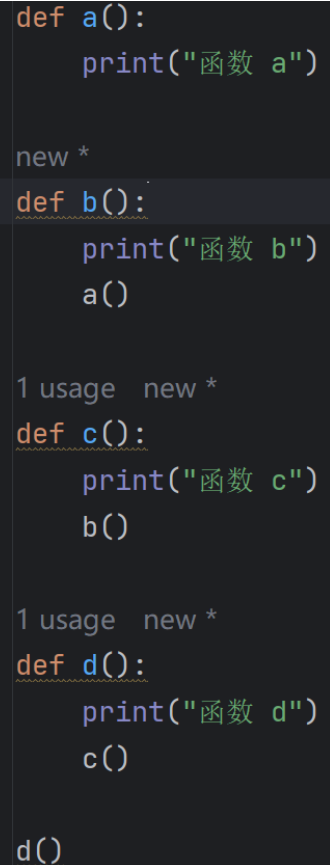
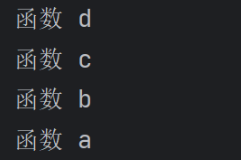
接下来我们对代码进行微微调整,打印结果则可能发生很大变化:
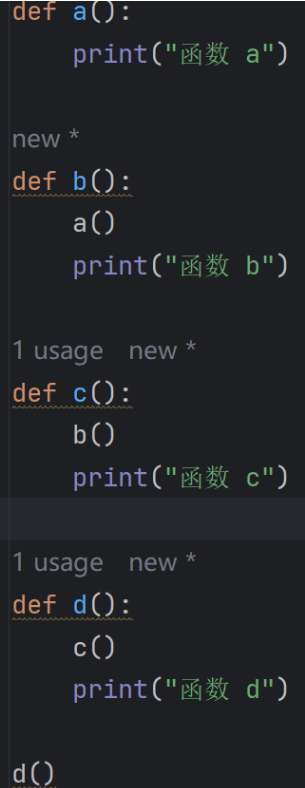
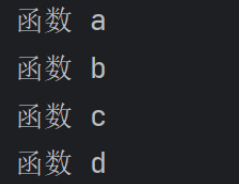
函数之间的调用关系,在 Python 中会使用一个特定的数据结构来表示,称为函数调用栈****。 每次函数调用,都会在调用栈里新增一个元素,称为栈帧****。
我们可以通过 PyCharm 调试器看到函数调用栈和栈帧。接下来,在调试状态下,PyCharm 左下角一般就会显示出函数调用栈。
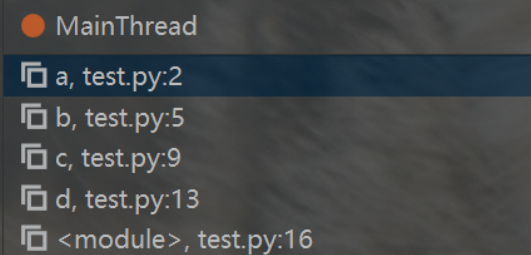
(2)每个函数的局部变量,都包含在自己的栈帧中
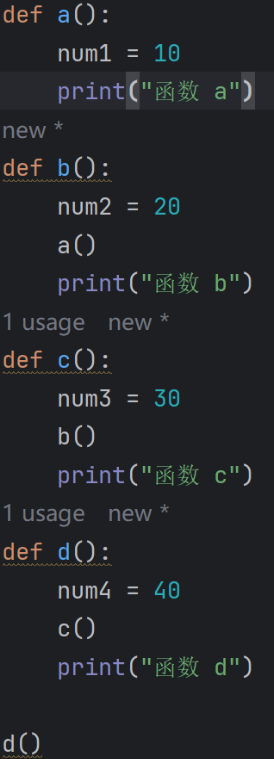
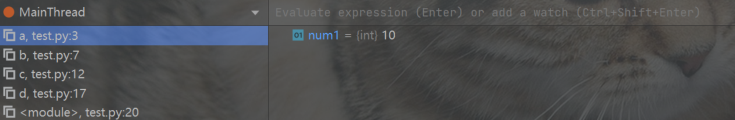
选择不同的栈帧就可以看到各自栈帧中的局部变量。
上述代码,a、b、c、d 函数中的局部变量名各不相同。
思考: 上述代码, a, b, c, d 函数中的局部变量名各不相同. 如果变量名是相同的, 比如都是 num , 那么这四个函数中的 num 是属于同一个变量, 还是不同变量呢?
答:虽然每个变量同名,但是它们是不同变量,属于不同的函数作用域,每个变量保存在各自的栈帧中(每个栈帧也是保存在内存上),变量本质就是一块内存空间。
9.函数递归
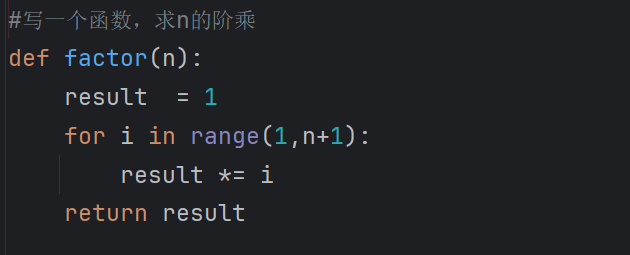
递归是嵌套调用中的一种特殊情况,即一个函数嵌套调用自己:
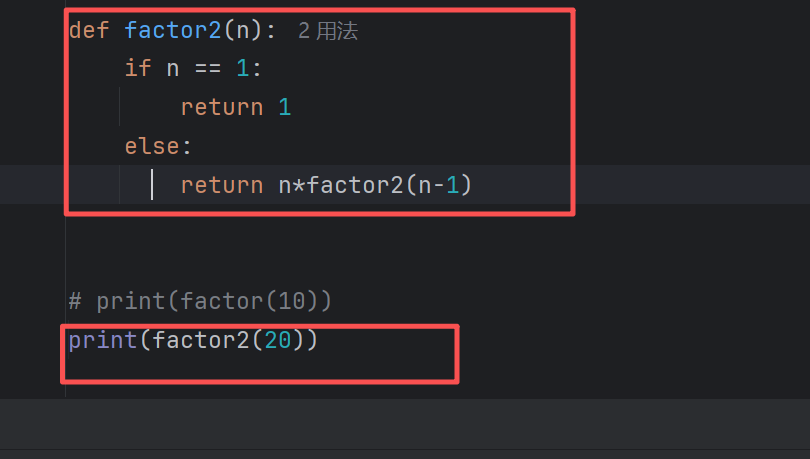
注意 :递归代码务必要保证存在递归结束条件 。比如 if n == 1 就是结束条件,当 n 为 1 的时候,递归就结束了。每次递归的时候,要保证函数的实参是逐渐逼近结束条件的。
如果上述条件不能满足, 就会出现 "无限递归" . 这是一种典型的代码错误.
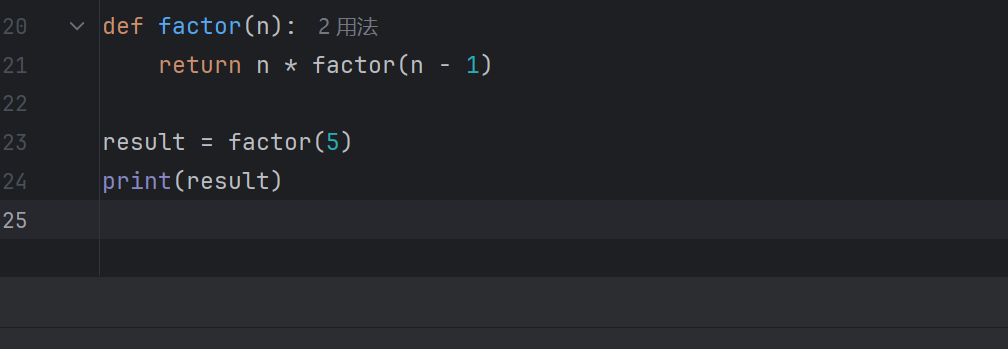
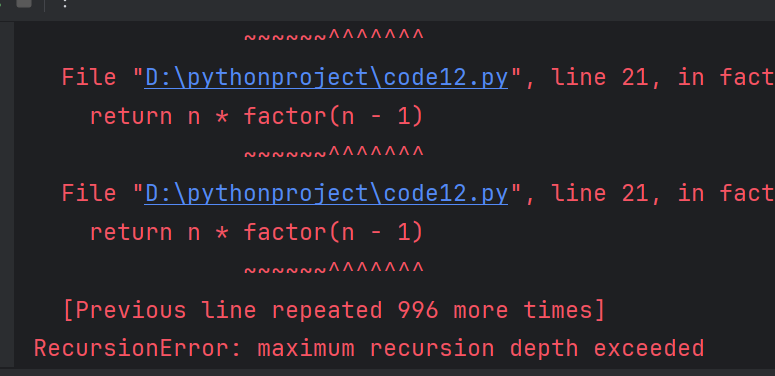
如前面所描述,函数调用时会在函数调用栈中记录每一层函数调用的信息,但是函数调用栈的空间不是无限大的。如果调用层数太多就会超出栈的最大范围,导致出现问题。
(1)递归的优点
- 递归类似于 "数学归纳法" , 明确初始条件, 和递推公式, 就可以解决一系列的问题.
- 递归代码往往代码量非常少.
(2)递归的缺点
- 递归代码往往难以理解, 很容易超出掌控范围
- 递归代码容易出现栈溢出的情况
- 递归代码往往可以转换成等价的循环代码. 并且通常来说循环版本的代码执行效率要略高于递归版本.
际开发的时候, 使用递归要慎重!
10.参数默认值
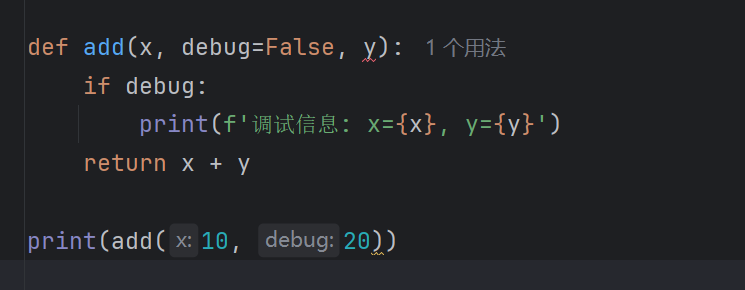
Python 中的函数, 可以给形参指定默认值.带有默认值的参数, 可以在调用的时候不传参.
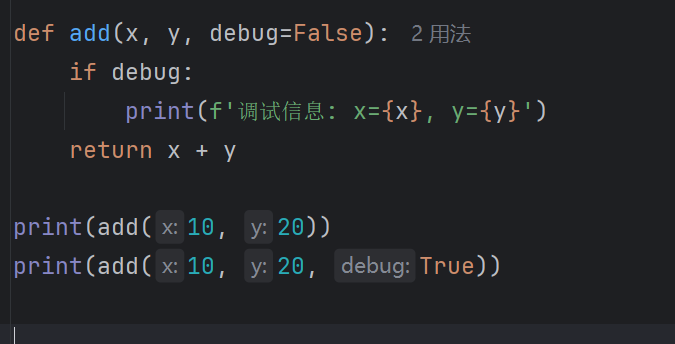
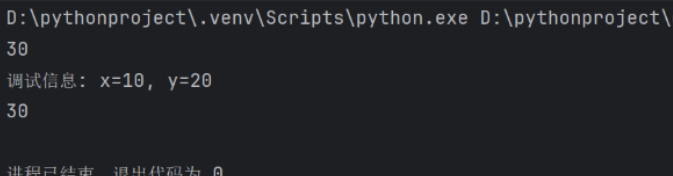
此处 debug=False 即为参数默认值。当我们不指定第三个参数的时候,默认 debug 的取值即为 False。
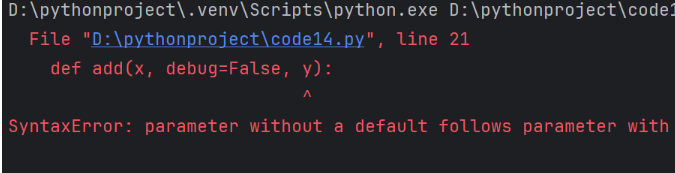
带有默认值的参数需要放到没有默认值的参数的后面
11.关键字参数
在调用函数的时候,需要给函数指定实参。一般默认情况下是按照形参的顺序来依次传递实参的。
但是我们也可以通过关键字参数来调整这里的传参顺序,显式指定当前实参传递给哪个形参。
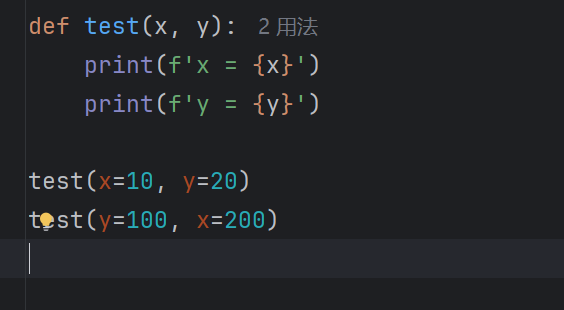
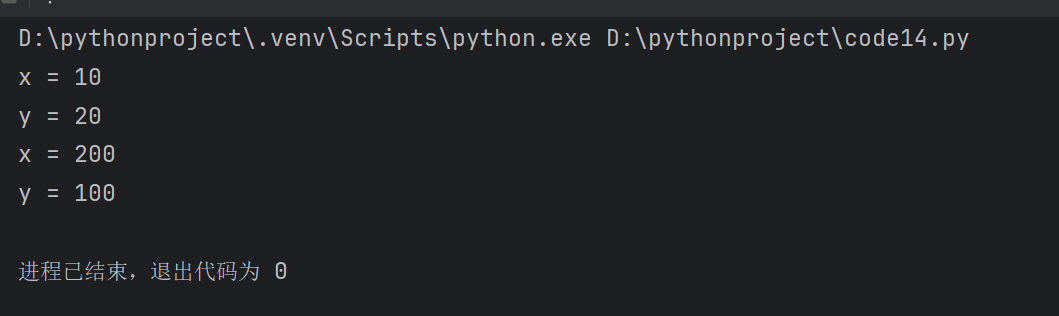
形如上述 test(x=10, y=20) 这样的操作, 即为 关键字参数.
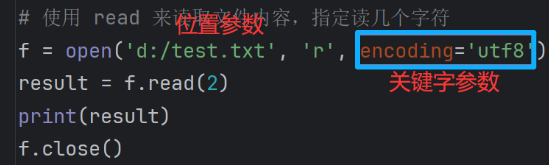
按照先后顺序传递实参,这种传参方式叫做位置参数。位置参数和关键字参数可以混合使用,但有硬性要求:位置参数必须写在关键字参数前面。
关键字参数经常和默认参数搭配使用。 一个函数可以设置多个参数,用来调整函数内部的行为。为了降低调用者的使用成本,我们可以给大部分参数设置默认值。 当调用者只需要修改其中少数几个参数时,就可以使用关键字参数单独指定要修改的项,不用把所有参数都完整传入。
12.小结
函数是编程语言中的一个核心语法机制. Python 中的函数和大部分编程语言中的函数功能都是基本类似的.
我们当下最关键要理解的主要就是三个点:
- 函数的定义
- 函数的调用
- 函数的参数传递
我们在后续的编程中, 会广泛的使用到函数. 大家在练习的过程中再反复加深对于函数的理解.
二.列表和元组
1.列表是什么, 元组是什么
编程中, 经常需要使用变量, 来保存/表示数据.
如果代码中需要表示的数据个数比较少, 我们直接创建多个变量即可.
python
num1 = 10
num2 = 20
num3 = 30
......
但是有的时候, 代码中需要表示的数据特别多, 甚至也不知道要表示多少个数据. 这个时候, 就需要用到列表.
(1)列表是一种让程序猿在代码中批量表示/保存数据的方式
就像我们去超市买辣条, 如果就只是买一两根辣条, 那咱们直接拿着辣条就走了.
但是如果一次买个十根八根的, 这个时候用手拿就不好拿, 超市老板就会给我们个袋子.
这个袋子, 就相当于 列表
(2)元组和列表相比, 是非常相似的, 只是列表中放哪些元素可以修改调整, 元组中放的元素是创建元组的时候就设定好的, 不能修改调整.
列表就是买散装辣条, 装好了袋子之后, 随时可以把袋子打开, 再往里多加辣条或者拿出去一些辣条.元组就是买包装辣条, 厂家生产好了辣条之后, 一包就是固定的这么多, 不能变动了.
二者最大的区别:列表中放哪些元素可以修改调整,元组中放的元素是创建元组的时候就设定好的,不能修改调整。
2.创建列表
- 创建列表主要有两种方式。
(1) 表示一个空的列表
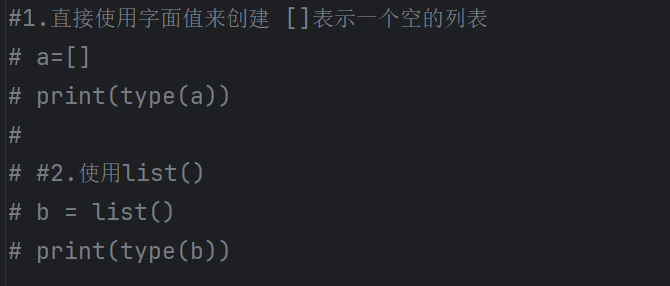
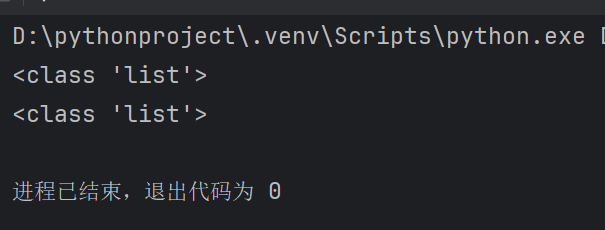
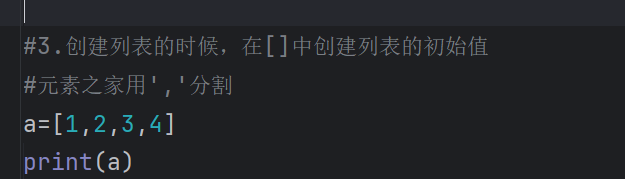
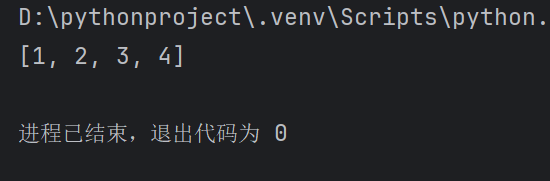
(2)如果需要往里面设置初始值,可以直接写在 当中
可以直接使用 print 来打印 list 中的元素内容。
(3)列表中存放的元素允许是不同的类型
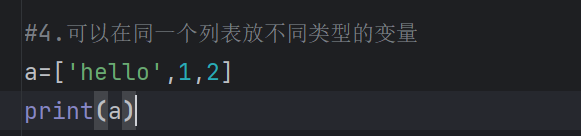
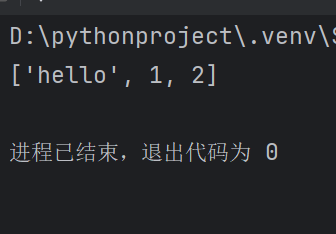
这一点和 C++、Java 差别较大。
注意:因为 list 本身是 Python 中的内建函数,不宜再使用 list 作为变量名,因此命名为 a。
3.访问下标
(1)可以通过下标访问操作符 来获取到列表中的任意元素
把 中填写的数字称为下标或者索引。
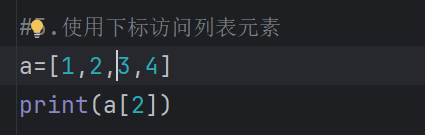
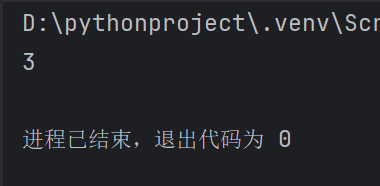
注意 :下标是从 0 开始计数的,因此下标为 2,则对应着 3 这个元素。
(2)通过下标不光能读取元素内容,还能修改元素的值
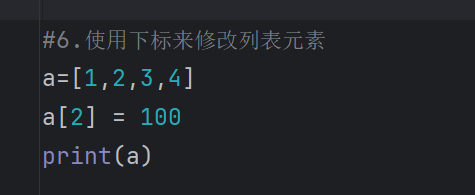
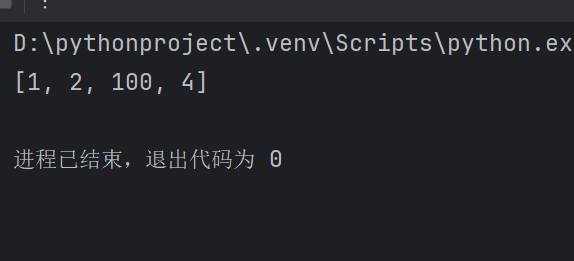
(3)如果下标超出列表的有效范围,会抛出异常
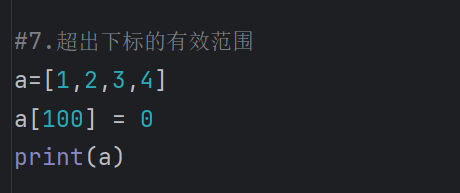
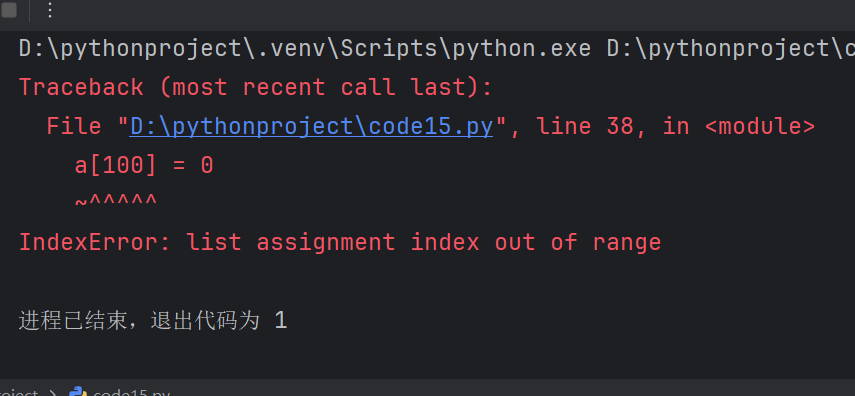
(4)因为下标是从 0 开始的,因此下标的有效范围是 0, 列表长度 - 1。使用 len 函数可以获取到列表的元素个数
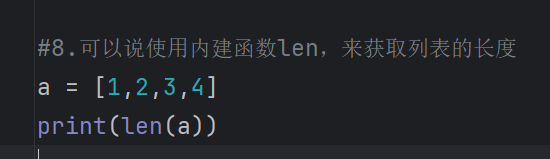
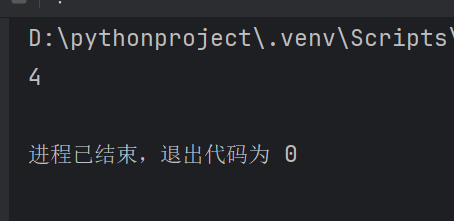
len 可以传字符串、列表、元组、字典、自定义的类 。(动态类型)
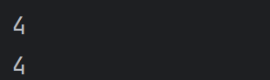
(5)下标可以取负数,表示 "倒数第几个元素"
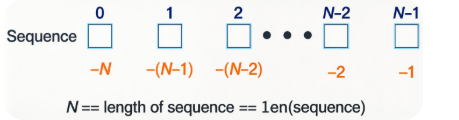
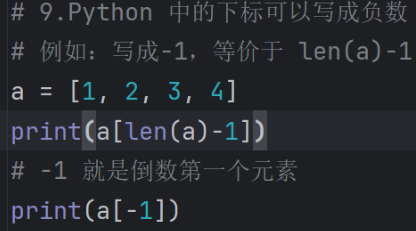
4.切片操作
通过下标操作是一次取出里面第一个元素。
通过切片,则是一次取出一组连续 的元素,相当于得到一个子列表。
(1)使用 : 的方式进行切片操作
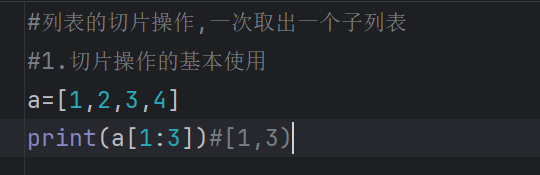
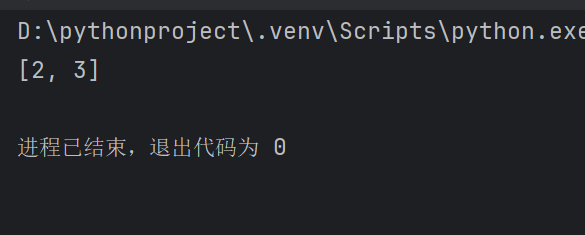
a1:3 中的 1:3 表示的是 [1, 3) 这样的由下标构成的前闭后开区间,也就是从下标为 1 的元素开始(2),到下标为 3 的元素结束(4),但是不包含下标为 3 的元素,所以最终结果只有 2,3。
(2)切片操作中可以省略前后边界
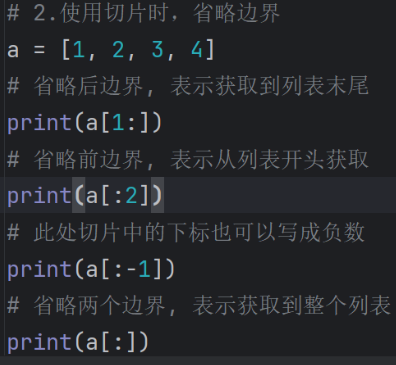
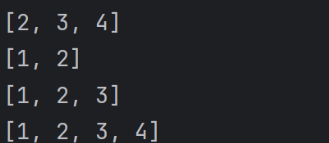
切片操作是一个比较高效的操作。进行切片时,只是取出了原有列表中的一个部分,并不涉及到 "数据的拷贝"。假设有一个很大的列表进行切片,切片的范围也很大,即使如此,切片操作仍然非常高效。
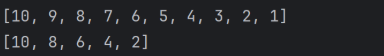
(3)切片操作还可以指定 "步长",也就是 "每访问一个元素后,下标自增几步"
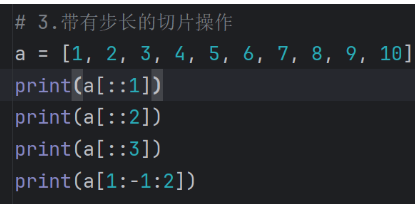
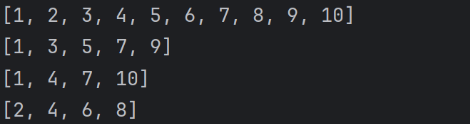
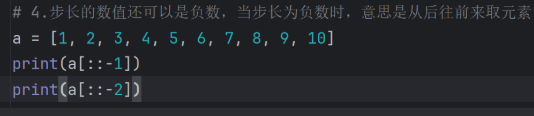
(4)切片操作指定的步长还可以是负数,此时是从后往前进行取元素,表示 "每访问一个元素之后,下标自减几步"
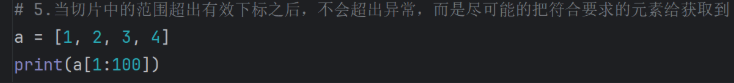
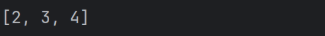
(5)如果切片中填写的数字越界了,不会有负面效果,只会尽可能的把满足条件的元素过去到
5.遍历列表元素
"遍历 " 指的是把元素一个一个的取出来,再分别进行处理。
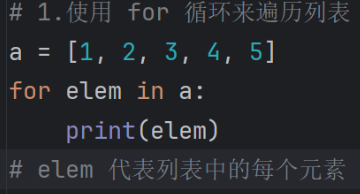
(1)for 循环(最常用)
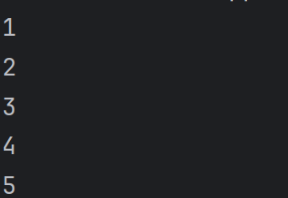
(2)使用 for 按照范围生成下标,按下标访问
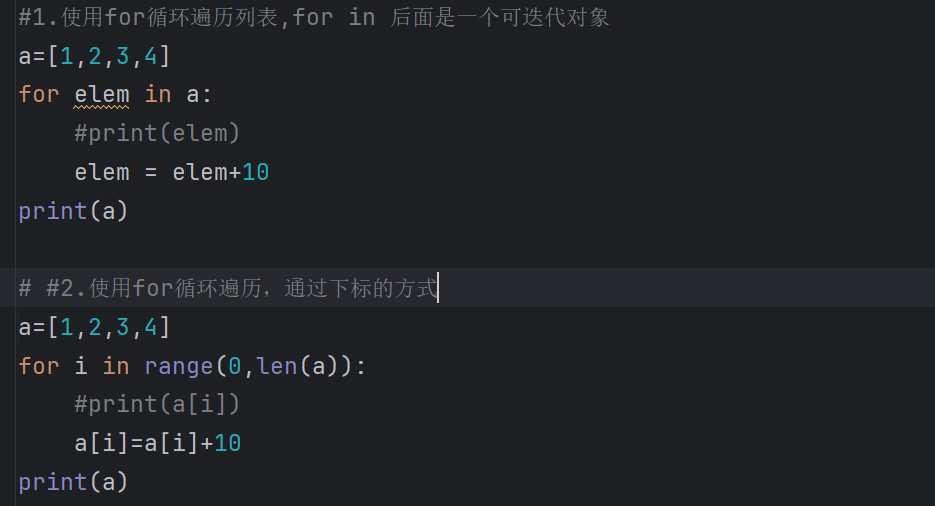
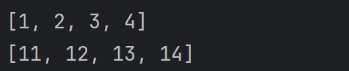
注意两种不同赋值的写法
(1) 修改临时变量
(2) 修改下标的赋值,才会修改列表本身
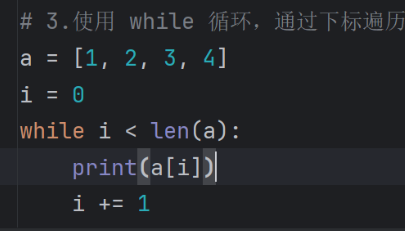
(3)使用 while 循环,手动控制下标的变化
6.新增元素
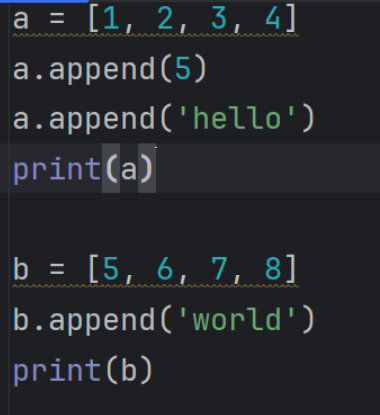
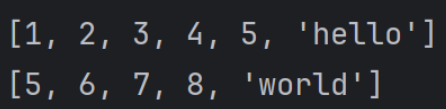
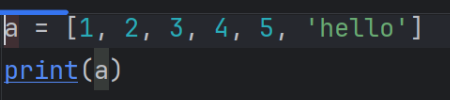
(1)使用 append 方法向列表末尾插入一个元素(尾插)
此处的 append 是搭配列表对象 a 来一起使用的,而不是作为一个独立的函数。这种要搭配对象来使用的函数(function),也叫作"方法"(method)。
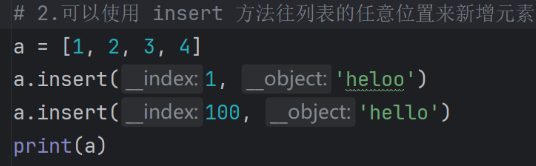
(2)使用 insert 方法向任意位置插入一个元素
insert第一个参数表示要插入元素的下标。

那什么是 "方法"(method)?
方法其实就是函数。只不过函数是独立存在的,而方法往往要依附于某个 "对象"。
像上述代码 a.append,append 就是依附于 a,相当于是 "针对 a 这个列表进行尾插操作"。
7.查找元素
(1)使用 in 操作符判定元素是否在列表中存在,返回值是布尔类型
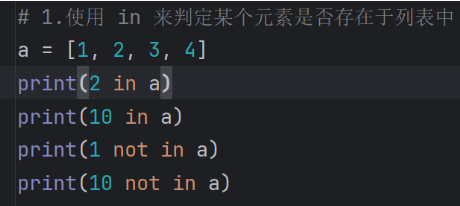
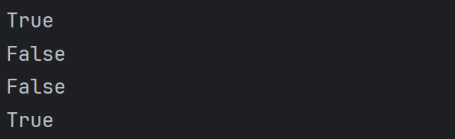
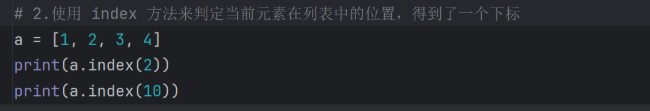
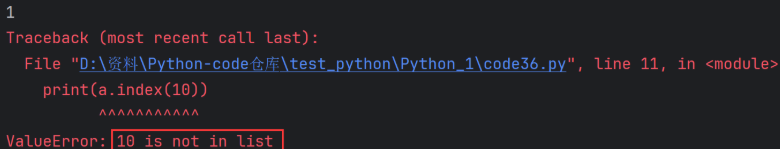
(2)使用 index 方法查找元素在列表中的下标,返回值是一个整数。如果元素不存在,则会抛出异常
8.删除元素
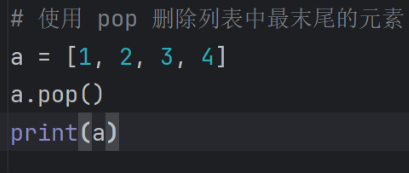
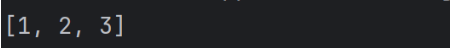
(1)使用 pop方法删除最末尾元素
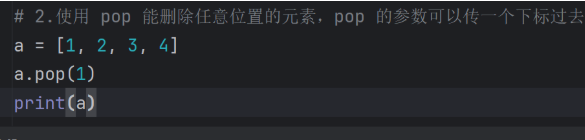
(2)pop 也能按照下标来删除元素

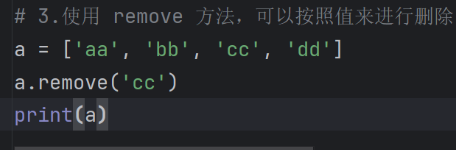
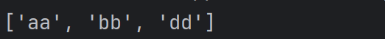
(3)使用 remove 方法,按照值删除元素
9.连接列表
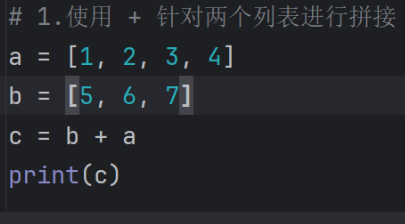
(1)使用 + 能够把两个列表拼接在一起
此处的 + 结果会生成一个新的列表,而不会影响到旧列表的内容。
(2)使用 extend 方法,相当于把一个列表拼接到另一个列表的后面
a.extend(b),是把 b 中的内容拼接到 a 的末尾。不会修改 b,但是会修改 a。
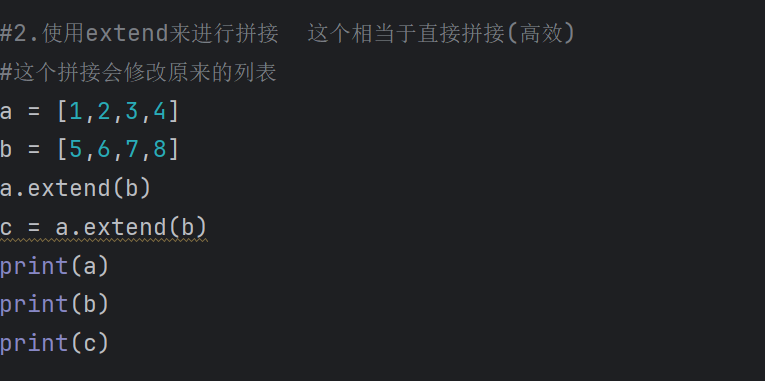
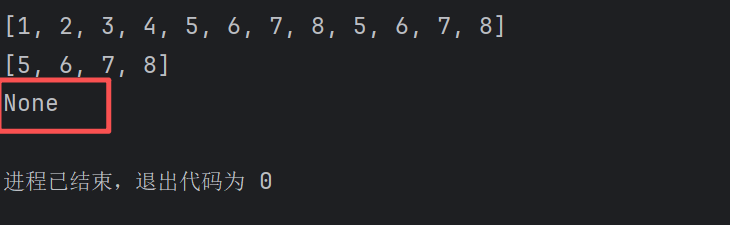
extend()是原地修改列表 ,直接把 b 里面所有元素追加到 a 中,返回值为 None,不能用变量接收它的结果,类似于Java中的null,C语言中的NULL。
不需要数据拷贝和释放。
(3)使用 += 能够把两个列表拼接在一起
需要进行数据拷贝和释放。
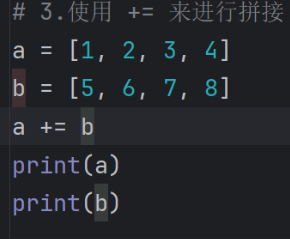
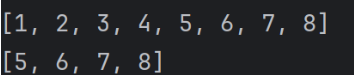
a +=b 等价于 a = a + b
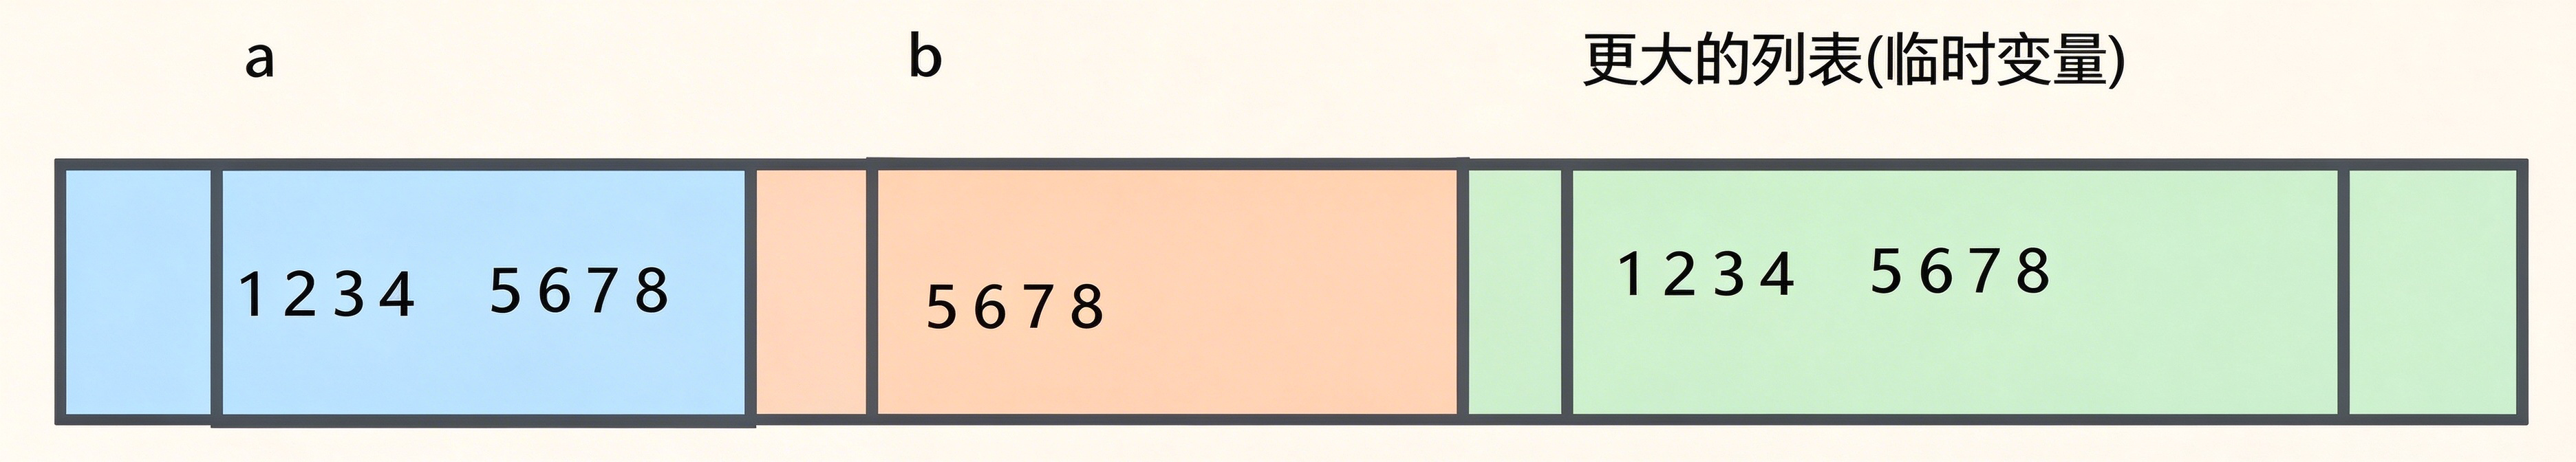
这里相比 extend,+= 多了 3 步操作:
- 构造新的大列表
- 把大列表中的值赋值给 a
- 把 a 的旧值进行释放
10.关于元组
元组的功能和列表相比,基本是一致的。
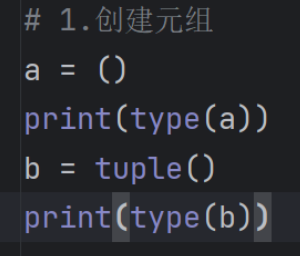
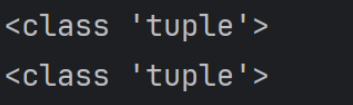
(1)创建元组
我们的元组使用 ( ) 来表示:
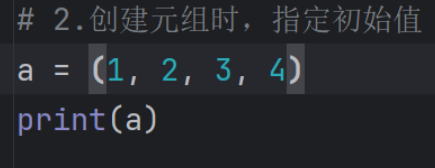
(2)在创建元组时就指定初始值
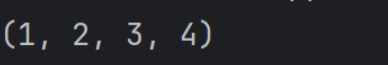
(3)元组中的元素可以是任意类型的
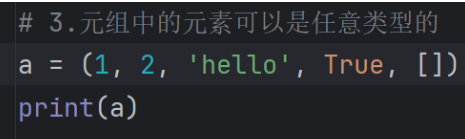
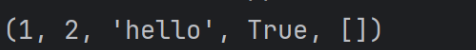
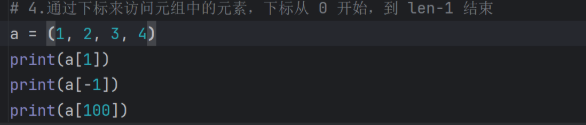
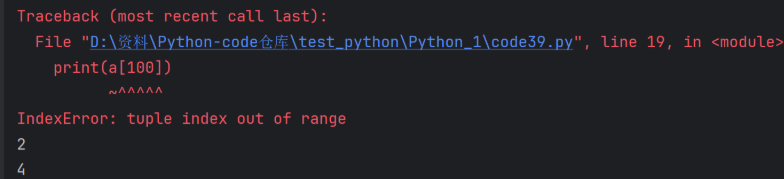
(4)通过下标来访问元组中的元素,下标从 0 开始,到 len-1 结束
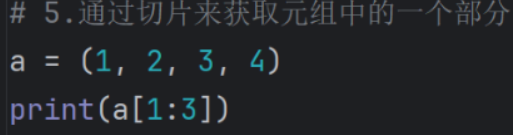
(5)通过切片来获取元组中的一个部分

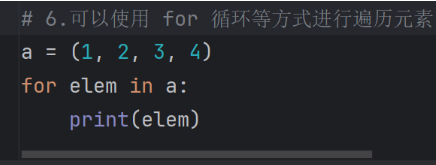
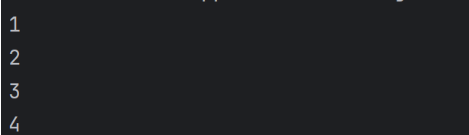
(6)可以使用 for 循环等方式进行遍历元素
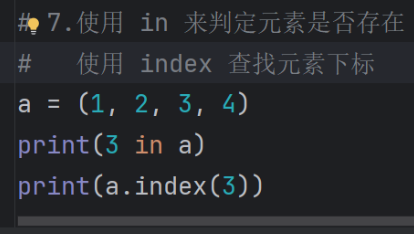
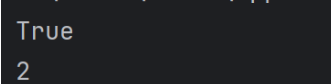
(5)使用 in 来判定元素是否存在 & 使用 index 查找元素下标
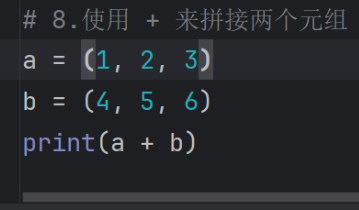
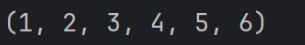
(6)使用 + 来拼接两个元组
(7)元组不能修改里面的元素,列表则可以修改里面的元素
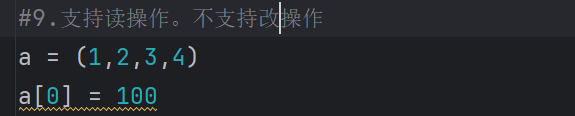
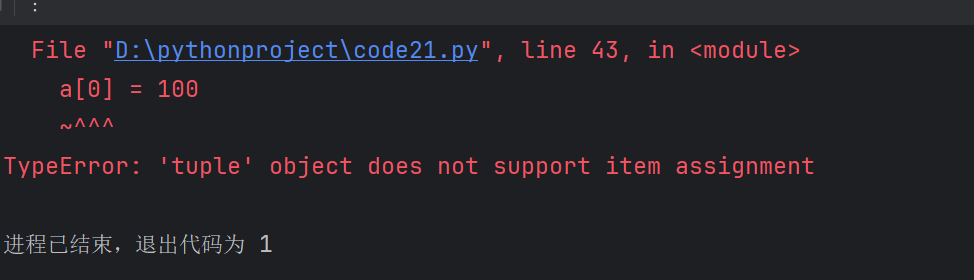
因此,像读操作,比如访问下标、切片、遍历、in、index、+ 等,元组也是一样支持的。但是像写操作,比如修改元素、新增元素、删除元素、extend 等,元组则不能支持。
(8)元组在 Python 中很多时候是默认的集合类型
例如,当一个函数返回多个值的时候:
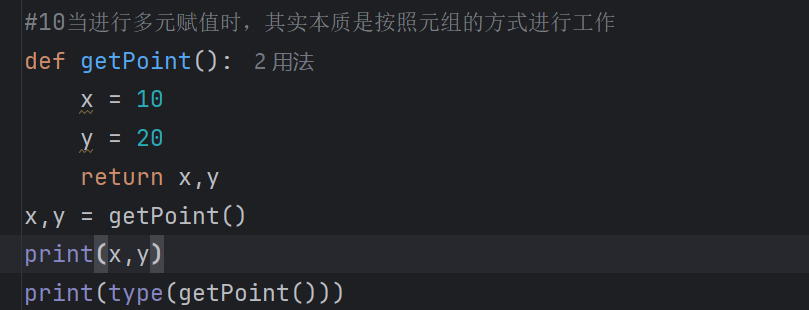
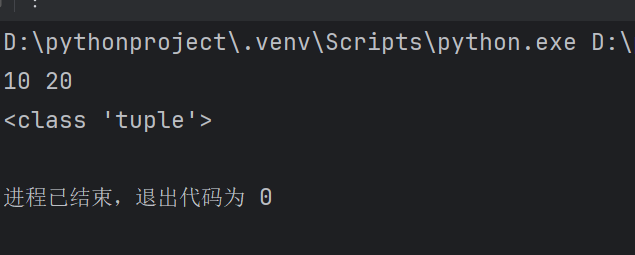
此处的 getPoint() 的类型其实是元组。
既然已经有了列表,为什么还需要有元组呢?
元组相比于列表来说,优势有两方面:
- 假如你有一个列表,现在需要调用一个函数进行一些处理。但你不是特别确认这个函数是否会把你的列表数据弄乱,那么这个时候选择传一个元组(不可变对象,可以 hash,可作为字典的键)就会安全很多。
- 下面要学习的字典,它是一个键值对结构,要求字典的键必须是 "可 hash 对象"(字典本质上也是一个 hash 表 ),而一个可 hash 对象的前提就是不可变,因此元组可以作为字典的键,但是列表不行。
11.小结
- 列表和元组都是日常开发最常用到的类型,最核心的操作就是根据 来按下标操作。
- 在需要表示一个 "序列" 的场景下,就可以考虑使用列表和元组。
- 如果元素不需要改变,则优先考虑元组。
- 如果元素需要改变,则优先考虑列表。
三.字典
1.字典是什么
字典是一种存储键值对的结构。
什么是键值对?
这是计算机 / 生活中一个非常广泛使用的概念。把键(key)和值(value)进行一个一对一的映射,然后就可以根据键快速找到值。
举例:学校的每个同学都会有一个唯一的学号。知道了学号,也就能确定是哪个同学。此处 "学号" 就是 "键",这个 "同学" 就是 "值"。
注意:在 Python 的字典中,可以同时包含很多个键值对,同时要求这些键不能重复。
创建字典
A. 创建一个空的字典. 使用 { } 表示字典
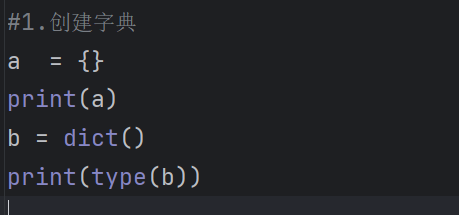
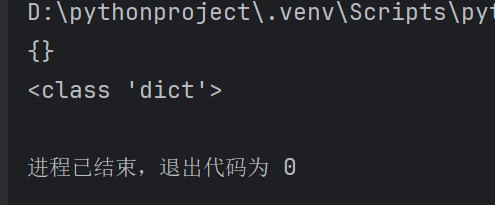
B. 在创建的同时指定初始值
键值对之间使用 ',' 分割,键和值之间使用 : 分割(冒号后面推荐加一个空格)
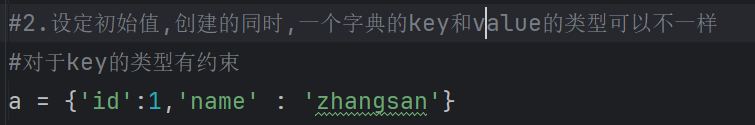
- 一个字典中的 key 的类型不一定都相同,一个字典中的 value 的类型也不需要都一样。
- 字典对于 key 是什么类型,有做约束;对于 value 是什么类型,没有做约束
同时为了使代码更规范美观,在创建字典的时候往往会把多个键值对,分成多行来书写:
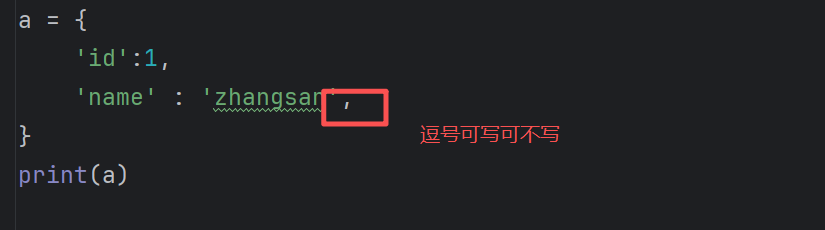
注意:最后一个键值对后面可以写 ',',也可以不写。
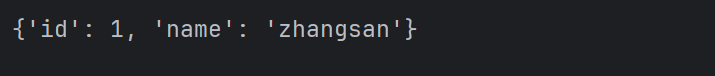
使用 print 来打印字典内容:
2.查找 key
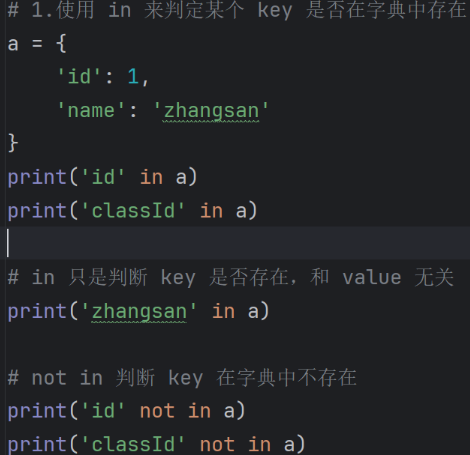
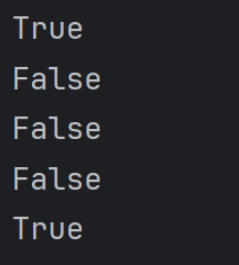
(1)使用 in 可以判定 key 是否在字典中存在,返回布尔值
(2)使用 通过类似于取下标的方式获取到元素的值,只不过此处的 "下标" 是 key(可能是整数,也可能是字符串等其他类型)
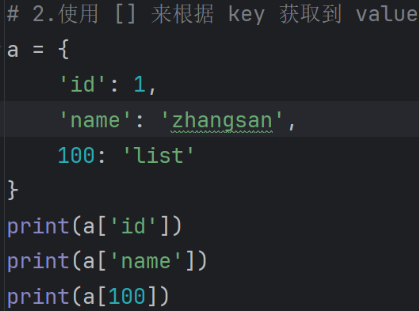
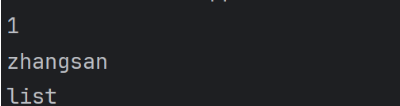
- 对于字典来说,使用 in 或者 来获取 value 都是非常高效的操作(字典背后使用了特殊的数据结构:哈希表)。
- 对于列表来说,使用 in 是比较低效的(需要把整个列表遍历一遍),而是使用 是比较高效的(类似于数组 / 顺序表取下标)。
(3)如果 key 在字典中不存在,就会抛出异常
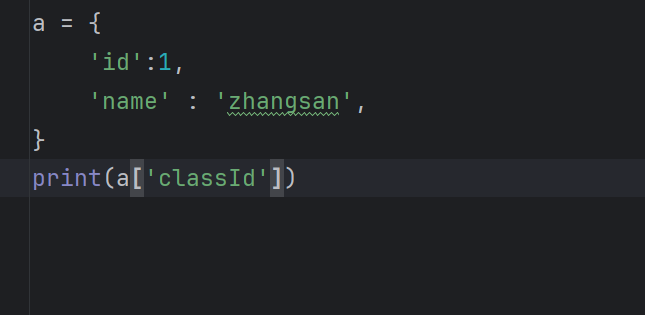
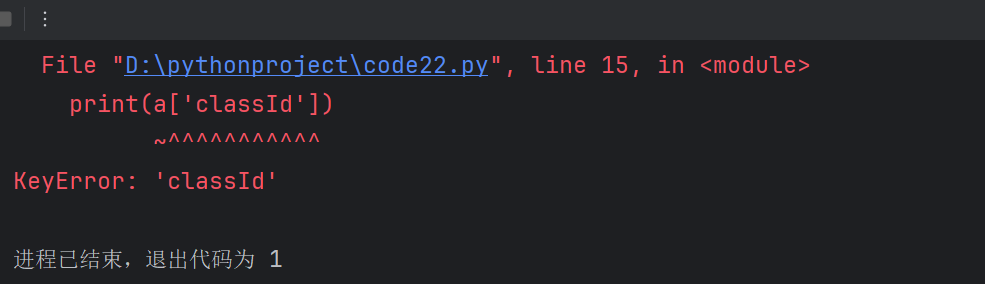
3.新增 / 修改元素
使用 可以根据 key 来新增 / 修改 value。
(1)如果 key 不存在,对取下标操作赋值,即为新增键值对
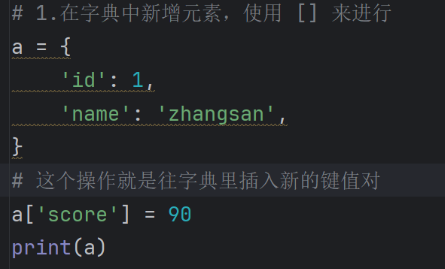

(2)如果 key 已经存在,对取下标操作赋值,即为修改键值对的值
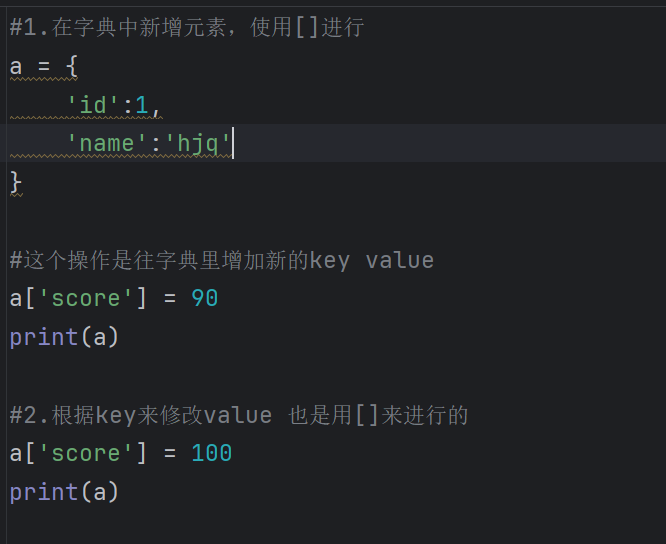
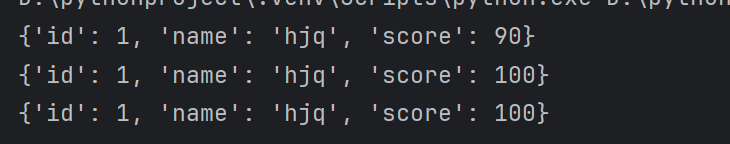
以上两种都是写操作。
4.删除元素
使用 pop 方法根据 key 删除对应的键值对
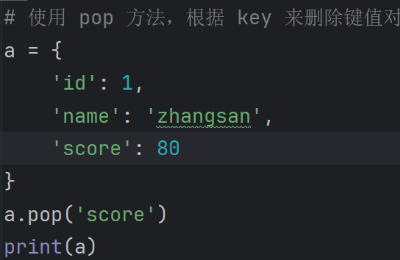

字典中的各种操作**(新增、删除、获取 value、修改 value)**都是针对 key 来进行的。
5.遍历字典元素
遍历指依次取出可迭代对象中的每一个元素并执行对应操作,要求做到不重不漏。
字典设计的核心目的并不是遍历,而是高效完成增删改查。字典底层基于哈希表实现,哈希表结构设计巧妙,增、删、改、查都可以在常数级时间复杂度下完成,查询性能极高。相对而言,字典做遍历操作的效率会更低一些。
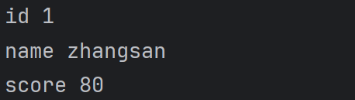
直接使用 for 循环能够获取到字典中的所有的 key,进一步的就可以取出每个值了
在 C++ / Java 里,哈希表存储的键值对是无序的,遍历顺序和元素插入顺序没有关系。但 Python 的字典有所不同,Python 对字典底层做了特殊处理,可以保证字典遍历的顺序和元素插入顺序保持一致。因此 Python 的字典并不是单纯传统意义上的哈希表。Python3.7 及以上版本,字典正式保证插入有序;3.6 版本只是底层实现上碰巧有序,规范文档还没有把有序定为标准。
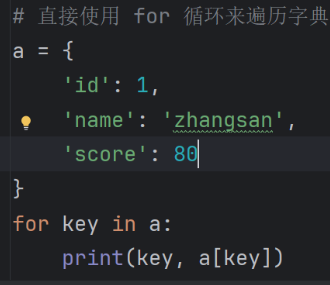
6.取出所有 key 和 value
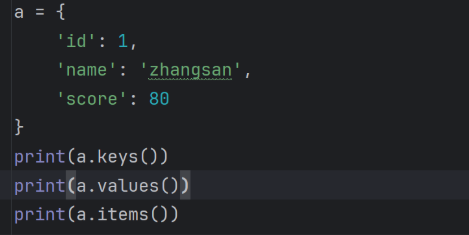
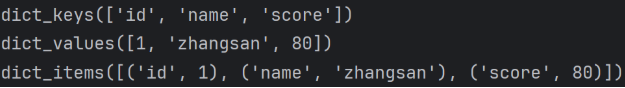
此处 dict_keys 是一种特殊类型,专门用来表示字典全部的 key。大部分可迭代、元组相关的操作,dict_keys 都支持。dict_values 和 dict_items 同样属于这类特殊类型,特性与 dict_keys 类似。
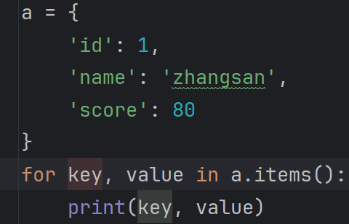
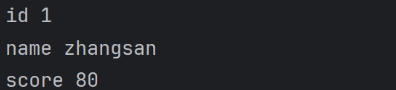
7.合法的 key 类型
不是所有的类型都可以作为字典的 key。
字典本质上 是一个哈希表,哈希表的 key 要求是 "可哈希的 ",也就是可以计算出一个哈希值
- 可以使用 hash 函数计算某个对象的哈希值。
- 但凡能够计算出哈希值的类型, 都可以作为字典的 key。
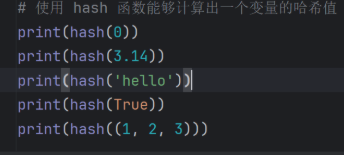
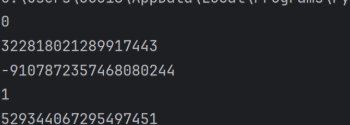
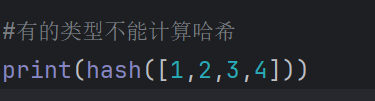
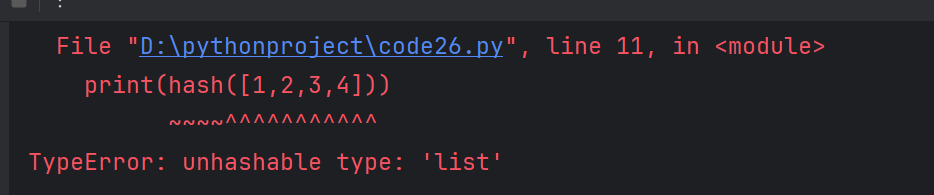
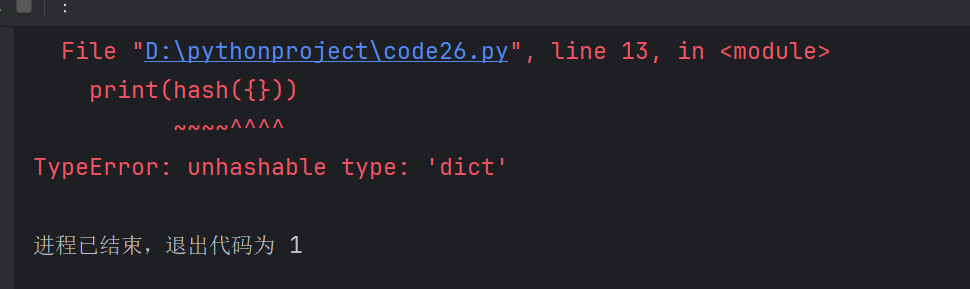
不可变的对象一般就是可哈希的,可变的对象一般就是不可哈希的。
8.小结
- 字典也是一个常用的结构,字典的所有操作都是围绕 key 来展开的。
- 需要表示 "键值对映射" 这种场景时就可以考虑使用字典。
四.文件
1.文件是什么
变量是把数据保存到内存中。如果程序重启 / 主机重启,内存中的数据就会丢失。
要想能让数据被持久化存储,就可以把数据存储到硬盘中,也就是在文件中保存。
在 Windows "此电脑" 中看到的内容都是文件:
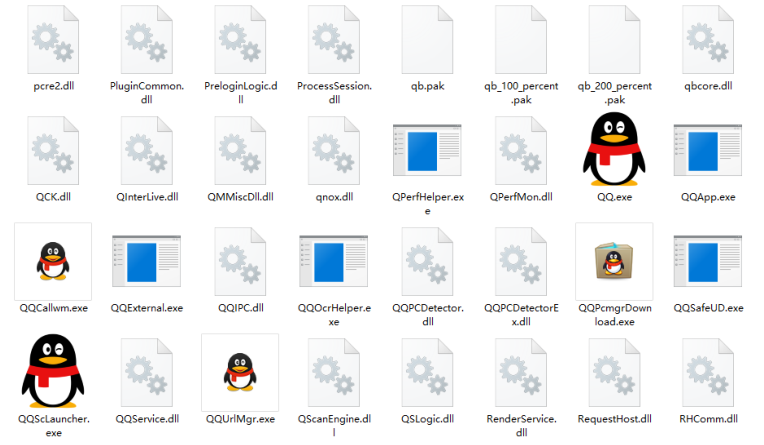
通过文件的后缀名可以看到文件的类型。常见的文件的类型如下:(数据都是保存在硬盘上的)
- 文本文件(文本:txt,表格:xlsx)
- 可执行文件(exe,dll)
- 图片文件(图片:jpg,gif)
- 视频文件(电影:mp4,歌曲:mp3,mov)
- office 文件(.ppt,docx)
- ... ...
存储器分为内存和外存:内存空间更小、访问速度快、成本更高,数据断电丢失;外存以硬盘为代表,空间更大、访问速度慢、成本更低,数据可以持久保存。变量存储在内存当中,文件存储在硬盘当中。 下面主要研究最简单的文本文件。
2.文件路径
一个机器上会存在很多文件,为了让这些文件更方便地被组织,往往会使用很多的 "文件夹"(也叫做目录)来整理文件。 实际一个文件往往是放在一系列的目录结构之中的。
为了方便确定一个文件所在的位置,使用文件路径(一层层目录构成的字符串)来进行描述。
知道了文件路径就可以知道这个文件在硬盘中的详细位置,也就可以进一步访问这个文件里面的数据。 文件路径也可以视为是文件在硬盘上的身份标识,每个文件对应的路径都是唯一的。
例如,QQ.exe 这个文件,可以使用路径 D:\program\qq\Bin\QQ.exe 来描述它的位置: D: 表示盘符,不区分大小写。 每一个 \ 表示一级目录。
当前 QQ.exe 就是放在 "D 盘下的 program 目录下的 qq 目录下的 Bin 目录中"。
目录之间的分隔符可以使用 \ 也可以使用 /,一般在编写代码的时候使用 / 更方便,因为在字符串里 \ 属于转义字符,会有特殊含义。
上述以盘符开头的路径,称为绝对路径。
除了绝对路径之外,还有一种常见的表示方式是相对路径。
相对路径需要先指定一个基准目录,然后以基准目录为参照点,间接找到目标文件。 描述一个文件的位置,使用绝对路径和相对路径都是可以的。不过,使用绝对路径更简单更好理解,也不容易出错。
3.文件操作
要使用文件, 主要是通过文件来保存数据, 并且在后续把保存的数据读取出来.
但是要想读写文件, 需要先 "打开文件", 读写完毕之后还要 "关闭文件".
(1)打开文件
使用内建函数 open打开一个文件:
python
f = open('d:/test.txt', 'r')
print(f)
print(type(f))
open 的返回值是一个文件对象,这个文件对象本质是内存中的一个变量,可以理解成操作文件的 "遥控器"。在计算机领域,这种用来远程操控资源的 "遥控器" 被称为句柄(handler)。
第一个参数是字符串类型,代表要打开的文件路径。 第二个参数也是字符串类型,代表文件的打开方式。其中 r 代表只读打开,w 代表写方式打开,a 代表追加写方式打开。
如果文件打开成功,会返回一个文件对象,后续所有对文件的读写操作,都要通过这个文件对象完成。 如果打开失败(例如路径对应的文件不存在),程序就会抛出异常。


(2)关闭文件
使用 close 方法关闭已经打开的文件:
python
f.close()注意:使用完毕的文件要记得及时关闭。
A. 一个程序能同时打开的文件个数,是存在上限的
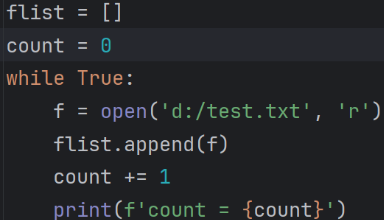

如上面代码所示,如果循环打开文件却不关闭,就会触发对应的报错。
当一个程序打开的文件数量超过系统上限,就会抛出异常。
系统可以通过相关配置修改允许打开文件的最大数目,但无论设置成多大,都不是无限的,所以一定要及时关闭文件,释放资源。
文件资源泄露是比较严重的问题,它不会立刻暴露,往往会在程序运行过程中突然 "偷袭",造成程序异常。
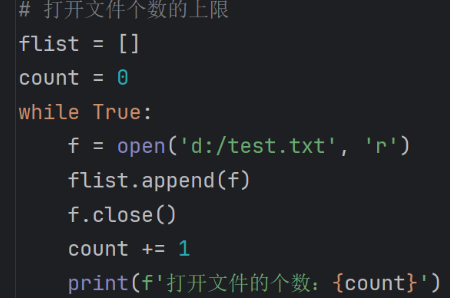
注意 :上述代码中,使用一个列表来保存了所有的文件对象。如果不进行保存,那么 Python 内置的垃圾回收机制(GC),会在文件对象销毁的时候自动关闭文件。
但是由于垃圾回收操作不一定及时,所以我们写代码仍然要考虑手动关闭释放,尽量避免依赖自动关闭。
正确写法:
补充:
每个程序启动时,会默认打开三个文件:
- 标准输入(对应键盘),也就是 input;
- 标准输出(对应显示器),也就是 print;
- 标准错误(也输出到显示器)。
(3)写文件
文件打开之后, 就可以写文件了.
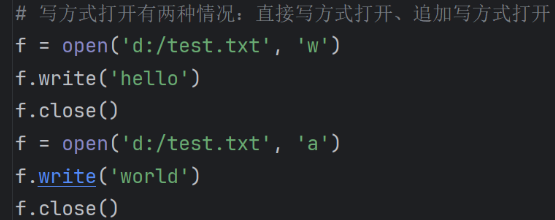
- 写文件, 要使用写方式打开, open 第二个参数设为 'w'
- 使用 write 方法写入文件.
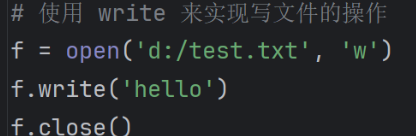
用记事本打开文件,即可看到文件修改后的内容:

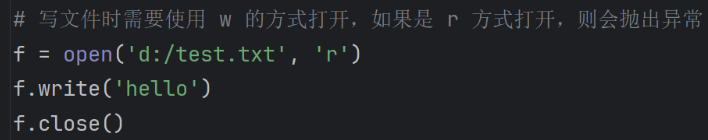
A. 如果是使用 'r' 方式打开文件,则写入时会抛出异常

- 使用 'w' 一旦打开文件成功, 就会清空文件原有的数据.
- 使用 'a' 实现 "追加写", 此时原有内容不变, 写入的内容会存在于之前文件内容的末尾.

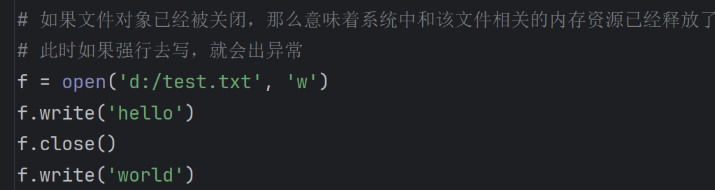
B. 针对已经关闭的文件对象进行写操作,也会抛出异常

(4) 读文件
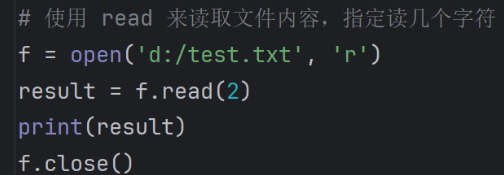
A. 读文件内容需要使用 'r' 的方式打开文件
使用 read 方法完成读操作,参数表示 "读取几个字符"。

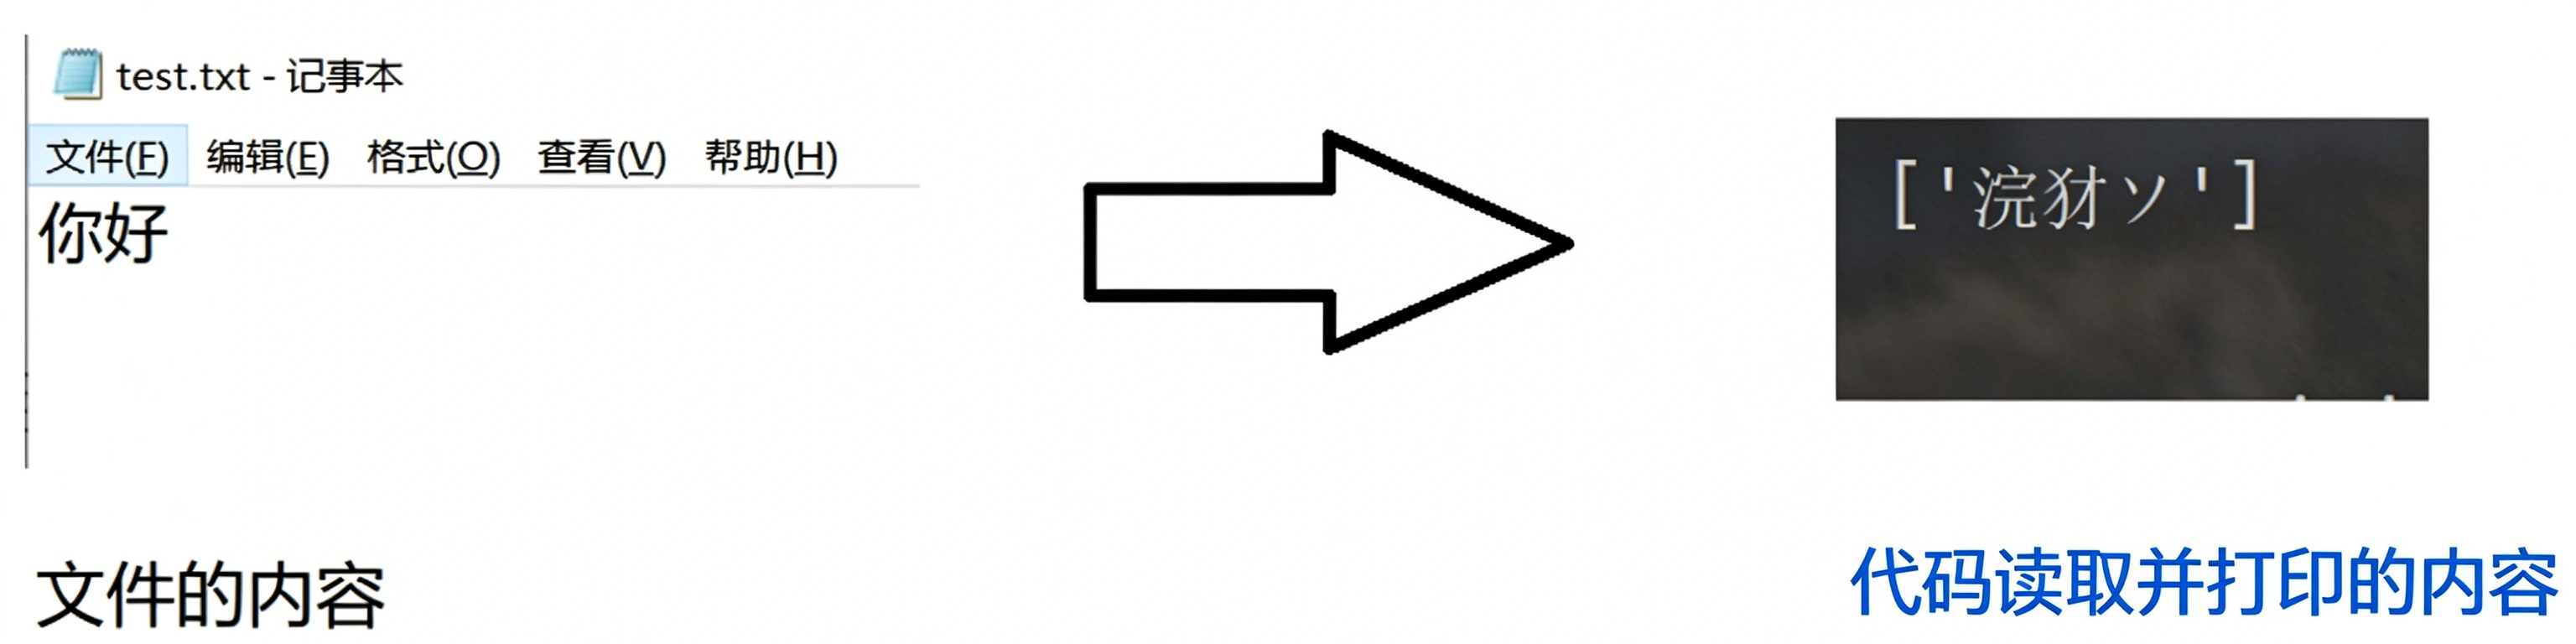
计算机表示中文时,会采用一定的编码方式,这种编码方式称为 "字符集"。 所谓 "编码方式",本质上就是用数字来表示汉字。无论是英文字母、汉字还是其他符号,计算机都需要先将文字转换成数字,再进一步处理为二进制数据。
最简单的字符编码是 ASCII,它可以表示英文字母和阿拉伯数字。 要表示汉字,则需要更大的码表。常用的中文编码主要有两种:GBK 和 UTF-8。其中,UTF-8 的使用更广泛。
在实际开发中,必须保证:
文件本身的编码方式,与 Python 代码读取文件时使用的编码方式一致。
只有这样,才能避免中文乱码。
Python3 中,open 函数默认打开文件的字符集会跟随系统。 在简体中文 Windows 系统中,默认字符集通常是 GBK。因此,如果文件本身是 GBK 编码,直接打开可能正常读取;如果文件是 UTF-8 编码,直接打开就可能出现乱码。
可以通过记事本查看文件编码:
记事本 --> 文件 --> 另存为 --> 查看窗口底部的编码方式
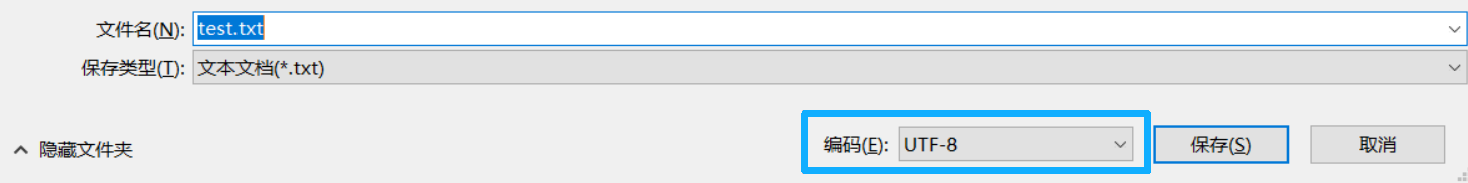
- 如果此处的编码为 ANSI,则表示 GBK 编码
- 如果此处为 UTF-8,则表示 UTF-8 编码
此时我们修改打开文件的代码,可以给 open 方法加上 encoding 参数,显式的指定为和文本相同的字符集,问题就可以解决:
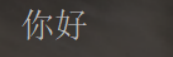
字符编码问题是编程里一类很常见,同时又比较棘手的问题。只有理解字符编码相关原理,才能从容处理这类问题。
同学们可以参考腾讯官方账号发表的帖子, 详细介绍了里面的细节.https://zhuanlan.zhihu.com/p/46216008
B.如果文件是多行文本, 可以使用 for 循环一次读取一行.
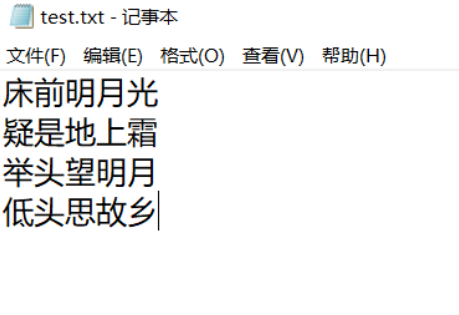
先构造一个多行文件.
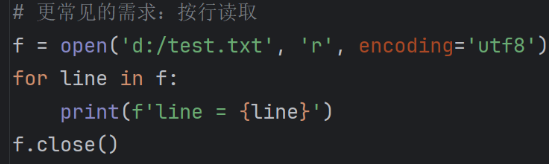
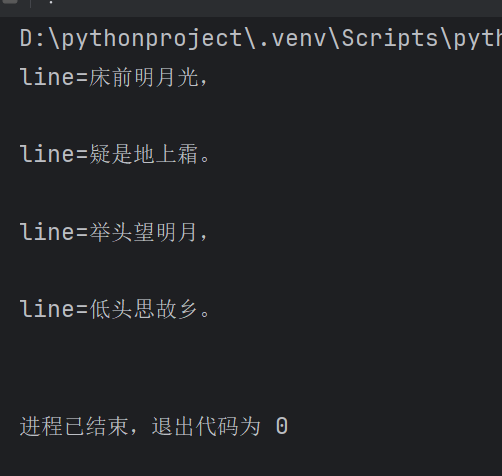
注意 :由于文件里每一行末尾都自带换行符,print 打印一行的时候又会默认加上一个换行符,因此打印结果看起来之间存在空行。
使用 print(f'line = {line}', end='') 手动把 print 自带的换行符去掉
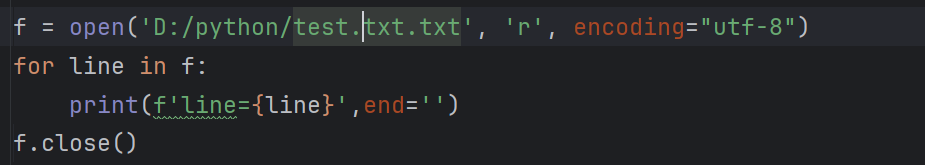
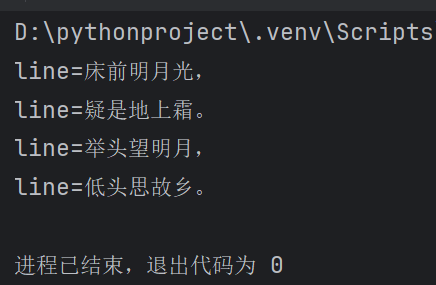
end 参数就表示每次打印之后要在末尾加什么,原先默认是 '\n',修改成 '',也就是什么都不加。
C. 使用 readlines 直接把文件整个内容读取出来,返回一个列表,每个元素即为一行
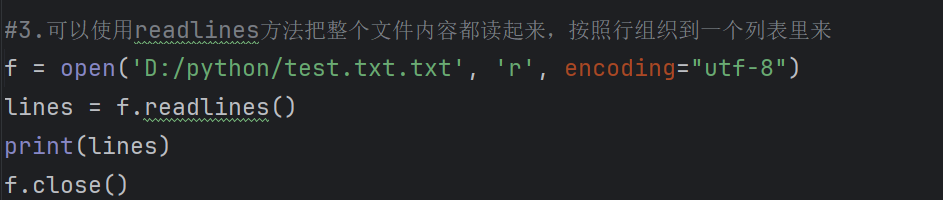
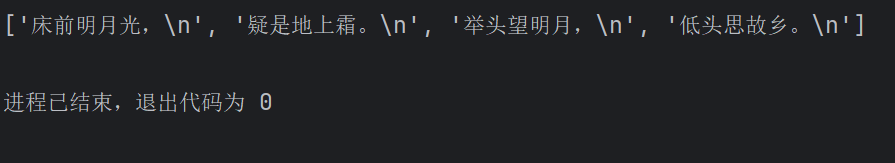
此处的 '\n' 为换行符
4.使用上下管理器
打开文件之后, 是容易忘记关闭的. Python 提供了上下文管理器 , 来帮助程序猿自动关闭文件.
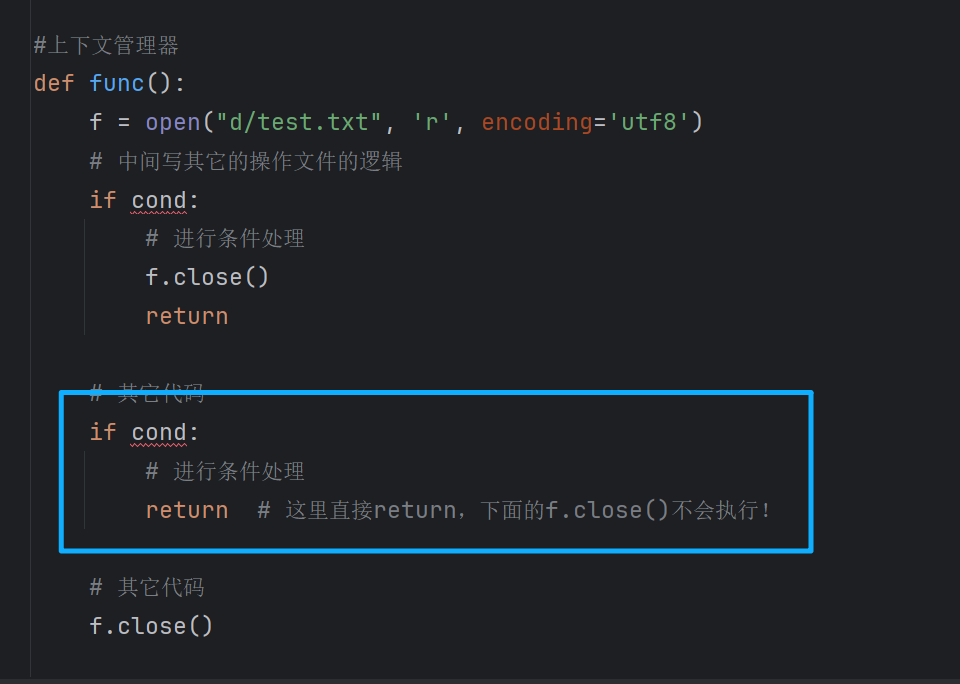
打开文件之后, 是容易忘记关闭的. Python 提供了 上下文管理器 , 来帮助程序猿自动关闭文件.
- 使用 with 语句打开文件.
- 当 with 内部的代码块执行完毕后, 就会自动调用关闭方法.
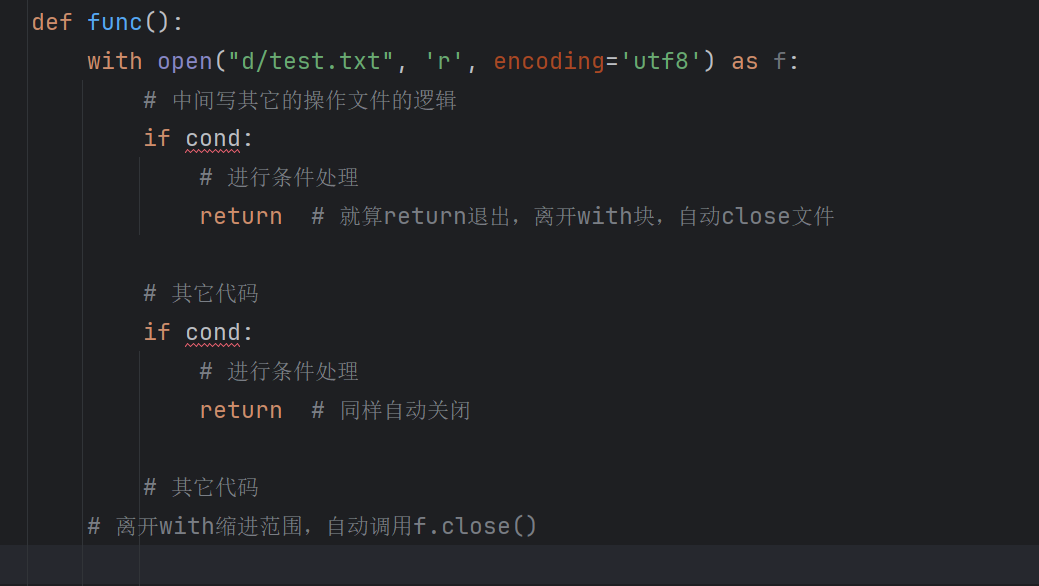
类比于C++ 中的智能指针、Java 中的 try with Resources 和 Golang 中的 defer 都有类似效果。