前言
本篇文章将是类和对象的最后一篇文章了,那么话不多说,直接开始吧。
初始化列表
如果类中的成员变量没有默认构造函数,就会报错,要初始化这个成员变量,就要用到初始化列表。
初始化列表的使⽤⽅式是以⼀个冒号开始,接着是⼀个以逗号分隔的数据成员列表,每个"成员变量"后⾯跟⼀个放在括号中的初始值或表达式。例如:
cpp
class MyClass {
    int a;
    double b;
    std::string name;
public:
    MyClass(int x, double y, std::string n)
        : a(x), b(y), name(std::move(n))  // 初始化列表
    {
        // 构造函数体(此时成员已初始化完毕)
    }
};
这里初始化列表的顺序要与类中的声明顺序一致,这里a先声明,b后声明,初始化列表也要一样,第一个类中声明先初始化,以此类推。
还有一点需要注意,先看段代码。
cpp
class OrderDemo {
    int a;  // 先声明
    int b;  // 后声明
public:
    // 危险!虽然列表中 b 写在前面,但实际先初始化 a
    OrderDemo(int y) : b(y), a(b) {
        // a 使用了未初始化的 b,产生未定义行为
    }
};
这里a先声明的,先初始化a,但是a初始化用到了b,那不是根没有初始化一样。这一点要注意。
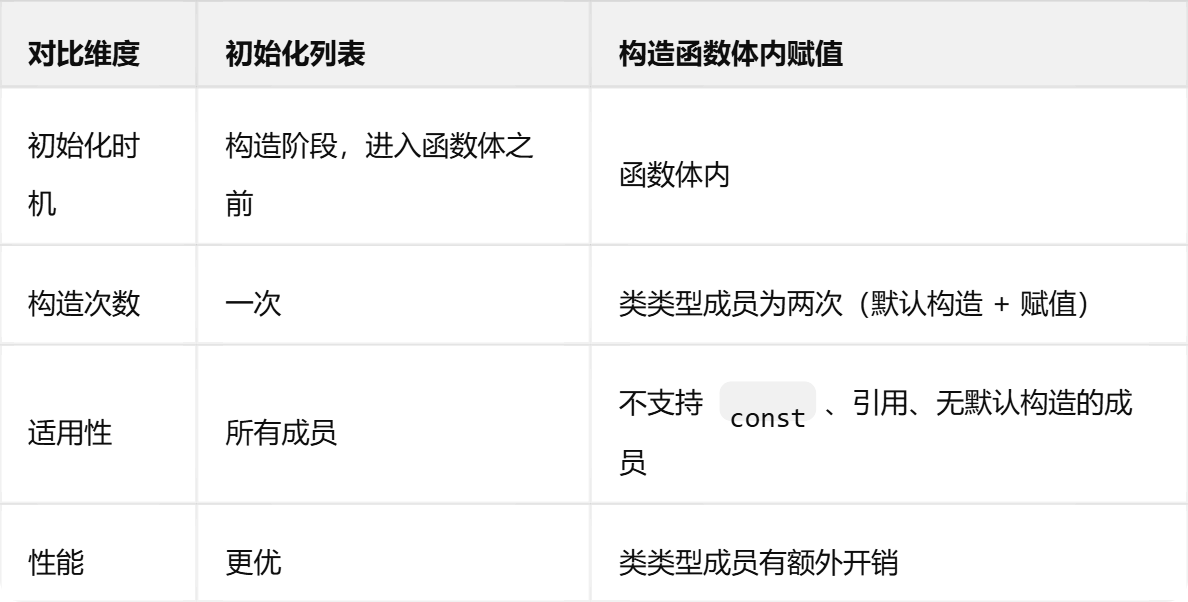
对于内置类型来说,这两个性能上差异不大,但是对于像std::string、std::vector 等复杂类型在性能上初始化列表更好,因为构造函数体内还要进行默认构造创建临时对象,再将新值拷贝到已有对象中,这样会有额外的开销。
每个成员变量在初始化列表中只能出现⼀次,语法理解上初始化列表可以认为是每个成员变量定义初始化的地⽅。
引⽤成员变量,const成员变量,没有默认构造的类类型变量,必须放在初始化列表位置进⾏初始化,否则会编译报错。
这几个只能初始化,不能被赋值,构造函数分为两个阶段,初始化列表,函数体。函数体中=运算符相当于赋值。
引用成员变量
引用在定义时必须绑定到一个已存在的对象,且一旦绑定就不能重新绑定到其他对象。构造函数体内无法完成"绑定"这个动作,因为此时引用已经"存在"了,再写 = 就变成了赋值,而引用不支持赋值。
cpp
class Demo {
    int& ref;
public:
    Demo(int& r) : ref(r) {}  // ✅ 初始化:定义时绑定到 r
    // Demo(int& r) { ref = r; }  // ❌ 编译报错:引用未初始化
};
const成员变量
用const修饰的成员变量只有可读性,其值在生命周期内不能被修改,而函数体内的=运算符是赋值,放在函数体内编译会报错。所以要放在初始化列表初始化。
cpp
class Demo {
    const int value;
public:
    Demo(int v) : value(v) {}  // ✅ 初始化:创建时绑定值
    // Demo(int v) { value = v; }  // ❌ 赋值:试图修改const变量,编译报错
};
没有默认构造的类类型变量
当编译器进入构造函数体之前,必须先把所有成员变量都构造出来。对于自定义类型的成员,编译器会尝试调用其默认构造函数(无参构造)来完成这一步。如果该类没有默认构造函数,编译器就"不知道该怎么构造它",直接报错。
cpp
class Engine {
public:
    Engine(int hp) {}  // 只有带参构造,没有默认构造
};

class Car {
    Engine engine;
public:
    Car() : engine(150) {}   // ✅ 显式调用带参构造
    // Car() {}               // ❌ 编译报错:找不到 Engine::Engine()
};
C++11⽀持在成员变量声明的位置给缺省值,这个缺省值主要是给没有显⽰在初始化列表初始化的成员使⽤的。
尽量使⽤初始化列表初始化,因为那些你不在初始化列表初始化的成员也会⾛初始化列表,如果这个成员在声明位置给了缺省值,初始化列表会⽤这个缺省值初始化。如果你没有给缺省值,对于没
有显⽰在初始化列表初始化的内置类型成员是否初始化取决于编译器,C++并没有规定。对于没有显⽰在初始化列表初始化的⾃定义类型成员会调⽤这个成员类型的默认构造函数,如果没有默认构造会编译错误。
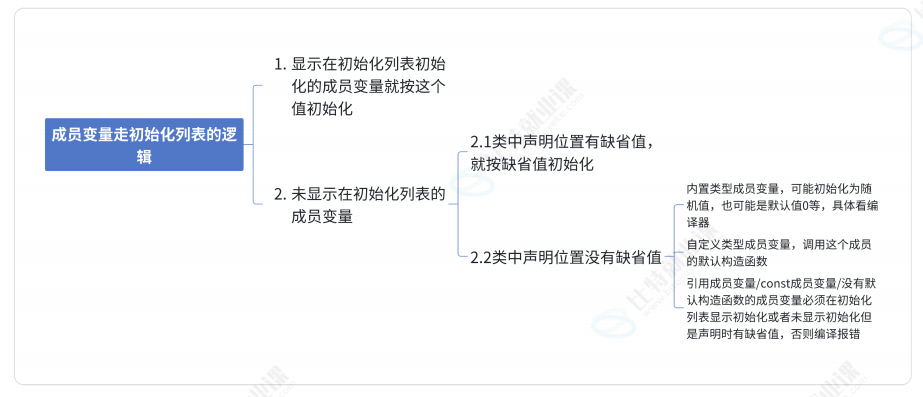
初始化列表总结:
⽆论是否显⽰写初始化列表,每个构造函数都有初始化列表和函数体;
⽆论是否在初始化列表显⽰初始化成员变量,每个成员变量都要⾛初始化列表初始化 ,编译器在进入构造函数体之前,都会强制为所有成员变量执行一次初始化;
我们看道题目:
下⾯程序的运⾏结果是什么()
A. 输出 1 1
B. 输出 2 2
C. 编译报错
D. 输出 1 随机值
E. 输出 1 2
F. 输出 2 1
cpp
#include<iostream>
 using namespace std;

 class A
 {
 public:
 A(int a)
 :_a1(a)
 , _a2(_a1)
 {}
void Print() {
cout << _a1 << " " << _a2 << endl;
}
private:
int _a2 = 2;
int _a1 = 2;
};
int main()
{
A aa(1);
aa.Print();
}
在类中先声明_a2,后声明 _a1,所以先初始化_a2,_a2初始化用上了_a1,此时_a1是随机值,_a2是随机值,这里实参传的1,a=1,_a1就初始化成1.选D。
类型转换
在C/C++中int可以转换成double类型的,这叫隐式转换。在C++的类中,在C++中编译器可以自动调用构造函数,把一个参数类型转换成这个类的对象。举个例子:
cpp
#include <iostream>
using namespace std;

class MyInt {
public:
    int val;

    // 这是一个"以 int 为参数"的构造函数
    MyInt(int v) : val(v) {
        cout << "构造函数被调用了!" << endl;
    }
};

// 这是一个需要 MyInt 对象作为参数的函数
void printValue(MyInt obj) {
    cout << "值是:" << obj.val << endl;
}

int main() {
    // 重点来了:我们传入了一个 int,但函数需要的是 MyInt 对象
    printValue(100);
    return 0;
}
发生了什么?
1.你调用了 printValue(100)。
2.编译器发现:printValue 想要一个 MyInt 类型的对象,但你给的是 int 类型的 100。
3.编译器去查 MyInt 类,发现它有一个构造函数 MyInt(int v)。
4.隐式转换发生:编译器偷偷执行了 MyInt temp(100),生成了一个临时对象,然后把这个临时对象传给了函数。
5.程序输出:"构造函数被调用了!"和"值是:100"。
这就是所谓的"内置类型(int)隐式转换为类类型(MyInt)对象"
这种隐式类型转换通常是不好的,会造成额外的开销(创建临时对象),并且会让代码变得难以理解。
那么该怎么禁止呢?在构造函数前⾯加explicit就不再⽀持隐式类型转换。
cpp
class MyInt {
public:
    int val;
    // 加上 explicit 关键字
    explicit MyInt(int v) : val(v) {}
};
若此时再写 printValue(100);,编译器就会直接报错,因为它被禁止进行隐式转换了。你必须显式地写 printValue(MyInt(100)); 才能通过编译。
类类型的对象之间也可以隐式转换,需要相应的构造函数⽀持。
static成员
⽤static修饰的成员变量,称之为静态成员变量,静态成员变量⼀定要在类外进⾏初始化。
• 静态成员变量为所有类对象所共享,不属于某个具体的对象,不存在对象中,存放在静态区。
• ⽤static修饰的成员函数,称之为静态成员函数,静态成员函数没有this指针。
• 静态成员函数中可以访问其他的静态成员,但是不能访问⾮静态的,因为没有this指针。
• ⾮静态的成员函数,可以访问任意的静态成员变量和静态成员函数。
• 突破类域就可以访问静态成员,可以通过类名::静态成员 或者 对象.静态成员 来访问静态成员变量和静态成员函数。
• 静态成员也是类的成员,受public、protected、private 访问限定符的限制。
• 静态成员变量不能在声明位置给缺省值初始化,因为缺省值是个构造函数初始化列表的,静态成员变量不属于某个对象,不⾛构造函数初始化列表。
友元函数
友元函数就是一个被类"特别授权"的普通外部函数,它虽然不是这个类的成员,但拥有和成员函数一样的特权------可以直接访问类内部的私有(private)和保护(protected)成员。
友元函数要在类中声明,在类外定义,它算是独立于类之外的普通全局函数 但是对于普通的全局函数又不能直接访问类的私有成员,而友元函数可以。它不能算是类的成员函数, 所以类外使用时不用像成员函数一样要加作用域限定符。
那友元函数能够解决什么问题呢?
运算符重载 :比如重载 << 运算符时,最左边的操作数必须是 ostream 对象(如 cout)。如果我们把它写成类的成员函数,调用方式就会变成反人类的 d << cout。因此它必须是一个全局函数,但全局函数又访问不了类的私有成员。
跨类数据共享 :当两个不同的类需要频繁访问彼此的私有数据时,如果通过公有接口(getter/setter)来回倒腾,不仅代码繁琐,还会产生额外的函数调用开销。
我们看段代码:
cpp
#include <iostream>
using namespace std;

class Date {
    // 1. 在**类内声明**友元函数(位置不受 public/private 限制)
    friend ostream& operator<<(ostream& out, const Date& d);

private:
    int _year;
    int _month;
    int _day;

public:
    Date(int year, int month, int day)
        : _year(year), _month(month), _day(day) {}
};

// 2. 在**类外定义**(注意:没有 Date:: 作用域限定符,因为它不是成员函数)
ostream& operator<<(ostream& out, const Date& d) {
    // 3. 这里可以直接访问 Date 的私有成员
    out << d._year << "-" << d._month << "-" << d._day;
    return out;
}

int main() {
    Date d(2026, 9, 27);
    cout << d << endl; // 输出:2026-9-27
    return 0;
}
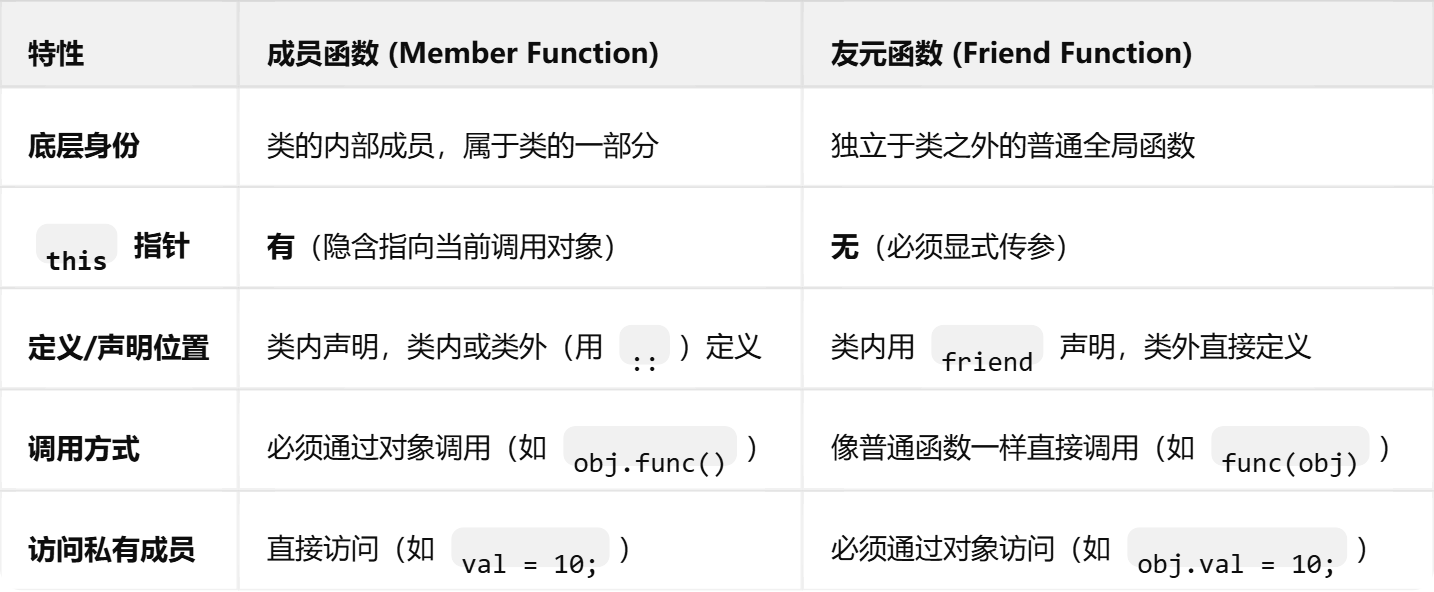
另外,友元函数不是全局普通函数嘛,所以参数中没有隐式this指针,并且在类中声明不受访问限定符约束(public,private,protected),写在类中的哪里功能都一样。
这个表格是友元函数与类中成员函数的区别。
⼀个函数可以是多个类的友元函数。
• 友元类中的成员函数都可以是另⼀个类的友元函数,都可以访问另⼀个类中的私有和保护成员。
• 友元类的关系是单向的,不具有交换性,⽐如A类是B类的友元,但是B类不是A类的友元。
• 友元类关系不能传递,如果A是B的友元, B是C的友元,但是A不是C的友元。
不可继承:基类的友元关系不会被子类继承。
虽然友元函数比较方便,提高效率,支持自然语法的表达,但是它破坏了封装性,破坏了数据的隐藏性,增加了类的耦合度。所以能不用友元函数就尽量不要用
内部类
如果⼀个类定义在另⼀个类的内部,那么这个类就叫做内部类。内部类是⼀个独⽴的类,跟定义在全局相⽐,他只是受外部类类域限制和访问限定符限制,所以外部类定义的对象中不包含内部类。
• 内部类默认是外部类的友元类。
• 内部类本质也是⼀种封装,当A类跟B类紧密关联,A类实现出来主要就是给B类使⽤,那么可以考虑把A类设计为B的内部类,如果放到private/protected位置,那么A类就是B类的专属内部类,其他地⽅都⽤不了。
匿名对象
⽤ 类型(实参) 定义出来的对象叫做匿名对象,相⽐之前我们定义的 类型 对象名(实参) 定义出来的叫有名对象。
• 匿名对象⽣命周期只在当前⼀⾏,⼀般临时定义⼀个对象当前⽤⼀下即可,就可以定义匿名对象。
语法对比:
有名对象:Data d1; (在 main 函数结束或离开作用域时才销毁)
匿名对象:Data(); 或 Data(10); (这一行代码执行完,立马调用析构函数销毁)
如果你写 Data d1();,编译器不会把它当成创建对象,而是会把它识别为一个函数声明(声明了一个名为 d1、无参数、返回 Data 类型的函数)
常见产生场景:
函数按值返回:当函数返回一个对象(非引用)时,底层会产生一个匿名对象来存储返回结果。
隐式类型转换:比如你之前问的"内置类型转类类型",编译器在底层会先利用内置类型(如 int)调用构造函数,偷偷创建一个临时的匿名对象,再传递给目标函数。
表达式中间结果:比如 string c = a + b;,a + b 的运算结果就是一个临时的匿名 string 对象。
若想延长匿名对象的生命周期,那么可以这样用。
cpp
const Data& ref = Data(10); // 匿名对象的生命周期被延长到 ref 的作用域结束将匿名对象绑定到一个 const 左值引用(const T&)或右值引用(T&&)上,它的生命周期会被延长,直到该引用的作用域结束。
注意:普通的非 const 左值引用(Data& ref)是不能绑定匿名对象的,编译会直接报错。
左值引用(lvalue) :有名字、能持久存在、可以取到内存地址的对象。直观上,它能出现在赋值号(=)的左边。比如:int a = 10; 中的变量 a,或者解引用指针 *p。
右值引用(rvalue) :临时的、没有名字、用完当前表达式就会被销毁的值,通常不能取地址。直观上,它只能出现在赋值号的右边。比如:字面量 10、表达式 a + b 的计算结果、或者函数的匿名返回值。
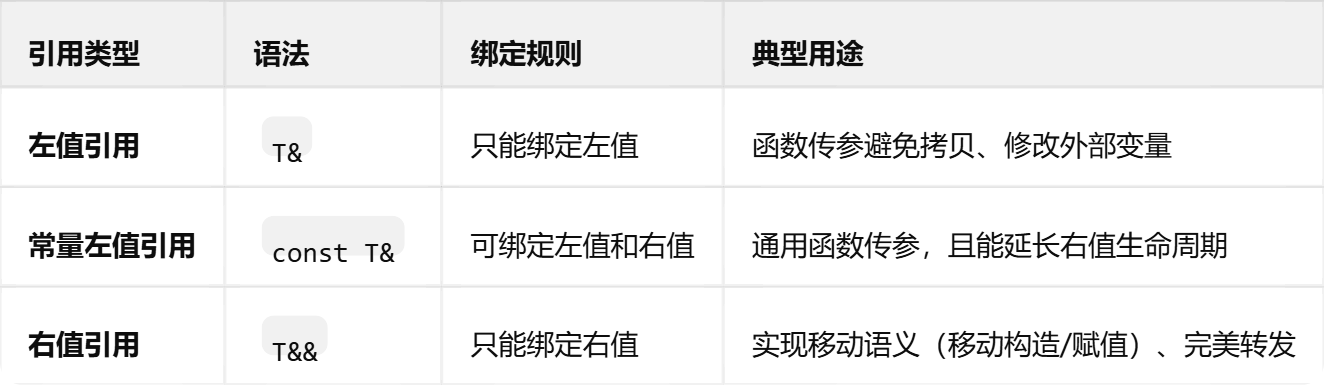
&&这个在这里是右值引用声明符。
作用:专门用来绑定右值(如字面量、临时对象、匿名对象),是实现移动语义和完美转发的底层基石。
匿名对象对于编译器拷贝还有一定的优化作用。
对象拷贝时编译器的优化
为了减少不必要的构造和拷贝开销,现代编译器会进行返回值优化(RVO)。比如函数返回一个匿名对象时,编译器会直接在调用者的内存空间里"就地构造"这个对象,从而完全省去了"先在函数内构造匿名对象 -> 再拷贝给外部变量"的中间步骤。
当前主流的相对新⼀点的编译器对于连续⼀个表达式步骤中的连续拷⻉会进⾏合并优化,有些更新更"激进"的编译器还会进⾏跨⾏跨表达式的合并优化。
结束语
到这里,我们关于类和对象的最后一篇文章就告一段落了。回顾整篇文章,我们从初始化列表 出发,理解了为什么引用、const 成员和没有默认构造的类类型变量必须放在初始化列表中;接着我们探讨了类型转换 的隐式与显式机制,学会了用 explicit 关键字来避免不必要的隐式转换;随后我们认识了static 成员 的共享特性、友元函数 的"破例授权"、内部类 的封装妙用,以及匿名对象 和编译器优化背后的性能哲学。
这些知识点看似零散,实则环环相扣------它们共同构成了 C++ 面向对象编程中"如何正确、高效地管理对象生命周期与访问权限"的核心能力。掌握了它们,你不仅能写出更健壮的代码,还能在阅读源码时更从容地理解设计者的意图。
类和对象是 C++ 的灵魂,而今天这篇收官之作,希望能帮你把这块拼图完整地拼上。如果你对某个知识点还有疑问,或者想深入了解某个细节,欢迎在评论区留言交流。编程之路,贵在坚持,我们下一篇再见!