你大概用过不少健康管理类的App------输入年龄、性别、BMI、血压,再填几项血液指标,它就能给出一个风险评分或健康提示。
这个评分背后,往往是一个训练好的机器学习模型在实时计算。
但模型在Jupyter Notebook里跑通,和让它变成成千上万用户都能调用的服务,中间隔着一条不小的鸿沟。
今天我们就以"乳腺肿瘤风险筛查"这个具体场景为例(选这个是因为 scikit-learn 库中自带了真实的数据集),手把手走一遍从模型训练到API封装,再到Docker容器化、最终发布上线的完整流程。
读完希望你能把自己的模型变成一个随时可调用的Web服务。
一、先规划好项目结构
动手之前,先想清楚项目怎么组织。
一个清晰的结构能让后续开发、调试和部署都顺心很多。
我们创建一个名为 health-risk-api 的文件夹,里面分成几个部分:
src目录放FastAPI应用代码artifacts目录存放训练好的模型文件- 根目录下放训练脚本、依赖清单和Dockerfile。
具体长这样:
plain
health-risk-api/
├── src/
│   ├── __init__.py
│   └── api.py              # FastAPI 应用
├── artifacts/
│   └── breast_cancer_model.joblib  # 训练好的模型
├── build_model.py          # 模型训练脚本
├── requirements.txt        # Python 依赖
└── Dockerfile              # 容器配置
这个结构不复杂,但把训练、服务、依赖和容器配置都分开了,后面每一步该做什么一目了然。
二、准备开发环境
接下来需要一台装有Python 3.9+和Docker的机器。
Python用来训练模型和写API,Docker用来打包运行环境。
为了避免污染系统环境,我们先建一个虚拟环境,再安装必要的库:scikit-learn、pandas、fastapi和uvicorn。
bash
python -m venv health-env
source health-env/bin/activate   # Windows 用 health-env\Scripts\activate
pip install scikit-learn pandas fastapi uvicorn joblib
这几行命令执行完,开发环境就齐了。
这里多装了一个 joblib,后面保存模型会用到它,比pickle更适合存储scikit-learn模型。
三、训练一个肿瘤风险分类模型
我们直接使用scikit-learn内置的乳腺癌数据集。它包含569条样本,每条有30个细胞核特征(半径、纹理、周长、面积等),目标是把肿瘤分为恶性或良性。
这个数据集规模适中,特征丰富,用来演示部署流程再合适不过。
我们选逻辑回归作为分类器,因为它训练快、可解释性好,而且输出概率值,方便我们包装成"风险评分"。
在 build_model.py 中,我们这样写:
python
import joblib
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, roc_auc_score
from sklearn.pipeline import Pipeline

# 加载数据
data = load_breast_cancer()
X, y = data.data, data.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 构建包含标准化和逻辑回归的管道
pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('clf', LogisticRegression(max_iter=1000, random_state=42))
])

pipe.fit(X_train, y_train)

# 评估
y_pred = pipe.predict(X_test)
y_prob = pipe.predict_proba(X_test)[:, 1]
print(f"准确率: {accuracy_score(y_test, y_pred):.4f}")
print(f"AUC: {roc_auc_score(y_test, y_prob):.4f}")

# 保存整个管道
joblib.dump(pipe, 'artifacts/breast_cancer_model.joblib')
运行这个脚本,你会在 artifacts 目录下得到 breast_cancer_model.joblib。
bash
$ python build_model.py
准确率: 0.9825
AUC: 0.9954
这个文件里既包含标准化器,也包含分类器,后面API直接加载它就能完成端到端的预测。
四、用FastAPI把模型包装成API
模型有了,但总不能要求每个用户都装Python和scikit-learn吧?这时候FastAPI就派上用场了。
它轻量、性能好,还能自动生成交互式文档。
我们在 src/api.py 里做三件事:定义输入数据格式、加载模型、提供预测接口。
先用Pydantic定义输入结构。
乳腺癌数据集一共有30个特征,分别是10个均值特征、10个误差特征和10个最差值特征。
Pydantic的模型字段顺序很重要,因为我们在后面拼装numpy数组时必须严格按训练时的特征顺序来,否则模型会用错数据,预测结果就完全不可信了。
python
from pydantic import BaseModel

class TumorFeatures(BaseModel):
    # 10 个均值特征
    mean_radius: float
    mean_texture: float
    mean_perimeter: float
    mean_area: float
    mean_smoothness: float
    mean_compactness: float
    mean_concavity: float
    mean_concave_points: float
    mean_symmetry: float
    mean_fractal_dimension: float

    # 10 个误差特征
    radius_error: float
    texture_error: float
    perimeter_error: float
    area_error: float
    smoothness_error: float
    compactness_error: float
    concavity_error: float
    concave_points_error: float
    symmetry_error: float
    fractal_dimension_error: float

    # 10 个最差特征
    worst_radius: float
    worst_texture: float
    worst_perimeter: float
    worst_area: float
    worst_smoothness: float
    worst_compactness: float
    worst_concavity: float
    worst_concave_points: float
    worst_symmetry: float
worst_fractal_dimension: float接着初始化FastAPI应用,并用 lifespan 在启动时加载模型。
这样比在模块顶层直接加载更规范,也方便后面做测试。
python
import joblib
import numpy as np
from contextlib import asynccontextmanager
from fastapi import FastAPI

ml_model = {}

@asynccontextmanager
async def lifespan(app: FastAPI):
    ml_model["pipe"] = joblib.load('artifacts/breast_cancer_model.joblib')
    yield
    ml_model.clear()

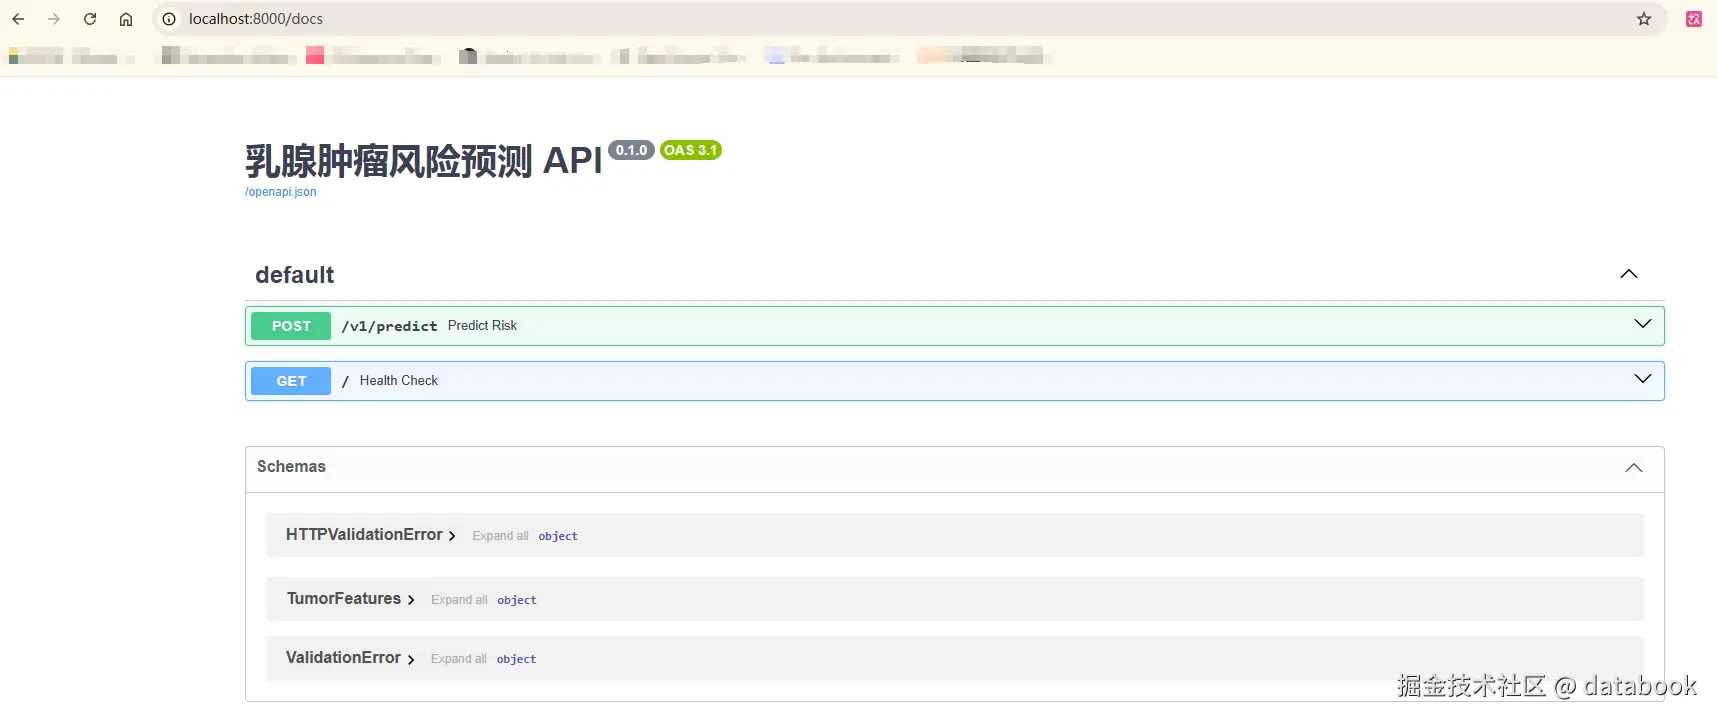
app = FastAPI(title="乳腺肿瘤风险预测 API", lifespan=lifespan)
然后写预测端点。用户POST过来一组特征,我们按顺序转成numpy数组,调用模型推理,返回恶性概率和风险等级:
python
@app.post("/v1/predict")
def predict_risk(features: TumorFeatures):
    input_array = np.array([[
        features.mean_radius,
        features.mean_texture,
        features.mean_perimeter,
        features.mean_area,
        features.mean_smoothness,
        features.mean_compactness,
        features.mean_concavity,
        features.mean_concave_points,
        features.mean_symmetry,
        features.mean_fractal_dimension,
        features.radius_error,
        features.texture_error,
        features.perimeter_error,
        features.area_error,
        features.smoothness_error,
        features.compactness_error,
        features.concavity_error,
        features.concave_points_error,
        features.symmetry_error,
        features.fractal_dimension_error,
        features.worst_radius,
        features.worst_texture,
        features.worst_perimeter,
        features.worst_area,
        features.worst_smoothness,
        features.worst_compactness,
        features.worst_concavity,
        features.worst_concave_points,
        features.worst_symmetry,
        features.worst_fractal_dimension
    ]])
    prob = ml_model["pipe"].predict_proba(input_array)[0, 1]
    risk_level = "高风险" if prob > 0.7 else ("中风险" if prob > 0.3 else "低风险")
    return {
        "malignancy_probability": round(float(prob), 4),
        "risk_level": risk_level
    }
再补一个根路径的健康检查,方便确认服务是否活着:
python
@app.get("/")
def health_check():
    return {"status": "ok", "service": "乳腺肿瘤风险预测"}
五、在本地把服务跑起来
代码写好了,先在本地验证一下。用uvicorn启动开发服务器:
bash
uvicorn src.api:app --reload --port 8000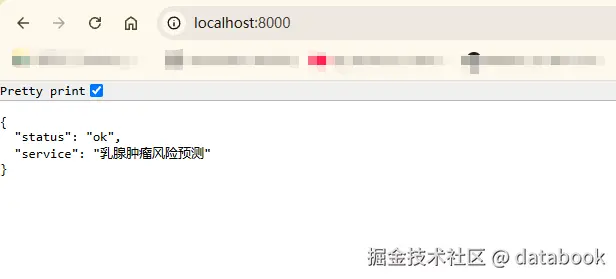
看到"Uvicorn running on http://127.0.0.1:8000"就说明服务起来了。
打开浏览器访问 http://localhost:8000/docs,FastAPI会自动生成Swagger文档,你可以直接在里面点"Try it out"发请求。
当然也可以用curl:
bash
curl -X POST "http://localhost:8000/v1/predict" \
  -H "Content-Type: application/json" \
  -d '{
    "mean_radius": 17.99, "mean_texture": 10.38, "mean_perimeter": 122.8,
    "mean_area": 1001.0, "mean_smoothness": 0.1184, "mean_compactness": 0.2776,
    "mean_concavity": 0.3001, "mean_concave_points": 0.1471,
    "mean_symmetry": 0.2419, "mean_fractal_dimension": 0.07871,
    "radius_error": 1.095, "texture_error": 0.9053, "perimeter_error": 8.589,
    "area_error": 153.4, "smoothness_error": 0.006399,
    "compactness_error": 0.04904, "concavity_error": 0.05373,
    "concave_points_error": 0.01587, "symmetry_error": 0.03003,
    "fractal_dimension_error": 0.006193,
    "worst_radius": 25.38, "worst_texture": 17.33, "worst_perimeter": 184.6,
    "worst_area": 2019.0, "worst_smoothness": 0.1622,
    "worst_compactness": 0.6656, "worst_concavity": 0.7119,
    "worst_concave_points": 0.2654, "worst_symmetry": 0.4601,
    "worst_fractal_dimension": 0.1189
  }'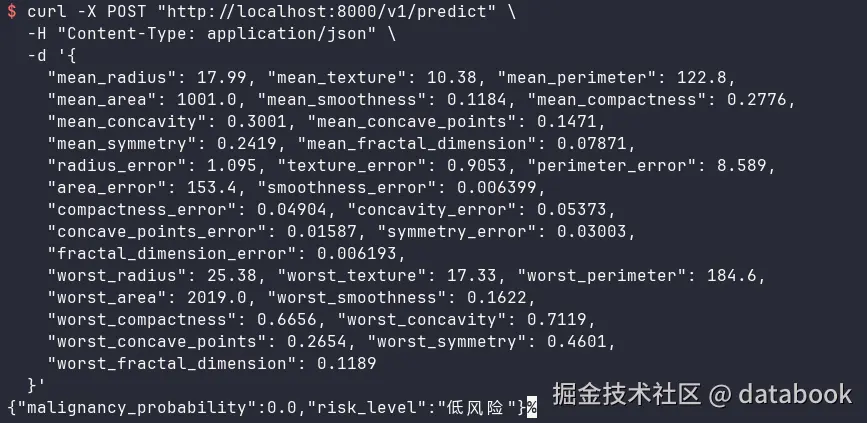
如果返回类似 {"malignancy_probability": 0.9823, "risk_level": "高风险"},说明本地服务已经通了。
顺便说一句,这条样本恰好是数据集里标签为恶性的第一条,所以高风险的结果也是符合预期的------这也能反过来验证你的API没有把特征拼错。
六、用Docker把服务装进容器
本地跑通只是第一步。
真实部署时,目标服务器可能没有Python环境,或者版本不一致。Docker能把应用和所有依赖打包成一个镜像,到哪都能跑。
我们先写 requirements.txt,把版本固定下来,保证环境一致:
plain
fastapi==0.115.12
uvicorn==0.34.2
scikit-learn==1.6.1
pandas==2.2.3
numpy==2.2.6
joblib==1.4.2然后写Dockerfile。
基于官方 python:3.12-slim 镜像,设置工作目录为 /code,复制依赖并安装,再把应用代码和模型文件复制进去,暴露8000端口,最后用uvicorn启动:
dockerfile
FROM python:3.12-slim

WORKDIR /code

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple

COPY src/ ./src/
COPY artifacts/ ./artifacts/

EXPOSE 8000

CMD ["uvicorn", "src.api:app", "--host", "0.0.0.0", "--port", "8000"]
在项目根目录执行构建:
bash
docker build -t health-risk-api .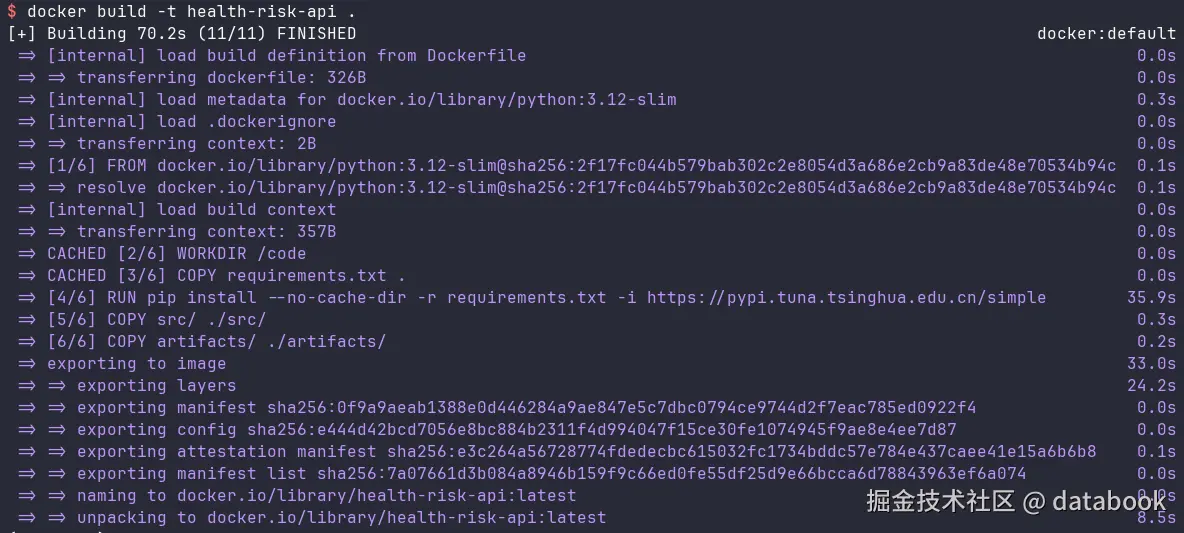
构建完成后运行容器:
bash
docker run -d -p 8000:8000 health-risk-api现在无论在哪台机器上,只要装了Docker,拉取这个镜像就能得到一模一样的服务。
七、发布到Docker Hub
镜像在本地构建好了,怎么分享给其他人或者部署到云服务器?最直接的办法是推到Docker Hub。
先登录:
bash
docker login然后给镜像打上你的用户名和版本标签,再推送:
bash
docker tag health-risk-api your-username/health-risk-api:v1.0
docker tag health-risk-api your-username/health-risk-api:latest

docker push your-username/health-risk-api:v1.0
docker push your-username/health-risk-api:latest
推送完成后,任何一台机器都可以用 docker pull your-username/health-risk-api:v1.0 拉取,然后 docker run 启动。
之后如果你想把服务部署到阿里云、腾讯云或者AWS ECS,也只需要基于这个镜像配置即可。
八、还能继续做什么
走到这一步,你已经拥有了一个可用的模型API。
但如果要上生产,还可以考虑几件事:
- 加一层认证(比如API Key),防止接口被滥用;
- 接入日志和监控,观察预测延迟和请求量;
- 如果业务需要一次性预测多条记录,可以再加一个批量预测端点。
这些都可以在现有FastAPI应用上逐步扩展。
从训练一个模型,到把它变成Docker镜像并推送到仓库,整个过程其实并不神秘。
关键是把每一步拆开,先让本地跑通,再考虑环境一致性和分发。
你完全可以把今天这套流程套用到自己的模型上------不管是预测房价、销量还是设备故障,思路都是一样的。