🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :从"数组名是首元素地址"这句常见结论继续向下追问:为什么
sizeof(arr)不是指针大小?arr + 1与&arr + 1为什么步长不同?数组传入函数后又为什么求不出元素个数?💡 学习目标:理解数组到指针的转换及两个常见例外;会用指针访问数组;能设计"指针 + 长度"的数组函数接口;掌握冒泡排序、二级指针、指针数组及其模拟二维访问的原理。
📌 阅读说明 :根据课程 PDF《第12讲:深入理解指针(2)》整理。全文按 C11 的常见规则讲解,并补充
%p、指针边界、数组形参调整和二维数组布局等容易被简化掉的细节。
文章目录
- 一、数组名真的是指针吗
- [二、arr、arr 加一与取数组地址的区别](#二、arr、arr 加一与取数组地址的区别)
- 三、使用指针访问一维数组
- 四、一维数组传参的本质
- 五、把数组传参用到冒泡排序
- 六、二级指针:指向指针的指针
- 七、指针数组:存放地址的数组
- 八、用指针数组模拟二维数组
- 九、常见误区与练习
- 总结
一、数组名真的是指针吗
先看一段很熟悉的代码:
c
int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int *p = &arr[0];
&arr[0] 是第一个元素的地址。既然数组名经常也能赋给 int *,我们可以比较二者:
c
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("&arr[0] = %p\n", (void *)&arr[0]);
    printf("arr     = %p\n", (void *)arr);
    return 0;
}
两行通常会打印相同的地址值。但更准确的说法不是"数组名本身就是指针变量",而是:
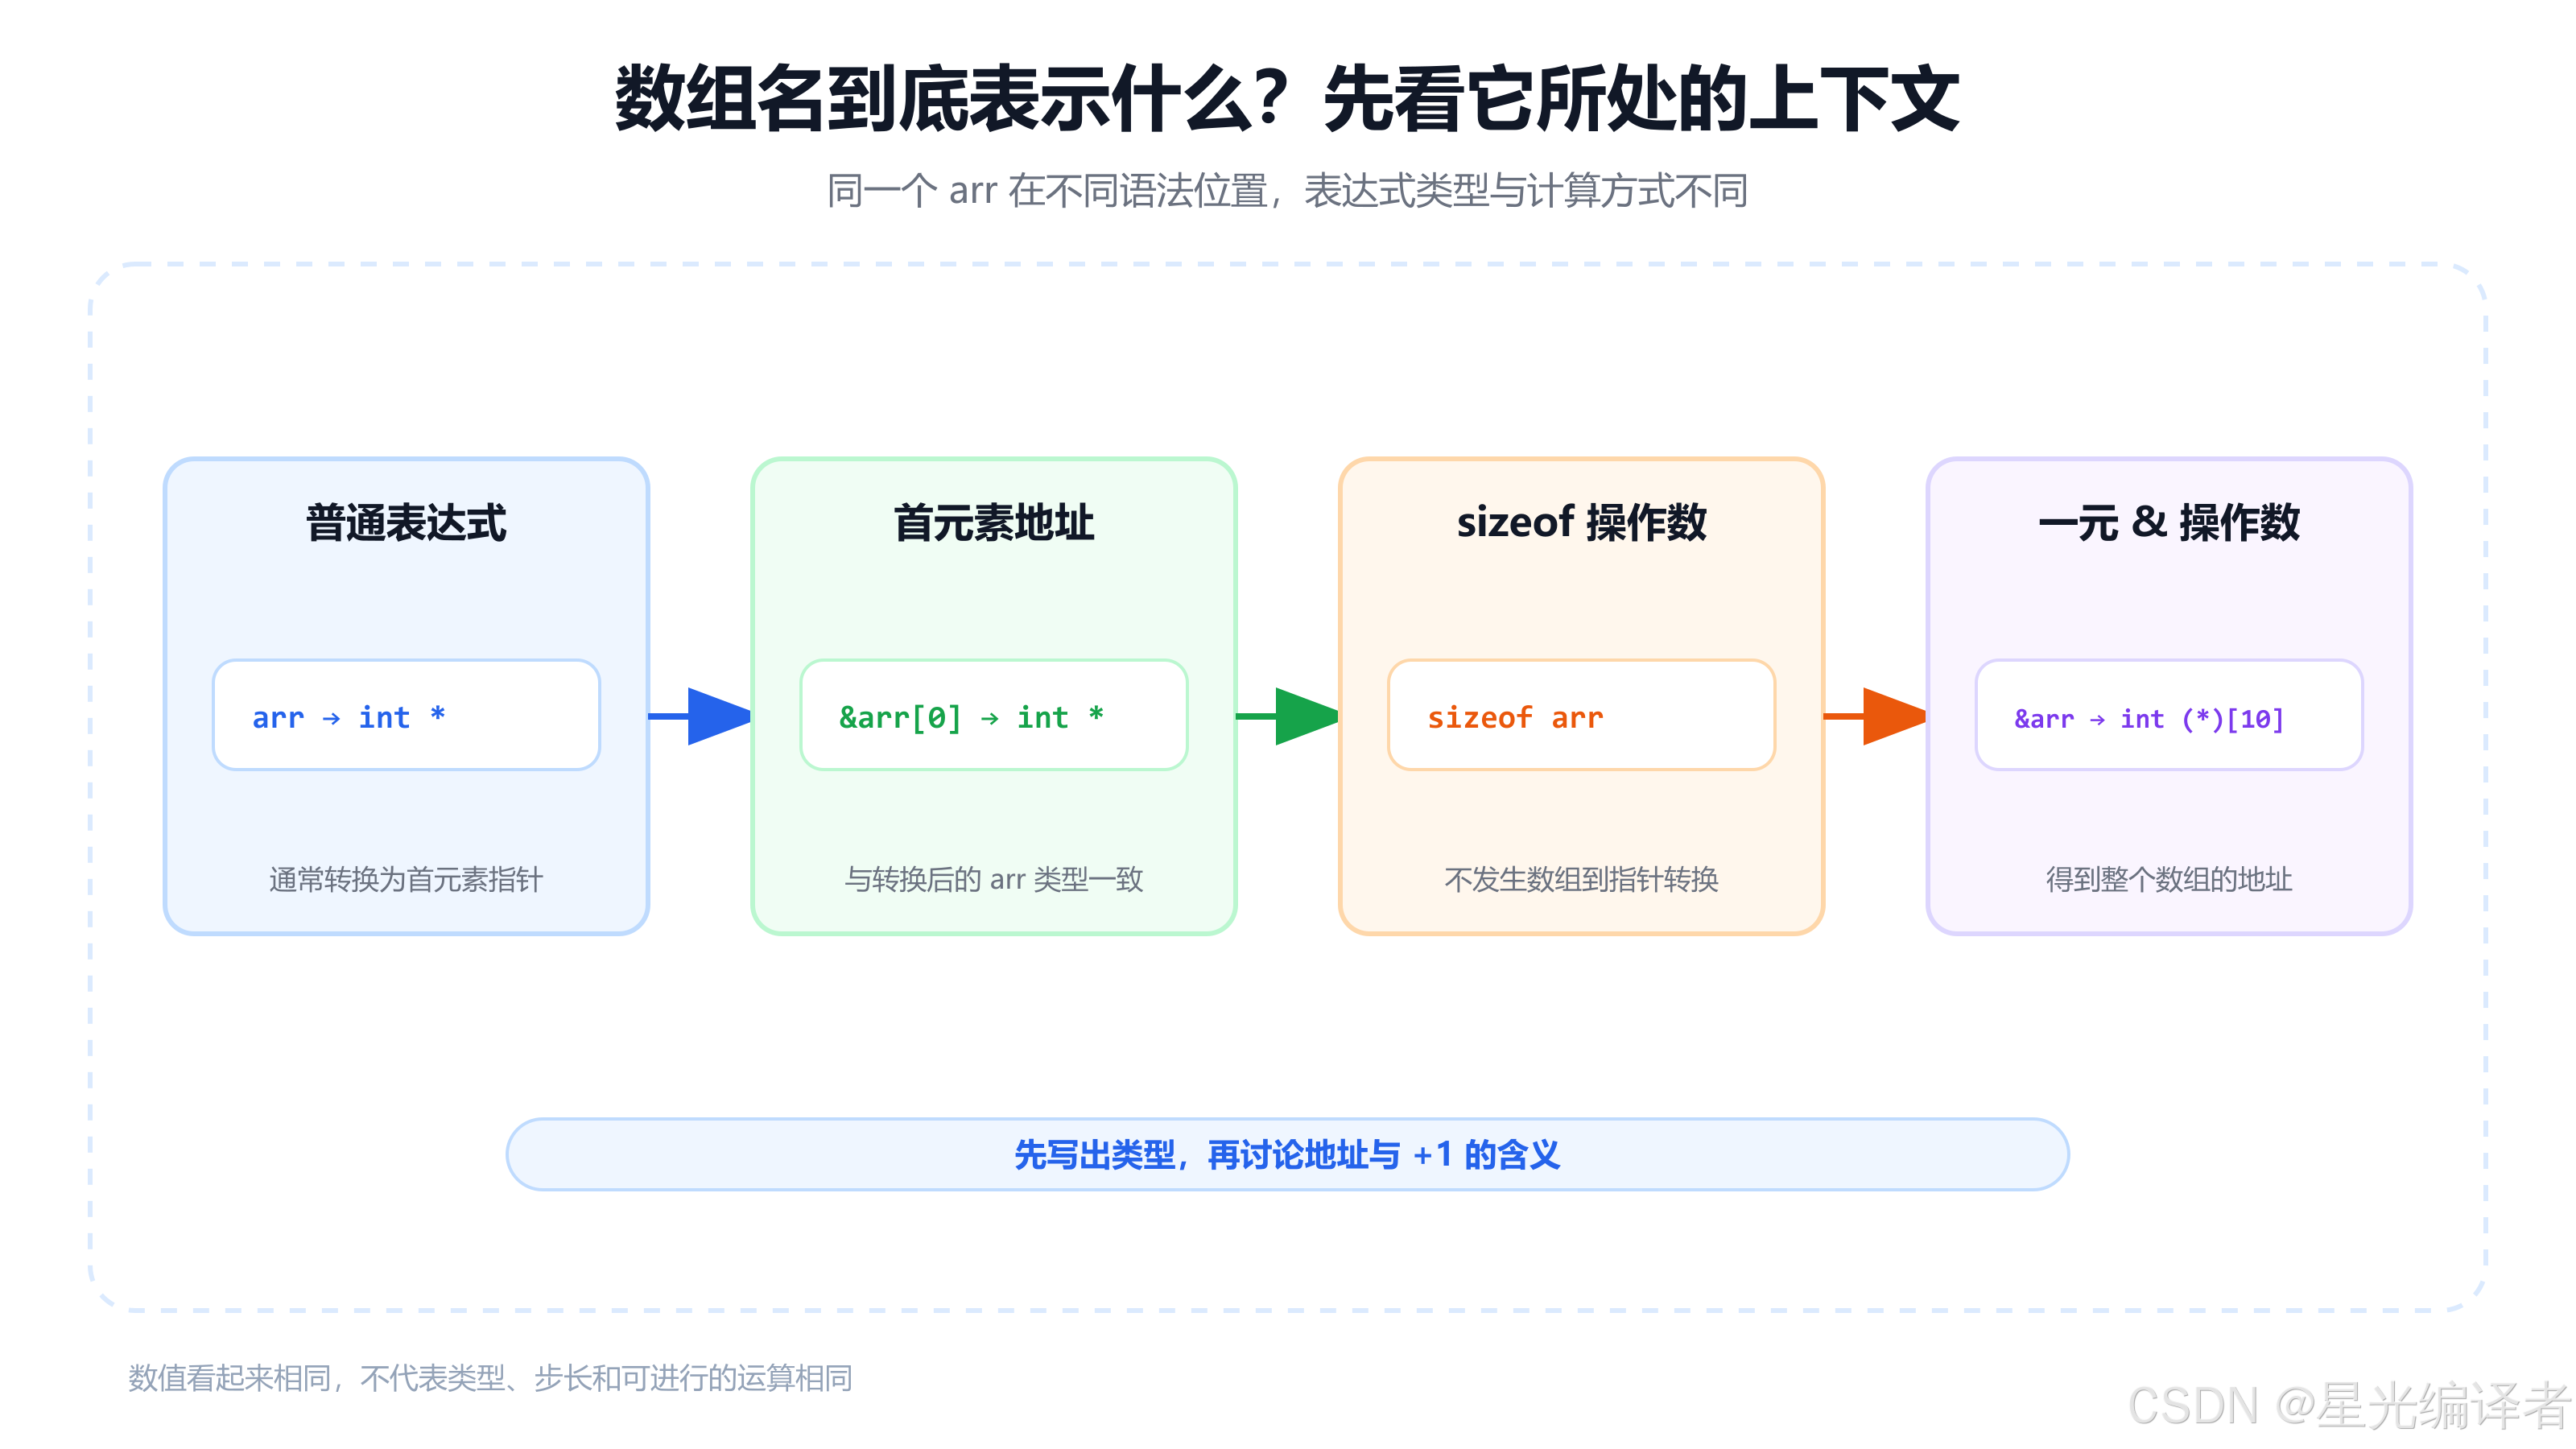
在大多数表达式中,数组类型的表达式会自动转换为指向首元素的指针。
arr 本身声明的是一个包含 10 个 int 的数组对象,它不是可以被重新赋值的指针变量:
c
int other[10] = {0};

/* arr = other; */  /* 错误:数组名不能作为可修改左值接收新地址 */
1.1 两个最常见的例外
课程重点给出了两个不会按"首元素指针"理解的场景:
sizeof(arr):数组名作为sizeof的操作数,不发生数组到指针的转换,计算整个数组占用的字节数。&arr:数组名作为一元取地址运算符&的操作数,得到整个数组对象的地址。
c
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("sizeof arr     = %zu\n", sizeof arr);
    printf("sizeof arr[0]  = %zu\n", sizeof arr[0]);
    printf("element count  = %zu\n", sizeof arr / sizeof arr[0]);
    return 0;
}
若当前实现中 sizeof(int) == 4,那么整个数组占 10 × 4 = 40 字节,元素个数就是 40 / 4 = 10。代码应使用 %zu 输出 sizeof 返回的 size_t,不要用 %d 猜测它的类型。
1.2 地址值相同,不等于类型相同
设 arr 的声明为:
c
int arr[10];常见表达式的类型关系如下:
| 表达式 | 主要含义 | 表达式类型 |
|---|---|---|
arr |
通常转换为首元素地址 | int * |
&arr[0] |
第一个 int 元素的地址 |
int * |
&arr |
整个 int[10] 数组的地址 |
int (*)[10] |
sizeof arr |
整个数组的字节数 | 结果类型为 size_t |
int (*)[10] 读作"指向含 10 个 int 的数组的指针"。其中括号不能省略;int *p[10] 是另一种类型,后文会讲。
二、arr、arr 加一与取数组地址的区别
下面三个表达式通常从同一个数值地址开始:
c
&arr[0]
arr
&arr
真正揭示差别的是给它们加 1:
c
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("&arr[0]     = %p\n", (void *)&arr[0]);
    printf("&arr[0] + 1 = %p\n", (void *)(&arr[0] + 1));
    printf("arr         = %p\n", (void *)arr);
    printf("arr + 1     = %p\n", (void *)(arr + 1));
    printf("&arr        = %p\n", (void *)&arr);
    printf("&arr + 1    = %p\n", (void *)(&arr + 1));
    return 0;
}
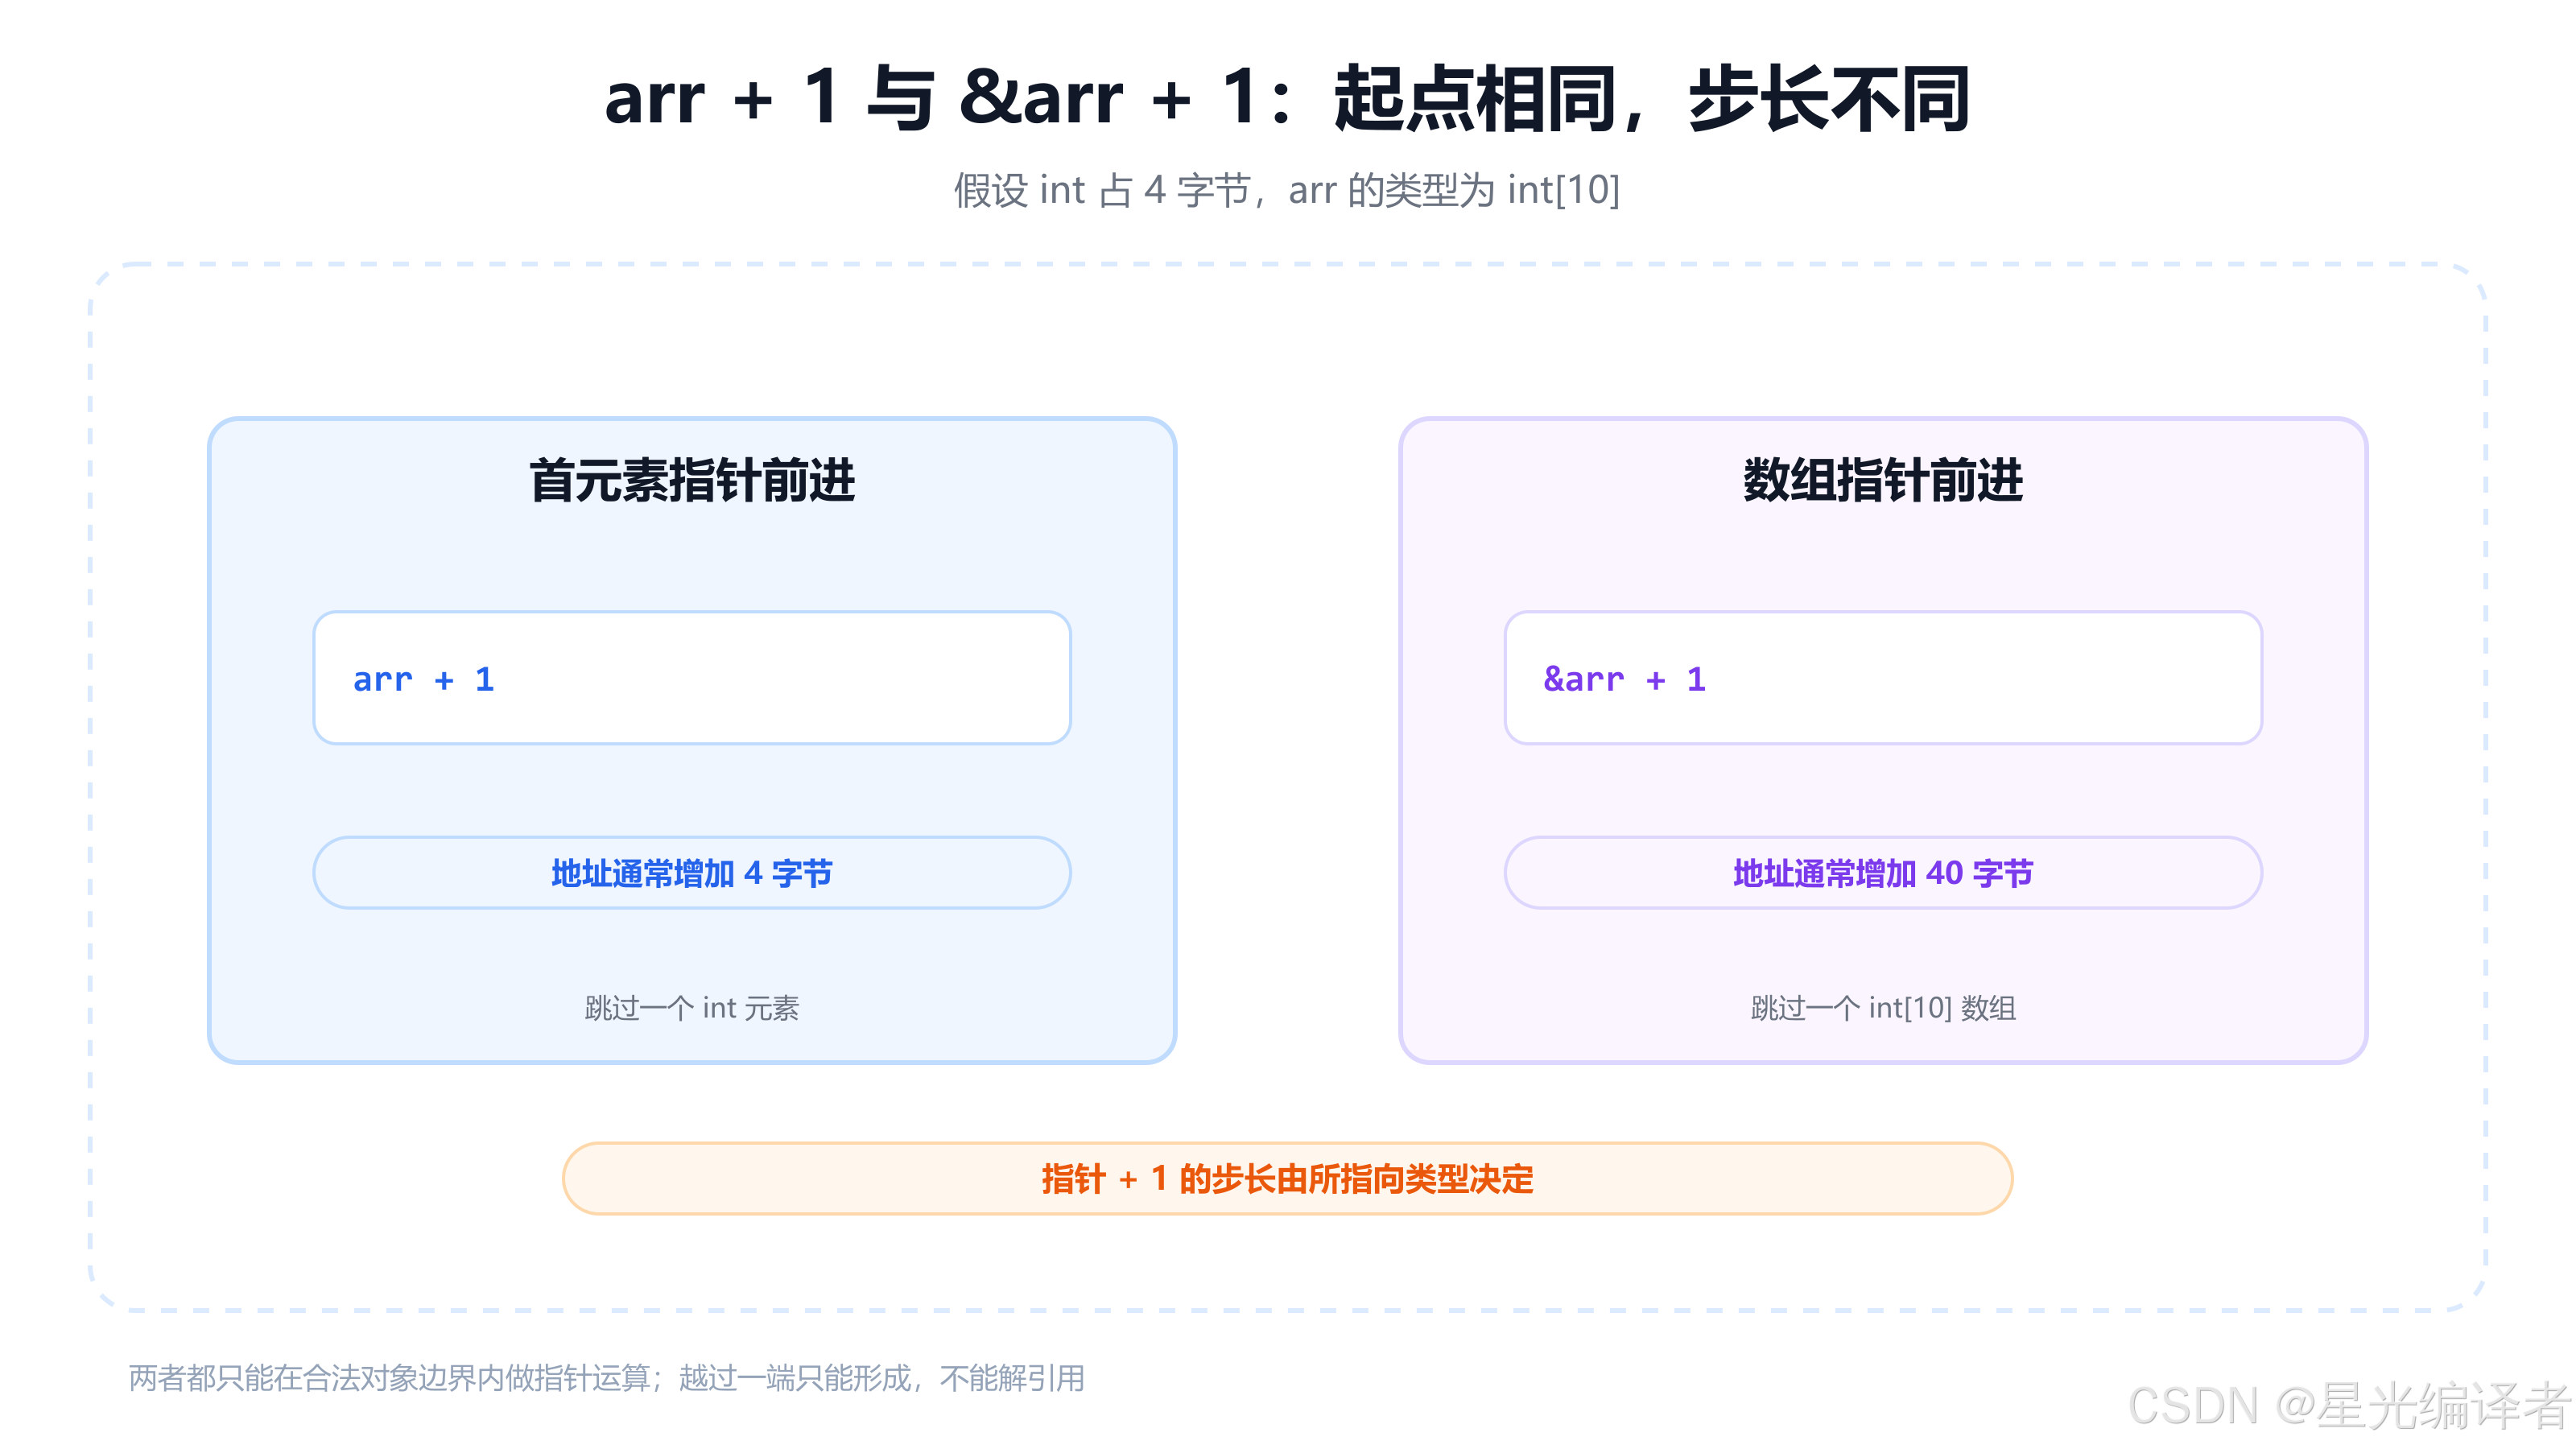
如果 int 占 4 字节,则:
arr + 1和&arr[0] + 1前进一个int,地址通常增加 4 字节;&arr + 1前进一个int[10],地址通常增加 40 字节。
2.1 指针加一不是地址数字简单加一
指针运算以"所指向类型的对象"为单位:
text
T *p;

p + 1 指向下一个 T 对象这正是指针保留类型信息的重要原因。int *、double *、int (*)[10] 即使暂时保存相同的起始地址,执行 +1 后的跨度也不一样。
2.2 one-past 指针能形成,但不能解引用
&arr + 1 指向整个数组末尾之后的位置。形成这样一个"尾后指针"可以用于边界比较,但它不指向实际数组元素,不能写 *(&arr + 1) 去访问对象。
同理,arr + 10 是一维数组的尾后指针;arr + 11 已经越过允许形成的范围。指针运算不是任意地址漫游,它应当限定在同一个数组对象及其尾后位置之内。
三、使用指针访问一维数组
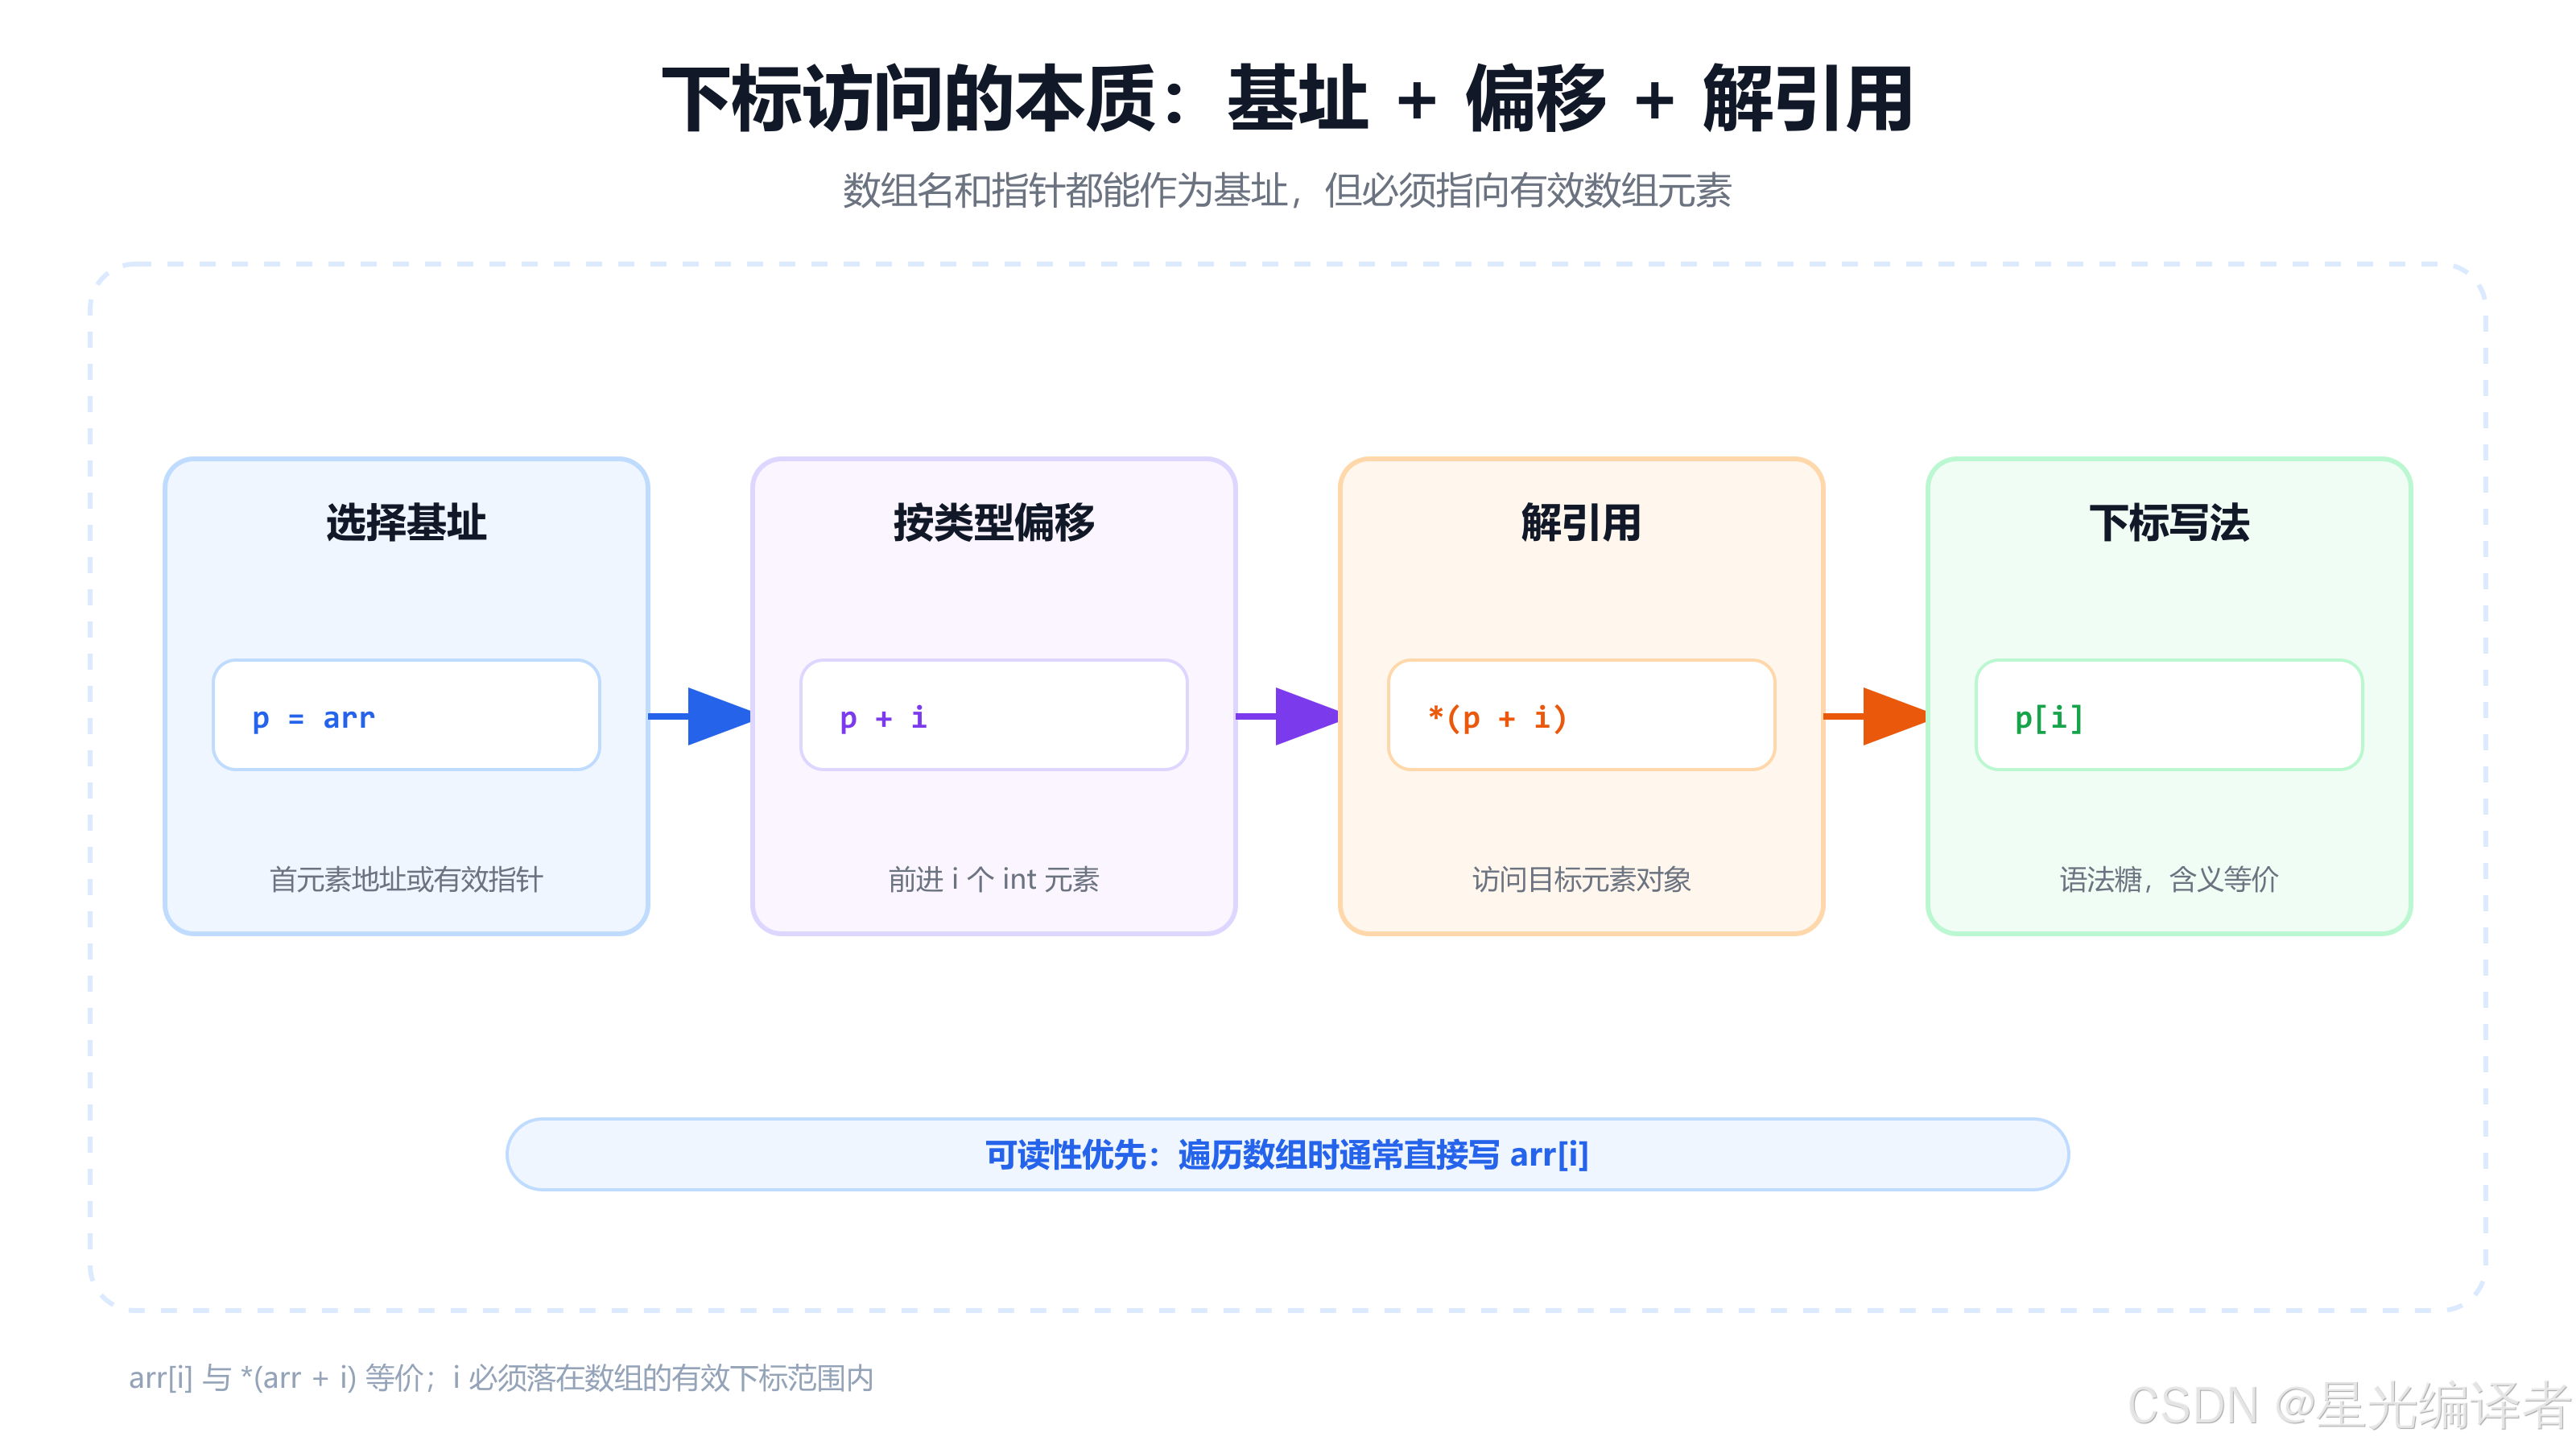
如果 p 指向数组首元素,那么 p + i 指向第 i 个元素,*(p + i) 就访问该元素:
c
#include <stdio.h>

int main(void)
{
    int arr[5] = {10, 20, 30, 40, 50};
    int *p = arr;

    for (size_t i = 0; i < sizeof arr / sizeof arr[0]; ++i)
    {
        printf("%d ", *(p + i));
    }
    putchar('\n');
    return 0;
}
输出:
text
10 20 30 40 503.1 p[i] 与 *(p + i) 等价
在 C 语言中,下标运算定义为地址偏移后解引用:
c
p[i] == *(p + i)
arr[i] == *(arr + i)
因此上面的输出循环也可以写成:
c
for (size_t i = 0; i < sizeof arr / sizeof arr[0]; ++i)
{
    printf("%d ", p[i]);
}
3.2 输入函数为什么直接写 p + i
scanf 需要的是对象地址。p + i 已经是第 i 个元素的地址,不需要再解引用:
c
int arr[5] = {0};
int *p = arr;

for (size_t i = 0; i < 5; ++i)
{
    if (scanf("%d", p + i) != 1)
    {
        /* 输入失败,按业务需要处理 */
        return 1;
    }
}
下面两种写法含义相同:
c
scanf("%d", p + i);
scanf("%d", &p[i]);
3.3 等价不代表可以忽略边界
若数组长度为 5,合法下标是 0 到 4。无论写 p[5] 还是 *(p + 5),都会解引用尾后指针,行为未定义。换一种指针写法不会让越界访问变得安全。
四、一维数组传参的本质
很多初学者会尝试在函数内部计算数组长度:
c
void test(int arr[])
{
    size_t count = sizeof arr / sizeof arr[0];
    printf("%zu\n", count);
}
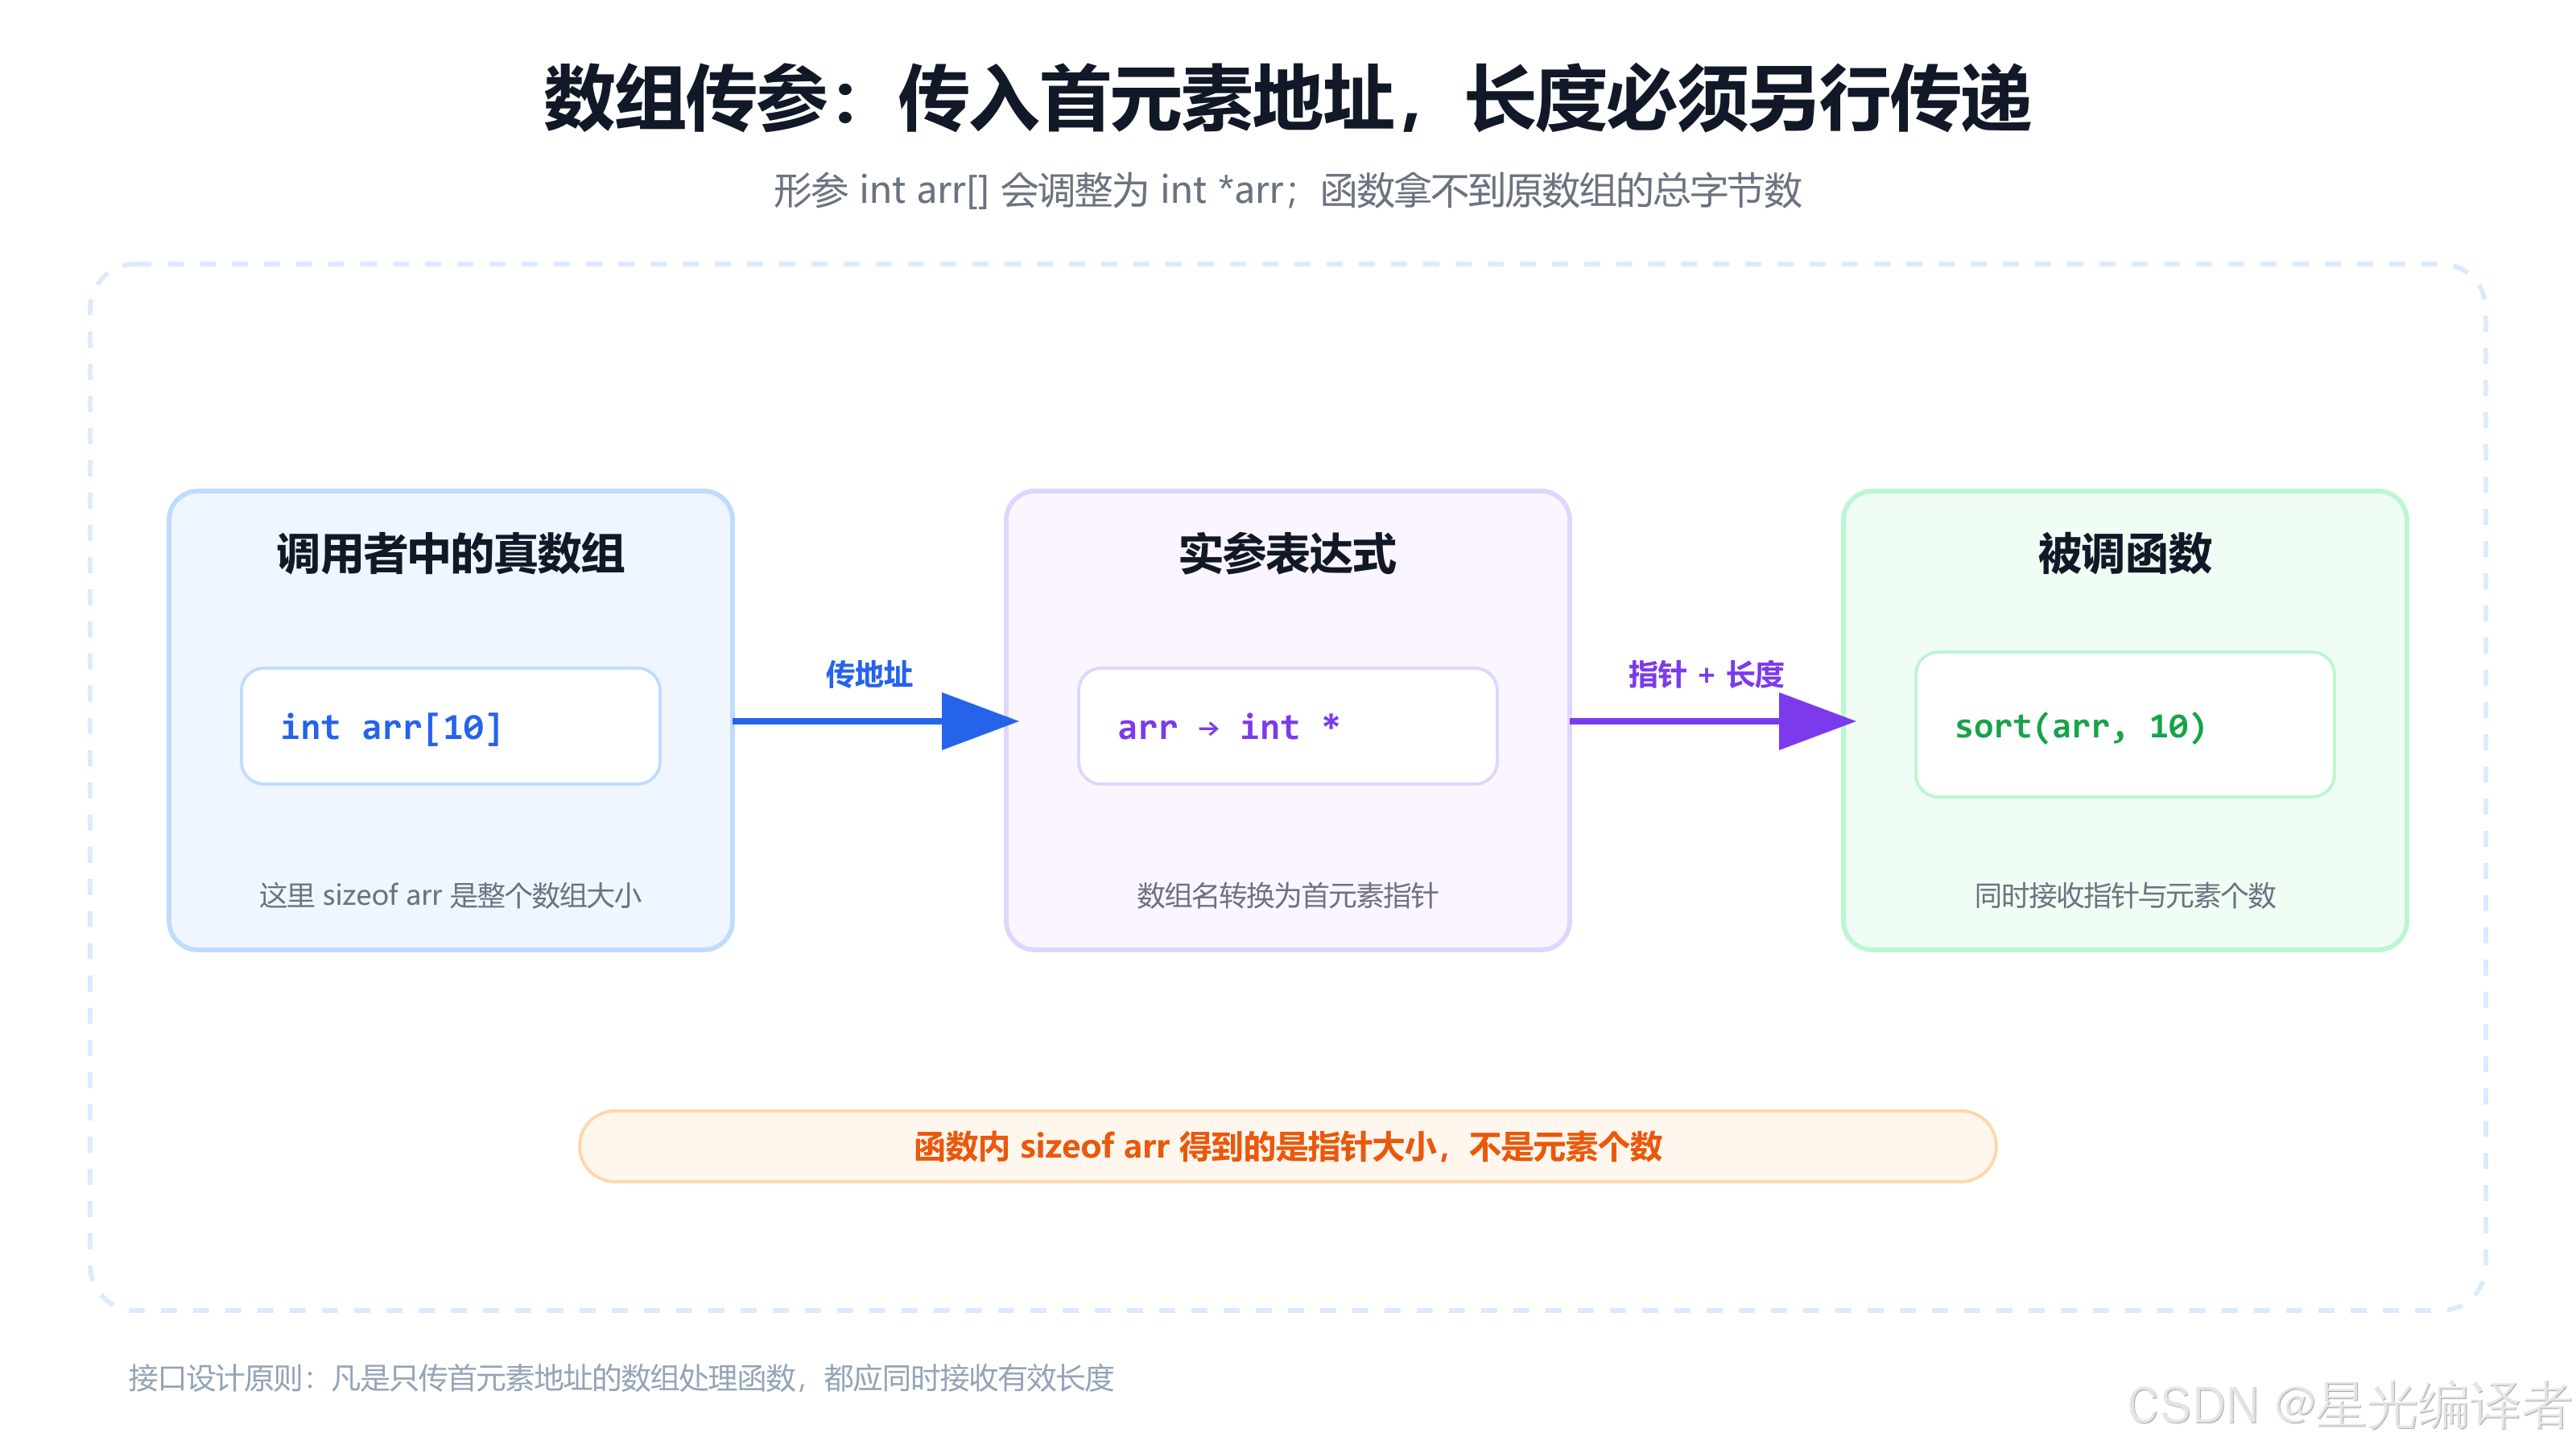
这段代码得不到调用者数组的元素个数。原因是函数参数列表中的数组写法会被调整为指针写法:
c
void test(int arr[]);  /* 调整为 int *arr */
void test(int *arr);   /* 与上面的函数类型相同 */
所以函数体里的 sizeof arr 计算的是一个指针变量的大小,不是原数组的大小。在常见的 64 位环境中它可能是 8,但不能把"指针永远是 8 字节"写成通用规则。
4.1 正确接口:同时传递指针和长度
c
#include <stddef.h>
#include <stdio.h>

void print_array(const int *arr, size_t count)
{
    for (size_t i = 0; i < count; ++i)
    {
        printf("%d%c", arr[i], i + 1 == count ? '\n' : ' ');
    }
}

int main(void)
{
    int data[] = {1, 2, 3, 4, 5};
    size_t count = sizeof data / sizeof data[0];

    print_array(data, count);
    return 0;
}
这里还有两个值得保留的习惯:
- 长度使用
size_t,与sizeof的结果类型一致; - 只读函数把参数写成
const int *,明确表示不会修改元素。
4.2 数组长度应在仍然拥有数组类型的位置计算
在 main 中,data 确实是数组,因此可以计算元素个数。把它传入 print_array 后,被调函数只拿到首元素指针和我们显式传入的 count。
可以定义一个只用于真实数组的宏:
c
#define ARRAY_SIZE(a) (sizeof(a) / sizeof((a)[0]))然后写:
c
print_array(data, ARRAY_SIZE(data));但不要对指针使用这个宏;传入 int *p 时,它仍然只会用"指针大小 ÷ 一个元素大小"得到毫无业务意义的结果。
五、把数组传参用到冒泡排序
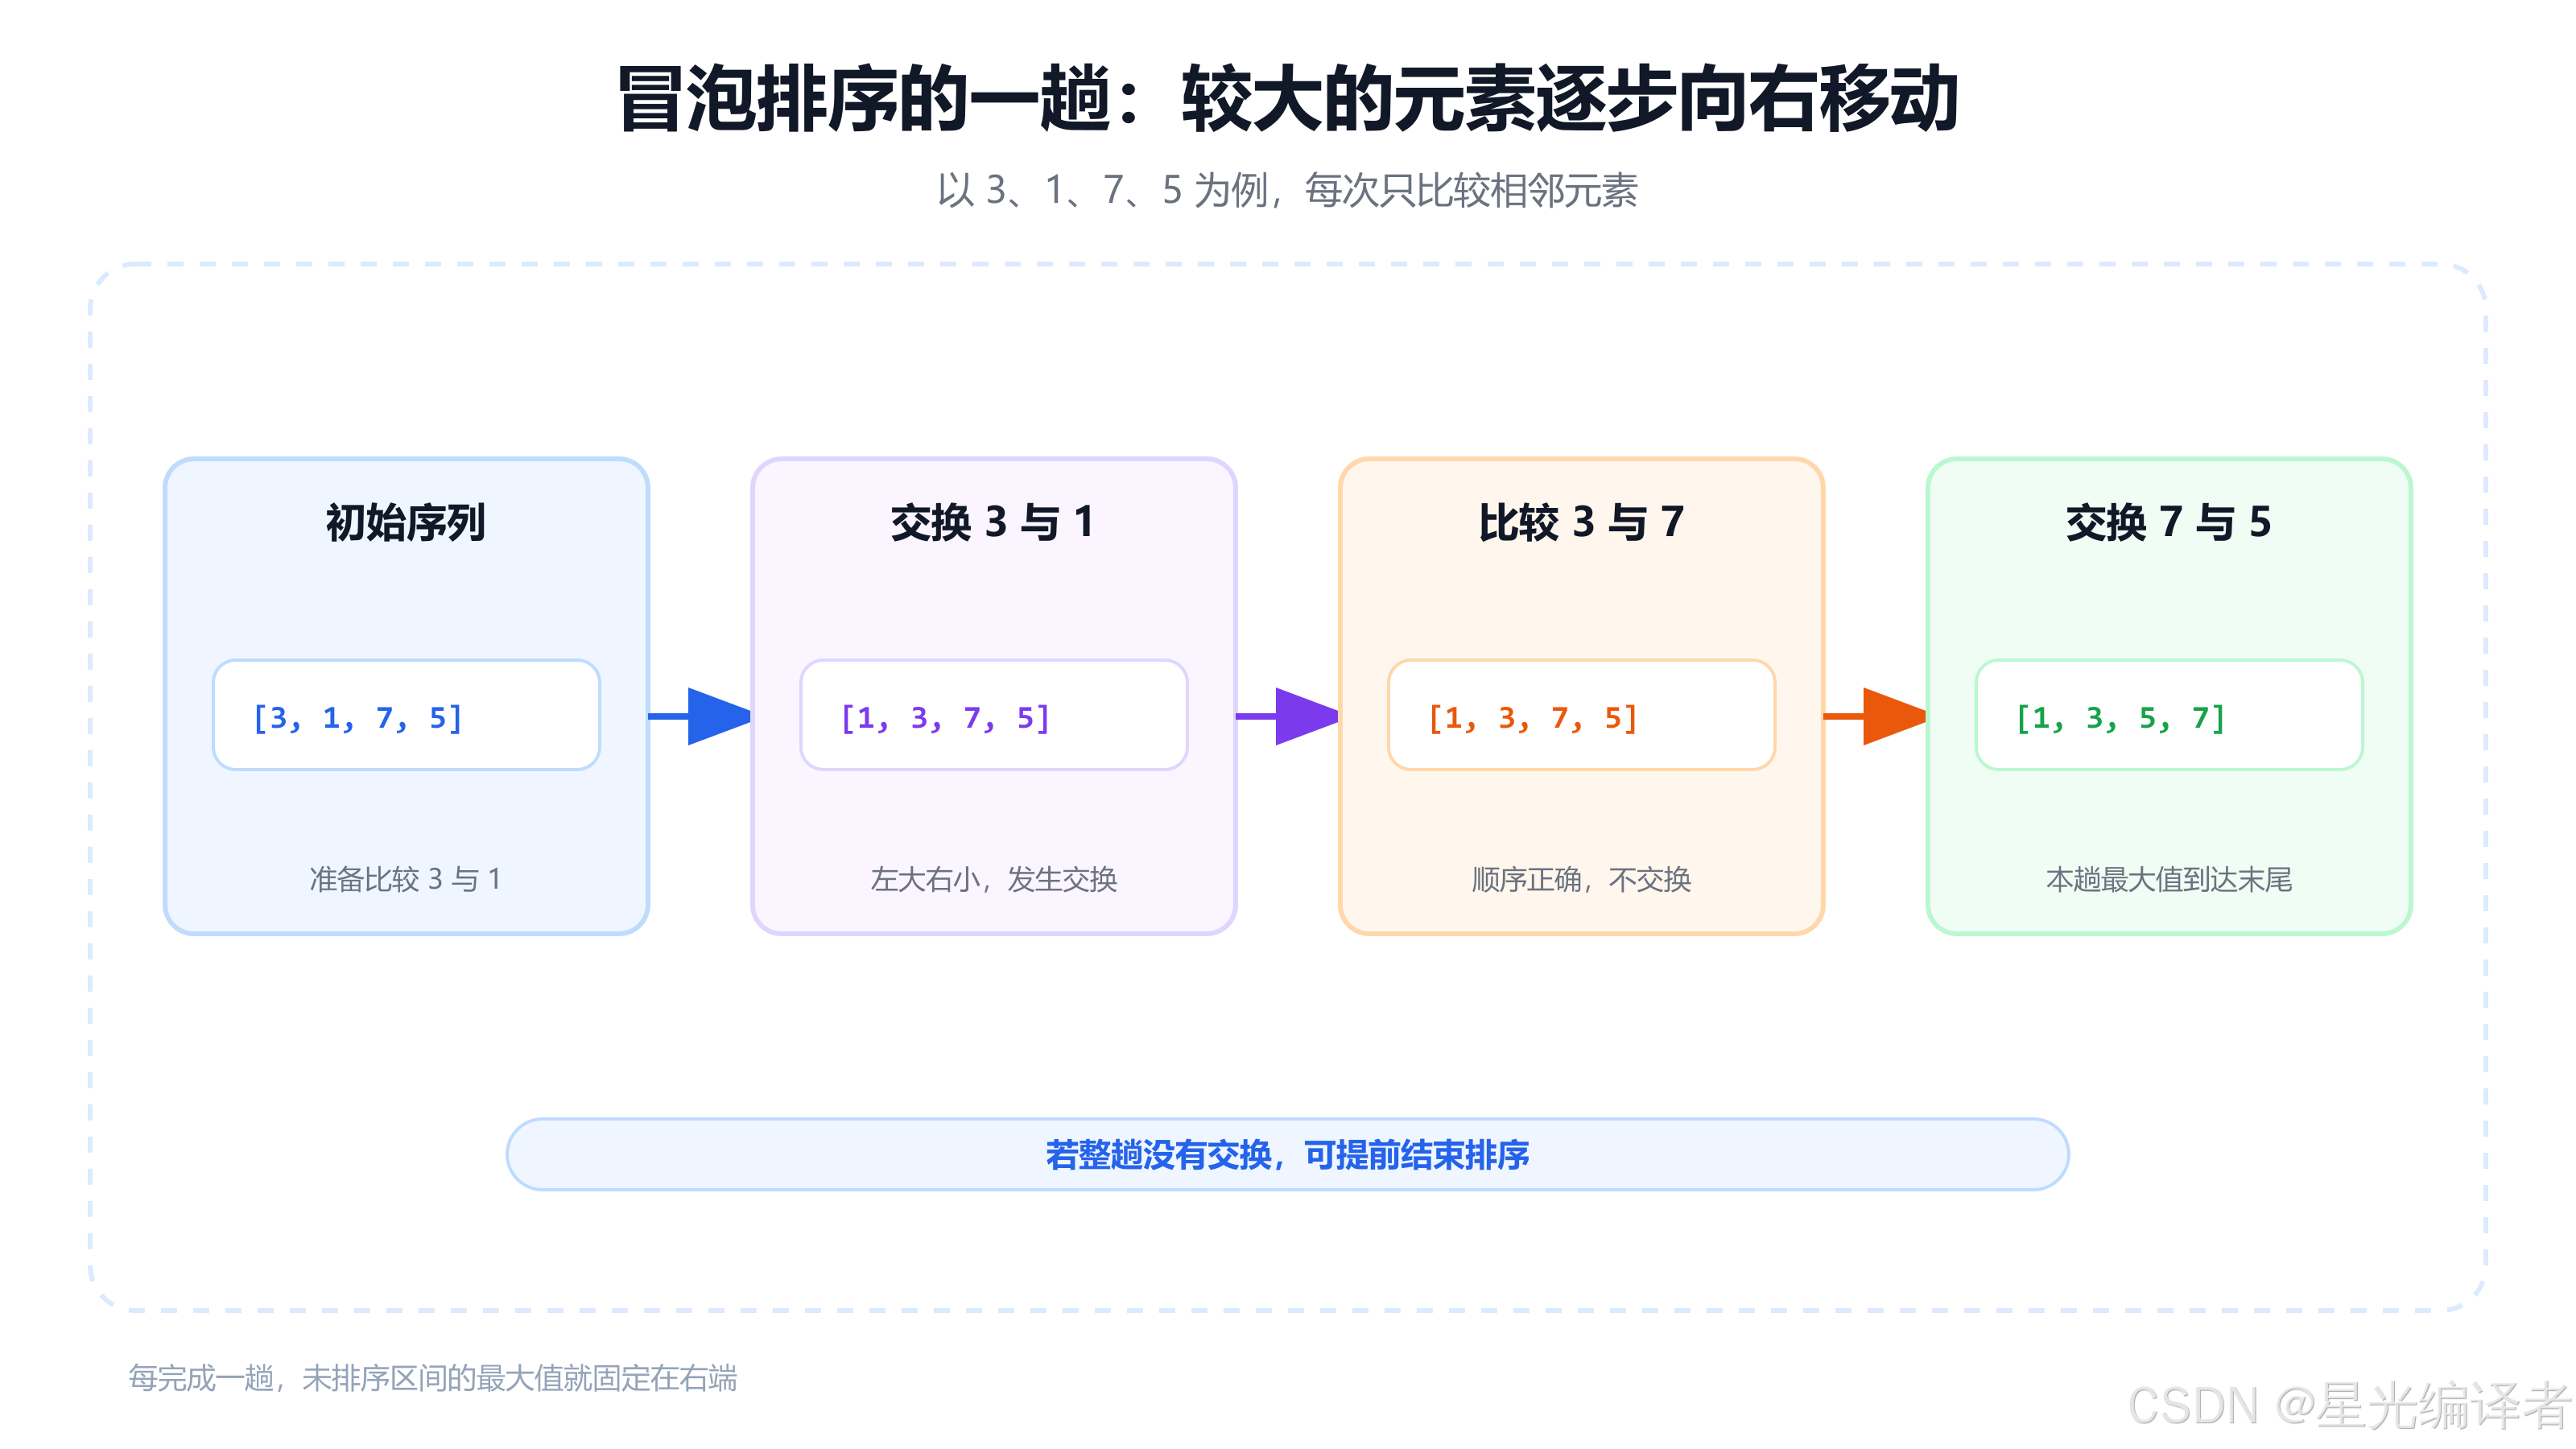
冒泡排序每次比较相邻元素。如果左边比右边大,就交换二者。完成一趟后,当前未排序区间中的最大值会移动到最右端。
5.1 基础版本
c
#include <stddef.h>

void bubble_sort(int arr[], size_t count)
{
    for (size_t i = 0; i + 1 < count; ++i)
    {
        for (size_t j = 0; j + 1 < count - i; ++j)
        {
            if (arr[j] > arr[j + 1])
            {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}
外层第 i 趟结束后,右边已经有 i + 1 个元素就位,所以内层不必再比较它们。
5.2 用交换标志提前结束
如果某一整趟没有发生交换,说明当前序列已经有序,后续循环可以直接停止:
c
#include <stdbool.h>
#include <stddef.h>

void bubble_sort(int *arr, size_t count)
{
    for (size_t i = 0; i + 1 < count; ++i)
    {
        bool swapped = false;

        for (size_t j = 0; j + 1 < count - i; ++j)
        {
            if (arr[j] > arr[j + 1])
            {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
                swapped = true;
            }
        }

        if (!swapped)
        {
            break;
        }
    }
}
调用者仍然负责提供长度:
c
#include <stdio.h>

int main(void)
{
    int data[] = {3, 1, 7, 5, 8, 9, 0, 2, 4, 6};
    size_t count = sizeof data / sizeof data[0];

    bubble_sort(data, count);

    for (size_t i = 0; i < count; ++i)
    {
        printf("%d%c", data[i], i + 1 == count ? '\n' : ' ');
    }
    return 0;
}
5.3 复杂度与稳定性
| 性质 | 结论 |
|---|---|
| 平均时间复杂度 | O(n²) |
| 最坏时间复杂度 | O(n²) |
| 最好时间复杂度 | 使用提前结束后为 O(n) |
| 额外空间复杂度 | O(1) |
| 稳定性 | 只在 > 时交换,属于稳定排序 |
冒泡排序并不适合大规模数据,但它非常适合练习数组传参、下标访问、循环边界和交换逻辑。
六、二级指针:指向指针的指针
指针变量也是对象,它自己同样有地址。若一个变量保存的是"指针变量的地址",它就是二级指针:
c
int a = 10;
int *pa = &a;
int **ppa = &pa;
这三层关系可以读成:
text
ppa  --指向-->  pa  --指向-->  a
int **           int *          int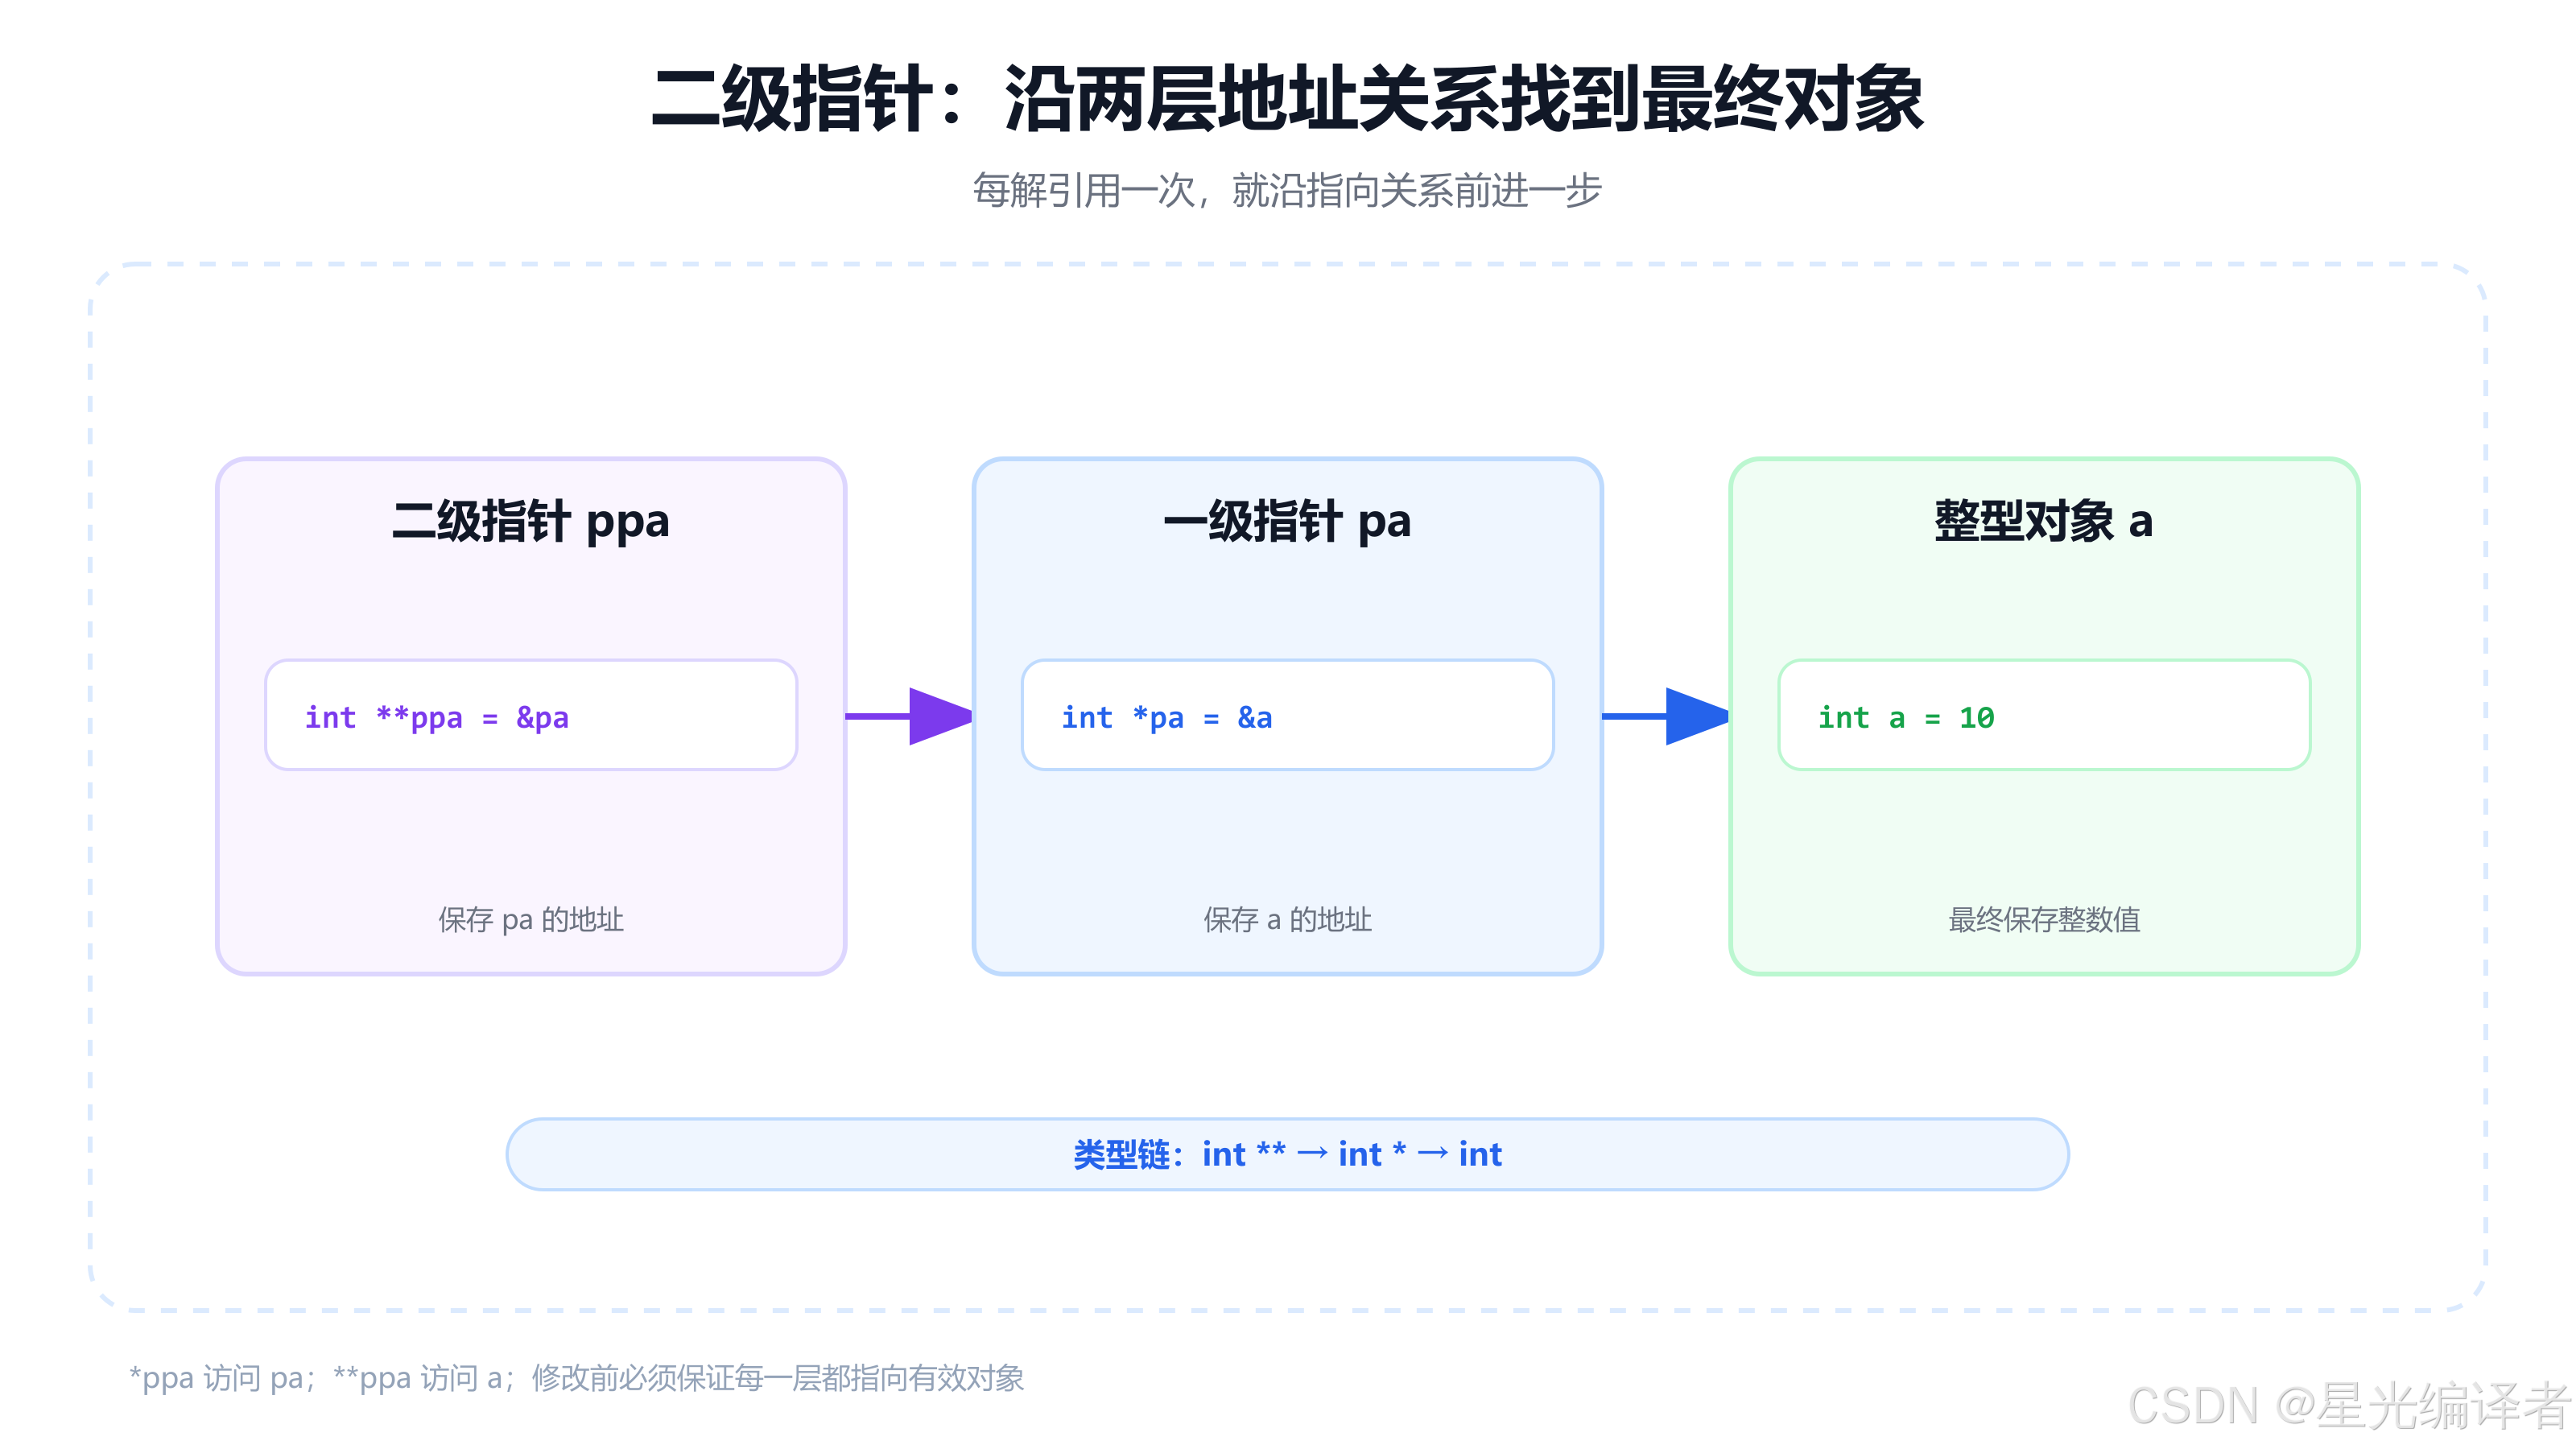
6.1 每个星号表示沿指向关系走一层
c
*ppa    /* 得到 pa 这个指针对象 */
**ppa   /* 再通过 pa 得到 a 这个 int 对象 */
因此:
c
int b = 20;

*ppa = &b;   /* 等价于 pa = &b */
**ppa = 30; /* 等价于 *pa = 30;现在修改的是 b */执行后,pa 已经改为指向 b,所以 **ppa = 30 修改的是 b,不是 a。
6.2 二级指针的典型用途
二级指针常用于:
- 函数需要修改调用者保存的指针;
- 管理动态分配得到的指针;
- 遍历字符串指针数组,例如
char **argv; - 操作由若干行指针组成的数据结构。
例如,让函数把调用者的指针改为指向另一个对象:
c
void redirect(int **target, int *new_address)
{
    if (target != NULL)
    {
        *target = new_address;
    }
}
调用:
c
int a = 10;
int b = 20;
int *p = &a;

redirect(&p, &b);
/* 此后 p 指向 b */
6.3 两层都必须有效
使用 **ppa 前至少要确认:
ppa指向一个仍然存在的int *对象;*ppa不是空指针,并且指向一个仍然存在的int对象。
二级指针不会自动保证这些条件。层级增加后,更应该通过清晰的变量名、生命周期和空指针检查保持关系可读。
七、指针数组:存放地址的数组
先按中心标识符分析声明:
c
int *rows[3];[] 的结合优先级高于 *,所以先看出 rows 是一个长度为 3 的数组;再看每个元素的类型是 int *。因此它是指针数组,不是"指向数组的指针"。
c
int a = 10;
int b = 20;
int c = 30;

int *items[3] = {&a, &b, &c};
访问方式:
c
printf("%d\n", *items[0]);  /* 10 */
printf("%d\n", *items[1]);  /* 20 */
printf("%d\n", *items[2]);  /* 30 */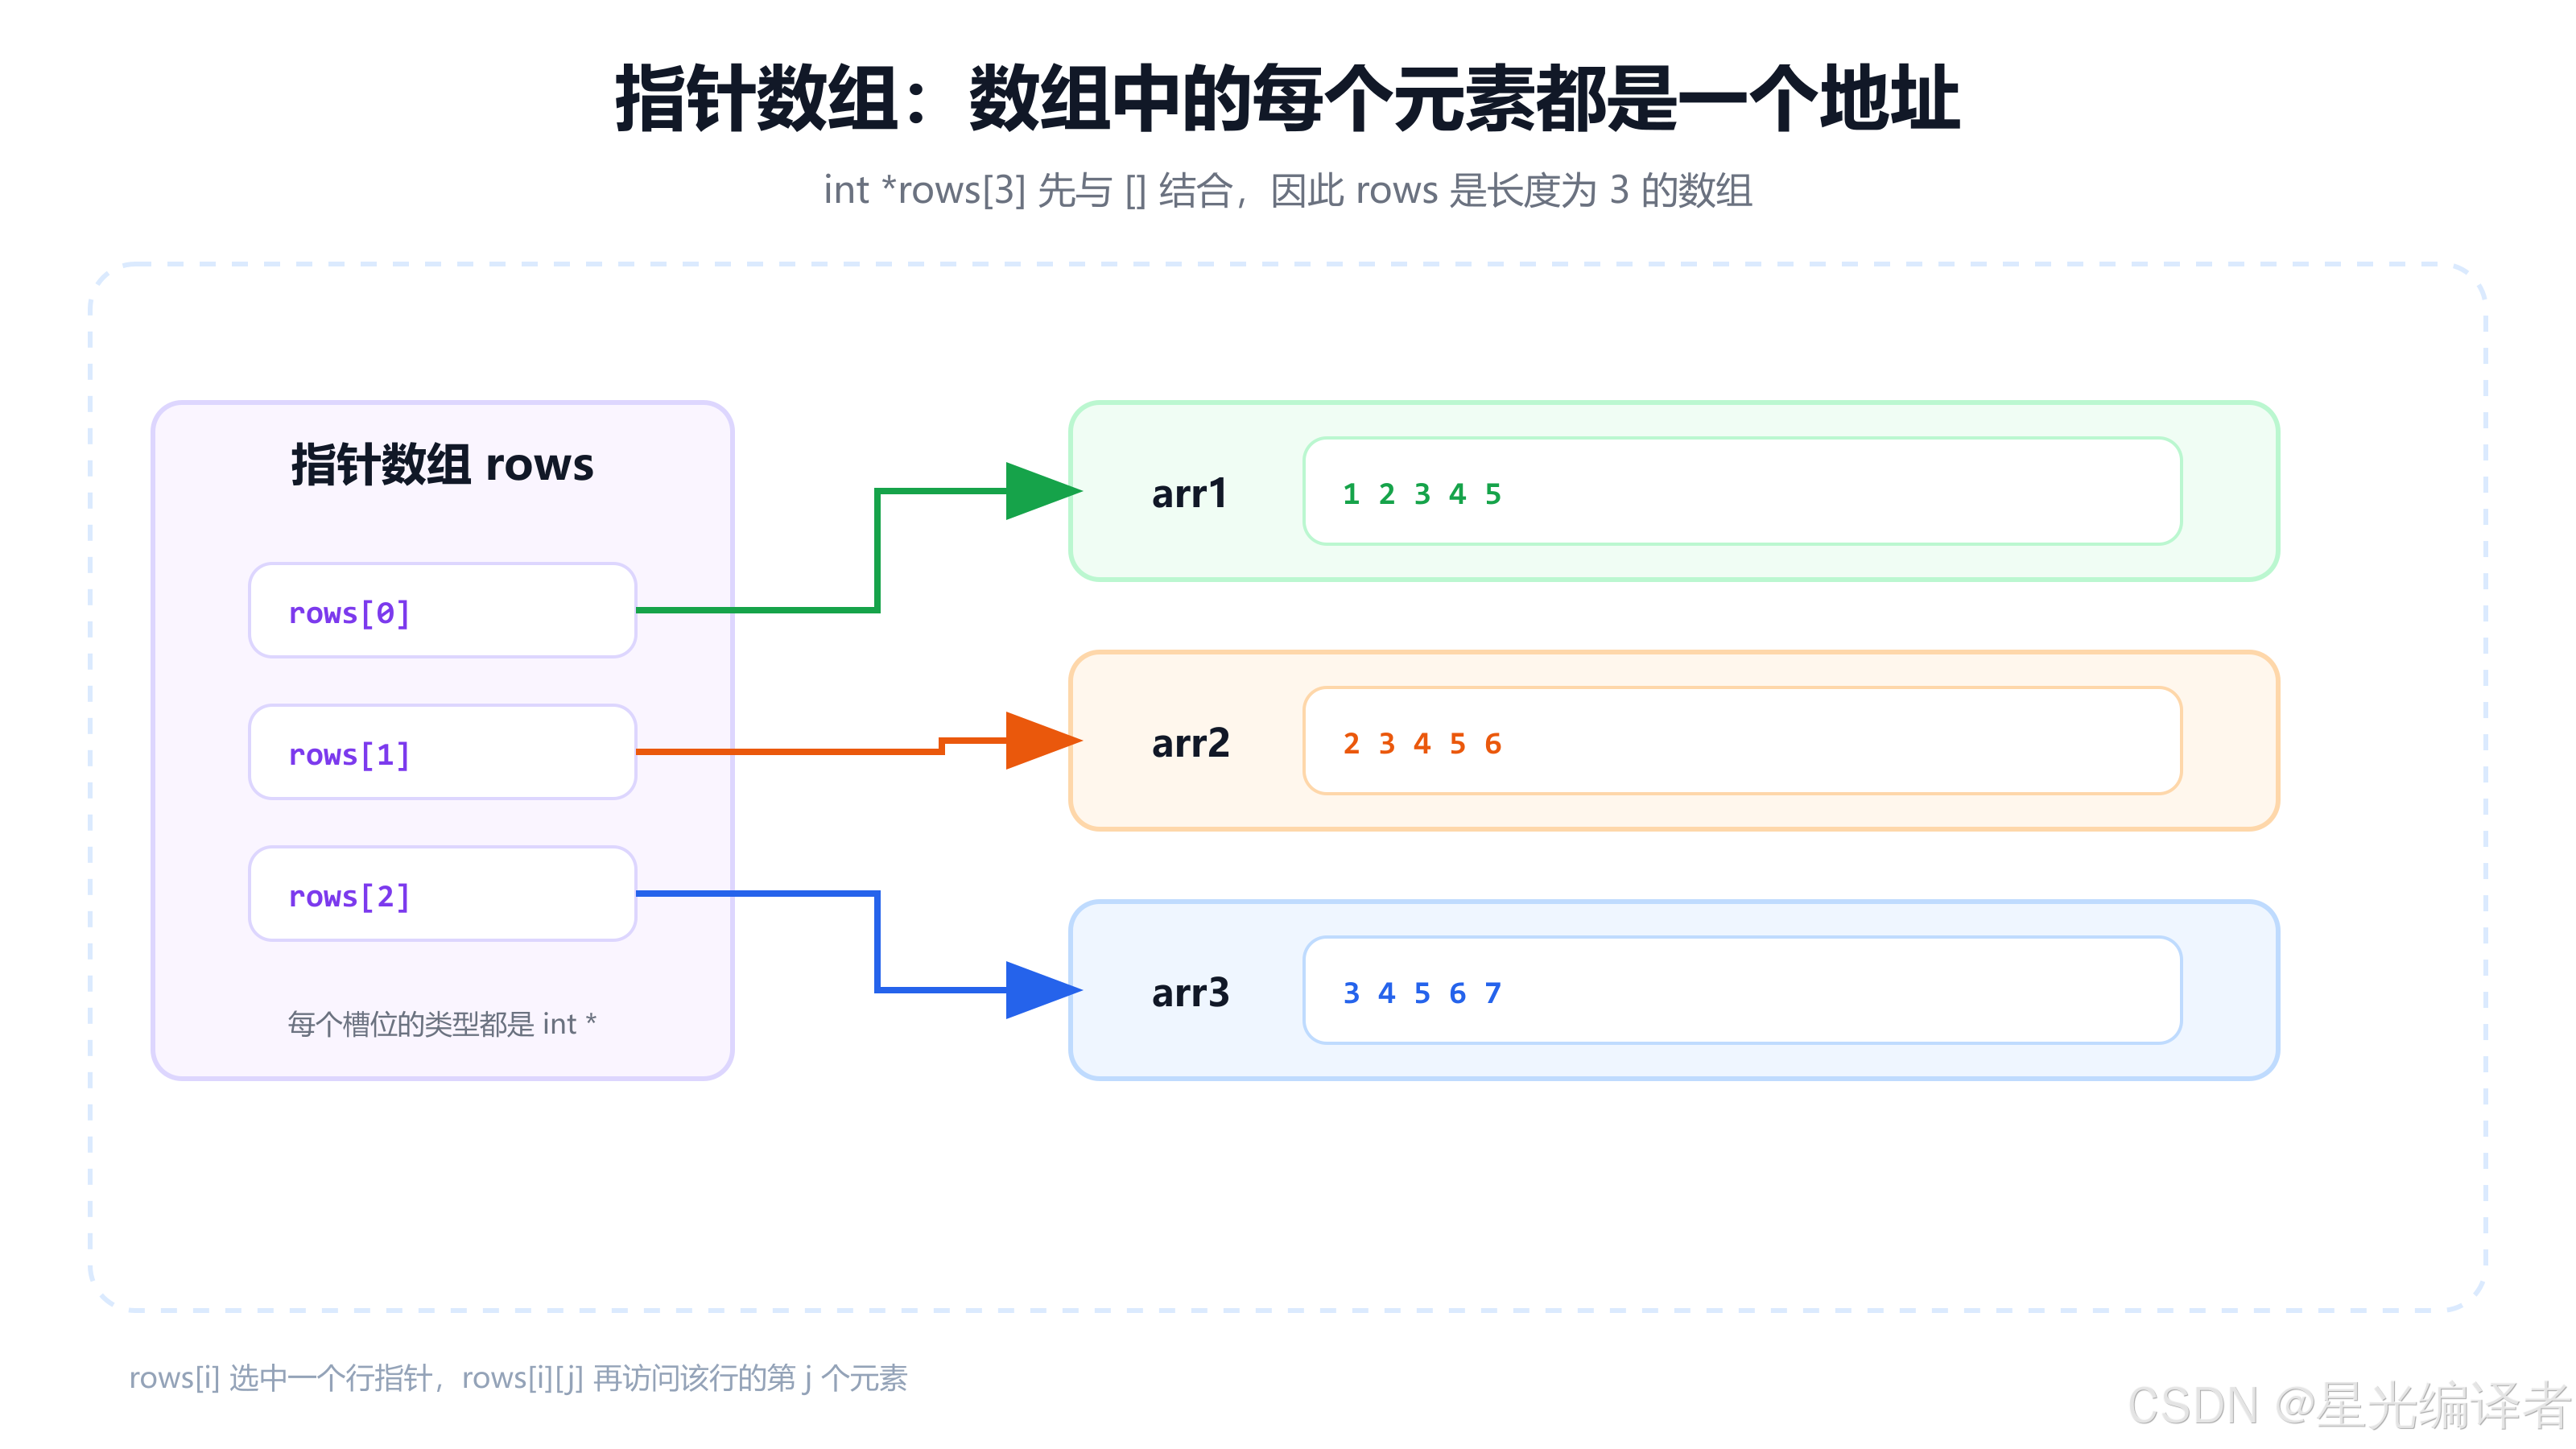
7.1 与数组指针对照
下面两个声明只差一对括号,含义完全不同:
c
int *p1[5];    /* p1 是数组,含 5 个 int * 元素 */
int (*p2)[5];  /* p2 是指针,指向含 5 个 int 的数组 */
可以用"先找变量名,再看它先与谁结合"的方法阅读:
p1先与[5]结合,所以主体是数组;p2被括号包住,先与*结合,所以主体是指针。
这组声明也是理解二维数组传参的关键。
八、用指针数组模拟二维数组
准备三个独立的一维数组,再让指针数组的三个元素分别指向它们:
c
#include <stdio.h>

int main(void)
{
    int row1[] = {1, 2, 3, 4, 5};
    int row2[] = {2, 3, 4, 5, 6};
    int row3[] = {3, 4, 5, 6, 7};

    int *rows[3] = {row1, row2, row3};

    for (size_t i = 0; i < 3; ++i)
    {
        for (size_t j = 0; j < 5; ++j)
        {
            printf("%d%c", rows[i][j], j + 1 == 5 ? '\n' : ' ');
        }
    }
    return 0;
}
为什么 rows[i][j] 能工作?逐层展开即可:
c
rows[i][j]
== *(rows[i] + j)
== *(*(rows + i) + j)
rows[i] 先取出第 i 个行指针,再用 [j] 访问该行中的第 j 个整数。
8.1 它与真正二维数组的区别
c
int matrix[3][5] = {
    {1, 2, 3, 4, 5},
    {2, 3, 4, 5, 6},
    {3, 4, 5, 6, 7}
};
真正的二维数组 matrix 是一个完整的连续对象,包含 3 个相邻的 int[5] 行数组。指针数组 rows 本身只连续保存 3 个指针;它们指向的三行可以位于互不相邻的位置。
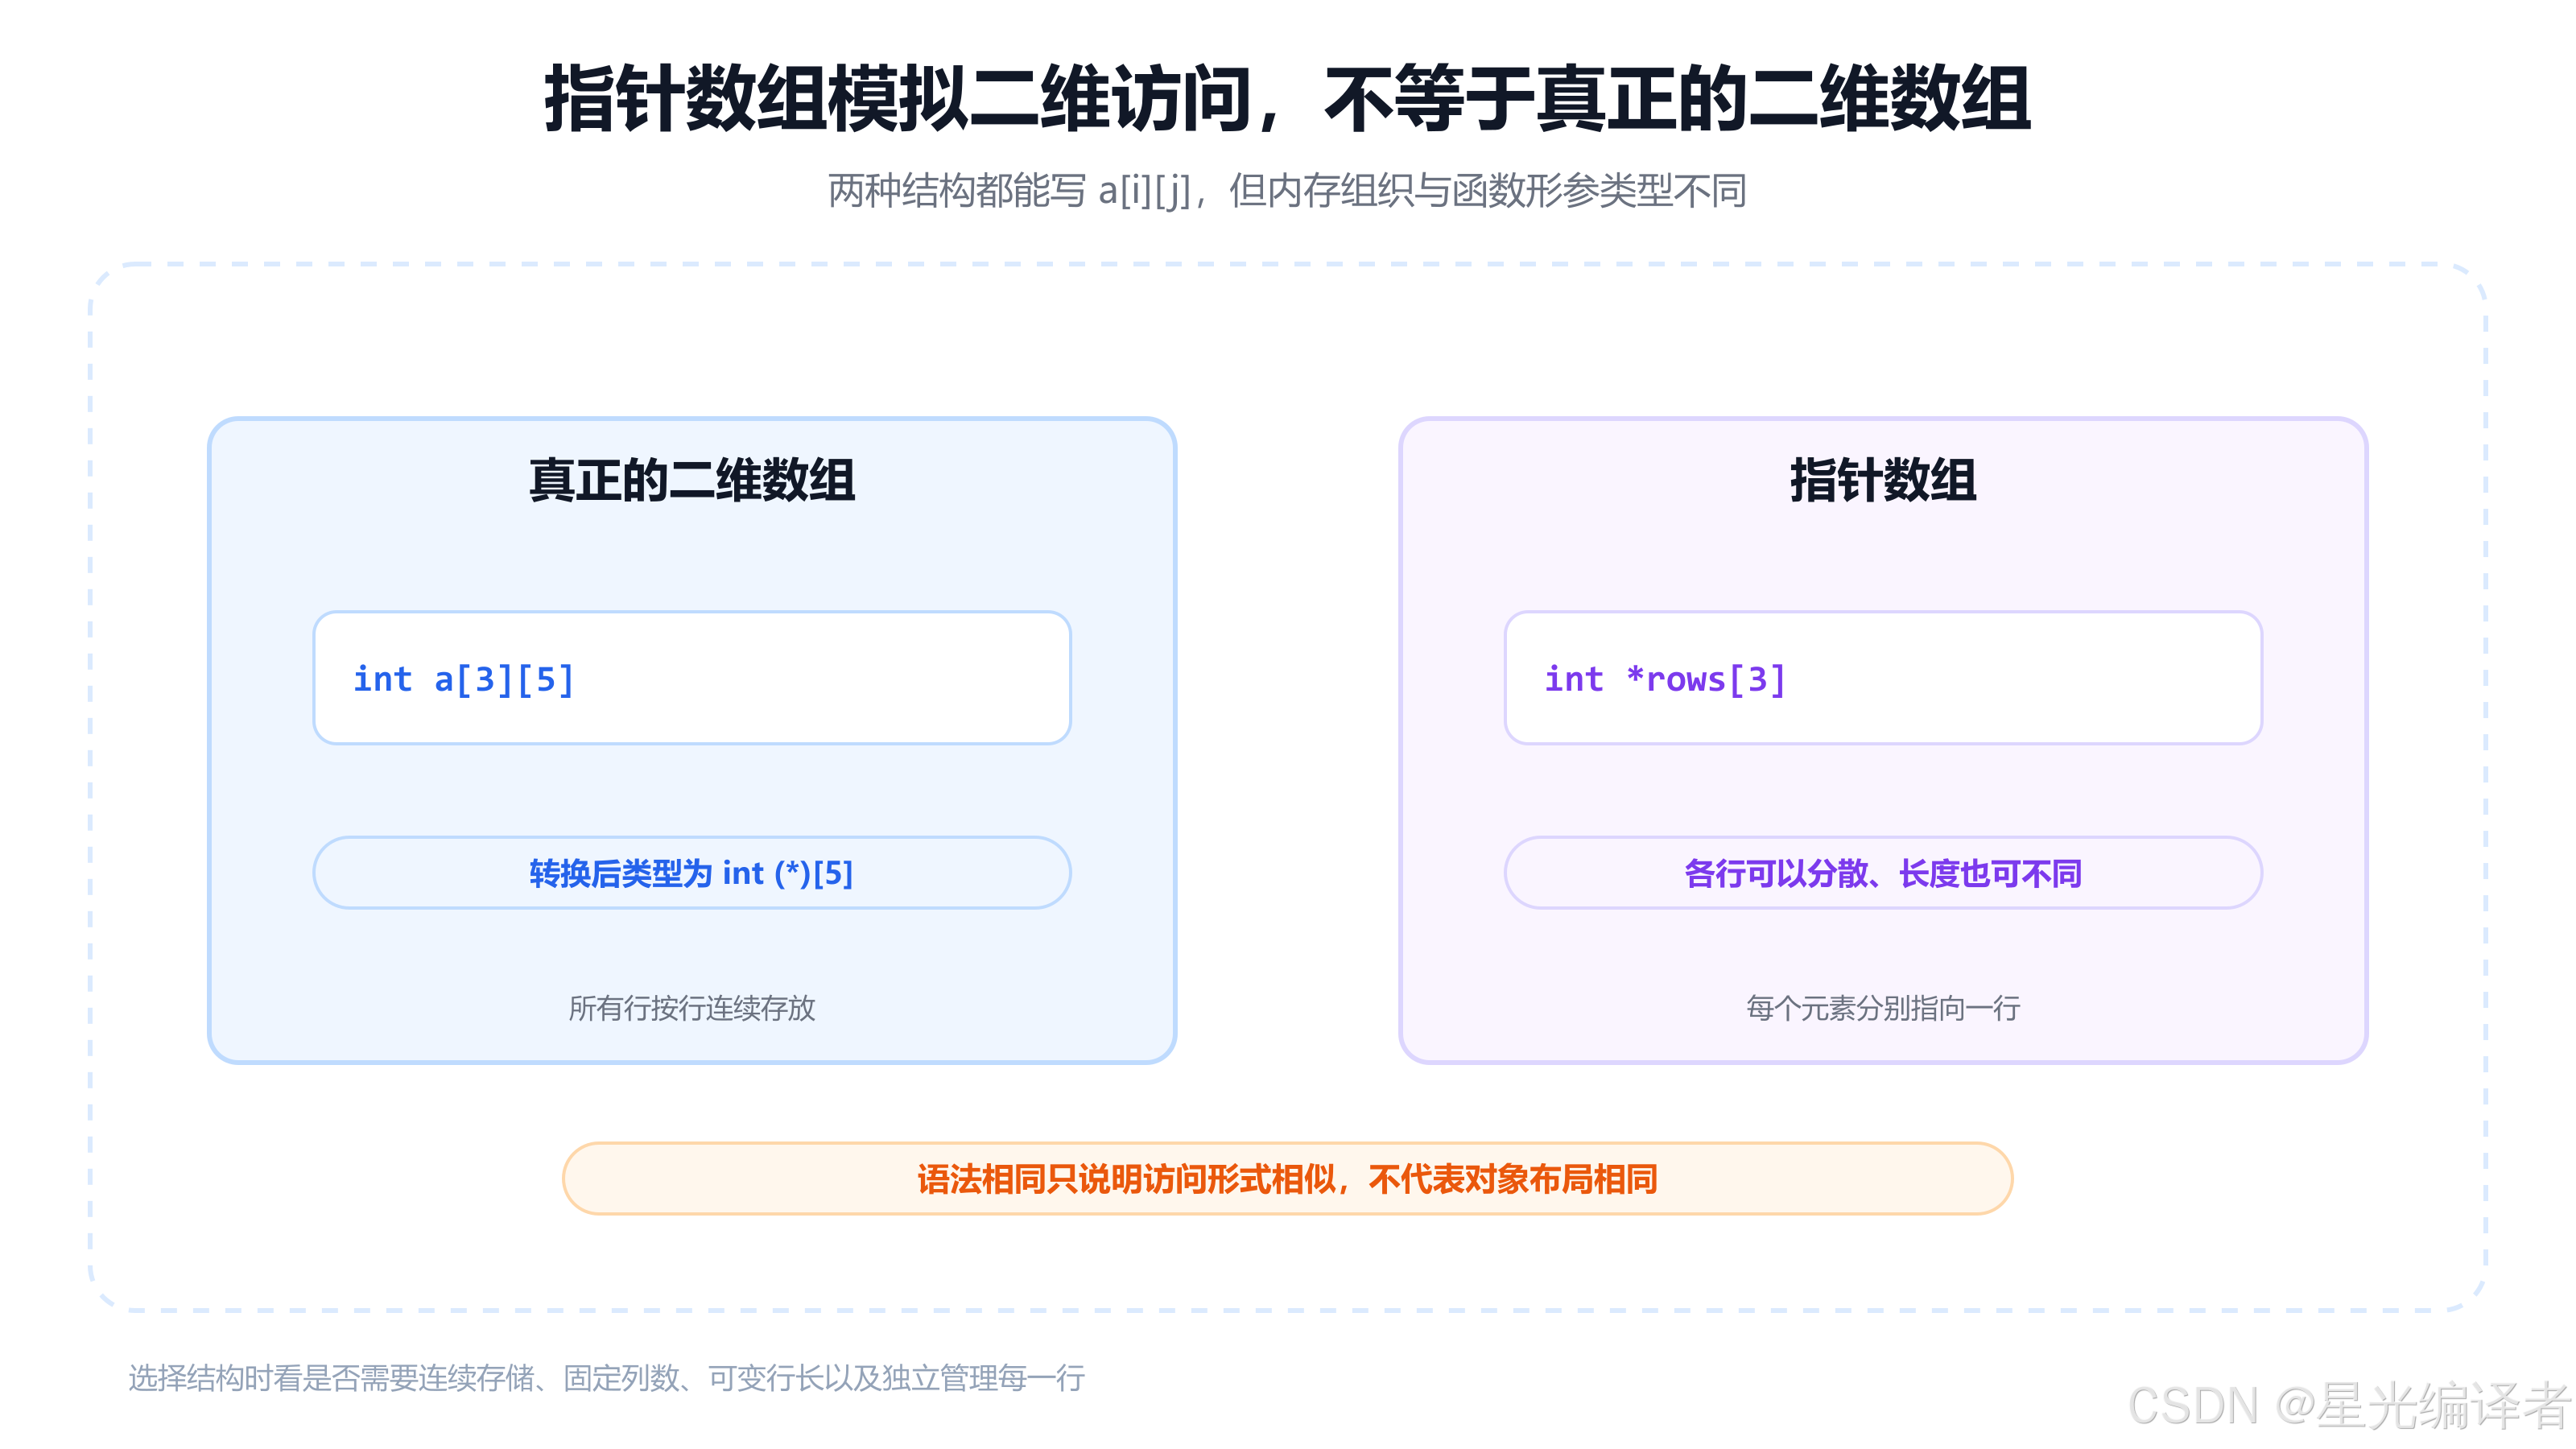
| 对比项 | int matrix[3][5] |
int *rows[3] |
|---|---|---|
| 主体 | 含 3 行的二维数组 | 含 3 个指针的数组 |
| 行数据布局 | 所有元素整体连续 | 各行可以分散 |
| 每行长度 | 固定为 5 | 可以让不同指针指向不同长度的行 |
| 普通表达式转换后 | int (*)[5] |
int ** 方向的首元素指针,即指向 int * 的指针 |
| 典型优势 | 局部性好、一次声明完成 | 行可独立选择或管理 |
注意:上表中的 rows 只有在普通表达式中才从"指针数组"转换为指向首元素的指针。它的首元素类型是 int *,所以转换结果是 int **。
8.2 真正二维数组怎样传参
二维数组传参时,函数必须知道每一行的列数,才能计算跨行步长:
c
#include <stddef.h>

void print_matrix(size_t row_count, int matrix[][5])
{
    for (size_t i = 0; i < row_count; ++i)
    {
        for (size_t j = 0; j < 5; ++j)
        {
            /* 使用 matrix[i][j] */
        }
    }
}
这个形参会调整为:
c
void print_matrix(size_t row_count, int (*matrix)[5]);它不是 int **。int ** 指向的是一个 int *,而 int (*)[5] 指向的是一个完整的五元素行数组;两者布局与步长都不同,不能因为都能写两个星号或两个下标就混用。
九、常见误区与练习
9.1 高频误区
误区一:数组名就是一个指针变量
数组名代表的是数组对象;只是在大多数表达式中会转换为首元素指针。数组不能像指针变量那样重新赋值。
误区二:地址打印一样,类型就一样
arr 与 &arr 可能打印相同的起始地址,但前者在普通表达式中是 int *,后者是 int (*)[10]。观察 +1 的步长就能看出差异。
误区三:任何函数里都能用 sizeof(arr) / sizeof(arr[0])
只有当 arr 在当前位置仍是真实数组时才成立。函数形参 int arr[] 已调整为指针,必须由调用者另外传长度。
误区四:int ** 可以接收任意二维数组
真正二维数组转换后通常得到"指向一行数组的指针",如 int (*)[5],不是 int **。二者不能互相替代。
误区五:指针数组中的各行天然连续
指针数组只保证指针槽位连续,不保证每个指针指向的数据区域彼此相邻。逐行分配时还要分别管理每一行的生命周期。
9.2 自测题
int arr[8]中,arr + 1与&arr + 1分别跨过多少个int?- 为什么
sizeof arr在main中能得到整个数组大小,而在void f(int arr[])中不能? int *table[4]与int (*table)[4]分别是什么?p[i]可以怎样用指针运算展开?展开后最容易忽略的安全条件是什么?- 冒泡排序中,为什么只在
arr[j] > arr[j + 1]时交换能保持稳定性? - 若
ppa的类型为int **,*ppa与**ppa的类型分别是什么?
9.3 参考答案
arr + 1跨过 1 个int;&arr + 1跨过整个int[8],也就是 8 个int。main中的arr仍是数组;函数参数中的数组声明会调整为指针。- 前者是含 4 个
int *的指针数组;后者是指向int[4]的数组指针。 p[i]等价于*(p + i);必须保证p指向有效数组且i未越界。- 相等元素不会交换相对位置,因此排序稳定;若使用
>=交换,稳定性会被破坏。 *ppa的类型是int *,**ppa的类型是int左值。
总结
这一讲表面上在讲数组与更多指针写法,真正贯穿全文的是四个判断步骤:
- 先看对象是什么:数组、指针变量、指针数组还是二维数组;
- 再写出表达式类型 :
int *、int **还是int (*)[N]; - 再判断步长与边界:指针加一跨过哪个类型,能否安全解引用;
- 函数接口显式携带长度:首元素地址不会自动保存原数组的元素个数。
数组名在普通表达式中通常转换为首元素指针,但 sizeof(arr) 与 &arr 会保留整个数组的语义;p[i] 是 *(p + i) 的下标写法;一维数组传参本质上只把首元素地址交给函数;二级指针沿两层地址关系访问对象;指针数组则把多个地址组织成一个数组。
把这些关系真正理解后,复杂声明不再只是"数星号",而会变成一张清晰的类型与对象地图。下一次看到 arr、&arr、int ** 或 int (*p)[N] 时,先问一句:它指向的究竟是哪一种对象?
🔥 如果这篇文章对你有帮助,欢迎点赞、收藏与关注。
📚 下一篇继续深入 C 语言指针的更多高级用法。