Agent Memory / 强化学习 MemPO源码学习笔记 ---(5)--- GRPO
0x00 概要
现有的基于强化学习的 Memory 管理方法往往缺乏一种有效机制针对 Memory 的更新内容进行引导优化,Memory 的内容难以保证质量。
MemPO(Self-Memory Policy Optimization)使模型对 Memory 进行自管理,并引入了基于有效信息含量的 Memory-level 的优势估计,引导 Memory 保留对解决任务更有效的信息,进而提升记忆有效性。
MemPO的独特切入点:让模型把记忆写在每轮开头(),形式上像"自我对话的草稿纸",既是记忆又是思考链的一部分。这样,变成可训练的策略变量,用RL信号端到端地教会模型"什么值得记、怎么记"。RL 直接端到端优化这一行为,无需额外的记忆模块。
MemPO 的信息如下:
- 论文标题:MemPO: Self-Memory Policy Optimization for Long-Horizon Agents
- 论文地址:arxiv.org/abs/2603.00...
- 代码地址:github.com/TheNewBeeKi...
- 模型和数据集地址:huggingface.co/collections...
本篇看看GRPO的使用。
0x01 原理
1.1 现状
Agent 引入记忆机制的目的是通过移除无关信息、保留关键细节来应对智能体的长上下文问题。
原始 GRPO 基于答案正确性计算奖励,并使用轨迹级别的优势 (advantage),即同一条轨迹内所有 token共享同一个奖励。这导致对记忆生成的奖励信号稀疏、指导有限 --- 因为最终答案的正确性无法直接反映交互过程中每次 操作的质量。
MemPO设计了一种新颖的优势计算方法:在轨迹级优势之外,额外评估每一步 中记忆的信息含量,并计算一个附加的优势值,从而确保记忆在保持简洁的同时保留重要信息。
论文原文说的:"computes an additional advantage"= 除了 outcome_adv 之外,额外再算一个 advantage。 "附加的优势值" 指的就是 Memory Advantage (mem_adv)。
对应代码:A2: compute_grpo_memory_advantage () → mem_adv = (P_mem - P_full - mean) /std → 仅作用于 ... 区间
ini
叠加方式 (A3):final_adv = outcome_adv + mem_adv
                          ↑ 原有的        ↑ "附加的"(additional)
"附加"(additional) 强调的是:这是 MemPO 在 GRPO 基础上新增的部分 --- 原始 GRPO 只有 outcome_adv, MemPO 额外加了 mem_adv来精确指导 的生成质量。
1.2 GRPO
GRPO是PPO的一个变体,区别仅在于advantage的计算方式(用组内统计替代 Critic)。GRPO 本质上是 " 用统计方法替代了 Critic网络 "--- 把一个需要学习的组件 (Critic) 换成了一个不需要学习的统计计算 (组内均值 / 标准差),代价是需要每个question 生成多条轨迹。其他所有环节 (PPO 优化框架) 不受影响。
标准PPO:
scss
advantage = V_critic(s) - R(s) ← 需要单独训练一个Critic网络GRPO (Group Relative Policy Optimization):
ini
advantage =(reward-group_mean)/ group_std  ←   不需要Critic
其中group = 同一个question的16条rollout轨迹
GRPO 是"无Critic的PPO"------它保留了PPO 的:
- Clipped surrogate loss
- Importance sampling ratio
- KL penalty to ref model
- 多 epoch mini-batch 更新
但去掉了 Critic网络,用同组轨迹的相对排名代替 value baseline。
1.3 PPO vs GRPO
GRPO 和 PPO 的核心差异就在于 advantage 的计算方式。其余部分 (clipped loss、ratio、KL、多epoch更新) 完全相同。
- PPO: adv = reward - V (s) ← 需要训练 Critic 来估计 V (s)
- GRPO: adv = (score - mean) /std ← 用同组轨迹统计量替代 V (s)
PPO 和 GRPO 对比如下:
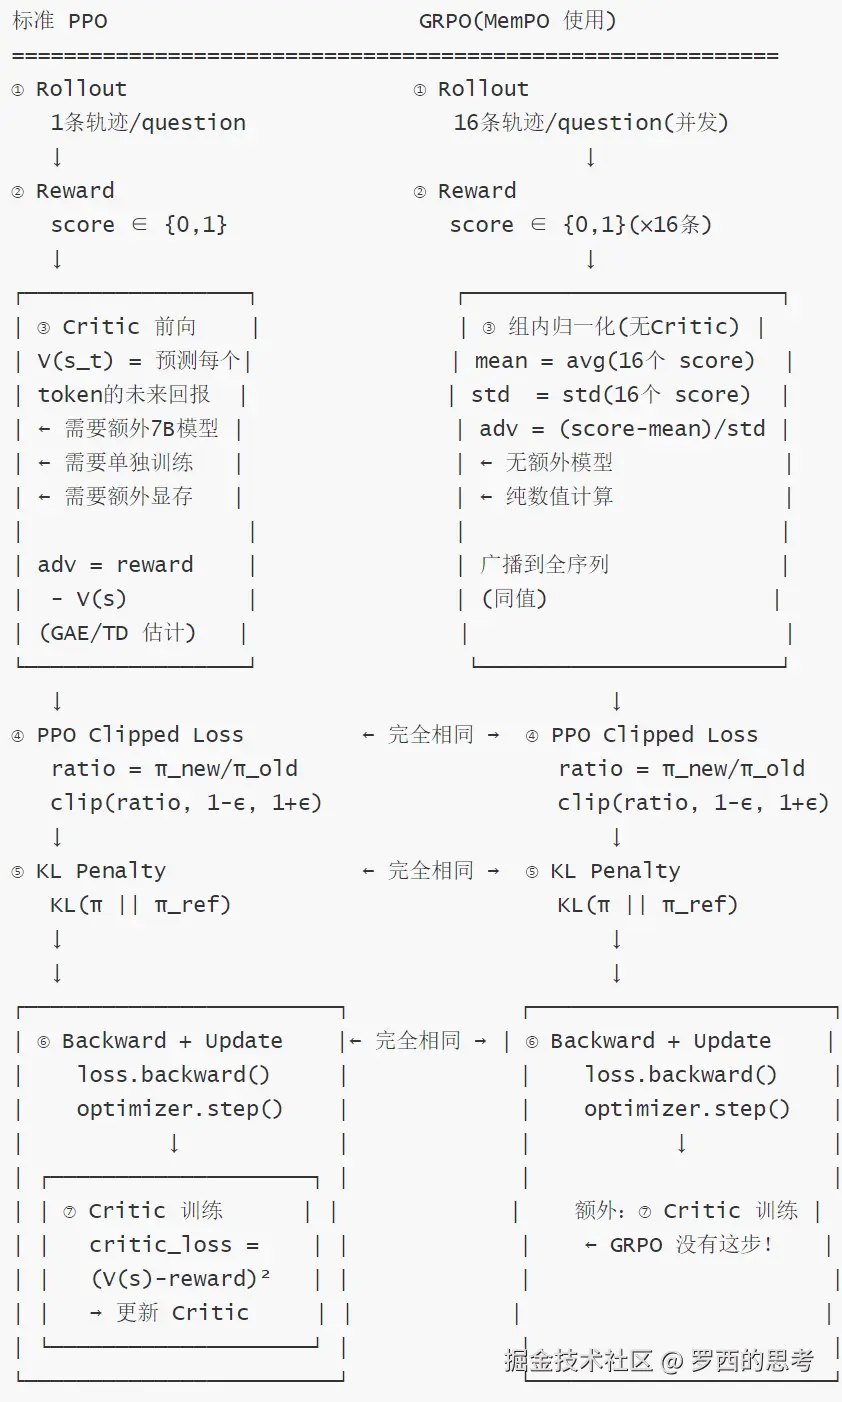
5-PPO 和 GRPO 对比
差异汇总如下:
scss
┌──────────────────┬─────────────────────────────┬─────────────────────────────┐
│                  │ 标准 PPO                     │ GRPO                        │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 轨迹数/question   │ 通常1条                     │ 16条(group size)            │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ Critic 网络       │ ✅ 需要(~7B)               │ ❌ 不需要                    │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ Advantage 来源    │ GAE: reward-V(s)            │ (score-mean)/std            │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 额外训练步骤      │ Critic loss                  │ 无                           │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 显存占用          │ actor+ref+critic             │ actor+ref                  │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ Advantage 精度    │ token-level(但有             │ trajectory-level          │
│                  │ estimation error)            │ (无estimation error)     │
├──────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 适合场景          │ dense reward                 │ sparse/outcome reward       │
└──────────────────┴─────────────────────────────┴─────────────────────────────┘
1.4 为什么MemPO选GRPO而不是PPO+Critic
MemPO不用Critic的四个原因如下:
Critic 在多轮长序列中极难训练
标准PPO:V(s_t) 需要为序列中每个token位置预测未来累计回报,预测"未来能否答对"。
但是,MemPO的序列结构为:Round1_tokens \| Round2_tokens \| ...\| Round5_tokens。此长度可达数千token,奖励仅在最末尾(sparse reward)。
因此,Critic 面对的挑战:
- 序列极长 → 需要巨大容量的value网络
- 奖励极稀疏→ V(s)几乎处处为0,难以学到有意义的信号
- 多轮工具交互→状态空间复杂,value estimation 噪声大
GRPO 比较适合 outcome-based 稀疏奖励
GRPO 用同组轨迹均值替代value baseline,比较适合trajectory-level离散奖励。
- GRPO的假设:奖励是trajectory-level的标量 → 完美匹配EM check的{0, 1}评分。
- 不需要学习 V(s_t):baseline = 同 question 16 条轨迹的均值 = (score - mean) / std → 零额外参数,零额外训练,无 value estimation 误差。
计算资源节约
PPO+Critic:
- 额外一个与actor 同规模的 Critic 网络(7B 参数)
- Critic需要额外前向+反向
- 显存翻倍:actor(7B)+ ref(7B)+ critic(7B)=21B 参数
GRPO:
- 仅actor(7B)+ref(7B)=14B参数
- 省下的资源用于更多并发rollout(16条/question)
Memory Reward 的特殊性
Memory Reward 本身自带baseline(P_mem-P_full),无需Critic 估计。
ini
mem_reward=P_mem-P_full 这本身就是一个"自带baseline"的信号如果用 Critic,还需要为 区间单独训练 value head → 但的"好坏"取决于未来能否答对(极长时间依赖)→ Critic几乎不可能准确估计这个value。
GRPO方案:直接跨轨迹归一化mem_reward,简单有效
小结
GRPO在MemPO 场景下是更实用的选择一一稀疏奖励、长序列、多轮交互这三个特点让Critic训练极其困难,而 GRPO通过"同组相对排名"巧妙绕过了value estimation问题。
MemPO最特色的地方:在标准GRPO之上,额外为片段设计了细粒度的位置感知奖励,让梯度信号可以精确地作用于"记忆写作"行为,而不只是笼统地惩奖整条轨迹。
我们接下来仔细分析。
0x02 MemPO GRPO
2.1 阶段
GRPO算法 = Advantage 计算方式 + PPO 优化框架,因此具体可以分两个环节:
环节1:GRPO Advantage计算(无梯度)
ini
B4-algo: outcome_adv =(score - mean) / std     ← 纯数值运算
A2: mem_adv = (r_t-mean) / std                 ← 纯数值运算
A3: final_adv = outcome_adv + mem_adv          ← 纯加法
所有 advantage 都是detached 常数,不参与计算图
环节2:PPO Update(有梯度)
css
for epoch in ppo_epochs:
    for mini_batch in shuffie(batch):
        new_log_prob = actor.forward(mini_batch)
                               ↑梯度计算

        ratio = exp(new_log_prob - old_log_prob)
        loss = -mean(final_adv x clip(ratio)) + KL_penalty

        loss.backward()   ← 反向传播
        optimizer.step()  ← 模型优化
总结:GRPO只决定"每个token 该鼓励还是抑制、强度多大"(advantage 值),但"怎么优化模型参数"完全是PPO 的事一一一梯度计算、反向传播、模型更新都在 PPO Update 环节。
2.2 模型
MemPO 有以下几种模型
actor(策略模型):
- 就是正在被训练的LLM(如Qwen2.5-7B)
- 每个PPO step都会更新其参数
- 配置:actor_rollout_ref.model.path→初始化自SFT模型
- 既用于rollout生成,也用于PPO更新时的前向计算
ref_model(参考模型):
- 与actor结构完全相同的 LLM,但参数冻结不更新
- 初始化为训练开始时的actor快照(即SFT模型本身)
- 作用:计算KL散度惩罚KL(
π_actor || π_ref) - 防止actor偏离初始策略太远(PPO的信任域约束)
在代码中的体现:
ini
run_train.sh 中:
    actor_rollout_ref.model.path="NewBeeKing/MemPo_Qwen2.5-SFT"

    actor   ← 加载这个模型,训练中不断更新
    ref     ← 加载同一个模型,训练中冻结
    rollout ← 用actor的权重做推理(通过SGLang服务)
三者在PPO loss中的角色:
ini
ratio = exp(new_log_prob_actor - old_log_prob_actor)
               ↑当前参数              ↑本轮开始时的快照
KL_penalty = ratio_to_ref -log(ratio_to_ref)-1
       where ratio_to_ref = exp(log_prob_actor -log_prob_ref)
                                                          ↑永远不更新
loss =-adv x clip(ratio)+ KL_coef x KL_penalty
简单来说:
- actor = "学生,不断学习改进
- ref_model = "老师基线", 确保学生不会偏离太远
- old_log_prob = "上一次考试成绩", 用于计算 importance sampling ratio
2.3 优势函数
Outcome Advantage 和 Memory Advantage 两者都用 GRPO 风格的归一化方式计算 advantage,但侧重点不同。
Outcome Advantage --------- GRPO 标准流程:
- B4-algo: compute_grpo_outcome_advantage()
- 分组:同一 question 的 16 条轨迹
- 归一化:adv = (score - group_mean) / group_std
- → 这就是 GRPO 的核心---用组内相对排名替代 Critic
Memory Advantage --------- GRPO 风格但维度不同:
- A2: compute_grpo_memory_advantage()
- 分组:同一 question 的所有轨迹 × 所有轮次 (~48 个值)
- 归一化:adv = (mem_reward - pool_mean) / pool_std
- → 借鉴了 GRPO 的 "组内归一化" 思想
- → 但池化范围更大(跨轨迹 + 跨轮次)
两者最终:
- final_adv = outcome_adv + mem_adv → 送入同一个 PPO loss
严格来说:
- Outcome Advantage = 标准 GRPO
- Memory Advantage = GRPO 启发的归一化(不是 GRPO 论文中定义的,是 MemPO 的创新设计)
- 最终优化 = PPO clipped surrogate loss(GRPO 只是 advantage 计算方式,优化器仍是 PPO)
2.4 前向传播
此点在Rollout篇也有涉及。
完整训练步的 Forward Pass 计数
MemPO 相比原版GRPO 多了1次extra forward pass(步骤②),但该次同时批量处理了 full_traj 和 mem_traj,实际吞吐开销约是标准old_log_prob的1.5~2倍,是 MemPO最主要的训练额外成本。
ini
───────────────────────────────────────────────────
① 生成阶段 (generate_sequences)
    SGLang 自回归解码,共 n=16 条轨迹
    → 本质也是 forward,但 KV cache 优化,计一次

───────────────────────────────────────────────────
②★ MemPO 专属: compute_log_prob(full_traj + mem_traj)
    agent_loop.py
    concat = [全部 full_traj, 全部 mem_traj]
    → 一次调用,但序列数量 = 2 × B × (T-1) × n
    B=batch_size, T=轮次, n=16

───────────────────────────────────────────────────
③ compute_log_prob (old_log_prob)
    ray_trainer.py
    → actor 计算轨迹的旧 logp (供 PPO ratio 使用)

───────────────────────────────────────────────────
④ compute_ref_log_prob (KL 约束)
    ray_trainer.py
    → ref model 计算 logp (供 KL 惩罚使用)

───────────────────────────────────────────────────
⑤ actor update (多 epoch 反向传播)
 默认 ppo_epochs=1, 每次需要当前 logp
特色
| 特性 | 详情 |
|---|---|
| 是否"推理两次"? | 否,1次extra forward pass,不生成新 token |
| 实际操作 | 对已生成的答案 Z,用两种不同的输入上下文计算 logp |
| 计算次数 | 一次 forward pass,两种输入拼成一个 batch |
| 计算时机 | rollout 完成后,advantage 计算前 |
| 目的 | 衡量"仅凭能否预测正确答案"的能力 |
对比
与原版 VeRL的对比
| 阶段生成 | 原版 VeRL GRPO | MemPO |
|---|---|---|
| 生成 | ①generate | ①generate |
| 记忆奖励 | ✗无 | ✓②full+mem 双路 logp |
| 旧logp | ③old_log_prob | ③old_log_prob |
| ref logp | ④ref_log_prob | ④ref_log_prob |
| 更新 | ⑤actor update | ⑤actor update |
| 总计 | 4次 forward | 5次forward |
每个 search_results 都是一次搜索的返回,不是多次搜索的集合。
2.5 Loss
outcome_adv 和 mem_adv 两者共同作为 PPO 的 advantage 信号,在同一个 PPO loss 中训练。
ini
final_adv = outcome_adv + mem_adv    ← 叠加后作为 PPO 的 advantage

PPO loss = -mean( final_adv × clip(ratio, 1-ε, 1+ε) × response_mask ) + KL_coef × KL(π || π_ref)
不是两个独立的训练过程,而是: 一次前向 → 一个 loss → 一次反向传播
不同 token 接收到的 advantage 值不同:
ini
position:    [R1 tokens] [<mem>R2 tokens</mem>] [think tokens] [<mem>R3</mem>] [answer]
final_adv:   [  +0.8  ]    [ +0.8 + 1.2 ]      [  +0.8  ]      [+0.8 - 0.5 ]   [ +0.8 ]
              ↑ 仅 outcome  ↑ outcome + mem (正)  ↑ 仅 outcome     ↑ outcome + mem (负)
输入
loss 的输入如下:
scss
new_log_prob [bsz, seq_len]   ←  当前actor前向得到
old_log_prob [bsz, seq_len]   ←  rollout时的快照(detached)
ref_log_prob [bsz, seq_len]   ←  refmodel(冻结)
final_adv    [bsz, seq_len]   ←  outcome_adv + mem_adv
response_mask [bsz, seq_len]  ←  1 = response token,0 = prompt token
计算
计算公式为:
scss
PPO loss = -mean( final_adv × clip(ratio, 1-ε, 1+ε) × response_mask ) + KL_coef × KL(π || π_ref)PPO是REINFORCE的改进版:
- 加入importance sampling ratio:
ratio=π_new/π_old,允许在旧数据上多次更新 - 加入clip约束:防止ratio偏离太大(限制单步更新幅度)
- 加入KL penalty:防止偏离参考策略太远
- 本质上PPO loss中的final_adv × ratio就是REINFORCE梯度的importance-weighted版本。
ini
# Importance Sampling Ratio
ratio = exp(new_log_prob - old_log_prob)

# Clipped Surrogate
surr1 = ratio × final_adv
surr2 = clip(ratio,1-e,1+e) × final_adv
policy_loss = -mean( min(surr1, surr2) × response_mask )

# KL Penalty (low-variance estimator)
ratio_ref = exp(new_log_prob - ref_log_prob)
kl = ratio_ref-log(ratio_ref)-1
kl_loss = KL_coef × mean(kl × response_mask)

# Total
total_loss = policy_loss + kl_loss
最终的 total_loss 是一个标量(scalar),但中间步骤涉及张量运算,即total_loss 是标量。中间的 ratio、advantage等是bsz,seq_len张量,通过mean()操作压缩为标量。total_loss.backward()从该标量反传梯度到所有模型参数,唯一有梯度的量是new_log_prob(当前actor前向计算得到)。
我们接下来看看几个具体细节。
ratio
PPO loss中的ratio是importance sampling比率,配合clip防止单步更新过大:
- ratio > 1:当前策略比生成时,更倾向选择这些token
- ratio < 1:当前策略比生成时,更不倾向选择这些token
- ratio = 1:没变化
Importance sampling
Importance sampling 允许用一个分布(旧策略 π_old)采的样本来估计另一个分布(新策略 π_new)下的期望:
css
E_π_new[f(x)] = E_π_old[f(x) × π_new(x) / π_old(x)]PPO需要它是因为rollout在旧策略下生成,但要更新到新策略。ratio=π_new/π_old就是importance weight,纠正了分布不匹配。clip限制ratio范围是为了防止weight太大导致高方差。
张量形状
各步骤的形状如下:
scss
  new_log_prob     [bsz, seq_len]    ← 张量(每个token一个log概率)
  old_log_prob     [bsz, seq_len]    ← 张量
  ratio            [bsz, seq_len]    ← 张量(逐token计算)
  final_adv        [bsz, seq_len]    ← 张量(逐token不同值)
  surr1            [bsz, seq_len]    ← 张量
  surr2            [bsz, seq_len]    ← 张量
  min(surr1,surr2) [bsz, seq_len]    ← 张量
  response_mask    [bsz, seq_len]    ← 张量(0/1)

  policy_loss = -mean(min(...) × mask)  ← 标量 ✓  (对所有元素求平均)
  kl_loss = KL_coef × mean(...)         ← 标量 ✓
  total_loss = policy_loss + kl_loss    ← 标量 ✓

total_loss.backward() ← 从这个标量反传梯度到所有参数
关键:mean()操作将[bsz,seq_len]的张量压缩为标量,然后.backward()从该标量计算梯度。
MemPO的特殊之处
Loss公式本身没有修改,特殊性全在final_adv的构造上:
ini
标准 GRPO:
    final_adv[i, :] = outcome_adv_i   ← 全序列同一个值

MemPO:
    final_adv[i, :] = outcome_adv_i + mem_adv[i, :]
                                        ↑ 仅 <mem> 区间非零
效果:同一条轨迹内,不同 token 的 advantage 值不同:
xml
token类型            advantage 值            梯度效果
─────────────────────────────────────────────────────────
<mem>...</mem>      outcome + mem_adv_t      双重驱动(可正可负)
<think>内容          outcome                  仅结果驱动
<search>query       outcome                  仅结果驱动
<answer>内容         outcome                  仅结果驱动
prompt tokens       masked out (=0)          无梯度
这就是 MemPO 的全部创新点在 loss 层面的体现------通过让 token 接收额外的 memory quality 信号,实现对记忆摘要能力的精准优化,而不影响其他 token 的学习。
为什么不用两个独立loss分别优化?
MemPO 的训练,本质上是一个 PPO 算法 + 一个复合 advantage:
- GRPO (Group Relative Policy Optimization) 负责计算 outcome_adv
- Memory reward 机制负责计算 mem_adv
- 两者加和后送入标准 PPO clipped surrogate loss
并没有分别训练两个 objective, 也没有分步交替优化 --- --- --- 就是一个统一的梯度更新。
如此设计的原因有三:
梯度冲突问题
如果两个loss独立:
ini
loss_outcome = -outcome_adv × log π(token)
loss_memory = -mem_adv × log π(mem_token)
以场景3(答错+好mem)为例:
scss
loss_outcome 想让<mem>token概率 ↓ (因为整条轨迹答错了)
loss_memory  想让<mem>token概率 ↑ (因为摘要写得好)
梯度冲突:两个loss对token可能方向相反 → 两个梯度方向相反 → 训练不稳定、震荡。
叠加方案直接解决:(-0.8) + (+1.2) = +0.4,产出一个明确的净方向。
PPO的clip 机制需要统一advantage
PPO clip的含义:限制每步更新幅度
如果拆成两个loss分别clip:每个loss各允许幅度的更新,叠加后实际更新了2ε→超出信任域
统一后只clip一次:final_adv = outcome + mem → clip一次 → 总更新在ε内
实现极简+计算高效
统一方案:1次前向,1次反向,1次参数更新 → 实现极简+计算高效 → 无需调两个1oss的权重系数
ini
final_adv = outcome_adv + mem_adv ← 1行加法独立方案:→2次前向,2次反向,2次参数更新(或需要梯度累积) → 还需要调两个loss的权重系数 →实际上调权重系数 ≈ 调mem_adv的相对幅度(本质相同)
总结:叠加 advantage 本质上等价于带权重的多目标优化,但更稳定、更高效、且天然兼容PPO的clip约束
2.6 梯度
我们来看看整个训练过程中哪些计算有梯度、哪些没有。
✗ 无梯度(detached/frozen):
java
✗ 无梯度(detached/frozen):
  - Rollout 生成 token                     → SGLang 推理,不保留计算图
  - A1 compute_log_prob (mem_reward)      → detached,仅算数值
  - B2 compute_score (outcome_reward)     → 纯字符串匹配,无张量
  - B4-algo outcome_adv                   → 纯数值运算
  - A2 mem_adv                            → 纯数值运算
  - A3 final_adv = outcome + mem          → 常数张量
  - old_log_prob                          → detached 快照
  - ref_log_prob                          → 冻结模型
☑ 有梯度(唯一来源):
scss
☑ 有梯度(唯一来源):
  PPO Update 中:
  new_log_prob = actor.forward(response_ids)    ← 当前 actor 前向
                 ↑ 这是唯一参与计算图的量

  ratio = exp(new_log_prob - old_log_prob)      ← 梯度流经 new_log_prob
  loss = -mean(final_adv × clip(ratio) × mask)  ← 标量
   + KL_coef x f(new_log_prob, ref_log_prob)

  loss.backward()
  ↓ 梯度方向:
  loss → ratio → new_log_prob → actor 参数 (weights, biases, embeddings)
  optimizer.step() →更新actor 所有参数
因此:
整个 MemPO 的梯度就是∂loss/∂θ_actor(PPO Update 中 new_log_prob 对 actor 参数的梯度),通过 new_log_prob这一个计算图节点反传到模型参数。
所有advantage、reward、ref/old log_prob 都只是常数系数,决定梯度的"方向和大小",但不贡献梯度本身。
2.7 KL约束
直觉含义
KL约束是防止模型为了刷分而"跑偏"一确保更新后的策略不会偏离起点太远。
直觉类比
想象一个学生(actor)在刷题提分:
- 没有约束:可能发现某种"作弊"捷径(如固定输出某个高频答案)→分数暂时上升,但能力退化
- KL约束:"你可以改进,但不能变得和原来的自己(ref)差别太大" →保持泛化能力的同时逐步提升
数学直觉
KL(π_actor || π_ref)衡量两个分布的"距离":
- = 0:actor和ref完全一样(没学到任何东西)
- 很大:actor和ref差别巨大(可能过度优化/rewardhacking)
在loss中:
csharp
total_loss = policy_loss + KL_coef x KL

policy_loss想让模型"往高reward方向走" → 拉离ref

KL_penalty想让模型"别离ref太远" → 拉回ref
两者对抗 → 模型在"提升"和"稳定"之间找到平衡
在MemPO中的实际作用
KL penalty约束actor不偏离ref model(SFT起点)太远。
没有KL penalty时可能出现的问题:
- 模型学会写一种固定模板的(高mem_reward但无实际信息 / reward hacking)
- 模型对所有问题都搜同一个query(碰巧某些场景有效)
- 输出多样性崩溃(所有16条轨迹趋同)
- 训练不稳定
KL penalty 确保:→ 模型的输出分布保持多样性 → 每步更新幅度有限,训练稳定 → 不会出现reward hacking
实现
配置kl_loss_type = low_var_kl,使用 k3估计量(Schulman 2020):
ini
# 普通KL(k1,有偏梯度):
kl ≈ log π_ref - log π_new

# Low-variance KL estimator
# 代码中用的不是直接的 KL,而是 low-variance 近似:
    # low_var_kl(k3,无偏梯度):
    kl = ratio_ref - log(ratio_ref) - 1
    where ratio_ref = exp(new_log_prob - ref_log_prob) = π_actor / π_ref

    当 ratio_ref = 1 (完全一样): kl = 1 - 0 - 1 = 0 ✅
    当 ratio_ref > 1 (actor概率更高): kl > 0
    当 ratio_ref < 1 (actor概率更低): kl > 0
    → 任何偏离都被惩罚,是一个"弹簧力"把 actor 拉回 ref
为什么用 k3? k3比 k1方差更低,训练更稳定,尤其适合多轮 agent 场景(轨迹长、方差本来就大)。
几个估计器比较如下:
| 估计器 | 公式 | 性质 |
|---|---|---|
| k1 | 无偏,方差大,可负 | |
| k2 | 有偏,恒正 | |
| k3 | () | 无偏 + 恒正 + 低方差(Schulman) |
| low_var_kl | 同k3,再做clamp(-10, 10)数值保护 | 同k3 + 防爆 |
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版