NumPy 数组操作详解
创建、变形、索引、拼接、排序与高效数组工作流
1. 心智模型:数组、形状与轴
NumPy 操作主要包括数据的选择、排列、组合和变换,同时必须保持清晰的 shape 与 dtype 契约。最实用的习惯是在每个复杂操作前后写出数组形状。
ndarray 具有 shape、维数 ndim、数据类型 dtype 和内存布局。axis 表示遍历方向:对于二维数组,axis=0 通常表示行方向,axis=1 通常表示列方向。
|---------|------------|-----------|
| 概念 | 含义 | 常用检查 |
| shape | 每个轴的长度 | a.shape |
| ndim | 轴的数量 | a.ndim |
| size | 元素总数 | a.size |
| dtype | 元素数据类型 | a.dtype |
| strides | 沿各轴移动的字节步长 | a.strides |
|------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| import numpy as np a = np.arange(12).reshape(3, 4) print(a.shape, a.ndim, a.size, a.dtype) print(a.sum(axis=0)) # 沿行归约;每列一个结果 print(a.sum(axis=1)) # 沿列归约;每行一个结果 |
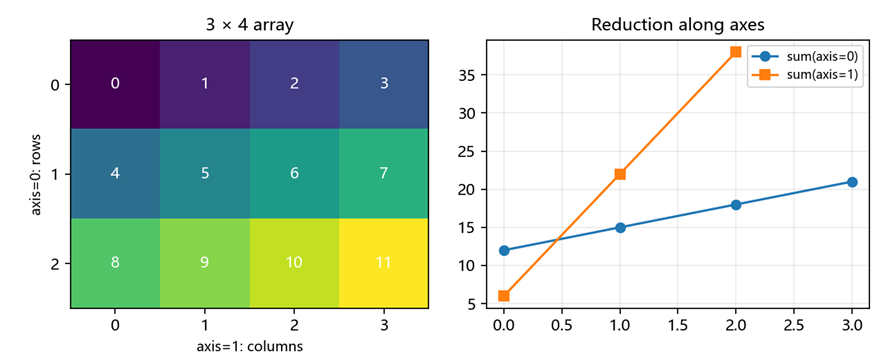
图 1 。数组的形状和轴方向决定归约操作的含义。
2. 变形、展平与维度控制
reshape 改变形状而不改变元素顺序。新旧 shape 的元素总数必须相同;使用 -1 可以让 NumPy 推断一个维度,但公共接口中应尽量明确写出关键维度。
ravel 在可行时通常返回 view,flatten 则总是返回 copy。squeeze 删除长度为 1 的轴,expand_dims 和 newaxis 插入轴。这些操作对样本、特征、批次和通道之间的转换非常重要。
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| x = np.arange(24) matrix = x.reshape(4, 6) rows = matrix.reshape(-1, 6) column = matrix:, np.newaxis # (4, 1) flat_view = matrix.ravel() flat_copy = matrix.flatten() assert matrix.size == rows.size == 24 |
|-------------|------------|-------------------------|
| 操作 | 形状效果 | 复制行为 / 注意事项 |
| reshape | 重新表达维度 | 兼容时可能是 view,否则为 copy |
| ravel | 变为一维 | 尽可能返回 view |
| flatten | 变为一维 | 始终返回 copy |
| squeeze | 删除长度为 1 的轴 | 动态 shape 时要防止形状意外变化 |
| expand_dims | 增加长度为 1 的轴 | 便于广播和批处理 |
建议保留语义轴。例如,(samples, features) 表示样本在前、特征在后,不要仅仅因为转置后表达式能够运行,就把它无意中变为 (features, samples)。
3. 索引、切片与布尔选择
基础切片使用 start:stop:step,通常返回 view。整数数组索引和布尔索引会创建新的数组。组合这些方式,可以建立清晰的数据清洗与特征筛选流程。
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| a = np.arange(20).reshape(4, 5) sub = a1:3, ::2 # 第 1--2 行,每隔一列取值 selected = aa % 2 == 0 # 布尔选择结果为一维 row_ids, col_ids = np.where(a > 12) coordinates = np.column_stack((row_ids, col_ids)) |
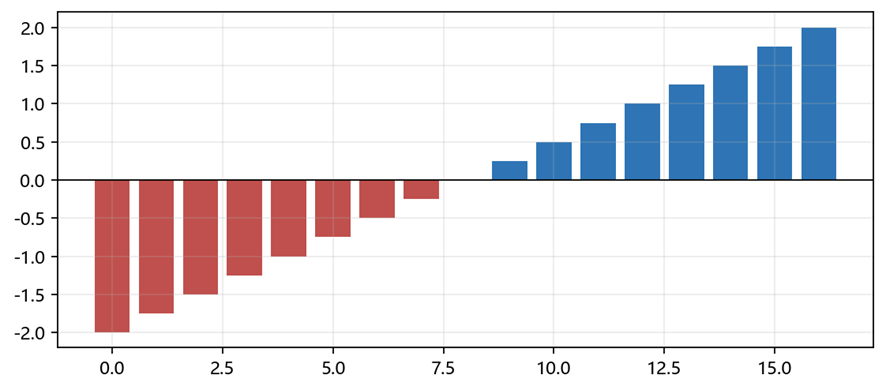
图 2 。布尔掩码可以在不编写 Python 循环的情况下选择元素。
|--------|-------------------------|-----------------|
| 模式 | 示例 | 结果 |
| 单个元素 | a2, 1 | 标量 |
| 行切片 | a1, : | 一维行数组 |
| 列切片 | a:, 2 | 一维列数组 |
| 矩形区域 | a1:3, 2:5 | 基础切片时通常为二维 view |
| 掩码 | aa \> threshold | 匹配值组成的一维 copy |
| 索引数组 | a\[0, 2, 1, 3] | 配对位置的高级索引 |
当两个索引列表表示行列笛卡尔积时,可以使用 np.ix_。如果希望让选择意图更明确,也可以使用 np.take、np.compress 或 np.nonzero。
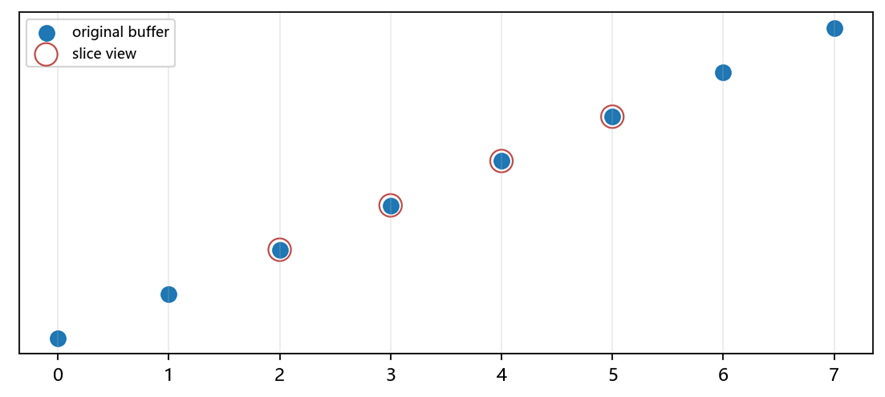
图 3 。基础切片可能与原数组共享存储;只有在明确需要时才修改 view 。
4. 广播与逐元素操作
广播从右侧对齐维度。当两个维度相等或其中一个为 1 时,它们兼容。较小的操作数在概念上被重复,但常规逐元素表达式不会真的创建这些重复数据。
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| values = np.arange(15).reshape(3, 5) offset = np.array(10, 20, 30, 40, 50) shifted = values + offset # (3, 5) + (5,) -> (3, 5) scale = np.array(\[1.0, 2.0, 3.0]) scaled = values * scale # (3, 5) * (3, 1) -> (3, 5) |
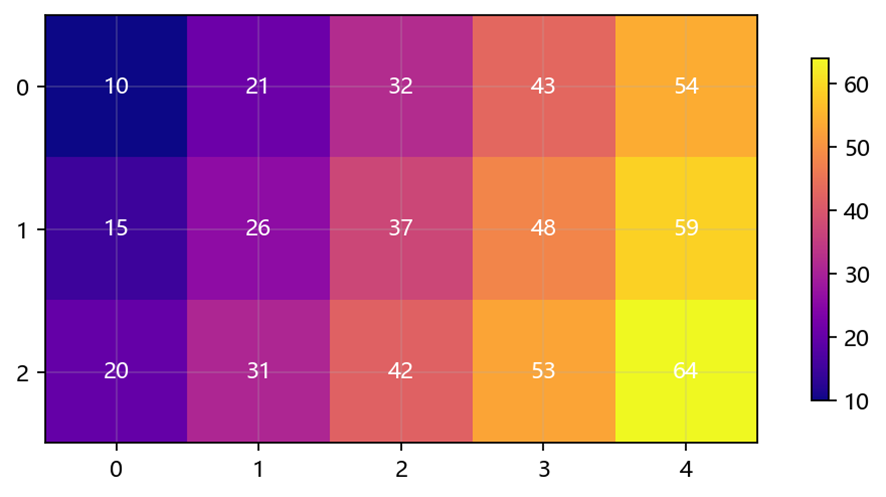
图 4 。长度为 5 的向量会广播到 3×5 数组的每一行。
|------------------|------------------|----------|------------|
| 左侧 shape | 右侧 shape | 是否兼容 | 输出 |
| (3, 5) | (5,) | 是 | (3, 5) |
| (3, 5) | (3, 1) | 是 | (3, 5) |
| (8, 1, 6) | (7, 6) | 是 | (8, 7, 6) |
| (3, 4) | (3,) | 否 | ValueError |
当向量代表列或行时,建议明确 reshape。x:, None 表示列向量契约,xNone, : 表示行向量契约,这样可以避免意外广播并便于代码审查。
5. 拼接、拆分、平铺与重复
拼接函数沿指定轴组合数组。concatenate 沿已有轴连接,stack 创建新轴;hstack 和 vstack 是便捷函数,但其行为会受到输入维数影响。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| a = np.array(\[1, 2, 3, 4]) b = np.array(\[5, 6, 7, 8]) rows = np.concatenate((a, b), axis=0) cols = np.concatenate((a, b), axis=1) batch = np.stack((a, b), axis=0) # (2, 2, 2) left, right = np.split(np.arange(10), 4) |
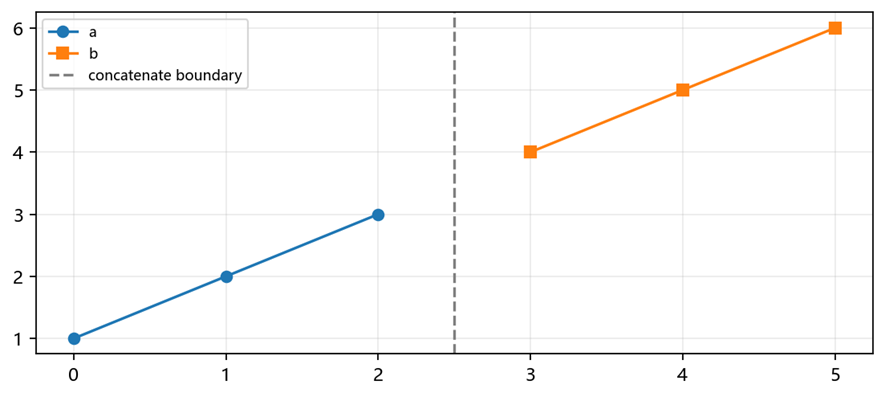
图 5 。一维拼接沿指定方向追加数据,同时保留元素顺序。
|-------------|----------|-----------------|
| 函数 | 主要用途 | 常见注意事项 |
| concatenate | 连接已有维度 | 除连接轴外,其他维度必须匹配 |
| stack | 创建新维度 | 所有输入 shape 必须一致 |
| split | 分割数组 | 分割点必须适合所选轴 |
| tile | 重复完整模式 | 可能创建很大的数组 |
| repeat | 重复单个元素 | 说明按元素还是按轴重复 |
处理表格型数据时,拼接前要确认目标轴。错误的 axis 也可能产生形状合法但语义错误的数组,这比立即抛出异常更危险。
6. 排序、查找与选择
NumPy 提供跨轴排序和选择操作。sort 返回排序后的值,argsort 返回排列索引,argpartition 用于快速确定分区,searchsorted 在有序一维数组中查找插入位置。
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| scores = np.array(72, 91, 72, 64, 88) order = np.argsort(scores, kind="stable") ranked_scores = scoresorder top_indices = np.argpartition(scores, -2)-2: threshold_positions = np.searchsorted(np.array(10, 20, 30, 40), 25) |
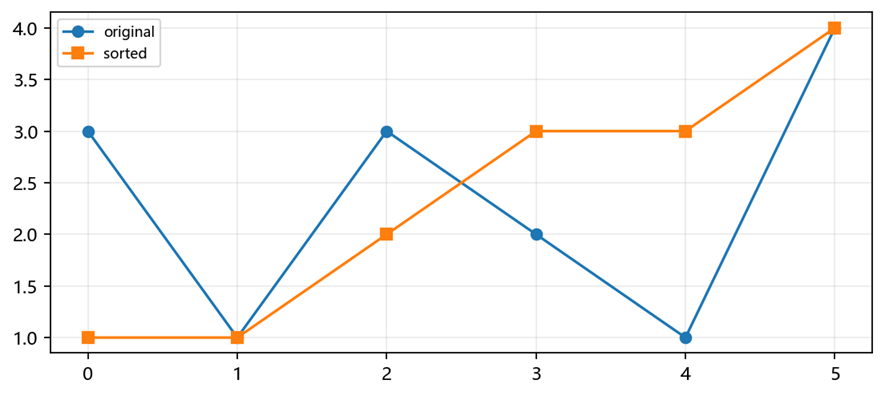
图 6 。 argsort 将排序决策与数据分离,可用于同步重排多个数组。
|----------|-----------------|---------------|
| 需求 | 推荐操作 | 原因 |
| 排序后的值 | np.sort | 简单且易读 |
| 可复用排序 | np.argsort | 同一个排列可应用于多个数组 |
| 较小 top-k | np.argpartition | 适合避免完整排序 |
| 插入有序数据 | np.searchsorted | 使用二分查找插入位置 |
| 唯一类别 | np.unique | 可同时返回计数和逆映射 |
如果重复值的顺序很重要,应选择稳定排序算法并记录并列处理规则。结构化数组可以按字段排序,多关键字排序可考虑 lexsort。
7. 向量化窗口、dtype 与内存安全
差分、累积和、裁剪、插值以及局部窗口计算都可以写成向量化操作。向量化通常减少 Python 层循环开销,但仍然需要关注中间数组的内存占用。
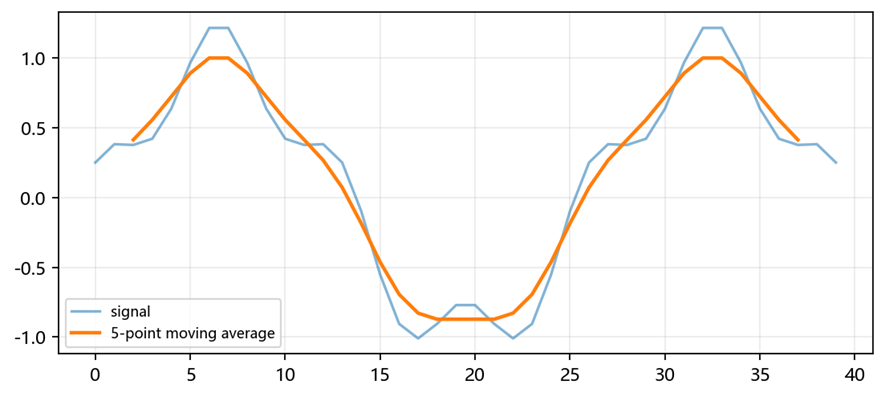
图 7 。移动平均是局部窗口变换,可以在不编写 Python 循环的情况下实现。
|------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| signal = np.asarray(signal, dtype=np.float64) delta = np.diff(signal) cumulative = np.cumsum(signal) limited = np.clip(signal, -1.0, 1.0) normalized = (signal - signal.mean()) / signal.std() |
|--------|----------------|---------------------------------|
| 问题 | 实践建议 | 示例 |
| 整数除法意外 | 选择浮点 dtype | np.asarray(x, dtype=np.float64) |
| 溢出 | 使用更宽 dtype 或缩放 | dtype=np.int64 / float64 |
| 数据别名 | 需要所有权时复制 | safe = view.copy() |
| 中间数组过大 | 复用缓冲区或分块 | 在支持时使用 out=buffer |
| 形状漂移 | 验证契约 | assert x.ndim == 2 |
可靠的生产流程应在边界检查 dtype、shape、缺失值策略和数据所有权。调试时可使用 np.shares_memory 验证一次变换是 view 还是 copy。
8. 实践清单与小项目
下面的工作流操作一个小型特征矩阵:清理无效值、标准化列、按掩码选择行、按分数重排,并将结果拆成批次。
|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| rng = np.random.default_rng(7) X = rng.normal(size=(12, 4)) X2, 1 = np.nan X = np.nan_to_num(X, nan=0.0) mu, sigma = X.mean(axis=0), X.std(axis=0) Z = (X - mu) / np.where(sigma == 0, 1, sigma) mask = Z:, 0 > 0 selected = Zmask order = np.argsort(selected:, 1)::-1 ranked = selectedorder batches = np.array_split(ranked, 3, axis=0) |
|--------|----------------------|------------------|
| 步骤 | 需要思考的问题 | 验证方法 |
| 输入 | 每个轴代表什么? | 记录 shape 与单位 |
| 选择 | 这是 view 还是高级索引 copy? | 检查 shares_memory |
| 拼接 | 哪个轴被扩展? | 比较期望 shape |
| 变换 | 广播是否隐藏错误? | 打印操作数 shape |
| 输出 | 下游能否依赖 dtype 和维数? | 使用断言与测试 |
总结:通过明确 shape 契约来操作数组,优先使用向量化表达式,区分 view 与 copy,并用小规模示例验证 axis 语义,再扩展到生产数据。