在网络协议的演进史中,HTTP/2 最令人兴奋的突破莫过于多路复用(Multiplexing)。
在 HTTP/1.1 时代,浏览器为了并发加载资源,不得不对同一个域名建立 6 到 8 条独立的 TCP 连接。然而,TCP 连接的建立与慢启动不仅开销高昂,更受到"队头阻塞(Head-of-Line Blocking)"的无情折磨------一个慢请求未响应,该连接后续的所有请求就只能干等。
HTTP/2 用一种极其优雅的架构解决了这个问题:在单条 TCP 连接上,并行承载成百上千个双向流(Streams)。
然而,许多深入研究协议或者在生产环境中排查 gRPC、Envoy 性能抖动的工程师,都会冒出一个强烈的困惑:
"底层的 TCP 协议明明自带了成熟的滑动窗口与流量控制(Receive Window,
rcv_wnd),为什么 HTTP/2 还要在应用层叠床架屋,重新实现一套复杂的流量控制机制?"
这套机制不仅在 RFC 7540(后更新为 RFC 9113)中占据了核心篇幅,更是各大微服务网关、反向代理和 RPC 框架中最容易踩坑的暗礁。
本文将剥离浮夸的概念,带你深入 HTTP/2 的底层帧交互与内幕设计,看懂这套双层信用流控的必然性、防死锁生命线,以及生产环境中的调优法则。
一、核心矛盾:TCP 窗口为什么管不了多路复用?
要回答"为何需要应用层流控",我们必须先看一看:假如 HTTP/2 仅仅依赖 TCP 自身的流量控制,会发生什么灾难?
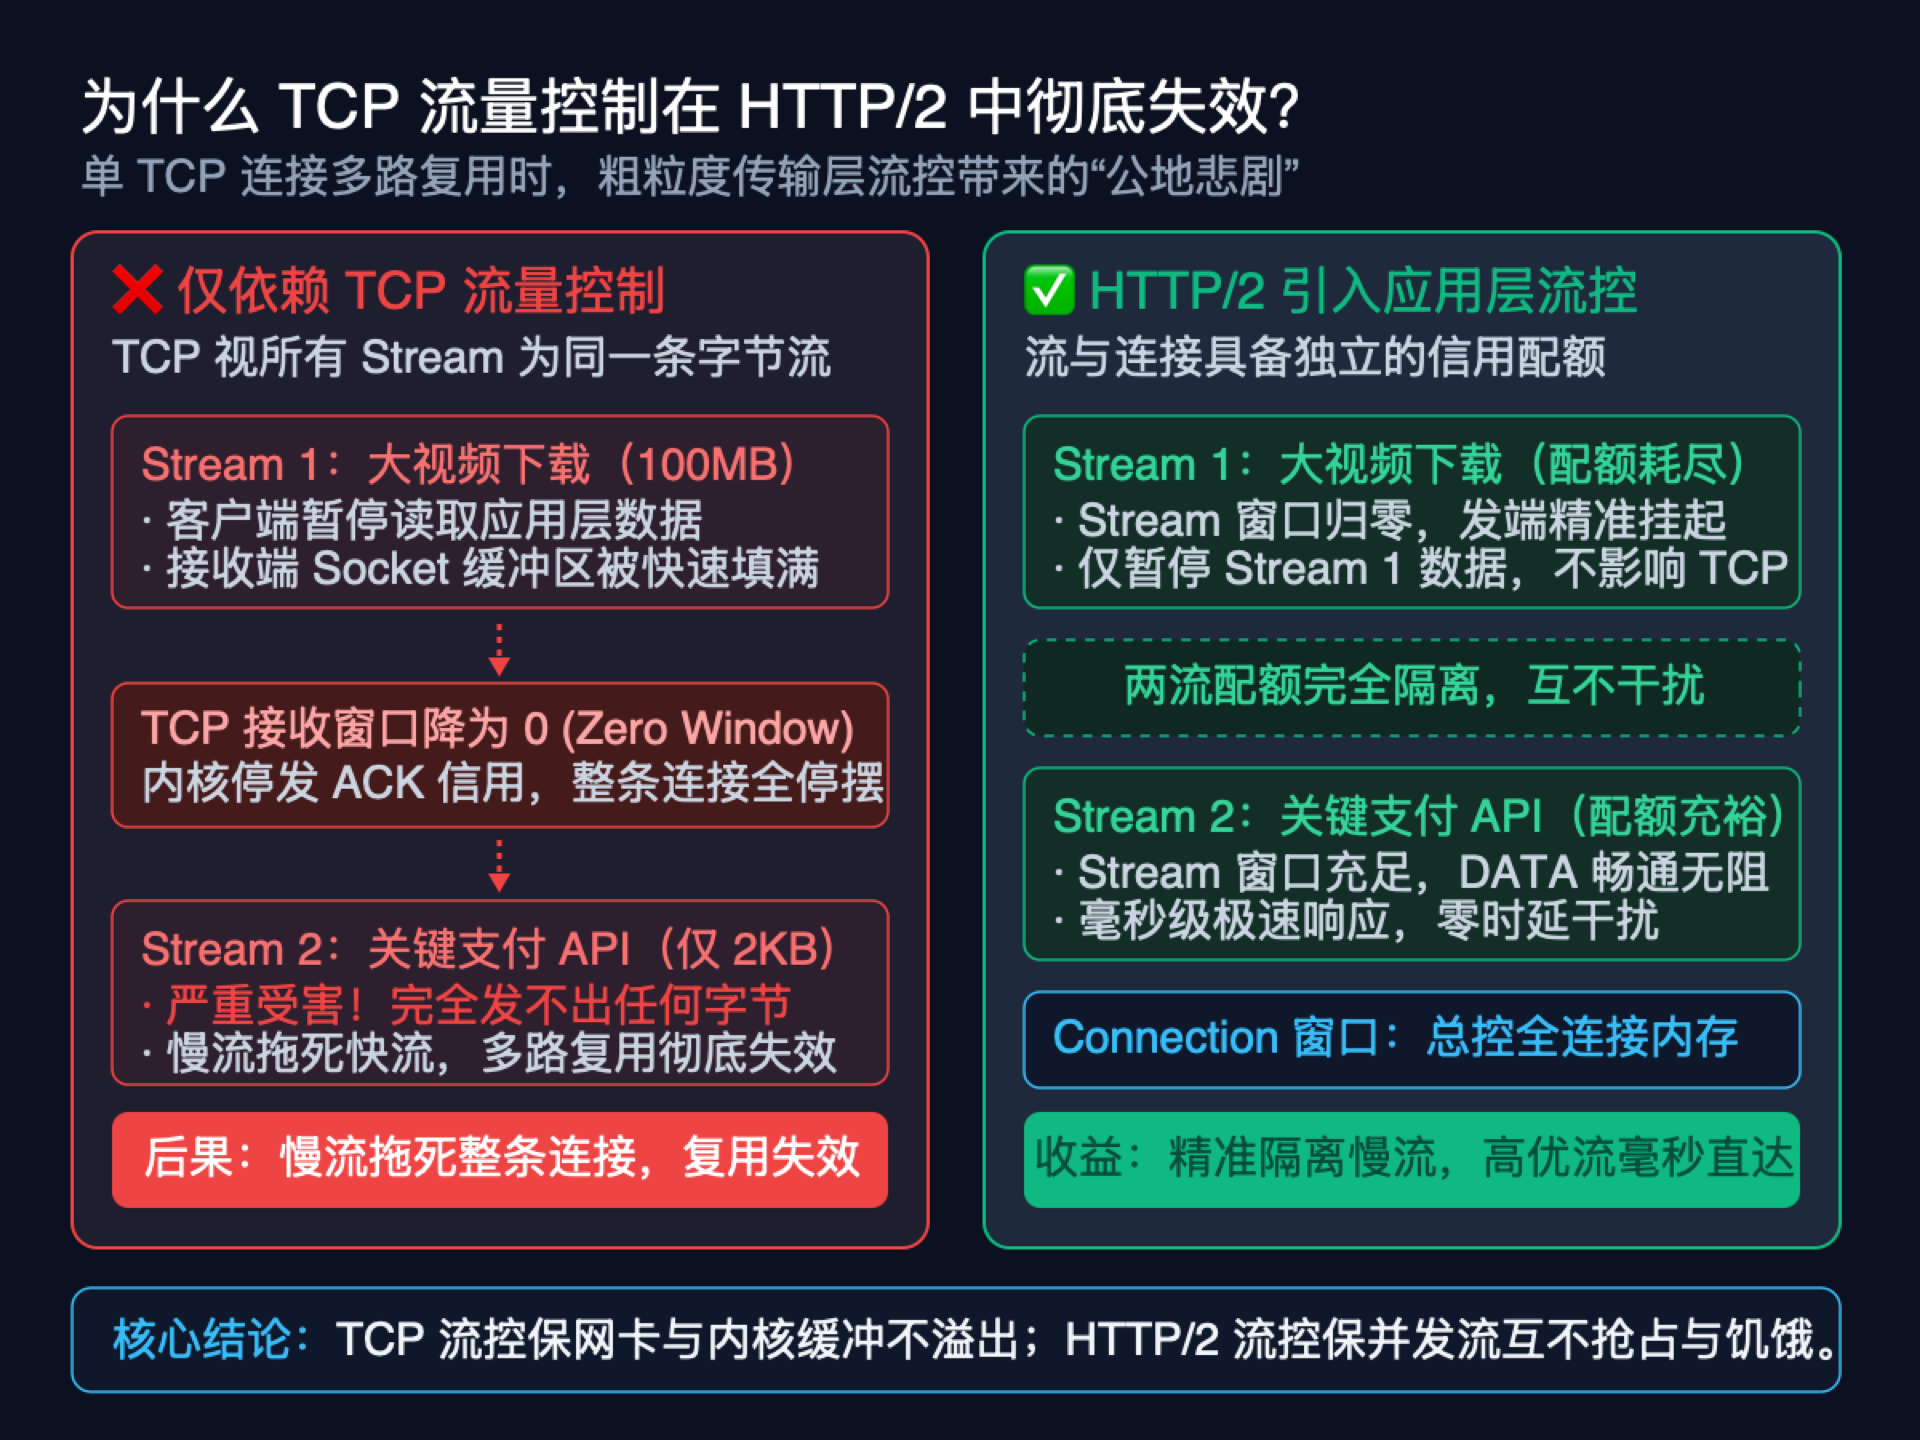
1. TCP 的"单字节流"盲区
TCP 是面向无差别字节流的传输层协议。在 TCP 的世界里,根本不存在 Stream 1、Stream 2 的概念,它只能看到一个线性的数据流:
text
TCP 视角: [Byte 0] [Byte 1] [Byte 2] ... [Byte N]当多个应用层 Stream(例如视频流、API RPC、静态 CSS)被交错切片为 DATA 帧并塞入同一条 TCP 连接时,内核 TCP Socket 缓冲区接收的是它们的混合体。
2. 慢流引发的"公地悲剧"
假设客户端在一条 TCP 连接上并发打开了两个流:
- Stream 1:一个正在下载的 100MB 视频文件,吞吐极大;
- Stream 2:一个紧急的支付确认 API,体积仅 2KB。
此时,如果用户按下了视频暂停键,或者客户端渲染线程卡死,导致客户端应用程序暂停调用 read() 读取 Socket 缓冲区中的 Stream 1 数据:
- 缓冲区塞满:服务端的视频数据持续灌入,很快占满了客户端操作系统的内核接收缓冲区;
- TCP 窗口清零 :客户端内核为了防止溢出,触发 TCP 流量控制,向服务端返回
rcv_wnd = 0(Zero Window); - 整条连接停摆:服务端的 TCP 层收到零窗口通知,立即停止向该连接发送任何数据包!
灾难发生了:原本只需要几毫秒的 Stream 2(支付 API),尽管其客户端消费能力完全正常,却因为与 Stream 1 共享了同一个 TCP 连接,被无辜拖入停摆状态。
核心结论 :
TCP 流量控制只能保护整条连接的内核缓冲区 不溢出,但它完全无法感知连接内部不同流之间的速率差异。如果没有应用层流控,任何一个慢流(Slow Consumer)都会通过 TCP 零窗口迅速拖垮整条连接上的所有流,多路复用的优势将彻底荡然无存。
二、HTTP/2 双层流控机制与信用模型
为了彻底隔离不同流的消费速率,HTTP/2 在应用层引入了基于信用(Credit-based)的双层滑动窗口机制。
1. 逐跳(Hop-by-Hop)而非端到端
与端到端(End-to-End)的逻辑不同,HTTP/2 的流控是**严格逐跳(Hop-by-Hop)**的:
- 浏览器与反向代理(如 Envoy / Nginx)之间有独立的一套流控;
- 反向代理与后端上游服务(如 gRPC Backend)之间又有一套独立的流控。
流控协商完全发生在直接相连的两个网络端点之间,不会穿透或向后透明传递。这使得代理节点可以根据自身的内存与负载,精确掌控两端的吞吐节奏。
2. 双层窗口判定法则
HTTP/2 同时维护两套独立的流控窗口:
- 流级别窗口(Stream-Level Window):针对具体某一个 Stream ID(如 Stream 1、Stream 3)进行独立限额;
- 连接级别窗口(Connection-Level Window) :针对全连接所有流的数据总和进行全局限额(在信令中以
Stream ID = 0表示)。
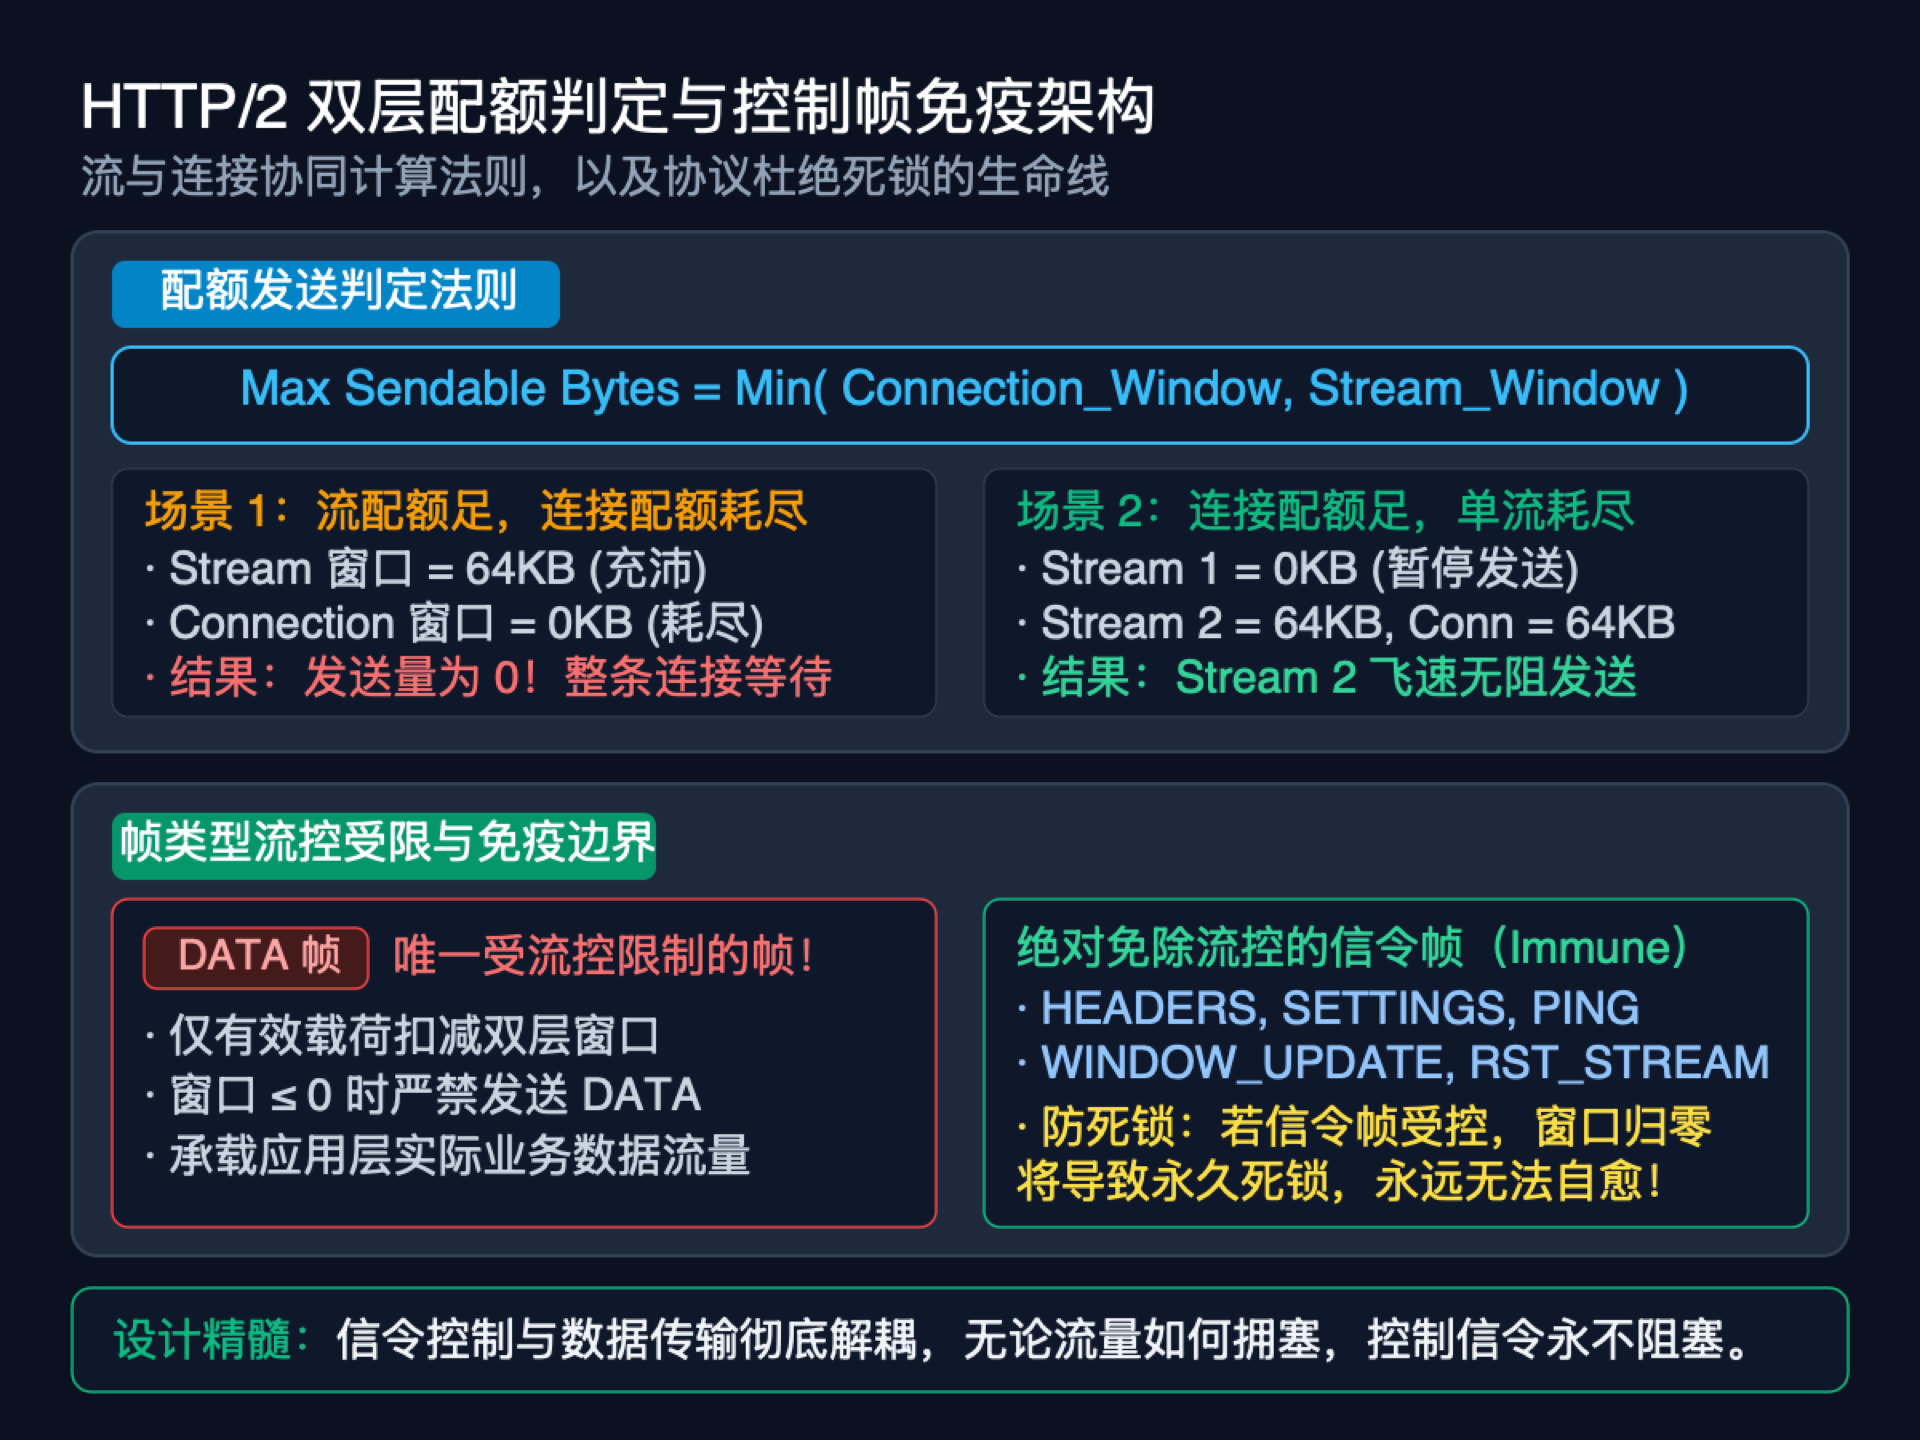
发送端在向接收端发送业务数据(DATA 帧)时,必须同时满足这两层配额。发送判定公式如下:
text
Max Sendable Bytes = Min( Connection_Window, Stream_Window )每次发送 LLL 字节的有效数据,发送端必须在当前 Stream 窗口和全连接窗口中同时扣减 LLL 字节 。只有当两者的值都大于 0 时,才允许发出 DATA 帧。
3. 基于信用的配额补充:WINDOW_UPDATE
流控窗口并非无限自增,而是基于信用额度发放的闭环控制:
- 初始配额 :连接建立伊始,默认的流初始窗口与连接窗口均为 65,535 字节(64KB - 1);
- 消耗配额 :发送端每发出一个
DATA帧,本地对应的 Stream 窗口与 Connection 窗口立即扣除相应载荷大小; - 归还配额 :接收端应用层每从缓冲区真正消费掉一部分数据(例如已交由业务逻辑处理),便会向发送端发回一个
WINDOW_UPDATE帧,告知发送端:"我又腾出了 XXX 字节的空间,请把你的窗口加上 XXX"。
WINDOW_UPDATE 帧由 9 字节标准帧头与 4 字节有效载荷构成(总长度 13 字节 / 104 比特):
| 字段名称 | 位宽 (Bits) | 规范约束与取值 | 核心作用与协议语义 |
|---|---|---|---|
| Length | 24-bit | 0x000004 (4 字节) |
负载长度固定为 4 字节,超出即触发协议错误 |
| Type | 8-bit | 0x08 |
标识该帧为 WINDOW_UPDATE |
| Flags | 8-bit | 0x00 |
规范未为此帧定义任何标志位,必须置零 |
| R | 1-bit | 0 |
保留位,发送时必须置 0,接收时必须忽略 |
| Stream ID | 31-bit | 0 或指定流编号 |
0 代表连接级全局窗口,>0 代表对应流级私有窗口 |
| Window Increment | 31-bit | 1∼231−11 \sim 2^{31}-11∼231−1 字节 | 本次归还的信用额度(最高位 R 为 1 位保留位) |
关于 WINDOW_UPDATE 的处理,RFC 9113 规定了严格的边界防护铁律:
- 零增量防护 :若端点收到
Window Size Increment为 0 的帧,必须视为协议错误(针对单流报错PROTOCOL_ERROR流错误;针对连接级Stream ID = 0则升级为连接终止错误); - 整型溢出防护 :若增量使得发送端的当前窗口累计超过 231−12^{31}-1231−1(2,147,483,647 字节),端点必须主动抛出
FLOW_CONTROL_ERROR并重置流或切断连接。
三、协议安全边界:控制帧免疫与死锁自愈
在分布式协议设计中,引入双层流控最危险的并发隐患就是死锁(Deadlock)。
试想一下:如果连接窗口已经彻底归零,发送端不能再发送任何帧,而接收端又恰好把用来补充配额的 WINDOW_UPDATE 帧也当成了流控对象,双方是不是就会陷入"你等我发额度,我等你放行数据"的永久僵局?
为了彻底消除死锁,RFC 9113 制定了一条不可动摇的安全铁律:
1. 唯一受控的只有 DATA 帧
在 HTTP/2 定义的 10 种核心帧类型中,只有 DATA 帧受流控窗口限制并消耗信用 。这里有一个常被忽视的关键规范细节(RFC 9113 §5.2 / §6.1):DATA 帧的 9 字节通用帧头不计入流控,但其整个 Payload(包括可选的安全填充字段 Pad Length 与 Padding 字节)必须全额计入流控窗口扣减。规范这样设计是为了防止恶意端点通过填充大量无用 Padding 绕过流控限制、撑爆接收端缓冲区。
其余所有用于会话控制与信令交互的帧类型,绝对免除流控(Flow-Control Exempt):
HEADERS/CONTINUATION:元数据与请求头直接通行;WINDOW_UPDATE:配额充值帧永不阻塞;RST_STREAM:异常流的重置与切断帧永不阻塞;SETTINGS:参数配置协商帧永不阻塞;PING:心跳保活与往返测速帧永不阻塞;PRIORITY/GOAWAY:优先级调度与平滑下线帧永不阻塞。
正因为 WINDOW_UPDATE 和 RST_STREAM 享有免流控的"外交豁免权",即便某个流甚至整条连接的窗口已经跌入 0 甚至负数,控制信令依然能够畅行无阻地穿透管道,随时唤醒或终止卡顿的流。
2. 负窗口(Negative Window)是怎么来的?
在排查 HTTP/2 协议实现时,很多开发者会震惊地发现窗口竟然可能变成负数(如 -32768),甚至误以为这是整型溢出的 Bug。
实际上,负窗口是 HTTP/2 规范明文允许的合法状态。它通常发生在客户端动态调小初始窗口配置的场景:
-
客户端与服务端已建立连接,某活跃 Stream 当前已发送 40KB 数据,剩余可用窗口为 24KB(基于默认 64KB 初始值);
-
此时客户端发现自身内存吃紧,向服务端发送了一个
SETTINGS帧,将SETTINGS_INITIAL_WINDOW_SIZE调小为 16KB; -
根据协议规定,当初始流窗口变更时,所有已存在的活跃流的窗口必须同步加上增量(Delta) :
Δ=New−Old=16KB−64KB=−48KB\Delta = \text{New} - \text{Old} = 16\text{KB} - 64\text{KB} = -48\text{KB}Δ=New−Old=16KB−64KB=−48KB
-
该流的实时可用窗口立即变为:
24KB+(−48KB)=−24KB24\text{KB} + (-48\text{KB}) = -24\text{KB}24KB+(−48KB)=−24KB
此时窗口变成了负值。发送端必须立即封锁该流的 DATA 帧发送,直到接收端后续发送 WINDOW_UPDATE,将该流的可用窗口累计补充回正数(>0>0>0)之后,才允许恢复发送。
四、生产实战与踩坑:反向代理背压与 BDP 吞吐陷阱
离开理论象牙塔,在真实的生产架构(Kubernetes 网关、Envoy 反向代理、跨机房 gRPC 集群)中,HTTP/2 流控往往会成为性能雪崩与 OOM 的隐形杀手。
1. 反向代理的"背压穿透"与 OOM 危机
在现代微服务组网中,反向代理(Envoy / Nginx / Traefik)横亘在下游客户端与上游后端之间:
text
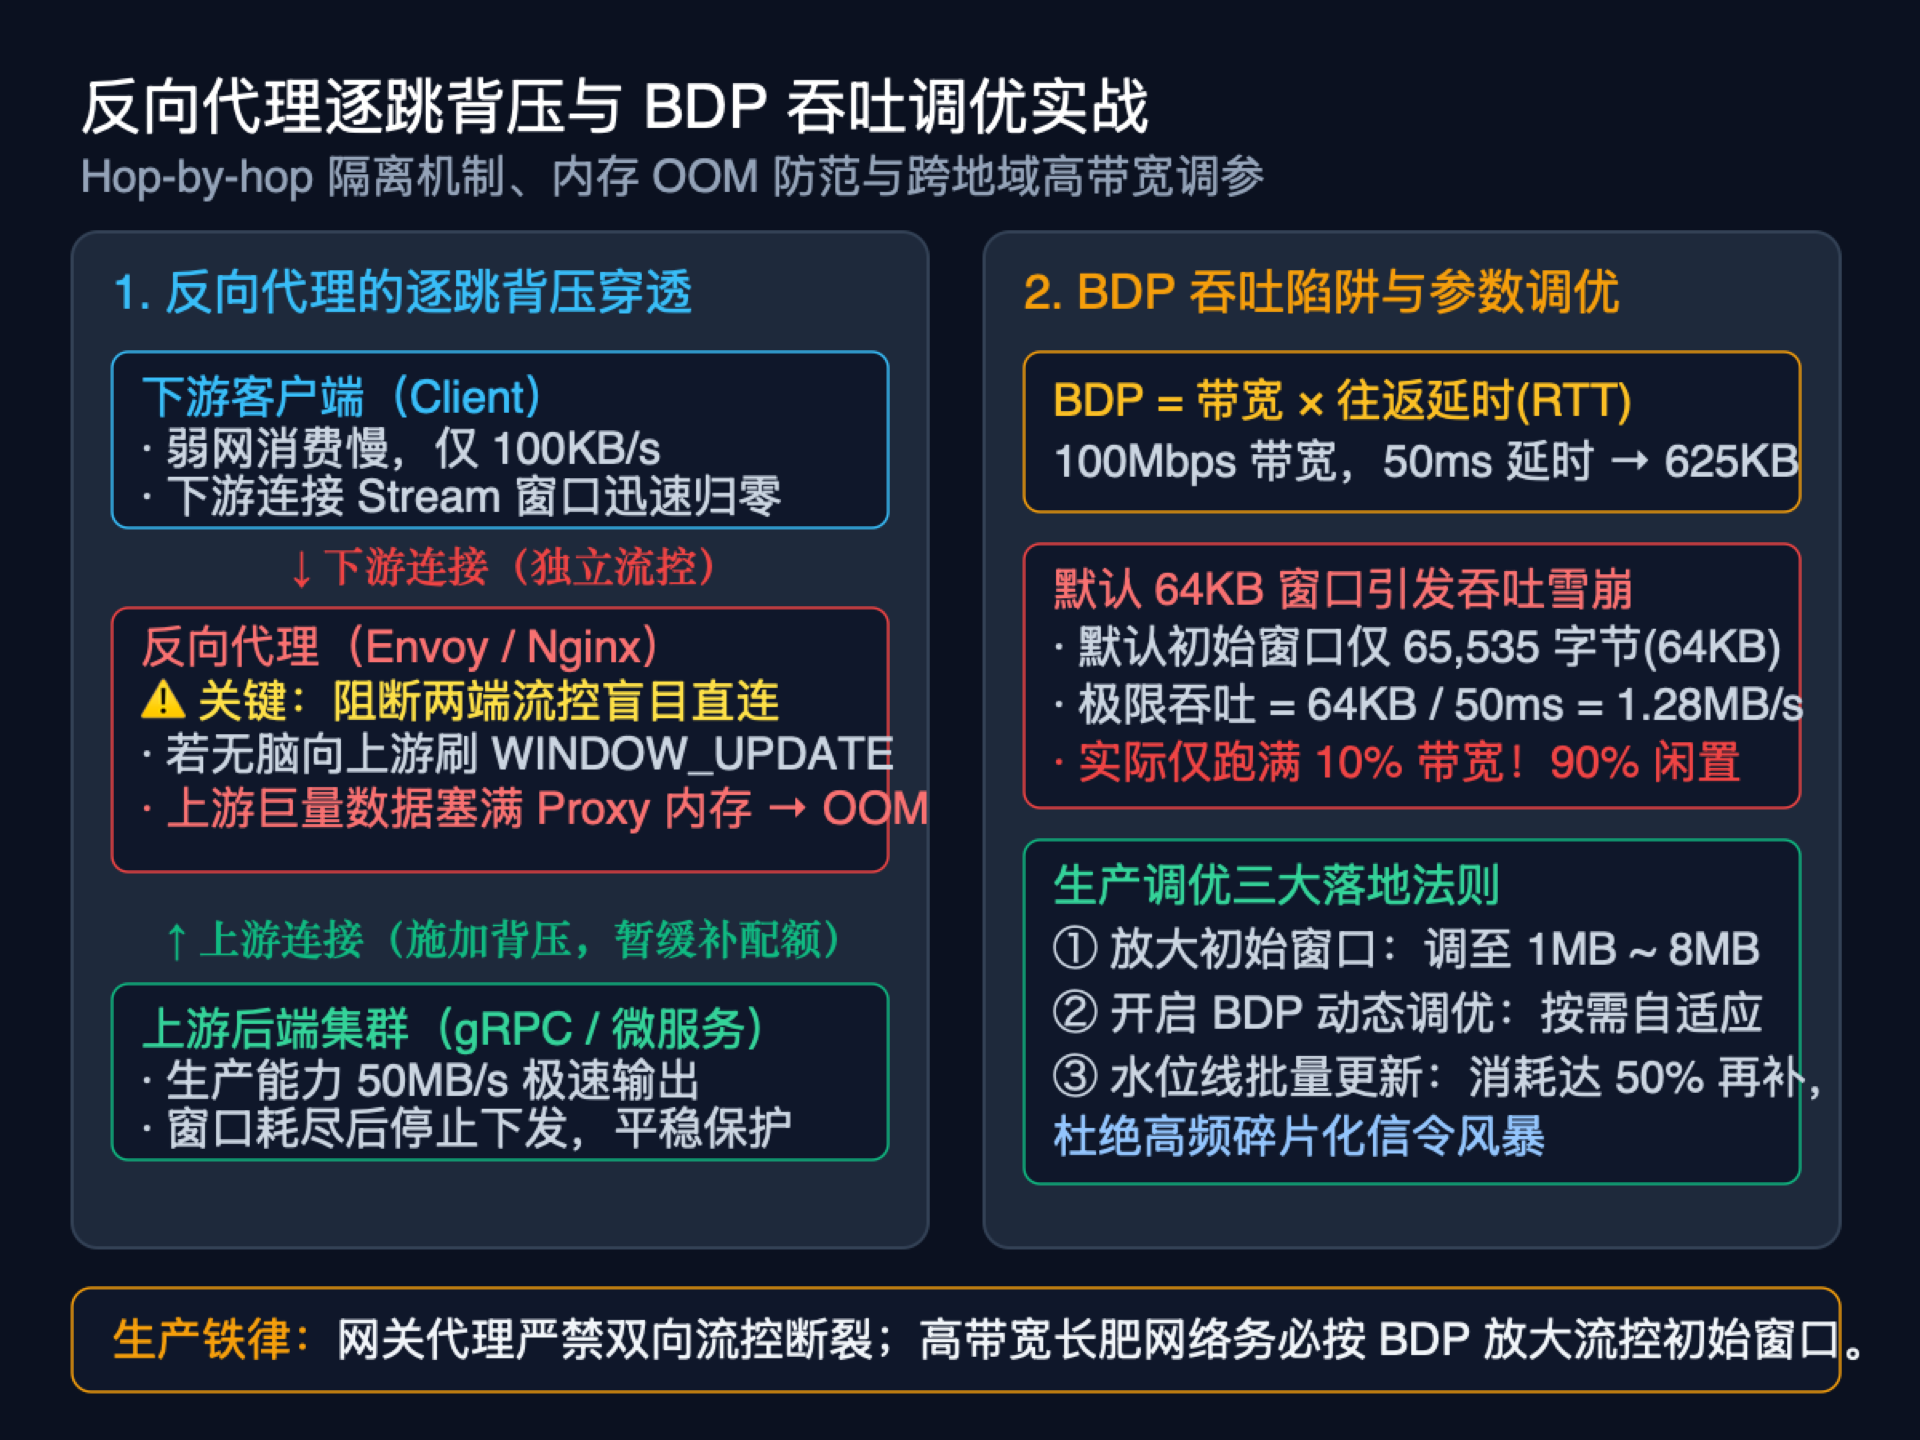
下游客户端 (Client) ←[HTTP/2 连接 1]→ 反向代理 (Proxy) ←[HTTP/2 连接 2]→ 上游后端 (Backend)前面提到,HTTP/2 流控是逐跳隔离的。代理服务器维护着两段独立的流控回路。
如果网关开发人员在自研代理或配置模块时,将两端的流控逻辑写成"下游慢、上游不管",就会发生灾难性的内存爆仓:
- 下游弱网:移动端客户端处于弱网环境,消费速率仅有 100 KB/s,导致 Conn 1 的 Stream 窗口迅速归零;
- 背压断裂 :如果代理程序没有将这个压力向上游传递,而是对上游 Conn 2 持续放行并无脑应答
WINDOW_UPDATE; - 数据倒灌:内部千兆内网的上游后端以 50 MB/s 的极速狂倾数据,代理节点不得不将海量的未投递响应全部缓存在自身的进程内存中;
- 惨烈结局:代理节点物理内存被迅速吃光,触发系统 OOM Killer,直接将整个网关进程杀死!
生产避坑原则 :
反向代理必须建立跨连接的流控背压联动机制 。代理只有在确认下游连接成功发出数据、或者下游缓冲区低于安全水位时,才允许向上游连接发送
WINDOW_UPDATE。上游与下游的流控必须形成联动闭环。
2. BDP 吞吐陷阱:默认 64KB 为什么跑不满带宽?
在公网环境或跨地域(Cross-Region)调用中,很多工程师反馈:"明明买了 100Mbps 的专线带宽,为什么单个 HTTP/2 流的传输速度无论如何都只能跑到 10Mbps 左右,带宽利用率连 15% 都不到?"
这正是著名的带宽时延积(Bandwidth-Delay Product, BDP)吞吐陷阱。
根据网络动力学原理:
BDP=Bandwidth×RTT\text{BDP} = \text{Bandwidth} \times \text{RTT}BDP=Bandwidth×RTT
假设我们在北京与法兰克福之间调用 gRPC 服务:
- 专线带宽 = 100 Mbps(折合 12.5 MB/s12.5 \text{ MB/s}12.5 MB/s);
- 网络往返时延(RTT)= 50 ms。
此时网络的管道容量为:
BDP=12.5 MB/s×0.05 s=625 KB\text{BDP} = 12.5 \text{ MB/s} \times 0.05 \text{ s} = 625 \text{ KB}BDP=12.5 MB/s×0.05 s=625 KB
这意味着,在发送端发出数据后、收到对方 WINDOW_UPDATE 确认之前的这 50ms 窗口期内,管道里至少需要能够容纳 625 KB 的在途数据,才能让带宽完全跑满。
而 HTTP/2 的规范默认初始窗口是多少?仅仅 65,535 字节(64 KB)!
在默认配置下,发送端的最大理论吞吐量被严严实实地封死在了:
Max Throughput=64 KB0.05 s=1.28 MB/s≈10.24 Mbps\text{Max Throughput} = \frac{64 \text{ KB}}{0.05 \text{ s}} = 1.28 \text{ MB/s} \approx 10.24 \text{ Mbps}Max Throughput=0.05 s64 KB=1.28 MB/s≈10.24 Mbps
整整 90% 的物理带宽都被闲置在空转状态!发送端每发完 64KB,就必须把发送线程挂起,眼巴巴地等待半个 RTT 后的 WINDOW_UPDATE 飞过来。
3. 生产调优三大法则
针对上述瓶颈,业界主流高性能框架(如 gRPC、Envoy、Go net/http2)总结了三项标准落地策略:
① 放大流与连接初始窗口
针对高延迟、高吞吐的内网专线或跨机房场景,必须打破默认 64KB 的束缚。
以 Envoy 为例,在 Upstream Cluster 中将窗口显式调大至 1MB ~ 8MB:
yaml
# Envoy HTTP/2 协议选项示例
typed_extension_protocol_options:
  envoy.extensions.upstreams.http.v3.HttpProtocolOptions:
    "@type": type.googleapis.com/envoy.extensions.upstreams.http.v3.HttpProtocolOptions
    explicit_http_config:
      http2_protocol_options:
        initial_stream_window_size: 1048576      # 1MB 单流窗口
        initial_connection_window_size: 8388608  # 8MB 连接总窗口
在 gRPC 服务中,同样可以通过核心参数打破 64KB 限制:
- Go gRPC :
grpc.InitialWindowSize(1024*1024)与grpc.InitialConnWindowSize(8*1024*1024); - Java / C++ :设置 Channel 参数
GRPC_ARG_HTTP2_INITIAL_STREAM_WINDOW_SIZE与GRPC_ARG_HTTP2_INITIAL_CONNECTION_WINDOW_SIZE。
② 开启动态窗口自适应(BDP Auto-Tuning)
静态放大窗口在连接数成千上万时会导致严重的内存浪费。现代 gRPC 实现了基于 BDP 采样的动态窗口自适应算法:
- 周期性监控传输队列深度与 RTT 波动;
- 探测到当前连接正在进行高通量传输且网络吞吐受限时,自动向上发送
WINDOW_UPDATE动态拉伸窗口; - 在传输回落后平稳恢复,平衡吞吐与内存开销(C++/Java 通过
GRPC_ARG_HTTP2_BDP_PROBING=1开启)。
③ 实施水位线批量更新(防信令 Chatter)
接收端切忌"每读到 1KB 数据就立即发一个 WINDOW_UPDATE"。这会导致网络上充斥着琐碎的 13 字节信令帧(信令风暴)。
工业级实现普遍采用水位线阈值策略 (如 50% 规则):只有当被消费的数据量累计达到当前窗口的一半(Window/2Window / 2Window/2),或者可用配额跌破某个安全下限时,才合并发射一个大额 WINDOW_UPDATE,既保障管道不空转,又节约了 CPU 与网卡中断开销。
五、协议演进视角:HTTP/3 (QUIC) 的流控重构
探讨完 HTTP/2 的流控体系,我们不妨把视线向前推进到 HTTP/3。
既然 HTTP/2 已经通过双层滑动窗口解决了应用层的慢流阻塞问题,为什么还需要由 Google 牵头演进出基于 UDP 的 HTTP/3 (QUIC) 协议?
答案在于:HTTP/2 解决了应用层流级饥饿,但始终被困在 TCP 传输层的队头阻塞之中。
- HTTP/2 的局限:所有的 Stream 最终依然塞在一根 TCP 管道内。只要物理链路发生哪怕一个分组丢包(Packet Drop),由于 TCP 必须保证字节流的绝对有序性,操作系统内核会暂停向应用层交付后续所有包,直到丢掉的包被重传确认。在此期间,整条连接上的所有 Stream 全部暂停;
- HTTP/3 的重构 :QUIC 直接抛弃了 TCP,在 UDP 之上重写了传输层。QUIC 将连接与流的概念直接下沉到了传输层本身 。它不仅具备与 HTTP/2 完全等价的双层流控帧(
MAX_DATA与MAX_STREAM_DATA),更彻底解除了不同流在传输层的丢包关联------Stream 1 丢包只会阻塞 Stream 1,Stream 2 照常交付。
HTTP/2 用应用层流控构筑了一座精巧的立交桥;而 HTTP/3 则直接拓宽了底层的地基公路。
六、总结与架构师避坑清单
流量控制从来不是单纯的协议规范参数,而是高并发、低延迟系统稳定运行的稳压器。
总结全文,工程师在面对 HTTP/2 流量控制时,请牢记以下四条黄金铁律:
- 认清根本矛盾 :TCP 流控保护的是网卡与操作系统内核缓冲区;HTTP/2 流控保护的是并发多路流互不抢占、慢流不拖死快流。
- 信任协议自愈 :只有
DATA帧消耗窗口配额;所有控制与信令帧绝对免疫,这是协议杜绝死锁的终极防线。 - 警惕反向代理断裂:编写或配置 API 网关时,必须保证下游消费能力与上游数据灌入具有背压联动,严禁无脑为上游充值配额引发 OOM。
- 按 BDP 科学调参:在跨机房、长距离专线的大吞吐业务中,坚决弃用默认 64KB 窗口,按带宽时延积将流与连接窗口放大至兆级,或直接开启框架的 BDP 动态自适应机制。