【摘要】 大模型的非确定性瓦解了传统软件"设计路径 + 事后校验"的可靠性逻辑,工程核心从"如何正确构建"转向"如何可靠度量"。本文以 Anthropic 的工程实践为底,梳理 Agent 评测的范式转变:可靠性逻辑重构、评测架构四要素、用 `pass@k`/`pass^k` 与组合评分器管理非确定性、评测体系构建路线,以及评测驱动开发的攻防体系。结论:度量即控制,评测即方向。没有评测,优化就是随机游走。
1. 从测试到评测:AI Agent 时代可靠性逻辑的重构
1.1. 旧逻辑的根基:设计路径 + 事后校验
传统软件的可靠性逻辑,建立在一个确定性的前提之上:系统的行为是可枚举、可预测、可复现的。
在这个前提下,研发和测试形成了一套分工:
- 研发: 通过架构、接口、规范,把系统行为"锁死"在一个可控的路径集合内;
- 测试: 作为最后一道闸门,验证实际行为是否落在预期集合内。
这套设计路径 + 事后校验 的模式,支撑了整个软件工程几十年。它的本质是路径可控:只要设计和实现正确,系统就会按预期运行。测试是成本,是兜底,是质量保障。
1.2. 断裂:非确定性动摇了根基
但 AI Agent 底层大模型的非确定性(Non-determinism),让这套逻辑走向失效。
研发无法再通过架构设计锁定系统的边界,也无法精准控制运行路径。这不是实现层面的缺陷,而是大模型的底层属性:同样的输入,不保证同样的输出。
于是,传统可靠性逻辑的根基------可复现性------被动摇了。当不存在一个固定的预期集合可以比对时,测试作为"最后一道闸门"的假设也随之瓦解。
1.3. 转向:从"设计路径"到"设计目标"
既然单次结果不可复现,成功指标就必须重新定义:不再是"单次输出是否正确",而是"在 n 次运行中,任务成功完成的频率是多少,结果的分布是怎样的"。评测必须把非确定性当作前提,度量成功率、稳定性和分布,而非单一的通过/失败。
核心目标因此发生转移:从"设计路径"转向"设计目标"。
- 设计路径 ,是规定系统每一步怎么走,走对了就是对的。比如传统程序,
if A then B,路径是确定的。 - 设计目标,是规定系统最终要达成什么,但不规定它怎么达成。比如让 Agent"帮用户订一张最便宜的机票",它可能查多个平台、比价、调用不同 API,路径不固定。
这带来几个连锁变化:
- 控制点后移:从"控制过程"转向"控制结果"。
- 正确性重新定义:不再是"是否符合预期路径",而是"是否达成目标且未越界"。
- 研发的重心转移:从写死逻辑,转向设计目标函数、约束条件和反馈机制。
研发不再是一个"建筑师",而更像一个"园丁":你不能命令植物怎么长,但可以控制阳光、水分和土壤,让它朝着你想要的方向生长。
1.4. 重构:评测从后置检查变成核心坐标
在传统系统里,测试是后置的、验证性的:先有系统,再有测试,测试告诉你"行不行"。
在 AI Agent 里,评测是前置的、驱动性的:没有评测,你甚至不知道 Agent 现在处于什么状态,更不知道优化是让它在变好还是变坏。
这让评测(Evals)的意义发生本质变化:它不再是后置检查,而是驱动 Agent 进化的核心坐标。
这里有一个很深的逻辑转换:
- 传统系统里,代码是 source of truth,测试是附属。
- AI Agent 里,评测集是 source of truth,模型和 prompt 是附属。
原因在于,Agent 的行为空间太大,你无法靠"读代码"来判断它会做什么。定义"什么是好 Agent"的主要依据,就是你构造的那套评测。
所以评测不再是"检查",而是定义目标本身。
你评测什么,Agent 就朝什么方向进化;评测错了,Agent 就朝错误方向进化。
1.5. 没有评测,优化就是随机游走
复杂系统都有一个通病:局部优化可能引发全局退化。而非确定性让情况更糟------退化难以稳定复现,你甚至无法确认它是否存在。
你为了让 Agent 在 A 场景表现更好,调整了 prompt 或模型,结果 B 场景变差了。你再修 B,C 又坏了。这就是"打地鼠"。
根本原因在于:没有可靠的评测,就没有稳定的坐标系。你不知道当前的位置,也不知道移动的方向是否正确,每次优化都是一次盲跳。行为漂移因此不可避免。
而可靠的评测提供了那个坐标系,让你能回答:
- 这次改动,整体是变好了还是变坏了?
- 变好了多少?在哪些维度上?
- 有没有引入新的退化?
没有这个坐标系,优化就是随机游走。
1.6. 结论:测试关乎质量,评测关乎生死
传统系统:测试没做好,可能出 bug,可能宕机,可能数据出错。这是质量问题,但系统的基本逻辑仍然成立,修就行了。
AI Agent:评测没做好,你根本不知道 Agent 在做什么。它可能在某个你没测到的场景里胡言乱语、越权操作、泄露数据、做出不可逆的决策。而且因为非确定性,同一个问题可能时好时坏,你甚至无法稳定复现。
更关键的是:Agent 的进化依赖评测。 没有评测,Agent 就不会进化,只会漂移。在一个快速迭代的领域里,这样的 Agent 很快会被淘汰。
当系统从确定性走向非确定性,工程的核心问题就从"如何正确地构建"变成了"如何可靠地度量"。度量即控制,评测即方向。
在 AI Agent 时代,没有评测就没有方向,没有方向就谈不上可靠性。
2. 评测架构
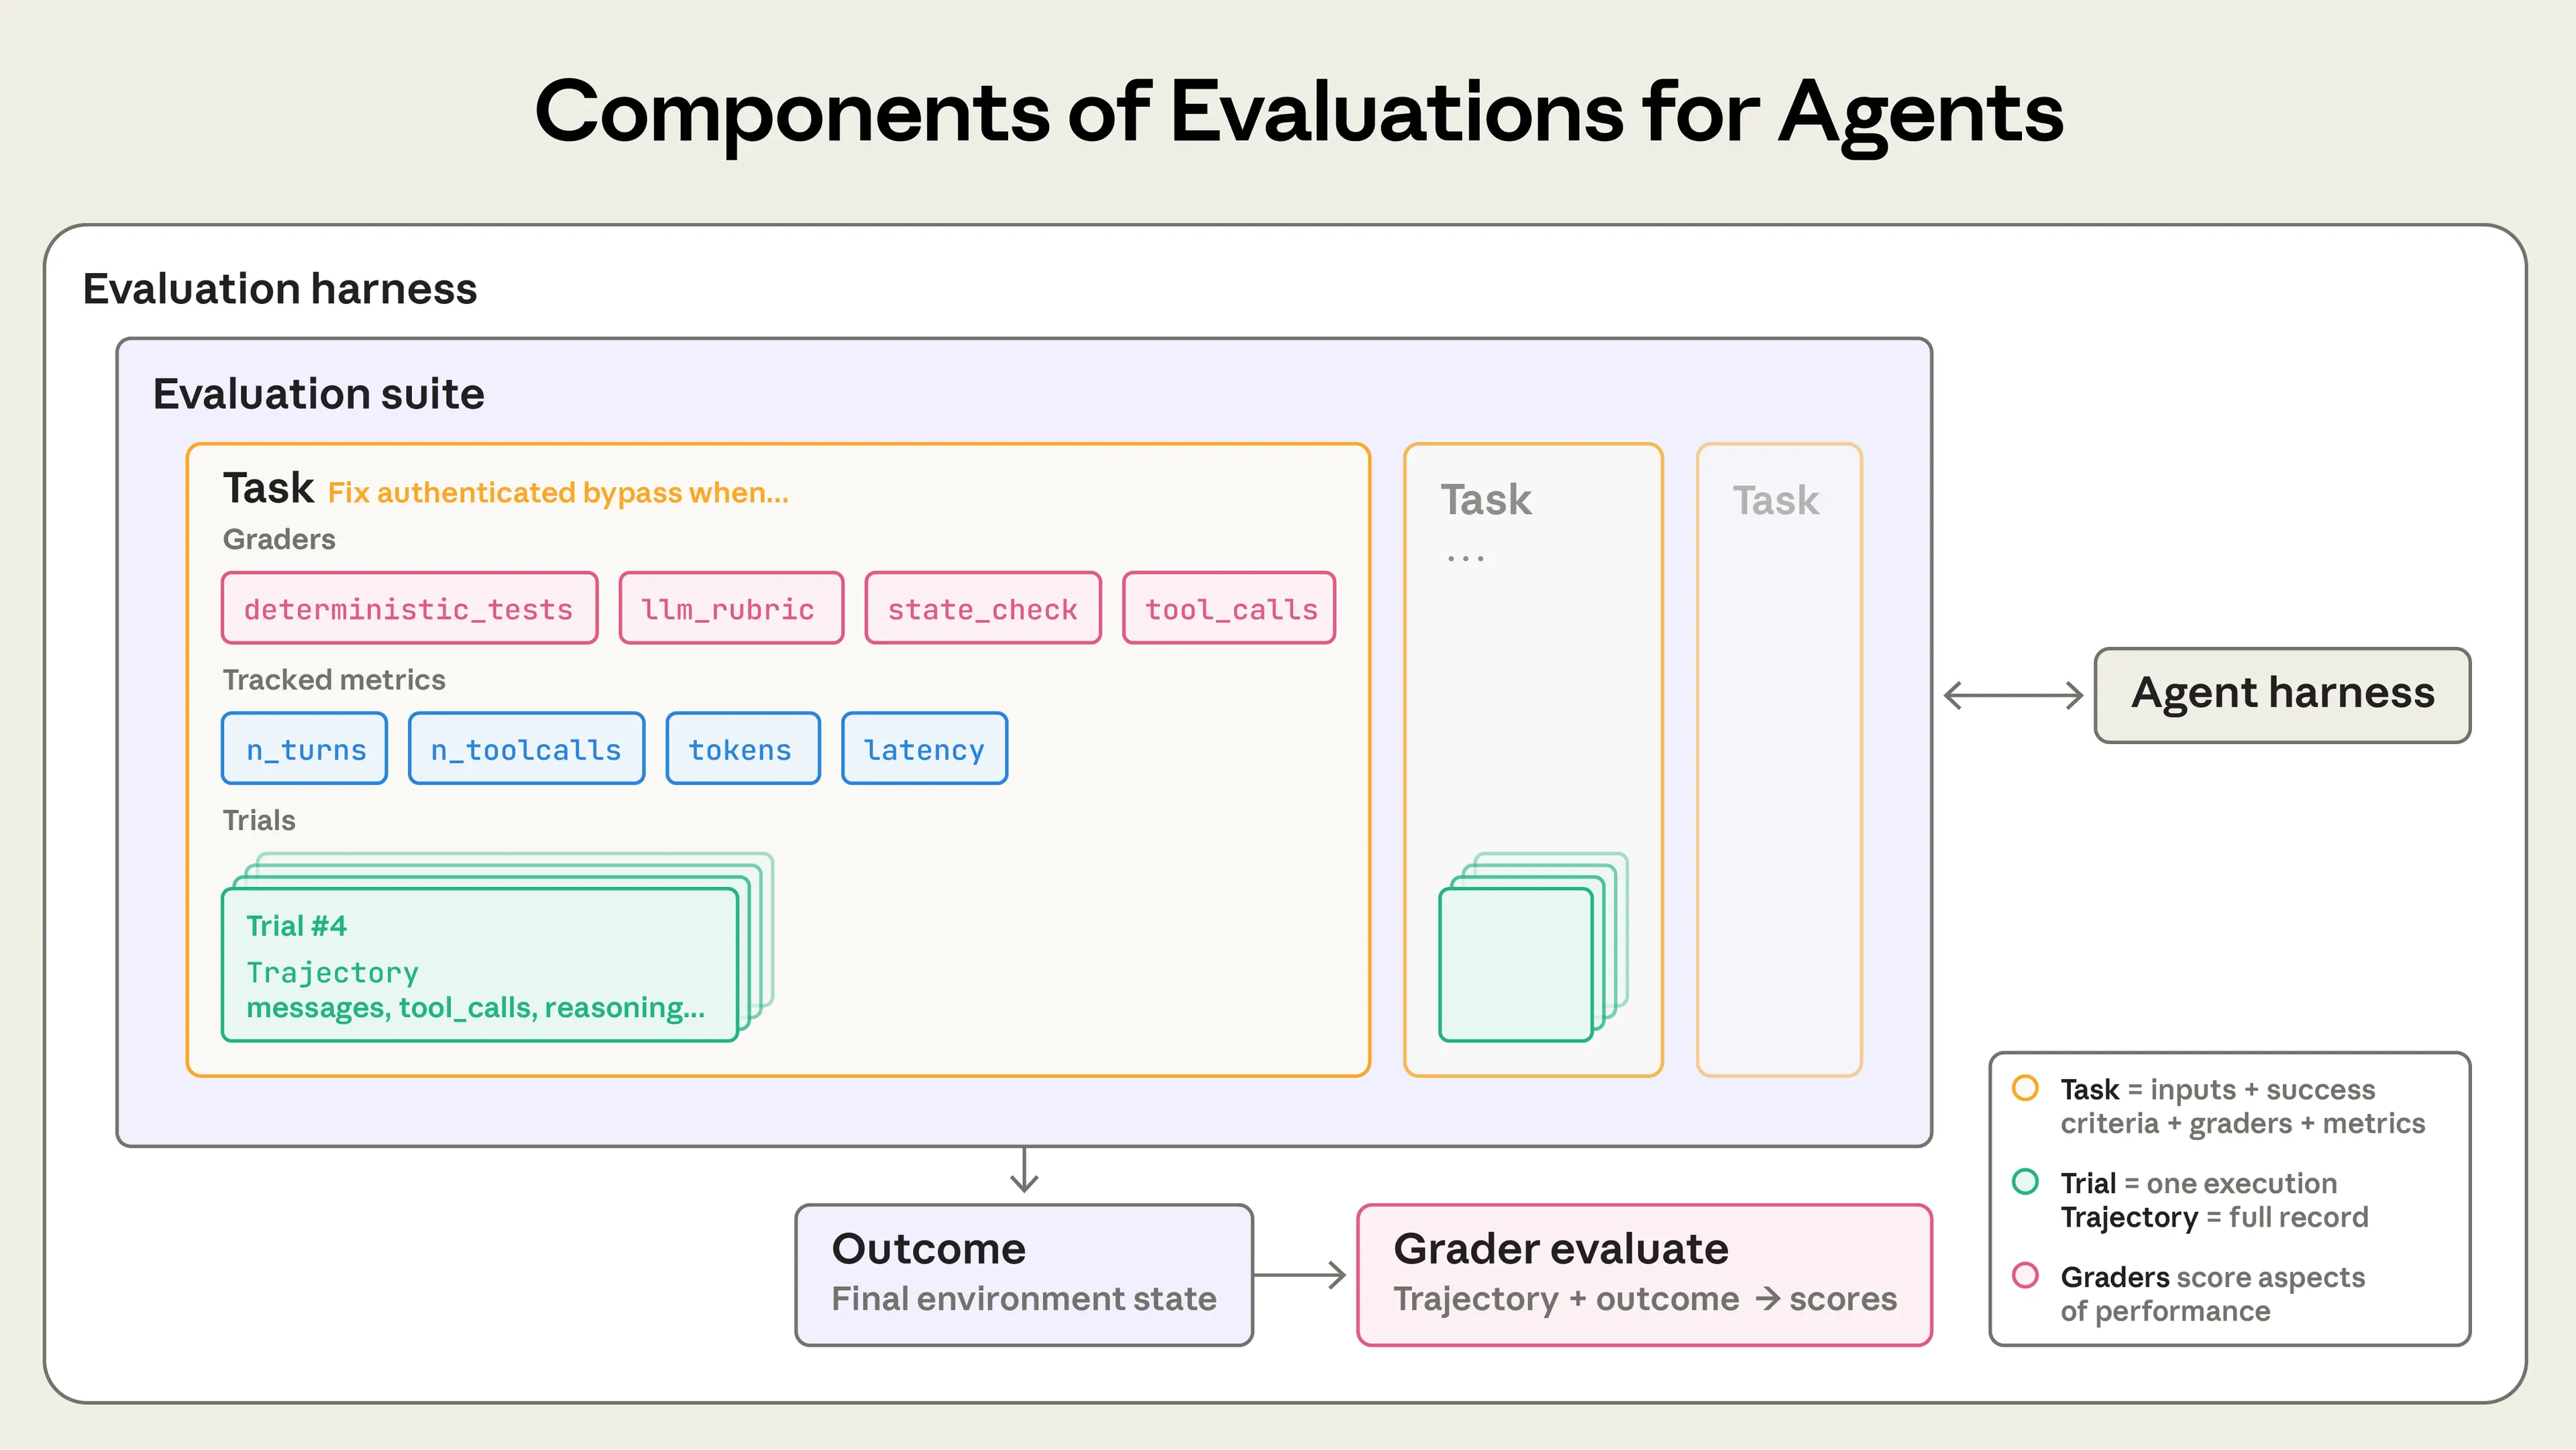
上图是 AI Agent 评测体系(Evaluations for Agents)的组件架构,覆盖从任务定义、执行到评分和结果输出的完整流程。
2.1. 整体架构:Evaluation Harness(评测框架)
最外层是 Evaluation harness(评测框架) ,负责统筹整个评测过程。右侧的 Agent harness(Agent 执行框架) 与之双向交互:评测框架向 Agent 下发任务,Agent 执行后返回结果。
2.2. 核心单元:Evaluation suite(评测套件)
评测框架内部包含一个 Evaluation suite(评测套件) ,由多个 Task(任务) 组成(图中展示了三个)。
2.2.1. 任务(Task)的构成要素
每个 Task 卡片内部,定义了评测一个 Agent 所需的所有要素:
- Task 描述 :如图中示例
Fix authenticated bypass when...,即一个具体的任务指令。 - Graders(评分器) :定义了如何判断任务是否成功。图中列出了四种评分方式:
deterministic_tests:确定性测试(如单元测试,结果非黑即白)。llm_rubric:LLM 评分规则(用大模型按标准打分,适合主观或复杂任务)。state_check:状态检查(检查最终环境状态是否符合预期)。tool_calls:工具调用检查(检查 Agent 是否调用了正确的工具)。
- Tracked metrics(追踪指标) :量化 Agent 表现的指标,如:
n_turns:交互轮次。n_toolcalls:工具调用次数。tokens:消耗的 Token 数。latency:延迟/耗时。
- Trials(试验/运行实例) :每个 Task 会运行多次(如图中
Trial #4,表示第4次运行)。因为大模型是非确定性的,单次运行不足以说明问题,必须通过多次试验来观察稳定性。 - Trajectory(轨迹) :每次 Trial 都会记录完整的执行轨迹,包括
messages(消息)、tool_calls(工具调用)、reasoning(推理过程)等。这是后续评分和调试的核心依据。
2.3. 执行与评分流程
图中下方的箭头展示了数据流向:
- Outcome(结果) :Agent 执行完任务后,会改变最终的环境状态(
Final environment state)。 - Grader evaluate(评分器评测) :评分器接收两个输入------Trajectory(执行轨迹) 和 Outcome(最终结果) ,然后输出 scores(分数)。
2.4. 右下角的图例(Legend)
图例进一步明确了几个关键概念的定义:
- Task = 输入 + 成功标准 + 评分器 + 指标。
- Trial = 一次执行。
- Trajectory = 完整记录。
- Grader = 对轨迹和结果进行评分的组件。
2.5. 总结
评测不再是简单的"通过/失败"测试,而是一个复杂的系统工程。
它强调了几个关键点:
- 非确定性应对 :通过
Trials(多次运行)来应对大模型的非确定性。 - 过程与结果并重 :不仅看
Outcome(结果),还要看Trajectory(轨迹),因为 Agent 的推理和工具调用过程同样重要。 - 多维评分 :结合了确定性测试、LLM 评分、状态检查等多种
Graders,以全面评测 Agent 能力。 - 数据驱动 :通过
Tracked metrics量化性能,为优化提供依据。
这套体系正是第 1 节结论的落地:没有它,Agent 的进化就是盲目的。
3. Agent 在评测中的"不确定性"
Anthropic 的文章针对 Agent 在评测中的"不确定性"(即非确定性)问题,给出了一套从度量指标到工程实践 的系统性应对方案。核心思路是:不追求消除非确定性,而是通过统计指标、多次运行和组合评分器,将其量化为可管理的工程信号。
3.1. 核心度量:pass@k 与 pass^k
这是应对非确定性的基石。因为 Agent 每次运行结果可能不同,单次成功或失败都不可靠,必须用两个互补的指标来区分"能力"与"可靠性"。
| 指标 | 含义 | 度量的是什么 |
|---|---|---|
| pass@k | k 次尝试中至少有一次成功的概率 | 能力上限:Agent 有没有可能解决这个问题? |
| pass^k | k 次尝试全部成功的概率 | 可靠性:Agent 能不能每次都做对? |
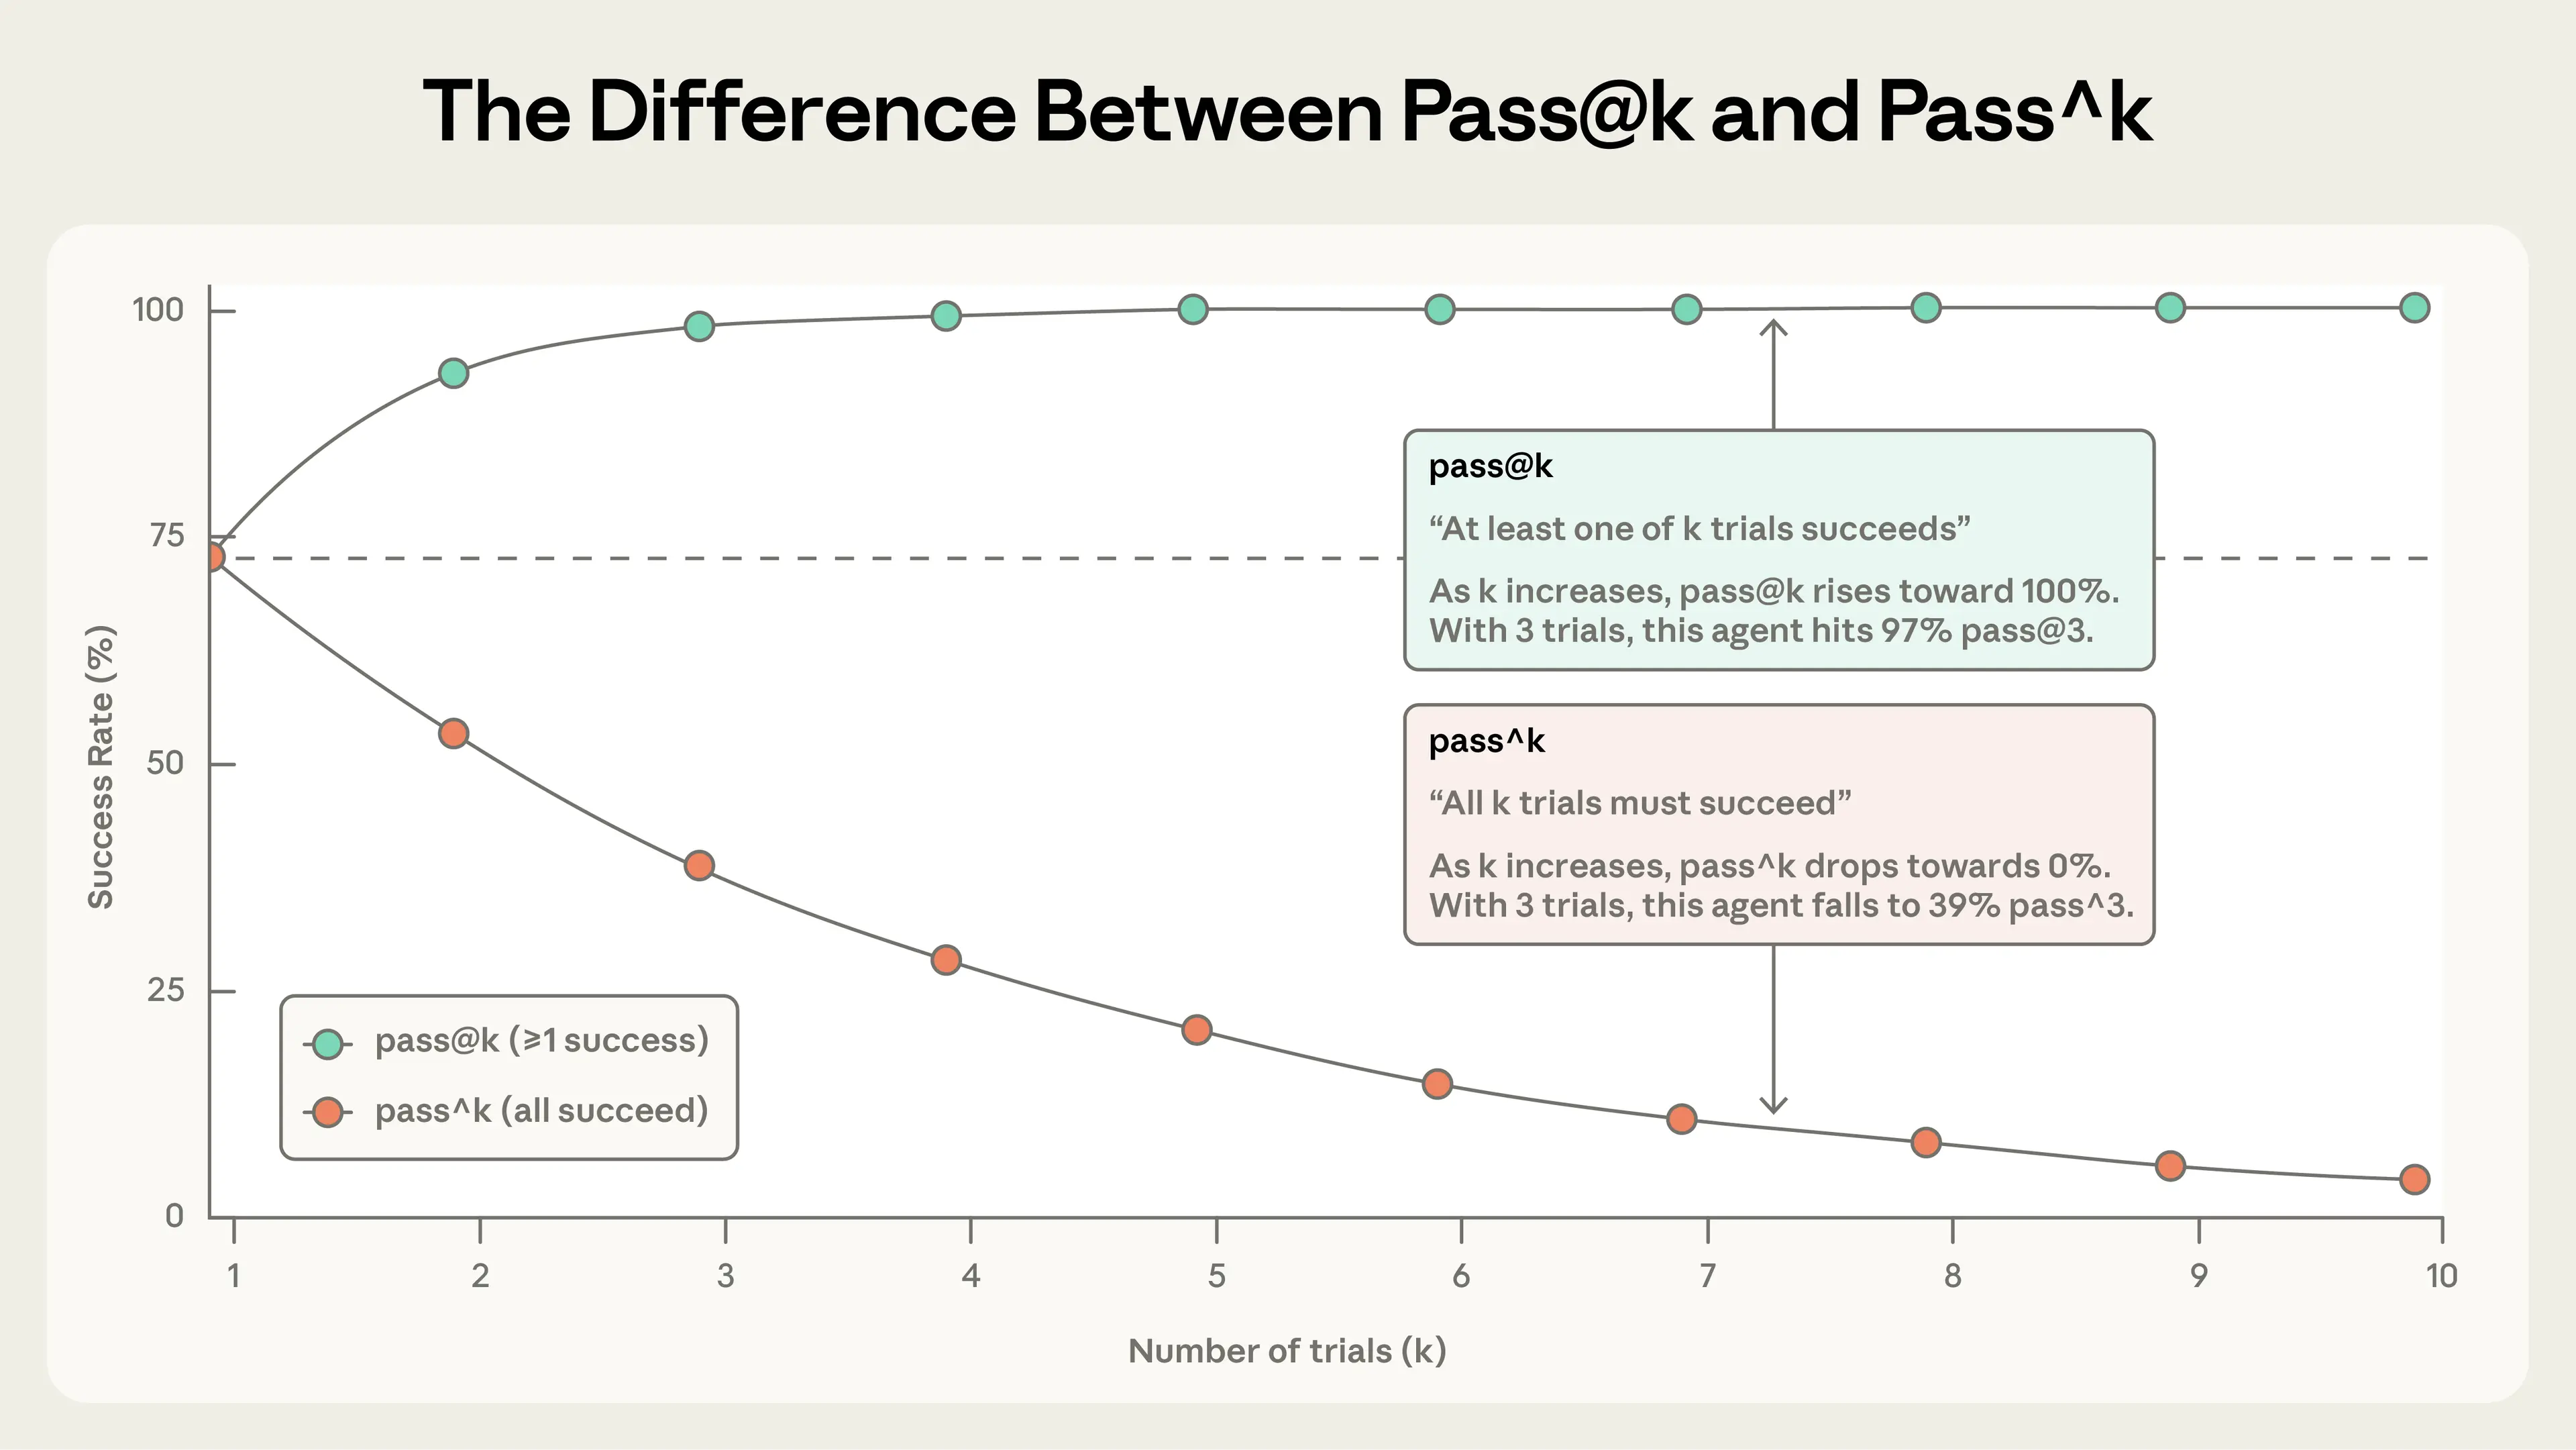
上图用两条曲线把抽象的"非确定性"变成可度量的指标,解释了为什么 Agent 评测中单次测试结果几乎没有统计意义 ,以及 pass@k 和 pass^k 如何区分"能力"与"可靠性"。评测 Agent 时,不要问"它能不能做对",而要问"它在 k 次尝试中,能稳定做对几次"。
3.1.1. 图表核心信息解读
图表的 X 轴是试验次数 k,Y 轴是成功率。两条曲线代表了同一个 Agent 在两种不同评测标准下的表现:
- 绿色曲线(pass@k) :
- 定义 :k 次尝试中至少有一次成功的概率。
- 趋势 :随着 k 增大,曲线迅速上升并逼近 100%。图中显示,当 k=3 时,pass@3 达到了 97%。
- 含义 :这衡量的是 Agent 的能力上限。只要给它足够多的机会,它几乎总能解决问题。
- 橙色曲线(pass^k) :
- 定义 :k 次尝试全部成功的概率。
- 趋势 :随着 k 增大,曲线迅速下降并逼近 0%。图中显示,当 k=3 时,pass^3 只有 39%。
- 含义 :这衡量的是 Agent 的可靠性。它能不能每一次都稳定地做对?
关键解读:
- 如果
pass@k高但pass^k低,说明 Agent 有能力但不稳定------能做对,但不保证每次都做对,在生产环境中很危险。 - 因此,对于重要任务,建议至少运行 3 次(k=3):单次评测只是样本量为 1 的抽样,多跑几次才能得到有统计意义的信号。
3.1.2. 这张图带给我们的启发
- 用数学事实打破"单次测试"的幻觉
由于大模型的非确定性,只跑一次测试,你看到的只是概率分布中的一个随机样本;单次成功可能只是运气好,并不代表稳定可靠。图中 Agent 的 pass@3 高达 97%,看起来非常强大;但 pass^3 只有 39%,意味着它在连续三次任务中全部成功的概率不到一半。如果这是一个自动客服 Agent,它有 61% 的概率在连续处理三个用户请求时至少失败一次。
-
评测必须基于多次运行(k>1),否则毫无统计意义。
-
定义"能力"与"可靠性"的分离
图表清晰地展示了:
- 能力(Capability) :看 pass@k。它告诉你 Agent 的上限在哪里,能不能解决这个问题。
- 可靠性(Reliability) :看 pass^k。它告诉你 Agent 的下限在哪里,能不能在生产环境中信任它。
- 指导工程决策
这张图直接回答了"我们该关心哪个指标?":
- 如果你在做探索性研究 (比如测试新模型能不能做某件事),看 pass@k,因为你需要知道它有没有潜力。
- 如果你在做生产部署 (比如让 Agent 自动处理退款),看 pass^k,因为你无法承受它偶尔失败带来的后果。
- 这也印证了第 1 节的判断:
pass^k低意味着生产环境不可靠(评测关乎生死);pass@k与pass^k是两套坐标,分别指引"能力探索"和"可靠性保障";只看单次结果,就无法区分 Agent 是在进步还是在碰运气。
3.2. 工程实践:用"多次试验"对抗随机性
文章在概念层面就把 Trial(试验)定为评测的基本执行单位:同一个 Task 必须运行多次。这背后是几个具体的工程考量:
- 统计显著性:通过多次运行,可以用均值、方差、置信区间等统计工具来描述 Agent 表现,而不仅仅是一个孤立的通过率数字。
- 识别"虚假信心":如果只测一次,一个碰巧成功的失败案例会被误判为成功。多次运行能暴露这种不稳定性。
- 校准评分器:对于 LLM 评分器,其本身也有随机性。通过多次运行取平均,可以减少评分波动带来的噪声。
3.3. 评分策略:用"组合拳"弥补单一方法的盲区
不确定性不仅存在于 Agent 的行为,也存在于评分过程本身;而且不同维度的问题需要不同的判定方式。因此,文章强调必须组合使用三类评分器:
| 维度 | 基于代码的评分器(Code-based) | 基于模型的评分器(LLM-as-a-Judge) | 人类评分器(Human) |
|---|---|---|---|
| 核心作用 | 验证确定性、可枚举的硬性条件 | 评测开放式、主观性、复杂语义的任务质量 | 定义"什么是好",校准其他评分器,处理边界案例 |
| 典型形式 | 字符串匹配、单元测试、静态分析、工具调用检查、状态检查 | LLM 按 Rubric 打分、 pairwise 对比、多轮评审 | 人工审阅 Transcript、标注评分、A/B 对比 |
| 优点 | 快、便宜、稳定、可复现;结果非黑即白,无歧义;适合大规模回归 | 灵活、可扩展;能处理开放式任务(如"解释是否清晰""推理是否合理");无需为每个场景写死规则 | 黄金标准;能捕捉 LLM 和代码都遗漏的微妙问题;提供最可靠的校准信号 |
| 缺点 | 死板;只能验证预设路径,可能误伤"合理但不在预期内"的正确输出;无法评测质量、连贯性等软性维度 | 不确定 ;同一输出可能评分不同;成本高;可能被"表面合理"的输出欺骗;需要定期与人类评分校准 | 贵、慢、不可规模化;主观性强,不同评审者可能不一致;难以覆盖全部场景 |
| 适用场景 | 安全底线(是否越权、是否泄露数据)、格式合规、工具调用正确性、确定性状态检查 | 任务完成度、推理质量、回答连贯性、多轮对话体验、开放式生成任务 | 校准 LLM 评分器、定义 Rubric、处理争议案例、关键版本发布前的最终验证 |
| 在评测体系中的角色 | 守底线------确保 Agent 不犯低级错误、不越界 | 抓质量------衡量 Agent 在复杂任务上的真实表现 | 定标准------回答"什么算好",并修正其他评分器的偏差 |
| 成本 | 极低 | 中等至高(取决于调用频率和模型) | 极高 |
| 速度 | 毫秒级 | 秒级到分钟级 | 分钟级到小时级 |
| 可复现性 | 完全可复现 | 部分可复现(受温度、提示词影响) | 低(受评审者主观影响) |
| 规模化能力 | 极强 | 强 | 弱 |
3.3.1. 组合使用的核心逻辑
三类评分器对应了 Agent 评测的成本-精度权衡,不是替代关系,而是互补关系,组合使用的逻辑是:
- 代码评分器(确定性) :用于锚定底线。工具调用、格式、状态检查等硬性条件,必须用确定性逻辑判定,这部分没有模糊空间。先把所有能确定性验证的东西交给代码------安全、格式、工具调用、状态变更。这些是"一票否决"项,不通过则直接失败,无需进入后续评分。
- LLM 评分器(概率性) :用于评测质量。它本身就有不确定性,所以需要人类校准,且不能作为唯一依据。在代码评分器通过的基础上,用 LLM 评测那些无法用规则写死的维度------任务是否真正完成、推理是否合理、回答是否清晰。LLM 评分器的 Rubric(评分规则/评分量表) 必须由人类定义和校准。
- 人类评分器(校准锚点) :用于定义标准。定期抽查 LLM 评分器的结果,检查它是否对某些失败模式过于宽容、对某些合理输出过于严苛,防止其在非确定性中"跑偏"。人类评分的结果反过来修正 LLM 的 Rubric 和提示词。
代码评分器守底线,LLM 评分器抓质量,人类评分器定标准。 三者组合,才能在成本、速度、精度和可扩展性之间取得平衡,构成一个可靠的 Agent 评测体系。
能用代码就用代码,必要时上 LLM,人类评分留给校准和验证。
3.4. 评测哲学:终点优先,包容路径的不确定性
文章反复强调,评测 Agent 的产出(Outcome),而非它走过的路径(Path)。这直接呼应了非确定性:因为 Agent 的推理路径本身就是不确定的,如果用固定路径去卡它,会误伤大量"走了不同路但到达了正确终点"的有效行为。
例如,Opus 4.5 在一个机票预订任务中走出了预设路径之外的解法------它发现了任务设定中的漏洞并加以利用。这类案例不能简单判失败(会掩盖能力上限),也不能直接算成功(等于放过钻空子),它暴露的是评测设计本身的问题,需要评测者显式裁决如何计分。
3.5. 持续监控:警惕"评测饱和"掩盖的不确定性
当评测套件通过率达到 100%(饱和),它就失去了信号价值------此时大的能力提升可能只表现为微小的分数增长,结果具有欺骗性。应对方式是:把饱和的"能力评测"毕业(graduate)为"回归评测",同时持续开发更难的评测任务,并深入审视对话记录(Transcript),确认分数提升是真实能力还是评测失效(详见 6.2 节)。
总结来说,Anthropic 对不确定性的处理逻辑是:承认它、度量它(pass@k/pass^k)、用工程手段管理它(多次试验、组合评分),并在它被"驯服"后,及时更换更难的标尺。
4. 示例:对话式智能体的评测
对话式智能体(Conversational Agent)评测的核心挑战在于:交互质量本身就是评测对象的一部分。这意味着不仅要看最终结果,还要看对话过程中的共情、清晰度、安全性等难以量化的维度。
下面这段 YAML 是 Anthropic 评测体系中一个对话式客服 Agent(退款场景)的评分器配置 。它把抽象的评测原则落地为可执行的检查逻辑,核心思路是:用不同工具验证不同维度,组合成完整的质量判断。
graders:
  - type: llm_rubric
    rubric: prompts/support_quality.md
    assertions:
      - "Agent showed empathy for customer's frustration"
      - "Resolution was clearly explained"
      - "Agent's response grounded in fetch_policy tool results"
  - type: state_check
    expect:
      tickets: {status: resolved}
      refunds: {status: processed}
  - type: tool_calls
    required:
      - {tool: verify_identity}
      - {tool: process_refund, params: {amount: "<=100"}}
      - {tool: send_confirmation}
  - type: transcript
    max_turns: 10
tracked_metrics:
  - type: transcript
    metrics:
      - n_turns
      - n_toolcalls
      - n_total_tokens
  - type: latency
    metrics:
      - time_to_first_token
      - output_tokens_per_sec
      - time_to_last_token
4.1. Graders(评分器):四个维度的检查
llm_rubric:评测沟通质量与行为
- type: llm_rubric
  rubric: prompts/support_quality.md
  assertions:
    - "Agent showed empathy for customer's frustration"
    - "Resolution was clearly explained"
- "Agent's response grounded in fetch_policy tool results"作用:用 LLM 按 Rubric 评测对话的软性质量,无法用代码写死。
三条断言分别对应三个维度:
- 共情:Agent 是否理解并回应了客户的沮丧情绪?------这是对话式 Agent 的核心体验指标。
- 清晰度:解决方案是否被清楚地解释?------客户能不能听懂、知道下一步做什么。
- 依据 :回复是否基于
fetch_policy工具的实际返回结果?------防止 Agent 凭空编造政策(幻觉)。
关键点 :rubric: prompts/support_quality.md 说明评分标准写在一个独立文件里,而不是硬编码在 YAML 中。这意味着 Rubric 是可维护、可迭代的活资产------当发现评分器误判时,改这个文件即可,不需要动评测框架。
state_check:验证最终环境状态
- type: state_check
  expect:
    tickets: {status: resolved}
    refunds: {status: processed}
作用 :检查任务结束时环境的真实状态,而不是 Agent 说了什么。
这是整个评测中最关键的设计之一 :Agent 可能在对话里说"您的退款已处理",但数据库里 refunds.status 仍然是 pending。state_check 直接查数据库,绕过了 Agent 的"口头承诺",确保结果真实发生。
tickets: {status: resolved}:客服工单是否真正关闭。refunds: {status: processed}:退款是否真正完成。
这直接呼应了 3.4 节的原则:评测产出(Outcome),而非过程------Agent 说了什么不算数,环境里真正发生了什么才算数。
tool_calls:验证必需的工作流步骤
- type: tool_calls
  required:
    - {tool: verify_identity}
    - {tool: process_refund, params: {amount: "<=100"}}
- {tool: send_confirmation}作用:检查 Agent 是否调用了关键工具,且参数符合约束。
三条必需调用构成了一条合规工作流:
verify_identity:先验证身份------这是安全底线,防止未授权退款。process_refund, amount: "<=100":执行退款,且金额不得超过 100------这是业务规则,防止 Agent 被诱导超额退款。send_confirmation:发送确认------确保客户收到闭环通知。
注意 amount: "<=100" 这个参数约束 :它不仅是"调用了就行",还要求参数在安全范围内。这是一个典型的"守底线"检查------用确定性代码逻辑拦截高风险操作。
这类工具调用约束与 3.4 节"评测产出而非路径"的原则并不冲突:约束对象是安全与合规底线(身份验证、金额上限、闭环通知),而不是限定 Agent 用什么思路解决问题。
transcript:约束对话轮次
- type: transcript
max_turns: 10作用:限制对话最多 10 轮,防止 Agent 陷入无限循环或低效拉锯。
这是一个效率与体验的平衡:对话式 Agent 如果 10 轮还没解决问题,要么是能力不足,要么是在兜圈子,对用户体验都是伤害。
4.2. Tracked Metrics(追踪指标):量化效率与性能
transcript 指标:交互效率
- type: transcript
  metrics:
    - n_turns        # 总轮次数
    - n_toolcalls    # 工具调用次数
- n_total_tokens # 总 Token 消耗n_turns:实际用了几轮。如果接近max_turns=10,说明 Agent 效率偏低。n_toolcalls:调用了几次工具。过多可能是反复试错,过少可能是遗漏步骤。n_total_tokens:成本指标。对话越长、上下文越多,Token 消耗越大。
这三个指标不直接决定通过/失败,但提供了"效率画像"------同样是成功的任务,用 3 轮完成和用 9 轮完成,用户体验差距明显。
latency 指标:响应性能
- type: latency
  metrics:
    - time_to_first_token    # 首 Token 延迟
    - output_tokens_per_sec  # 输出吞吐
- time_to_last_token # 末 Token 延迟time_to_first_token:用户等待第一句话的时间------对话体验的关键指标。如果 Agent 思考 10 秒才开口,用户会以为它卡死了。output_tokens_per_sec:生成速度,影响对话的流畅感。time_to_last_token:整个回复完成的总时间,影响用户等待完整答案的体验。
为什么对话式 Agent 特别需要延迟指标:对话是实时交互,延迟直接决定用户体验。需要注意的是,延迟只被列为追踪指标而非评分项------在退款这类高风险任务里,正确性永远优先于速度;它衡量的是体验维度,供优化时权衡,而非通过/失败的判据。
4.3. 整体设计逻辑:分层验证 + 效率追踪
把这段配置抽象出来,可以看到一个清晰的结构:
| 层次 | 组件 | 验证什么 | 失败意味着 |
|---|---|---|---|
| 体验层 | llm_rubric |
共情、清晰、有依据 | 对话质量差,用户体验受损 |
| 结果层 | state_check |
工单解决、退款完成 | 任务实际失败,即使对话看起来很好 |
| 合规层 | tool_calls |
身份验证、金额限制、确认发送 | 存在安全/业务风险 |
| 效率层 | transcript(轮次上限)+ 追踪指标 |
轮次、Token、延迟 | 轮次超限即失败;Token、延迟超标提示效率问题 |
核心设计思想:
- 分工明确:LLM 评分器管"软质量",代码评分器管"硬底线",各司其职。
- 结果优先 :
state_check区分"说做到了"和"真的做到了"------只认环境状态,不认口头承诺。 - 安全兜底 :
tool_calls的参数约束(amount <= 100)用确定性逻辑拦住高风险操作。 - 效率可见:追踪指标不参与通过/失败判断,但为优化提供方向。
这正是 Anthropic 方法论的一个具体范例:代码评分器守底线,LLM 评分器抓质量,追踪指标看效率。人类评分器不出现在单个任务的配置里,它的位置在体系层面------离线定义并校准 Rubric(见 3.3 节)。
4.4. Gherkin 用例描述
把上面的配置转写为 Gherkin 验收用例,便于与非技术角色对齐评测标准:
Feature: 对话式智能体退款场景评测
  作为评测系统
  我希望通过多维度评分器验证 Agent 在退款客服场景中的表现
  以便同时衡量沟通质量、业务结果、合规性和效率

  Background:
    Given 客户发起一个退款请求
    And 客户身份信息已提供

  # ========== 体验层:LLM 评分器 ==========
  Scenario: 评测对话沟通质量
    When Agent 完成对话
    Then Agent 应对客户的沮丧情绪表现出共情
    And 解决方案应被清晰解释
    And Agent 的回复应基于 fetch_policy 工具的返回结果

  # ========== 结果层:状态检查 ==========
  Scenario: 验证最终环境状态
    When Agent 结束任务
    Then 工单状态应为 "resolved"
    And 退款状态应为 "processed"

  # ========== 合规层:工具调用检查 ==========
  Scenario: 验证必需的工作流步骤
    When Agent 执行任务
    Then Agent 必须调用 verify_identity 工具
    And Agent 必须调用 process_refund 工具
    And process_refund 的 amount 参数应小于等于 100
    And Agent 必须调用 send_confirmation 工具

  # ========== 效率层:对话轮次约束 ==========
  Scenario: 验证对话效率
    When Agent 完成对话
    Then 对话轮次不应超过 10 轮

  # ========== 追踪指标:交互效率 ==========
  Scenario: 记录交互效率指标
    When Agent 完成对话
    Then 系统应记录 n_turns(总轮次数)
    And 系统应记录 n_toolcalls(工具调用次数)
    And 系统应记录 n_total_tokens(总 Token 消耗)

  # ========== 追踪指标:响应性能 ==========
  Scenario: 记录响应性能指标
    When Agent 完成对话
    Then 系统应记录 time_to_first_token(首 Token 延迟)
    And 系统应记录 output_tokens_per_sec(输出吞吐)
    And 系统应记录 time_to_last_token(末 Token 延迟)
5. 评测体系构建过程
不要等完美,先跑起来。Anthropic 明确建议从 20--50 个来自真实失败案例的简单任务起步。这个门槛低到几乎任何团队都能立刻开始,背后有一个关键判断:评测的价值会随积累不断增长,而维护成本是后期才显现的------越早开始,收益越大。
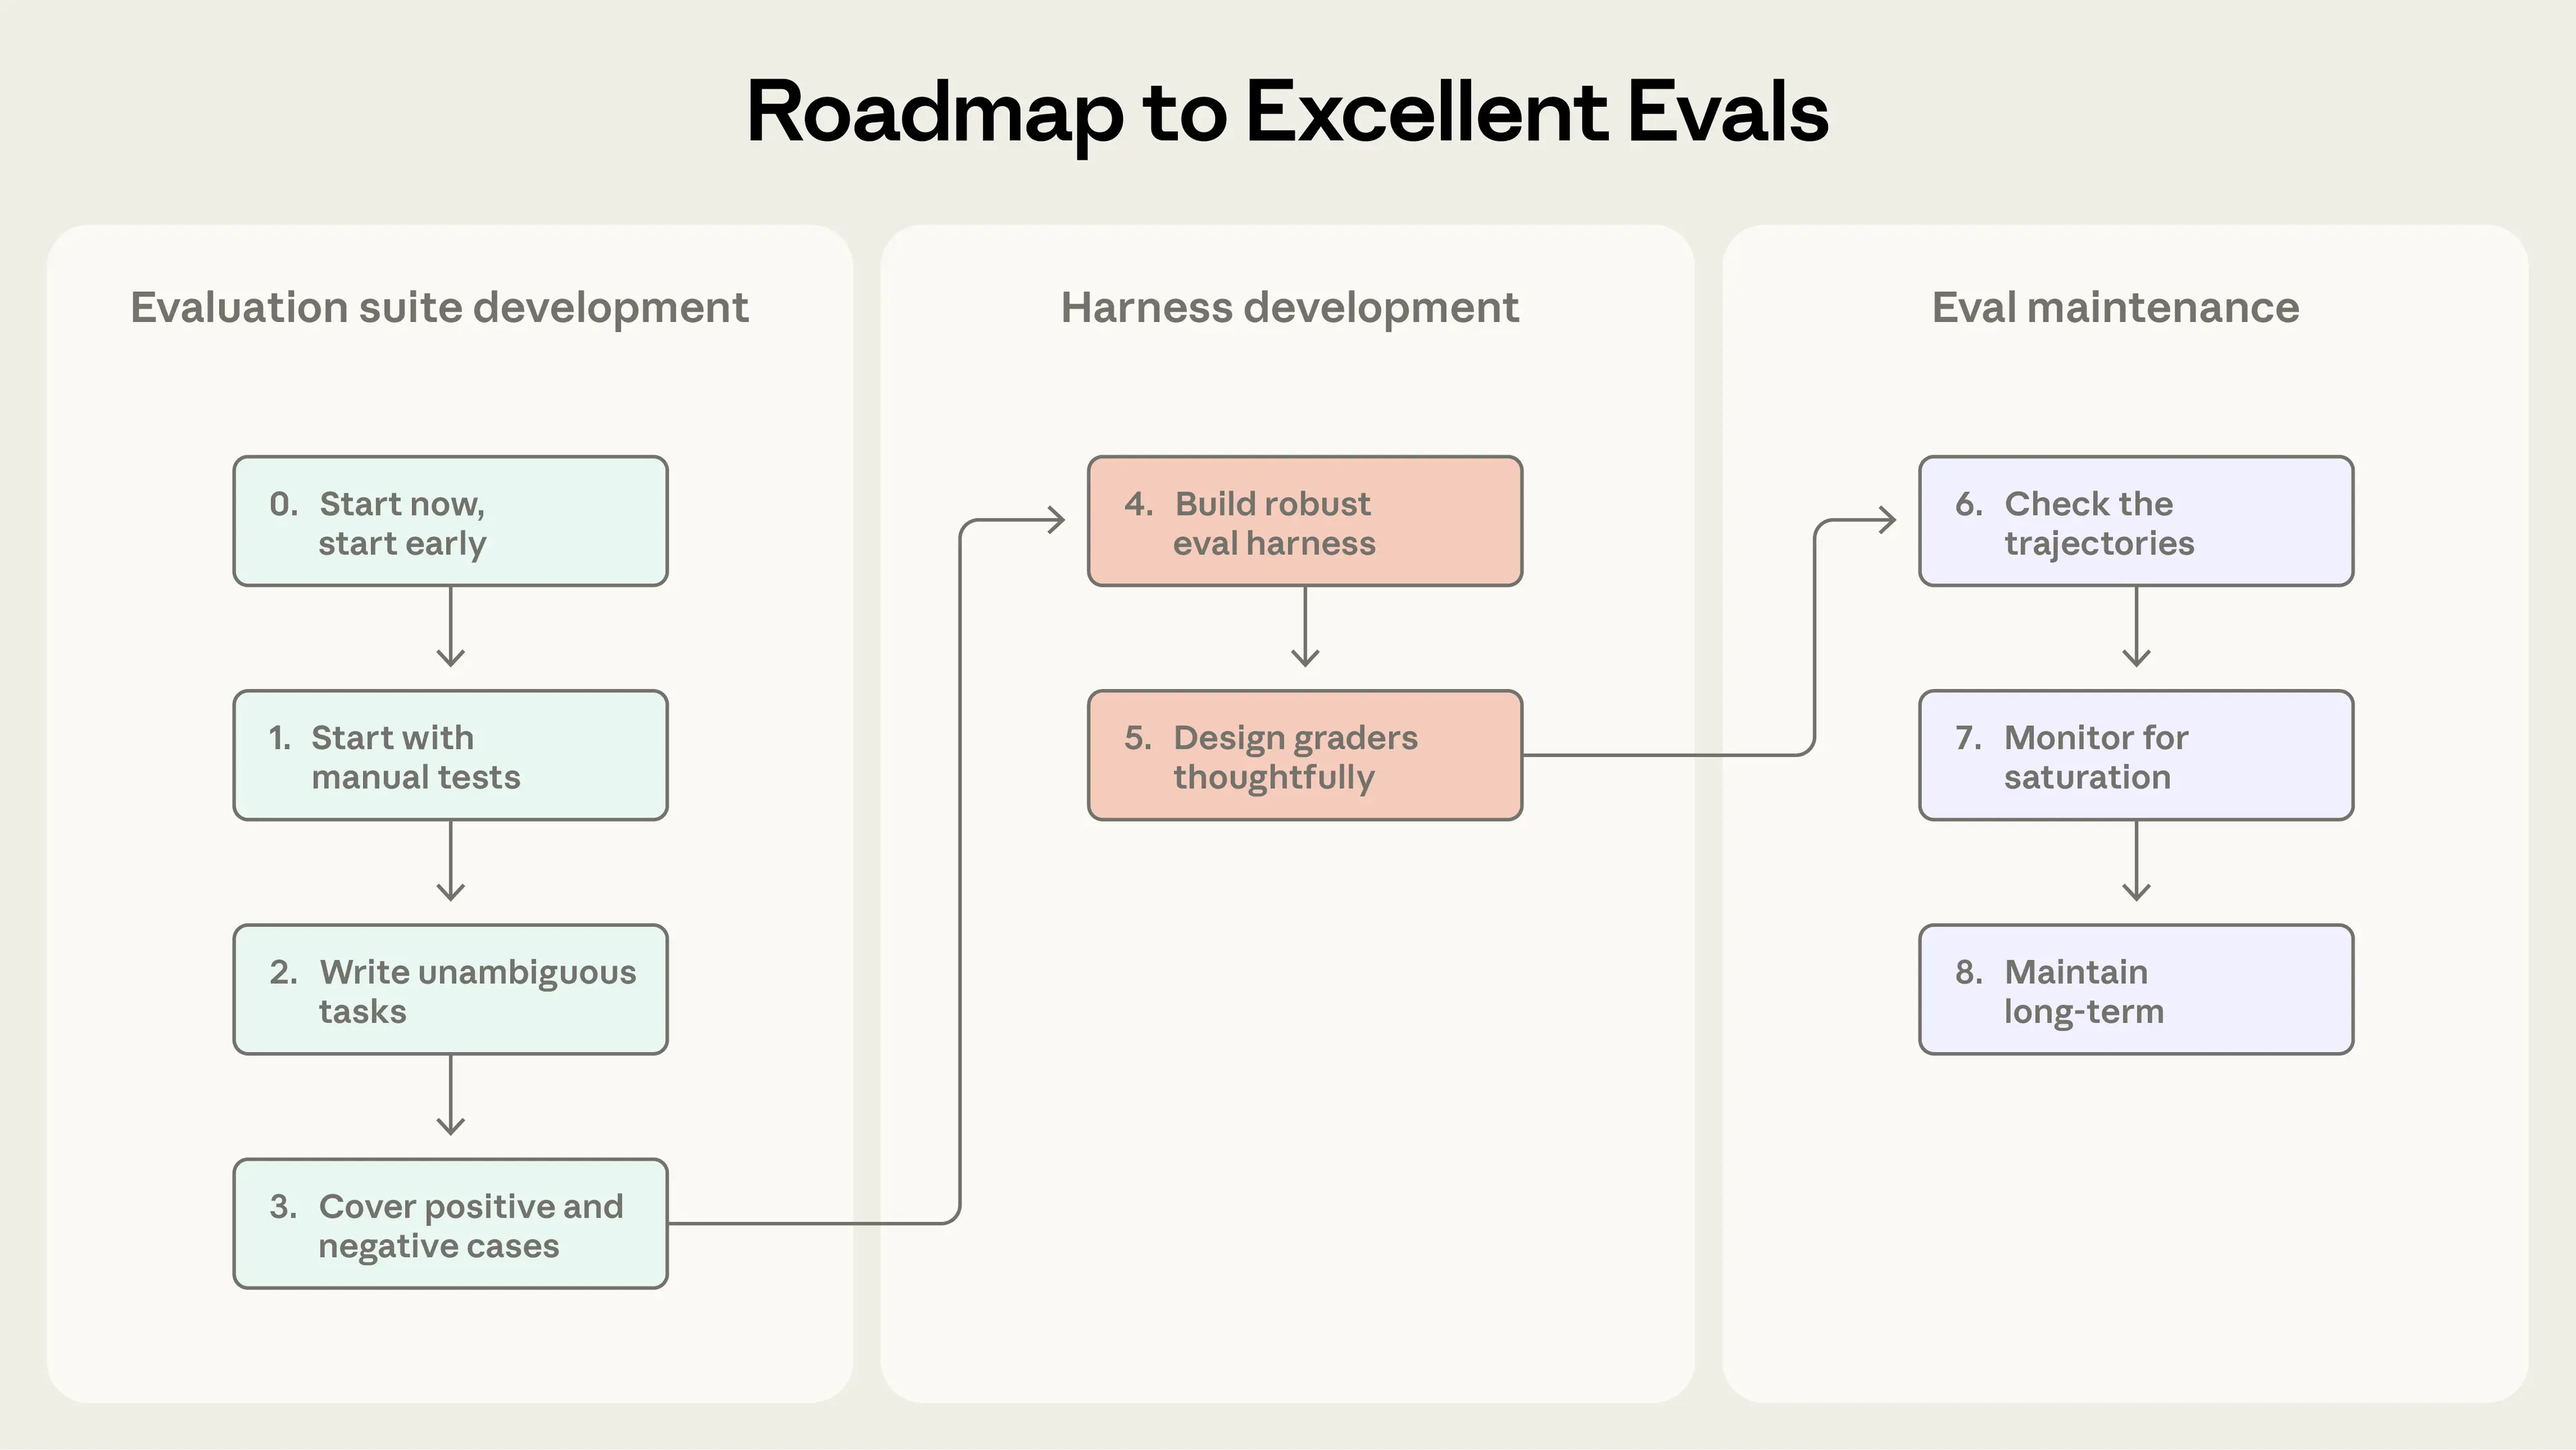
| 阶段 | 步骤 | 名称 | 核心动作 | 关键原则 / 危险信号 |
|---|---|---|---|---|
| 起步期 | Step 0 | 尽早开始 | 在 Agent 开发早期就建立评测,不要等到规模化 | 从 20--50 个来自真实失败案例的简单任务起步;越晚开始越难建立 |
| 起步期 | Step 1 | 从人工检查开始 | 把已经在手动验证的行为转化为评测任务 | 按对用户的影响程度排序:高频任务、Bug 追踪、客服投诉 |
| 起步期 | Step 2 | 编写无歧义的任务 | 确保两位领域专家独立判断能得出相同的通过/失败结论 | 必须创建参考解决方案;危险信号:大量试验通过率为 0%(pass@100 = 0) |
| 起步期 | Step 3 | 构建平衡的问题集 | 同时测试"行为应该发生"和"行为不应该发生"的场景 | 防止单边优化------Agent 会在评测中"作弊",真实场景表现更差 |
| 工程化期 | Step 4 | 构建健壮的评测框架 | 确保评测行为与生产一致;每次试验从干净状态开始 | 警惕:基础设施不稳定;共享状态导致虚假的性能提升;上一轮残留状态带来不公平优势 |
| 工程化期 | Step 5 | 精心设计评分器 | 优先确定性评分器,必要时用 LLM,人类用于验证 | 评测产出而非路径;设计部分得分机制(partial credit);给 LLM 评委"Unknown"选项;用 Rubric 校准 |
| 工程化期 | Step 6 | 查看对话记录 | 逐条审视 Agent 的执行轨迹和对话记录,验证评分器是否在工作 | 不读对话记录(Transcript),永远不知道评分器是否在衡量真正重要的事 |
| 持续运营期 | Step 7 | 监控能力评测饱和 | 当 Agent 通过所有可解任务时,评测不再提供改进信号 | 迹象:分数接近 100%、进展变慢;应对:毕业为回归评测,开发更难任务 |
| 持续运营期 | Step 8 | 长期维护 | 把评测套件当作需要持续维护的资产,明确归属 | 专门团队 + 领域专家贡献;推行"评测驱动开发";最接近用户的人定义成功标准 |
6. 评测驱动开发(Eval-Driven Development)
6.1. 能力评测 vs 回归评测
按目标,评测可以分为两类:
-
能力评测(Capability Evals):探索 Agent 能做什么,初始通过率可能很低,但驱动创新。比如测试一个旅行 Agent 能否处理复杂的多程改签。
-
回归评测(Regression Evals):保护 Agent 不会退化,必须持续运行。比如模型升级后,验证 Agent 仍然能正确预订航班。
能力评测是"进攻",回归评测是"防守"。没有能力评测,Agent 不会进步;没有回归评测,Agent 会在进步的过程中不断退化。两者缺一不可。
6.2. 评测饱和(Eval Saturation)的危险
当评测套件达到 100% 通过率时,它就失去了作为改进信号的价值。例如 SWE-Bench Verified 的分数从 30% 起步,前沿模型已达到 80% 左右、逼近饱和。饱和后,大幅度的能力提升可能只表现为微小的分数增长,结果具有欺骗性。
评测的标尺必须随着 Agent 的进步而移动。如果评测集是静态的,Agent 一旦"通关",评测就失去了方向指引的功能。必须持续补充新的、更难的案例,让评测集本身也"进化"。
6.3. 评测维护与驱动开发
评测套件不是一次性交付物,而是需要持续维护和明确归属的资产。最有效的做法是设立专门的评测团队负责核心基础设施,同时让领域专家和产品团队贡献评测任务并自行运行。
- 评测驱动开发(Eval-Driven Development):先构建评测来定义计划中的能力,然后迭代直到 Agent 表现良好。
评测不再是开发完成后的验证环节,而是开发本身的一部分------先定义"什么算成功",再让 Agent 去达成。这与测试驱动开发(TDD)一脉相承,只是对象从代码变成了 Agent 行为。
7. 完整的 Agent 评测体系
六种评测手段:
| 评测手段 | 核心目标 | 优点 | 缺点 | 投入成本 |
|---|---|---|---|---|
| 自动化评测 (Automated Evals) | 建立基线性能标准;在部署前捕获回归;提供一致、可复现的测量 | 速度快(毫秒至秒级);成本低;完全可复现;可大规模并行运行;适合 CI/CD 集成 | 只能验证预设路径;对开放式任务、微妙失败、长尾边缘案例存在盲区;容易产生"虚假信心" | 低(算力成本为主;评测集和 Rubric 需前期建设,并需持续维护) |
| 生产监控 (Production Monitoring) | 在真实用户环境中持续追踪 Agent 表现;发现线上异常和性能退化 | 反映真实使用模式;能捕获自动化评测遗漏的边缘案例;反应及时(可实时告警) | 被动(问题已发生);可能干扰用户;数据稀疏或有偏;需要额外的日志和观测基建 | 中(需要观测基建、日志存储、告警系统;持续运营成本) |
| 用户反馈收集 (User Feedback) | 直接获取用户对 Agent 表现的主观评价;发现未预见的问题 | 揭示真实用户痛点;成本低(用户主动提供);能捕捉"感觉不对"但难以量化的失败 | 稀疏(只有少数用户会反馈);有偏(极端体验者更倾向反馈);噪声大;难以归因 | 低(只需埋点和收集渠道,但后续清洗和分析需要人力) |
| A/B 测试 (A/B Testing) | 测量不同 Agent 版本对真实用户结果的影响;验证改动的实际收益 | 因果推断最强;直接测量业务指标(如转化率、留存);避免"离线好、线上差"的陷阱 | 慢(需要足够流量和统计周期);成本高(需要工程支持分流);只适用于可量化的结果指标 | 高(需要流量、工程分流、统计分析和较长实验周期) |
| 人工文本审核 (Manual Transcript Review) | 深入审阅 Agent 的执行轨迹;捕捉微妙失败和意外行为;建立对失败模式的直觉 | 能发现自动化评测漏掉的细节;理解"为什么失败"而非仅仅"是否失败";灵活应对新场景 | 极慢;极贵;不可规模化;受评审者主观偏差影响;覆盖范围有限 | 极高(需要领域专家投入大量时间逐条审阅) |
| 系统化的人类评测 (Systematic Human Evaluation) | 校准 LLM 评分器;定义和修正 Rubric;为关键版本发布提供黄金标准 | 最可靠的质量判断;能处理争议案例和边界情况;为自动化评测提供"锚点" | 成本极高;速度极慢;评审者间一致性难保证;难以高频运行 | 极高(需要结构化流程、多人标注、一致性校验和仲裁机制) |
7.1. 组合使用的逻辑:瑞士奶酪模型
- 瑞士奶酪模型:
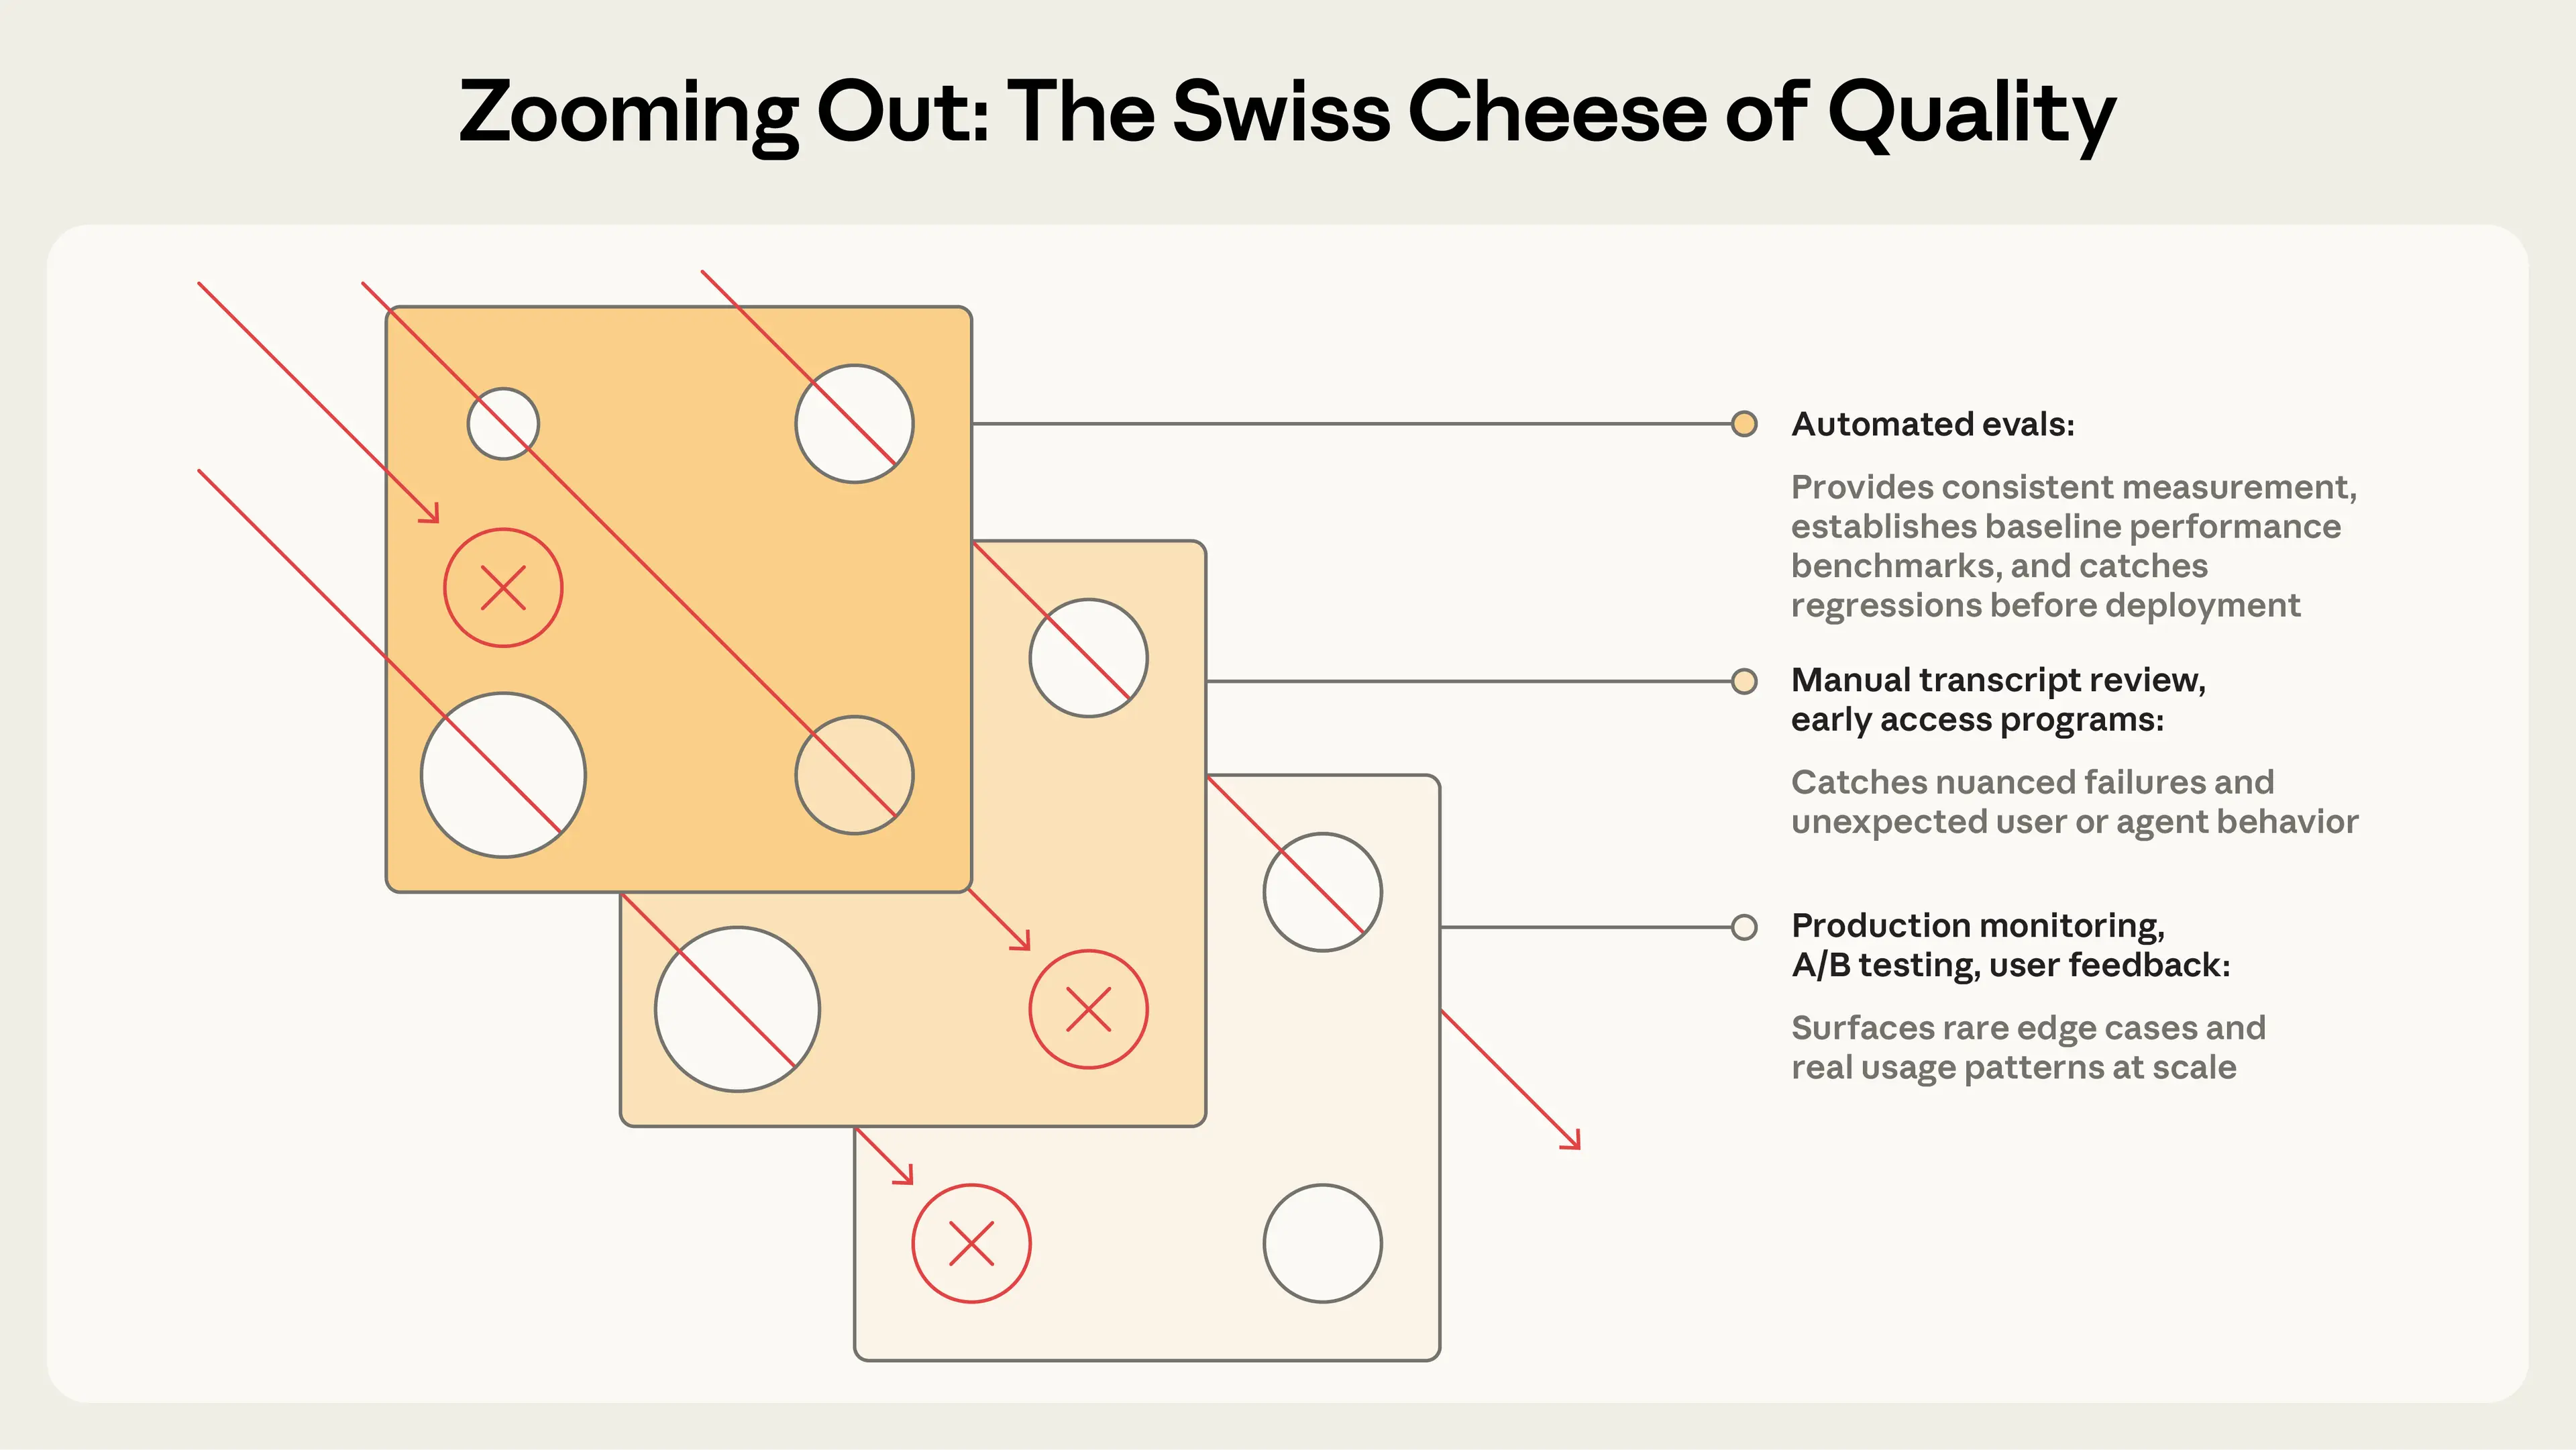
每种手段都有各自的"孔洞"(缺点/盲区),但组合起来可以形成多层防御:
| 层次 | 手段 | 在防御体系中的角色 |
|---|---|---|
| 第一层(离线/部署前) | 自动化评测 + 系统化人类评测 | 守底线、抓回归、校准评分标准 |
| 第二层(小范围/灰度) | 人工文本审核 + A/B 测试 | 抓微妙失败、验证真实收益 |
| 第三层(线上/规模化) | 生产监控 + 用户反馈收集 | 发现长尾、捕捉真实痛点、兜底 |
核心结论 :自动化评测负责效率和一致性 ,人类评测负责深度和校准 ,生产监控和用户反馈负责真实性和规模 ,A/B 测试负责因果验证。没有一种手段是万能的,只有组合成多层防御网,才能在非确定性的 AI Agent 系统中可靠地保障质量。
8. 总结:从测试到评测的范式转变
大模型的非确定性,瓦解了传统软件"设计路径 + 事后校验"的可靠性逻辑。Agent 时代,工程的核心问题从"如何正确地构建"转向"如何可靠地度量"。全文围绕这一转变展开四条主线:
-
可靠性逻辑重构:当系统行为不可枚举、不可复现,测试作为"最后一道闸门"的假设随之失效。评测从后置检查升格为驱动 Agent 进化的核心坐标------你评测什么,Agent 就朝什么方向进化;没有评测,优化就是随机游走。
-
评测架构的四要素:评测框架内含评测套件,套件由多个 Task 组成。每个 Task 定义输入、成功标准、评分器与追踪指标,通过多次 Trial 运行并记录完整 Trajectory,再由 Grader 对轨迹与最终结果评分------"多次试验 + 多维评分"是应对非确定性的基本骨架。
-
不确定性的工程化管理 :不追求消除非确定性,而是度量它、管理它。
pass@k衡量能力上限,pass^k衡量可靠性下限,二者分离才能区分"能做对"与"能稳定做对";代码评分器守底线、LLM 评分器抓质量、人类评分器定标准,三者互补覆盖完整光谱;当评测套件饱和,及时"毕业"为回归评测并开发更难的标尺。 -
评测驱动开发:评测不再是开发完成后的验证环节,而是开发本身的一部分------先定义"什么算成功",再让 Agent 去达成。能力评测负责进攻、回归评测负责防守;六种评测手段按"瑞士奶酪"模型组合成多层防御网,在非确定性系统上可靠地保障质量。
度量即控制,评测即方向。 在 AI Agent 时代,谁建立了可靠的评测,谁就掌握了 Agent 进化的方向盘------没有评测,就没有方向;没有方向,可靠性无从谈起。